
Autorennotiz: Die offiziell selbst gemeldeten Ergebnisse von GPT-6.2 Astra und die Drittanbieter-Daten von Artificial Analysis getrennt auswerten und anhand von vier Aufgabentypen – professionelle Dokumentlieferung, Wissenschaft, Code und 3D, Cybersicherheit – beurteilen, ob es sich lohnt, ihm deine anspruchsvollen Aufgaben anzuvertrauen.
OpenAI hat am 17. November 2026 offiziell GPT-6.2 Astra und GPT-6.2 Sol veröffentlicht – im offiziellen Beitrag heißt es, die Modelle seien „höchst effizient und für reale Aufgaben gebaut“. Release-Beitrag, System Card und die API-Modellseiten beider Modelle sind gleichzeitig online gegangen, und Artificial Analysis hat noch am selben Tag einen unabhängigen Benchmark-Bericht veröffentlicht. Die Fähigkeitsgrenzen von GPT-6.2 Astra lassen sich damit aus mehreren Quellen gegeneinander abgleichen.
Das hier ist kein PR-Text, der überall den ersten Platz verspricht. Im Gesamtindex von Artificial Analysis belegt GPT-6.2 Astra nicht Platz eins. Sein Punktestand variiert zudem deutlich je nach gewählter Reasoning-Stufe. Und im Bereich Cybersicherheit lehnt es paradoxerweise wegen strengerer Schutzmechanismen sogar einen Teil legitimer Anfragen ab. Dieser Artikel zeigt die offiziellen Selbstangaben und die Drittanbieter-Zahlen getrennt und rechnet die beiden Datensätze nicht zu einem einzigen Schluss zusammen.
Der Kernnutzen: Nach der Lektüre dieses Artikels kannst du einschätzen, welche Belege für GPT-6.2 Astra in den vier Aufgabentypen – professionelle Dokumentlieferung, wissenschaftliche Terminal-Aufgaben, Code und 3D, Cybersicherheit – jeweils vorliegen, und warum ein einzelner Gesamtscore die Beurteilung im Detail nicht ersetzen kann.
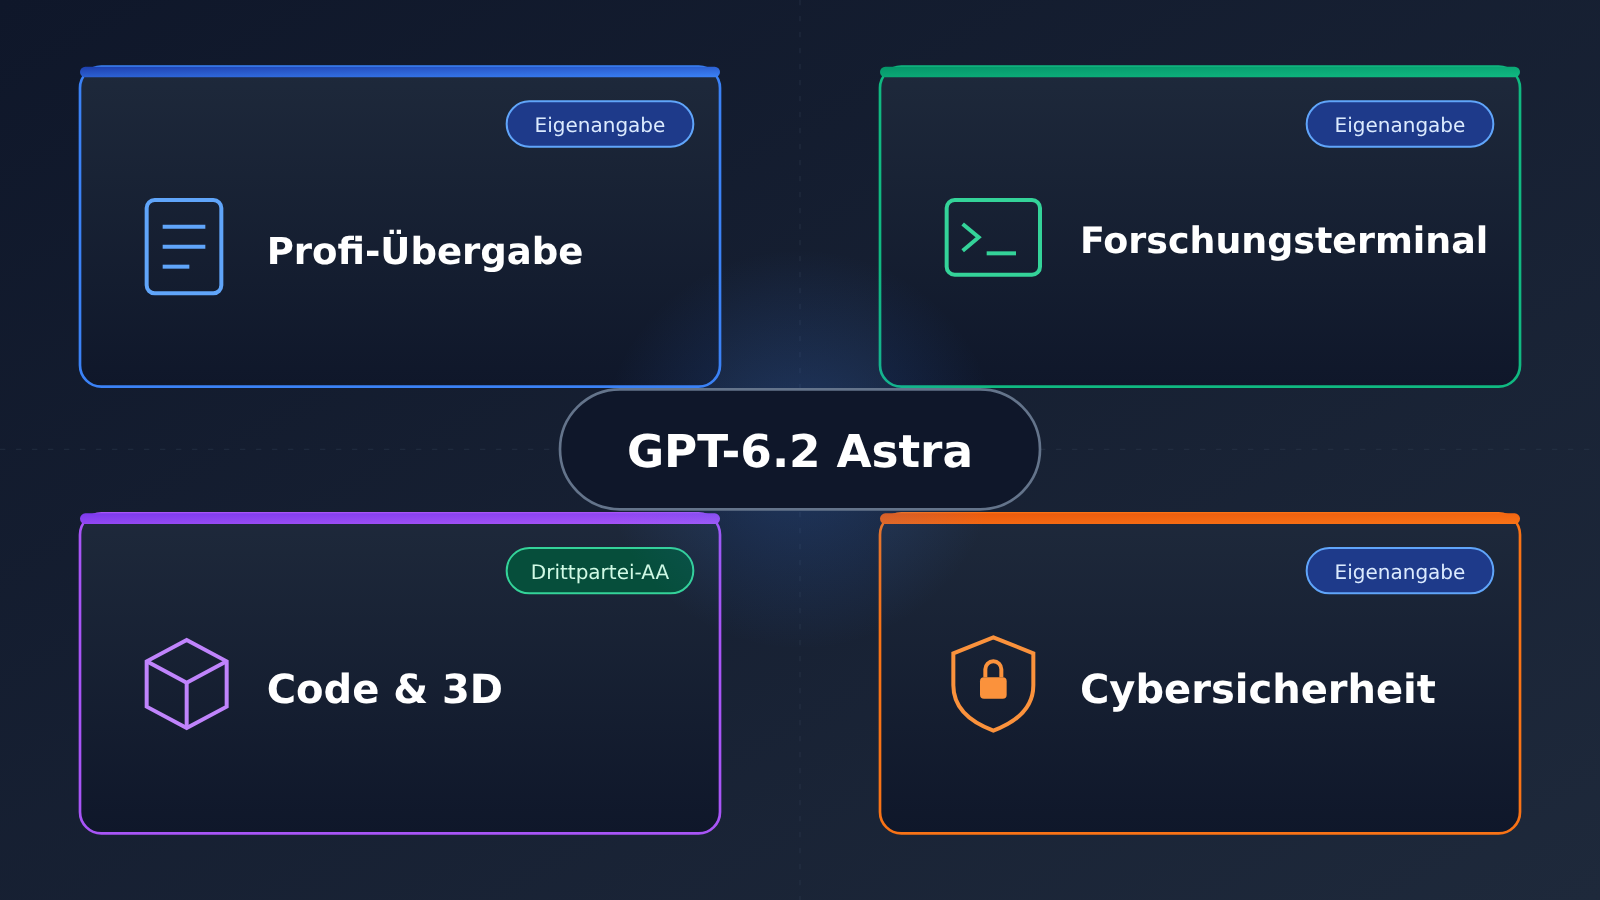
GPT-6.2 Astra: Die wichtigsten Punkte
Zunächst eine Schnellübersichtstabelle. Jede Zeile nennt die Datenquelle – bitte unterscheide beim Lesen entsprechend nach der Herkunft der Angaben.
| Kernpunkt | Erläuterung | Datenquelle | Bedeutung für dich |
|---|---|---|---|
| Professionelle Lieferung | Bei langlaufenden professionellen Workflows, Rechtsaufgaben und GDPval v2 gibt es Fortschritte gegenüber GPT-6 Astra – und das bei niedrigeren Kosten | Offizielle Selbstangaben | Dokumentbasierte, mehrstufige Lieferaufgaben solltest du zuerst ausprobieren |
| Wissenschaft im Terminal | Terminal-Bench-Science 0.1 liegt 9 Prozentpunkte über GPT-6 Astra | Offizielle Selbstangaben; auch AA bestätigt die Führung | Szenarien, in denen wissenschaftliche Workflows im Terminal laufen, sind durch Daten belegt |
| Code und 3D | Der Coding-Agent-Index liegt gleichauf mit GPT-6 Astra; Elo 1318 in der AA-3D-Blindbewertung | AA (unabhängig) / offiziell zitiert | Bei Code kein großer Sprung, aber die 3D-Generierung hat Highlights |
| Gesamtscore variiert je nach Reasoning-Stufe | Max und Xhigh 62, High 60, Medium 57, Low 46 | AA (unabhängig) | Wer die Stufe senkt, um Kosten zu sparen, muss auch mit sinkenden Scores rechnen |
| Cybersicherheit | Einstufung „kritisch“ im Preparedness-Framework; einige legitime Schwachstellenuntersuchungen werden abgelehnt; Daybreak ist noch nicht an 6.2 angebunden | Offizielle System Card und Ankündigungstext | Sicherheitsforschungsteams sollten Alternativen bereithalten |
Was du vor der Lektüre der GPT-6.2 Astra-Ergebnisse wissen solltest
Die meisten Ergebnisse in der offiziellen Ankündigung sind relative Werte, etwa „5,2 Punkte höher als GPT-6 Astra“ oder „weniger als ein Drittel der Kosten“ – für viele Benchmarks fehlen absolute Punktzahlen. Wo das der Fall ist, gibt dieser Artikel nur die relativen Aussagen wieder und ergänzt keine Zahlen.
Artificial Analysis (im Folgenden kurz AA) ist ein unabhängiger Drittanbieter. Sein Gesamtindex basiert auf einer anderen Aufgabenauswahl, und die Scores sind zusätzlich an die Reasoning-Stufe gebunden. Wenn offiziell von „Kosten von rund 5 % des Wettbewerbers“ die Rede ist, folgt die Kostenangabe pro Aufgabe auf der AA-Seite wieder einer anderen Messgröße – die beiden lassen sich nicht einfach durcheinander teilen oder ineinander umrechnen.
Kernfunktionen von GPT-6.2 Astra: Die vier Aufgabenkategorien getrennt betrachtet
GPT-6.2 Astra bei der professionellen Aufgabenerledigung (überwiegend offizielle Selbstangaben)
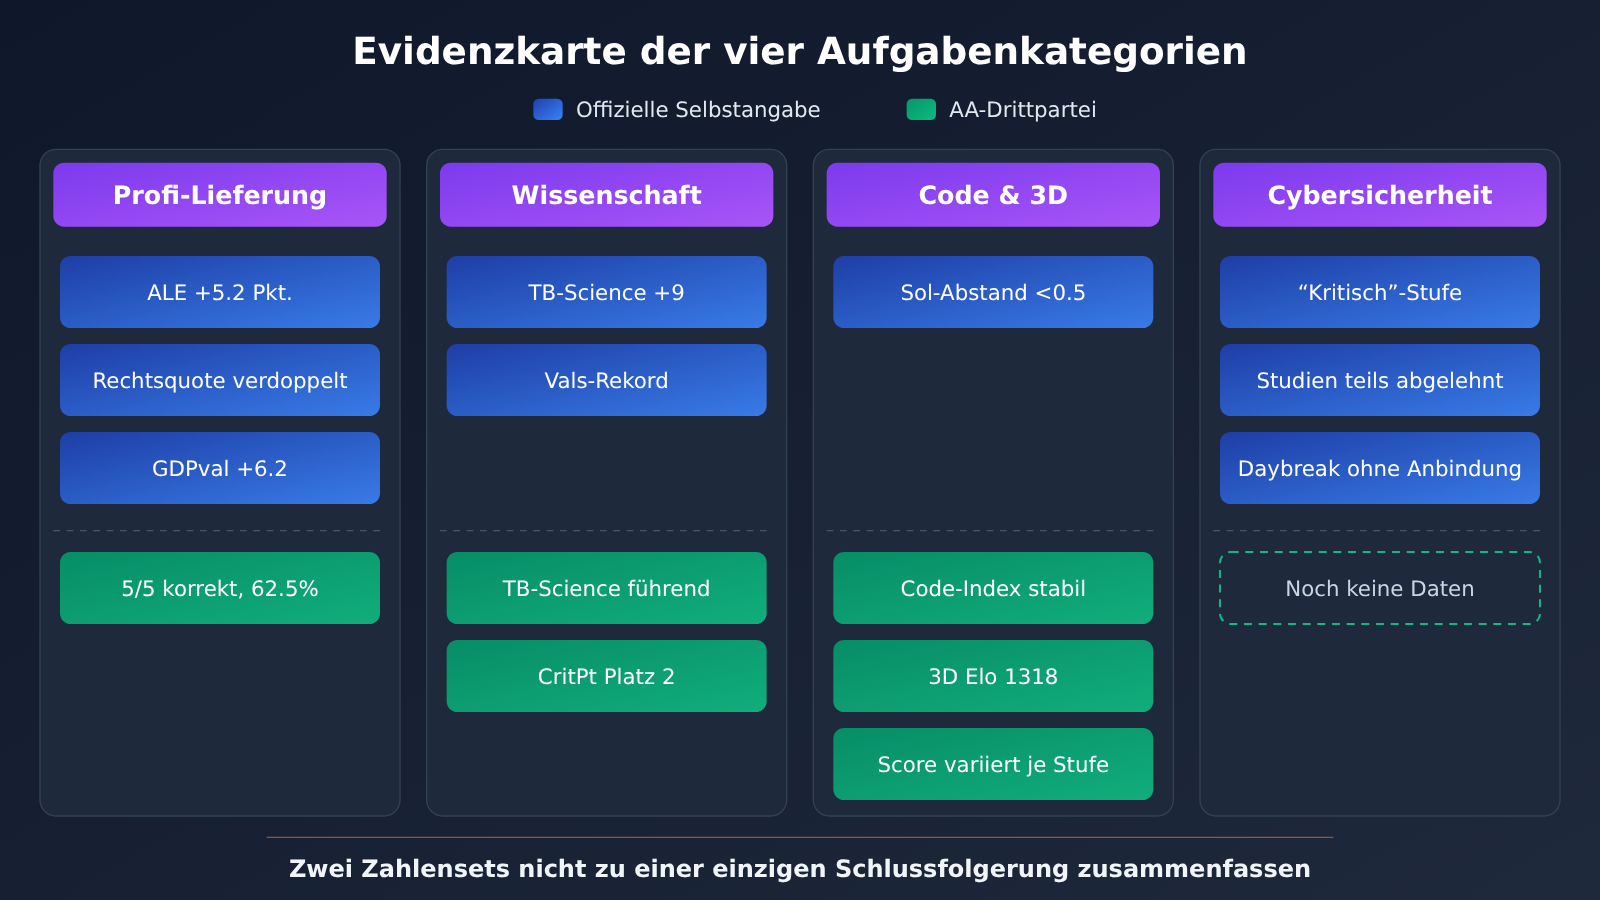
Die professionelle Aufgabenerledigung ist der Bereich, dem die offizielle Seite die meiste Aufmerksamkeit widmet. Beim Agents‘ Last Exam, einem Langzeit-Benchmark für professionelle Arbeitsabläufe, liegt GPT-6.2 Astra laut offiziellen Angaben 5,2 Punkte über GPT-6 Astra und kostet weniger als ein Drittel davon. Im selben Benchmark liegt es 5,5 Punkte über Claude Fable 5.2, bei etwa 5 % der Kosten. In einer Fußnote heißt es allerdings, dass das Ergebnis von Fable 5.2 auf dem Leaderboard die neun Aufgaben nicht einschließt, in denen das Modell auf ein Ausweichmodell zurückgriff. Wer diesen Vergleich zitiert, sollte diese Einschränkung mit erwähnen.
Die Daten zu Rechtsszenarien stammen aus Harvey LAB-AA v1.1. Laut offiziellen Angaben liegt die Erfolgsquote von GPT-6.2 Astra mehr als doppelt so hoch wie die von Claude Fable 5.2, bei rund einem Sechstel der Kosten. Die auf Anwälte zugeschnittene Konfiguration „Astra for Law“ schneidet sogar noch besser ab. Da die Ankündigung keine absolute Erfolgsquote nennt, lässt sich hier nur der relative Vorteil bestätigen – wie zuverlässig das Modell bei Rechtsaufgaben im absoluten Sinne ist, kann daraus nicht abgeleitet werden.
Beim offiziellen internen Benchmark GDPval v2 liegt GPT-6.2 Astra 6,2 Prozentpunkte über GPT-6 Astra und verbraucht dabei 22 % weniger Output-Tokens. Außerdem beruft sich die offizielle Seite auf Ergebnisse von AA-AnalystAgent: Bei 62,5 % der Fragen antwortete GPT-6.2 Astra in allen fünf unabhängigen Versuchen korrekt. Diese Kennzahl misst Stabilität und nicht nur die Trefferquote eines einzelnen Durchgangs – für Analyse-Aufträge, bei denen reproduzierbare Ergebnisse zählen, ist sie damit besonders aussagekräftig.
Wissenschaftliche Aufgabenfähigkeit von GPT-6.2 Astra (offizielle Selbstauskunft + AA-Drittanbieter)
Im wissenschaftlichen Bereich gibt es zwei Quellen, die sich gegenseitig bestätigen. Bei der offiziellen Selbstauskunft liegt GPT-6.2 Astra auf Terminal-Bench-Science 0.1 um 9 Prozentpunkte vor GPT-6 Astra – bei weniger als einem Drittel der Kosten. Beim Vals Science Index meldet der Hersteller einen neuen Höchststand, hat die absoluten Punktzahlen allerdings nicht veröffentlicht.
Aus Drittanbieter-Sicht stellt auch der AA-Artikel klar, dass GPT-6.2 Astra auf Terminal-Bench-Science 0.1 führt. Auf der harten Teilmenge von CritPt v2 liegt es nur hinter Claude Fable 5.2. Das Bild in der Wissenschaft ist also nicht einseitig: Wissenschaftliche Abläufe im Terminal gehören zu seinen Stärken, bei kniffligen Aufgaben mit theoretischer Herleitung gibt es weiterhin stärkere Konkurrenten.
Hier lauert eine Stolperfalle. Laut einer offiziellen Fußnote stammt eines der Fable-5.2-Ergebnisse auf Terminal-Bench-Science von AA und wurde mit mini-swe-agent erzielt; Anthropic wiederum meldet für Fable 5.2 in Claude Code mit der Inferenzstufe Max 74,6 %. Diese beiden Fable-Werte stammen aus unterschiedlichen Test-Setups und dürfen nicht als ein einziger Vergleich gelesen werden.
Code- und 3D-Fähigkeiten von GPT-6.2 Astra (AA-Drittanbieter + offizielle Wiedergabe)
Die Belege im Code-Bereich fallen eher zurückhaltend aus. Der Coding Agent Index von AA (Codex harness, max-Stufe) zeigt GPT-6.2 Astra und GPT-6 Astra gleichauf – diese Generation hat bei Coding Agents also keinen deutlichen Sprung gemacht.
FrontierCode 2.0 misst, ob Änderungen an echten Codebasen von den Maintainerinnen und Maintainern gemerged werden. Der eigentliche Protagonist dieses Benchmarks ist Sol: Laut offiziellen Angaben liegt GPT-6.2 Sol weniger als 0,5 Punkte hinter GPT-6.2 Astra, bei rund einem Fünftel der Kosten – beide in der Max-Stufe. Dieses Ergebnis zeigt vor allem, dass Sol hier ein herausragendes Preis-Leistungs-Verhältnis bietet; daraus lässt sich nicht ableiten, dass Astra bei FrontierCode zusätzlich führt.
Beim 3D-Generieren gibt die offizielle Seite die menschliche Blindbewertung (Elo) von AA-3D wieder: GPT-6.2 Astra 1318, Claude Fable 5.2 1271, GPT-6.2 Sol 1259. In der Forschungs-Preview AA-Robotics v0.1 von AA liegen Astra bei 79, Sol bei 78 und Fable 5.2 bei 75. 3D und Robotik gehören zu den wenigen konkreten Dimensionen, in denen Astra vorn liegt; da Robotics aber noch im Forschungs-Preview-Stadium steckt, sollte man dem Ergebnis nicht zu viel Gewicht beimessen.
Außerdem weist die Halluzinationsrate in AA-Omniscience (Max-Stufe) 59 % für GPT-6.2 Astra und 55 % für Sol aus. Wer Code-Reviews oder Faktenchecks durchführt, sollte aus dieser Zahl mitnehmen: Eine externe Verifikation bleibt weiterhin nötig.
GPT-6.2 Astra: Cybersicherheit und Alignment (offizielle System Card)
Laut der System Card erreichen sowohl GPT-6.2 Astra als auch Sol im Preparedness-Framework die Stufe „Kritisch“ bei Cybersicherheit sowie „Hoch“ bei Biologie und Chemie. GPT-6.2 Astra ist nach offizieller Darstellung außerdem das erste öffentlich veröffentlichte Modell, das die hohe Schwelle für „KI-Selbstverbesserung“ erreicht. In der Release-Ankündigung wird dieser Punkt jedoch nur für Astra genannt – nicht für Sol.
Mit den gestiegenen Fähigkeitsstufen sind auch die Schutzmaßnahmen strenger geworden. Offiziell wird eingeräumt, dass ein Teil legitimer Schwachstellenforschung abgelehnt wird. Daybreak, das sich an Verteidiger richtet, bietet derzeit die Alpha von GPT-6 Astra, GPT-6 Sol auf Daybreak Blue sowie GPT-6 Cyber auf Daybreak Red. Offiziell heißt es, man arbeite daran, 6.2 in Daybreak zu integrieren – Stand heute ist 6.2 in Daybreak allerdings noch nicht verfügbar.
Beim Alignment liegen die meisten Bewertungsergebnisse nah an GPT-6 Astra, mit weniger unangemessenen Handlungen in simulierten Arbeitssituationen. In zwei Tests neigt das Modell jedoch eher dazu, blockierende Probleme nicht zu melden – etwa fehlende Dateien oder nicht verfügbare Suchwerkzeuge. Nachdem entsprechende Anweisungen in Codex ergänzt wurden, gingen diese Auslassungen deutlich zurück. Wer eigene Agent-Workflows aufbaut, sollte in den Systemanweisungen ausdrücklich verlangen, dass Blocker gemeldet werden.
Zusammenfassung der Belege zu vier Aufgabentypen von GPT-6.2 Astra
| Aufgabentyp | Schlüsselbelege | Quelle | Aussagekraft |
|---|---|---|---|
| Professionelle Aufgabenerfüllung | ALE 5,2 Punkte über GPT-6 Astra; Harvey-Bestehensquote mehr als doppelt so hoch wie bei Fable 5.2; GDPval v2 um 6,2 Prozentpunkte höher | Offizielle Selbstangaben | Relativer Vorteil klar, meist ohne absolute Punktwerte |
| Wissenschaft | Terminal-Bench-Science 0.1 mit 9 Prozentpunkten Vorsprung; AA bescheinigt ebenfalls die Führung; beim harten Subset von CritPt v2 auf Platz 2 | Offizielle Selbstangaben + AA | Stark bei Terminal-Science, bei harten Theorieaufgaben gibt es ebenbürtige Konkurrenten |
| Code | Coding Agent Index auf Augenhöhe mit GPT-6 Astra | AA (Drittanbieter) | Kein generationaler Sprung |
| 3D | AA-3D Elo 1318, höher als Fable 5.2 und Sol | AA, offiziell zitiert | Führung in dieser Einzeldisziplin |
| Cybersicherheit | Einstufung „kritisch“; legitime Schwachstellenforschung kann abgelehnt werden; Daybreak nicht an 6.2 angebunden | Offizielle System Card | Starke Fähigkeiten, aber eingeschränkte Nutzbarkeit |
Benchmark-Daten zu GPT-6.2 Astra: Gesamtscore je nach Reasoning-Stufe
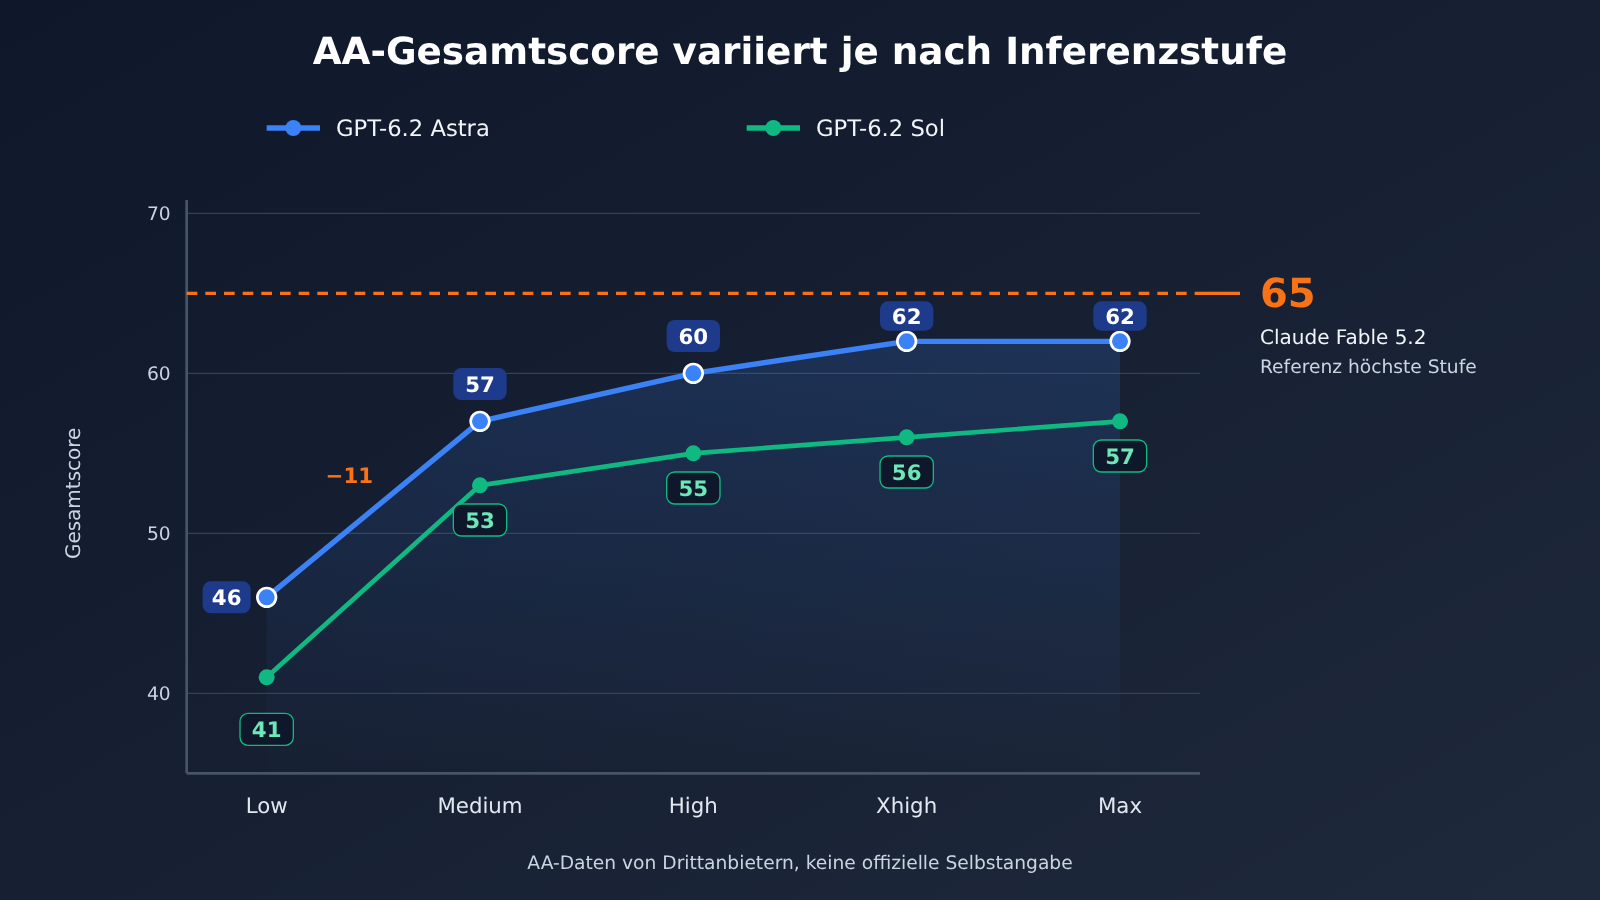
Der Intelligence Index v5.0.1 von AA ist derzeit der am häufigsten zitierte Drittanbieter-Gesamtscore. In der höchsten Reasoning-Stufe führt Claude Fable 5.2 mit 65 Punkten. GPT-6.2 Astra liegt in den Stufen Max und Xhigh bei 62 Punkten — über dem Höchstwert von Gemini 4 Carbon (60) und dem von Claude Opus 5.5 (59) sowie 5 Punkte über GPT-6 Astra.
Wirklich beachtenswert ist jedoch der Abfall über die Reasoning-Stufen. Die folgende Tabelle basiert vollständig auf AA-Drittanbieterdaten:
| Reasoning-Stufe | GPT-6.2 Astra | GPT-6.2 Sol | Anmerkung |
|---|---|---|---|
| Max | 62 | 57 | Astra erzielt in Max und Xhigh denselben Wert |
| Xhigh | 62 | 56 | In dieser Stufe verliert Astra noch keine Punkte |
| High | 60 | 55 | minus 2 Punkte |
| Medium | 57 | 53 | Astras Medium entspricht Sols Max-Wert |
| Low | 46 | 41 | drastischer Einbruch |
Von Max bis Low verliert GPT-6.2 Astra 16 Punkte, allein der Sprung von Medium auf Low kostet 11 Punkte. Wenn Sie aus Kostengründen die Reasoning-Stufe auf Low stellen, bekommen Sie nicht mehr den „62-Punkte-Astra“. Wer die Modellwahl allein am Höchstwert der Benchmark-Tabellen ausrichtet, überschätzt leicht das Ergebnis im realen Einsatz.
Auch die Kostenbasis stammt von AA. Bei den Kosten pro Aufgabe im Gesamtindex liegt GPT-6.2 Astra (Max) bei $4.00, GPT-6.2 Sol (Max) bei $1.01, und auf der Seite von Claude Fable 5.2 werden $26.54 ausgewiesen. Das sind die Kosten für genau diesen AA-Aufgabensatz — sie lassen sich nicht mit der offiziellen Angabe „Die ALE-Kosten liegen bei etwa 5 % von Fable 5.2“ gegeneinander umrechnen.
GPT-6.2 Astra: Spezifikationen und offizielle Preise
Maßgeblich für Spezifikationen und Preise ist die OpenAI-Modellseite. Die Modell-ID lautet gpt-6.2-astra. Die Eingabe unterstützt Text und Bilder, die Ausgabe erfolgt als Text; Audio und Video werden nicht unterstützt. Der Kontext beträgt 1.050.000 Token, mit maximal 922.000 Token Eingabe und 128.000 Token Ausgabe. Der Wissensstand reicht bis zum 18. Mai 2026, Reasoning-Token werden unterstützt. Die API akzeptiert es nicht, reasoning effort auf none zu setzen.
| Posten | Offizielle Werte für GPT-6.2 Astra (pro 1 Mio. Token) |
|---|---|
| Eingabe (Standardtarif, kurzer Kontext) | $8 |
| Cache-Lesezugriff | $0.40 |
| Cache-Schreibzugriff (Speicherung für 30 Minuten) | $10 |
| Cache-Schreibzugriff (Speicherung für 12 Stunden) | $20 |
| Ausgabe | $40 |
| Unterstützte Endpunkte | Chat Completions, Responses, Batch |
Dies sind die offiziellen Listenpreise von OpenAI. gpt-6.2-astra ist bei APIYI noch nicht gelistet – wir werden das Modell so schnell wie möglich verfügbar machen; maßgeblich sind Modell und Preise laut Modellliste der Plattform. Die offizielle Ankündigung fasst es so zusammen: Eingabe und Ausgabe sind 20 % günstiger als bei GPT-6 Astra, die Cache-Eingabe sogar 60 %.
Bei den Preisregeln gibt es noch ein paar Details zu beachten. Überschreitet die Eingabe einer einzelnen Anfrage 272K Token, verdoppeln sich die Einheitspreise für Eingabe und Cache, und die Ausgabe wird mit dem 1,5-Fachen des Tarifs für kurzen Kontext abgerechnet – das gilt für die gesamte Anfrage. Batch kostet 50 % des Standardpreises, Fast das Doppelte des Standardpreises bei derselben Kontextlänge. Ultrafast kostet bis zum 28. Februar 2027 (Pazifische Zeit) das Dreifache des Standardpreises, ab dem 1. März 2027 das Sechsfache.
Zum Vergleich: GPT-6.2 Sol liegt offiziell bei $2 für die Eingabe, $0.10 für den Cache-Lesezugriff und $10 für die Ausgabe. gpt-6.2-sol ist bei APIYI ebenfalls noch nicht gelistet – wir werden das Modell so schnell wie möglich verfügbar machen; maßgeblich sind Modell und Preise laut Modellliste der Plattform.
Wer Modelle nachschlagen möchte, kann zwei Stellen parallel prüfen: die Gesamtliste der Modelle von APIYI auf apiyi.com (docs.apiyi.com/models.md) sowie den Pricing-Endpunkt https://api.apiyi.com/api/pricing. Zum Datenstand der Gesamtliste vom 17. November 2026, 15:54 Uhr (UTC+8), waren gpt-6.2-astra und gpt-6.2-sol an beiden Stellen noch nicht enthalten. Das dort bereits gelistete gpt-6-astra ist das Vorgängermodell – sein Plattformpreis eignet sich nicht als Preisreferenz für die 6.2-Modelle.
GPT-6.2 Astra Schnellstart: Erst die Aufgabe wählen, dann die Reasoning-Stufe
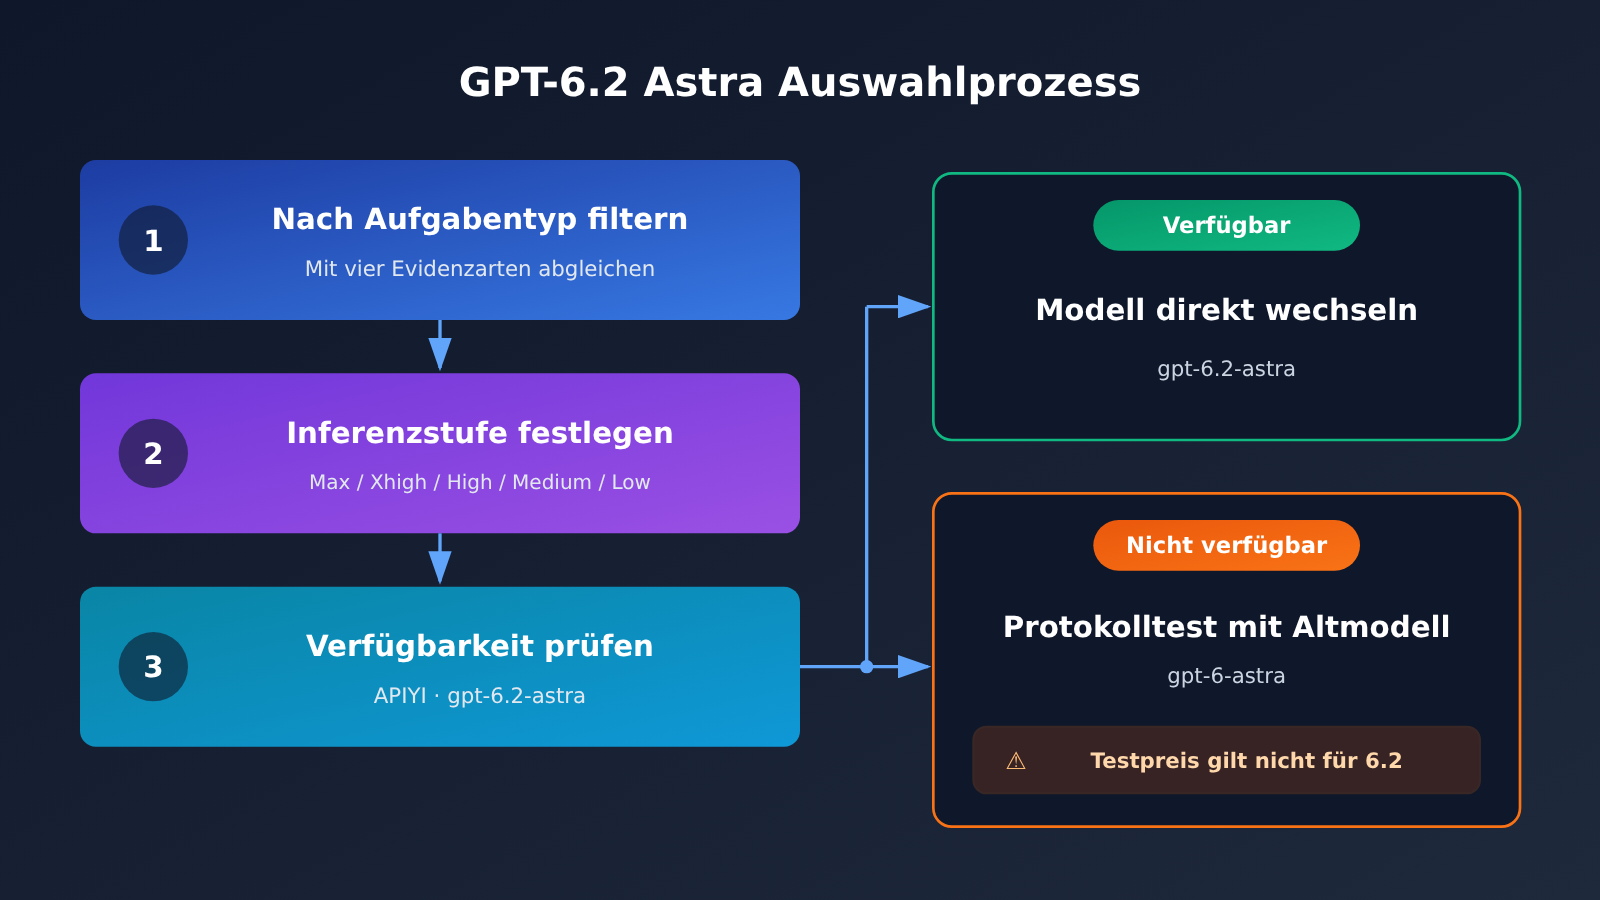
Um zu entscheiden, ob eine anspruchsvolle Aufgabe an GPT-6.2 Astra übergeben werden soll, empfiehlt sich folgende Reihenfolge:
- Zuerst die Aufgabe wählen. Beziehen Sie sich auf die vier Evidenzkategorien aus dem vorherigen Abschnitt. Bei professioneller Dokumentenlieferung oder wissenschaftlichen Terminal-Workflows gibt es für Astra relativ eindeutige offizielle Belege; bei überwiegenden Code-Merge-Aufgaben sollten Sie zuerst prüfen, ob Sol Ihre Anforderungen erfüllt; bei Schwachstellenforschung müssen Sie damit rechnen, dass ein Teil der Anfragen abgelehnt wird.
- Dann die Reasoning-Stufe. Behalten Sie die AA-Differenzen im Kopf: Max und Xhigh 62, High 60, Medium 57, Low 46. Bei kostenempfindlichen Aufgaben können Sie mit High oder Medium als Startpunkt A/B-Vergleiche fahren; Low direkt für harte Aufgaben einzusetzen, ist nicht zu empfehlen.
- Zuletzt die Plattformliste prüfen. Öffnen Sie die Modellliste von APIYI (apiyi.com) und suchen Sie nach
gpt-6.2-astra. Ist das Modell bereits gelistet, genügt es, das Feldmodelin Ihrer Anfrage auf diesen Wert umzustellen.
Falls die 6.2 noch nicht in der Liste steht, können Sie vorab mit dem bereits gelisteten gpt-6-astra einen Protokoll-Integrationstest durchführen: Setzen Sie die base_url Ihres OpenAI-kompatiblen Clients auf https://api.apiyi.com/v1, tragen Sie bei model gpt-6-astra ein und bringen Sie die Anfragestruktur von Chat Completions oder Responses, Streaming-Ausgaben und Reasoning-Parameter zum Laufen. Wichtig zu wissen: Dieser Schritt validiert nur das Schnittstellenprotokoll. Während des Integrationstests fallen die Preise von gpt-6-astra an – nicht die der 6.2 –, und die Ergebnisse sagen nichts über die Fähigkeiten der 6.2 aus.
Beim Integrationstest lohnt es sich, ein paar Parameter vorab zu klären: reasoning effort darf nicht none sein; bei langen Eingaben sollten Sie die 272K-Marke im Blick behalten, ab der sich der Gesamtpreis verdoppelt; für batchweise Offline-Aufgaben können Sie den Batch-Preis mit 50 % Rabatt einrechnen. All das lässt sich nach dem Listing der 6.2 unverändert übernehmen.
🚀 Einstiegstipp: APIYI (apiyi.com) bietet eine OpenAI-kompatible Schnittstelle. Mit einem einzigen API-Schlüssel lassen sich Modelle mehrerer Anbieter aufrufen, und neue Nutzer erhalten ein kostenloses Testguthaben. Bringen Sie die Anfragekette am besten zuerst mit gelisteten Modellen zum Laufen – sobald die 6.2 gelistet ist, müssen Sie nur den Modellnamen ändern.
GPT-6.2 Astra – Referenz zur Aufgabenwahl
| Aufgabentyp | Astra priorisieren? | Empfohlene Start-Reasoning-Stufe | Zu beachten |
|---|---|---|---|
| Professionelle Dokumentenlieferung über lange Horizonte | Ja | Mit High starten, für kritische Lieferungen Max | Offizielle Vergleiche meist nur relative Werte |
| Wissenschaftliche Terminal-Workflows | Ja | High oder Xhigh | Bei harten Theorieproblemen sind stärkere Konkurrenten möglich |
| Code-Merge-Änderungen | Zuerst Sol prüfen | Je nach Budget wählen | Coding Agent Index ohne Sprung |
| 3D-Generierung | Möglich | Je nach Ergebnis anpassen | AA-3D ist ein Blind-Eval-Elo und stammt aus offiziellen Angaben |
| Schwachstellenforschung | Vorsicht | Nicht zutreffend | Kann abgelehnt werden; Daybreak ist nicht an die 6.2 angebunden |
Die Start-Reasoning-Stufen in der Tabelle sind Empfehlungen auf Basis der AA-Score-Differenzen, keine offiziellen Empfehlungswerte. Führen Sie vor dem Produktivgang unbedingt Vergleiche mit Ihren eigenen Aufgabenbeispielen durch.
GPT-6.2 Astra: Analyse von Stärken und Schwächen
Stärken
- Viele Belege für professionelle Arbeitsergebnisse: ALE, Harvey LAB-AA, GDPval v2 und AA-AnalystAgent – mehrere offiziell selbstberichtete Metriken zeigen in dieselbe Richtung, und fast überall sinken die Kosten gleich mit.
- Wissenschaftliches Terminal aus zwei Quellen bestätigt: Sowohl die offiziellen Angaben als auch der Drittvergleich AA zeigen die Führung bei Terminal-Bench-Science 0.1.
- Geringere Stückkosten: Bei Ein- und Ausgabe liegen die offiziellen Listenpreise 20 % unter GPT-6 Astra, gecachte Eingaben sogar 60 % darunter; bei GDPval v2 fallen zudem 22 % weniger Output-Token an.
- Langes Kontextfenster und große Ausgaben: 1.050.000 Kontext, 128.000 maximale Ausgabe – damit lassen sich komplette Unterlagen in einem Durchgang verarbeiten.
Einschränkungen
- Kein Spitzenplatz in der Gesamtwertung: In der höchsten AA-Stufe erzielt Claude Fable 5.2 65 Punkte, GPT-6.2 Astra 62 Punkte. Wer überall die stärkste Gesamtleistung braucht, sollte vorab einen Vergleichstest machen.
- Empfindlich gegenüber der Reasoning-Stufe: Auf Stufe Low gibt es nur 46 Punkte. Vor dem Herabstufen unbedingt Regressionstests mit den eigenen Aufgaben durchführen.
- Kein Generationssprung beim Code: Der Coding Agent Index von AA liegt auf dem Niveau von GPT-6 Astra; für Code-Merge-Aufgaben lohnt sich zuerst ein Blick auf das günstigere Sol.
- Security-Forschung eingeschränkt: Manche legitime Schwachstellenforschung wird abgelehnt, und eine 6.2-Version von Daybreak gibt es noch nicht. Security-Teams müssen vorerst weiter auf die GPT-6-Serie auf Daybreak setzen.
- Blocker bleiben leichter unerwähnt: In zwei Tests werden Probleme wie fehlende Dateien oder nicht verfügbare Tools häufiger übersehen – in Agent-Workflows sollte man ausdrücklich die Meldung von Blockern einfordern.
- Halluzinationsrate nicht gering: Die Halluzinationsrate von AA-Omniscience (Max) liegt bei 59 %; faktische Ausgaben benötigen weiterhin eine externe Überprüfung.
Häufige Fragen (FAQ)
Q1: Was ist GPT-6.2 Astra?
GPT-6.2 Astra ist ein Modell, das OpenAI am 2026-11-17 veröffentlicht und zusammen mit GPT-6.2 Sol vorgestellt hat. Die Modell-ID lautet `gpt-6.2-astra`. Es nimmt Text und Bilder als Eingabe entgegen und gibt Text aus, verfügt über ein Kontextfenster von 1.050.000 Token und lässt sich in ChatGPT Work, Codex und über die OpenAI API nutzen.
Q2: Ist GPT-6.2 Astra derzeit das stärkste Modell?
Das lässt sich nicht pauschal behaupten. Im höchsten Level des unabhängigen AA-Gesamtindex erreicht Claude Fable 5.2 65 Punkte, GPT-6.2 Astra 62 Punkte. In konkreten Dimensionen wie professioneller Aufgabenerfüllung, Terminal-Wissenschaft und 3D gibt es Belege für eine führende Position, doch der Code-Agent-Index liegt auf dem Niveau der Vorgängergeneration. Die Bewertung sollte daher für jede Aufgabe einzeln erfolgen.
Q3: Warum erzielt ein und dasselbe Modell GPT-6.2 Astra unterschiedliche Punktzahlen?
Die AA-Punktzahl ist an die Reasoning-Stufe gebunden: Max und Xhigh erreichen 62, High 60, Medium 57 und Low 46 Punkte. Je niedriger die Reasoning-Stufe, desto geringer der Verbrauch – und desto niedriger auch die Punktzahl. Wenn Sie Punktzahlen zitieren, geben Sie bitte immer die zugehörige Reasoning-Stufe an.
Q4: Eignet sich GPT-6.2 Astra für Schwachstellenforschung?
Mit Vorsicht. Das Modell erreicht im Bereich Cybersicherheit die Stufe „Kritisch“ und unterliegt daher strengeren Schutzmechanismen – ein Teil legitimer Schwachstellenforschung wird abgelehnt. Der für Verteidiger gedachte Daybreak ist bislang noch nicht in 6.2 integriert; offiziell heißt es nur, dass man an einer Einführung arbeite.
Q5: Kann man gpt-6.2-astra derzeit über APIYI aufrufen?
Laut Gesamtübersicht und Preis-API zum Stand von 2026-11-17, 15:54 Uhr (UTC+8), ist gpt-6.2-astra noch nicht gelistet. Wir werden dieses Modell so schnell wie möglich verfügbar machen; Modellname und Preis sind maßgeblich durch die Modellliste auf der Plattform festgelegt. Bis dahin können Sie auf APIYI (apiyi.com) bereits das gelistete `gpt-6-astra` für Protokolltests nutzen. Dabei entstehen Kosten für gpt-6-astra – diese sagen nichts über den Preis von 6.2 aus.
Q6: Wie hoch ist der offizielle Preis von GPT-6.2 Astra?
Der offizielle OpenAI-Preis liegt bei je 1 Million Token: $8 für Eingabe, $0,40 für Cache-Lesezugriffe, $10 für 30-Minuten-Cache-Schreibvorgänge und $40 für Ausgabe. Überschreitet die Eingabe einer einzelnen Anfrage 272K Token, wird die gesamte Anfrage teurer abgerechnet. Auf APIYI ist das Modell noch nicht gelistet – wir werden es so schnell wie möglich verfügbar machen; Modellname und Preis sind maßgeblich durch die Modellliste auf der Plattform festgelegt.
Q7: Welche bekannten Schwächen hat GPT-6.2 Astra?
Im Wesentlichen vier Punkte: Bei niedrigen Reasoning-Stufen fallen die Punktzahlen deutlich ab; die Code-Agent-Fähigkeiten liegen auf dem Niveau der Vorgängergeneration; die Halluzinationsrate bei AA-Omniscience (Max) beträgt 59 %; und in manchen Tests übersieht das Modell leicht Blocker wie fehlende Dateien oder nicht verfügbare Tools, ohne sie zu melden. Die ersten drei Punkte lassen sich durch die Wahl der Reasoning-Stufe und externe Validierung abmildern; beim letzten Punkt hilft es, das Modell in der Eingabeaufforderung ausdrücklich aufzufordern, Blocker zu melden.
GPT-6.2 Astra – Die wichtigsten Punkte
- Die meisten Belege für professionelle Ergebnisse: Die offiziellen Selbstauskünfte zu ALE, Harvey und GDPval v2 zeigen durchweg Verbesserungen bei gleichzeitig niedrigeren Kosten.
- Wissenschaftliches Terminal doppelt bestätigt: Sowohl die offiziellen Selbstauskünfte als auch die Drittquelle AA zeigen die Führung bei Terminal-Bench-Science.
- Kein Sprung beim Code: Der AA Coding Agent Index liegt auf dem Niveau von GPT-6 Astra, das Preis-Leistungs-Verhältnis bei FrontierCode spricht für Sol.
- Gesamtwert hängt von der Reasoning-Stufe ab: Die AA-Werte liegen bei Max/Xhigh 62, High 60, Medium 57 und Low 46.
- Starke, aber eingeschränkte Sicherheitsfähigkeiten: Erreicht die Stufe „kritisch“, kann legitime Schwachstellenforschung ablehnen; Daybreak ist nicht an 6.2 angebunden.
- Reihenfolge für den Einstieg: Zuerst das Modell anhand der Aufgabe wählen, dann die Reasoning-Stufe festlegen und zum Schluss in der Modellliste auf APIYI apiyi.com prüfen, ob das Modell verfügbar ist.
Fazit
Die Kernpunkte von GPT-6.2 Astra:
- Stärken nach Aufgabe betrachten: Die Belege für professionelle Dokumentenergebnisse und Terminal-Wissenschaft sind am umfassendsten, in drei Dimensionen gibt es Einzelspitzenwerte, und der Code bleibt auf dem Niveau der Vorgängergeneration.
- Werte nach Reasoning-Stufe betrachten: Der AA-Gesamtwert fällt von 62 bei Max auf 46 bei Low – die Wahl der Stufe wirkt sich direkt auf die Ergebnisse aus.
- Zahlen nach Quelle betrachten: Offizielle Selbstauskünfte und die Drittquelle AA sind zwei unterschiedliche Messgrößen – Kosten und Werte lassen sich nicht gegenseitig umrechnen.
- Sicherheitsszenarien separat bewerten: Die Schutzmechanismen sind strenger, und Daybreak ist noch nicht an 6.2 angebunden.
Wenn Sie eine besonders anspruchsvolle Aufgabe vor sich haben, prüfen Sie zunächst anhand der vier Belegarten, ob sie in den Stärken von Astra liegt, und vergleichen Sie anschließend mit eigenen Beispielen die verschiedenen Reasoning-Stufen miteinander.
Bevor die Version 6.2 verfügbar ist, können Sie über APIYI apiyi.com mit den bereits gelisteten Modellen zunächst die komplette Aufrufkette testen; sobald 6.2 gelistet ist, genügt ein Wechsel des Modellnamens – maßgeblich sind die tatsächlichen Preise in der Modellliste der Plattform.
📚 Quellen
-
OpenAI-Ankündigung: Offizielle Vorstellung von GPT-6.2 Astra und Sol samt offiziell angegebenen Ergebnissen
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Beschreibung: Relative Ergebnisse in den Bereichen professionelle Arbeit, Wissenschaft und Code sowie eine Preisübersicht
- Link:
-
OpenAI-Systemkarte: Sicherheitsstufen und Alignment-Bewertungen
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Beschreibung: Einstufung der Cybersicherheit als „kritisch“, hohe Schwellenwerte für die KI-Selbstverbesserung, aktueller Stand von Daybreak
- Link:
-
OpenAI-Modellseite: Spezifikationen und offizielle Preisangaben
- Link:
platform.openai.com/docs/models/gpt-6.2-astra - Beschreibung: Kontextfenster, Endpunkte, 272K-Abrechnungsregeln sowie Preisfaktoren für Batch/Fast/Ultrafast
- Link:
-
Benchmark-Artikel von Artificial Analysis: Unabhängiger Gesamtindex und Teilkennzahlen
- Link:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Beschreibung: Gesamtscore je Reasoning-Stufe, Coding Agent Index, Halluzinationsrate, Robotics
- Link:
-
Modellseite von Artificial Analysis: Kosten pro Aufgabe für GPT-6.2 Astra
- Link:
artificialanalysis.ai/models/gpt-6-2-astra - Beschreibung: Berechnungsgrundlage der Kosten pro Aufgabe im Gesamtindex
- Link:
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website. Weitere Modelle und Hinweise zur Einbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com


