
Dieser Artikel vergleicht Qwen4-Max und GPT-6 Luna anhand der Kennzahlen aus demselben Leaderboard, der Preise für langen Kontext und der Eingabemodalitäten im Rahmen einer Modellauswahl. Die Gesamtpunktzahl übersetzen wir dabei in Abnahmekriterien und Kostenurteile für konkrete Aufgaben.
Zuerst die Schlussfolgerung, dann die Bedingungen: Wenn eine Aufgabe zwingend eine Videoeingabe erfordert, kommt nach den Modellkarten der beiden Anbieter zunächst nur Qwen4-Max infrage; GPT-6 Luna fällt aus der Auswahl. Handelt es sich um reine Text- oder Bild-Text-Aufgaben und sind Einzelkosten und Aufrufvolumen harte Randbedingungen, ist der Listenpreis von GPT-6 Luna deutlich niedriger, sodass es sich als Standardstufe empfiehlt. Bei hochkomplexen Aufgaben wie mehrstufiger Automatisierung liegt Qwen4-Max bei einigen Teilwerten von Artificial Analysis deutlich vorn und kann als Kandidat für hochkomplexes Routing dienen. Welche Stufe letztlich zum Einsatz kommt, hängt von der Abnahmequote und den Kosten pro bestandener Aufgabe in Ihrem eigenen Aufgaben-Set ab.
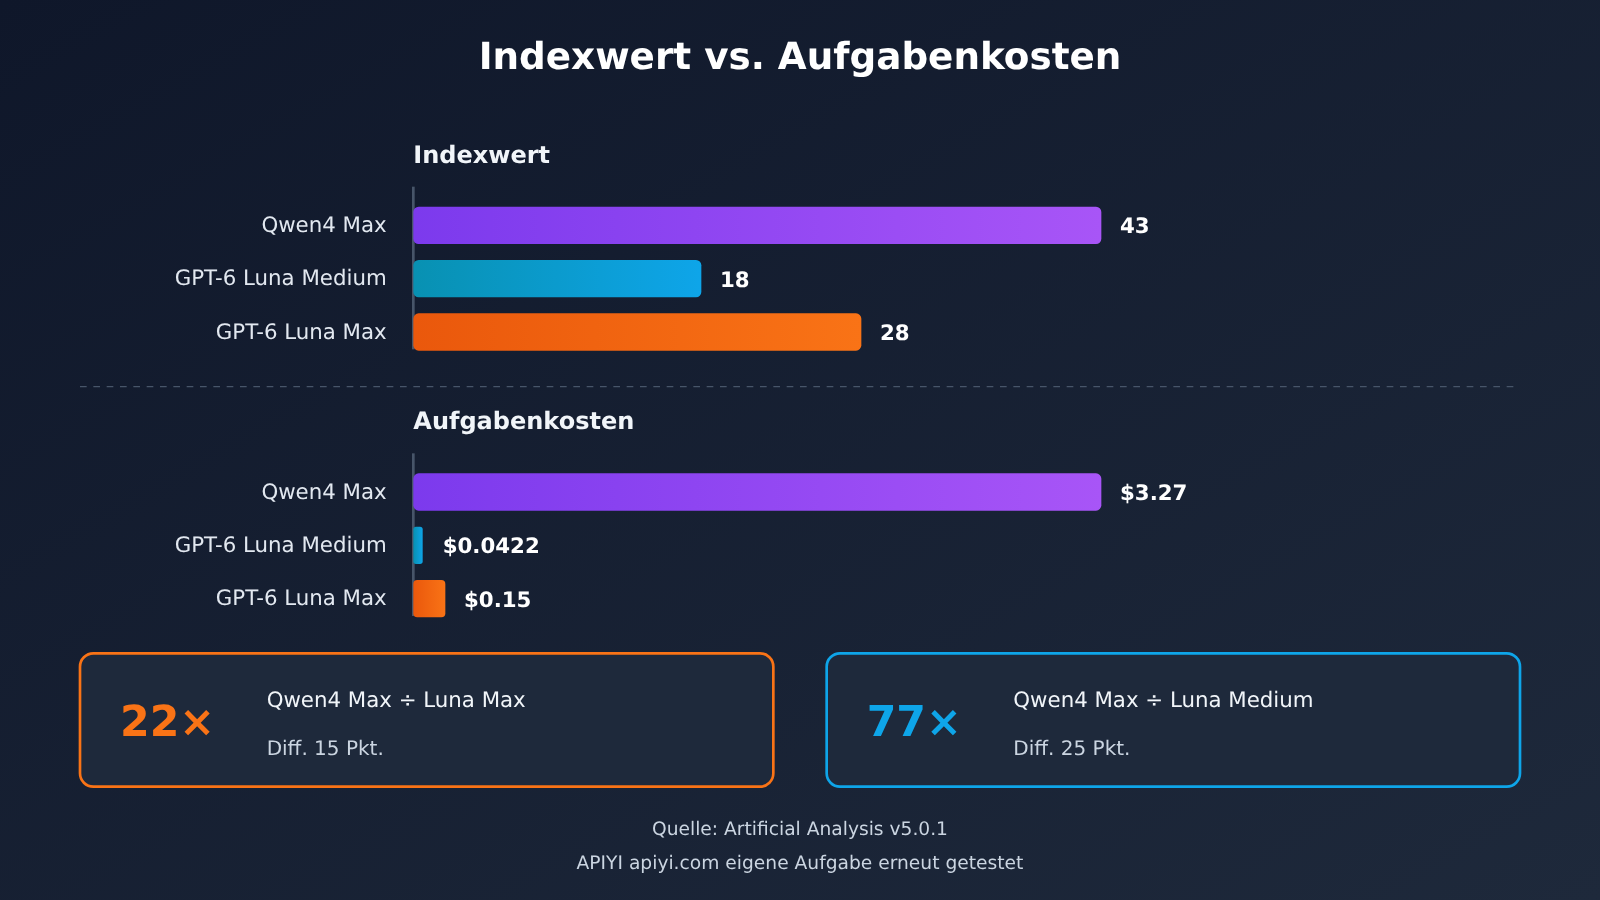
Die Schlussfolgerung ändert sich unter drei Bedingungen. Erstens: Je nachdem, welche Reasoning-Stufe bei Luna gewählt wird, kann der Abstand bei Indexwert und Aufgabenkosten von etwa dem 22-Fachen auf etwa das 77-Fache wachsen. Zweitens: Sobald die Eingabe 272.000 Token überschreitet, wird bei Luna nach OpenAI-Listenpreis die gesamte Anfrage in eine höhere Tarifstufe verschoben. Drittens: Bei einer konkreten Aufgabe kann der Unterschied in einem Teilwert sehr klein ausfallen – bei FrontierCode-AA 2.0 liegen beide beispielsweise nur 1,3 Prozentpunkte auseinander.
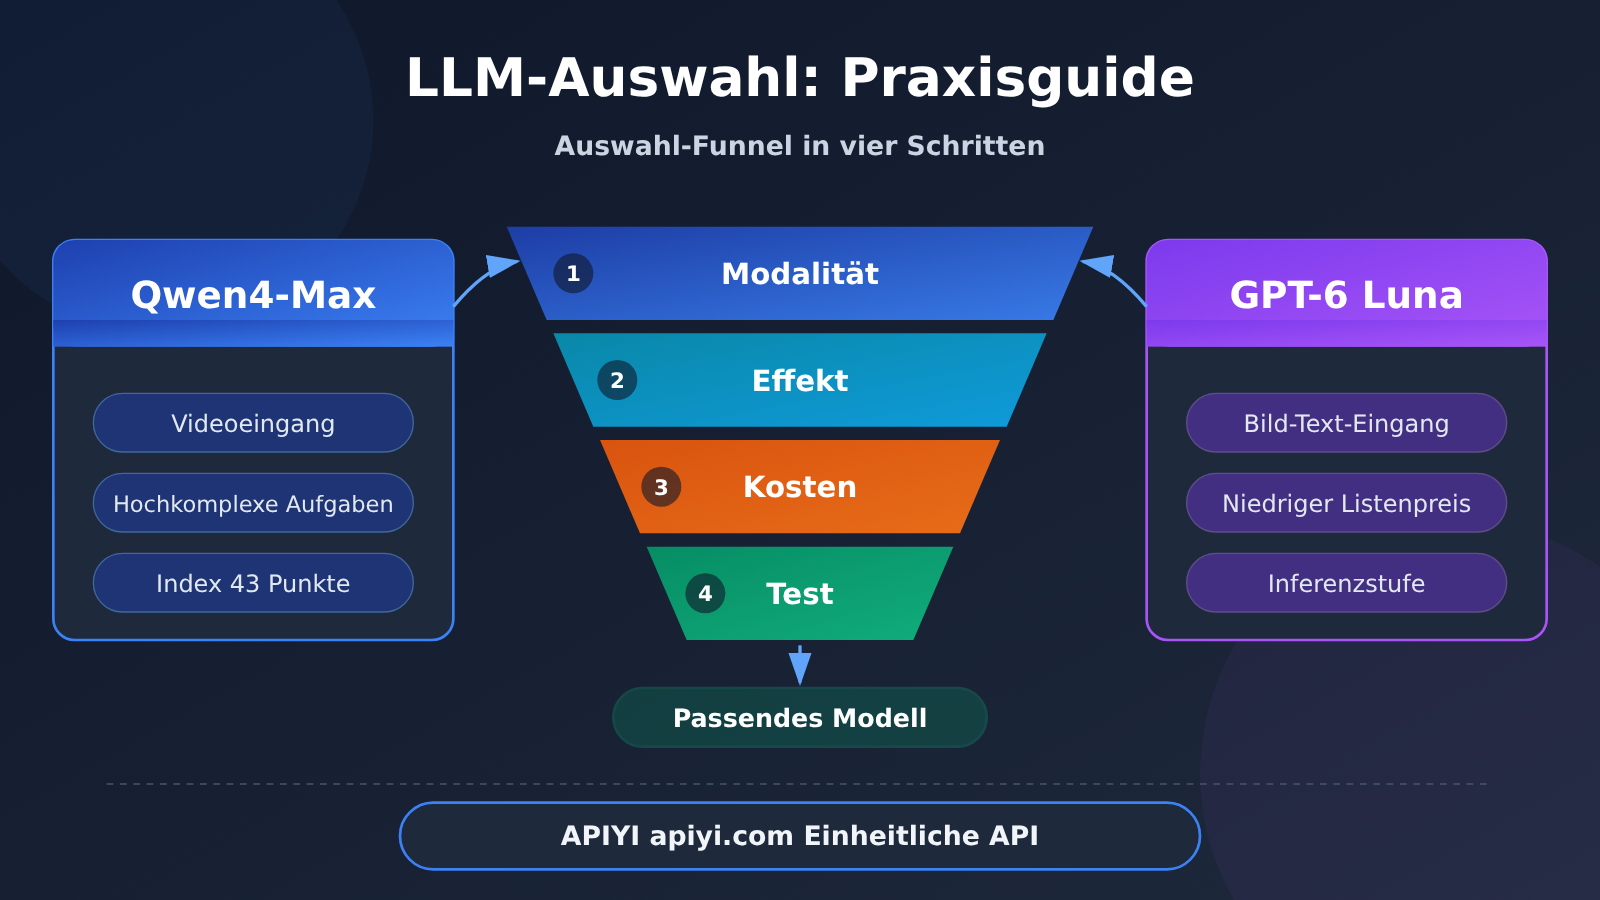
Kurzüberblick zum Vergleich großer Sprachmodelle: Qwen4-Max vs. GPT-6 Luna
Die folgende Tabelle listet nur die Dimensionen auf, die für die Auswahl relevant sind. Die Punktzahlen stammen aus dem Intelligence Index v5.0.1 von Artificial Analysis, die Preise aus öffentlich ausgewiesenen Herstellerpreisen oder dem APIYI-Katalog. Alle Angaben sind öffentliche Informationen mit Stand 2026-11-20 und keine von uns bezahlten Praxistests.
| Vergleichsdimension | Qwen4-Max | GPT-6 Luna | Was der Unterschied bedeutet |
|---|---|---|---|
| Eingabemodalität (Hersteller-Modellkarte) | Text, Bild, Video | Text, Bild | Videoaufgaben schließen Luna direkt aus |
| Ausgabemodalität | Text | Text | Beide erzeugen weder Bilder noch Sprache |
| Intelligence Index v5.0.1 | 43 Punkte | Medium-Stufe 18 Punkte; Max-Stufe 28 Punkte | Unterschiedliche Stufen, unterschiedliche Abstände |
| Kosten pro Index-Aufgabe | $3.27 | Medium-Stufe $0.0422; Max-Stufe $0.15 | Gilt nur für diese Index-Workload |
| Herstellerpreis (pro Million Token, kurzer Kontext) | Alibaba Cloud Singapur: Eingabe $1.50, Ausgabe $4.50 | OpenAI Standard: Eingabe $0.10, Ausgabe $0.50 | Eingabe etwa 15:1, Ausgabe 9:1 |
| Bepreisung langer Eingaben | Drittanbieterquellen nennen einen einheitlichen Tarif für das gesamte Kontextfenster | Ab 272.000 Token wird die gesamte Anfrage in eine höhere Stufe eingestuft | Bei langen Dokumenten separat kalkulieren |
| APIYI-Katalog-Endpunkte | chat, responses, messages | Chat Completions, Responses | Die Wahl des Protokolls beeinflusst die Migrationskosten |
| Verfügbare Plattformen | APIYI apiyi.com, Alibaba Cloud Model Studio u. a. | APIYI apiyi.com, OpenAI offiziell u. a. | Derselbe API-Schlüssel erleichtert abwechselnde Vergleichstests |
Der Hauptteil folgt der Reihenfolge, in der die Auswahlentscheidung von den jeweiligen Faktoren abhängt. Abschnitt 1 klärt zuerst, ob eine Integration möglich ist. Denn wenn Modalität oder Endpunkt nicht passen, sind die späteren Punktzahlen und Preise bedeutungslos. Abschnitt 2 vergleicht die Leistung unter demselben Benchmark, Abschnitt 3 zerlegt bei identischem Nutzungsvolumen den Herstellerpreis, den Katalogpreis und den tatsächlich im Konto abgerechneten Betrag, und Abschnitt 4 macht aus den bisherigen Einschätzungen Schritte, die sich im eigenen Geschäft nachprüfen lassen. Wer nur die Kosten im Blick hat, kann direkt zu Abschnitt 3 springen – sollte aber vorher einen Blick auf die Ausschlusskriterien in Abschnitt 1 werfen.
Begriffe, die man vor der Auswahl eines großen Sprachmodells kennen sollte (To Know)
| Begriff | Bedeutung in diesem Artikel |
|---|---|
| Intelligence Index | Der von Artificial Analysis unter einer bestimmten Version zusammengefasste Score über die Leistung in mehreren Aufgaben; in diesem Artikel wird v5.0.1 verwendet |
| Kosten pro Index-Aufgabe | Die geschätzten Aufwendungen, um eine Aufgabe in diesem Benchmark vollständig durchlaufen zu lassen; sowohl die Reasoning-Stufe als auch die Input- und Output-Menge verändern das Ergebnis |
| Reasoning-Stufe | Steuert die Intensität des Denkaufwands, den das Modell investiert, z. B. Medium und Max bei Luna; beim Vergleich muss diese Stufe immer angegeben werden |
| Eingabemodalität | Die Art der Inhalte, die das Modell entgegennimmt, z. B. Text, Bild oder Video |
| Stufenpreis ab Kontextlänge | Überschreitet die Eingabe einen bestimmten Schwellenwert, wird nach einem anderen Tarif abgerechnet; es ist zu prüfen, ob nur der überschreitende Teil oder die gesamte Anfrage so berechnet wird |
| Cache-Lesen | Ein Abrechnungsposten für wiederverwendete Eingaben; sollte anhand der Preistabelle und der tatsächlich erfassten Treffer gezählt werden |
| Latenz bis zum ersten sichtbaren Antwort-Token | Die Zeit vom Absenden der Anfrage bis zum Erscheinen des ersten nutzbaren Antwortabschnitts; bei Reasoning-Modellen muss man das vom „ersten Event“ unterscheiden |
| P50 / P95 | Median und 95. Perzentil der Latenzverteilung; sie zeigen den typischen Wert bzw. die langsamen Anfragen |
| Kosten pro bestandener Aufgabe | Die Kosten für Fehlschläge, Nachprüfungen und Wiederholungen werden auf jedes tatsächlich bestandene Ergebnis umgelegt |
1. Erster Schritt bei der Auswahl großer Sprachmodelle: Unpassende Kombinationen anhand der Aufgabenanforderungen aussortieren
Bei der Modellauswahl spart man am meisten, wenn man zuerst aussortiert. Ein Modell mag noch so gute Bewertungen haben – wenn es nicht zu deinen Eingabetypen oder deinem Aufrufprotokoll passt, bleibt nur, es zu verwerfen. Umgekehrt braucht man bei einem günstigen Modell, das die harten Anforderungen nicht erfüllt, später gar nicht erst die Kosten zu berechnen.
1.1 Eingabemodalitäten anhand der Modellkarten unterscheiden
Die Modellkarten von Alibaba Cloud Model Studio listen für Qwen4-Max Text-, Bild- und Videoeingaben sowie Textausgaben auf. Die Modellkarte von OpenAI listet für GPT-6 Luna Text- und Bildeingaben sowie Textausgaben auf; die Zusammenfassung von OrcaRouter erwähnt zudem, dass Luna keine Bilderzeugung, Sprachgenerierung, Transkription oder Übersetzung unterstützt. Das ist der härteste Unterschied zwischen beiden und entscheidet, dass für Videoaufgaben nur Qwen4-Max als Kandidat übrig bleibt.
Zu beachten ist: Die Modellkarten der Anbieter beschreiben die Fähigkeiten des Modells selbst. Ob Videoparameter bei einem bestimmten Anbieter oder Endpunkt tatsächlich übergeben werden können, muss separat geprüft werden.
Die Modellseite von Together AI listet beispielsweise ausdrücklich Text- und Bildeingaben auf, aber für dieselbe Route ließ sich keine Beschreibung für Video finden. In diesem Fall darf man nur schreiben: „Together listet Text und Bild ausdrücklich auf“, und nicht daraus schließen, dass Video unterstützt wird.
1.2 IDs, Gruppen und Endpunkte im APIYI-Katalog abgleichen
APIYI kündigte am 17. November 2026 die Verfügbarkeit von qwen4-max an; das am 20. November 2026 erzeugte öffentliche Modellregister führt als Endpunkte chat, responses und messages sowie die Gruppen ClaudeCode, CodexResponses, default und svip. In der Preistabelle ist gpt-6-luna mit den Gruppen Default und SVIP sowie Einträgen für Chat Completions und Responses aufgeführt. Die frühere Aussage im Blog, „Qwen4-Max ist noch nicht gelistet“, sollte man anhand der neuesten Ankündigung und des Registers überprüfen – maßgeblich sind diese.
Der Katalog belegt nur, dass die Plattform das Modell und den Endpunkt unterstützt. Die Gruppe, in der sich das Konto befindet, und die Berechtigungen des Tokens beeinflussen, ob du tatsächlich aufrufen kannst. Nach dem Erstellen eines Tokens in der APIYI-Konsole unter apiyi.com solltest du zunächst mit einer minimalen Anfrage prüfen, ob die genaue Modell-ID und der Endpunkt verfügbar sind, und erst dann mit dem Ergebnisvergleich beginnen.
1.3 Unverhandelbare Einschränkungen in den drei Szenarien
| Szenario | Unverhandelbare Einschränkung | Ausschlussergebnis | Nächster Schwerpunkt |
|---|---|---|---|
| Textaufzeichnungen aufbereiten (Meeting-Protokolle, Ticket-Archivierung) | Stabiles Ausgabeformat, niedrige Kosten pro Aufruf, hohes Aufrufvolumen | Beide bleiben im Rennen | Quote formatkonformer Ausgaben und Stückkosten vergleichen |
| Videoverständnis (Qualitätsprüfung von Bildschirmaufnahmen, Videozusammenfassungen) | Muss Videoeingaben akzeptieren | GPT-6 Luna nach Modellkarte ausgeschlossen | Prüfen, ob Endpunkt und Token Videoparameter unterstützen |
| Komplexe Workflows (mehrstufige Automatisierung, systemübergreifende Vorgänge) | Hohe Erfolgsrate bei mehrstufiger Ausführung, hohe Fehlerkosten | Beide bleiben im Rennen | Erfolgsquote bei Abnahmetests statt Stückpreis in den Fokus rücken |
Das Aufbereiten von Textaufzeichnungen ist ein typisches kostensensibles Szenario. Die Aufgabe selbst ist nicht schwierig; entscheidend sind die durchschnittlichen Kosten pro Ergebnis bei hohem Aufrufvolumen. Videoverständnis ist dagegen eine Frage der Fähigkeitshürde: Passt die Modalität nicht, gibt es nichts zu vergleichen. Fehler in komplexen Workflows bedeuten oft manuelle Nacharbeit; scheitert ein günstigeres Modell ein paar Mal mehr, können die tatsächlichen Kosten sogar höher ausfallen. Das rechnen wir in den Abschnitten 3 und 4 konkret durch.
2. Zweiter Schritt der Modellauswahl: Nutzen auf derselben Benchmark vergleichen
Schauen Sie sich die Ergebnisse erst an, nachdem die Kandidaten ausgesiebt sind. Verwenden Sie dafür ausschließlich Daten aus derselben Vergleichsansicht von Artificial Analysis – denn verschiedene Ranglisten nutzen unterschiedliche Aufgabensets und Bewertungsmethoden, sodass eine gemeinsame Rangfolge über sie hinweg keine Aussagekraft hat.
2.1 Gesamtwert und Aufgabenkosten immer zusammen mit der Stufe lesen
| Konfiguration | Intelligence Index v5.0.1 | Kosten pro Index-Aufgabe | Kostenfaktor relativ zu Qwen4-Max |
|---|---|---|---|
| Qwen4 Max | 43 | $3.27 | 1 |
| GPT-6 Luna (Medium, Standardstufe) | 18 | $0.0422 | ca. 1/77 |
| GPT-6 Luna (Max-Stufe) | 28 | $0.15 | ca. 1/22 |
Die oft zitierte „rund 22-fach“ stammt aus $3.27 ÷ $0.15 und vergleicht Qwen4 Max mit der Max-Stufe von Luna, wobei der Punkteabstand 15 Punkte beträgt. Vergleicht man stattdessen die standardmäßige Medium-Stufe von Luna, liegt der Kostenfaktor bei rund 77-fach, der Punkteabstand bei 25 Punkten. Die Aussage „22-mal teurer“ ist also für sich genommen unvollständig – man muss immer dazusagen, um welche Stufe und welche Art von Arbeitslast es geht.
Ein weiterer Punkt ist die Vollständigkeit der Daten. OrcaRouter weist darauf hin, dass die Rangliste für Qwen4-Max nur einen einzigen Wert veröffentlicht hat, ohne Daten zu den einzelnen Stufen; bei Luna ist die komplette Stufenleiter öffentlich. Bei der Kostenschätzung zeigt eine vollständige Leiter den Knickpunkt, an dem „nach dem Hochschalten der Stufe der Wert noch steigt oder nicht“ – solche Informationen sind manchmal nützlicher als ein einzelner höherer Wert.
2.2 Die Unterschiede in den Einzelkategorien variieren je nach Aufgabe
Ein Gesamtindex kann den Nutzen für eine bestimmte Aufgabe nicht vorhersagen. Auf AutomationBench-AA liegt Qwen4 Max bei 72.6% und Luna Max bei 53.2%, also rund 19 Prozentpunkte Unterschied; auf FrontierCode-AA 2.0 liegen beide bei 26.5% bzw. 25.2%, nur 1.3 Prozentpunkte auseinander.
Betrachtet man das im Kontext der Szenarien aus Abschnitt 1, ähneln komplexe Abläufe eher mehrstufigen Automatisierungsaufgaben wie bei AutomationBench, wo der Vorsprung von Qwen4-Max sich in weniger Nacharbeit niederschlagen dürfte. Geht Ihre Aufgabe eher in Richtung FrontierCode, ist der Abstand gering, während der Preisunterschied weiterhin groß bleibt – dann ist Luna klar die bessere Wahl beim Preis-Leistungs-Verhältnis. Das ist nur eine Einschätzung der Richtung; konkret müssen Sie es auf Ihrem eigenen Aufgabenset verifizieren.
3. Dritter Schritt der Modellauswahl: Herstellerpreise, Katalogpreise und Kontokosten getrennt kalkulieren
Bei den Kosten gerät am schnellsten alles durcheinander. Dieser Abschnitt ist in drei Ebenen gegliedert: die öffentlich ausgewiesenen Herstellerpreise, den Katalogpreis von APIYI und den Betrag, den das Konto nach der Aufladung inklusive Bonusguthaben tatsächlich zahlt. Die drei gehören unterschiedlichen Ebenen an und lassen sich nicht gegeneinander austauschen.
3.1 Rechenbeispiel für einen Herstellerpreis bei derselben Anfrage mit langem Input
Nehmen wir an, eine Anfrage hat 400.000 Token Input und 8.000 Token abgerechneten Output, ohne Cache-Treffer und ohne zusätzliche Tool-Kosten.
| Position | Qwen4-Max (Alibaba Cloud International, Standardpreis Singapur) | GPT-6 Luna (OpenAI-Standardpreis, langer Input) |
|---|---|---|
| Input-Tarif | $1.50 / Million | $0.20 / Million (ab 272.000 wird die gesamte Anfrage in die höhere Stufe eingestuft) |
| Output-Tarif | $4.50 / Million | $0.75 / Million |
| Berechnung | 0.4 × 1.50 + 0.008 × 4.50 | 0.4 × 0.20 + 0.008 × 0.75 |
| Kosten pro Anfrage | $0.636 | $0.086 |
Das Verhältnis liegt bei etwa 7.40 – also nur noch halb so groß wie der Faktor 15 zu 1 bei den Input-Preisen im kurzen Kontext. Der Grund dafür ist Lunas Stufenregel. Nach OpenAIs Preisliste gilt die Stufe für langen Input für die gesamte Anfrage und nicht nur für den übersteigenden Teil: Bei einer Eingabeaufforderung von 300.000 Token werden alle 300.000 zum hohen Tarif abgerechnet, nicht nur die letzten 28.000. Die Übersicht von OrcaRouter besagt, dass Qwen4-Max über das gesamte Millionen-Fenster hinweg zum gleichen Tarif abgerechnet wird, ohne 32K- oder 128K-Stufen.
Herstellerpreise ändern sich außerdem je nach Region und Kanal. OrcaRouter listet Qwen4-Max in der Region Global mit $1.413 für den Input und $4.24 für den Output – anders als in Singapur. Die offizielle Pricing-Seite von Together AI führt Qwen4 Max als Aktion mit einem befristeten Preis von $1.05 für den Input, $3.15 für den Output und $0.0525 für Cache-Lesezugriffe; das entspricht genau 70 % des Singapur-Preises. Die Seite nennt als Gültigkeit den 2026-11-23, gibt aber keine Zeitzone an. Die Detailseite des Modells zeigt dagegen eine andere Staffel: $1.43, $4.28, $0.0713. Wenn man solche Preise zitiert, sollte man immer Quellseite und Datum angeben; maßgeblich für die Abrechnung ist der tatsächliche Verbrauch des Kontos.
3.2 Katalogpreise von APIYI auf Basis von Katalogtarifen und Nutzungsprotokollen
Im APIYI-Katalog kostet qwen4-max pro Million Token $1.50 für Input, $4.50 für Output und $0.075 für Cache-Lesen; gpt-6-luna kostet bei kurzem Kontext $0.10 für Input, $0.50 für Output und $0.01 für Cache-Lesen. Die Preistabelle weist darauf hin, dass der Input-Preis auf $0.20 steigt, wenn der Input 272,000 Token überschreitet.
Für dieselbe Anfrage aus 3.1 ergibt sich bei qwen4-max nach Katalogpreisen ebenfalls $0.636. Bei gpt-6-luna beträgt der Input-Anteil 0.4 × 0.20 = $0.08; die in dieser Prüfrunde verwendete Preistabelle nennt nur die Input-Preiserhöhung. Welcher Tarif für den Output bei langem Kontext gilt, entnehmen Sie bitte der aktuellen Preistabelle und dem Nutzungsprotokoll. Die tatsächlichen Kosten sollten aus dem Nutzungsprotokoll in Ihrem Konto stammen, nicht aus den obigen Formeln.
💰 Tipp zur Kostenkalkulation: Rufen Sie beide Modelle unter demselben Konto bei APIYI apiyi.com auf. Das Nutzungsprotokoll zeichnet für jede Anfrage Input-, Output- und Cache-Token auf und kommt der tatsächlichen Rechnung näher als eine Schätzung anhand öffentlicher Listenpreise.
3.3 Der Aufladebonus beeinflusst die Umrechnung des eingesetzten Kapitals, nicht den Stückpreis des Modells
Die aktuelle FAQ von APIYI nennt folgende Staffel für Einzelaufladungen: $100 bis unter $500 erhalten 10 % Bonus, $500 bis unter $1,000 erhalten 12 %, $1,000 bis unter $3,000 erhalten 15 %, ab $3,000 20 %. Online-Aufladungen und Aufladungen für Geschäftskunden sind teilnahmeberechtigt; der Bonus wird automatisch gutgeschrieben. Ob er mit einer separat vereinbarten Preisregelung des Vertriebs kombiniert werden kann, ist gesondert zu klären. Normale Nutzer erhalten bei der ersten Aufladung zusätzlich $1, per Schul-E-Mail verifizierte Bildungsnutzer $2; die Gutschrift erfolgt über den Kundenservice. Für das aufgeladene Guthaben gilt die in der Dokumentation beschriebene 365-Tage-Regel.
| Aufladestufe | Guthaben nach Gutschrift | Aufgeladenes Kapital je $1 Protokollguthaben | Senkung der Kapitalkosten |
|---|---|---|---|
| Einzelaufladung $100 | $110 | ca. $0.909 | ca. 9.09% |
| Einzelaufladung ab $3,000 | Aufladebetrag × 1.2 | ca. $0.833 | ca. 16.67% |
Dabei wird vorausgesetzt, dass das gesamte Bonusguthaben verbraucht wird. Bei der 10-%-Stufe entsprechen die einmaligen Protokollkosten von $0.636 aus 3.1 etwa $0.578 an aufgeladenem Kapital. Beachten Sie, dass der Bonus einheitlich für das gesamte Plattformguthaben gilt. Er senkt das eingesetzte Kapital, das jedem $1 Protokollguthaben entspricht, und darf nicht als zusätzliche Preissenkung für ein einzelnes Modell verstanden werden. Beim Vergleich für die Auswahl sollten beide Seiten denselben Umrechnungsfaktor verwenden, sonst wird der Vergleich verfälscht.
4. Vierter Schritt der Auswahl großer Sprachmodelle: Bedingungen als vergleichbare Messschritte formulieren
Die ersten drei Abschnitte stützen sich ausschließlich auf öffentlich zugängliche Informationen. Was wirklich darüber entscheidet, welches Modell Sie wählen, sind die Erfolgsquote, die Latenz und die Kosten Ihrer eigenen Aufgabe unter identischen Bedingungen. Derzeit liegen uns keine Daten zu Erfolgsquote, Latenz und Abrechnung für zwei Modelle mit derselben Aufgabe und derselben Gruppe auf der APIYI-Plattform vor. Im Folgenden beschreiben wir daher ein Vergleichstest-Verfahren, das Sie selbst durchführen können.
4.1 Kontrollvariablen und zu protokollierende Felder
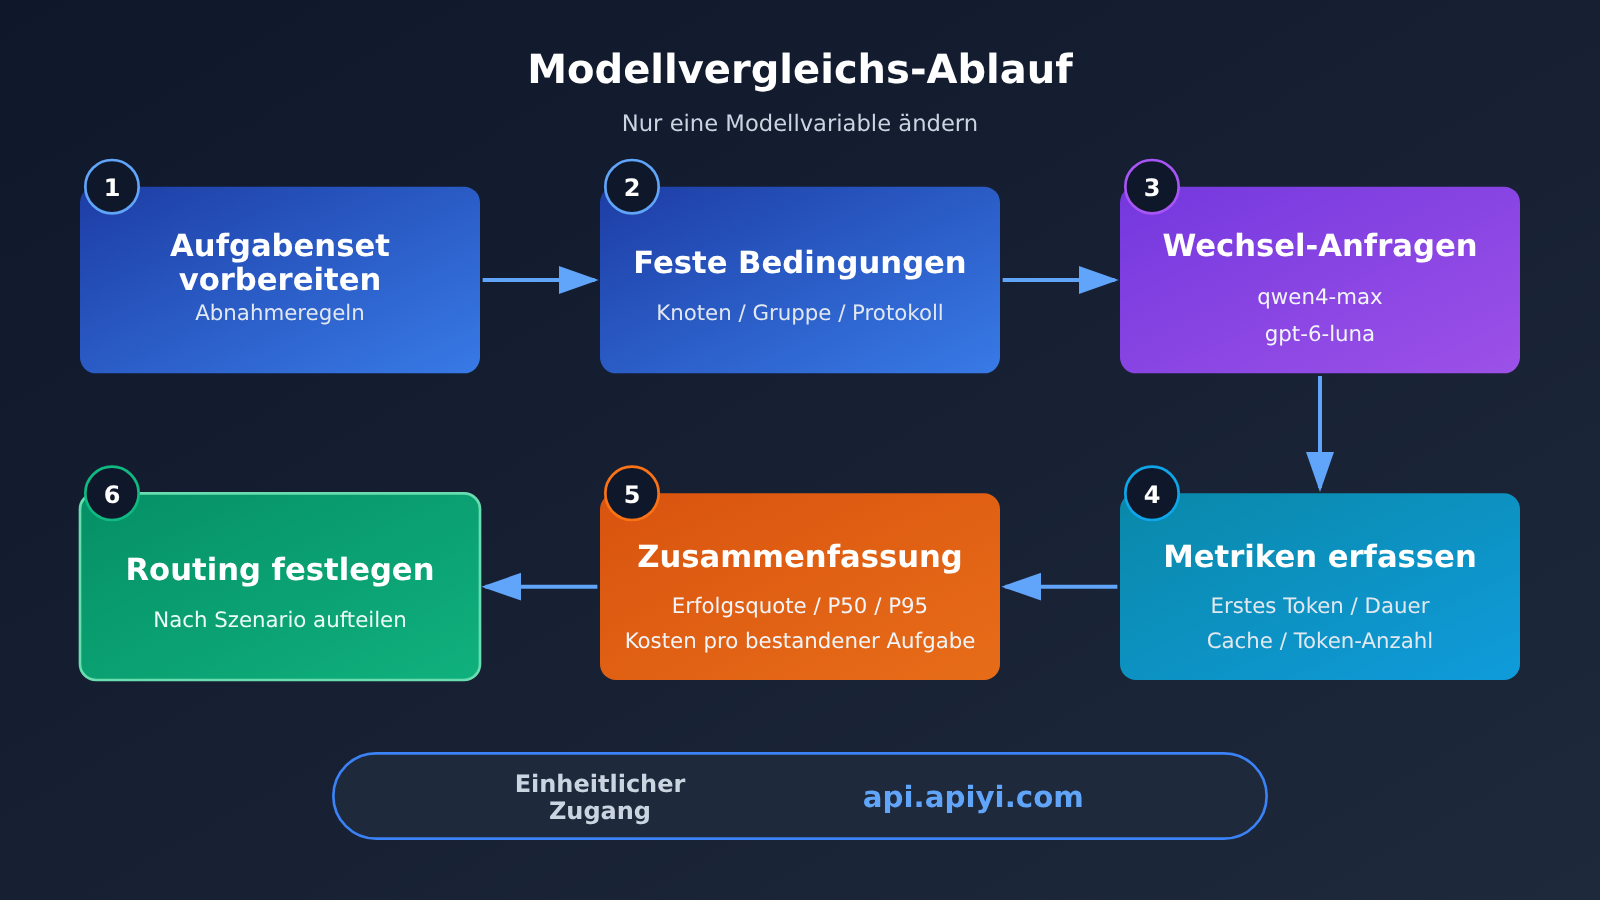
Beim Vergleichstest sollte nach Möglichkeit nur die eine Variable „Modell“ variieren. Konkret gehen Sie so vor: gleicher Festland-Knoten und gleicher Netzbetreiber, gleiche APIYI-Gruppe und gleiches Protokoll, dasselbe Eingabeset und dieselbe Ausgabegrenze – und bei identischer Parallelität abwechselnd Anfragen an beide Modelle senden. So vermeiden Sie eine zeitliche Verzerrung, die entsteht, wenn Sie erst das eine und dann das andere Modell komplett durchlaufen lassen.
| Protokollfeld | Zweck |
|---|---|
| Abnahme bestanden (Ja/Nein) | Berechnung der Erfolgsquote und der Kosten pro bestandener Aufgabe |
| HTTP-Status, Request-ID | Fehlersuche, Abgleich mit den Nutzungsprotokollen |
| Latenz bis zum ersten sichtbaren Antwort-Token | Misst die Interaktionserfahrung; bei Reasoning-Modellen getrennt vom ersten Event zu erfassen |
| Gesamtdauer | Misst den Batch-Durchsatz |
| Kalt-/Warmverbindung, Cache-Treffer | Erklärt Schwankungen bei Latenz und Kosten |
| Anzahl Eingabe- und Ausgabe-Token | Abgleich des tatsächlich abgerechneten Verbrauchs |
Die Zeiten für DNS, TCP und TLS sollten am besten separat protokolliert werden. Im Bericht geben Sie Stichprobenumfang, Erfolgsquote, P50 und P95 klar an; für öffentliche Vergleiche können Sie die Definitionen von Erfolgsquote, Latenz bis zum ersten Token und Durchsatz aus dem Bericht der China Academy of Information and Communications Technology (CAICT) heranziehen.
4.2 Minimales Skript für den alternierenden Vergleichstest
Das folgende Skript ruft über die OpenAI-kompatible Schnittstelle abwechselnd zwei Modelle auf und misst mit Streaming-Ausgabe das erste sichtbare Antwort-Token sowie die Gesamtdauer. Die Abnahmefunktion müssen Sie durch Ihre eigene Aufgabe ersetzen; falls Sie die Reasoning-Stufe festlegen möchten, prüfen Sie bitte zunächst in der APIYI-Dokumentation den genauen Parameternamen, fügen ihn dann hinzu und vermerken dies in Ihren Aufzeichnungen.
import time, statistics, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle, beide Modelle nutzen denselben Key
)

MODELS = ["qwen4-max", "gpt-6-luna"]
TASKS = ["把下面的会议记录整理成 JSON:...", "..."]  # Durch Ihre eigene Aufgabensammlung ersetzen

def passed(task, answer):
    return answer.strip().startswith("{")  # Durch die tatsächlichen Abnahmeregeln ersetzen

records = {m: [] for m in MODELS}
for task in TASKS:
    for model in MODELS:  # Abwechselnde Anfragen, um zeitliche Abweichungen zu verringern
        start, first = time.perf_counter(), None
        text = ""
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": task}],
            max_tokens=2000,  # Beide Modelle verwenden dasselbe Ausgabelimit
            stream=True,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                if first is None:
                    first = time.perf_counter() - start  # Erstes sichtbares Antwort-Token
                text += chunk.choices[0].delta.content
        total = time.perf_counter() - start
        records[model].append({"ok": passed(task, text), "ttft": first, "total": total})

for m, rs in records.items():
    ttfts = sorted(r["ttft"] for r in rs if r["ttft"] is not None)
    n = len(rs)
    print(m, "样本", n, "通过率", sum(r["ok"] for r in rs) / n,
          "首字P50", statistics.median(ttfts) if ttfts else None,
          "首字P95", ttfts[int(0.95 * (len(ttfts) - 1))] if ttfts else None)
Für Token-Verbrauch und Kosten empfiehlt es sich, die Werte direkt aus dem Nutzungsprotokoll der Plattform nach Anfrage-ID zu aggregieren und anschließend in die folgende Formel einzusetzen.
4.3 Kosten pro bestandener Aufgabe und abgestuftes Routing
Kosten pro bestandener Aufgabe = sämtliche Aufrufkosten (einschließlich fehlgeschlagener Aufrufe und Wiederholungen) + Kosten für manuelle Nachprüfung und Nacharbeit, geteilt durch die Anzahl der Aufgaben, die die Abnahme am Ende bestehen. Hat ein Modell mit niedrigerem Stückpreis eine niedrigere Bestehensquote, wird der Nenner kleiner und der Zähler größer – dann können die Kosten pro bestandener Aufgabe trotzdem höher liegen als bei einem Modell mit höherem Stückpreis. Umgekehrt: Sind die Bestehensquoten ähnlich, schlägt der Preisunterschied fast unverändert auf das Ergebnis durch.
Daraus lässt sich ein Routing nach Aufgabenkomplexität ableiten: Standardaufgaben laufen standardmäßig über gpt-6-luna, hochkomplexe Aufgaben oder Videoaufgaben über qwen4-max. Ob eine Route aktiviert wird, hängt zuerst davon ab, ob ihre Bestehensquote bei der Abnahme im jeweiligen Aufgabensatz den Zielwert erreicht; erst danach zählen die Kosten pro bestandener Aufgabe. Da beide Modelle über dieselbe OpenAI-kompatible Schnittstelle von APIYI apiyi.com laufen, müssen Sie für einen Routenwechsel nur das Feld model ändern.
🎯 Tipp zum Vergleichstest: Neue Nutzer können zunächst mit dem Registrierungs-Testguthaben, das auf der Schnellstartseite von APIYI apiyi.com aufgeführt ist, das Skript zum Laufen bringen und danach je nach Umfang ihres Aufgabensatzes Guthaben aufladen, um den eigentlichen Vergleichstest durchzuführen.
4.4 Endpunkt-Sondierungen zeigen nur die Grenzen der Messung
Die öffentlich einsehbare Monitoring-Tabelle von Lingjian AI hat die APIYI-Domain über Nodes in Festlandchina abgetastet. Drei HTTP-200-Einträge vom 5. bis 6. November 2026 wiesen Laufzeiten von 429, 569 und 565 ms auf. Solche Sondierungen sagen nur etwas über die Erreichbarkeit des Endpunkts aus; auf der Seite werden zudem einige HTTP-404-Antworten als normal gewertet, und weder die Anfrage-Payload noch das Authentifizierungsverfahren werden erläutert. Daher lassen sich daraus weder die Generierungslatenz noch die Erfolgsquote des Modells ableiten. Die Time-to-First-Token-Messung von Artificial Analysis bezieht sich ebenfalls nur auf deren eigene Testumgebung; Ergebnisse unter Ihren Netzwerk- und Parallelitätsbedingungen müssen mit der Methode aus 4.1 separat gemessen werden.
Zurück zur Frage aus der Überschrift: Videoeingabe ist eine harte Hürde – nur Qwen4-Max erfüllt sie. Bei reinen Text- und Text-Bild-Aufgaben ist der Preisvorteil von GPT-6 Luna bei kurzem Kontext am größten und schrumpft, sobald die Eingabe 272.000 Token überschreitet. Bei hochkomplexen mehrstufigen Aufgaben kann der Vorsprung von Qwen4-Max in den Einzelkategorien den Stückpreisunterschied wettmachen. Alle drei Schlussfolgerungen hängen von der Tarifstufe, der Eingabelänge und dem Aufgabentyp ab; maßgeblich sind letztlich die Kosten pro bestandener Aufgabe in Ihrem eigenen Aufgabensatz. Wenn Sie für abwechselnde Vergleichstests einen einheitlichen Endpunkt benötigen, können Sie über APIYI apiyi.com mit einem API-Schlüssel beide Modelle gleichzeitig aufrufen.
Referenzen
- Artificial Analysis – Veröffentlichungsvergleich Qwen4 Max vs. GPT-6 Luna: Intelligence Index v5.0.1 und Daten der Einzelkategorien
- Link:
artificialanalysis.ai/zh/models/comparisons/qwen4-max-vs-gpt-6-luna
- Link:
- Alibaba Cloud Model Studio – Modellkarte und Preisliste für Qwen4-Max: Eingabemodalitäten und Standardpreise für Singapur
- Link:
alibabacloud.com/help/en/model-studio/model-pricing
- Link:
- OpenAI – GPT-6 Luna Model: Eingabemodalitäten und Preisgestaltung für lange Kontextfenster
- Link:
developers.openai.com/api/docs/models/gpt-6-luna
- Link:
- OrcaRouter – Qwen4-Max vs GPT-6 Luna: Preisverhältnis pro Einheit, Erläuterung zum Tarifsprung bei 272.000 Token
- Link:
orcarouter.ai/blog/qwen-4-max-vs-gpt-6-luna
- Link:
- Together AI – Pricing: zeitlich begrenzter Aktionspreis für Qwen4 Max
- Link:
together.ai/pricing
- Link:
- APIYI – Modellpreis-Übersicht, Modellregister und FAQ zur Aufladeaktion: Listenpreise, Endpunkt-Gruppen und Bonusstufen
- Link:
docs.apiyi.com/models
- Link:
- CAICT (Chinesische Akademie für Informations- und Kommunikationstechnologie) u. a. – Bericht zur Leistungsüberwachung von Token-Diensten großer Sprachmodelle (2026): Erfolgsrate, Latenz bis zum ersten Token, Definition des Durchsatzes
- Link:
caict.ac.cn
- Link:
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI unter apiyi.com – weitere Integrationsunterlagen finden Sie im Dokumentationszentrum unter docs.apiyi.com


