
Zusammenfassung: Dieser Artikel beantwortet eine Frage: Kann GPT-6.2 Sol die Datenfragen von Front-Office-Nutzern tatsächlich beantworten – und welche Fragen müssen trotzdem noch einmal nachgeprüft werden?
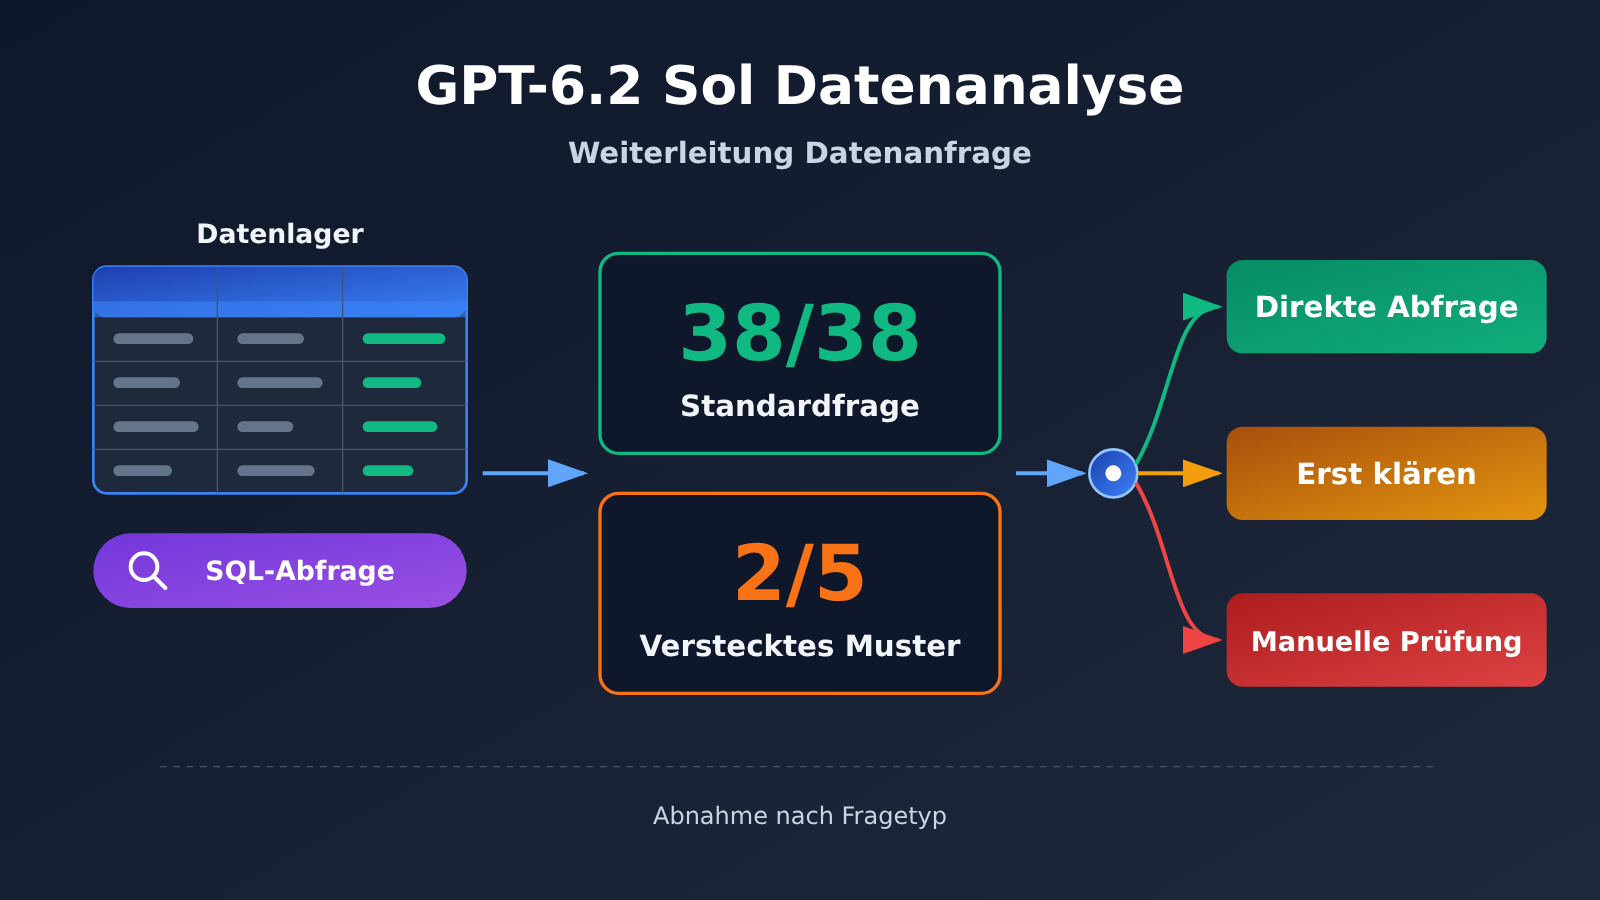
Die Leistung von GPT-6.2 Sol in der Datenanalyse lässt sich in zwei Teile aufteilen. In dem einmaligen Single-Turn-Spezialtest, den Plotly am 17. November 2026 veröffentlicht hat, hat es in fünf Kategorien – Routineanalyse, Erkennung von Mehrdeutigkeiten, nicht beantwortbare Datenfragen, Datenqualität und statistische Fallstricke – alle 38 Aufgaben richtig beantwortet, mit einer medianen Bearbeitungszeit von etwa 10,5 Sekunden pro Aufgabe. Im selben Testdurchlauf hat es von 5 Aufgaben mit versteckten Mustern nur 2 bestanden.
Daraus lässt sich folgern: Bei summarischen Datenfragen mit klarer Kennzahlendefinition und geringem Auswirkungsradius kann man testweise Sol mit Nur-Lese-Rechten direkt antworten lassen; fehlt die Definition, sollte man Sol zuerst nachfragen lassen; offene Ursachenanalysen und nach außen gerichtete Entscheidungen gehören zur Prüfung durch einen Analysten. Diese Schlussfolgerung hat drei Voraussetzungen: Der Test lief nur einmal, der Aufgabenpool bestand aus englischsprachigen Aufgaben eines simulierten Windkraftunternehmens, und die Kosten stammen aus dem OpenRouter-Kanal. Sobald man auf die eigenen Daten und den eigenen Kanal umstellt, muss man die Abnahme nach Aufgabentyp erneut durchführen.
GPT-6.2 Sol: Wissenskarte und Leseindex für Datenanalyse
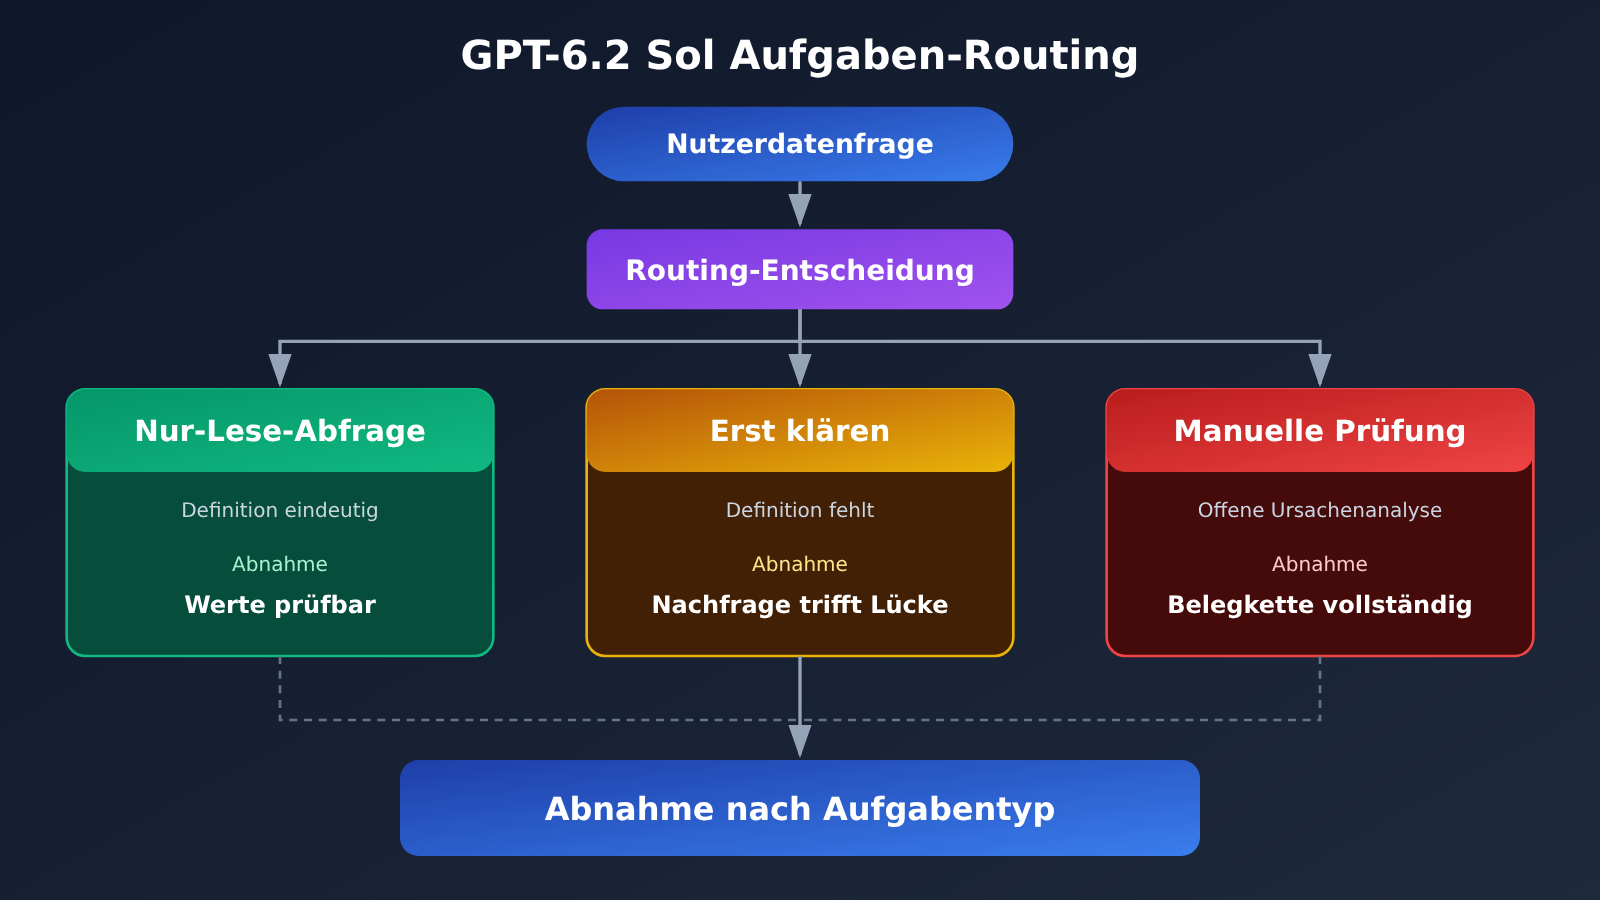
Die folgende Grafik zeigt die Aufgaben-Routing-Logik des gesamten Artikels. Jeder Zweig nennt die Eingabebedingung, die erwartete Ausgabe des Modells und die Nummer des Zweigs im Haupttext.
Nutzer stellt eine Datenfrage
 │
 ├─ Eindeutige Definition + wirkungsarme Zusammenfassung ──→ [1] Sol: reine Datenabfrage (read-only)
 │                               Ausgabe: Zahl + Zähler/Nenner + Zeitraum und Zeitzone + Abfrageanweisung
 │
 ├─ Definition fehlt / Daten unzureichend ────→ [3.2] zuerst klären
 │                               Ausgabe: eine konkrete Rückfrage + Liste möglicher Definitionen
 │
 └─ Offene Ursachenanalyse / Entscheidung nach außen ──→ [3.3] an Analysten zur Prüfung
                                Ausgabe: erste Eingrenzungsnotizen + Belege + Prüfung alternativer Erklärungen
            ↓
   [2] mit Latenz und Kosten pro Frage entscheiden, ob es ins Frontend gehört
            ↓
   [4] mit eigenen Daten nach Fragetyp abnehmen, Ergebnis mit Datenstand und Abfragebelegen liefern
Die Reihenfolge der Abschnitte ist wie folgt. Abschnitt 3 steht für sich und kann bei Bedarf nachgeschlagen werden; die übrigen Abschnitte sollten der Reihe nach gelesen werden.
| Abschnitt | Beantwortete Frage | Was er für den nächsten Abschnitt liefert | Was du danach tun kannst |
|---|---|---|---|
| 1 | Bei welchen Aufgabentypen Sol stabil ist | Aufgabentyp-Grenzen: 38/38 und 2/5 | Den Bereich abstecken, in dem du direkt nach Zahlen fragen kannst |
| 2 | Ob sich ein Einsatz im Frontend lohnt | Latenz, Kosten pro Frage und Extrapolationsannahmen | Budget und Wartezeit für interaktive Szenarien einschätzen |
| 3 | Welche Hinweise eine Klärung oder Übergabe an Menschen erfordern | Drei Fehlerbilder und drei Beispielausgaben | Routing-Regeln entwerfen |
| 4 | Wie du mit eigenen Daten abnimmst | Kennzahlen und Grenzen je Aufgabentyp | Ein nachprüfbares Ergebnis liefern |
To Know: Begriffe rund um die Datenanalyse mit GPT-6.2 Sol
| Begriff | Kurze Erklärung |
|---|---|
| Data Warehouse | Eine Datensammlung, in der verstreute historische Daten aus den Geschäftssystemen zusammengeführt werden, um sie abzufragen und zu analysieren |
| Kennzahlen-Definition | Definition der Kennzahl, Filterbedingungen, Zähler und Nenner sowie Zeitgrenzen |
| Read-only-SQL | Eine Abfrageart, die nur liest und aggregiert; die Datenquelle selbst behält Nur-Lese-Rechte |
| Aufgabe mit verstecktem Muster | In den Daten ist vorab eine strukturelle Anomalie eingebaut; die Aufgabe liefert nur Hinweise, das Modell muss das konkrete Muster selbst finden |
| Abfragebeleg | Abfrageanweisung, Definition, Ergebnis und Datenstand, mit denen andere die Schlussfolgerung nachprüfen können |
| p50-/p95-Latenz | Die Zeit, in der die Hälfte der Anfragen abgeschlossen ist / in der 95 % der Anfragen abgeschlossen sind |
| Gecachte Eingabe | Eingabe-Token, die die Abrechnung beim Upstream als wiederverwendbar erkennt; der Stückpreis liegt deutlich unter dem für normale Eingaben |
| Abnahme nach Fragetyp | Datenabfrage, Klärung, Ablehnung und Exploration werden getrennt bewertet, damit eine Gesamtnote keine Fehlerklasse verdeckt |
1. GPT-6.2 Sol für die Datenanalyse: zuerst die verlässlich prüfbaren Ergebnisse von Datenabfragen
1.1 Was der Plotly-Test umfasste
Plotly rief das Modell im Testframework Plotly Studio Embedded über OpenRouter auf und stellte ihm nur vier schreibgeschützte Tools zur Verfügung: Datensätze auflisten, SQL-Abfragen ausführen, Diagramme erstellen und Tabellen anzeigen. Das Test-Repository simuliert ein Windenergieunternehmen mit rund 19,9 Millionen Datenzeilen, 44 Tabellen und 554 Spalten. 43 englischsprachige Aufgaben wurden anhand des Lösungsschlüssels und der Bewertungsregeln einzeln als bestanden oder nicht bestanden bewertet. Das Bewertungsmodell war Claude Sonnet 5 mit temperature=0; Aufgaben mit Punkteverlust wurden vom Team manuell geprüft.
Dieses Setup kommt der realen Form von BI-Datenabfragen in Unternehmen nahe: Das Modell sieht nicht alle Daten, sondern muss selbst Tabellen finden, SQL schreiben, Ergebnisse lesen und dann antworten. Aufgabenkatalog und Lösungsschlüssel behält Plotly zurück; von außen lassen sich die Aufgaben nicht einzeln reproduzieren. Die folgenden Zahlen sind daher als eine einmalige Beobachtung mit dokumentierter Methodik zu verstehen und nicht als stabile Rangliste.
| Aufgabentyp | Anzahl | GPT-6.2 Sol Ergebnis | Bedeutung für das Geschäft |
|---|---|---|---|
| Standardanalysen | 20 | 20/20 | Zusammenfassungen mit festen Definitionen lassen sich pilotweise direkt beantworten |
| Mehrdeutigkeitsprüfung | 5 | 5/5 | Erkennt, dass die Frage selbst mehrere Interpretationen zulässt |
| Nicht beantwortbare Datenfragen | 5 | 5/5 | Kann ablehnen, wenn die Daten nicht ausreichen, statt Zahlen zu erfinden |
| Datenqualität | 3 | 3/3 | Erkennt fehlende Werte, Duplikate und ähnliche Probleme |
| Statistische Fallstricke | 5 | 5/5 | Vermeidet gängige statistische Fehlinterpretationen |
| Verborgene Muster | 5 | 2/5 | Offene Mustersuche erfordert weiterhin manuelle Prüfung |
| Gesamt | 43 | 40/43 | Die ersten 38 Aufgaben wurden alle bestanden; Punkteverluste traten ausschließlich bei explorativen Aufgaben auf |
Plotly erwähnt außerdem, dass andere Modelle bei Wiederholungsläufen Schwankungen von bis zu drei Aufgaben zeigten. 40/43 liegt nur drei Aufgaben unter der Bestnote und fällt damit genau in diesen Schwankungsbereich. Interessanter ist daher die Verteilung der Fehler: Alle Punkteverluste entfielen auf Aufgaben zu verborgenen Mustern, in den ersten fünf Kategorien gab es keinen einzigen Fehler.
1.2 Warum sich Datenabfragen mit festen Definitionen überprüfen lassen
Am Beispiel eines After-Sales-Berichts: Die Kennzahl „Rückgabequote je Lager in den letzten 7 Tagen“ lässt sich stabil abnehmen, wenn zuvor drei Dinge festgelegt wurden: ob der Nenner alle Bestellungen oder nur zugestellte Bestellungen umfasst, nach welcher Zeitzone der Zeitraum abgegrenzt wird und ob die Filterbedingungen Testbestellungen und interne Bestellungen ausschließen. Sobald diese drei Punkte in der Definitionsdokumentation festgehalten sind, lassen sich die vom Modell erzeugte SQL-Abfrage und deren Ergebnisse Punkt für Punkt mit einer manuellen Abfrage abgleichen.
Feste Definitionen verwandeln die Frage „Ist das Modell klug?“ in „Sind die Zahlen konsistent?“ – und Letzteres lässt sich automatisch vergleichen. Das ist auch der Grund, warum die 38 Aufgaben vollständig bestanden werden konnten und warum dieses Ergebnis aussagekräftig ist: Die meisten dieser Aufgaben haben eine eindeutige Standardantwort.
2. Latenz und Kosten der Datenanalyse mit GPT-6.2 Sol: Sollte man das im Frontend anbieten?
2.1 Die beiden Sol-Generationen im Gesamtdurchlauf
Wenn Nutzer im Frontend eine Frage stellen, entscheidet die Wartezeit direkt über die Erfahrung. Der Plotly-Report zeigt GPT-6.2 Sol und GPT-6.1 Sol im direkten Vergleich über dieselbe Runde mit 43 Fragen:
| Kennzahl | GPT-6.1 Sol | GPT-6.2 Sol | Veränderung |
|---|---|---|---|
| Kosten des Gesamtdurchlaufs | $2.61 | $1.22 | ca. 53.3 % niedriger |
| Median der Bearbeitungszeit pro Frage | 17.6 Sekunden | 10.5 Sekunden | ca. 40.3 % niedriger |
| Anzahl der Tool-Aufrufe | 258 | 158 | deutlich weniger |
| Anzahl der Modellaufrufe | 227 | 173 | weniger |
| Eingabemenge | ca. 7.8 Mio. Tokens | ca. 4.6 Mio. Tokens | weniger |
| Ausgabemenge | ca. 70.000 Tokens | ca. 45.000 Tokens | weniger |
| Anteil zwischengespeicherter Eingaben | 94 % | 97 % | höher |
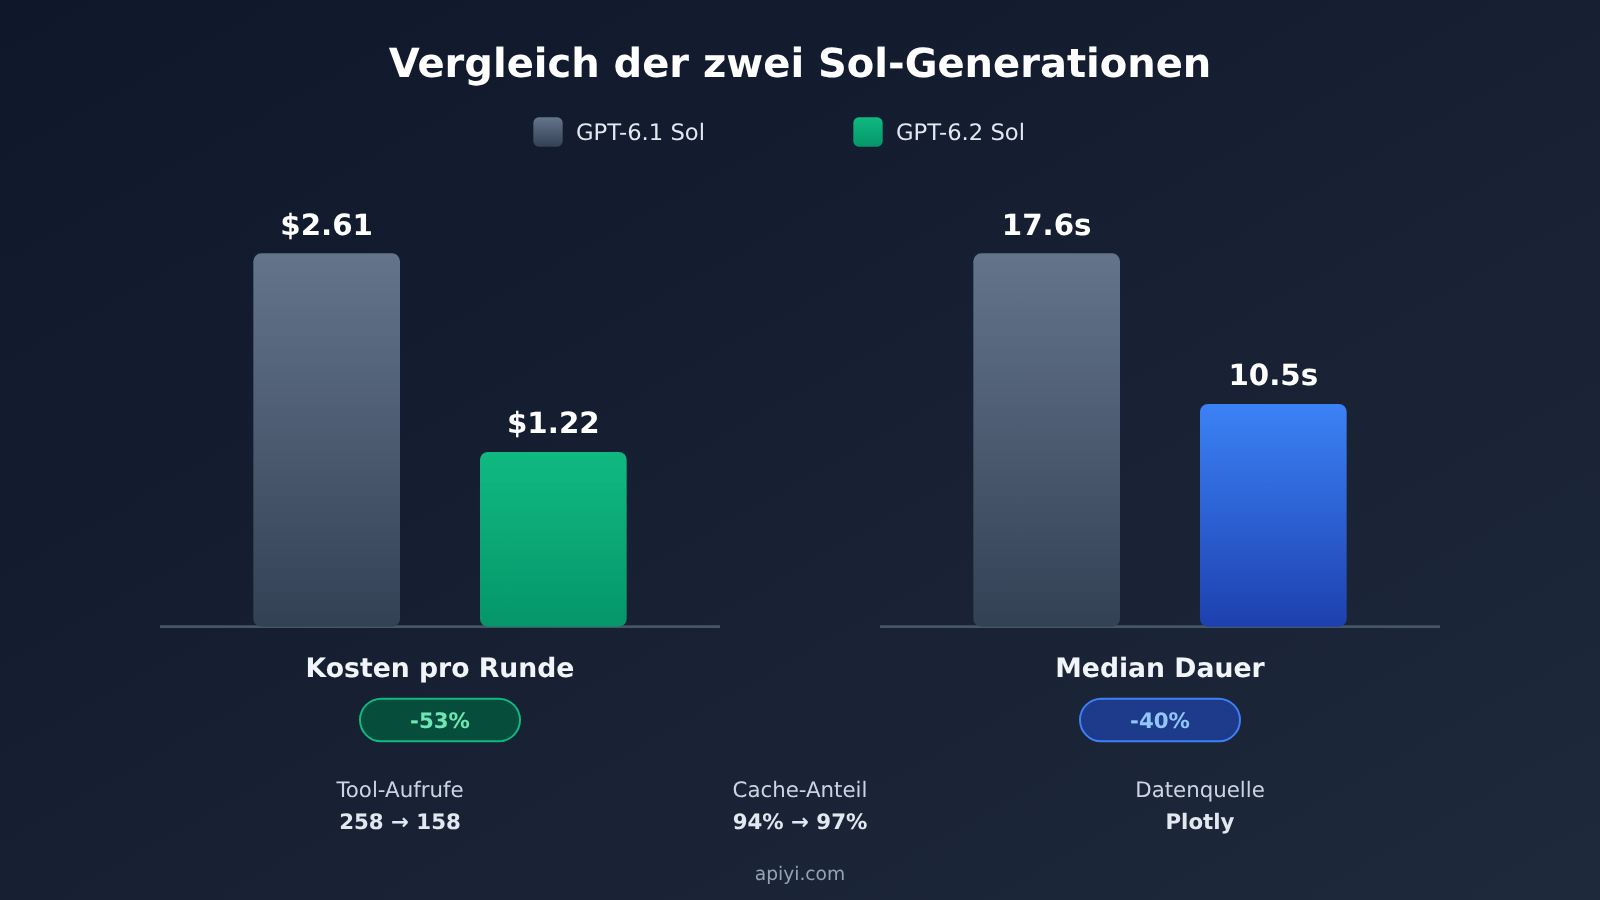
Die Grundpreise der beiden Sol-Generationen im Short-Context-Standard-Tarif sind identisch, doch die Kosten pro Durchlauf sind nahezu halbiert. Der Unterschied entsteht im Ablauf der Aufgabe: weniger Aufrufrunden, weniger gelesene und geschriebene Tokens, höhere Cache-Trefferquote. Wer die Kosten für Datenanalyse-Szenarien bewertet, sollte deshalb in der Einheit „Was kostet eine fertig bearbeitete Frage?“ rechnen – der Listenpreis pro Million Tokens ist nur einer von mehreren Faktoren.
2.2 Hochrechnung von rund $28.4 pro tausend Fragen – und die Annahmen dahinter
Teilt man die $1.22 des Gesamtdurchlaufs durch 43 Fragen, ergibt das im Schnitt rund $0.0284 pro Frage, hochgerechnet etwa $28.4 pro tausend Fragen. Diese Zahl gilt nur, wenn gleichzeitig folgende Annahmen erfüllt sind:
- Die Verteilung der Aufgabentypen entspricht den 43 Fragen von Plotly, davon rund 12 % explorative Fragen;
- es wird derselbe OpenRouter-Kanal zu denselben Preisen genutzt;
- der Cache-Anteil bleibt bei rund 97 %, weil die Fragen denselben System-Prompt und dieselbe Beschreibung der Tabellenstruktur teilen;
- jede Frage wird nur einmal ausgeführt, ohne Wiederholungsversuche.
Eine weitere Zahl aus dem Plotly-Ranking ist der Median der Kosten pro Frage mit $0.017 – er und der Durchschnittswert sind unterschiedliche statistische Größen. Explorative Fragen rufen mehr Tools auf und dauern länger, was den Mittelwert nach oben zieht; der Median kommt dem Preis einer gewöhnlichen Frage-nach-Zahlen-Aufgabe näher. Bei der Budgetplanung kann man mit dem Median die alltäglichen Abfragen kalkulieren und für den Anteil explorativer Fragen einen separaten Aufschlag einplanen.
Die offiziellen OpenAI-Preise im Short-Context-Standard-Tarif lauten: normale Eingabe $2.00, Cache-Lesen $0.10, Ausgabe $10.00 (USD pro Million Tokens, Ausgabe inklusive Reasoning-Tokens). Übersteigt die gesamte Eingabemenge einer Anfrage 272K, wird der komplette Auftrag in den Long-Context-Tarif umgestellt. Die öffentlich einsehbare Preisschnittstelle von APIYI apiyi.com stimmt in der kurzen Stufe mit der offiziellen überein; in der langen Stufe gilt: Eingabe $3, Cache-Lesen $0.15, Cache-Schreiben $3.75, Ausgabe $11.25. Bei Frage-nach-Zahlen-Szenarien liegt eine einzelne Anfrage normalerweise weit unter 272K; auf den Tarifwechsel achten muss man erst, wenn man in einem Rutsch große Mengen an Tabellenstrukturen oder frühere Ergebnisse hineinschiebt.
3. GPT-6.2 Sol in der Datenanalyse: drei Arten von Hinweisen – wann klären, wann an Menschen übergeben
3.1 Warum Aufgaben mit verborgenen Mustern Punkte kosten
Bei den 38 Aufgaben ohne verborgene Muster kommt 6.2 Sol auf durchschnittlich etwa 2,9 Tool-Aufrufe pro Aufgabe, 6.1 Sol auf etwa 4,3 – beide bestehen alle Aufgaben. Bei den 5 Aufgaben mit verborgenen Mustern hält der Sol-Sonderbericht für 6.2 Sol im Schnitt etwa 9 Datenbankabfragen fest, für 6.1 Sol etwa 16. (In den Beispielen des Plotly-Gesamtranking-Artikels wurde für die Vorgängerversion die Größenordnung von rund 18 genannt; hier gilt der Sonderbericht als Maßstab.)
Nach manueller Prüfung waren es drei Aufgaben, bei denen Punkte verloren gingen:
- Das eingepflanzte Muster wurde nicht separat herausgefiltert;
- es wurde nicht benannt, welche Objekte konkret betroffen sind;
- der Datenteil, in dem der Effekt tatsächlich vorlag, wurde nicht gefunden.
Alle drei Fehler haben eines gemeinsam: Die Abfragen blieben an der Oberfläche. Das lässt sich als Beobachtung festhalten: Die neue Version sucht bei Explorationsaufgaben flacher. Ob der kausale Zusammenhang „weniger Abfragen führen zu Punktverlust“ tatsächlich gilt, lässt sich erst mit kontrollierten Experimenten bestätigen. Für die Praxis bleibt die Schlussfolgerung dieselbe: Bei allen Attributionsaufgaben, die aktives Suchen nach Belegen erfordern, darf man die erste Antwort des Modells nicht direkt als Ergebnis übernehmen.
3.2 Fehlende Definition: erst fragen, dann antworten
Im Folgenden wird anhand eines fiktiven Datensatzes mit Support-Tickets drei Arten von Ausgaben demonstriert. Der Datensatz enthält vier Tabellen: Bestellungen, Tickets, Produktchargen und Lager. Die folgenden Ausgaben sind Designbeispiele und keine tatsächlich gemessenen Ergebnisse.
Normale Antwort (klare Definition). Auf die Frage „Wie hoch ist die Rücksendequote je Lager in den letzten 7 Tagen?“ sollte eine geeignete Ausgabe neben dem Wert pro Lager auch Folgendes ausweisen: Zähler (Anzahl der Tickets für physische Rücksendungen), Nenner (Anzahl der im selben Zeitraum zugestellten Bestellungen), Datumsbereich und Zeitzone (z. B. 11.–19. November nach Pekinger Zeit), Aggregationsdimension (Lager) sowie das ausgeführte SQL.
Erst nach der Definition fragen (fehlende Definition). Fragt der Nutzer nur „Wie hoch war die Rücksendequote letzte Woche?“, sollte das Modell zunächst nachfragen: „Wird die Rücksendequote auf Basis von Erstattungsanträgen oder auf Basis physisch zurückgesandter Ware berechnet? In Szenarien mit reiner Erstattung ohne Rücksendung unterscheiden sich beide deutlich.“ Anschließend sollten die beiden Berechnungsvarianten zur Auswahl gestellt werden. Bis der Nutzer sich entschieden hat, werden keine Zahlen ausgegeben.
3.3 Offene Ursachenanalyse: an Analysten übergeben
Fragt der Nutzer „Die Rücksendequote eines Kanals hat sich verdoppelt – bei welchen Chargen häufen sich die Auffälligkeiten?“, bewegt sich das im Bereich versteckter Muster. Das Modell kann zunächst eine Vorprüfung durchführen: prüfen, ob Daten fehlen und ob die Gesamtstichprobe ausreichend groß ist, und dann schrittweise nach Kanal, Kategorie, Lager und Charge aufteilen. In der Ausgabe sollte mindestens ein Beleg für die These sowie eine Prüfung enthalten sein, mit der alternative Erklärungen ausgeschlossen werden (z. B. die Bestätigung, dass das Bestellvolumen des Kanals in dieser Woche nicht ungewöhnlich stark gesunken ist, um eine Verdopplung durch einen kleineren Nenner auszuschließen).
Nach diesen Schritten sollte die Ausgabe als „Zur Prüfung durch Analysten“ gekennzeichnet werden und nicht als „Schlussfolgerung“. Die Routing-Regeln lassen sich in einer Tabelle zusammenfassen:
| Hinweis | Typische Fragestellung | Routing | Modellausgabe | Prüfschwerpunkt |
|---|---|---|---|---|
| Klare Definition, geringe Auswirkung | Rücksendequote je Lager über 7 Tage | Sol nur lesend, Datenabfrage | Wert + Definition + SQL | Wert stimmt mit manueller Abfrage überein |
| Definition oder Daten unzureichend | Wie hoch war die Rücksendequote letzte Woche? | Zuerst klären | Eine Rückfrage + mögliche Definitionsvarianten | Rückfrage trifft die Lücke |
| Offene Ursachenanalyse, externe Entscheidung | Bei welchen Chargen häufen sich die Auffälligkeiten? | An Analysten zur Prüfung übergeben | Prüfprotokoll + Beleg + Prüfung alternativer Erklärungen | Belegabdeckung, Fehlalarme und Auslassungen |
4. Mit eigenen Daten die Datenanalysefähigkeiten von GPT-6.2 Sol validieren
4.1 Anbindung und Routing-Code
gpt-6.2-sol lässt sich über zwei Endpunkte aufrufen – Responses und Chat Completions. Funktionsaufrufe und integrierte Tools laufen dabei über den Responses-Pfad. Beide Endpunkte akzeptieren die Reasoning-Stufe none nicht; beim Migrieren älteren Codes sollten Sie diesen Parameter also prüfen. Das folgende Minimalbeispiel nutzt Chat Completions für die Routing-Klassifizierung:
import openai, json

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI-kompatible Schnittstelle
)

question = "上周退货率多少"
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[
        {"role": "system", "content": "把用户的数据问题分类为 direct / clarify / escalate,"
                                      "只返回 JSON:{\"route\":..., \"reason\":...}"},
        {"role": "user", "content": question},
    ],
)
print(json.loads(resp.choices[0].message.content))
Vollständiges Beispiel für einen schreibgeschützten SQL-Tool-Aufruf anzeigen (Responses API)
import openai, json, sqlite3

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Datenbank auf Verbindungsebene schreibgeschützt öffnen; die Regex-Prüfung ist nur die zweite Absicherung
conn = sqlite3.connect("file:aftersales.db?mode=ro", uri=True)

def run_readonly_sql(sql: str) -> str:
    head = sql.strip().lower()
    if not (head.startswith("select") or head.startswith("with")):
        return json.dumps({"error": "only read-only queries allowed"})
    rows = conn.execute(sql).fetchmany(200)
    return json.dumps({"rows": rows, "row_count": len(rows)}, default=str)

tools = [{
    "type": "function",
    "name": "run_readonly_sql",
    "description": "在售后数据仓库执行只读 SQL,返回最多 200 行",
    "parameters": {
        "type": "object",
        "properties": {"sql": {"type": "string"}},
        "required": ["sql"],
    },
}]

instructions = (
    "你是数据分析助手。回答必须包含:分子、分母、时间范围与时区、聚合维度、所执行的 SQL。"
    "口径不明确时先提问;涉及归因的结论标注为待分析师复核。"
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions=instructions,
    input="按仓库列过去 7 天的退货率",
    tools=tools,
)

# Tool-Aufrufe in der Schleife abarbeiten, bis das Modell eine endgültige Antwort liefert
while True:
    calls = [o for o in resp.output if o.type == "function_call"]
    if not calls:
        break
    outputs = [{
        "type": "function_call_output",
        "call_id": c.call_id,
        "output": run_readonly_sql(json.loads(c.arguments)["sql"]),
    } for c in calls]
    resp = client.responses.create(
        model="gpt-6.2-sol",
        previous_response_id=resp.id,
        input=outputs,
        tools=tools,
    )

print(resp.output_text)
print("output_tokens:", resp.usage.output_tokens)
🚀 Schnellstart: Wenn Sie mit Ihren eigenen Geschäftsproben validieren möchten, können Sie über APIYI apiyi.com ein kostenloses Testkontingent für neue Nutzer beantragen. Mit demselben API-Schlüssel wechseln Sie zwischen
gpt-6.2-solund anderen gängigen Modellen und vergleichen sie auf demselben Fragensatz – die Datenquelle bleibt dabei einfach schreibgeschützt.
4.2 Abnahmekennzahlen nach Aufgabentyp
Der Testkatalog für die Abnahme sollte die drei Routing-Pfade aus Abschnitt 3 abdecken. Jeder Aufgabentyp wird separat bewertet.
| Aufgabentyp | Hauptkennzahl | Bewertung | Empfohlene Erfassung |
|---|---|---|---|
| Abfragen mit fester Kennzahlendefinition | Genauigkeit der Zahlenwerte | Zeilenweiser Abgleich mit manuell erstellten SQL-Ergebnissen | Kosten pro Frage, p50/p95-Latenz |
| Fehlende Kennzahlendefinition | Anteil angemessener Rückfragen | Ob die Rückfrage die tatsächlich fehlende Kennzahlendefinition adressiert | Ob unnötige Rückfragen auftreten |
| Nicht beantwortbare Datenanfragen | Anteil korrekter Ablehnungen | Keine erfundenen Zahlen | Anzahl falscher Antworten |
| Offene Ursachenanalyse | Evidenzabdeckung, Fehlalarme und übersehene Fälle | Ob Stützbelege und die Prüfung alternativer Erklärungen vollständig sind | Konsistenz über mehrere Wiederholungsläufe |
Der Plotly-Bericht zeigt nur den Latenzmedian. In Ihrer eigenen Abnahme müssen Sie zusätzlich p95 erfassen. Das Nutzererlebnis im Frontend leidet oft unter wenigen Long-Tail-Anfragen; bei explorativen Fragen treten Long-Tails besonders häufig auf. Bei den Kosten lesen Sie die Ausgabemenge aus usage.output_tokens; Reasoning-Tokens stehen üblicherweise im Unterfeld output_tokens_details.reasoning_tokens. Zusammen mit der Menge der aus dem Cache gelesenen Tokens lässt sich so berechnen, was eine Frage tatsächlich kostet.
4.3 Grenzen von kleinen Stichproben und Wiederholungsläufen
Die versteckten Musterfragen von Plotly umfassen nur 5 Fragen; das Konfidenzintervall für 2 von 5 ist sehr breit – bei einem anderen Fragensatz könnten es 1 von 5 oder auch 4 von 5 sein. Bei Wiederholungsläufen anderer Modelle traten Schwankungen von bis zu drei Fragen auf, weshalb der Unterschied der Gesamtpunktzahl einer einzelnen Runde für die Modellauswahl nicht ausreicht. Bei der eigenen Abnahme sollten die Explorationsfragen mindestens mehrere Runden lang wiederholt und dabei fünf Variablen abgeglichen werden: Daten-Snapshot, Werkzeugsatz, Modell-Inferenzstufe, Aufrufkanal und Bewertungstabelle. Ändert sich auch nur eine davon, lassen sich die Ergebnisse davor und danach nicht mehr direkt vergleichen.
💡 Empfehlung zur Abnahme: Der Kanal ist eine leicht übersehene Variable. Die Kosten von Plotly stammen von OpenRouter; die Abrechnung und die Caching-Strategie deines Produktionskanals können davon abweichen. Es empfiehlt sich, auf APIYI apiyi.com mit demselben Daten-Snapshot erneut zu laufen, die Kosten pro tausend Fragen anhand der tatsächlichen Abrechnung neu zu berechnen und erst dann das Frontend-Kontingent festzulegen.
4.4 Ein abnahmefähiges Lieferobjekt
Der Standard für eine bestandene Abnahme lautet: Jedes Abfrageergebnis muss von einer dritten Person unabhängig nachvollzogen werden können. Im Folgenden die Form eines qualifizierten Lieferobjekts (fiktive Daten):
question: 按仓库列过去 7 天的退货率
route: direct
data_snapshot: 2026-11-19 23:59 (Asia/Shanghai)
metric_definition:
  numerator: 实物退回工单数(status = returned)
  denominator: 同期已签收订单数(排除测试单、内部单)
  time_range: 2026-11-13 ~ 2026-11-19,北京时间
  group_by: warehouse_id
query: "SELECT w.warehouse_id, ... GROUP BY w.warehouse_id"
result: [{warehouse: 华东一仓, rate: 3.1%}, {warehouse: 华南二仓, rate: 2.4%}]
model: gpt-6.2-sol
cost_usd: 0.012
latency_s: 8.7
reviewer: 无需复核(固定口径问数)
Ein Lieferobjekt enthält das Datum der Daten, die Berechnungsdefinition, die Abfrage und das Ergebnis; GPT-6.2 Sol lässt sich bei der Frontend-Abfrage in diesem Schritt bereits abnehmen. Ausgaben ohne diese Angaben sollten nicht in den Bericht aufgenommen werden, selbst wenn die Zahlen zufällig stimmen. Wer diese Prozedur im eigenen Repository zum Laufen bringen möchte, kann mit der OpenAI-kompatiblen Schnittstelle von APIYI apiyi.com beginnen – zuerst Abfragen mit festen Berechnungsdefinitionen online stellen und dann schrittweise auf Klärung und Attribution ausweiten.
Referenzen
- Plotly – GPT-6.2 Sol Spezialbericht zur Datenanalyse: Aufschlüsselung der Ergebnisse für 43 Aufgaben sowie Kosten- und Zeitvergleich
- Link:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- Link:
- Plotly – DataAnalyticsBench Testmethodik: Aufgabentyp-Design, Bewertungsregeln und Statistik-Methodik des Rankings
- Link:
plotly.com/blog/introducing-dataanalyticsbench
- Link:
- OpenAI – GPT-6.2 Sol Modellkarte: Kontextfenster, Endpunkt-Unterstützung und Abrechnungsregeln für lange Kontexte
- Link:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Link:
- OpenAI – API-Preise: Standard-Input, Cache- und Output-Einzelpreise
- Link:
developers.openai.com/api/docs/pricing
- Link:
- APIYI öffentliche Preis-Schnittstelle: Preisansdrücke für die kurze und lange Tarifstufe von
gpt-6.2-sol- Link:
api.apiyi.com/api/pricing
- Link:
Autor: APIYI Technik-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com


