
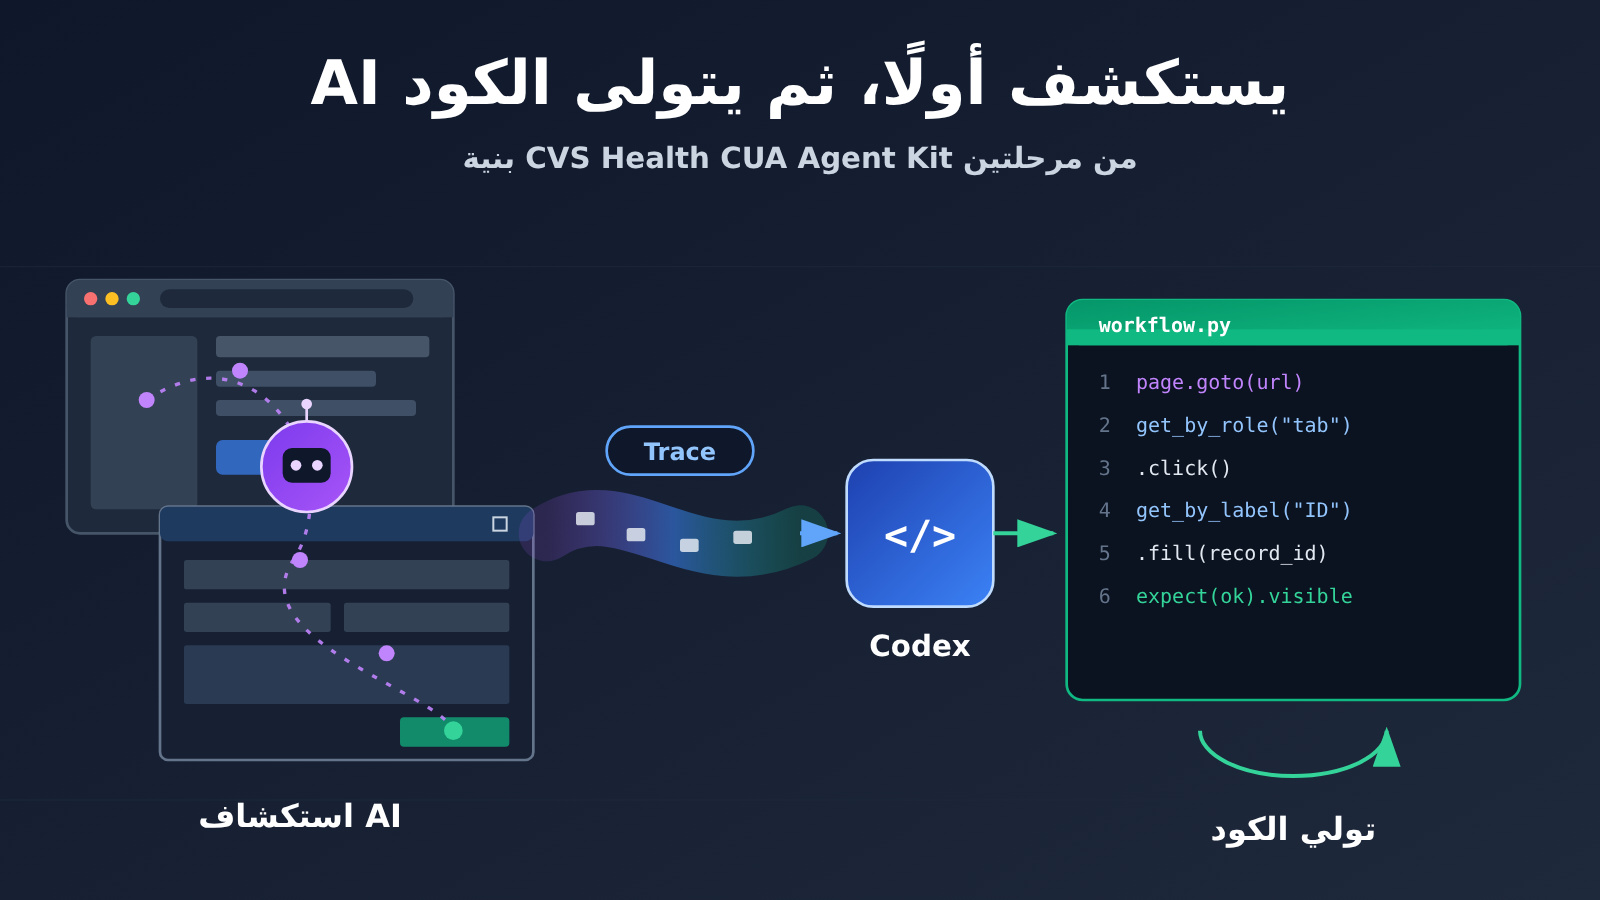
لا يحتاج وكيل المؤسسة إلى استدعاء نموذج لغة كبير في كل مرة يكرر فيها مهمة. فقد قدّم CUA Agent Kit المفتوح المصدر من CVS Health مسارًا هندسيًا أكثر اقتصادًا: يدع وكيل استخدام الحاسوب (Computer-use Agent) يستكشف أولاً تدفق عمل غير معروف، ويسجّل العملية الناجحة في صورة لقطات شاشة وأحداث وTrace؛ ثم يحوّل Codex هذه الأدلة إلى كود حتمي قابل للفحص والصيانة وإعادة التنفيذ.
تدمج هذه الخطة قدرة الاستكشاف المرنة لدى الذكاء الاصطناعي مع قدرة التنفيذ المستقرة في الأتمتة التقليدية، لتنتج بنية هجينة قوامها «استكشاف بالذكاء الاصطناعي، تثبيت بالكود، صيانة مستمرة». وهي لا تجعل الوكيل بديلاً عن السكربتات، بل تجعله هو من يكتب السكربت ويصلحه.
ماذا ستعرف بعد قراءة هذا المقال؟
- كيف ينفّذ CVS Health CUA Agent Kit العملية المكوّنة من مرحلتين، من الاستكشاف بالذكاء الاصطناعي إلى تثبيت الكود
- ما الدور الذي تؤديه لقطات الشاشة وevents.jsonl وTrace والمحددات الدلالية في مرحلة التثبيت
- كيف يعمل التدفق الثابت من دون استدعاء نموذج لغة كبير، وكيف تتم صيانته عند حدوث استثناء
يتناول الجزء الخاص بالحقائق الموضوعية لاحقًا، بالترتيب: آلية عمل CUA Agent Kit، وما يحدث أثناء الانتقال من عمليات الذكاء الاصطناعي إلى كود Playwright، والمهام التي يظل الوكيل مسؤولاً عن صيانتها بعد التثبيت، والأدلة البحثية التي توضح الفرق بين هذه البنية وRPA التقليدية، وكيف يمكن للمطورين إعادة استخدامها عمليًا. ثم يناقش جزء التحليل والتقييم سؤالين: لماذا يُعدّ جعل الوكيل يعيد التفكير من الصفر في كل مرة إهدارًا، وما المهام التي تناسب هذه البنية الهجينة وما المهام التي يجب أن تبقى تحت المراجعة البشرية.
للتعرف: فهم المفاهيم السبعة لمسار أتمتة CVS Agent
| المفهوم | شرح موجز |
|---|---|
| Computer Use | القدرة على إنجاز المهام عبر مراقبة واجهة البرنامج وتنفيذ عمليات مثل النقر والكتابة. |
| EHR | نظام السجلات الصحية الإلكترونية، وهو البرنامج الأساسي الذي تستخدمه المؤسسات الصحية لتخزين ومعالجة سجلات المرضى. |
| MCP | بروتوكول معياري لاكتشاف الأدوات الخارجية واستدعائها. |
| RPA | أسلوب أتمتة ينفّذ العمليات المتكررة عبر قواعد أو برامج مُعدّة مسبقًا. |
| Rubric points | نقاط تقييم مقسّمة وفق قواعد التقييم، تقيس مدى تحقق جزء من المتطلبات. |
| معدل النجاح من طرف إلى طرف | نسبة المهام الكاملة التي تحقق جميع شروط النجاح. |
| Trace | دليل تتبّع يسجل عملية التنفيذ والعمليات وحالة الصفحات. |
نظرة سريعة على التأثير: من يتأثر بمسار أتمتة CVS Agent
- المطورون والمسؤولون التقنيون: النقطة الأساسية ليست “هل نستخدم Agent أم لا”، بل تقسيم آلية التنفيذ حسب المهمة. يجب التحقق بشكل منفصل من معدل الإنجاز في مرحلة الاستكشاف، واستقرار الكود المُثبّت، والتكلفة الكاملة بما في ذلك الصيانة، بدلًا من النظر فقط إلى سعر استدعاء النموذج لمرة واحدة.
- المؤسسات الصحية ومسؤولو سير العمل: يجب التمييز بين العرض التجريبي الاصطناعي، وتقييم المورّد، وحالات المؤسسات المنشورة، والتجربة الداخلية، لأن وزن هذه الأدلة يختلف. وبالنسبة للخطوات التي تتضمن بيانات المرضى وتغيير الحالة، يجب تطبيق الموافقة البشرية، وأقل صلاحية ممكنة، وتوثيق مسار العمليات مسبقًا.
الوقائع الموضوعية: النهج ذو المرحلتين الخاص بـ CVS Health CUA Agent Kit
لنبدأ بالخلفية أولًا. في 16 نوفمبر 2026، أعلنت OpenAI عن مستجدات وكيل استخدام الحاسوب (Computer-use Agent) الموجّه لفرق الرعاية الصحية، ونشرت نتائج التقييم الخاصة بالمهام السريرية والإدارية الطبية، إلى جانب تجارب التعاون مع مؤسسات من بينها CVS Health وCigna Healthcare وAbridge وAmbience. وقد عرضت CVS Health ضمن ذلك حالة من بيئة الإنتاج، وأتاحت CUA Agent Kit مفتوح المصدر برخصة Apache-2.0.
تشمل نتائج الإنتاج التي أفصحت عنها CVS Health: وكيل ضمن أحد تدفقات عمل الإنتاج صفّى خلال عطلة نهاية أسبوع واحدة تراكمًا من مهام إرسال الملفات يعود إلى عدة أشهر؛ ووكيل آخر يتعامل يوميًا مع عشرات الآلاف من خطوات التشغيل على النظام خلال الاستشارات الطبية التخصصية. ويأتي النظام مصحوبًا بفحوصات تحقق وإشراف بشري، ويتحقق من العمليات الفعلية وحالة التطبيقات عبر لقطات الشاشة وسجلات العمليات. ويجدر الانتباه إلى أن هذه بيانات أفصحت عنها الشركة من تلقاء نفسها. كما أن عبارة “عشرات الآلاف” تشير إلى خطوات العمل على النظام المرتبطة بالاستشارات، وليست دليلًا على أن عشرات الآلاف من القرارات السريرية أُنجزت باستقلالية بواسطة الذكاء الاصطناعي. ولم تبيّن المواد المنشورة ما إذا كانت هذه الوكلاء في بيئة الإنتاج مبنية بالكامل على النسخة مفتوحة المصدر من Agent Kit، ومن ثم لا ينبغي اعتبار الأمرين متطابقين.
المصدر: openai.com/index/advancing-computer-use-for-healthcare-teams/
كيف يعمل CUA Agent Kit من CVS Health؟
الوصف الذاتي في ملف README الخاص بالمشروع واضح ومباشر: إنه مجموعة أدوات انطلاق لأتمتة المتصفح وسير عمل Windows، تستخدم الذكاء الاصطناعي لاكتشاف الخطوات، ثم تعيد تنفيذها بالكود. ويشدّد المشروع تحديدًا على أن «معرفة كيف تُنفَّذ المهمة» و«تكرار تنفيذها بشكل مستقر على المدى الطويل» مسألتان مختلفتان، وينبغي معالجة كل منهما بوسيلة مختلفة.
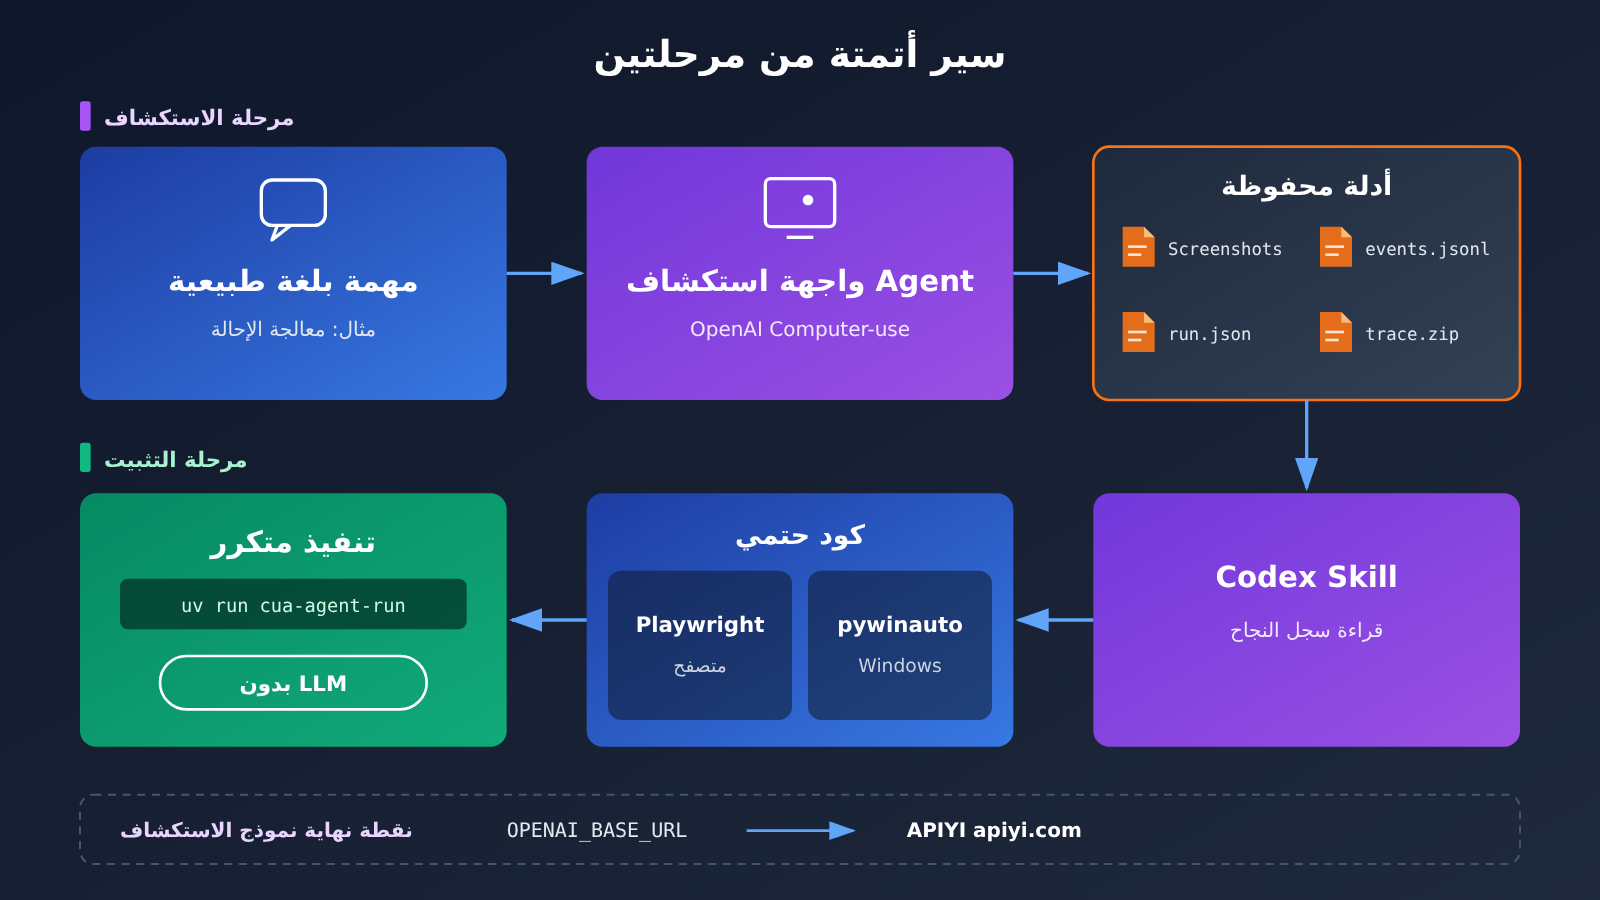
تنقسم العملية بأكملها إلى مرحلتين:
- مرحلة الاستكشاف: يتلقى OpenAI Computer-use Agent وصفًا للمهمة باللغة الطبيعية، مثل «العثور على سجل معيّن ومعالجة إحالة»، ثم يستكشف داخل الواجهة الحقيقية وينفّذ ويتحقق. وأثناء ذلك يحفظ لقطات الشاشة وأفعال التشغيل وأهداف التشغيل ومسار التنفيذ.
- مرحلة الترسيخ: يقرأ Codex Skill سجلات الاستكشاف التي نجحت، ويولّد أو يحدّث كود سير عمل حتمي. بعد ذلك يُترك تكرار تنفيذ السير نفسه لكود عادي، دون مطالبة نموذج اللغة الكبير بإعادة الاستدلال في كل مرة.
الأدلة التي تتركها مرحلة الاستكشاف هي ملفات محفوظة على القرص، وليست عملية استدلال تبقى حبيسة النموذج. أنواع السجلات التي يعلنها README كما يلي:
| السجل | الاستخدام الأساسي | قيمته في مرحلة الترسيخ |
|---|---|---|
| Screenshots | تسجيل حالة الواجهة عند كل خطوة | ليتحقق المهندسون وCodex من الشكل الفعلي للصفحة |
| events.jsonl | تسجيل أحداث التشغيل سطرًا بسطر | استعادة «ما الذي تم فعله وبأي ترتيب» |
| run.json | تسجيل معلومات هذه الجولة من التشغيل | التمييز بين عمليات تشغيل مختلفة والحكم على نجاحها |
| trace.zip | مسار تنفيذ Playwright | توفير تفاصيل العناصر والشبكة والتوقيت، لاستخدامها في توليد الكود وتشخيصه |
المصدر: github.com/cvs-health/cua-agent-kit
من عمليات الذكاء الاصطناعي إلى شفرة Playwright: ماذا يفعل CVS Agent Kit؟
أحد أهم التفاصيل في مرحلة التثبيت هو أن ما يتم توليده ليس «إعادة تشغيل لإحداثيات الفأرة». فعندما يولّد مشروع CVS سير عمل المتصفح، يستخدم Semantic Locators لإنتاج شفرة Playwright، بحيث يحدد الهدف عبر خصائص دلالية للعنصر مثل الدور والاسم، بدلًا من حفظ إحداثيات معينة على الشاشة.
الفرق بين الطريقتين يظهر بوضوح أكبر عند الصيانة. فإعادة تشغيل الإحداثيات تتأثر بدقة الشاشة وحجم النافذة والتعديلات الطفيفة في التخطيط؛ فقد يتحرك الزر ببكسلات قليلة فيصبح النقر في المكان الخطأ، والأسوأ من ذلك أنه يصعب عند حدوث خطأ معرفة ما كان المقصود بالنقر من سلسلة الإحداثيات. أما الشفرة التي تنتجها Semantic Locators فتشبه «النقر على الزر المسمى ‘إرسال’»، إذ يكون القصد مكتوبًا داخل الشفرة، ويستطيع المهندس مراجعته مباشرة، كما تقل احتمالية تعطلها عند إجراء تعديلات جزئية على الصفحة. وبالطبع، إذا تغيّر اسم الزر أو أُعيد تصميم سير العمل، فإن Semantic Locators ستفشل هي الأخرى، لكن تحديد سبب الفشل يكون أسهل.
توزيع الأدوات في المشروع كالتالي:
- Playwright: مسؤول عن التنفيذ الحتمي لسير عمل المتصفح، وإنتاج مسارات قابلة لإعادة التشغيل مثل trace.zip.
- pywinauto: مسؤول عن أتمتة تطبيقات سطح مكتب Windows، ويغطي الأنظمة القديمة التي لا تمتلك واجهة ويب.
- Codex Skill: يقرأ مسارات الاستكشاف الناجحة، ثم يولّد أو يحدّث النوعين المذكورين من الشفرة.
هذا التوجه يتوافق مع اتجاه وثائق OpenAI الرسمية. إذ يشرح دليل Computer Use من OpenAI مسارين: الأول أن يعيد النموذج إجراءات فأرة ولوحة مفاتيح منظمة ينفذها التطبيق، والثاني أن يولّد النموذج شفرة تعمل على الواجهة بمساعدة أدوات مثل Playwright. وتوصي الوثائق بالنسبة إلى GPT-6 Astra بأسلوب تنفيذ الشفرة، بينما يظل Computer Tool خيارًا متاحًا. كما تُشرح ComputerToolset وBrowserToolset ومدخل المتصفح المُدار كلٌّ على حدة في الدليل الرسمي.
المصدر: developers.openai.com/api/docs/guides/tools-computer-use
بعد التثبيت: ما الذي يبقى على الوكيل في CVS Agent Kit فعله؟
بعد تثبيت سير العمل، صار التنفيذ الحتمي يُشغَّل بالأمر الوارد في README:
uv run cua-agent-run
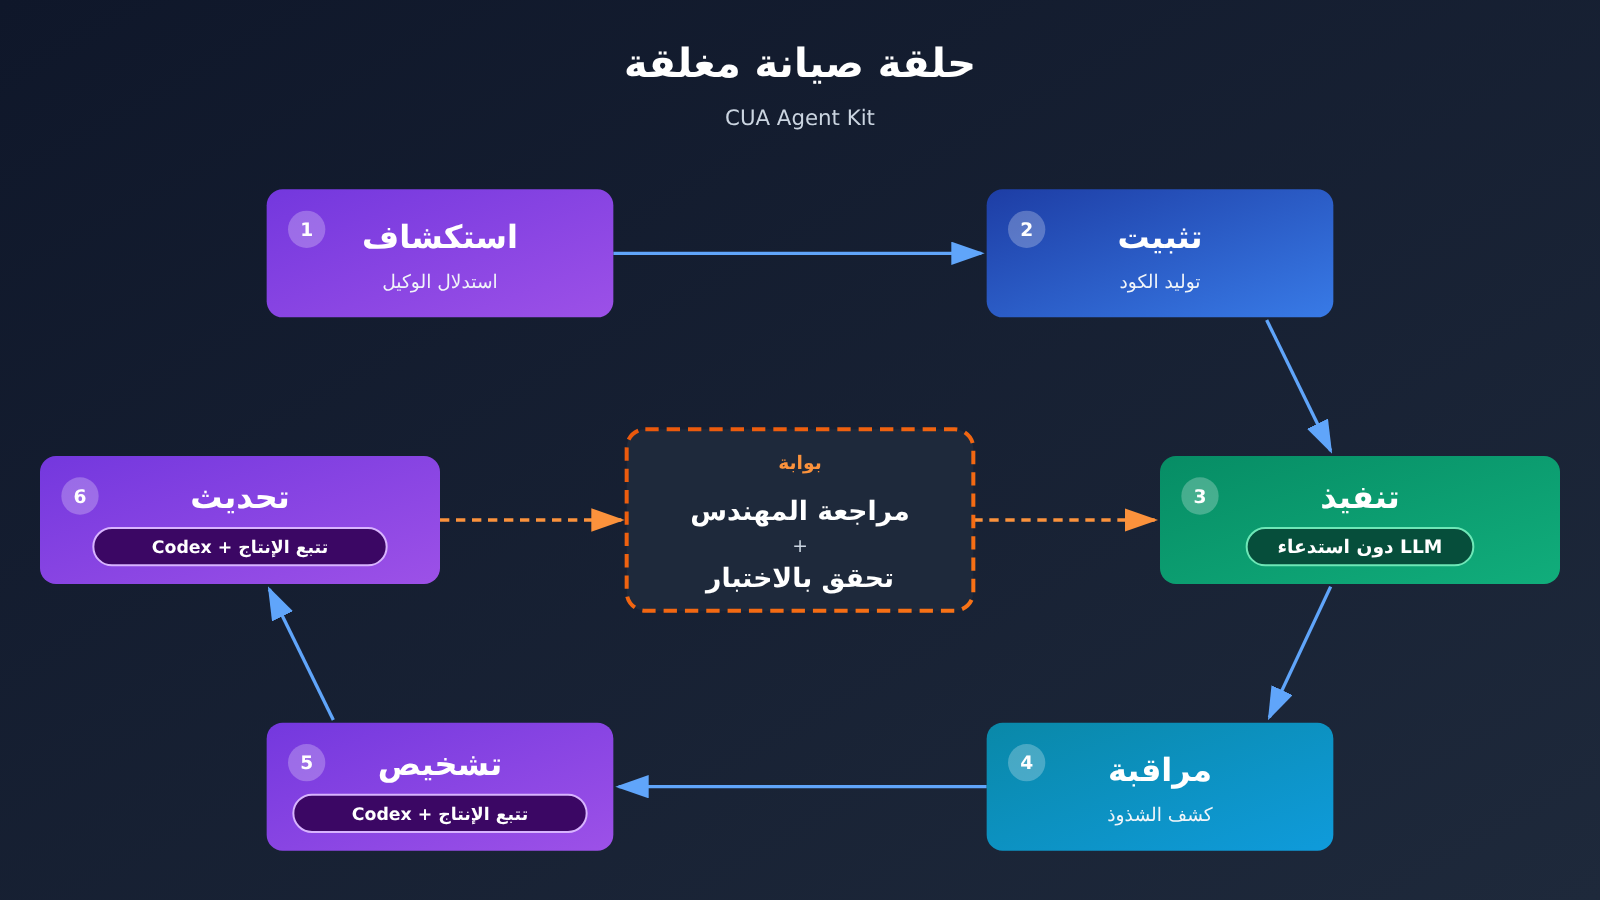
هذه المرحلة لا تحتاج إلى استدعاء نموذج لغة كبير في كل مرة، ولا تحتاج إلى مفتاح API. لكن المشروع لا ينظر إلى “التثبيت” على أنه حل نهائي يكفي مرة واحدة. فآلية الصيانة التي يصفها README هي حلقة مغلقة:
- تنفيذ سير العمل المثبَّت وفق الجدول المحدد؛
- اكتشاف anomalies في Trace الإنتاج؛
- استخدام Codex لـ Trace لتشخيص المشكلة؛
- تحديث الشفرة الحتمية؛
- مراجعة المهندس للتغييرات؛
- إعادة الإدخال في دورة التنفيذ المتكرر بعد اجتياز الاختبارات والتحقق.
بعبارة أخرى، تغيّر دور الوكيل من “القيام بالعمل بنفسه في كل مرة” إلى “الغياب في الأوقات العادية، والحضور لإصلاح الشفرة عند وقوع مشكلة”. فالشفرة ستتعطل، والواجهات ستتغير، والمشروع نفسه يفترض ذلك مسبقًا، ولهذا صمم مرحلتي التشخيص والمراجعة.
ما الفرق بين أتمتة الوكيل الهجينة في CVS وRPA التقليدية؟
تعتمد RPA التقليدية على خطوات مُعدّة مسبقًا وعلى تحديد مواقع عناصر الواجهة، فتنفيذها سريع ونتائجها مستقرة، لكن تطويرها وصيانتها بعد تغيّر الواجهات يحتاج إلى جهد بشري. أما الوكيل (Agent) الخالص فيستطيع فهم اللغة الطبيعية والتكيّف مع تغيّرات الواجهة، لكن إعادة الاستدلال في كل مرة ترفع التكلفة وتُحدث تقلّبًا في النتائج. وتقع CUA Agent Kit بين الاثنين: فهي تستخدم الوكيل بديلًا عن خطوة «التسجيل اليدوي وكتابة سير العمل»، ثم تعود في مرحلة التنفيذ إلى شيفرة حتمية.
وللاطلاع على مقارنة مباشرة بين الاثنين، يمكن الرجوع إلى دراسة نُشرت في 2026: Are LLM agents the new RPA? A comparative benchmark study of agentic automation and RPA across standardized workflow tasks (DOI: 10.1080/23311975.2026.2724760). أُجريت الدراسة في الفترة من مايو إلى يونيو 2025، وقارنت UiPath Studio 2023.4.0 مع Anthropic Computer Use Agent، وغطّت ثلاثة أنواع من المهام القياسية: إدخال البيانات، والمراقبة، واستخراج المستندات.
| المهمة | معدل نجاح RPA | معدل نجاح الوكيل | وقت التطوير الأولي (ملاحظة من مطوّر واحد) |
|---|---|---|---|
| P1 | لم يُدرج في إحصاءات المقارنة | فشل الوكيل من أول تشغيل، فلم يدخل الإحصاءات اللاحقة | لم يُفصح عنه |
| P2 | 100% (10 مرات) | 90% (10 مرات) | الوكيل نحو 10 دقائق، RPA نحو 38 دقيقة |
| P3 | 100% (10 مرات) | 60% (10 مرات) | الوكيل نحو 15 دقيقة، RPA نحو 240 دقيقة |
ووجدت الدراسة أيضًا أن RPA كان أسرع بوضوح في P2 وP3؛ وأن مشكلات الوكيل تمثّلت أساسًا في فشل عمليات الواجهة، وفقدان السياق، وأخطاء في القرار؛ وأن الوكيل يمتلك ميزة كامنة في التكيّف مع الواجهات الديناميكية.
ولا بد من توضيح حدود هذه الدراسة:
- العينة صغيرة جدًا: في P2 وP3 أُجريت 10 محاولات لكل تقنية، أما P1 فلم تكن «10 محاولات لكل تقنية»، فلا يصح التعميم.
- وقت التطوير مجرد ملاحظة أولية: مستمد من مطوّر واحد، وليس له تمثيل إحصائي، ولا يمكن اعتباره متوسطًا للقطاع.
- إصدارات الأدوات قديمة نسبيًا: استخدمت الدراسة إعدادات وكيل من 2025، ولا يمكن أن تمثّل نتائج النماذج الجديدة في 2026.
ومع ذلك، فإن اتجاه الاستنتاجات يتوافق مع تصميم CVS: فالوكيل بارع في الاستكشاف السريع والمعالجة المرنة، بينما يظل التنفيذ الحتمي على طريقة RPA متفوقًا في التكرار المستقر.
المصدر: tandfonline.com/doi/full/10.1080/23311975.2026.2724760
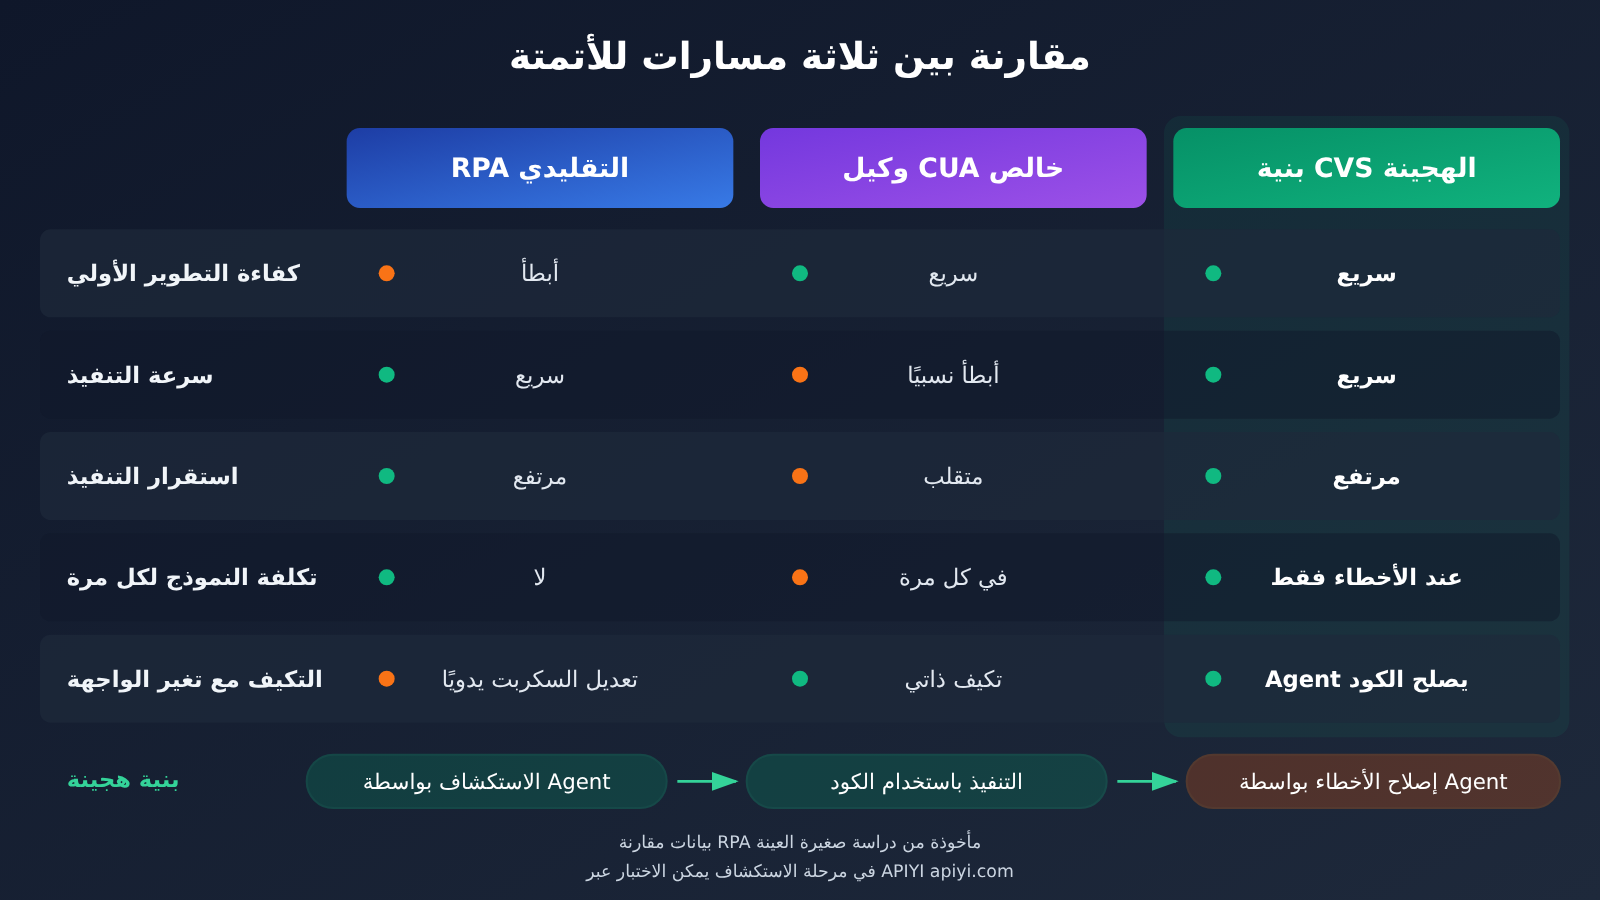
كيف يمكن للمطورين إعادة استخدام نهج CVS CUA Agent Kit؟
لا يسرد README متطلبات بيئة كثيرة:
- Python 3.12 أو أحدث؛
- uv (أداة إدارة حزم ومشاريع Python)؛
- موقع ويب مستهدف أو تطبيق سطح مكتب يمكن الوصول إليه؛
- مرحلة الاستكشاف تحتاج إلى
OPENAI_API_KEY؛ - يمكن تكوين نقطة نهاية API مخصصة عبر
OPENAI_BASE_URL.
يرتبط الاستخدام بثلاث مراحل: الاستكشاف (يستكشف الوكيل ويجمع الأدلة)، والترسيخ (يولّد Codex الشيفرة)، والتشغيل (تنفيذ حتمي). راجع README الخاص بالمستودع للأوامر والمعاملات المحددة في مرحلتي الاستكشاف والترسيخ؛ أما مرحلة التشغيل فهي الأمر uv run cua-agent-run المذكور سابقًا.
تصميم OPENAI_BASE_URL جدير بالانتباه. فهو يعني أن نقطة الدخول إلى النموذج في مرحلة الاستكشاف يمكن أن تشير إلى API الرسمي، أو إلى بوابة داخلية للمؤسسة أو خدمة أخرى متوافقة مع واجهة OpenAI، مما يسهّل توحيد المصادقة والفوترة والتدقيق. يمكن تكوين متغيرات البيئة الخاصة بمرحلة الاستكشاف على النحو التالي:
# مرحلة الاستكشاف: تحتاج إلى API النموذج
export OPENAI_API_KEY="YOUR_API_KEY"
export OPENAI_BASE_URL="https://api.apiyi.com/v1"   # استخدم واجهة APIYI الموحدة، أو استبدلها ببوابةك

# مرحلة التشغيل: تنفيذ حتمي، لا يحتاج إلى مفتاح API
uv run cua-agent-run
تجدر الإشارة إلى نقطة مهمة: يعتمد Computer Use على قدرات محددة في Responses API وأنواع أدوات معينة. قبل التبديل إلى أي نقطة نهاية مخصصة، تأكد أولًا من أن نقطة النهاية هذه تدعم النماذج والأدوات اللازمة لمرحلة الاستكشاف، وجرّبها عبر مسار بسيط حتى تنجح قبل التوسع في استخدامها.
بعد الترسيخ، يكون أكثر ما تفعله في الصيانة اليومية هو قراءة Trace وسجلات الأحداث. فيما يلي مثال على سكربت مساعد: يتم تمرير events.jsonl من تشغيل واحد إلى نموذج لغة كبير عام، ليُنشئ قائمة بالخطوات ونقاط الفشل المشتبه بها كمرجع للمهندسين عند المراجعة. تعتمد الحقول المحددة في events.jsonl على المخرجات الفعلية للمشروع؛ وهنا يُقرأ الملف سطرًا بسطر فقط. وعند التعامل مع معلومات حساسة مثل بيانات المرضى، احرص على إزالة البيانات الحساسة أولًا، أو عالجها فقط داخل بيئة مطابقة للمتطلبات التنظيمية.
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

def summarize_events(path: str, model: str = "gpt-4o-mini") -> str:
    """يقرأ events.jsonl بعد إزالة البيانات الحساسة، وينشئ قائمة بالخطوات ونقاط الفشل المحتملة"""
    with open(path, encoding="utf-8") as f:
        events = [json.loads(line) for line in f if line.strip()]

    sample = json.dumps(events[:200], ensure_ascii=False)  # التحكم في طول السياق
    prompt = (
        "以下是一次界面自动化运行的事件日志。"
        "请按顺序列出操作步骤,并指出最可能导致失败的步骤及原因,"
        "只基于日志内容,不要臆测。\n" + sample
    )
    resp = client.chat.completions.create(
        model=model,  # استبدله بالنموذج المتاح فعليًا على منصتك
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

print(summarize_events("runs/latest/events.jsonl"))
هذا السكربت مجرد مساعدة للقراءة؛ فهو لا يغني عن تشخيص Codex للمشكلات استنادًا إلى Trace الكامل، ولا يغني عن مراجعة المهندسين واختباراتهم.
🚀 نصيحة للبدء السريع: عند إعادة استخدام هذا النهج، يمكنك أولاً اختيار سير عمل منخفض المخاطر على أحد مواقع الاختبار الداخلي، وتشغيل السلسلة الكاملة «الاستكشاف ← التثبيت ← التشغيل». تحتاج مرحلة الاستكشاف إلى استدعاء النموذج مرارًا وتكرارًا لمقارنة النتائج، ويمكنك الحصول على حصة اختبار مجانية عبر APIYI apiyi.com، ثم استخدام مفتاح API نفسه للتبديل بين نماذج مختلفة وإنجاز مهام مساعدة مثل تحليل السجلات، وبعدها تحدّد النموذج المناسب للبيئة الرسمية.
التحليل والحكم: المفاضلة في مسار أتمتة CVS Agent
المحتوى التالي هو قراءة مبنية على الحقائق المذكورة سابقًا، وليس استنتاجًا يصدر عن جهة المشروع أو عن OpenAI.
لماذا يُعدّ إعادة الوكيل للتفكير من الصفر في كل مرة هدرًا؟
ثمة سمة تميّز أتمتة الأعمال متعددة الخطوات: بمجرد أن تعمل العملية بنجاح، تسير الغالبية العظمى من التنفيذات اللاحقة على المسار نفسه. وإذا جعلنا وكيل استخدام الحاسوب (Computer-use Agent) يلتقط الشاشة من جديد ويفهم الواجهة ويخطط للخطوة التالية في كل مرة، فالنموذج في الحقيقة يدفع مرارًا مقابل سؤال يعرف جوابه مسبقًا. ويترتب على هذا الاستدلال المتكرر ثلاثة أنواع من التكلفة في آنٍ واحد.
أولًا، التكلفة. فـ Computer Use ينطوي على استدعاءات متعددة الجولات، ولقطة الشاشة بعد كل خطوة عملية تُعدّ إدخالًا بصريًا يراكم التوكنات باستمرار. وبالاستشهاد بأسعار السياق القصير (Standard) التي أعلنتها OpenAI في 17 نوفمبر 2026، يبلغ سعر الإدخال والإخراج والإدخال المخزّن لنموذج GPT-6 Astra 10 و50 و1 دولار لكل مليون توكن على الترتيب، مقابل 0.10 و0.50 و0.01 دولار لـ GPT-6 Luna. وفي تقييم HealthAdminBench، بلغت تكلفة المهمة الواحدة على Luna نحو 0.085 دولار، أي أقل بنسبة 98% من Astra؛ وبالعكس من هذه النسبة يمكن تقدير تكلفة Astra بنحو 4.25 دولار للمهمة، لكن هذا تقدير فقط، وهو تكلفة في ظروف اختبار مرجعي، ولا يصلح سعرًا إنتاجيًا.
ثانيًا، زمن التأخير. فكل خطوة تتطلب انتظار عودة النموذج، وكلما طالت العملية طال الانتظار. وهذا أيضًا سبب السرعة الملحوظة لـ RPA في P2 وP3 مقارنة بالوكيل في الدراسة السابقة.
ثالثًا، التقلب. فعند تشغيل المهمة نفسها عدة مرات قد يسلك الوكيل مسارات مختلفة، وقد بلغت نسبة نجاح الوكيل في P3 في الدراسة 60% فقط. وبالنسبة إلى الأعمال التي تتطلب قابلية للتنبؤ وقابلية للتدقيق، يكون عدم اليقين هذا أصعب في القبول من التكلفة.
لذلك ينبغي حساب هيكل التكلفة في المرحلتين بصورة منفصلة:
| بند التكلفة | مرحلة الاستكشاف (الوكيل) | مرحلة التنفيذ (كود حتمي) |
|---|---|---|
| توكنات النموذج | تُحتسب المدخلات البصرية والنصية والمخرجات المدفوعة في كل جولة على حدة؛ ولا تُضاف توكنات إعادة المحاولة مرة ثانية إن كانت قد دُحتسبت ضمن الإجمالي | صفر في التشغيل الطبيعي |
| الأدوات وبيئة التشغيل | المتصفح وبيئة سطح المكتب والحاويات وغيرها من الخدمات المستخدمة فعليًا | الجهاز والمتصفح اللذان يشغّلان الكود |
| الجهد الهندسي | كتابة وصف المهمة، والتحقق من الأدلة، ومراجعة الكود المولّد | المراقبة وتشخيص الأخطاء وتحديث الكود واختباره |
| تكرار الحدوث | عند إطلاق عملية جديدة أو تغيير كبير في العملية | عند كل تنفيذ تشغيلي |
| الممارسة الموصى بها | اختيار النموذج حسب التعقيد: النماذج القوية للعمليات الصعبة، والنماذج الرخيصة للعمليات المهيكلة | تجنّب استدعاء النموذج قدر الإمكان، والعودة إلى الوكيل للإصلاح عند حدوث خطأ فقط |
والجدوى الاقتصادية للهندسة المختلطة تنبع تحديدًا من هذا الجدول: فاستدعاءات النموذج المكلفة تتركّز في مرحلتي الاستكشاف والإصلاح منخفضتي التكرار، بينما تعود مرحلة التنفيذ عالية التكرار إلى كود تقترب تكلفته الحدية للنموذج من الصفر. على أن الدفتر الحقيقي يجب أن يحتسب أيضًا جهد الصيانة: فكلما تكرّر تغيير الواجهة، زادت العودة إلى مرحلة الاستكشاف، وضبطت فائدة التوفير.
💰 نصيحة بشأن التكلفة: عند اختيار طبقات النماذج خلال مرحلة الاستكشاف، من الأفضل أن تختبرها في سير عملك الحقيقي بدلًا من نسخ أرقام المقارنات المرجعية كما هي. يتيح لك APIYI عبر apiyi.com التبديل بين النماذج ضمن واجهة واحدة متوافقة مع OpenAI، مع الدفع حسب الاستخدام، ما يسهّل مقارنة استهلاك التوكن الفعلي لدى النماذج المختلفة في مرحلتي الاستكشاف وتشخيص السجلات.
وهناك أيضًا مسألة تتعلق بمنهجية التقييم كثيرًا ما تُغفل. نتائج HealthAdminBench التي أعلنتها OpenAI هي 94.3% لـ Astra و91.8% لـ Luna، وهما نسبتا نقاط rubric عند أعلى مستوى من قوة الاستدلال، وليسا معدلي نجاح من طرف إلى طرف. تحتوي نسخة الورقة البحثية 2604.09937v1 لفريق ستانفورد على 135 مهمة و1698 مهمة فرعية (منها 1177 تقييمًا حتميًا و521 يقيّمها نموذج)، ويذكر التقرير أن أفضل معدل نجاح لمهمة كاملة هو 36.3% (Claude Opus 4.6 CUA)، وأفضل معدل نجاح لمهمة فرعية هو 82.8% (GPT-5.4 CUA). أما البيانات التي كُشف عنها مبكرًا على الويب من 70 مهمة و947 نقطة تقييم فتعود إلى نسخة عامة أخرى، ولا يمكن اعتبارها إلا مرجعًا تاريخيًا للمقارنة. تأتي هذه الأرقام من نماذج وتواريخ وظروف تنفيذ ومؤشرات مختلفة، ولا يمكن جمعها في لوحة تصنيف واحدة.
وبالنسبة إلى مبدأ «الاستكشاف أولاً ثم التثبيت»، يعد معدل نجاح المهمة الكاملة من طرف إلى طرف أهم من الدرجات الجزئية. يحتاج Codex إلى مسار ناجح مكتمل؛ فإذا كان أداء مرحلة الاستكشاف صحيحًا في 90% من الخطوات الفرعية لكنه توقف عند خطوة التقديم الأخيرة، فإن Trace المتبقي يبقى غير قابل للتثبيت المباشر. عند اختيار النموذج، ينبغي قياس معدل نجاح المهمة الكاملة باستخدام سير العمل الخاص بك.
ما المهام المناسبة لبنية Agent هجينة على نمط CVS؟
بجمع الحقائق السابقة معًا، يمكن الحصول على جدول تقريبي لتوزيع المهام:
| خصائص المهمة | طريقة التنفيذ المقترحة | مثال نموذجي | التدخل البشري |
|---|---|---|---|
| العملية غير معروفة، الوثائق ناقصة، الواجهة معقدة | يستكشفها الـ Agent مع ترك الأدلة | التخطيط الأول لمسار تشغيل نظام قديم ما | مراجعة نتائج الاستكشاف والشفرة المولّدة |
| العملية مستقرة، متكررة بدرجة عالية، يمكن التحقق من الحالة | التثبيت في شفرة حتمية | إرسال الملفات عبر الأنظمة، نقل الحقول الثابتة | فحص النتائج بشكل انتقائي، ومراقبة الحالات الشاذة |
| مغطاة بالـ API مسبقًا | تفضيل استدعاء الـ API | كتابة البيانات المهيكلة | الإدارة وفق الصلاحيات المعتادة |
| الواجهة تُحدَّث بشكل متكرر | التثبيت ثم تعزيز المراقبة، مع تخصيص ميزانية للعودة إلى الاستكشاف | البوابات الخارجية | مراجعة كل تحديث للشفرة |
| تغيير حالة أعمال عالية المخاطر | لا تصل الشفرة أو الـ Agent إلا إلى مسودة / بانتظار الموافقة | تقديم طلب، إرسال رسالة، تعديل سجل | موافقة بشرية إلزامية |
وفي المجال الطبي، قدّمت ممارسات شركاء آخرين مرجعًا أيضًا. في الحل الذي عرضته Ambience، يتوقف الـ Agent ليسأل الطبيب عندما يكون السجل الطبي غامضًا، وينتظر الموافقة قبل الإرسال؛ أما حالة Assort، فتتولى الـ API الأجزاء التي يمكن تغطيتها، بينما يكمل Computer Use فقط خطوات الواجهة التي لا يغطيها الـ API. إن الجمع بين «API + Computer Use + شفرة حتمية + موافقة بشرية» أكثر واقعية من الاعتماد على تقنية واحدة بعينها.
من الضروري التوضيح أن الشفرة الحتمية تجعل التنفيذ قابلًا للتوقع فحسب، لكنها لا تضمن صحة النتائج. إذا كان المسار الذي تم تثبيته في مرحلة الاستكشاف معيبًا، فستكرر الشفرة هذا العيب بشكل ثابت؛ وفي العمليات العابرة للأنظمة، قد ينسخ خطأ واحد إلى أنظمة تدفق لاحقة متعددة. لذلك، يظل فحص الحالة قبل العملية والتحقق من النتائج بعدها ومبدأ أقل صلاحية وتسجيل الأثر الكامل طوال العملية أمورًا لا يمكن التنازل عنها حتى بعد التثبيت. يناقش هذا المقال بنية هندسية، ولا يتضمن أي توصيات لتشخيص المرضى أو علاجهم.
بالنسبة للفرق التي تريد البدء عمليًا، فإن المسار الأكثر أمانًا هو: اختيار عملية منخفضة المخاطر وعالية التكرار في بيئة غير إنتاجية، ثم المرور بالكامل عبر الاستكشاف والتثبيت والتشغيل وتغيير واجهة مُصطنع متعمّد، مع تسجيل تكلفة استدعاء النموذج وساعات صيانة الشفرة ووقت التعافي من الفشل. هذه البيانات الثلاثة أوضح من أي درجة معيارية في بيان ما إذا كانت هذه البنية مجدية في سياقك. أما اختبارات المقارنة متعددة النماذج في مرحلة الاستكشاف، فيمكن البدء بها باستخدام الحصة المجانية من APIYI عبر apiyi.com، ثم تحديد النموذج وطريقة الاتصال للنشر الرسمي بناءً على النتائج المقاسة.
إن سبب استحقاق حل CVS للاهتمام لا يكمن في ادعائه بأن الـ Agent ذكي للغاية، بل في اعترافه بحدود الـ Agent، واستخدام الذكاء في المكان الذي ينبغي استخدامه فيه فعلًا: استكشاف مرة واحدة، ثم التثبيت في شفرة، ثم الإصلاح عند حدوث عطل. وسيعتمد ما إذا كان هذا المسار سيصبح واقعًا في مزيد من الشركات في نهاية المطاف على البيانات المقاسة لكل عملية في بيئتها الحقيقية.
The proof of the pudding is in the eating. (الترجمة العربية للمثل: الطريقة الوحيدة لمعرفة إن كان البودينغ لذيذًا هي تذوّقه — أي أن النتيجة الفعلية لا تُعرف إلا بالتجربة العملية.)
المؤلف: فريق APIYI التقني
للتواصل التقني: نرحب بتواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com، ولمزيد من مواد التكامل يمكنكم زيارة مركز الوثائق على docs.apiyi.com


