
ملاحظة المؤلف: نقرأ في هذا المقال النتائج التي أبلغ عنها GPT-6.2 Astra عن نفسه رسميًا بمعزل عن بيانات الطرف الثالث الواردة من Artificial Analysis، ونحكم على ما إذا كان يستحق تولّي مهامك الصعبة من عدمه بناءً على أربع فئات من المهام: التسليم الاحترافي، والعلوم، والشيفرة والأبعاد الثلاثية، والأمن السيبراني.
أطلقت OpenAI رسميًا في 2026-11-17 GPT-6.2 Astra و GPT-6.2 Sol، ووصفهما المنشور الرسمي بأنهما «فائقان في الكفاءة، ومصمَّمان للمهام في العالم الحقيقي». نُشر مقال الإطلاق وبطاقة النظام وصفحتا نموذج API للطرازين في آنٍ واحد، ونشرت Artificial Analysis في اليوم نفسه مقال تقييم من طرف ثالث، وبذلك أصبح من الممكن التحقق المتبادل من حدود قدرات GPT-6.2 Astra اعتمادًا على مصادر متعددة.
هذا ليس مقالًا دعائيًا من طراز «الأول في كل شيء». ففي المؤشر المركّب لدى Artificial Analysis، لا يحتل GPT-6.2 Astra المركز الأول. كما أن درجاته تتغير تغيّرًا واضحًا تبعًا لمستوى الاستدلال المختار. وفي اتجاه الأمن السيبراني، يرفض بل بعض الطلبات المشروعة لأن أنظمة الحماية فيه أكثر صرامة. يعرض هذا المقال الأرقام الرسمية المبلغ عنها ذاتيًا والأرقام الواردة من الطرف الثالث كلًّا على حدة، ولا يدمج مجموعتي البيانات في استنتاج واحد.
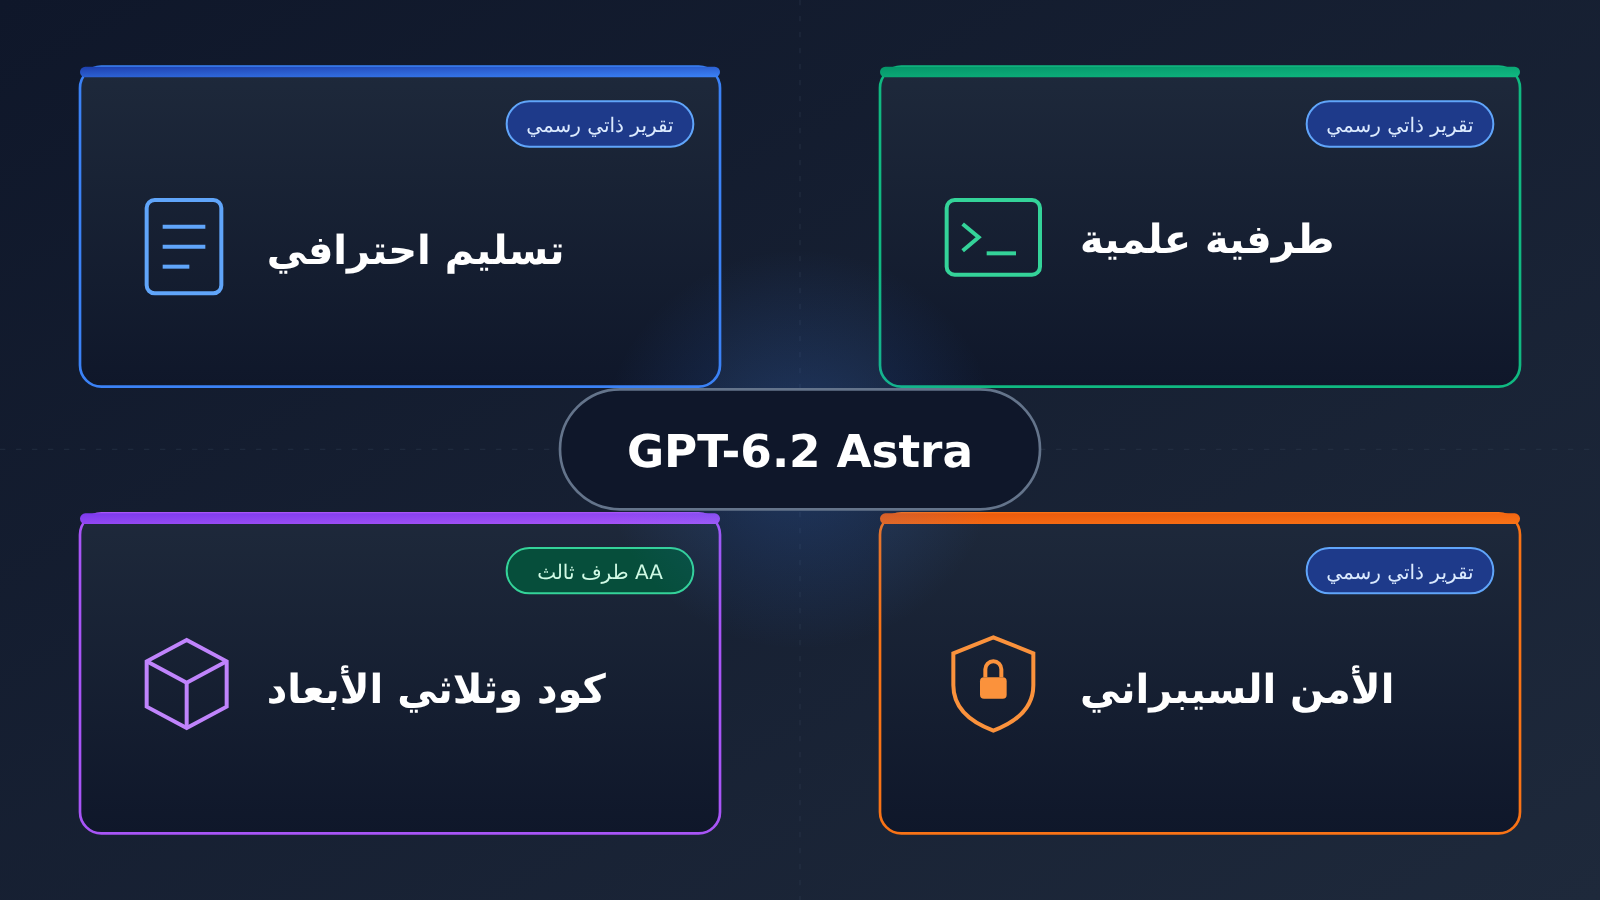
القيمة الجوهرية: بعد قراءة هذا المقال، ستتمكن من تحديد ما تثبته الأدلة عن GPT-6.2 Astra في كل فئة من فئات العمل الأربع — تسليم الوثائق الاحترافية، والمهام العلمية عبر الطرفية، والشيفرة والأبعاد الثلاثية، والأمن السيبراني — ولماذا لا يغني درج مركّب واحد عن الحكم بندًا بندًا.
النقاط الأساسية في GPT-6.2 Astra
نبدأ بجدول قراءة سريعة. وقد أُشير في كل صف إلى مصدر البيانات، فاحرص على التمييز بين المصادر أثناء القراءة.
| النقطة | الشرح | مصدر البيانات | ماذا يعني لك |
|---|---|---|---|
| التسليم الاحترافي | تحسّن مقارنةً بـ GPT-6 Astra في مسارات العمل الاحترافية طويلة المدى، والمهام القانونية، و GDPval v2، وبتكلفة أقل | تقارير رسمية ذاتية | المهام التسليمية المستندية متعددة الخطوات تستحق التجربة أولاً |
| المحطة الطرفية العلمية | Terminal-Bench-Science 0.1 أعلى بـ 9 نقاط مئوية من GPT-6 Astra | تقارير رسمية ذاتية، وتؤكد AA تفوّقه | السيناريوهات التي تتطلب تشغيل سير العمل العلمي في المحطة الطرفية مدعومة بدليل |
| الشيفرة والأبعاد الثلاثية | مؤشر وكلاء البرمجة متعادل مع GPT-6 Astra، وتقييم أعمى AA-3D بمقدار Elo 1318 | AA كطرف ثالث / نقل عن الرسميين | الشيفرة ليست قفزة نوعية، بينما التوليد ثلاثي الأبعاد يمثل نقطة قوة بارزة |
| النتيجة الإجمالية تتغير حسب مستوى الاستدلال | Max و Xhigh تساوي 62، و High تساوي 60، و Medium تساوي 57، و Low تساوي 46 | AA كطرف ثالث | عند خفض المستوى لتوفير المال، تنخفض النتيجة أيضاً |
| الأمن السيبراني | مستوى «حرج» في إطار الاستعداد، وقد تُرفض بعض أبحاث الثغرات المشروعة، ولم يُربط Daybreak بعد بالإصدار 6.2 | بطاقة النظام الرسمية وبيان الإصدار | على فرق أبحاث الأمان توفير بدائل جاهزة |
ما يجب معرفته قبل قراءة نتائج GPT-6.2 Astra
معظم النتائج الواردة في بيان الإصدار الرسمي هي قيم نسبية، مثل «أعلى بـ 5.2 نقطة من GPT-6 Astra» و«بتكلفة أقل من الثلث»، وكثير من البنود لا تقدم نتيجة مطلقة. وفي مثل هذه الحالات، يكتفي هذا المقال بنقل العلاقة النسبية دون إضافة أرقام من عند نفسه.
Artificial Analysis (ويُشار إليه فيما يلي بـ AA) هو طرف ثالث مستقل. مؤشره الإجمالي يعتمد على مجموعة مهام مختلفة، كما أن نتائجه مرتبطة بمستوى الاستدلال. فعندما تقول الشركة الرسمية إن «تكلفة إحدى المهام تبلغ نحو 5% من تكلفة المنافس»، فإن تكلفة المهمة الواحدة المعروضة على صفحة AA تتبع معياراً آخر تماماً، ولا يمكن قسمة أحدهما على الآخر أو التحويل بينهما مباشرة.
الميزات الأساسية لـ GPT-6.2 Astra: نظرة منفصلة على فئات المهام الأربع
قدرات GPT-6.2 Astra في التسليم الاحترافي (بالاستناد أساسًا إلى الإفصاحات الرسمية)
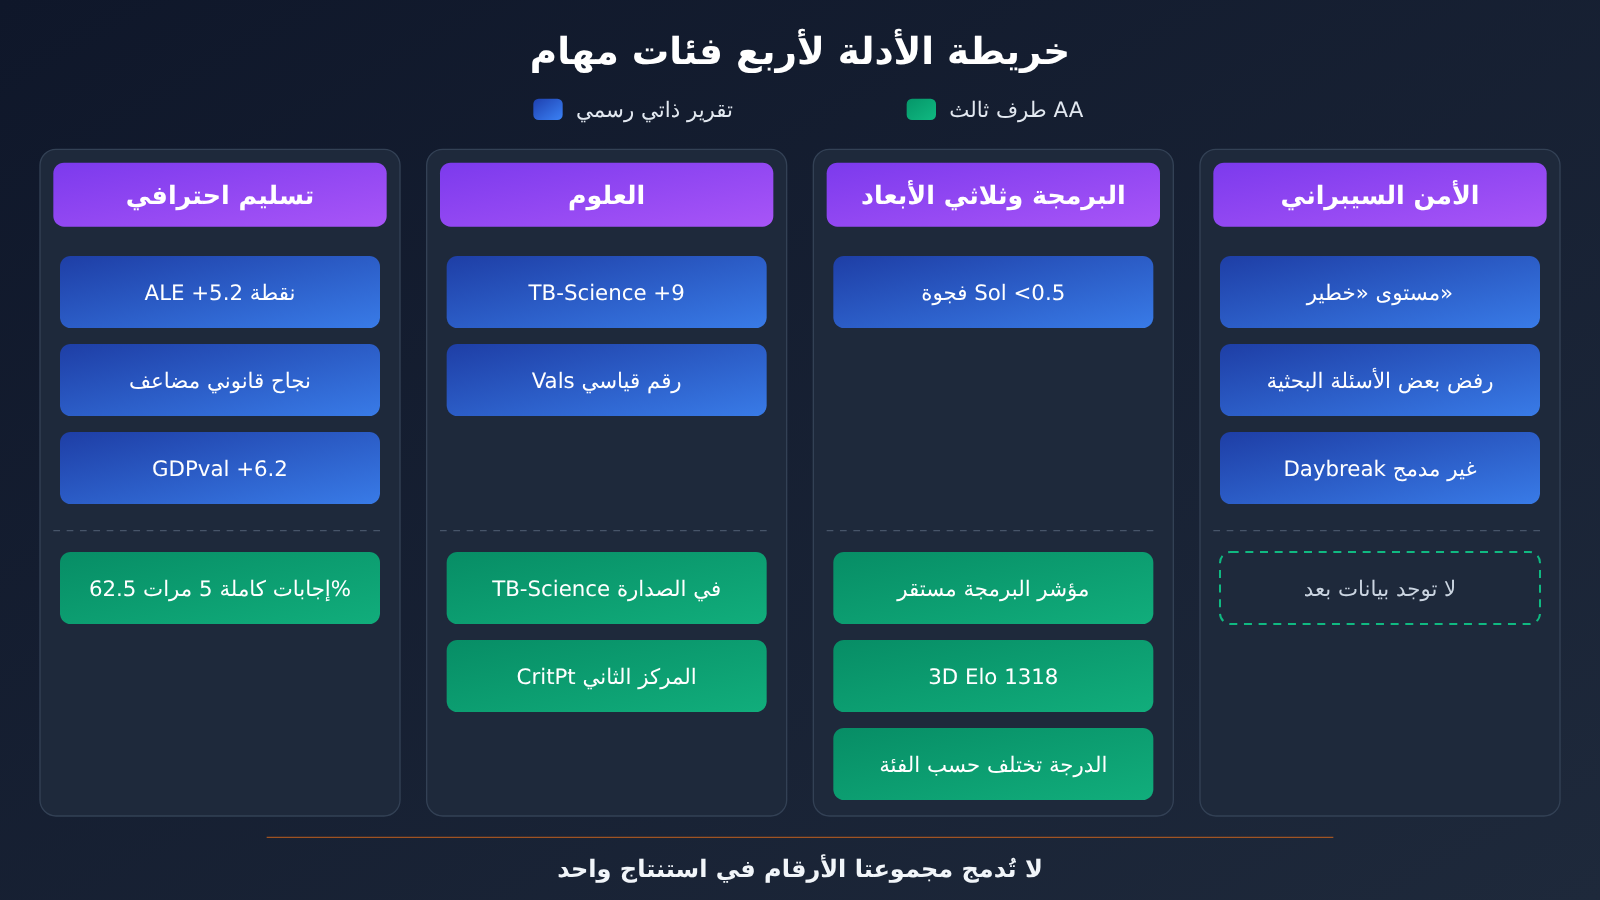
التسليم الاحترافي هو الاتجاه الذي توليه الإفصاحات الرسمية أكبر قدر من الاهتمام. في تقييم Agents’ Last Exam، وهو تقييم لسير العمل الاحترافي طويل المدى، تقول الجهة الرسمية إن GPT-6.2 Astra يتفوق على GPT-6 Astra بفارق 5.2 نقطة، وبكلفة تقل عن ثلث كلفة الأخير. وفي التقييم نفسه، يتفوق على Claude Fable 5.2 بفارق 5.5 نقطة، وبكلفة تعادل نحو 5% فقط من كلفته. وتوضح الحاشية السفلية أن نتائج Fable 5.2 الظاهرة في القائمة لا تشمل تسع مهام استخدم فيها نموذجًا احتياطيًا، لذا عند الاستشهاد بمجموعة المقارنة هذه يجب أخذ هذا الشرط بعين الاعتبار.
أما بيانات السيناريوهات القانونية فتأتي من Harvey LAB-AA v1.1. وتقول الجهة الرسمية إن معدل النجاح الذي حققه GPT-6.2 Astra يفوق ضعف معدل نجاح Claude Fable 5.2، وبكلفة تعادل نحو سدس كلفته، كما ستكون النتائج أعلى من ذلك في إعداد “Astra for Law” الموجه للمحامين. ولم تذكر مذكرة الإصدار أي معدل نجاح مطلق، ولذلك يمكن هنا تأكيد الأفضلية النسبية فقط، في حين يتعذر تأكيد درجة موثوقيته المطلقة في المهام القانونية.
في تقييم GDPval v2 الداخلي الرسمي، يتفوق GPT-6.2 Astra على GPT-6 Astra بفارق 6.2 نقطة مئوية، مع استهلاك توكنات إخراج أقل بنسبة 22%. كما استشهدت الجهة الرسمية بنتائج AA-AnalystAgent: فقد أجاب GPT-6.2 Astra عن 62.5% من الأسئلة إجابة صحيحة في جميع المحاولات الخمس المستقلة. يقيس هذا المؤشر درجة الاستقرار، وليس مجرد معدل الإصابة في محاولة واحدة، وهو ما يمنحه قيمة مرجعية أكبر بالنسبة إلى التسليمات التحليلية التي تتطلب نتائج قابلة للتكرار.
قدرات GPT-6.2 Astra في المهام العلمية (الإبلاغ الذاتي الرسمي + AA كطرف ثالث)
في المجال العلمي، يتوفر مصدران يدعم كل منهما الآخر. على صعيد الإبلاغ الذاتي الرسمي، تفوّق GPT-6.2 Astra على Terminal-Bench-Science 0.1 بفارق 9 نقاط مئوية عن GPT-6 Astra، وبتكلفة تقل عن الثلث. أما على Vals Science Index، فتذكر الجهات الرسمية أنه حقق رقمًا قياسيًا جديدًا، وإن لم تنشر الدرجة المطلقة.
ومن جهة الأطراف الثالثة، تؤكد مقالة AA كذلك أن GPT-6.2 Astra يتصدّر Terminal-Bench-Science 0.1. وفي المجموعة الفرعية الصعبة من CritPt v2، يحتل المرتبة الثانية مباشرة بعد Claude Fable 5.2. ومن هنا يتضح أن المشهد العلمي ليس من طرف واحد: سير العمل العلمي داخل الطرفية يمثل نقطة قوته، بينما تظل هناك منافسات أقوى في المسائل الصعبة ذات الطابع النظري والاستنباطي.
وهنا يكمن فخ يقع فيه الكثير بسهولة. فالحاشية الرسمية تشير إلى أن إحدى نتائج Fable 5.2 على Terminal-Bench-Science مأخوذة من AA وباستخدام mini-swe-agent، في حين تُبلغ Anthropic على حدة أن Fable 5.2 سجّل 74.6% على Claude Code وبمستوى استدلال Max. هذان الرقمان الخاصان بـ Fable صادران عن إعدادَي اختبار مختلفين، فلا يجوز التعامل معهما كأنهما مقارنة واحدة.
قدرات GPT-6.2 Astra في البرمجة والتصميم ثلاثي الأبعاد (بيانات الطرف الثالث من AA + نقلاً عن المصادر الرسمية)
الأدلة في اتجاه البرمجة متحفظة نسبيًا. يُظهر مؤشر وكلاء البرمجة (Coding Agent Index) من AA — ضمن بيئة Codex harness والفئة max — أن GPT-6.2 Astra يتعادل مع GPT-6 Astra، أي أن هذا الجيل لم يشهد قفزة ملحوظة في وكلاء البرمجة.
يقيس FrontierCode 2.0 مدى قدرة المشرفين على المشاريع على دمج التعديلات المقدمة لقواعد الشيفرة الحقيقية. وبطل هذا التقييم الفعلي هو Sol: فبحسب ما ذكرته الجهة الرسمية، لا يتجاوز الفارق بين GPT-6.2 Sol وGPT-6.2 Astra 0.5 نقطة، بينما تبلغ تكلفته خُمس تكلفة الأخير تقريبًا، مع استخدام كليهما للفئة Max. توضح هذه النتيجة أن Sol يبرز بوضوح من حيث القيمة مقابل التكلفة في هذا الاختبار، ولا يصح فهمها على أنها أفضلية إضافية لـ Astra في FrontierCode.
في اتجاه التوليد ثلاثي الأبعاد، نقلت المصادر الرسمية نتائج التقييم الأعمى البشري بمقياس Elo في AA-3D: سجل GPT-6.2 Astra 1318 نقطة، وClaude Fable 5.2 بـ 1271، وGPT-6.2 Sol بـ 1259. وفي المعاينة البحثية AA-Robotics v0.1 من AA، حصل Astra على 79 وSol على 78 وFable 5.2 على 75. يُعد بُعدا التوليد ثلاثي الأبعاد والروبوتات من الجوانب المحدودة القليلة التي يتقدم فيها Astra بشكل ملموس، لكن Robotics لا يزال في مرحلة المعاينة البحثية، فلا ينبغي تضخيم وزن هذه النتيجة.
إضافة إلى ذلك، تُظهر معدلات الهلوسة في AA-Omniscience (الفئة Max) أن GPT-6.2 Astra حقق 59% مقابل 55% لـ Sol. وعند إجراء مراجعة الشيفرة أو التحقق من الحقائق، يذكّرك هذا الرقم بأنك ما زلت بحاجة إلى تدقيق خارجي.
الأمن السيبراني والمواءمة في GPT-6.2 Astra (بطاقة النظام الرسمية)
وفقًا لبطاقة النظام، وصل كلٌّ من GPT-6.2 Astra وSol إلى مستوى «الحرج» في الأمن السيبراني، ومستوى «المرتفع» في المجالين البيولوجي والكيميائي ضمن إطار الاستعداد. كما يُعد GPT-6.2 Astra، وفقًا للبيانات الرسمية، أول نموذج يُطرح للجمهور يبلغ العتبة العالية لـ«التحسين الذاتي للذكاء الاصطناعي». وقد اكتفت منشورات الإطلاق بإسناد هذه النقطة إلى Astra دون Sol.
وبعد ارتفاع مستويات القدرات، أصبحت إجراءات الحماية أكثر صرامة. وقد اعترفت الشركة رسميًا بأن جزءًا من أبحاث الثغرات المشروعة سيُرفض. أما Daybreak الموجَّه للمدافعين، فيوفر حاليًا نسخة Alpha من GPT-6 Astra، وGPT-6 Sol على Daybreak Blue، وGPT-6 Cyber على Daybreak Red. وأوضحت الشركة أنها ستعمل على إدخال الإصدار 6.2 إلى Daybreak، لكن حتى الآن لم يدمج Daybreak الإصدار 6.2 بعد.
فيما يخص المواءمة، فإن معظم نتائج التقييم قريبة من نتائج GPT-6 Astra، مع حالات أقل من التصرفات غير الملائمة في بيئات العمل المحاكاة. غير أنه في اختبارين كان أكثر ميلاً إلى إغفال الإبلاغ عن المشكلات المعيقة، مثل الملفات المفقودة أو عدم توفر أدوات البحث. وبعد إضافة التعليمات المناسبة في Codex، انخفض هذا النوع من الإغفالات بشكل ملحوظ. وإذا كنت تبني سير عمل يعتمد على الوكلاء (Agent)، فننصحك بأن تطلب منه صراحةً في تعليمات النظام الإبلاغ عن أي عوائق تعترضه.
ملخص الأدلة عبر فئات المهام الأربع لنموذج GPT-6.2 Astra
| نوع المهمة | الأدلة الرئيسية | المصدر | قوة الاستنتاج |
|---|---|---|---|
| التسليم الاحترافي | سجّل ALE أداءً أعلى بـ 5.2 نقطة من GPT-6 Astra؛ ومعدل نجاح Harvey يفوق معدل Fable 5.2 بأكثر من الضعف؛ وأعلى بـ 6.2 نقطة مئوية في GDPval v2 | الإبلاغ الذاتي الرسمي | ميزة نسبية واضحة، لكن معظمها يفتقر إلى درجات مطلقة |
| العلوم | أعلى بـ 9 نقاط مئوية في Terminal-Bench-Science 0.1؛ وتشير AA أيضًا إلى الصدارة؛ والمركز الثاني في المجموعة الفرعية الصعبة من CritPt v2 | الإبلاغ الذاتي الرسمي + AA | متقدم في علوم الطرفية، لكن لديه منافسون في المسائل النظرية الصعبة |
| البرمجة | مؤشر Coding Agent Index متكافئ مع GPT-6 Astra | تقييم خارجي من AA | لا قفزة بين الأجيال |
| ثلاثي الأبعاد | تقييم Elo يبلغ 1318 في AA-3D، أي أعلى من Fable 5.2 وSol | نقلاً عن AA رسميًا | الصدارة في هذا المجال |
| الأمن السيبراني | مصنّف بمستوى “شديد الخطورة”؛ وقد تُرفض مهام أبحاث الثغرات المشروعة؛ وDaybreak غير مدمج في الإصدار 6.2 | بطاقة النظام الرسمية | قدرات قوية لكن إمكانية الاستخدام محدودة |
بيانات تقييم GPT-6.2 Astra: تغيّر الدرجة الإجمالية باختلاف مستويات الاستدلال
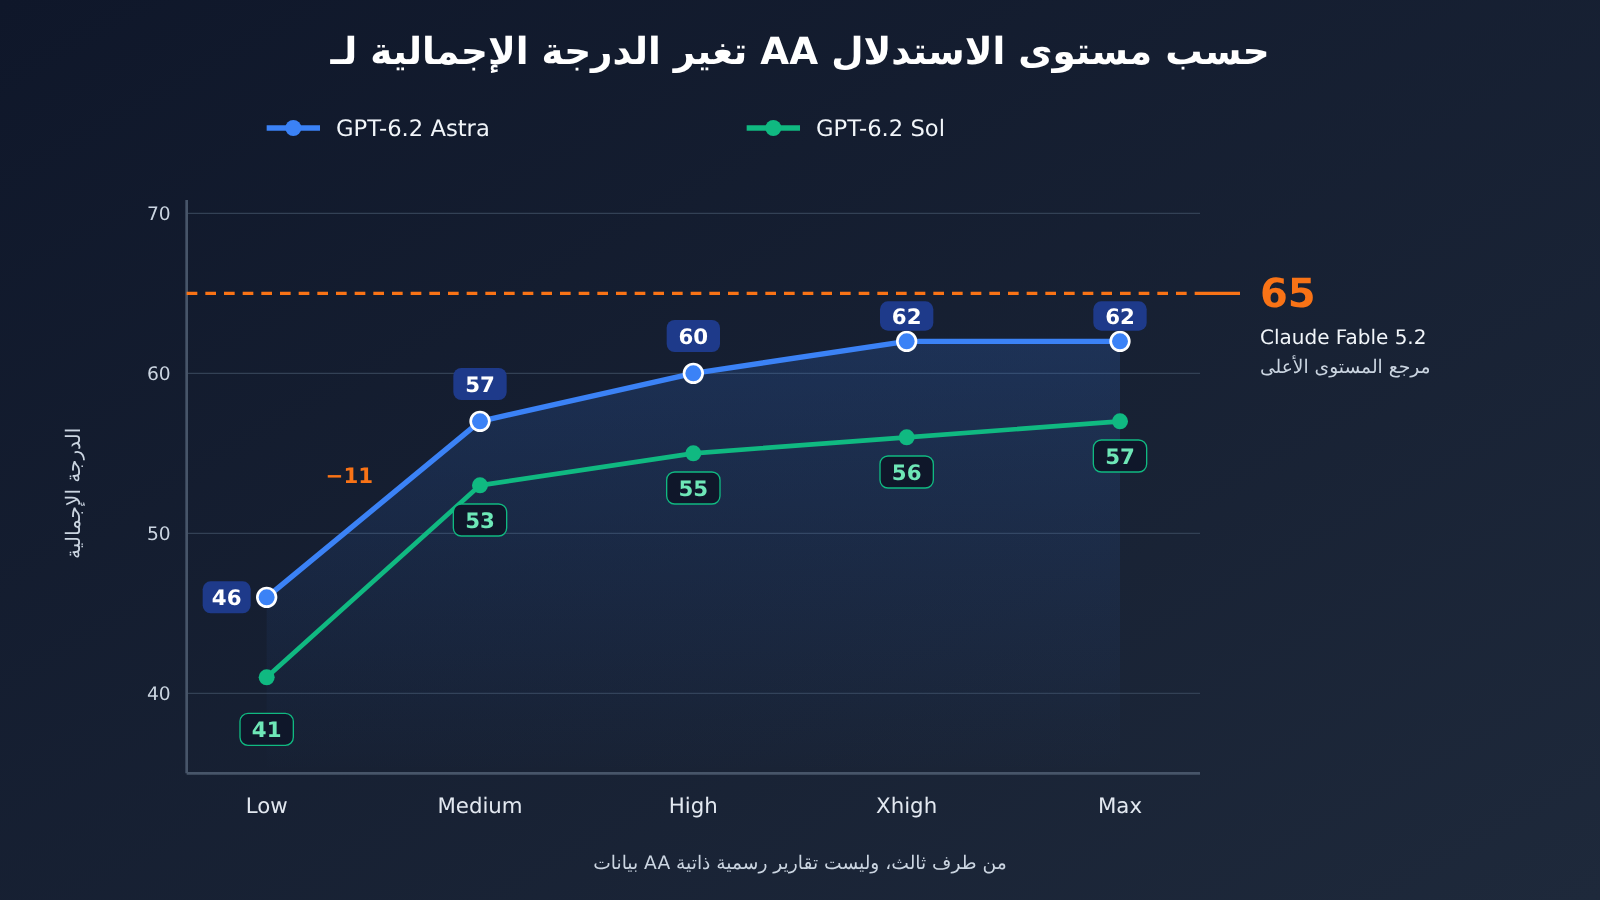
يُعد مؤشر الذكاء Intelligence Index v5.0.1 الصادر عن AA أكثر الدرجات الإجمالية من طرف ثالث استشهادًا في الوقت الحالي. فعند أعلى مستوى استدلال، تحتل Claude Fable 5.2 الصدارة بدرجة 65. بينما تسجّل GPT-6.2 Astra درجة 62 عند مستويَي Max وXhigh، متفوقةً على Gemini 4 Carbon البالغة درجتها 60 في أعلى مستوى، وعلى Claude Opus 5.5 البالغة درجتها 59، ومسجلةً 5 نقاط أكثر من GPT-6 Astra.
ما يستحق الانتباه حقًا هو فارق الأداء الذي تُحدثه مستويات الاستدلال. فالجدول التالي مبني بالكامل على بيانات AA من طرف ثالث:
| مستوى الاستدلال | GPT-6.2 Astra | GPT-6.2 Sol | ملاحظات |
|---|---|---|---|
| Max | 62 | 57 | Astra تحقق الدرجة نفسها عند Max وعند Xhigh |
| Xhigh | 62 | 56 | Astra لم تفقد أي نقاط عند هذا المستوى بعد |
| High | 60 | 55 | انخفاض بمقدار نقطتين |
| Medium | 57 | 53 | درجة Astra عند Medium تساوي درجة Sol عند Max |
| Low | 46 | 41 | هبوط حاد كالهاوية |
من Max إلى Low، تراجعت GPT-6.2 Astra بمقدار 16 نقطة، منها 11 نقطة في الانتقال من Medium إلى Low وحده. فإذا خفّضت مستوى الاستدلال إلى Low توفيرًا للتكلفة، فلن تحصل بعد الآن على «Astra ذات الـ 62 نقطة». والاكتفاء بالنظر إلى أعلى درجة في قائمة الترتيب عند اختيار النموذج يجعلك تبالغ بسهولة في تقدير الأداء الفعلي وقت النشر.
أما معيار التكلفة فيأتي من AA أيضًا. فمن حيث تكلفة المهمة الواحدة في المؤشر الإجمالي، تبلغ تكلفة GPT-6.2 Astra (Max) $4.00، وتكلفة GPT-6.2 Sol (Max) $1.01، فيما تدرج صفحة Claude Fable 5.2 مبلغًا قدره $26.54. لكن هذه تكلفة مجموعة مهام AA تحديدًا، فلا يمكن مقارنتها أو الاستناد إليها في الاستنتاج المتبادل مع التصريح الرسمي بأن «تكلفة ALE تعادل نحو 5% من تكلفة Fable 5.2».
مواصفات GPT-6.2 Astra وأسعاره الرسمية
المواصفات والأسعار المعتمدة هي المذكورة في صفحة النموذج على موقع OpenAI. معرّف الطراز هو gpt-6.2-astra، ويدعم الإدخال النصوص والصور، بينما الإخراج نصوص فقط، ولا يدعم الصوت أو الفيديو. تبلغ نافذة السياق 1,050,000 توكن، بحد أقصى للإدخال 922,000 توكن وحد أقصى للإخراج 128,000 توكن، ويصل تاريخ قطع المعرفة إلى 2026-05-18، مع دعم توكنات الاستدلال. لا تقبل واجهة API تعيين قيمة reasoning effort على none.
| البند | القيم الرسمية لـ GPT-6.2 Astra (لكل مليون توكن) |
|---|---|
| الإدخال (الفئة القياسية للسياق القصير) | $8 |
| القراءة من ذاكرة التخزين المؤقت | $0.40 |
| الكتابة إلى ذاكرة التخزين المؤقت (تُحفظ لمدة 30 دقيقة) | $10 |
| الكتابة إلى ذاكرة التخزين المؤقت (تُحفظ لمدة 12 ساعة) | $20 |
| الإخراج | $40 |
| نقاط النهاية المدعومة | Chat Completions وResponses وBatch |
ما سبق هو الأسعار الرسمية المعلنة من OpenAI. طراز gpt-6.2-astra غير متوفر بعد على منصة APIYI، وسنعمل على إضافته في أقرب وقت ممكن؛ ويُعتمد الطراز والسعر وفقًا لقائمة الطرازات على المنصة. وخلاصة بيان الإصدار: الإدخال والإخراج أقل بنسبة 20% مقارنة بـ GPT-6 Astra، بينما الإدخال المخزَّن مؤقتًا أقل بنسبة 60%.
توجد تفاصيل أخرى في قواعد التسعير تستحق الانتباه. فعندما يتجاوز إدخال الطلب الواحد 272K توكن، يتضاعف سعر الوحدة للإدخال وذاكرة التخزين المؤقت، ويُحسب الإخراج بمعدل 1.5 ضعف سعر السياق القصير، ويُطبق ذلك على الطلب بأكمله. أما Batch فيُسعَّر بنسبة 50% من السعر القياسي، وFast بمعدل ضعف السعر القياسي لنفس طول السياق. ويبقى Ultrafast بسعر 3 أضعاف السعر القياسي حتى 2027-02-28 (بتوقيت المحيط الهادئ)، ثم يرتفع إلى 6 أضعاف اعتبارًا من 2027-03-01.
وكمقارنة، تبلغ الأسعار الرسمية لـ GPT-6.2 Sol: الإدخال $2، والقراءة من ذاكرة التخزين المؤقت $0.10، والإخراج $10. وطراز gpt-6.2-sol كذلك غير متوفر بعد على منصة APIYI، وسنعمل على إضافته في أقرب وقت ممكن؛ ويُعتمد الطراز والسعر وفقًا لقائمة الطرازات على المنصة.
عند البحث عن طراز، يمكنك مراجعة مكانين في آن واحد: الجدول الشامل للطرازات على APIYI عبر apiyi.com (docs.apiyi.com/models.md)، وكذلك واجهة التسعير https://api.apiyi.com/api/pricing. وحتى وقت بيانات الجدول الشامل بتاريخ 2026-11-17 الساعة 15:54 (UTC+8)، لم يكن أي من المكانين يتضمن gpt-6.2-astra أو gpt-6.2-sol. أما طراز gpt-6-astra المتوفر حاليًا في الجدول الشامل فهو من الجيل السابق، ولا يصلح سعره على المنصة مرجعًا لأسعار إصدار 6.2.
البدء السريع مع GPT-6.2 Astra: اختر المهمة أولًا، ثم حدّد مستوى الاستدلال
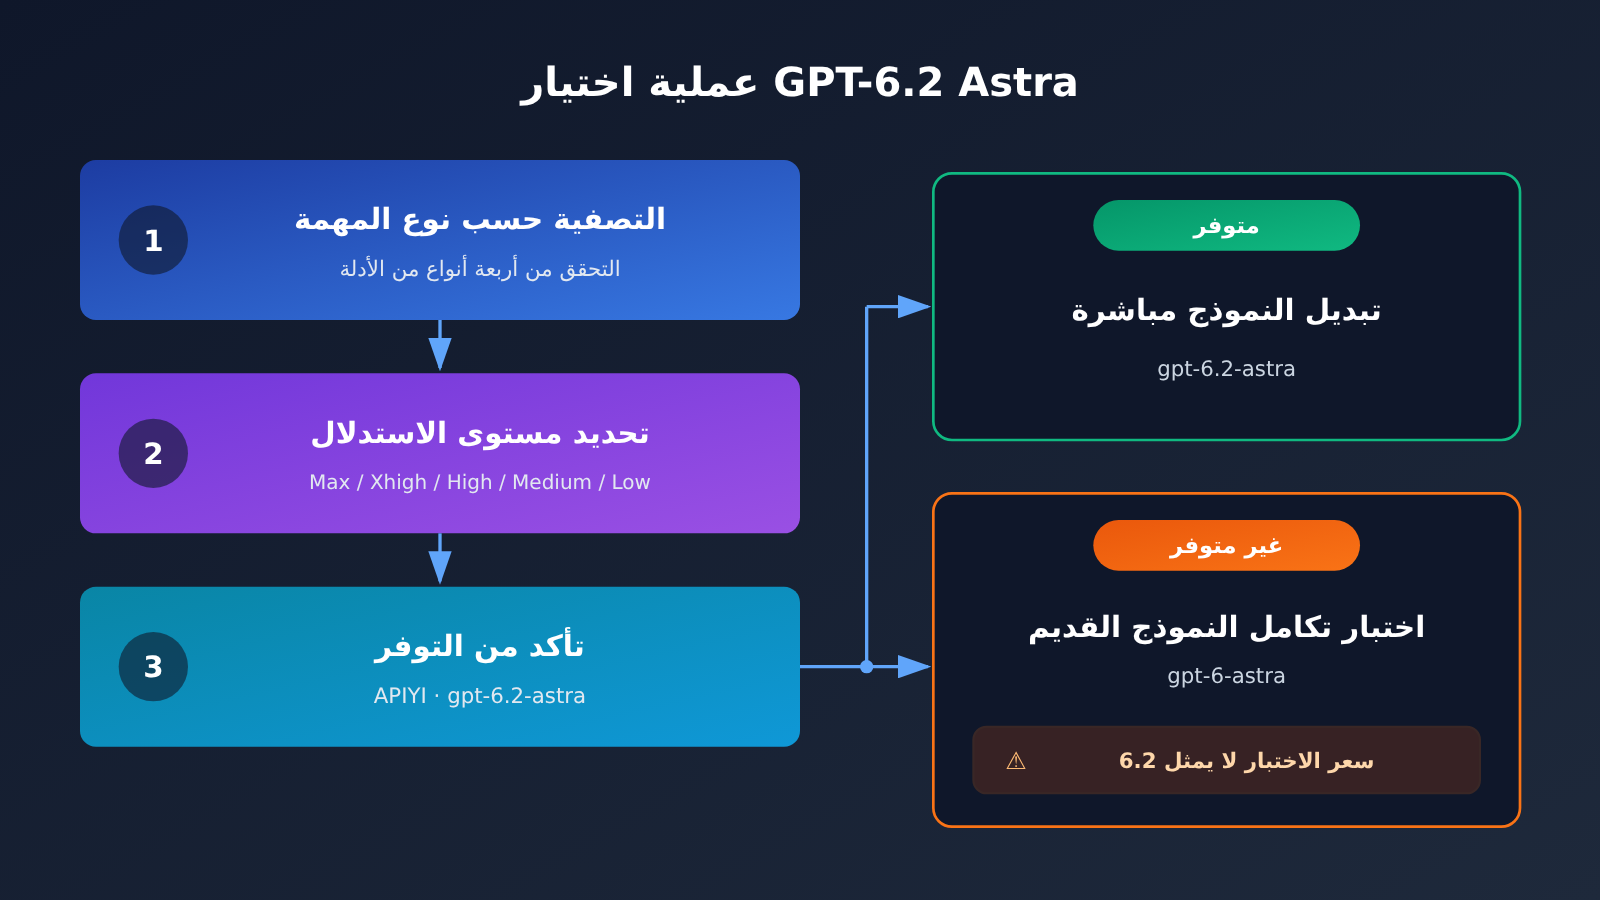
قبل أن تقرر تكليف GPT-6.2 Astra بمهمة صعبة، ننصحك باتباع ترتيب التقييم التالي:
- ابدأ بحسب المهمة. قارن مع فئات الأدلة الأربع المذكورة سابقًا. إذا كانت المهمة تسليم مستندات احترافية أو سير عمل علمي متكامل، فلدى Astra أدلة رسمية أوضح؛ أما إذا كانت المهام في معظمها من نوع دمج الأكواد، فقيّم أولًا مدى كفاية Sol لاحتياجاتك؛ وإذا كان الأمر أبحاثًا عن الثغرات الأمنية، فتوقّع أن تُرفض بعض الطلبات.
- ثم حدّد مستوى الاستدلال. تذكّر حجم الفجوة في درجات تقييم AA: يحقق Max وXhigh درجة 62، بينما يحصل High على 60، وMedium على 57، وLow على 46. بالنسبة للمهام الحساسة للتكلفة، يمكنك البدء بمستوى High أو Medium لإجراء مقارنة A/B، أما الاعتماد على Low مباشرة في المهام الصعبة فغير موصى به.
- وأخيرًا راجع قائمة المنصة. افتح قائمة النماذج على APIYI عبر apiyi.com وابحث عن
gpt-6.2-astra. إذا كان النموذج متوفرًا بالفعل، فما عليك سوى تغيير قيمة حقل model في الطلب إلى هذا النموذج.
إذا لم يكن 6.2 متوفرًا في القائمة بعد، فيمكنك مؤقتًا استخدام النموذج gpt-6-astra المتاح فعلًا لإجراء اختبار التوافق البروتوكولي: اضبط base_url في عميلك المتوافق مع OpenAI على https://api.apiyi.com/v1، وضع gpt-6-astra في حقل model، ثم جرّب بنية طلبات Chat Completions أو Responses والمخرجات المتدفقة ومعاملات الاستدلال حتى تسير جميعها بسلاسة. من المهم التوضيح أن هذه الخطوة تتحقق من بروتوكول الواجهة فقط؛ فالفواتير خلال اختبار التوافق تُحتسب وفق أسعار gpt-6-astra وليس وفق أسعار 6.2، كما أن النتائج الحالية لا تعبّر عن قدرات 6.2.
هناك بعض المعاملات التي يجدر التحقق منها مسبقًا أثناء اختبار التوافق: لا يمكن تمرير القيمة none في reasoning effort؛ وعند المدخلات الطويلة انتبه لعتبة 272K التي يتضاعف عندها تسعير الطلب بالكامل؛ وإذا كنت تنفذ مهام دفعية دون اتصال، فيمكنك تقييم تسعيرة Batch المخفّضة إلى النصف. وكل هذه الإعدادات يمكن إبقاؤها كما هي بعد طرح 6.2 على المنصة.
🚀 نصيحة للبدء: توفر لك APIYI عبر apiyi.com واجهة متوافقة مع OpenAI، بحيث يكفيك مفتاح API واحد لاستدعاء نماذج من مزودين متعددين، ويحصل المستخدمون الجدد على رصيد تجريبي مجاني. ننصحك أولًا بتشغيل مسار الطلبات بالكامل باستخدام النماذج المتاحة حاليًا، وبعد طرح 6.2 لن تحتاج سوى إلى تغيير اسم النموذج لإتمام التبديل.
مرجع اختيار المهام لـ GPT-6.2 Astra
| نوع المهمة | هل تُمنح Astra الأولوية؟ | مستوى الاستدلال المبدئي المقترح | ما يجب الانتباه إليه |
|---|---|---|---|
| تسليم مستندات احترافية طويلة النطاق | نعم | ابدأ بـ High، واستخدم Max للتسليمات الحاسمة | المقارنات الرسمية تعتمد غالبًا على قيم نسبية |
| سير العمل العلمي في الطرفية | نعم | High أو Xhigh | قد توجد منافسة أقوى في المسائل النظرية الصعبة |
| تعديلات دمج الشيفرة البرمجية | قيّم Sol أولًا | اختر وفق الميزانية | لم يسجّل مؤشر Coding Agent Index أي قفزة |
| التوليد ثلاثي الأبعاد | ممكن | اضبط وفق النتائج | AA-3D تقييم Elo أعمى، وهو منقول رسميًا |
| أبحاث الثغرات | بحذر | لا ينطبق | قد تُرفض الطلبات، ولم يُتاح الإصدار 6.2 على Daybreak بعد |
مستويات الاستدلال المبدئية الواردة في الجدول هي توصيات مبنية على فوارق درجات AA، وليست قيمًا رسمية موصى بها. قبل الإطلاق الفعلي، قارن الأداء باستخدام عينات مهامك الخاصة.
تحليل مزايا وعيوب GPT-6.2 Astra
المزايا
- أدلة متعددة على التميز في التسليم الاحترافي: مؤشرات أبلغت عنها الشركة رسميًا — منها ALE وHarvey LAB-AA وGDPval v2 وAA-AnalystAgent — تشير جميعها إلى الاتجاه نفسه، ويرافق ذلك في معظمها انخفاض في التكلفة.
- تأكيد من مصدرين للأداء العلمي الطرفي: كل من الإعلانات الرسمية وتقييمات الطرف الثالث لدى AA تُظهر تفوقه في Terminal-Bench-Science 0.1.
- انخفاض التكلفة لكل وحدة: التسعير الرسمي أقل من GPT-6 Astra بنسبة 20% للإدخال والإخراج، وبنسبة 60% للإدخال المخزّن مؤقتًا؛ كما انخفضت مخرجات الـ token على GDPval v2 بنسبة 22% أيضًا.
- سياق طويل ومخرجات كبيرة: نافذة سياق تبلغ 1,050,000 وحد أقصى للمخرجات يبلغ 128,000، ما يجعله مناسبًا لمعالجة المادة كاملة دفعة واحدة.
القيود
- ليس الأول في الدرجة الشاملة: على أعلى مستوى لدى AA حقق Claude Fable 5.2 درجة 65 مقابل 62 لـ GPT-6.2 Astra. في السيناريوهات التي تتطلب الأداء الشامل الأقوى، أجرِ اختبارات مقارنة أولًا.
- حساسية تجاه مستوى الاستدلال: عند المستوى Low لا يتجاوز الدرجة 46. قبل خفض المستوى، احرص على إجراء اختبار انحدار باستخدام مهامك الخاصة.
- لا تحسّن جيليًا في البرمجة: مؤشر Coding Agent Index لدى AA متعادل مع GPT-6 Astra؛ في مهام دمج الشيفرة يمكن تقييم Sol الأقل تكلفة أولًا.
- قيود على أبحاث الأمان: قد تُرفض بعض أبحاث الثغرات المشروعة، والإصدار 6.2 غير متوفر على Daybreak بعد. سيتعين على فرق الأمان مؤقتًا مواصلة استخدام سلسلة GPT-6 على Daybreak.
- إغفال الإبلاغ عن العوائق: في اختبارين، كان أكثر عرضة لإغفال مشكلات مثل الملفات المفقودة أو الأدوات غير المتاحة؛ في سير عمل الوكيل (Agent)، اطلب منه صراحةً الإبلاغ عن العوائق التي تعترضه.
- معدل هلوسة غير منخفض: بلغ معدل الهلوسة في AA-Omniscience (بالمستوى Max) 59%؛ ما يزال التحقق الخارجي ضروريًا للمخرجات المتعلقة بالوقائع.
الأسئلة الشائعة FAQ
س1: ما هو GPT-6.2 Astra؟
GPT-6.2 Astra هو نموذج أعلنت عنه OpenAI في 2026-11-17، وطُرح ضمن الدفعة نفسها التي شملت GPT-6.2 Sol، ومعرّف النموذج هو `gpt-6.2-astra`. يستقبل النصوص والصور ويُخرج نصوصًا، وتبلغ نافذة السياق لديه 1,050,000 توكن، ويمكن استخدامه في ChatGPT Work وCodex وOpenAI API.
س2: هل GPT-6.2 Astra هو أقوى نموذج حاليًا؟
لا يمكن الحسم بذلك بشكل مطلق. فوفقًا للشريحة الأعلى في المؤشر الشامل الصادر عن الجهة الخارجية AA، حصل Claude Fable 5.2 على 65 نقطة مقابل 62 نقطة لـ GPT-6.2 Astra. وتشير الأدلة إلى تقدّمه في أبعاد محددة مثل التسليم الاحترافي والعلوم الطرفية وثلاثي الأبعاد، لكن مؤشر Agent البرمجي بقي عند مستوى الجيل السابق، لذا يجب تقييم أدائه مهمةً تلو الأخرى.
س3: لماذا يحصل GPT-6.2 Astra نفسه على درجات مختلفة؟
لأن درجات AA مرتبطة بمستوى الاستدلال: يحقق المستويان Max وXhigh درجة 62، وHigh درجة 60، وMedium درجة 57، وLow درجة 46. كلما انخفض مستوى الاستدلال، قلّ الاستهلاك وانخفضت الدرجة معه. وعند الاستشهاد بأي درجة، يُرجى ذكر مستوى الاستدلال الخاص بها.
س4: هل GPT-6.2 Astra مناسب لأبحاث الثغرات الأمنية؟
يجب توخّي الحذر. فقد وصل النموذج إلى مستوى “الخطورة الشديدة” في الأمن السيبراني، ما جعل إجراءات الحماية أكثر صرامة، وسيُرفض جزء من أعمال أبحاث الثغرات المشروعة. أما Daybreak الموجَّه لجهة الدفاع، فلم يُربط بعد بالإصدار 6.2، واكتفت الجهة الرسمية بالتأكيد على أنها ستعمل على إدخاله مستقبلًا.
س5: هل يمكن حاليًا استدعاء gpt-6.2-astra عبر APIYI؟
بحسب الجدول الشامل وواجهة التسعير حتى تاريخ 2026-11-17 الساعة 15:54 (UTC+8)، لا يزال gpt-6.2-astra غير متوفر، وسنعمل على إتاحة هذا النموذج في أقرب وقت؛ ويُعتمد في تحديد النماذج والأسعار على قائمة النماذج في المنصة. وقبل ذلك، يمكنك إجراء اختبار التكامل على مستوى البروتوكول عبر APIYI على apiyi.com باستخدام النموذج المتاح `gpt-6-astra`. علماً بأن الرسوم الناتجة عن هذا الاختبار تخص gpt-6-astra، ولا تعكس سعر الإصدار 6.2.
س6: ما هو السعر الرسمي لـ GPT-6.2 Astra؟
السعر الرسمي المعلن من OpenAI لكل مليون توكن هو: الإدخال $8، وقراءة الذاكرة المؤقتة $0.40، وكتابة الذاكرة المؤقتة لمدة 30 دقيقة $10، والإخراج $40. وإذا تجاوزت مدخلات الطلب الواحد حدّ 272K، يرتفع سعر الطلب بأكمله. النموذج غير متوفر بعد على APIYI، وسنعمل على إتاحته في أقرب وقت؛ ويُعتمد في تحديد النماذج والأسعار على قائمة النماذج في المنصة.
س7: ما أوجه القصور المعروفة في GPT-6.2 Astra؟
تتمثل الملاحظات الرئيسية في أربع نقاط: انخفاض ملحوظ في درجات مستوى الاستدلال المنخفض؛ وثبات قدرات وكيل البرمجة (Code Agent) عند مستوى الجيل السابق؛ وبلوغ معدل الهلوسة في AA-Omniscience (عند مستوى Max) نسبة 59%؛ إضافة إلى ميل النموذج في بعض الاختبارات إلى إغفال الإبلاغ عن عوائق مثل الملفات المفقودة أو الأدوات غير المتاحة. يمكن التخفيف من النقاط الثلاث الأولى عبر اختيار المستوى المناسب والتحقق الخارجي، أما النقطة الأخيرة فيمكن معالجتها بتضمين طلب صريح في التعليمات يُلزم النموذج بالإبلاغ عن أي عوائق.
GPT-6.2 Astra: النقاط الأساسية (Key Takeaways)
- أكبر قدر من أدلة التسليم الاحترافي: التقارير الرسمية الذاتية في ALE وHarvey وGDPval v2 تُظهر جميعها تحسنًا بتكلفة أقل.
- إثبات من مصدرين للأداء في الترمينال العلمي: كلٌّ من التقارير الرسمية الذاتية والتقييم الخارجي من AA يؤكد تفوق Terminal-Bench-Science.
- لا قفزة في البرمجة: مؤشر AA Coding Agent Index مماثل لمستواه في GPT-6 Astra، وأفضل قيمة مقابل السعر ضمن FrontierCode تعود إلى Sol.
- الدرجة الإجمالية تتوقف على مستوى الاستدلال: درجات AA هي 62 عند Max/Xhigh، و60 عند High، و57 عند Medium، و46 عند Low.
- قدرات أمان قوية لكنها مقيّدة: يصل إلى مستوى «الخطورة الحرجة»، وقد يرفض أبحاث الثغرات المشروعة، كما أن Daybreak غير مدمج في 6.2.
- ترتيب خطوات البدء: اختر النموذج حسب المهمة، ثم حدد مستوى الاستدلال، وأخيرًا تحقق من توفره ضمن قائمة النماذج على APIYI (apiyi.com).
الخلاصة
النقاط الأساسية في GPT-6.2 Astra:
- النقاط القوية حسب المهمة: الأدلة الأكثر رسوخًا تتعلق بتسليم المستندات المتخصصة والمهام العلمية عبر الطرفية، مع صدارة في بنود فردية ضمن ثلاثة مجالات، بينما يحافظ الأداء البرمجي على مستوى الجيل السابق.
- الدرجات حسب مستوى الاستدلال: الدرجة التجميعية من الجهة الخارجية AA تنخفض من 62 عند مستوى Max إلى 46 عند مستوى Low، واختيار المستوى يؤثر مباشرةً على النتائج.
- الأرقام حسب المصدر: الأرقام المعلنة رسميًا وأرقام AA كطرف ثالث تمثل منهجيتين مختلفتين، ولا يمكن تحويل التكاليف أو الدرجات من أحدهما إلى الآخر.
- تقييم سيناريوهات السلامة بشكل منفصل: الحماية أكثر صرامة، ولم تُدمج Daybreak بعد في الإصدار 6.2.
إذا كانت بين يديك مهمة صعبة، ننصحك أولًا بمراجعة أنواع الأدلة الأربعة لتحديد ما إذا كانت تقع ضمن نقاط قوة Astra، ثم إجراء مقارنة بين مستويات الاستدلال المختلفة باستخدام عيناتك الخاصة.
وقبل إتاحة الإصدار 6.2 على المنصة، يمكنك عبر APIYI على apiyi.com تشغيل سلسلة استدعاء النموذج كاملة باستخدام النماذج المتاحة حاليًا؛ وبعد إتاحته، ما عليك سوى التبديل إلى اسم النموذج الجديد، مع اعتماد الأسعار الفعلية الواردة في قائمة نماذج المنصة.
📚 المراجع
-
منشور الإطلاق من OpenAI: التعريف الرسمي بنموذجي GPT-6.2 Astra وSol والنتائج المعلنة رسميًا
- الرابط:
openai.com/index/introducing-gpt-6-2-astra-sol - الوصف: ملخص للنتائج النسبية والأسعار المتعلقة بالتسليم المتخصص والعلوم والبرمجة
- الرابط:
-
بطاقة النظام من OpenAI: مستويات السلامة وتقييمات المواءمة
- الرابط:
deploymentsafety.openai.com/gpt-6-2-astra-sol - الوصف: تصنيف “خطير” للأمن السيبراني، وعتبة مرتفعة للتحسين الذاتي للذكاء الاصطناعي، والوضع الحالي لـ Daybreak
- الرابط:
-
صفحة النموذج من OpenAI: المواصفات والأسعار الرسمية المعتمدة
- الرابط:
platform.openai.com/docs/models/gpt-6.2-astra - الوصف: نافذة السياق ونقاط النهاية وقواعد تسعير 272K ومضاعفات Batch/Fast/Ultrafast
- الرابط:
-
مقال التقييم من Artificial Analysis: المؤشر التجميعي من طرف ثالث وبنوده الفرعية
- الرابط:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - الوصف: الدرجات التجميعية لكل مستوى استدلال، ومؤشر Coding Agent Index، ومعدل الهلوسة، وRobotics
- الرابط:
-
صفحة النموذج من Artificial Analysis: تكلفة المهمة الواحدة لنموذج GPT-6.2 Astra
- الرابط:
artificialanalysis.ai/models/gpt-6-2-astra - الوصف: منهجية تكلفة المهمة الواحدة وفق المؤشر التجميعي
- الرابط:
الكاتب: الفريق التقني في APIYI
للتواصل التقني: يسعدنا تواصلكم عبر الصفحة الرئيسية للموقع الرسمي لـ APIYI، ولمزيد من النماذج وتعليمات التكامل، يمكنك الرجوع إلى مركز الوثائق على docs.apiyi.com


