
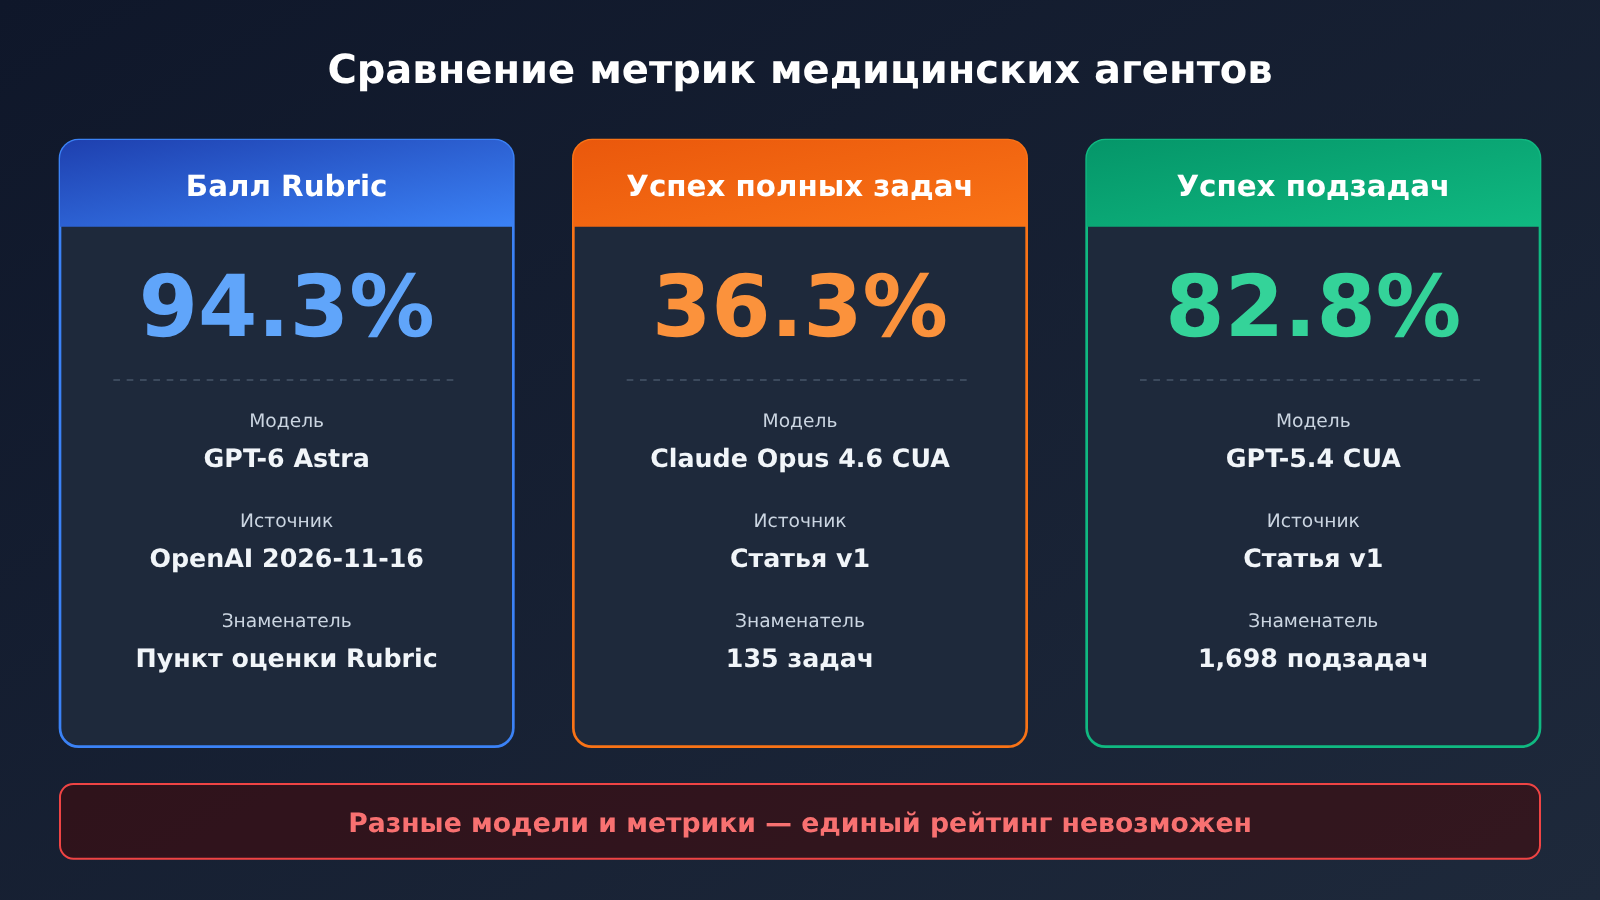
94.3% не означает, что 94.3% медицинских административных задач были выполнены полностью. 94.3% GPT-6 Astra, объявленные OpenAI 16 ноября 2026 года, — это доля баллов по rubric points (оценочным пунктам) в HealthAdminBench; 36.3% Claude Opus 4.6 CUA из статьи лаборатории Shah Lab Стэнфордского университета — это успешность полных задач (full-task success). Первый показатель измеряет «сколько оценочных пунктов выполнено», второй — «сколько задач полностью удовлетворяют условиям успеха». Это разные метрики, и их нельзя ставить в один рейтинг.
Медицинский Agent может отлично справляться с отдельными операциями — поиском информации, обработкой документов, заполнением форм — и при этом всё равно не проходить стабильно через сквозной межсистемный бизнес-процесс. Чтобы понять, есть ли у Agent производственная ценность, нужно смотреть одновременно на качество выполнения подзадач, сквозную успешность, типы ошибок, стоимость выполнения и вмешательство человека. Любого единственного балла для этого недостаточно.
Что вы узнаете из этой статьи?
- что именно считают 94.3% и 36.3% и почему их нельзя сравнивать напрямую
- из чего состоит HealthAdminBench, откуда берутся оценочные пункты и какие есть два механизма проверки
- набор критериев оценки, ориентированных на продакшен и переносимых на других корпоративных Agent
Содержание: в части объективных фактов последовательно разбираем, почему результат 94.3% привлёк внимание, что именно измеряет HealthAdminBench, в чём разница между успехом подзадачи и успехом полной задачи, на каких этапах медицинский Agent чаще всего терпит неудачу и почему одна и та же модель может показывать разные результаты в зависимости от исполнительного фреймворка. В аналитической части говорим о том, как построить комплексную систему оценки, как считать стоимость и какие компромиссы выбирать компаниям при внедрении.
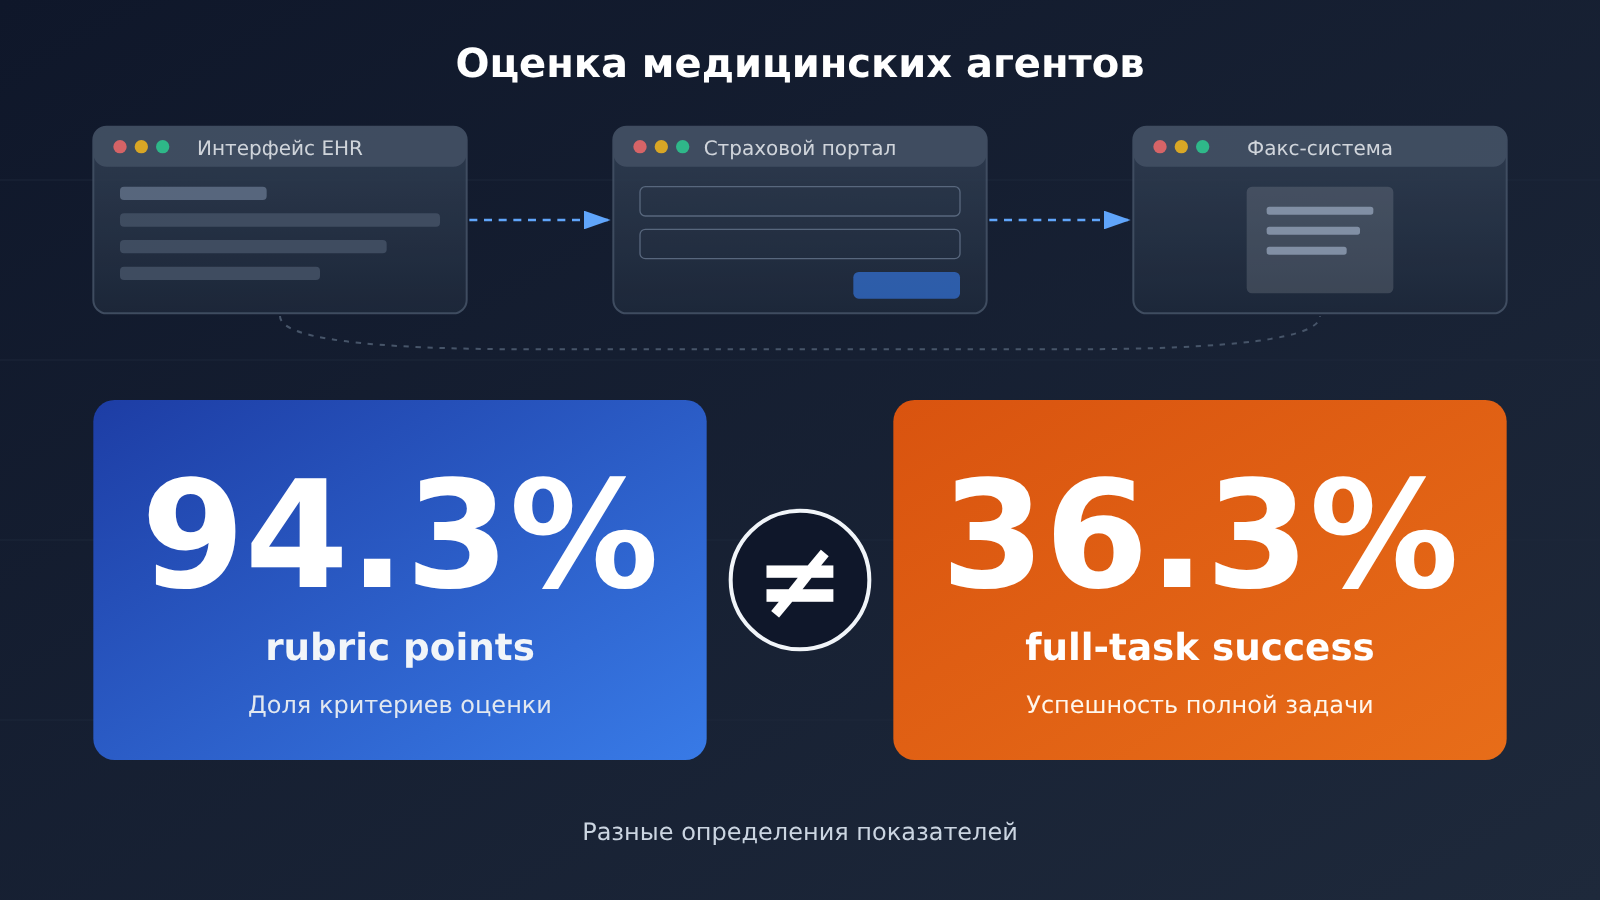
Что нужно знать: 7 понятий, чтобы разобраться в оценке медицинских агентов
| Понятие | Краткое пояснение |
|---|---|
| Computer Use | Способность выполнять задачи, наблюдая за интерфейсом программы и имитируя клики, ввод, прокрутку и другие действия |
| EHR | Электронная система медицинских записей — ключевое ПО больницы для хранения информации о лечении пациентов |
| MCP | Стандартный протокол для обнаружения и вызова внешних инструментов |
| RPA | Автоматизация повторяющихся процессов с помощью заранее настроенных правил или скриптов |
| Баллы по рубрике | Баллы, начисляемые по правилам оценки и показывающие, насколько выполнены отдельные требования |
| Сквозной процент успешных выполнений | Доля задач, полностью удовлетворяющих всем условиям успеха; если провалено любое ключевое условие, задача считается неуспешной |
| Trace | Запись хода выполнения, действий и состояний интерфейса — доказательство траектории |
Кратко о влиянии оценки медицинских агентов
- Разработчики и технические руководители: нельзя выбирать решение только по одному показателю, опубликованному производителем. Нужно проверять механизм выполнения, сквозную долю успешных выполнений и полные затраты — включая скриншоты, повторные попытки и среду выполнения — на собственных задачах.
- Медицинские организации и руководители рабочих процессов: нужно различать четыре типа доказательств — демонстрации в синтетической среде, бенчмарк-оценки, пилоты в учреждениях и продакшн-кейсы. А при развёртывании — внедрять ручное утверждение, минимально необходимые права доступа и аудит действий.
Объективные факты: что стоит за 94.3% и 36.3% в оценке медицинских агентов
Почему результат 94.3% привлёк внимание?
16 ноября 2026 года OpenAI опубликовала материалы о прогрессе в области агентов, работающих с компьютером, для медицинских команд, и раскрыла несколько наборов данных оценки. В частности, GPT-6 Astra получила 94.3% на HealthAdminBench, GPT-6 Luna — 91.8%; обе модели оценивались при максимальной интенсивности рассуждений (maximum reasoning effort). OpenAI также сообщила, что стоимость одной задачи у Luna составляет 0.085 доллара — на 98% меньше, чем у Astra.
Эти цифры привлекают внимание потому, что ранее опубликованные Стэнфордом результаты HealthAdminBench были заметно ниже. Важно подчеркнуть: 94.3% и 91.8% в публикации OpenAI — это доля баллов по рубрикам (rubric points), а не независимая доля полностью успешно выполненных задач. Две другие группы данных из того же сообщения тоже относятся к разным этапам оценки, и знаменатели у них разные:
| Метрика | Значение | Знаменатель / база расчёта | Что это не означает |
|---|---|---|---|
| Оценка HealthAdminBench (Astra) | 94.3% | доля rubric points | долю полностью успешных задач |
| Оценка HealthAdminBench (Luna) | 91.8% | доля rubric points | долю полностью успешных задач |
| Безопасность клинических задач (Astra) | 99% | 325 проверенных задач | точность медицинской диагностики |
| Доля высокой оценки со стороны врачей (Astra) | 93% | 646 оценок от врачей | успешность задач; это и не 646 врачей |
| Стоимость одной задачи (Luna) | $0.085 | стоимость одной задачи в конкретных условиях оценки | цену при развёртывании в продакшене |
У этих трёх наборов данных разные знаменатели, и их нельзя свести в одну «сводную точность». Кроме того, в тексте публикации OpenAI не раскрыты результаты по каждой задаче, полная конфигурация экспериментов, доверительные интервалы и все случаи провалов, поэтому внешние наблюдатели пока не могут независимо проверить, из чего складывается оценка 94.3%. Стоимость одной задачи у Astra — около 4.25 доллара; это оценка, полученная обратным расчётом из снижения на 98%, а не цена, которую OpenAI прямо опубликовала.
Что на самом деле измеряет HealthAdminBench?
HealthAdminBench предложен лабораторией Shah Lab Стэнфордского университета и предназначен для оценки того, как компьютерные агенты-операторы справляются с административными задачами в медицине. Публичная версия бенчмарка менялась: на ранней странице исследования было указано 70 задач, 947 оценочных точек и 6 агентов; в версии статьи 2604.09937v1 эти цифры выросли до 135 задач, 1 698 проверяемых подзадач и 7 конфигураций моделей. В этой статье мы опираемся на версию из статьи, а данные ранней веб-страницы используем только как исторический ориентир.
В версии статьи четыре смоделированные среды GUI — это EHR, портал страховых выплат A, портал страховых выплат B и портал факсимильной связи. 135 задач делятся на три типа административных рабочих процессов:
| Тип задачи | Количество | Основное содержание |
|---|---|---|
| Prior Authorization (предварительное согласование) | 60 | Проверка права на страховое покрытие, сбор медицинской документации, подача заявки на предварительное согласование |
| Appeals and Denials Management (апелляции и работа с отказами) | 60 | Проверка отказов, сбор подтверждающих документов, подготовка и подача апелляции |
| DME Order Processing (заказы на медицинское оборудование) | 15 | Сбор документов на медицинское оборудование, оформление заказа, фиксация результата |
1 698 оценочных точек формируются двумя механизмами. В 1 177 случаях применяется детерминированная проверка: с помощью структурированных средств вроде JMESPath сверяется состояние системы — например, найден ли нужный пациент, заполнены ли заданные поля, создан ли правильный заказ. По сути это близко к традиционному тестированию ПО. Ещё 521 случай передаётся на суд LLM Judge: он в основном оценивает, достаточно ли содержательны документы и соответствуют ли подаваемые материалы требованиям — то есть те аспекты, которые сложно проверить напрямую правилами.
Во всех задачах используются синтетические данные пациентов, а не реальные медицинские записи. Это значит, что бенчмарк даёт воспроизводимую тестовую среду: тестирование не проводится в реальной производственной системе больницы и не измеряет напрямую результаты ухода за пациентами.
В чём разница между успехом подзадачи и успехом задачи целиком?
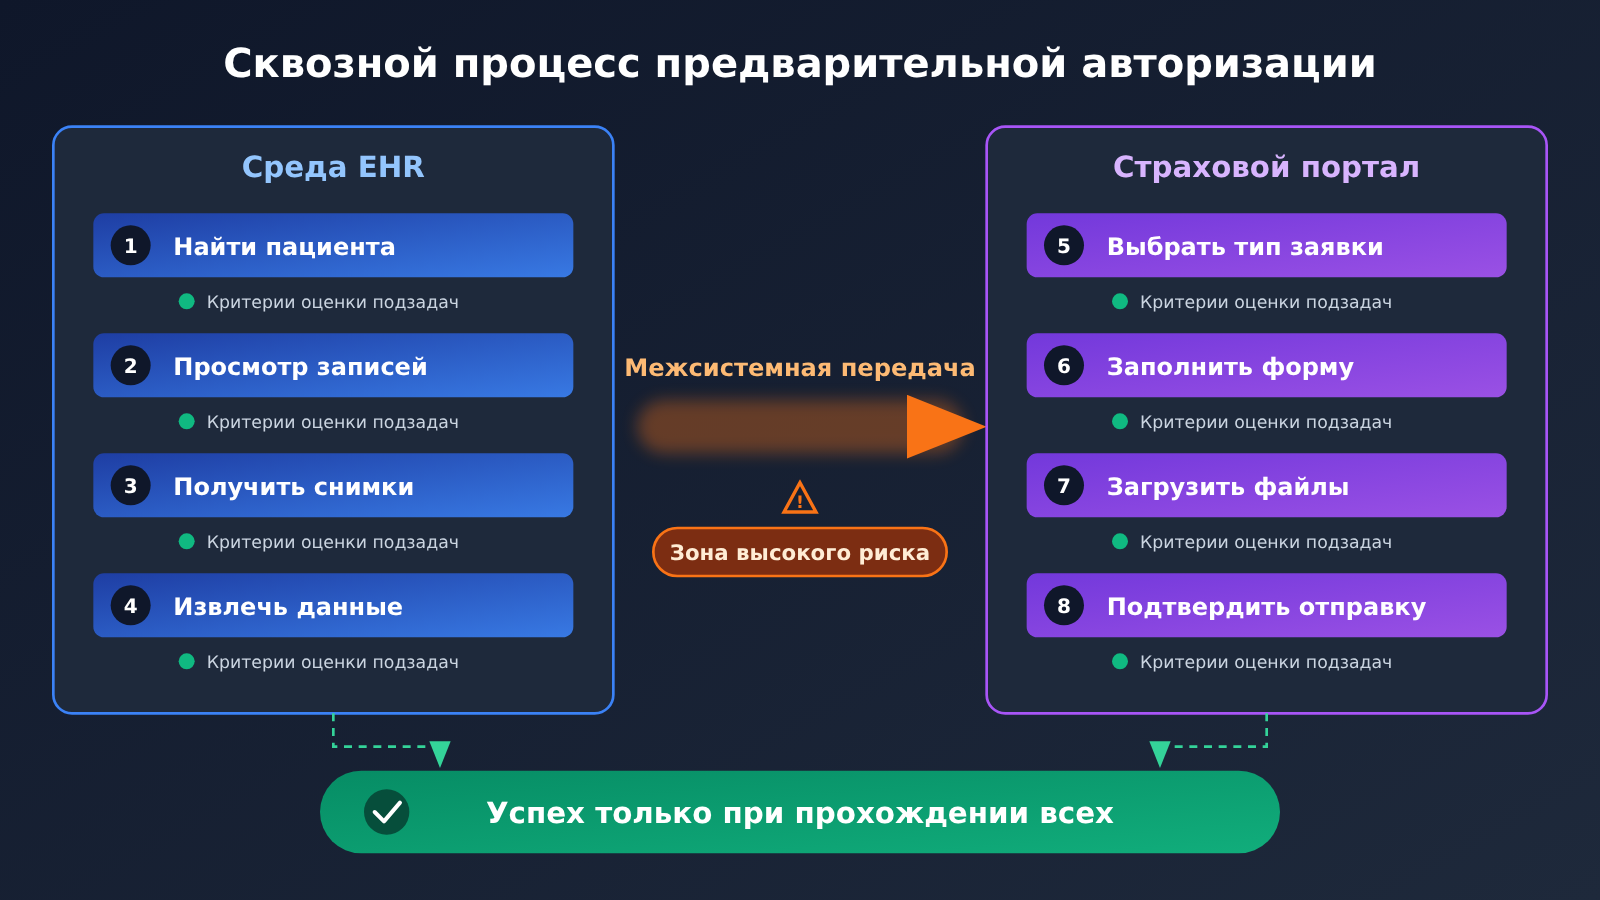
Проще всего увидеть разницу на примере процесса подачи заявки на предварительное разрешение. Как описано в исследовательских материалах, задача предварительного разрешения может требовать от агента последовательно выполнить следующие действия:
- Найти нужного пациента в EHR
- Просмотреть историю лечения пациента
- Найти материалы визуализации и предыдущего лечения
- Определить, какие подтверждения нужны для страховой заявки
- Извлечь нужную информацию из медицинской карты
- Зайти на портал страховых выплат
- Выбрать правильный тип заявки
- Заполнить форму заявки
- Приложить необходимые документы
- Отправить заявку и подтвердить статус
Между этими десятью шагами существуют жёсткие зависимости. Если на шаге 1 выбран не тот пациент, то все последующие шаги, как бы правильно они ни были выполнены, окажутся ошибочными; если первые девять шагов выполнены верно, но на шаге 9 забыли приложить документ или на шаге 10 заявка не была действительно отправлена, вся задача всё равно считается неуспешной. Успешность подзадач считает, «сколько из десяти шагов выполнено правильно», а успешность задачи целиком — «выполнены ли правильно все десять шагов».
Данные из статьи наглядно показывают этот разрыв: успешность подзадач GPT-5.4 CUA составляет 82.8%, а успешность задачи целиком у Claude Opus 4.6 CUA — 36.3%. Эти два числа относятся к разным моделям и тоже не подлежат прямому сравнению, но вместе они говорят об одном: выполнение отдельных действий и выполнение всего бизнес-процесса — это две разные способности.
Ранние исследовательские веб-отчёты сообщали о похожем разрыве: лучшая успешность задачи целиком у Claude Opus 4.5 — 22.9%, успешность подзадач у Gemini 3 — 76.4%. Поскольку масштаб задач и версии различаются, эти числа можно использовать только для наблюдения за тенденцией, но нельзя ставить в один рейтинг с версиями из статьи или с результатами OpenAI.
На каких этапах медицинский агент чаще всего даёт сбой?
В работе по категориям подзадач опубликованы результаты двух конфигураций CUA:
| Категория подзадачи | Claude Opus 4.6 CUA | GPT-5.4 CUA |
|---|---|---|
| Поиск информации | 96,5% | 96,1% |
| Подготовка документов | 74,3% | 84,4% |
| Заполнение форм | 88,9% | 84,9% |
| Решение задач | 70,7% | 66,2% |
| Обработка документов | 92,3% | 94,3% |
| Клиническое рассуждение | 61,3% | 77,0% |
Особо отметим: 94,3% GPT-5.4 CUA в обработке документов и 94,3% общего результата GPT-6 Astra по rubric points, которые опубликовала OpenAI, — это просто совпадение цифр. Модели, метрики и источники у них совершенно разные.
Если посмотреть по отдельным категориям, поиск информации уже почти достиг потолка, а клиническое рассуждение, решение задач и подготовка документов пока остаются относительно слабыми местами. Работа также указывает, что обработка документов (Document Handling) и передача данных между системами (Cross-system Data Transfer) — основные причины сквозных сбоев. В ранней веб-версии сообщалось, что у пяти из шести моделей точность на подзадаче обработки документов была ниже 20%, но это относится к другому варианту постановки задачи, и напрямую сравнивать эти цифры с таблицей выше нельзя.
Почему передача данных между системами особенно подвержена ошибкам? В процессе предварительного согласования (prior authorization) одну и ту же информацию нужно извлечь из EHR, сохранить в контексте агента, а затем записать в форму на страховом портале, у которой другая структура; кроме того, вложения могут проходить через портал факса. Каждое такое перемещение — ещё одна возможность допустить ошибку, а ошибка в вышестоящей системе в неизменном виде копируется в следующую. В перечне рисков, который приводит OpenAI, есть и «распространение ошибочной информации из одной системы в другую», и «ошибочное сообщение о завершении задачи, когда состояние системы неясно».
Почему одна и та же модель ведёт себя по-разному в разных фреймворках исполнения?
В статье провели аблационные эксперименты со способами подачи промптов и режимами наблюдения, и основные выводы такие:
- Если дать Portal Guidance (инструкции по работе с порталом), результат обычно лучше, чем при одном лишь описании задачи
- Наблюдение через Accessibility Tree (дерево доступности) обычно лучше, чем наблюдение только по скриншотам
- Когда инструкции по работе с порталом сочетаются со структурированной информацией о странице, сквозной результат обычно лучше
В статье также отмечается, что реальная продакшн-среда не обязательно даёт полное Accessibility Tree. Иными словами, результат агента зависит не только от базовой модели, но и от фреймворка исполнения (Harness), способа наблюдения за страницей, промпта и описания задачи.
Документация OpenAI для разработчиков тоже отражает различия в путях исполнения. Официальное руководство отдельно описывает ComputerToolset, BrowserToolset и точку входа управляемого браузера. Для GPT-6 Astra текущая документация рекомендует подход Code Execution — когда модель генерирует код вроде Playwright для работы с интерфейсом, а Computer Tool остаётся опциональным вариантом. Документация также подчёркивает: то, что модель сгенерировала команду действия, ещё не значит, что действие выполнено успешно — приложение должно сначала его выполнить, а потом проверить результат по новому скриншоту или другим способом.
Открытый CUA Agent Kit от CVS Health (Apache-2.0) предлагает другой инженерный подход. Механизм, описанный в его README, такой: сначала Computer-use Agent исследует рабочий процесс и сохраняет скриншоты, действия и Trace как доказательства, затем Codex Skill закрепляет успешную траекторию в виде детерминированного кода, который проходит проверку инженером; последующие детерминированные запуски уже не требуют ключа модели. Так «как это делать» и «стабильно повторять это» разделяются на две отдельные задачи.
Анализ и критерии: как оценивать действительно пригодного медицинского агента
Как оценивать действительно пригодного агента?
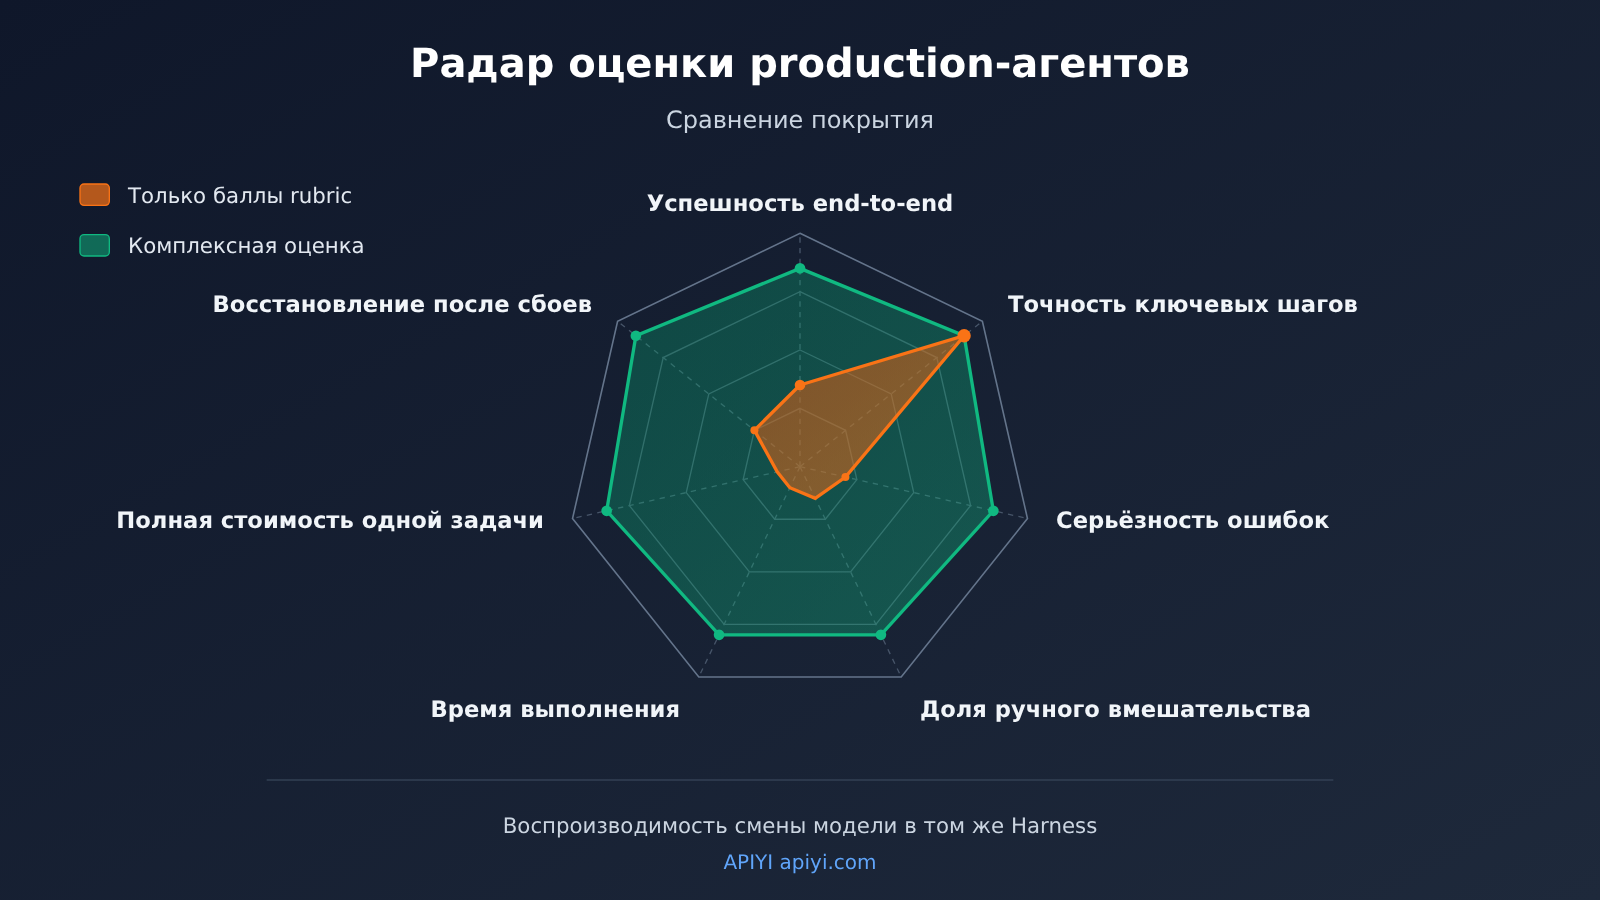
Ниже — наши суждения, а не официальный стандарт какой-либо организации. Мы считаем, что такие оценки, как 94.3% по rubric points, хорошо отвечают на вопрос «насколько улучшились отдельные способности модели», но недостаточны для ответа на вопрос «можно ли запускать её в производственный процесс». Для второго вопроса нужен набор взаимно уравновешивающих метрик:
| Параметр оценки | Что измеряет | Зачем нужен | Источник данных |
|---|---|---|---|
| Сквозная успешность (end-to-end) | Доля задач, где полностью выполнены все условия успеха | Для бизнеса важен только конечный результат | Проверка финального состояния системы |
| Точность ключевых шагов | Доля правильных действий в ключевых точках: выбор пациента, отправка, загрузка вложений и т. п. | Ошибка на ключевом шаге ломает весь сценарий | Детерминированные проверки |
| Серьёзность ошибок | Был ли сбой исправимым упущением или же записью неверных данных, отправкой сообщения не туда | При одинаковой доле сбоев риск может различаться радикально | Ручная проверка + метки уровней серьёзности |
| Доля ручного вмешательства | Доля случаев, где требуется ручной перехват или правка с утверждением | Определяет реальную экономию человеческого труда | Журнал согласований |
| Время выполнения | Время на одну задачу и время хвостовых задач | Влияет на пропускную способность и очередь | Временные метки Trace |
| Полная стоимость одной задачи | Сумма затрат на модель, скриншоты, повторные попытки, среду выполнения и поддержку | Цена за токен не отражает реальную стоимость | Счета + журналы выполнения |
| Способность восстанавливаться после сбоев | Может ли агент остановиться или откатиться при неоднозначности, тайм-ауте или изменении страницы | В медицинских сценариях агент обязан «уметь остановиться» | Тесты с внедрением сбоев |
Суть этой схемы — раздельно отчитываться о том, «сколько шагов сделано правильно» и «сколько задач реально выполнено», а затем корректировать оба показателя с учётом серьёзности ошибок и доли ручного вмешательства. Решение, показанное Ambience, как раз отражает параметр «восстановление после сбоев»: когда в медицинской карте есть неоднозначность, агент останавливается и спрашивает врача, а заявку на предварительное согласование отправляет только после одобрения врачом. Это лишь демонстрация подхода к управлению со стороны компании, а не гарантия, что все медицинские агенты по умолчанию имеют такую же конфигурацию.
Объём выборки и число повторов тоже должны быть открыты. В одном исследовании, сравнивавшем RPA и агентов (DOI: 10.1080/23311975.2026.2724760), каждую технологию запускали по 10 раз на двух процессах — P2 и P3, — но на P1 агент выполнил только 1 запуск, и он оказался неудачным, поэтому результат не включили в дальнейшую статистику. Исследование использовало конфигурацию инструментов 2025 года, поэтому его нельзя считать прямым результатом моделей 2026 года. Этот пример показывает: читая выводы оценки, сначала смотрите, сколько запусков стоит за каждой цифрой и какие результаты были исключены.
Практический подход к оценке медицинских агентов: запускаем свои тесты в одном Harness
Для команды разработчиков самый практичный вариант — зафиксировать среду выполнения и на собственном наборе задач одновременно считать две группы метрик: по подзадачам и сквозную. В примере ниже LLM Judge оценивает материалы, которые агент отправляет на проверку, а интерфейс совместим с OpenAI SDK:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI, можно переключать разные модели-судьи
)

resp = client.chat.completions.create(
    model="YOUR_JUDGE_MODEL",
    messages=[
        {"role": "system", "content": "你是评测裁判,只输出 PASS 或 FAIL 及一句理由。"},
        {"role": "user", "content": "要求:附上影像报告与既往治疗记录。\n提交内容:<Agent 提交的材料摘要>"}
    ]
)
print(resp.choices[0].message.content)
Открыть полную реализацию: одновременно вычисляем успешность подзадач и сквозную успешность
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class Subtask:
    name: str
    critical: bool          # критический ли это шаг (при провале проваливается вся задача)
    passed: bool = False

@dataclass
class TaskResult:
    task_id: str
    subtasks: list = field(default_factory=list)
    human_intervened: bool = False
    cost_usd: float = 0.0   # уже включает токены повторных попыток, не суммировать повторно

def llm_judge(requirement: str, submission: str, model: str) -> bool:
    """Для подзадач, которые сложно описать правилами, используем LLM Judge"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "只输出 PASS 或 FAIL。"},
            {"role": "user", "content": f"要求:{requirement}\n提交:{submission}"}
        ]
    )
    return resp.choices[0].message.content.strip().upper().startswith("PASS")

def summarize(results: list) -> dict:
    total_sub = sum(len(r.subtasks) for r in results)
    passed_sub = sum(s.passed for r in results for s in r.subtasks)
    full_success = sum(all(s.passed for s in r.subtasks) for r in results)
    critical_fail = sum(
        any(s.critical and not s.passed for s in r.subtasks) for r in results
    )
    n = len(results)
    return {
        "subtask_rate": passed_sub / total_sub,
        "end_to_end_rate": full_success / n,
        "critical_failure_rate": critical_fail / n,
        "human_intervention_rate": sum(r.human_intervened for r in results) / n,
        "avg_cost_usd": sum(r.cost_usd for r in results) / n,
    }
🎯 Технический совет: оценки по подзадачам и сквозную успешность лучше приводить рядом — в одном и том же Harness и на одном и том же наборе задач. Через OpenAI-совместимый интерфейс APIYI apiyi.com можно одним API-ключом переключаться между OpenAI, Claude, Gemini и другими моделями — выбирать модель-исполнитель или модель-судью — и так уменьшать число переменных, связанных с разными способами подключения.
Расчёт затрат медицинского агента и разделение моделей по уровням
Цена за токен — это только отправная точка. По ценам Standard для короткого контекста, которые OpenAI опубликовала 17 ноября 2026 года, у GPT-6 Astra ввод, вывод и кешированный ввод стоят 10, 50 и 1 доллар за миллион токенов соответственно, у GPT-6 Luna — 0,10, 0,50 и 0,01 доллара. Скорость обработки, длина контекста и регион влияют на итоговую стоимость. Computer Use — это многошаговые вызовы; каждый скриншот на каждом шаге считается визуальным вводом. Поэтому при расчёте нужно отдельно учитывать визуальный и текстовый ввод и оплачиваемый вывод на каждом шаге, плюс расходы на инструменты, среду выполнения и инженерное сопровождение. Если токены, израсходованные на повторные попытки, уже включены в общий объём, не добавляйте их второй раз.
Судя по разнице между 0,085 и примерно 4,25 доллара, разделение моделей по уровням, скорее всего, станет нормой: сложные задачи, требующие сильного рассуждения, отдаём более сильной модели; хорошо структурированные и часто повторяющиеся задачи — более дешёвой модели; а уже отлаженные фиксированные процессы по аналогии с подходом CVS переводим в детерминированный код. Стоит оговориться: эти затраты на одну задачу получены в конкретных условиях бенчмарка и не годятся как цена для продакшена.
💰 Оптимизация затрат: прежде чем выбирать модели по уровням, советую сначала на небольшой партии реальных задач измерить для каждой модели долю задач, успешно выполненных от начала до конца, и полную стоимость одной задачи. APIYI apiyi.com работает с оплатой за фактическое потребление; у новых пользователей есть бесплатный тестовый лимит. Так можно недорого провести такие сравнительные эксперименты ещё на этапе запуска проекта.
От медицинских агентов к корпоративным агентам: переносимый подход к оценке
Особенность медицинской административной сферы — высокий риск и жёсткое регулирование, но проблемы, которые она вскрывает, есть и в корпоративных процессах: страховые выплаты, сверка финансов, документы цепочки поставок. Везде одно и то же: множество систем, сильные зависимости, перенос данных между системами. Наша позиция такая: следующие четыре принципа можно перенести напрямую.
- Разделяйте отчётность: баллы за подзадачи и сквозная (end-to-end) доля успешных выполнений указываются отдельно, и первое никогда не должно подменять второе.
- Помечайте уровень доказательности: демонстрации в синтетической среде, самооценка вендора, сторонние бенчмарки, корпоративные пилоты и производственные кейсы относятся к разным категориям, их нельзя смешивать.
- Сравнивайте только при фиксированном Harness: если меняются способ наблюдения, промпт или инструкции портала, результаты уже несопоставимы.
- Управление важнее баллов: минимальные права доступа, ручное утверждение ключевых действий, проверка состояния после операции, сквозная трассировка (Trace) и механизмы аварийной остановки должны быть критериями приёмки ещё до запуска.
Когда делаете PoC внутри компании, можно разметить набор задач по «ключевым шагам»: сначала получить сквозной базовый показатель, а затем постепенно добавлять инструкции портала, структурированное наблюдение или фиксацию кода — и смотреть, какой реальный вклад каждое изменение вносит в полную долю успешных выполнений. Если нужно быстро воспроизвести один и тот же набор задач на нескольких моделях, можно подключиться единообразно через APIYI apiyi.com — это снижает инженерные затраты на горизонтальное сравнение.
Что стоит отслеживать в дальнейшем: опубликует ли OpenAI результаты по каждой задаче и конфигурацию экспериментов, стоящие за 94.3%; будут ли последующие версии HealthAdminBench публиковать полную долю успешных выполнений новых моделей в той же методике; и смогут ли другие организации раскрыть данные о доле ручного вмешательства и классификации ошибок в реальной производственной среде. Пока эта информация не появилась, любые заявления о том, что «медицинскую административную сферу можно полностью автоматизировать», остаются предположениями.
94.3% доказывают значительный прогресс модели по оцениваемым пунктам, а 36.3% напоминают: надёжность выполнения бизнес-процесса в конечном счёте проверяется на полной задаче, в реальной системе и под человеческим контролем. Как говорит английская пословица: «The proof of the pudding is in the eating.» (Практика — критерий истины: реальный эффект проверяется делом.)
Источники
- OpenAI: Advancing computer-use agents for healthcare teams: данные оценки 94.3%, 91.8%, 99%, 93% и примеры сотрудничества
- Ссылка:
openai.com/index/advancing-computer-use-for-healthcare-teams/
- Ссылка:
- Статья HealthAdminBench 2604.09937v1: 135 задач, 1,698 подзадач, результаты по отдельным пунктам и абляционные эксперименты
- Ссылка:
arxiv.org/html/2604.09937v1
- Ссылка:
- Страница проекта и репозиторий кода HealthAdminBench: среда бенчмарка и реализация оценки
- Ссылка:
som-shahlab.github.io/health-admin-bench-website/ - Ссылка:
github.com/som-shahlab/health-admin-bench
- Ссылка:
- Страница ранних исследований Stanford Shah Lab: историческая версия с 70 задачами и 947 точками оценки
- Ссылка:
shahlab.stanford.edu/doku.php?id=healthadminbench
- Ссылка:
- Документация для разработчиков OpenAI Computer Use и цены API: путь выполнения и стоимость Standard
- Ссылка:
developers.openai.com/api/docs/guides/tools-computer-use - Ссылка:
developers.openai.com/api/docs/pricing
- Ссылка:
- CVS Health CUA Agent Kit: исследование, доказательства, закрепление кода и механизм проверки инженерами
- Ссылка:
github.com/cvs-health/cua-agent-kit
- Ссылка:
- Сравнительное исследование RPA и Agent: количество повторных выполнений и пояснение про исключения P1
- Ссылка:
doi.org/10.1080/23311975.2026.2724760
- Ссылка:
- Cambridge Dictionary: толкование пословицы proof of the pudding is in the eating
- Ссылка:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Ссылка:
Автор: техническая команда APIYI
Общение по техническим вопросам: заходите на APIYI apiyi.com, чтобы обсудить с нами практику оценки Agent; больше информации о подключении — в центре документации docs.apiyi.com


