
Экономия возможна, но при определённых условиях. Согласно двум гипотетическим примерам расчёта из официальной документации Google, в сценарии с 200 инструментами и базовым контекстом в 2 000 токенов входные токены Gemini Tool Retrieval снижаются с 164 000 до 23 650 — примерно на 85,6 %. В сценарии с 10 инструментами и базовым контекстом в 30 000 токенов входные токены растут с 68 000 до 92 830 — примерно на 36,5 %. Выгодно ли это, зависит от одного вопроса: смогут ли сэкономленные полные схемы инструментов перекрыть дополнительные расходы на контекст, которые создаёт поиск на стороне сервера.
Что вы узнаете, прочитав эту статью?
- Какую часть токенов экономит Tool Retrieval и какие токены добавляет.
- Полные предпосылки и разбор по пунктам для официальных примеров с 200 и 10 инструментами.
- Формулу точки безубыточности, выведенную на основе официальных параметров, и способ понять, «при каком количестве инструментов Tool Retrieval стоит включать».
- Как рассчитать реальную стоимость одной задачи агента с помощью поля
interaction.usageи правил кэширования.
Навигация: сначала с помощью таблицы понятий и краткого обзора влияния мы поможем вам унифицировать термины и определить, к какому типу читателей вы относитесь. В разделе «Объективные факты» изложены механизм, правила расчёта стоимости и исходные формулировки двух примеров, опубликованные Google. В разделе «Анализ и выводы» приведены критическая точка, выведенная по официальным параметрам, различия между тремя видами «экономии», формула стоимости одной задачи и таблица решений о включении.
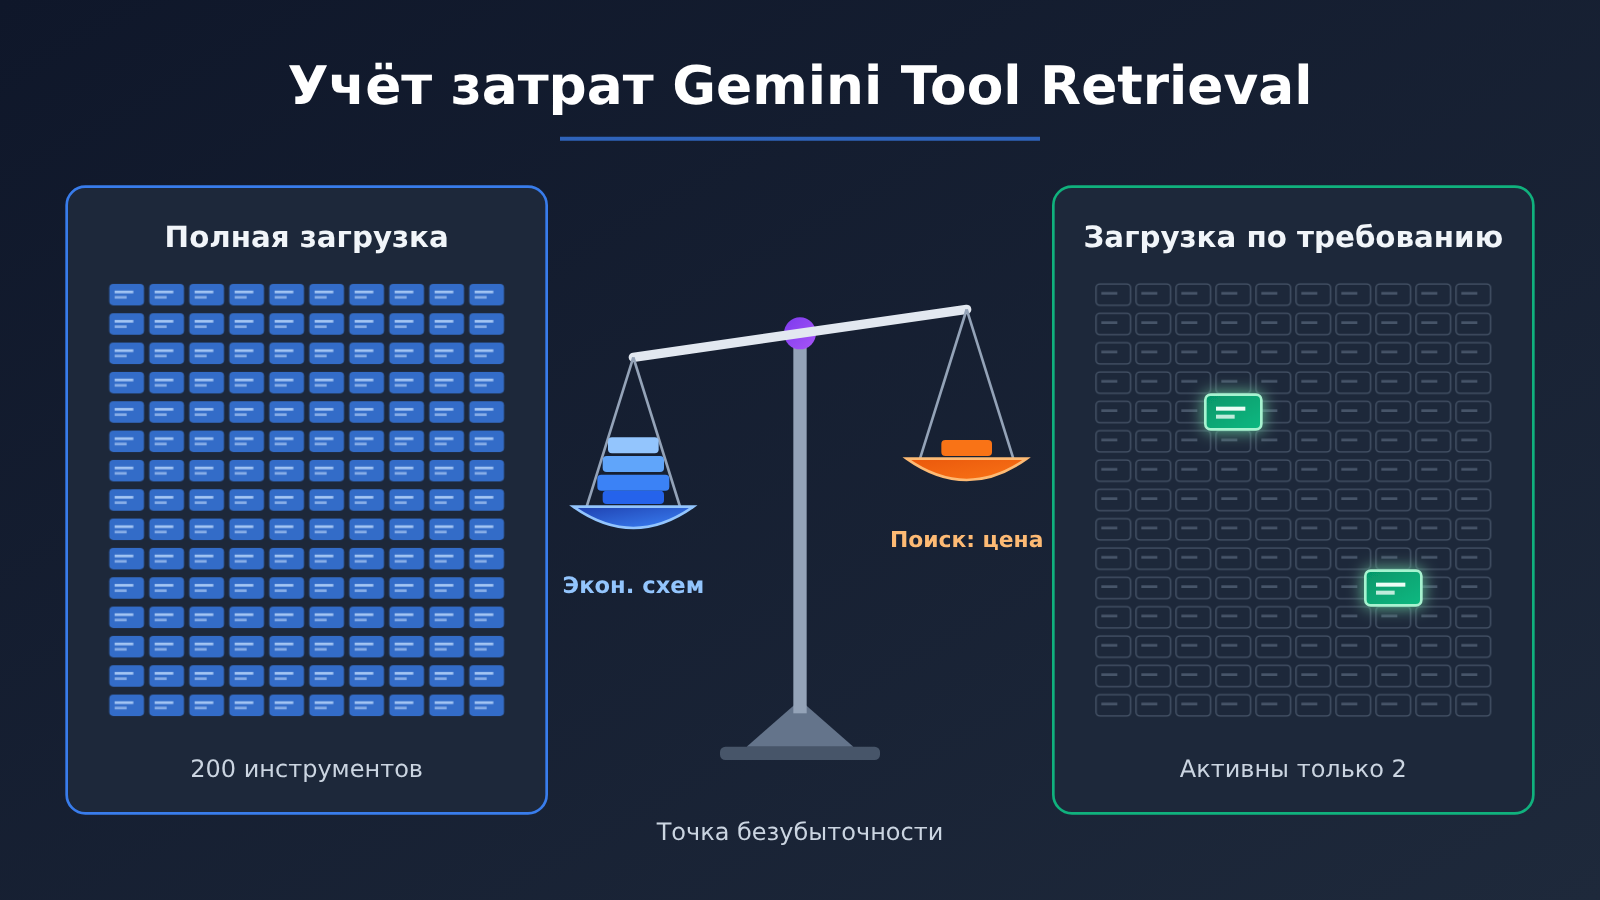
Анализ затрат Gemini Tool Retrieval To Know: разбор понятий
| Понятие | Краткое пояснение |
|---|---|
| Входные токены | Единица измерения объёма текста, истории контекста, объявлений инструментов и других материалов, подаваемых модели на обработку |
| Схема инструмента | Полное описание параметров, на которое опирается модель при формировании вызова функции; в примере расчёта каждая занимает примерно 400 токенов |
| Список отложенных инструментов | То, что модель изначально видит после установки defer_loading: true — только названия и краткие описания инструментов; в ранних официальных тестах это около 26 токенов на позицию |
| Базовый контекст B | История и информация о задаче, которые в примере расчёта и так обрабатываются при каждом вызове модели |
| Рассуждение после поиска | Дополнительный вызов модели, выполняемый после того, как сервер нашёл инструмент: в него передаются текущий контекст и новая схема |
total_tool_use_tokens |
Объём входных данных дополнительных вызовов модели в рамках одного запроса, вызванных серверными инструментами и поиском |
total_cached_tokens |
Часть входного объёма, обработанная кэшем и оплачиваемая по тарифу кэша |
| Точка безубыточности | Граница, на которой при одном и том же наборе допущений затраты на входные данные при статической загрузке и при загрузке по требованию совпадают |
| Стоимость одной успешной задачи | Сумма расходов на все раунды вызовов модели и на инструменты, потраченных на достижение одного бизнес-результата |
Влияние Gemini Tool Retrieval — коротко о главном
- Разработчики агентов с большими библиотеками инструментов: когда инструментов много, а в рамках одной задачи используется лишь несколько, есть шанс заметно снизить затраты на повторную передачу схем. Именно этот сценарий соответствует официальному примеру со 200 инструментами.
- Разработчики приложений с небольшим набором инструментов и длинным контекстом: каждый серверный поиск требует дополнительного прогона модели и повторной обработки длинного контекста, так что после включения может стать дороже. Официальный пример с 10 инструментами — как раз обратный случай.
- Инженеры и специалисты FinOps, отвечающие за расчёт затрат: если смотреть только на
total_input_tokensпервого запроса, стоимость легко недооценить — нужно учитывать ещёtotal_tool_use_tokens, попадания в кэш и выходные токены. - Платформенные команды, которые ведут корпоративный реестр инструментов: клиентский режим поиска можно совмещать с собственными фильтрами прав доступа и динамическими инструментами, но каждый поиск добавляет ещё один запрос к API, поэтому методику расчёта затрат придётся оценивать отдельно.
Объективные факты: релиз Gemini Tool Retrieval и механика тарификации
Что такое Gemini Tool Retrieval и когда он появился
19 ноября 2026 года Google объявил в официальном блоге о запуске функции Tool Retrieval в preview-режиме внутри Gemini Interactions API. Функция находится на стадии Preview и требует версии API v1beta; старый метод generateContent её не поддерживает. Чтобы включить серверный режим, нужно добавить {"type": "tool_search"} в tools и установить defer_loading: true для тех function или mcp_server, которые вы хотите загружать с задержкой.
В документации для разработчиков по состоянию на 20 ноября 2026 года явно перечислены четыре совместимых идентификатора моделей: gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash, gemini-3.6-flash. Формулировка в анонсе — «Gemini 3.6 и более новые модели» — звучит шире, но модели, не попавшие в документацию, придётся проверять самостоятельно: если задать defer_loading для неподдерживаемой модели, вернётся HTTP 400.
Стоит подчеркнуть один момент, который легко понять неправильно: в серверном режиме разработчик по-прежнему отправляет в каждом запросе полный массив tools, включая все параметры отложенных инструментов, — даже при использовании previous_interaction_id. Tool Retrieval меняет момент, когда полная схема попадает в контекст модели, а не то, что эти определения перестают отправляться в теле запроса.
Откуда берутся затраты при статической загрузке и Gemini Tool Retrieval
При статической загрузке каждый вызов модели требует чтения полных схем всех инструментов, даже если в текущем раунде используется только одна функция возврата средств. Tool Retrieval заменяет эти полные определения кратким списком инструментов: когда модель нуждается в инструменте, она инициирует tool_search_call, сервер возвращает tool_search_result с полной схемой, и модель на основе этого генерирует function_call.
Google прямо указывает, что у Tool Retrieval нет отдельной платы за функцию, но следующие пункты по-прежнему тарифицируются по ставке выбранной модели:
- Краткие пункты списка для всех инструментов с отложенной загрузкой.
- Фиксированные инструкции поиска, добавляемые после включения
tool_search. - Дополнительные вычисления модели, запускаемые каждым поиском на стороне сервера: они заново обрабатывают полный контекст и только что загруженные схемы.
- Полные схемы загруженных инструментов, а также их постоянное присутствие в последующих раундах (в текущей документации не описан механизм выгрузки).
- Обычные токены вывода, Thinking и результатов выполнения инструментов.
Официальные примеры расчёта Gemini Tool Retrieval: 200 инструментов и 10 инструментов
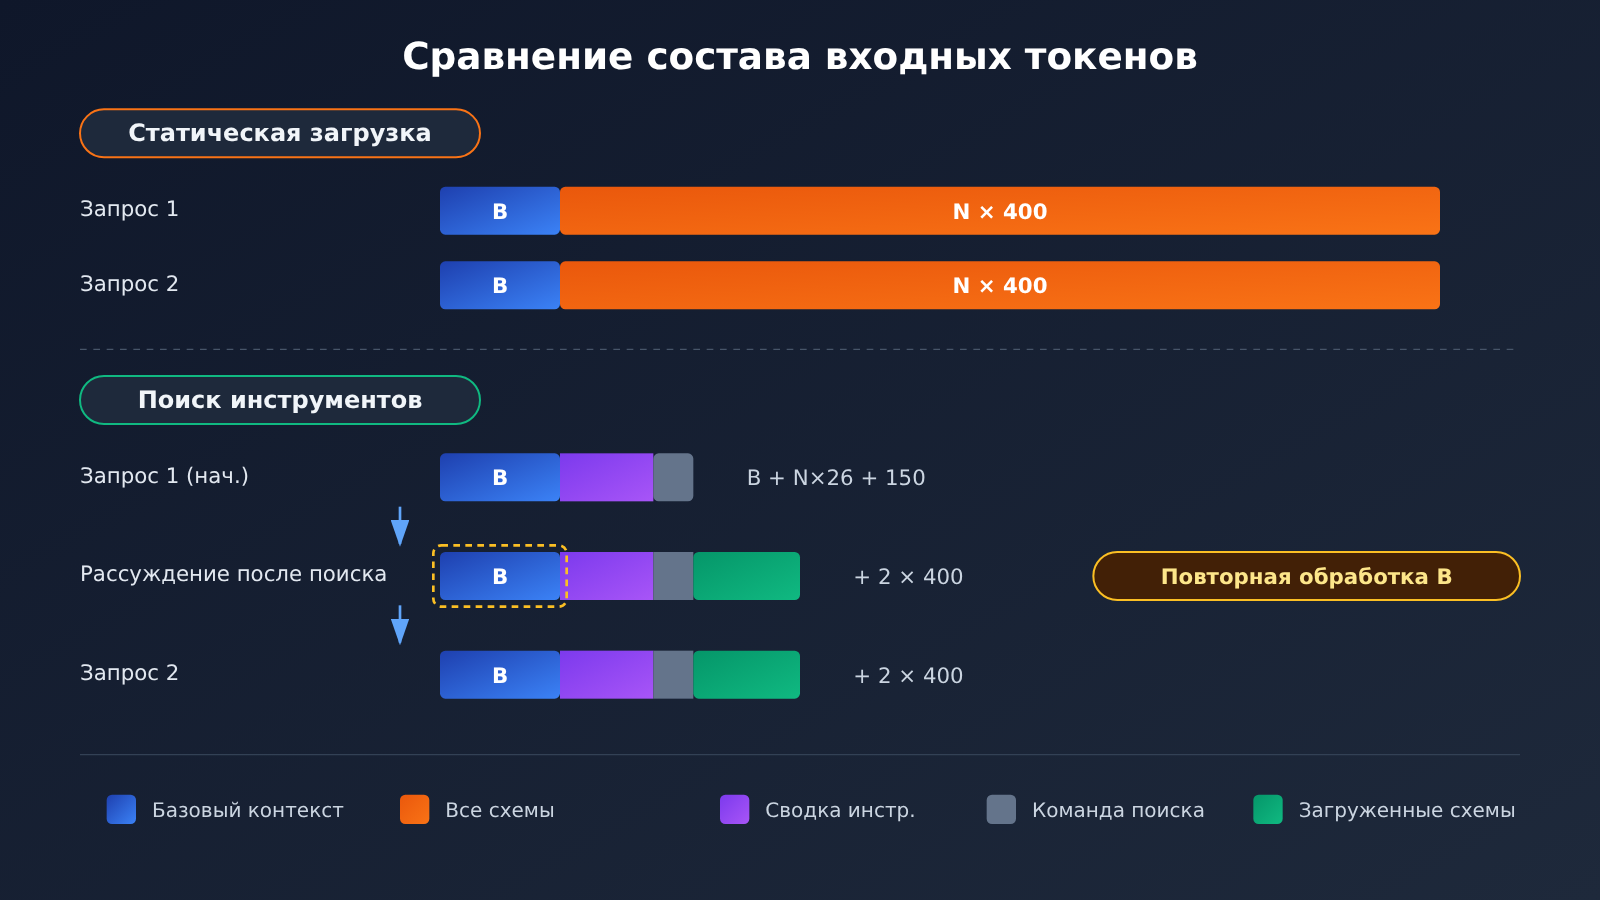
Оба набора примеров взяты из документации Google Tool Retrieval — это официально помеченные гипотетические расчёты, а не production-бенчмарк, и в обоих игнорируются выходные токены и выгода от кэширования. Единые допущения: каждая полная схема — 400 токенов, краткое описание отложенного инструмента — около 26 токенов, поисковая инструкция — 150 токенов, одна задача включает 2 внешних запроса, в первом запросе выполняется 1 серверный поиск, всего загружается 2 инструмента.
| Показатель расчёта | 200 инструментов, B=2,000 | 10 инструментов, B=30,000 |
|---|---|---|
| Статическая загрузка: 2 × (B + N × 400) | 164,000 | 68,000 |
| Начальный ввод запроса 1 (B + N × 26 + 150) | 7,350 | 30,410 |
| Инференс запроса 1 после поиска (плюс 2 схемы) | 8,150 | 31,210 |
| Ввод запроса 2 | 8,150 | 31,210 |
| Итого Tool Retrieval | 23,650 | 92,830 |
| Изменение | -140,350 | +24,830 |
| Величина изменения (пересчитано по официальным цифрам) | около -85,6% | около +36,5% |
В сценарии с 200 инструментами экономия заметна, потому что статический вариант каждый раз тащит на себе 80,000 токенов определений инструментов, а базовый контекст — всего 2,000, так что цена одного лишнего инференса при поиске мала. В сценарии с 10 инструментами всё наоборот: определения инструментов занимают в сумме лишь 4,000 токенов, экономить особо нечего, а инференс после поиска заново обрабатывает длинный контекст в 30,000 токенов — и новые издержки сразу перекрывают экономию.
Поля Usage, цены и правила кэширования в Gemini Tool Retrieval
Google предоставляет в interaction.usage поля, необходимые для анализа затрат на Tool Retrieval:
| Поле | Что означает | Роль в анализе затрат |
|---|---|---|
total_input_tokens |
Входные токены первого вызова модели в запросе | Показывает только, насколько короче стал исходный контекст |
total_tool_use_tokens |
Входные токены дополнительных вызовов модели, вызванных серверными инструментами и поиском | Основной источник затрат на поиск, который чаще всего упускают |
total_cached_tokens |
Часть, уже включённая во входные данные и обработанная кэшем | Считается по тарифу кэша; повторно прибавлять её нельзя |
total_output_tokens |
Выходные токены, созданные моделью | Считаются по тарифу вывода |
total_thought_tokens |
Токены, созданные в процессе рассуждения | Считаются по тарифу вывода выбранной модели |
Что касается цен: в стандартных ценах Standard на странице цен Google у Gemini 4 Hydrogen ввод стоит $1.50 за миллион токенов, вывод (включая Thinking) — $7.50, а кэшированный ввод — $0.075. Если пересчитать официальный пример, используя только эту цену ввода, для сценария с 200 инструментами получится примерно $0.246 против $0.0355, а для сценария с 10 инструментами — примерно $0.102 против $0.139. Это всего лишь умножение гипотетического числа токенов на официальный тариф, а не какой-либо реальный счёт.
В правилах кэширования есть два порога, которые нужно понимать по отдельности. Во-первых, Interactions API поддерживает только неявное кэширование; по состоянию на 20 ноября 2026 года минимальный размер входа для неявного кэширования у серии Gemini 4, Gemini 3.8 Flash и Gemini 3.6 Flash составляет 4,096 токена. Во-вторых, в многоходовых диалогах и Agent Loop на Gemini 4 новый запрос должен добавить как минимум 2,050 токенов — только тогда система закэширует весь предыдущий запрос. Если прирост меньше, последние 2,050 токенов предыдущего запроса повторно тарифицируются по стандартной цене ввода; вывод модели, Thinking и результаты функций тоже входят в этот прирост.
На дату проверки материалов Google не опубликовал данные о доле экономии токенов Tool Retrieval на реальных наборах задач, о величине улучшения задержки или о приросте точности выбора инструментов; также не было достаточно проверяемых производственных тестов от независимых разработчиков.
Анализ: когда Gemini Tool Retrieval действительно экономит токены
Точка окупаемости Gemini Tool Retrieval: при каком количестве инструментов его стоит включать
Ниже — расширенные примеры, выведенные по параметрам официального расчётного примера, а не универсальные пороги, опубликованные Google. Пусть N — общее число инструментов, B — базовый контекст; используем те же значения S=400, D=26, H=150, K=2 и сценарий «два запроса, один поиск»:
- Статическая загрузка: T_static = 2 × (B + 400N)
- Загрузка по требованию: T_retrieval = 3 × (B + 26N + 150) + 2 × 2 × 400
Эта формула полностью воспроизводит два официальных результата. При T_retrieval < T_static после преобразований получаем 722N > B + 2050, то есть N > (B + 2050) / 722. Здесь 2050 берётся из 3 × 150 + 1600 — это просто алгебраический результат, и он никак не связан с условием прироста в 2,050 токенов при многораундовом кэшировании Gemini 4 из документации по кэшированию — не путайте эти вещи.
| Базовый контекст B | Число инструментов N | Статическая загрузка | Tool Retrieval | Изменение | Доля | Тип данных |
|---|---|---|---|---|---|---|
| 2,000 | 200 | 164,000 | 23,650 | -140,350 | -85.6% | Официальный пример |
| 30,000 | 10 | 68,000 | 92,830 | +24,830 | +36.5% | Официальный пример |
| 30,000 | 44 | 95,200 | 95,482 | +282 | +0.3% | Расширенный вывод |
| 30,000 | 45 | 96,000 | 95,560 | -440 | -0.5% | Расширенный вывод |
| 30,000 | 50 | 100,000 | 95,950 | -4,050 | -4.1% | Расширенный вывод |
| 30,000 | 100 | 140,000 | 99,850 | -40,150 | -28.7% | Расширенный вывод |
При B=30,000 порог составляет N > 44.39, то есть начиная с 45-го инструмента загрузка по требованию даёт небольшое преимущество, причём вблизи точки окупаемости экономия почти незаметна. По той же формуле при B=2,000 порог примерно 5.6, то есть достаточно 6 инструментов, чтобы картина перевернулась. Отсюда вывод: чем длиннее базовый контекст, тем более крупная библиотека инструментов нужна, чтобы размыть затраты на повторную обработку контекста при поиске.
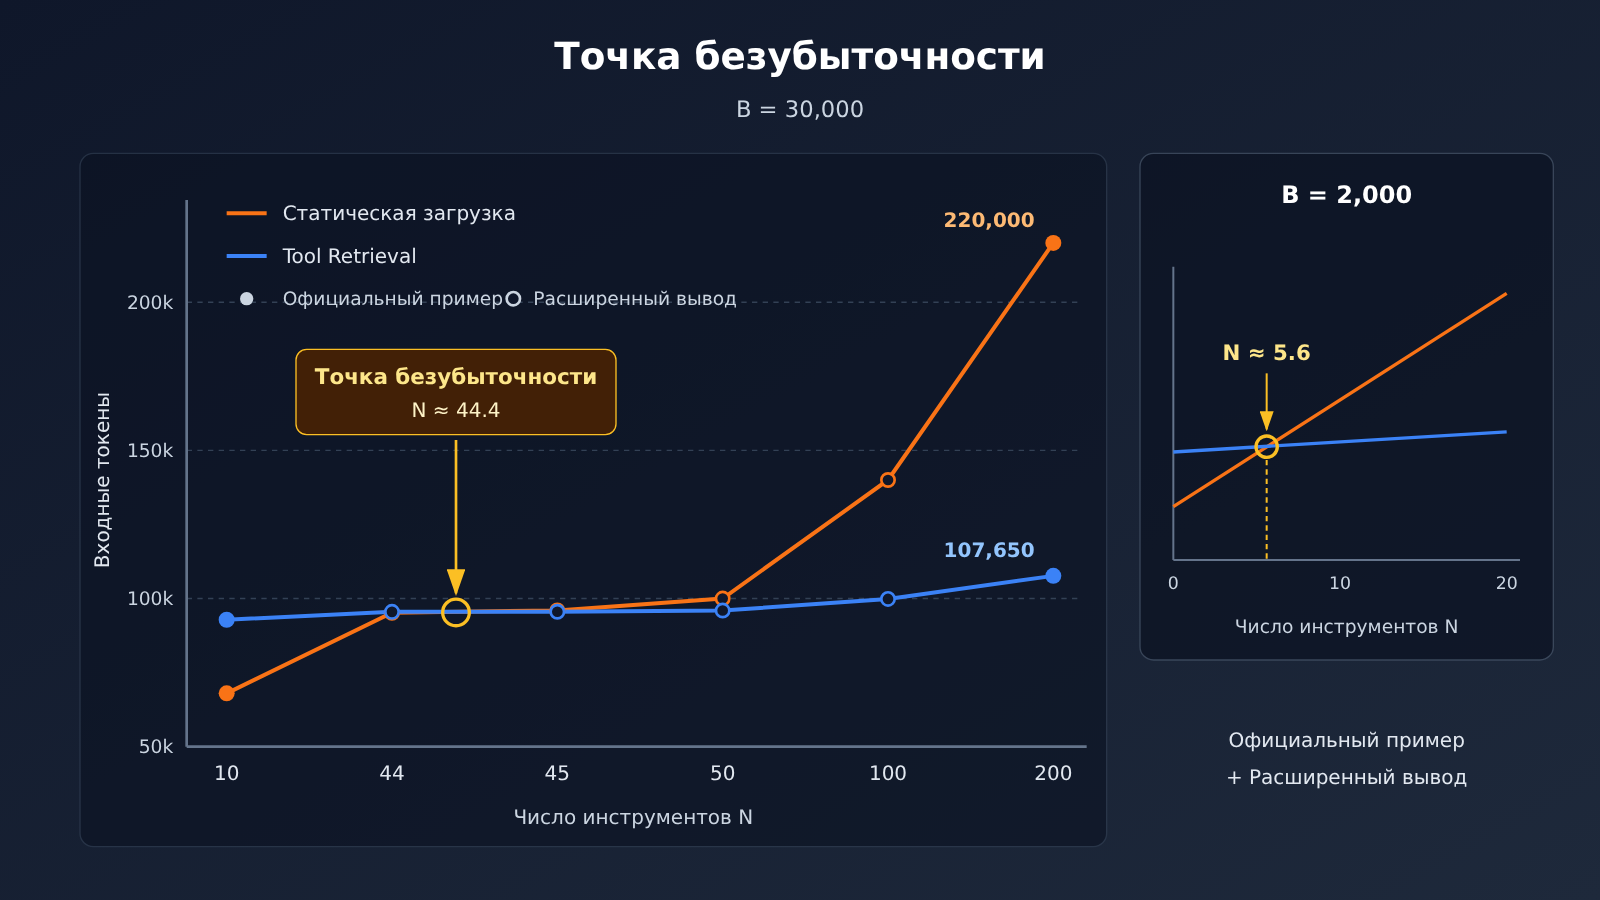
Подпись к рисунку: первые две строки данных — официальные примеры Google, остальные — вывод по той же методике. В реальных задачах число поисков и объём загрузки изменят кривые, поэтому рекомендуем перепроверить на собственных бизнес-запросах: через единый интерфейс APIYI apiyi.com можно быстро поднять базовые линии статической загрузки для нескольких моделей и сравнить.
Реальные задачи редко строго соответствуют этим допущениям — следующие переменные сдвигают точку окупаемости:
- Количество поисков: каждый дополнительный серверный поиск — это ещё один вход модели размером примерно «B + список инструментов + загруженные Schema». В сценариях с длинным контекстом это равносильно тому, что вы каждый раз снова платите за B.
- Фактически загруженное количество K: чем больше инструментов загружено, тем меньше экономия; загруженные Schema нельзя выгрузить, и в длинных сессиях они постоянно накапливаются.
- Размер одного Schema S: для инструментов со сложными параметрами и длинными описаниями выгода от загрузки по требованию больше; если Schema совсем короткая, выгоду съедают элементы списка и инструкции поиска.
- Количество раундов сессии: статический подход требует повторять все Schema в каждом раунде; чем больше раундов и чем реже запускается новый поиск, тем заметнее преимущество загрузки по требованию.
Меньше входных токенов, ниже общая стоимость, быстрее ответ: три вида «экономии» в Gemini Tool Retrieval
Эти три вещи часто смешивают, но они не эквивалентны. Сокращение входных токенов — самое наглядное, но если смотреть только на total_input_tokens, можно упустить инференс после поиска, который учитывается в total_tool_use_tokens, и тем самым переоценить экономию.
Снижение общей стоимости зависит ещё и от кэширования и цены за единицу. Загрузка по требованию сокращает начальный промпт; если изначально именно за счёт большого количества Schema удавалось преодолеть порог неявного кэширования в 4,096 токена, то после включения можно, наоборот, потерять кэш. Если короткий цикл вызова функции и возврата результата добавляет меньше 2,050 токена, Gemini 4 тоже не получит полный кэш предыдущего запроса. То есть токенов стало меньше, но структура цены за единицу может ухудшиться.
Более быстрый ответ пока не подтверждается ни официальными, ни независимыми данными. Серверный поиск не увеличивает число клиентских round-trip, но внутри запроса действительно выполняется дополнительный инференс модели; клиентский поиск добавляет один API round-trip на каждый поиск. Стала ли задержка меньше или больше — на этот вопрос можно ответить только собственным end-to-end тестированием.
Как рассчитать реальный счёт за одну задачу Gemini Tool Retrieval Agent
Согласно официальной семантике Usage, при стандартном биллинге, когда кешированные токены уже включены во входные данные и нет других инструментов с оплатой за вызов, стоимость одного запроса можно оценить так:
USD ≈ [ (I + U − C) × P_in + C × P_cache + (O + T) × P_out ] / 1,000,000
Здесь I, U, C, O, T — это пять полей из таблицы выше. Одна задача Agent обычно охватывает несколько запросов, поэтому нужно сначала суммировать Usage по каждому запросу, а затем рассчитывать. В итоге «общая стоимость ÷ количество успешно выполненных задач» даёт стоимость одной успешно выполненной задачи.
Прежде чем включать Tool Retrieval, надёжнее всего сначала измерить базовый уровень при статической загрузке. Ниже приведён пример запуска статического Function Calling через OpenAI-совместимый интерфейс с записью базового Usage:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI для запуска базовой статической загрузки
)

resp = client.chat.completions.create(
    model="gemini-3.8-flash",  # имя модели — по списку моделей на платформе
    messages=[{"role": "user", "content": "Refund 40 USD for order A-1042."}],
    tools=[{"type": "function", "function": {"name": "issue_refund",
            "parameters": {"type": "object", "properties": {
                "order_id": {"type": "string"}, "amount": {"type": "number"}},
                "required": ["order_id", "amount"]}}}]
)
print(resp.usage)  # записываем входные и выходные токены при полной статической загрузке
Стоит пояснить: сам Tool Retrieval зависит от версии v1beta Google Interactions API. Пример выше предназначен только для получения контрольных данных статической загрузки. Для стороны с загрузкой по требованию используйте способ вызова, поддерживающий Interactions API, а затем подставьте Usage с обеих сторон в одну и ту же формулу стоимости для сравнения.
Полный код реализации: расчёт точки безубыточности + оценка счёта по Usage
import openai

# ---------- 1. Теоретический расчёт по официальной методике (расширенный пример, не официальные пороги) ----------
def static_tokens(B: int, N: int, S: int = 400) -> int:
    return 2 * (B + N * S)

def retrieval_tokens(B: int, N: int, D: int = 26, H: int = 150,
                     K: int = 2, S: int = 400) -> int:
    return 3 * (B + N * D + H) + 2 * K * S

def breakeven_tools(B: int) -> float:
    return (B + 2050) / 722  # справедливо только при S=400, D=26, H=150, K=2

for B, N in [(2000, 200), (30000, 10), (30000, 45), (30000, 100)]:
    s, r = static_tokens(B, N), retrieval_tokens(B, N)
    print(f"B={B:>6} N={N:>3} static={s:>7} retrieval={r:>7} "
          f"change={(r - s) / s:+.1%}")
print("B=30000 临界工具数:", round(breakeven_tools(30000), 2))

# ---------- 2. Оценка стоимости одного запроса по полю Usage (в долларах) ----------
def request_cost(I, U, C, O, T, p_in, p_cache, p_out) -> float:
    """I/U/C/O/T соответствуют total_input / tool_use / cached / output / thought tokens"""
    return ((I + U - C) * p_in + C * p_cache + (O + T) * p_out) / 1_000_000

# Пример: стандартные цены Gemini 4 Hydrogen 1.50 / 0.075 / 7.50 (за миллион токенов)
print(request_cost(I=7350, U=8150, C=0, O=200, T=0,
                   p_in=1.50, p_cache=0.075, p_out=7.50))

# ---------- 3. Базовый вариант со статической загрузкой (интерфейс, совместимый с OpenAI) ----------
client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_static_baseline(prompt: str, tools: list, model: str = "gemini-3.8-flash"):
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools
    )
    return resp.usage  # при суммировании многораундовых задач складывать по каждому запросу
🚀 Быстрый старт: советуем сначала в APIYI apiyi.com прогнать на одном ключе базовый вариант со статической загрузкой, записать Token и долю успешно выполненных задач на реальном наборе бизнес-задач, и уже потом решать, переводить ли Agent на загрузку по требованию — чтобы не менять архитектуру, опираясь на официальные демонстрационные цифры.
Решение о включении Gemini Tool Retrieval: готова ли ваша библиотека инструментов
С учётом официальных инженерных рекомендаций и приведённых выше рассуждений можно сделать предварительную оценку по таблице ниже. Окончательное решение всё равно принимайте по стоимости одного успешного задания и доле успешно завершённых задач на реальных нагрузках:
| Характеристика нагрузки | Рекомендуемая стратегия | Причина |
|---|---|---|
| Меньше ~20 стабильных инструментов, большинство используется в каждом раунде | Продолжать статическую загрузку | Официальная рекомендация; схем экономится мало, а затраты на поиск занимают большую долю |
| Инструментов мало, но базовый контекст очень длинный | Статическая загрузка или отложенная загрузка лишь нескольких инструментов с крупными схемами | Каждый поиск заново обрабатывает длинный контекст; пример с 10 инструментами — как раз контрпример |
| От десятков до сотен инструментов, а за один вызов используется лишь несколько | В первую очередь оценить серверный поиск | Большая библиотека с длинным хвостом — это сценарий, соответствующий официальному примеру с 200 инструментами |
| Смесь часто используемых инструментов и большого числа редких специализированных | Частые загружать напрямую, редкие — через defer_loading |
Официально рекомендованный гибридный подход: даже простые задачи не должны начинаться с поиска |
| Мультитенантность, динамические инструменты и фильтрация по правам пользователей | Оценить клиентский поиск | Можно подключить собственный реестр, но каждый поиск добавляет ещё один сетевой запрос |
| Инструменты, которые часто явно упоминаются в системных инструкциях | Оставить прямую загрузку | Официальное предупреждение: отложенный инструмент, названный в инструкции, может быть вызван напрямую, минуя поиск, и дать ошибку |
💡 Совет по выбору: прогоните один и тот же набор задач в двух вариантах — со статической загрузкой и с загрузкой по требованию, — сохраняя одинаковыми модель, библиотеку инструментов, длину контекста и условия кэширования. Через APIYI apiyi.com можно в едином интерфейсе переключать разные Gemini и другие популярные модели для сравнения с базовой линией, чтобы относить разницу в стоимости именно к стратегии загрузки инструментов.
Есть ещё несколько инженерных деталей, которые напрямую влияют на счёт: при самостоятельном управлении историей с store=false нужно сохранять tool_search_call, tool_search_result и их signature без изменений, иначе последующие запросы могут возвращать HTTP 400; нельзя опускать parameters отложенных инструментов, чтобы уменьшить тело запроса; при отладке проверяйте function_call в interaction.steps, а не только interaction.status. Если из-за этих проблем запускаются повторные попытки, токены дублирующих запросов тоже попадают в стоимость.
В конечном счёте, Tool Retrieval — это инструмент снижения затрат, основанный на предпосылке «несколько инструментов используются часто, а большинство долго простаивает». Два официальных примера с противоположными выводами уже ясно обозначили границы: чем больше библиотека инструментов, чем короче контекст и чем меньше поисков, тем выше шанс экономии; в обратном случае можно потратить больше. Оптимизировать нужно не число токенов в первом запросе, а совокупную стоимость каждого успешно выполненного задания.
Как писал цинский автор Чэнь Даньжань в «У янь. Цянь ду цзянь фань и»: «Кто не думает о целом, не способен продумать и одну область».
Справочные материалы
- Официальный анонс Google: Introducing Tool Retrieval in the Gemini API (2026-11-19)
- Ссылка:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- Ссылка:
- Техническая документация Google Tool Retrieval: настройка, оплата, официальные примеры и ограничения
- Ссылка:
aistudio.google.com/docs/tool-retrieval
- Ссылка:
- Документация Google Context caching: порог неявного кэширования и правила многораундового кэширования Gemini 4
- Ссылка:
aistudio.google.com/docs/caching
- Ссылка:
- Цены Google Gemini Developer API: тарифы на ввод, вывод и кэширование модели
- Ссылка:
aistudio.google.com/docs/pricing
- Ссылка:
Автор: техническая команда APIYI
По техническим вопросам: если хотите сравнить Token-затраты разных моделей (включая Gemini) в сценариях Agent, заходите на APIYI apiyi.com за тестовым лимитом — подробности подключения собраны в документации docs.apiyi.com


