
Коротко: OpenAI Batch API подходит для задач, где результат можно получить не сразу, запросы независимы друг от друга, а объём большой. Стоит он вдвое дешевле синхронного API и использует отдельный пул лимитов запросов. Ограничение — 24-часовое окно обработки, причём оно не гарантирует, что результат придёт к конкретному моменту. В офлайн-задачах — классификации по заранее заданным правилам, обработке базы знаний, оценке моделей — Batch можно рассматривать в первую очередь. А вот живую поддержку клиентов, интерактивные сценарии, где нужен немедленный ответ, и цепочки, где следующий шаг зависит от предыдущего результата, Batch API лучше не поручать.
Что вы узнаете из этой статьи?
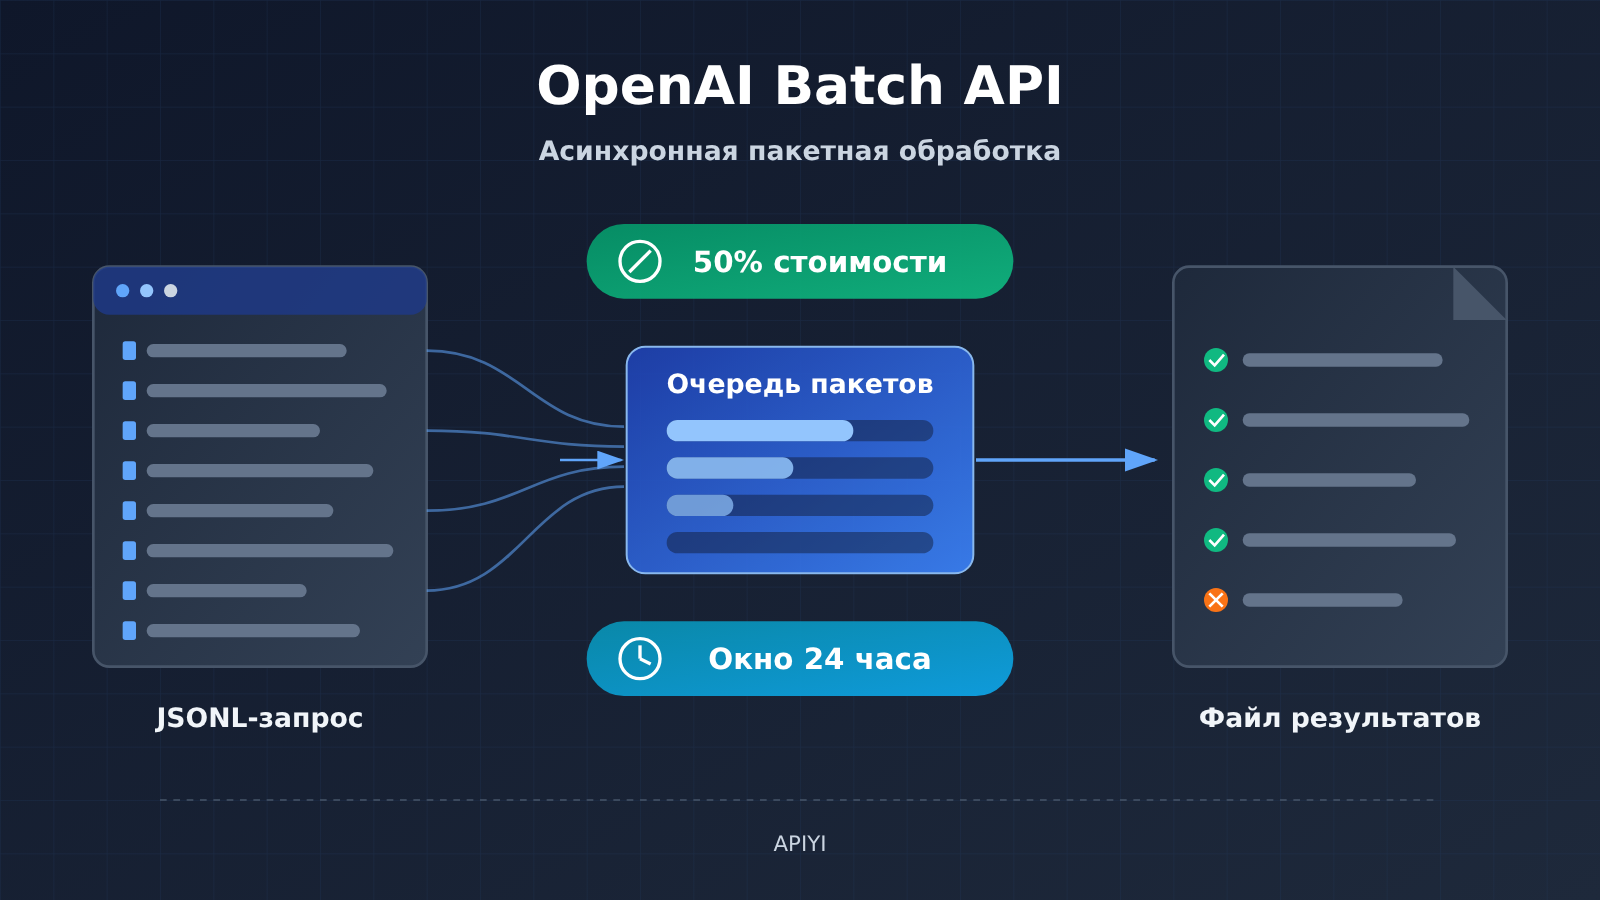
- Основные правила OpenAI Batch API: скидка, лимиты скорости, окно обработки, формат файлов и ограничения на количество запросов.
- Чем отличаются успешная отправка, успешная генерация и доставка результата в срок.
- Как рассчитывается оплата после истечения срока батча и как перезапустить только неудачные запросы.
- На чём именно экономит скидка 50% и какие расходы не уменьшаются вдвое.
- Практический способ понять, подходит ли задача для Batch.
Навигация: перед основным текстом — таблица ключевых понятий и краткий обзор того, на что это влияет: так проще сразу сформировать базовую картину. В разделе «Объективные факты» правила из официальной документации разобраны по пунктам; в разделе «Анализ и выводы» — что эти правила значат для выбора задач, расчёта стоимости и проектирования, плюс типы задач, для которых Batch подходит и не подходит.
Стоит оговориться: статья опирается на официальное, постоянно обновляемое руководство OpenAI по Batch; данные проверены по состоянию на 2026-11-17. У этого документа нет явной даты первой публикации, поэтому мы не считаем его описанием новой функции, выпущенной в тот день, а разбираем правила уже существующей возможности.
To Know: ключевые понятия для понимания OpenAI Batch API
| Понятие | Краткое объяснение |
|---|---|
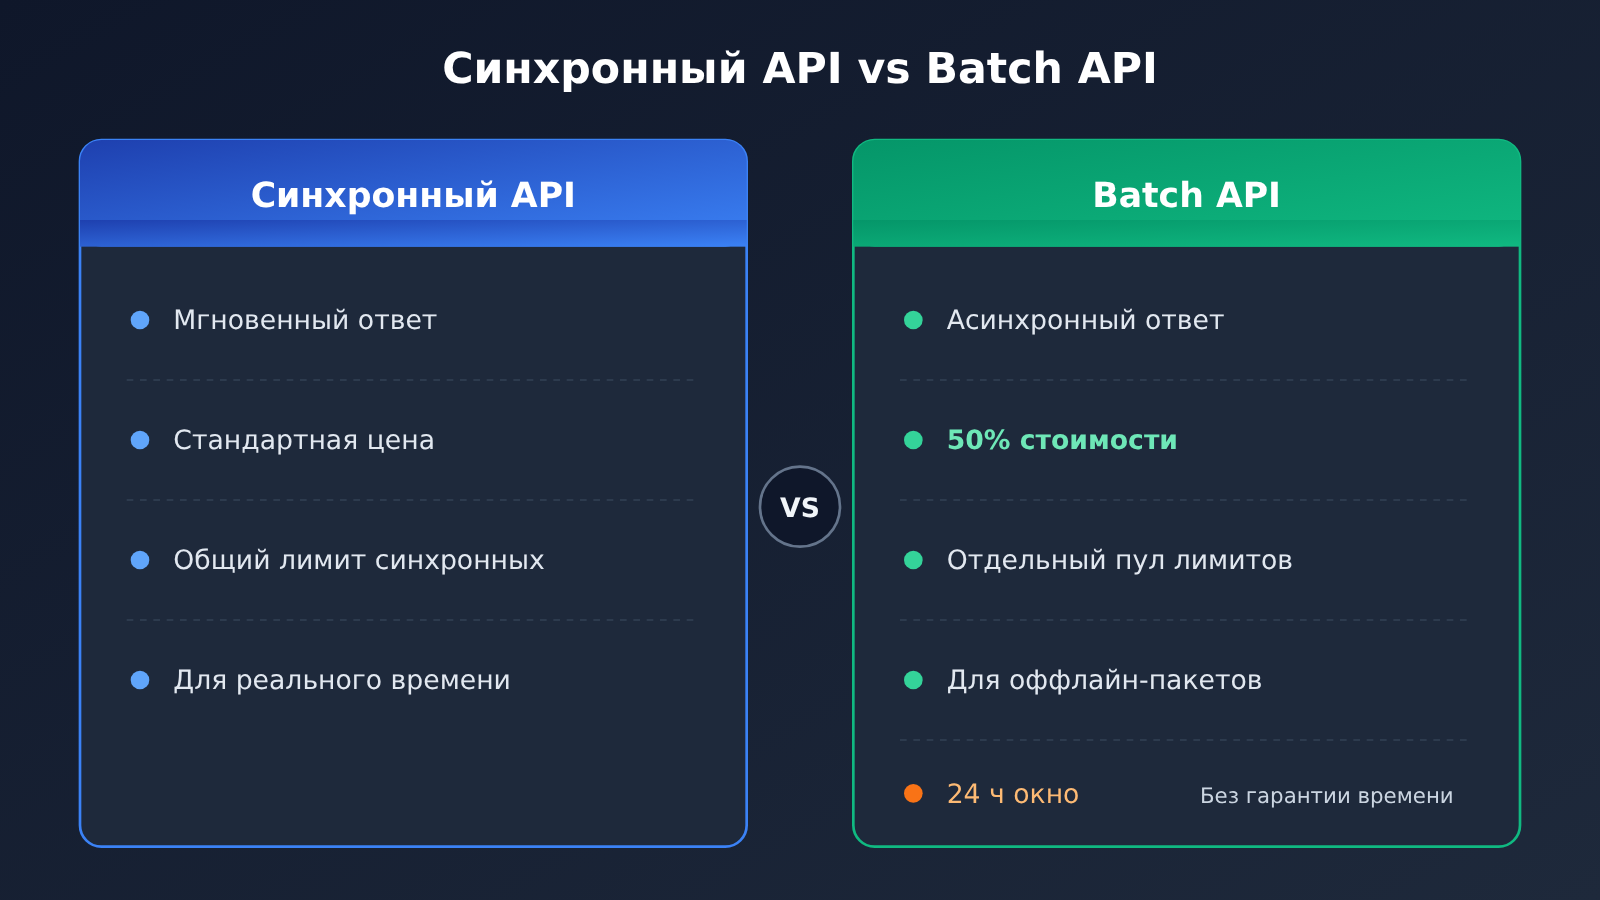
| Синхронный API | Обычный способ вызова: отправляете запрос, сразу ждёте и получаете результат |
| Batch API | Интерфейс, который позволяет за один раз отправить много запросов, обрабатывает их асинхронно и позже возвращает результаты единым пакетом |
| JSONL | Текстовый формат, в котором каждая строка — отдельный JSON-объект; в Batch каждая строка соответствует одному запросу |
| custom_id | Уникальный идентификатор, который вы задаёте для каждого запроса, чтобы сопоставить результат с исходным запросом |
| Отдельный пул лимитов скорости | Ограничения скорости для Batch-запросов считаются отдельно от синхронных и не вытесняют друг друга |
| 24-часовое окно обработки | Срок обработки батча; после его истечения незавершённые запросы отменяются |
| Просроченный батч | Батч, который не был полностью выполнен в пределах окна обработки |
Быстрый обзор влияния OpenAI Batch API
- Разработчикам: API-расходы на офлайн-пакетные задачи можно оценивать как половину цены синхронных запросов, при этом они не расходуют лимиты скорости онлайн-сервисов. Но придётся самому реализовать сопоставление по custom_id, повторную отправку при сбоях и проверку результатов.
- Командам контента и данных: масштабная классификация, суммирование, очистка базы знаний — так выгоднее. Цена — отказ от «результата сразу»; в сроках сдачи нужно оставлять запас.
- Исследователям и оценщикам: для масштабных прогонов тестовых наборов Batch подходит идеально. Но учтите: в одном файле можно использовать только одну модель, для сравнения нескольких моделей придётся разбивать на несколько файлов.
- Продуктовым и операционным руководителям: нельзя понимать «24 часа» как «завтра утром точно будет готово». Давая внешние обещания по срокам, стоит рассматривать Batch как канал «по мере возможности» (best-effort).
OpenAI Batch API: что известно точно
Правила тарификации и лимитов Batch API
Согласно официальному руководству по Batch (документация OpenAI: developers.openai.com/api/docs/guides/batch), у Batch API есть три ключевые особенности:
- Скидка на стоимость: на 50% дешевле по сравнению с синхронным API.
- Отдельные лимиты скорости: используется собственный пул лимитов, он не делится квотой с синхронными запросами.
- Окно обработки: пакет обрабатывается в течение 24 часов.
Какие модели и эндпоинты поддерживаются — смотрите официальный список в документации. Сейчас нельзя обобщённо говорить, что «Batch поддерживают все модели».
Формат файлов и лимиты количества в Batch API
| Параметр | Требование | Что это значит на практике |
|---|---|---|
| Формат файла | JSONL, одна строка — один запрос | Каждая строка — отдельная задача |
| Идентификатор запроса | У каждого запроса свой уникальный custom_id | По нему же потом сопоставляются результаты |
| Ограничение по модели | В одном файле допустима только одна модель | Задачи с несколькими моделями придётся разбивать на несколько файлов |
| Лимит количества | До 50 000 запросов в одном пакете | Если больше — отправляйте частями |
| Лимит объёма | Максимальный размер файла пакета — 200 МБ | Задачи с длинным контекстом могут упереться в лимит объёма раньше |
| Порядок вывода | Совпадение с порядком ввода не гарантируется | Соотносить результаты по номеру строки нельзя |
Ниже — примерная структура одной строки запроса, чтобы было видно, где находится custom_id. Конкретные эндпоинты и параметры — по списку поддерживаемых в официальной документации:
{"custom_id": "article-001", "method": "POST", "url": "/v1/chat/completions", "body": {"model": "MODEL_NAME", "messages": [{"role": "user", "content": "为以下主题写一段摘要:..."}]}}
Правила истечения срока и тарификации Batch API
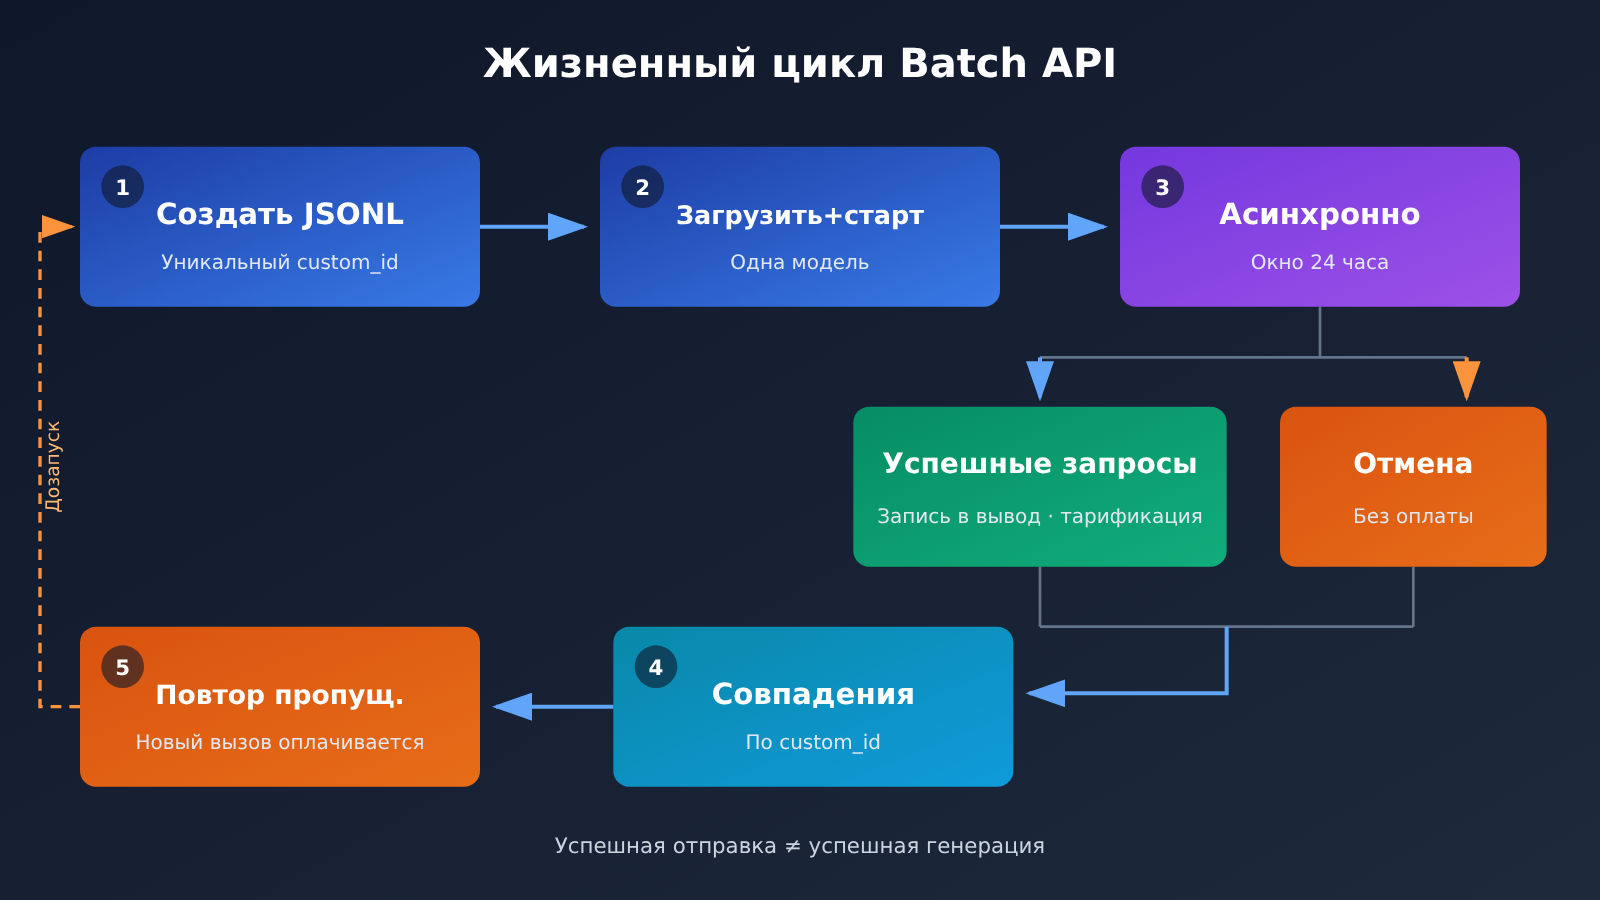
Если пакет не укладывается в окно обработки, незавершённые запросы в нём отменяются. Уже полученные успешные результаты по-прежнему можно скачать, а оплата взимается только за успешные запросы.
Документация напоминает ещё об одном: успешная отправка ≠ успешная генерация. То, что пакет принят, означает лишь, что он попал в обработку, и вовсе не гарантирует, что каждая строка даст результат. 24-часовое окно — тоже не обещание «завтра утром в определённый момент всё будет готово».
Анализ и оценка OpenAI Batch API
На чём именно экономит скидка в 50%
«Скидка 50%» касается только стоимости вызова модели при пакетной обработке. Ниже — пример из проектирования, цифры не взяты из реальных замеров.
Предположим, что по тарифу синхронных запросов задача стоит 100 рублей. Тогда те же запросы, отправленные через Batch, по этой иллюстрации обойдутся в 50 рублей. Но общая стоимость проекта вовсе не обязательно уменьшится вдвое, потому что некоторые виды затрат скидка не покрывает:
| Статья затрат | Дешевеет ли вдвое с Batch | Пояснение |
|---|---|---|
| Стоимость вызова модели для пакетных запросов | Да | Иллюстрация: 100 рублей при синхронном режиме соответствуют 50 рублям в Batch |
| Вызовы инструментов на этапе предварительного исследования | Нет | Например, сначала поиск и разведка, потом решение, что именно писать |
| Ручная проверка | Нет | Затраты на людей не зависят от способа тарификации |
| Дополнительные повторные попытки | Нет, считаются отдельно | После сбоя или истечения срока догоняющий прогон даёт новые вызовы |
| Разработка и сопровождение | Нет | На генерацию файлов, сопоставление результатов и логику повторной отправки нужно вкладываться |
Поэтому при составлении бюджета скидку в 50% стоит применять только к «той части вызовов, которую можно пустить в пакет», а не срезать весь бюджет проекта наполовину. Если в проекте велика доля исследования и проверки, общая экономия от Batch окажется заметно меньше 50%.
Как понимать 24-часовое окно
24-часовое окно описывает срок обработки, а не гарантию доставки. Разумнее всего относиться к результатам Batch так: «в пределах окна они, скорее всего, будут доступны, но часть может отсутствовать» — и заранее оставлять в графике время на повторный прогон.
Если бизнес требует «к 9 утра завтра обязательно получить все результаты», рассчитывать только на одну отправку Batch рискованно. Для задач с жёсткими сроками можно отправить задание заранее,预留reserve — оставить окно на повторный прогон или перевести ключевую часть на синхронные запросы.
custom_id — ядро инженерного дизайна Batch
Поскольку порядок вывода не гарантируется, сбор результатов должен полностью опираться на custom_id. А значит, custom_id нужно наделять бизнес-смыслом ещё на этапе проектирования и делать глобально уникальным — например, «тип задачи-номер пакета-порядковый номер».
Следующий пример дизайна тоже не из реальных тестов: чтобы сгенерировать 20 независимых статей одной моделью, можно записать 20 строк JSONL. Если в итоге 18 статей пройдут успешно, а 2 отменятся из-за истечения срока, достаточно по custom_id найти эти две отсутствующие и отправить их заново — перезапускать все 20 не нужно. За успешные 18 списывается плата как за успешные запросы, за отменённые 2 — нет.
Ключевые моменты этого процесса можно свести к следующему:
- Перед отправкой проверить, что custom_id в каждой строке уникален.
- После сбора результатов вычесть множество выходных custom_id из множества входных custom_id — получится список отсутствующих.
- Сгенерировать новый JSONL только для списка отсутствующих и отправить его снова.
- Повторный прогон создаёт новые расходы на вызовы модели — их нужно учитывать в бюджете.
Мультимодельные сценарии и зависимости нужно обрабатывать раздельно
Один файл может использовать только одну модель. Если в рамках одного проекта нужно, чтобы модель A занималась классификацией, а модель B — суммаризацией, придётся подготовить два файла, каждый отдельно подать и отдельно же собрать результаты.
Ещё важнее вопрос зависимостей. Если процесс такой: «сначала исследуем материалы, потом по выводам исследования решаем, что писать», и второй шаг зависит от вывода первого, Batch не будет выстраивать эти два шага за вас автоматически. Нужно после сбора результатов первой партии сформировать вторую партию запросов своей программой и уже её подать. Это также значит, что общее время всей цепочки может складываться из нескольких окон обработки.
Какие задачи подходят для OpenAI Batch API
| Тип задачи | Подходит ли Batch | Причина |
|---|---|---|
| Пакетная классификация по заданным правилам | Подходит | Правила фиксированы, элементы независимы, срочный ответ не нужен |
| Обработка базы знаний (суммаризация, очистка, структурирование) | Подходит | Большой объём данных, можно сделать офлайн |
| Оценка моделей, пакетный инференс на тестовом наборе | Подходит | Задача естественно пакетная, не чувствительна к срокам |
| Пакетная генерация независимого контента одной моделью | Подходит | Каждая строка независима, при сбое можно перезапустить по custom_id |
| Поддержка клиентов в реальном времени, диалоги | Не подходит | Пользователю нужен мгновенный ответ — используйте синхронные вызовы |
| Задачи со строгими сроками сдачи | С осторожностью | 24-часовое окно не гарантирует конкретный момент времени |
| Многошаговый процесс «сначала исследование, потом контент» | Нужно организовывать самому | Batch не обрабатывает зависимости между шагами автоматически |
Простой способ определить, подходит ли задача, — задать три вопроса подряд: можно ли получить результат чуть позже? Каждый запрос независим от остальных? Объём достаточно велик, чтобы стоило писать логику для файлов и сбора результатов? Если на все три вопроса ответ «да», Batch обычно выгоднее. Если хотя бы один ответ «нет», задачу стоит разделить или сохранить синхронные вызовы.
Что стоит отслеживать дальше
Это официальная документация, которую постоянно обновляют, так что поддерживаемые модели, набор эндпоинтов, а также лимиты по количеству и размеру могут меняться. Дальше — прогноз: по мере того как в Batch будет попадать всё больше моделей и эндпоинтов, офлайн-оценка и рабочие процессы обработки данных всё чаще будут по умолчанию идти через пакетную обработку. Но при реальном подключении всё равно нужно ориентироваться на правила из документации на тот момент — не стоит слепо переносить цифры, актуальные на день проверки, из этой статьи.
Ценность Batch API в том, что он заставляет задуматься: какие задачи вообще могут подождать. Задачи, которые готовы ждать, получают половинную цену и запас по лимиту запросов, который никто не отвлекает. А задачи, где ответ нужен немедленно, по-прежнему уходят в синхронные запросы.
«Не спеши, не гонись за мелкой выгодой. Поспешишь — цели не достигнешь; погонишься за мелкой выгодой — большое дело не выйдет». — «Лунь юй», глава «Цзы Лу»


