
Nota do autor: Este artigo analisa os testes cegos, os benchmarks do apêndice e os depoimentos da equipe de produto na página de pesquisa da Tencent, compara Hy4 flash e GLM-5.3-Flash em tarefas diárias, codificação no terminal, custo e protocolo de integração, e explica qual dos dois pode ser chamado hoje na APIYI.
A Tencent Hunyuan lançou o Hy4 flash em 2026-11-16, e a empresa o posiciona como “o modelo mais barato para produtividade diária”. Muitas pessoas estão escolhendo entre o GLM-5.3-Flash e ele para ser o modelo principal do dia a dia. A página de pesquisa da Tencent apresentou três tipos de materiais: testes cegos humanos, tabelas de benchmark no apêndice e depoimentos da equipe de produto. As conclusões dos três não apontam exatamente na mesma direção.
Este não é um artigo de compromisso do tipo “cada um tem seus pontos fortes”. A seguir, os dados dos três são apresentados separadamente, com a fonte indicada para cada número. No fim, há uma escolha clara por cenário e também a indicação de qual modelo pode ser chamado diretamente hoje na APIYI.
Valor central: Ao terminar a leitura, você vai saber onde o Hy4 flash se sai melhor no teste cego, onde o GLM-5.3-Flash se sai melhor nos benchmarks do apêndice e quais protocolos e critérios de preço observar na integração.
Diferenças centrais entre Hy4 flash e GLM 5.3 Flash
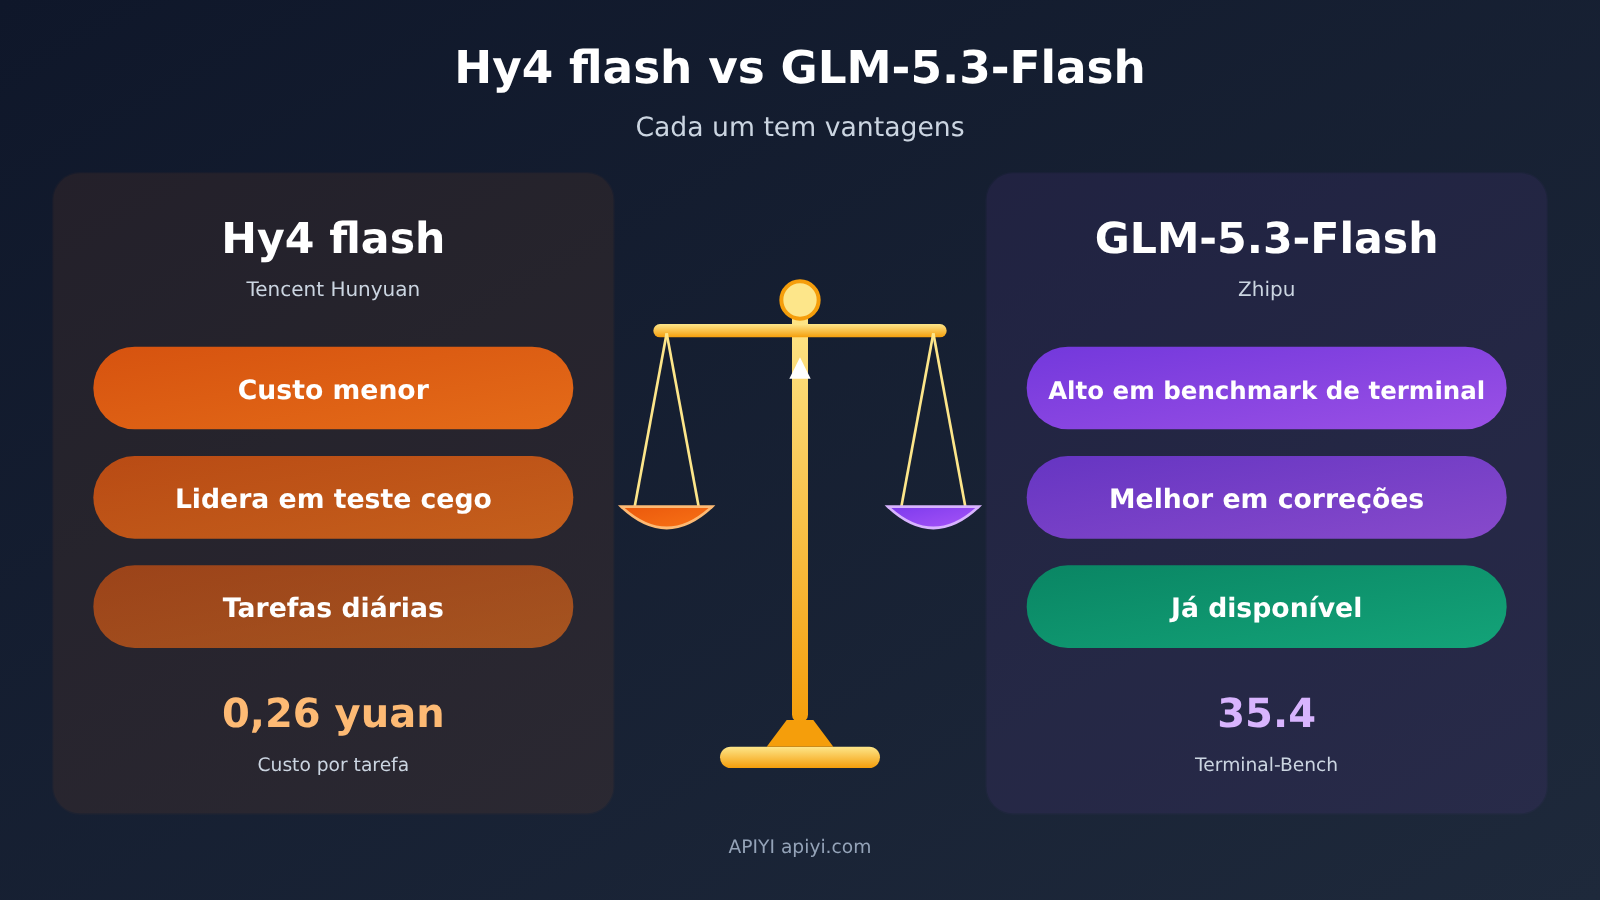
Vamos direto à conclusão: não existe um vencedor absoluto entre os dois. No teste cego da Tencent, o Hy4 flash teve maior satisfação, além de ser mais rápido e mais barato. No apêndice, em itens mais voltados para “correção e operação de terminal”, como Terminal-Bench 4.0 e PPTFixBench, o GLM-5.3-Flash tem pontuação mais alta.
| Dimensão de comparação | Hy4 flash | GLM-5.3-Flash | Fonte dos dados |
|---|---|---|---|
| Satisfação no teste cego (escala de 4 pontos) | 2.79 | 2.53 | Tabela de teste cego da página de pesquisa da Tencent (autodeclarado oficialmente) |
| Tempo mediano ponta a ponta | 6.7 minutos | 7.6 minutos | Idem |
| Custo por tarefa no teste cego | 0.26 RMB | 0.81 RMB | Idem, em RMB |
| Terminal-Bench 4.0 | 19.2 | 35.4 | Apêndice da página de pesquisa da Tencent |
| PPTFixBench | 23.7 | 28.6 | Apêndice da página de pesquisa da Tencent |
| MdCoEditBench (coescrita em Markdown) | 56.9 | 32.3 | Apêndice da página de pesquisa da Tencent |
| Especificações | 224B de parâmetros totais (incluindo 64B Engram), 12B ativos, contexto de 1M | 320B de parâmetros totais, 18B ativos, contexto de 1M, saída máxima de 128,000 | Página de pesquisa / página do modelo na APIYI |
| Plataformas de chamada | Tencent Cloud TokenHub, WorkBuddy, entre outras; ainda não disponível na APIYI | glm-5.3-flash já disponível na APIYI apiyi.com |
Página de pesquisa / lista de modelos da APIYI |
Todos os números desta tabela vêm do lado da Tencent; o GLM não entrou em campo para se defender. Ao interpretar, lembre-se: tanto o teste cego quanto o apêndice são autodeclarados oficialmente pela Tencent, e a maioria dos conjuntos de avaliação é interna da Tencent, não colocações em um ranking público final.
Três critérios de medição na comparação entre Hy4 flash e GLM 5.3 Flash
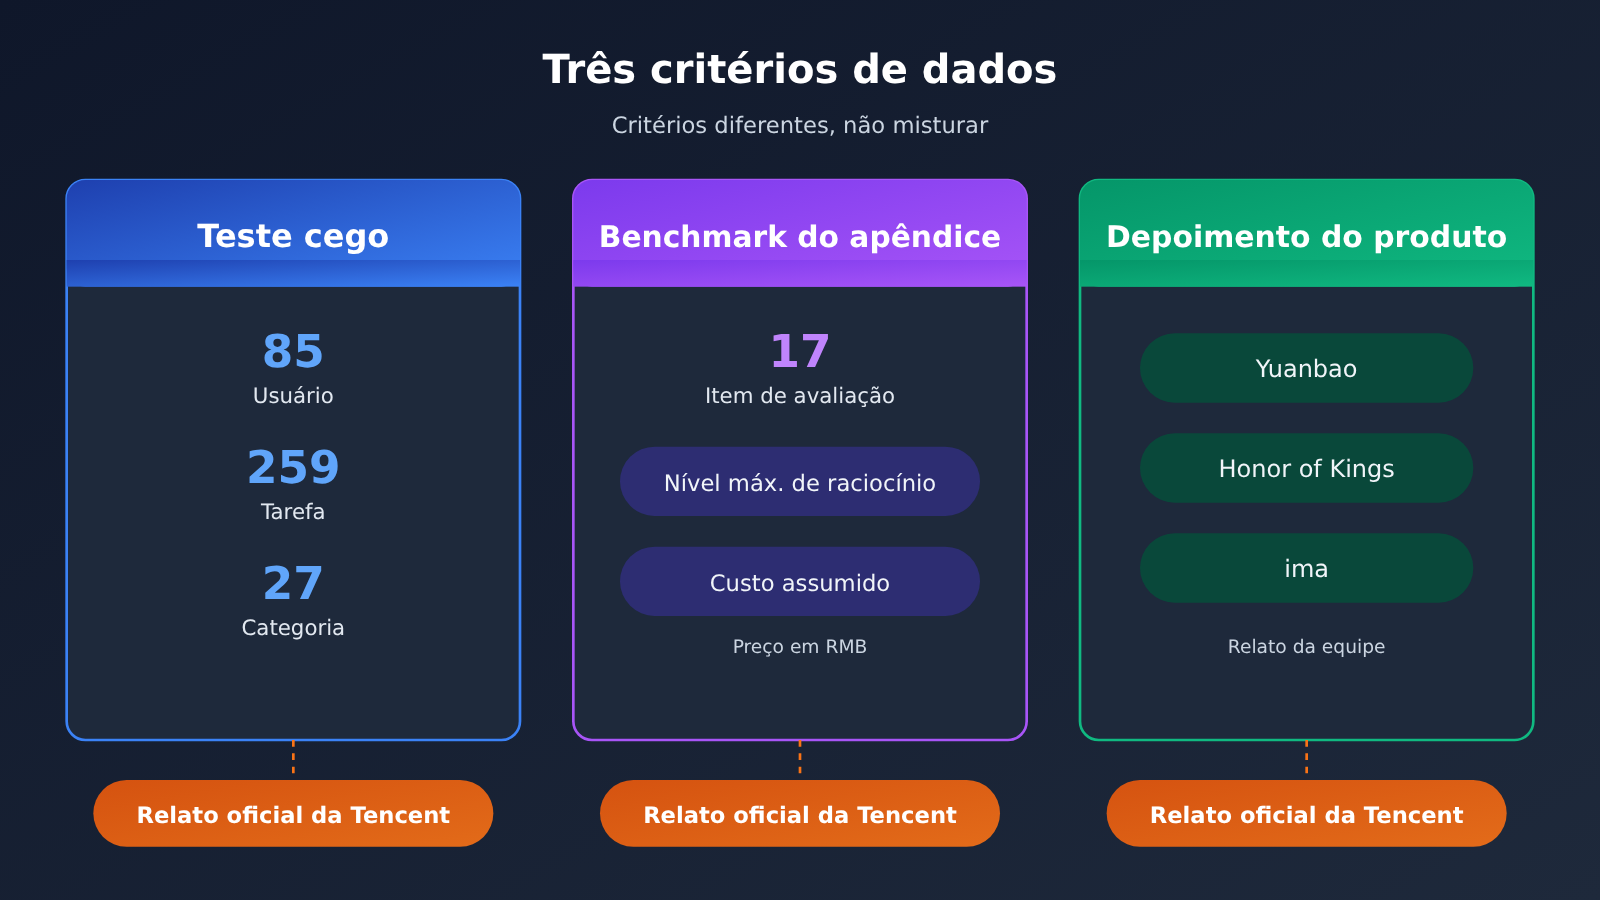
As três fontes usam critérios completamente diferentes; misturá-las na leitura facilmente leva a conclusões erradas:
- Teste cego: 85 usuários internos do WorkBuddy, 259 tarefas, 27 categorias. Os modelos externos (incluindo GLM) usaram o nível high; a linha do Hy4 flash não indica o nível.
- Tabela de apêndice: 17 itens de avaliação; todos os modelos usam seu respectivo nível máximo de raciocínio. Cada célula inclui o custo por tarefa, calculado com base no preço fixo em RMB definido pela Tencent.
- Depoimentos dos produtores: números auto-relatados por equipes como Yuanbao, Honor of Kings e ima; cada um tem seu próprio cenário e linha de base, e não podem ser combinados diretamente.
Resultados do teste cego: Hy4 flash vs. GLM 5.3 Flash
O teste cego é a evidência mais favorável ao Hy4 flash. A tabela completa do teste cego na página do estudo tem quatro linhas e é reproduzida abaixo como está (dados autodeclarados oficialmente pela Tencent):
| Modelo | Satisfação (escala de 4 pontos) | Tempo mediano ponta a ponta | Custo por tarefa (RMB) |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 (high) | 3.09 | 10.3 minutos | 1.20 RMB |
| Hy4 flash (nível não indicado) | 2.79 | 6.7 minutos | 0.26 RMB |
| Claude-Haiku-5.5 (high) | 2.81 | 6.8 minutos | 4.73 RMB |
| GLM-5.3-Flash (high) | 2.53 | 7.6 minutos | 0.81 RMB |
Olhando apenas para as duas linhas de Hy4 flash e GLM-5.3-Flash, o Hy4 flash tem 0.26 ponto de satisfação a mais, cerca de 0.9 minuto a menos e um custo por tarefa de aproximadamente um terço do GLM. Esse é o fundamento direto para dizer que ele “é mais barato no teste cego do dia a dia”.
Três pontos precisam ser lidos com atenção. Primeiro, a maior satisfação é a do DeepSeek, com 3.09, e não a do Hy4 flash. Segundo, o Hy4 flash fica 0.02 ponto abaixo do Haiku; a página do estudo usa a expressão “próximo” (close to), não “superior”. Terceiro, a “redução de 18 vezes no custo por tarefa” citada no post oficial vem de 4.73 RMB dividido por 0.26 RMB, e a comparação é com o Haiku, não com o GLM.
Como é calculado o custo do teste cego do Hy4 flash em comparação com o GLM 5.3 Flash
Os custos em RMB na tabela do teste cego foram calculados pela Tencent de acordo com seus próprios critérios de precificação. Eles refletem “quem gasta menos no mesmo lote de tarefas”, e não equivalem à sua fatura real em qualquer plataforma. O custo mais baixo do Hy4 flash vem, em parte, do preço de tabela mais baixo e, em parte, do que a página do estudo diz sobre o aprendizado por reforço ter reduzido em 50% a média de tokens de saída ponta a ponta.
A página do estudo também traz um conjunto de conclusões do WorkIndex: o custo médio por tarefa é 1/13 do Hy4 preview e 1/20 do Hy4. Essas frases pertencem apenas ao WorkIndex; não as use para substituir os números em RMB da tabela do teste cego, e elas também não têm relação com o GLM.
Hy4 flash vs. GLM-5.3-Flash: benchmark do apêndice
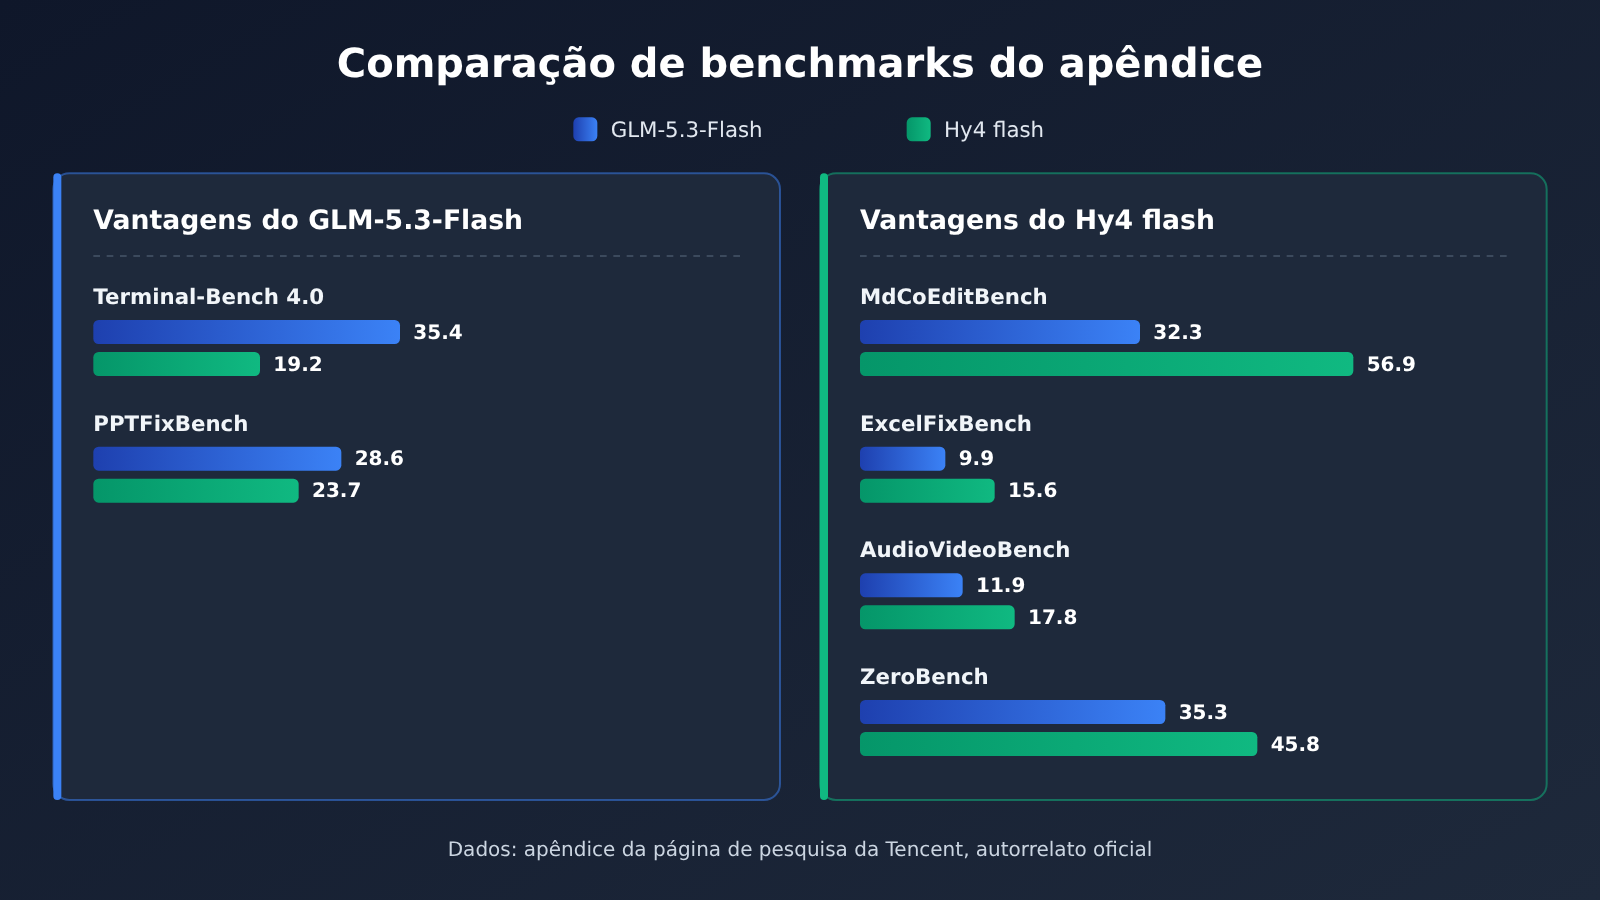
O apêndice é onde o GLM-5.3-Flash recupera terreno. A tabela abaixo foi extraída da imagem completa do Appendix da página de pesquisa da Tencent, mantendo apenas estas duas colunas, no formato “pontuação / custo por tarefa (RMB)”:
| Item de avaliação | Hy4 flash | GLM-5.3-Flash | Maior pontuação |
|---|---|---|---|
| PPTGenBench | 54.2 / 0.169 | 53.6 / 1.460 | Hy4 flash |
| PPTCoEditBench | 74.0 / 0.105 | 67.3 / 0.489 | Hy4 flash |
| PPTFixBench | 23.7 / 0.253 | 28.6 / 2.517 | GLM |
| MdCoEditBench | 56.9 / 0.057 | 32.3 / 0.133 | Hy4 flash |
| WordEditBench | 46.2 / 0.629 | 47.6 / 2.840 | GLM |
| ExcelFixBench | 15.6 / 0.310 | 9.9 / 2.879 | Hy4 flash |
| AudioVideoBench | 17.8 / 0.344 | 11.9 / 3.370 | Hy4 flash |
| BuddyVQA Atlas (sem ferramentas) | 48.5 / 0.007 | 50.1 / 0.019 | GLM |
| DeepSWE v1.1 | 64.6 / 0.290 | 67.8 / 3.230 | GLM |
| ProgramBench | 16.0 / 0.561 | 13.0 / 17.959 | Hy4 flash |
| Terminal-Bench 4.0 | 19.2 / 0.558 | 35.4 / 5.597 | GLM |
| APEX-Agents v1.1 | 63.1 / 0.087 | 51.5 / 0.485 | Hy4 flash |
| AutomationBench v1.0.6 | 52.2 / 0.038 | 48.4 / 0.104 | Hy4 flash |
| HLE-Full (com ferramentas) | 55.2 / 0.060 | 52.2 / 0.616 | Hy4 flash |
| OSWorld 2.1 | 68.1 / 0.451 | 64.0 / 3.803 | Hy4 flash |
| MMMU-Pro | 75.8 / 0.010 | 77.0 / 0.013 | GLM |
| ZeroBench-main (com ferramentas) | 45.8 / 0.077 | 35.3 / 1.861 | Hy4 flash |
A maior diferença está em Terminal-Bench 4.0: GLM 35.4, Hy4 flash 19.2, quase o dobro. Esse benchmark usa o harness do Claude Code, com até 500 rodadas e duração máxima de 13 horas por execução; o que está em jogo é a operação de terminal de longa duração. No PPTFixBench, o GLM também lidera por cerca de 5 pontos. Além disso, em DeepSWE, WordEditBench, BuddyVQA e MMMU-Pro, o GLM tem uma pequena vantagem.
Onde o Hy4 flash abre vantagem é na coescrita em Markdown (56.9 contra 32.3), na correção de tabelas, no processamento de áudio e vídeo e no ZeroBench. Esses itens estão mais próximos do trabalho de escritório do dia a dia: “escrever documentos, editar tabelas, processar materiais”. Isso bate com a recomendação da página de pesquisa: para engenharia de software de longa duração, continuar usando o Hy4, não o Hy4 flash.
A coluna de custos do apêndice é uma premissa da Tencent, não a fatura da plataforma
O texto original do apêndice explica: os custos seguem o preço oficial da API de cada modelo, com 1 dólar convertido a 7,2 yuans. O preço fixo usado para o GLM-5.3-Flash é de 0,8 yuan por milhão de tokens de entrada, 0,23 yuan em caso de acerto de cache e 2,8 yuan de saída, anotado como “preço padrão da API”. Isso é uma premissa do apêndice no momento em que a Tencent montou a tabela, não é o preço de tabela da APIYI — e não use esses números para calcular a sua fatura na APIYI.
Depoimentos das equipes de produto: Hy4 flash contra GLM 5.3 Flash
A página de pesquisa também traz depoimentos das equipes de produto da Tencent, e três deles citam o GLM-5.3-Flash diretamente. Todos são relatos das próprias equipes de produto, com cenários e baselines que não coincidem:
- Yuanbao (relato da equipe de produto): no diálogo geral, fica 2,52% acima do GLM-5.3-Flash, com diferença mais visível no diálogo multiturno. É uma avaliação interna da equipe do Yuanbao, não um ranking público.
- Honor of Kings (relato da equipe de produto): em relação ao DeepSeek-V4.1-Flash-1017 e ao GLM-5.3-Flash, a localização da causa raiz fica em nível parecido. As requisições ao modelo caem de 22,0% a 39,1%, os tokens de 40,5% a 61,2%, enquanto as chamadas de ferramentas sobem 51,2% e 7,7%, respectivamente.
- ima (relato da equipe de produto): em relação aos dois modelos acima, a espera média é de 18% a 35% menor, a nota das respostas é 1,8% maior e a qualidade do conteúdo, 8,1% maior.
O ponto em comum entre esses relatos: o Hy4 flash leva vantagem em “gastar menos tokens e esperar menos”, enquanto na qualidade fica empatado ou levemente à frente. Eles reforçam a conclusão do teste cego, mas não refutam a diferença do Terminal-Bench mostrada no apêndice — porque simplesmente não são o mesmo tipo de tarefa.
Hy4 flash vs GLM 5.3 Flash: preço e integração
O preço é a parte mais fácil de errar. Números de fontes diferentes não podem ser misturados, e a tabela abaixo separa a origem de cada preço (todos em dólares por milhão de tokens):
| Modelo / Fonte | Entrada | Saída | Leitura de cache | Observação |
|---|---|---|---|---|
| Hy4 flash (tabela de preços da página de pesquisa da Tencent) | 0.070 | 0.281 | 0.003 | Não é o preço exibido na APIYI; TokenHub com 50% de desconto até 2026-11-30 |
glm-5.3-flash (página do modelo na APIYI apiyi.com) |
0.15 | 0.50 | 0.03 | Já disponível, grupos CodexResponses, Default, SVIP, multiplicador 1x |
glm-5-3-flash-260828 (tabela geral da APIYI) |
0.15 | 0.499995 | 0.03 | Outro canal, não conflita com a linha acima |
hy4 (tabela geral da APIYI) |
0.85 | 2.55 | 0.045 | Este é o Hy4, não o Hy4 flash |
| Hy4 (tabela de preços da página de pesquisa da Tencent) | 0.834 | 2.501 | 0.042 | Preço da página de pesquisa, deve ser lido separadamente do preço da APIYI |
O desconto de 50% do Hy4 flash é um preço promocional por tempo limitado do TokenHub. A página de pesquisa não traz uma tabela separada com o preço após o desconto; se você mesmo dividir por 2 para estimar, lembre-se de que o preço de tabela volta a valer depois de 30 de novembro.
O Hy4 flash ainda não está disponível na plataforma; vamos disponibilizá-lo o quanto antes. O modelo e o preço devem ser conferidos na lista de modelos da plataforma. Hoje a APIYI só tem o hy4, nenhuma versão flash do Hunyuan. Se você precisa da versão do Hunyuan da Tencent com limite mais alto, pode usar o hy4 por enquanto; se o que você quer é exatamente o Hy4 flash, neste momento só restam os canais oficiais, como o Tencent Cloud TokenHub e o WorkBuddy. A página de pesquisa também não informa o ID do modelo de API, então antes de fazer a invocação, use o nome exibido no console do TokenHub.
Como invocar o GLM-5.3-Flash na APIYI
O glm-5.3-flash já pode ser invocado hoje. Na APIYI ele só aceita OpenAI Chat Completions, não aceita Anthropic Messages nem Responses. Isso determina se você consegue conectá-lo diretamente a alguns clientes:
- Crie uma chave no console do apiyi.com.
- Defina o
base_urldo cliente comohttps://api.apiyi.com/v1; o caminho da requisição é/chat/completions. - No corpo da requisição, preencha
modelcomglm-5.3-flashe passemessagesno formato OpenAI. - O raciocínio vem ativado por padrão; a entrada pode ser texto, imagem ou vídeo, e a saída é texto.
Se a sua ferramenta só envia requisições no formato Anthropic Messages, o glm-5.3-flash não funciona diretamente. Nesses casos, troque para um cliente que suporte Chat Completions ou use um modelo que ofereça tanto o endpoint chat quanto o messages. Parâmetros como janela de contexto, saída máxima e endpoints devem ser conferidos na página do modelo na APIYI.
🚀 Dica de integração: para modelos já disponíveis na APIYI, use a chave do apiyi.com e envie a requisição para
https://api.apiyi.com/v1; clientes compatíveis com OpenAI só precisam de dois ajustes de configuração para funcionar. Novos usuários têm cota gratuita de teste, então você pode experimentar oglm-5.3-flashprimeiro com suas tarefas do dia a dia.
Hy4 flash vs GLM 5.3 Flash: recomendações por cenário
Cenários em que vale escolher o Hy4 flash
- Escrita conjunta de documentos e Markdown: no MdCoEditBench do apêndice, 56,9 contra 32,3 — diferença clara.
- Reparo de planilhas e processamento de mídia de áudio e vídeo: nas duas provas, ExcelFixBench e AudioVideoBench, o Hy4 flash lidera.
- Tarefas diárias de alta frequência e sensíveis a custo: no teste cego, 0,26 yuan contra 0,81 yuan por tarefa (números divulgados pela própria Tencent).
- Produtos baseados em conversas multi-turno: a equipe do produto Yuanbao afirma 2,52% a mais em conversa geral, com vantagem mais evidente no multi-turno.
Cenários em que vale escolher o GLM-5.3-Flash
- Operações de terminal e tarefas longas de linha de comando: no Terminal-Bench 4.0 é 35,4 contra 19,2 — a maior diferença entre todos os itens.
- Tarefas de reparo de slides: PPTFixBench 28,6 contra 23,7.
- Precisa entrar no ar hoje: o
glm-5.3-flashjá está disponível na APIYI; o Hy4 flash ainda não. - Toolchain baseada em Chat Completions: clientes no formato OpenAI podem se conectar direto.
Hy4 flash vs GLM 5.3 Flash: recomendações de decisão
| Sua situação | Recomendação |
|---|---|
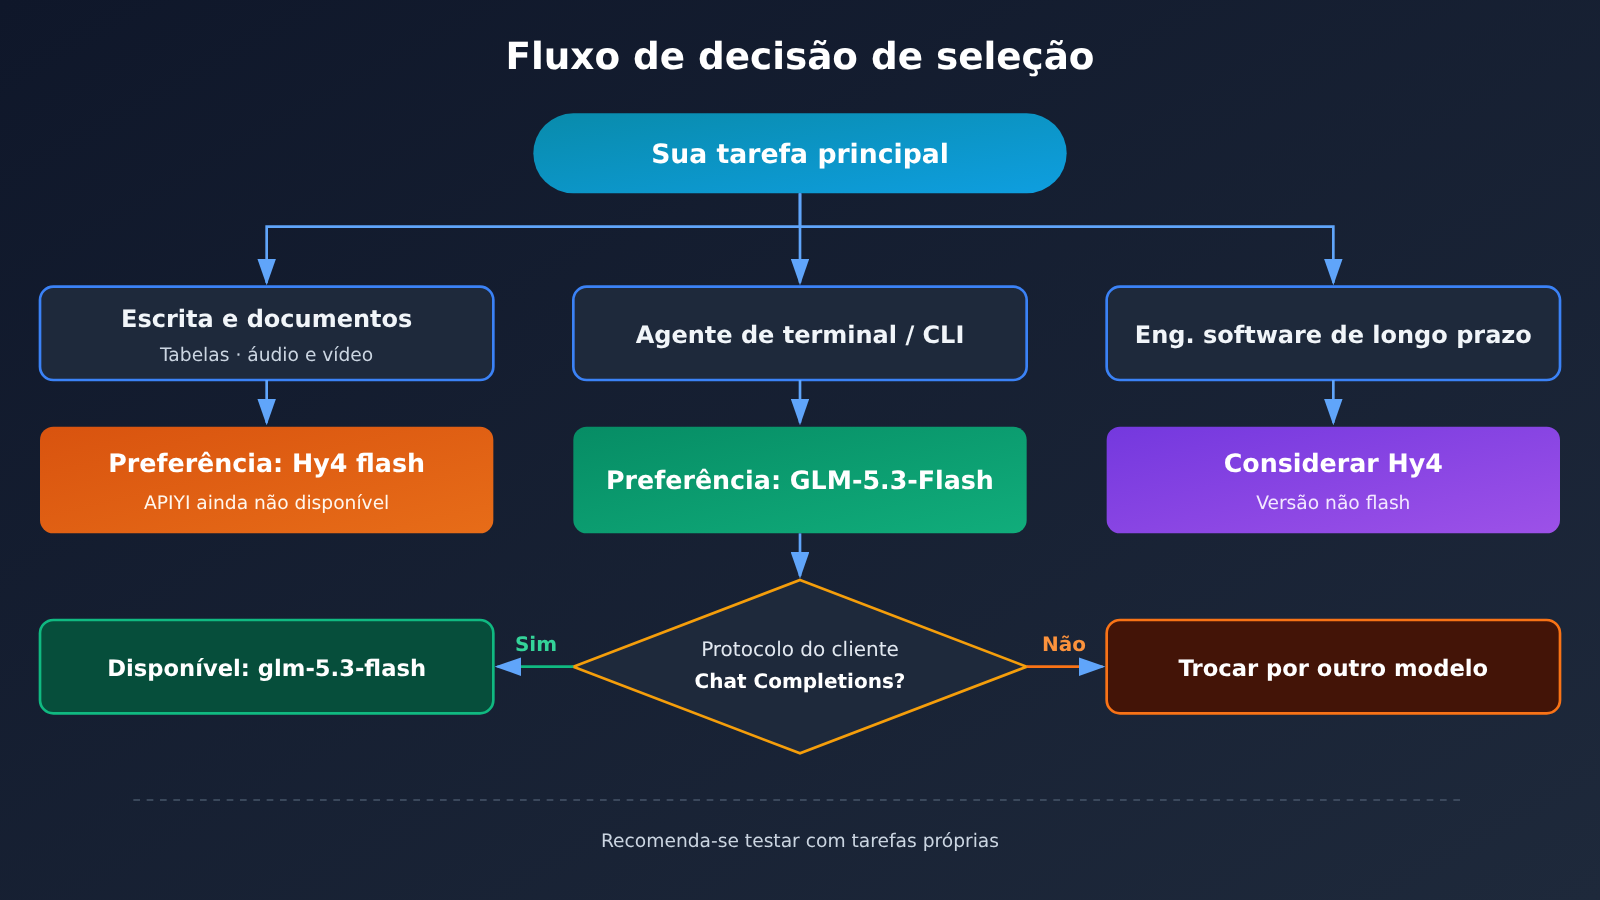
| Foco em escrita, documentos, planilhas e processamento de mídia | Espere o Hy4 flash ser lançado, ou teste primeiro pelo canal oficial da Tencent |
| Foco em operações de terminal e Agent de linha de comando | Escolha o GLM-5.3-Flash |
| Precisa entrar no ar hoje na APIYI | Escolha o glm-5.3-flash, via Chat Completions |
| O cliente só suporta Anthropic Messages | O glm-5.3-flash não serve; troque por um modelo que suporte messages |
| Engenharia de software de longa duração | Nenhum dos dois é a primeira escolha; a página de pesquisa recomenda o Hy4 |
💡 Dica de escolha: o teste cego e o apêndice apontam em direções diferentes, então o caminho mais seguro é rodar um lote das suas próprias tarefas com cada modelo. Dá para validar o
glm-5.3-flashagora mesmo na APIYI apiyi.com; quando o Hy4 flash for lançado, basta trocar o parâmetromodele comparar no mesmo código.
Perguntas frequentes (FAQ)
Q1: O que são, afinal, o Hy4 flash e o GLM-5.3-Flash?
O Hy4 flash é o modelo da Tencent Hunyuan lançado em 16/11/2026 para tarefas do dia a dia, com 224B de parâmetros totais, 12B ativos e 1M de janela de contexto. Já o GLM-5.3-Flash, conforme registrado na página de modelos do APIYI, tem 320B de parâmetros totais, 18B ativos e 1M de contexto, com lançamento pelo fabricante em 26/08/2026.
Q2: Comparando Hy4 flash com GLM 5.3 Flash, qual é o mais forte?
Depende do tipo de tarefa. No teste cego da Tencent, a satisfação do Hy4 flash foi 2,79 contra 2,53 do GLM; no apêndice, Terminal-Bench 4.0 e PPTFixBench ficam com o GLM, enquanto co-escrita em Markdown, tabelas, áudio e vídeo e ZeroBench ficam com o Hy4 flash. Todos os dados são auto-relatados pela própria Tencent.
Q3: O Yuanbao diz que o diálogo geral é 2,52% melhor que o GLM-5.3-Flash. Dá para confiar?
É uma avaliação autodeclarada pela equipe do produto Yuanbao, não é um ranking público e também não traz detalhes de metodologia. Serve como pista de que o Hy4 flash pode levar vantagem na direção de diálogo multi-turno, mas não convém tratar como veredito.
Q4: Os 0,8 yuan, 0,23 yuan e 2,8 yuan do GLM no apêndice são os preços do APIYI?
Não. São premissas de preço fixo em yuan (RMB) que a Tencent adotou ao montar a tabela do apêndice. Na página de modelos do APIYI, o `glm-5.3-flash` custa 0,15 de entrada, 0,50 de saída e 0,03 de leitura de cache em dólares por milhão de tokens — vale sempre conferir a lista de modelos da plataforma.
Q5: Já dá para chamar o Hy4 flash no APIYI?
O Hy4 flash ainda não está no catálogo; vamos disponibilizá-lo o quanto antes, e modelo e preço seguem a lista de modelos da plataforma. Por enquanto, o que dá para chamar no APIYI é `glm-5.3-flash` e `hy4` — atenção que `hy4` não é a versão flash. As novidades de lançamento podem ser acompanhadas na lista de modelos em apiyi.com.
Q6: O glm-5.3-flash pode ser usado em clientes que só aceitam o formato Anthropic?
Não. No APIYI, o `glm-5.3-flash` só oferece o endpoint OpenAI Chat Completions e não suporta Messages nem Responses. O cliente precisa conseguir apontar o base_url para `/v1` e enviar requisições Chat Completions.
Q7: Quais são as limitações conhecidas dos dois modelos?
O Hy4 flash tem só 19,2 pontos no Terminal-Bench 4.0, e a própria página de pesquisa admite que ele fica atrás do Hy4 em engenharia de software de longo prazo; os pesos, por ora, são apenas um plano de abertura do código. Já o GLM-5.3-Flash fica atrás em satisfação no teste cego e em co-escrita em Markdown, além de só funcionar via Chat Completions. Os dados comparativos dos dois vêm ambos do lado da Tencent.
Hy4 flash vs GLM 5.3 Flash: principais conclusões
- No teste cego, Hy4 flash leva vantagem: satisfação de 2,79 contra 2,53, 6,7 minutos contra 7,6 minutos e 0,26 yuan contra 0,81 yuan.
- Nos benchmarks de terminal, GLM sai na frente: Terminal-Bench 4.0 com 35,4 contra 19,2; no PPTFixBench o GLM também lidera.
- Nas tarefas de escritório do dia a dia, Hy4 flash pontua mais: escrita colaborativa em Markdown, correção de tabelas, áudio e vídeo, e ZeroBench tiveram pontuações maiores.
- Depoimento é só autodeclaração: os “2,52% a mais” citados pelo Yuanbao são uma declaração do próprio fornecedor, não um ranking público.
- Preços: diferencie as fontes: o valor em RMB no apêndice é uma hipótese da Tencent, e o valor em dólares na página do estudo é o preço de tabela; nenhum dos dois é o preço praticado pela APIYI.
- Hoje, o que dá para chamar é o GLM: o
glm-5.3-flashjá está disponível na APIYI (apiyi.com), com suporte apenas a Chat Completions.
Resumo
Conclusões principais da comparação entre Hy4 flash e GLM 5.3 Flash:
- Para tarefas do dia a dia, olhe para o Hy4 flash: no teste cego da Tencent ele foi mais bem avaliado, mais rápido e mais barato; também teve pontuação maior nos benchmarks de documentos e tabelas.
- Para tarefas de terminal, olhe para o GLM-5.3-Flash: a diferença no Terminal-Bench 4.0 é de quase o dobro, então tarefas longas de linha de comando não devem usar o Hy4 flash.
- Na prática, pesam disponibilidade e protocolo: hoje, o que dá para chamar na APIYI é o
glm-5.3-flash, e somente via Chat Completions; o Hy4 flash ainda não está disponível.
Se suas tarefas são principalmente redação e documentos, vale acompanhar o lançamento do Hy4 flash; se você faz mais operações de terminal ou precisa colocar algo em produção agora, o glm-5.3-flash é a escolha mais direta. Recomendo usar a cota gratuita de testes do apiyi.com, rodar uma rodada com suas tarefas reais e então decidir.
📚 Referências
-
Página de pesquisa do Tencent Hunyuan Hy4 flash: tabela de testes cegos, benchmarks do apêndice, depoimentos dos produtos e preços de tabela
- Link:
hy.tencent.ai/research/hy4-flash - Observação: todos os testes cegos, pontuações do apêndice e depoimentos deste artigo vêm desta página e são auto-relatados pela Tencent
- Link:
-
Post oficial de lançamento do Tencent Hunyuan: lançamento do Hy4 flash e preços de tabela da API
- Link:
x.com/TencentHunyuan/status/2122217770314301469 - Observação: origem da “redução de 18 vezes no custo da tarefa”, comparada com o Claude Haiku 5.5
- Link:
-
Página do modelo GLM-5.3-Flash no APIYI: parâmetros, contexto, endpoints e preços
- Link:
docs.apiyi.com/models/glm-5-3-flash - Observação: as especificações e o protocolo do
glm-5.3-flashseguem esta página
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site APIYI. Para mais modelos e instruções de integração, acesse a central de documentação em docs.apiyi.com


