
Resposta direta: em condições ideais, o cache de prompt padrão de 30 minutos da OpenAI já fica mais barato a partir do segundo uso; o cache de 12 horas só começa a compensar no terceiro uso. Essas condições ideais significam: o mesmo prefixo fixo é gravado por inteiro no cache uma única vez, todas as requisições seguintes acertam o cache e não há regravações no meio do caminho. Pelos preços oficiais da faixa de contexto curto padrão do gpt-6-luna, quando um prefixo fixo de 10.000 tokens é usado 10 vezes no total, o cache de 30 minutos economiza cerca de 78,5% em comparação a não usar cache, e o cache de 12 horas economiza cerca de 66%. Mas essa é apenas a conta da parte do prefixo fixo — não quer dizer que a requisição inteira saia com desconto.
O que você vai encontrar neste artigo?
- As condições reais para um acerto de cache de prompt, e por que elas são diferentes de “semanticamente parecido”.
- Como as duas taxas de gravação (30 minutos e 12 horas) são cobradas, e por que a tarifa normal de entrada não pode ser somada a elas.
- Um conjunto de exemplos verificáveis com 1, 2, 3 e 10 usos, além da fórmula de retorno válida para qualquer comprimento de prefixo.
- O que essas regras significam, na prática, para quem projeta a estrutura do prompt e organiza tarefas em lote.
Índice: começamos com uma tabela conceitual e um resumo de impactos para alinhar a terminologia e os públicos afetados; a seção “Fatos objetivos” reúne as regras de cache, os preços e os dados de exemplo dos documentos oficiais; a seção “Análise e julgamento” explica a matemática por trás da linha de retorno e discute estrutura de prompt, organização de lotes e equívocos comuns.
OpenAI Prompt Caching To Know: explicação dos conceitos
| Conceito | Explicação resumida |
|---|---|
| Cache de prompt (Prompt Caching) | A OpenAI faz cache dos prefixos de prompt que se repetem; quando uma requisição posterior acerta o cache, a cobrança usa o preço mais baixo de “leitura de cache” |
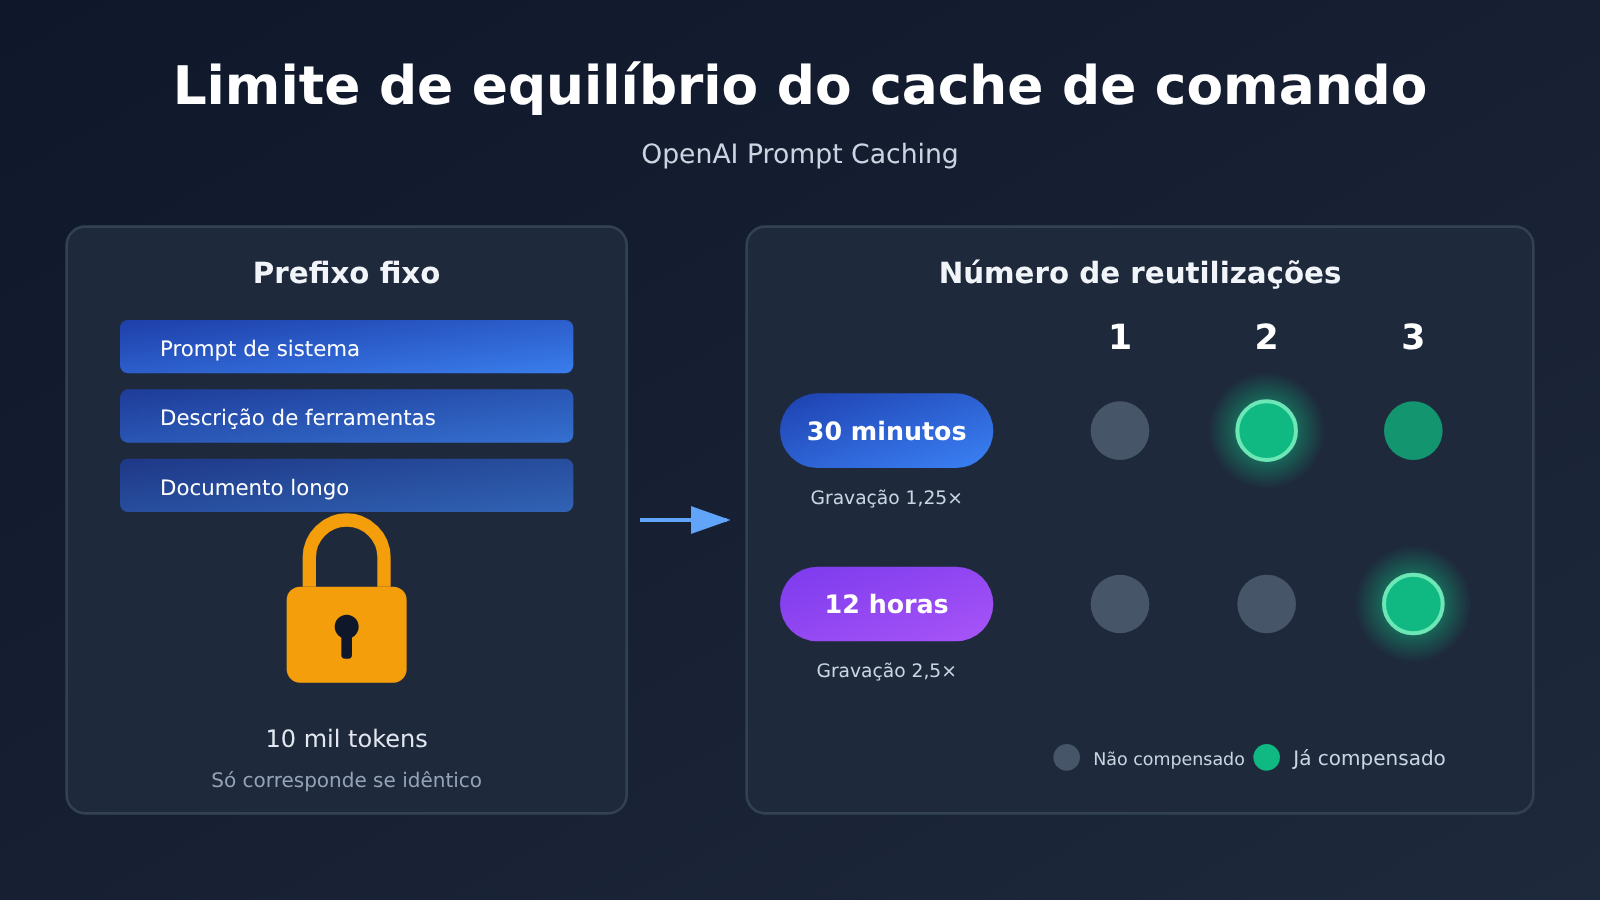
| Prefixo do prompt | O conteúdo contínuo desde o início da entrada de uma requisição; o cache corresponde a prefixos exatamente idênticos, não a conteúdos com significado parecido |
| Tokens de entrada visíveis | Tokens de entrada contados para o limite mínimo do cache; modelos GPT-5.6 e posteriores exigem pelo menos 1024 para poder usar o cache |
| Escrita no cache | Cobrança no momento em que o prefixo é gravado no cache pela primeira vez; é precificada como um múltiplo do preço normal de entrada e representa uma taxa total de escrita |
| Leitura do cache | Cobrança quando requisições posteriores acertam o cache; o preço é bem menor que o da entrada normal |
| Cache de 30 minutos / 12 horas | Dois níveis de validade do cache, com 30 minutos como padrão; o nível de 12 horas está disponível na Responses API e a escrita custa mais caro |
| Nível de processamento Standard | Nível de processamento padrão da tabela oficial de preços; níveis diferentes têm preços diferentes e não podem ser misturados |
| Nível Short context | A tabela oficial de preços separa os níveis por comprimento de contexto; este artigo usa apenas os preços de contexto curto |
Visão rápida do impacto do cache de prompts da OpenAI
- Desenvolvedores de API: se o cache economiza dinheiro depende do número de reutilizações e da taxa de acerto dentro do período válido — e não de “ativei, então economizo”. Na faixa de 30 minutos, basta usar um total de 2 vezes (a primeira escrita mais um acerto) para ficar mais barato do que não usar cache; já a faixa de 12 horas tem custo de escrita maior e precisa de mais reutilizações para diluir o gasto.
- Times que criam Agents ou mantêm prompts de sistema longos: coloque regras fixas, descrições de ferramentas e documentos longos na frente, e o conteúdo variável depois, para que o prefixo acerte de forma estável. Isso é uma questão de design de estrutura, não de ajuste de parâmetros.
- Times com tarefas de processamento em lote: concentre as requisições com o mesmo prefixo e envie dentro do período de validade do cache; isso aumenta bastante a taxa de acerto. Se as tarefas ficam espalhadas ao longo do dia, vale avaliar se a faixa de 12 horas compensa.
- Quem cuida da contabilidade de custos: o cache afeta apenas a parte da despesa de entrada referente ao prefixo fixo — saída, material novo, chamadas de ferramentas e novas tentativas ficam de fora. Na planilha de orçamento, não dá para aplicar a porcentagem de economia do cache diretamente na fatura total.
Fatos objetivos sobre o cache de prompts da OpenAI
Fonte e atualidade das informações
As informações deste artigo foram verificadas em 2026-11-17, com base na documentação oficial mantida continuamente pela OpenAI: o Guia de cache de prompts developers.openai.com/api/docs/guides/prompt-caching e a página de preços developers.openai.com/api/docs/pricing.md. Esses documentos são atualizados constantemente e não verificamos a data da primeira publicação das regras em questão. Portanto, este artigo não é uma notícia do dia, mas uma compilação e uma estimativa das regras vigentes.
Regras de acerto do cache de prompts
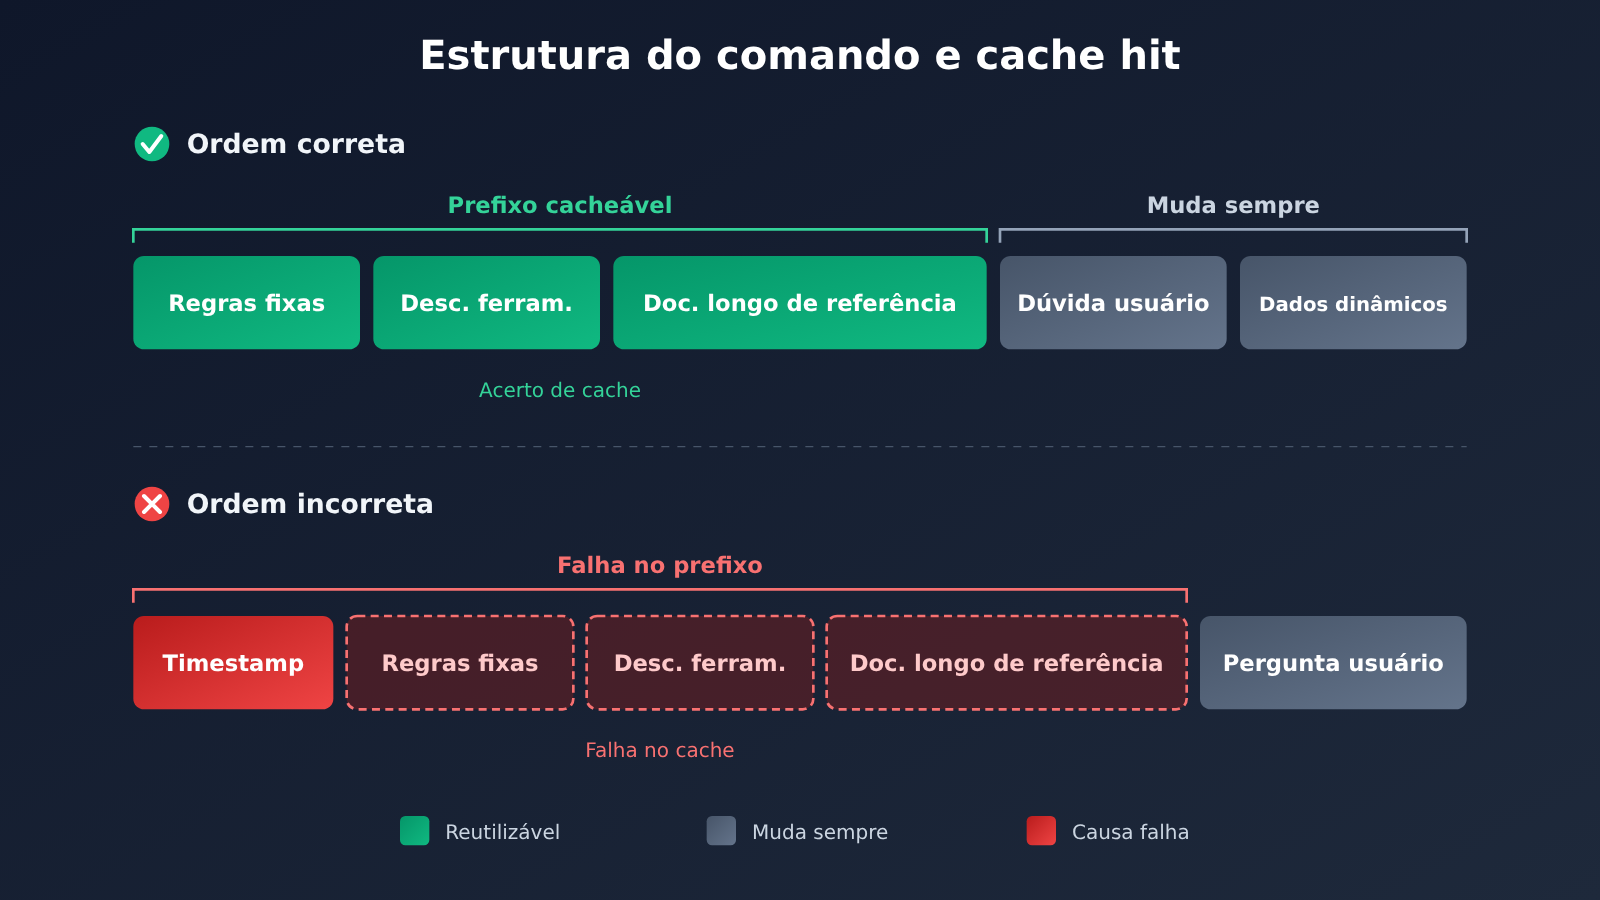
O cache de prompts da OpenAI corresponde a prefixos de prompt idênticos. Dois prompts podem ter quase o mesmo significado, mas não terão acerto no cache se o conteúdo da parte inicial for diferente. Não se trata de uma busca por similaridade semântica. Isso significa que qualquer alteração de um único caractere no prefixo, como inserir a hora atual no início do prompt de sistema, pode fazer com que todo o conteúdo seguinte perca a chance de acerto.
Para modelos GPT-5.6 e posteriores, o limite mínimo para usar o cache é de pelo menos 1024 tokens de entrada visíveis. As regras dos modelos antigos são diferentes; as conclusões deste artigo sobre preços e limites se aplicam apenas às novas regras descritas na documentação oficial e não podem ser aplicadas diretamente a modelos antigos.
Duas taxas de escrita em cache
| Nível de cache | Taxa de escrita (em relação à entrada normal) | Observação de uso |
|---|---|---|
| 30 minutos (padrão) | 1.25x | Tempo de validade padrão do cache |
| 12 horas | 2.5x | Disponível na Responses API |
A documentação oficial deixa claro que ambos os multiplicadores correspondem à taxa de escrita total: na primeira escrita a cobrança já segue essa taxa, sem somar de novo a tarifa de entrada normal por cima. Vale também destacar que as 12 horas se referem ao tempo de validade do cache, e não a um prazo de exclusão dos dados — são duas coisas diferentes e não devem ser confundidas.
Preços oficiais do gpt-6-luna
A seguir estão os preços do gpt-6-luna na página oficial de preços da OpenAI, no nível de processamento Standard e no nível Short context, com unidade por milhão de tokens. Esses valores não se aplicam ao nível de contexto longo nem a outros níveis de processamento, e também não correspondem ao preço de nenhuma plataforma de terceiros.
| Item de cobrança | Preço (USD / milhão de tokens) |
|---|---|
| Entrada normal | $0.10 |
| Saída | $0.50 |
| Leitura de cache | $0.01 |
| Escrita de cache de 30 minutos | $0.125 |
| Escrita de cache de 12 horas | $0.25 |
Como dá para ver, o preço de escrita de 30 minutos ($0.125) é exatamente 1.25x a entrada normal, e o de 12 horas ($0.25) é 2.5x — batendo com a regra de multiplicadores da documentação. Já a leitura de cache custa apenas um décimo da entrada normal.
Exemplo de cálculo do número de reutilizações
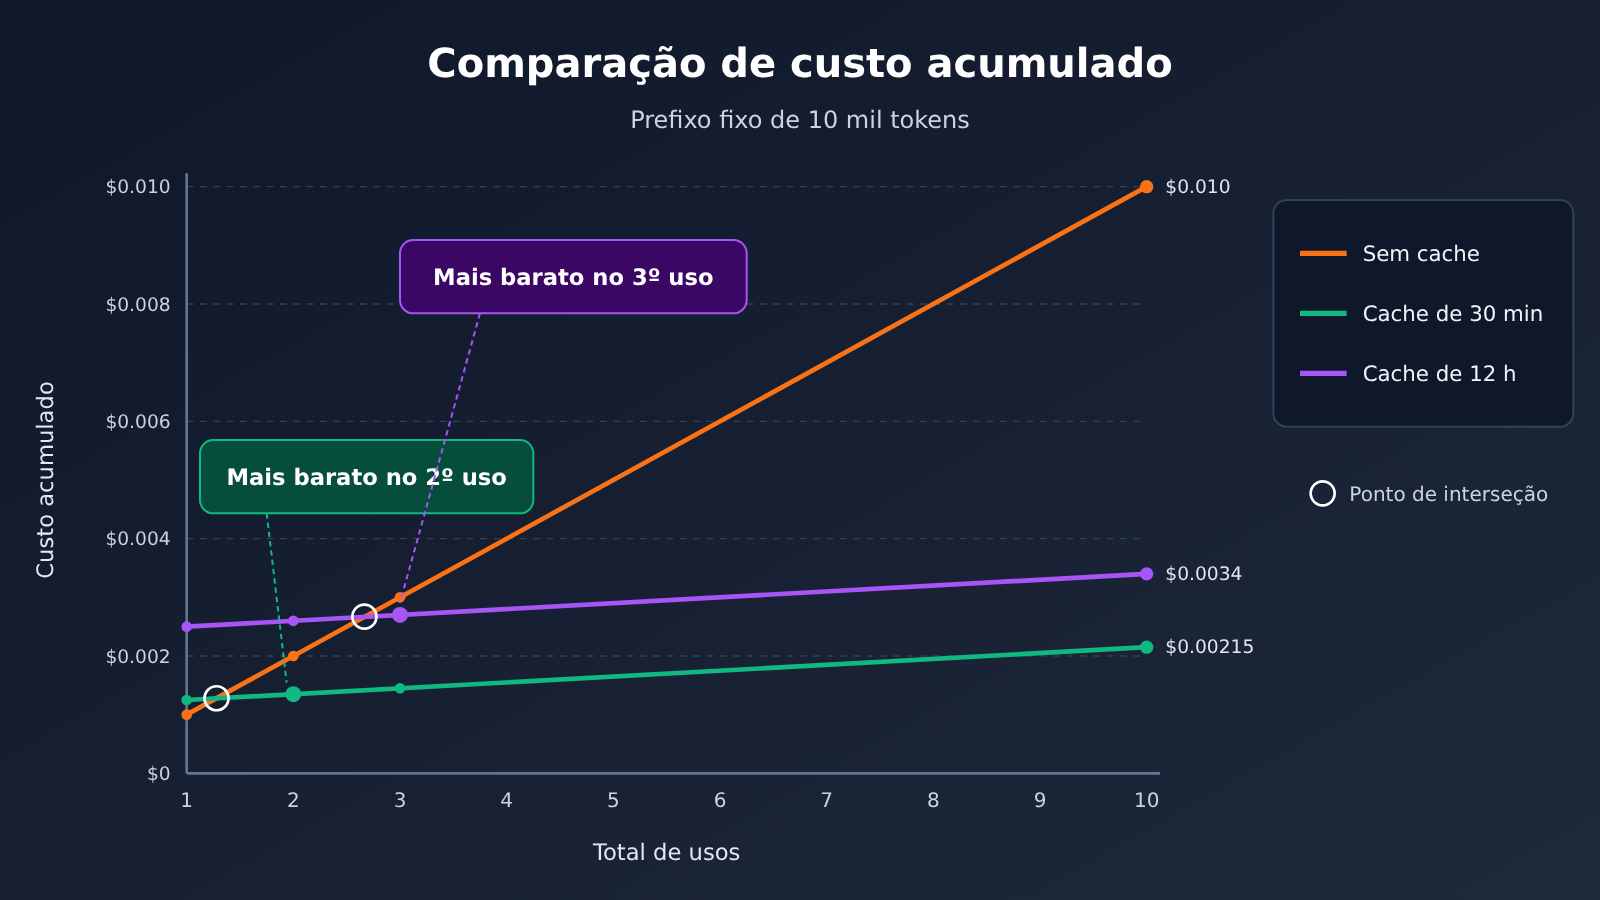
Os exemplos abaixo são cálculos teóricos derivados dos preços oficiais, e não medições reais. As premissas são: prefixo fixo de 10.000 tokens cobrados, gravado integralmente no cache na primeira utilização, com todas as utilizações seguintes acertando o cache, sem gravações duplicadas no período.
| Total de utilizações | Sem cache | Cache de 30 minutos | Cache de 12 horas |
|---|---|---|---|
| 1 vez | $0.001 | $0.00125 | $0.0025 |
| 2 vezes | $0.002 | $0.00135 | $0.0026 |
| 3 vezes | $0.003 | $0.00145 | $0.0027 |
| 10 vezes | $0.010 | $0.00215 | $0.0034 |
Nessas premissas, o cache de 30 minutos passa a sair mais barato que não usar cache a partir do 2º uso total, e o cache de 12 horas a partir do 3º. Se você usar apenas 1 vez, os dois tipos de cache ficam mais caros que não usar cache, porque você paga o prêmio de gravação sem aproveitar o desconto de leitura.
Escopo de aplicação do exemplo de cálculo
Esses números cobrem apenas a parte do prefixo fixo. O material novo adicionado a cada requisição, a saída do modelo, as chamadas de ferramentas e as novas tentativas após falhas ficam fora do cálculo — ou seja, isso não representa um desconto sobre a requisição inteira. Se o intervalo entre dois usos ultrapassar o tempo de validade do cache, as requisições seguintes não podem mais ser contabilizadas como “acerto total”, e é preciso somar de volta o custo de reescrita.
Análise e avaliação do cache de comandos da OpenAI
Por que o ponto de equilíbrio é 2 e 3 usos
Generalizando o exemplo para um número qualquer de usos N, dá para escrever três linhas de custo (em dólares por milhão de tokens de prefixo):
- Sem cache: 0.10 × N
- Cache de 30 minutos: 0.125 + 0.01 × (N − 1)
- Cache de 12 horas: 0.25 + 0.01 × (N − 1)
Fazendo o custo do cache menor que o custo sem cache, a faixa de 30 minutos exige N maior que aproximadamente 1.28, ou seja, compensa a partir do 2º uso; a faixa de 12 horas exige N maior que aproximadamente 2.67, ou seja, compensa a partir do 3º uso. Essa conclusão independe do comprimento do prefixo, porque as três linhas de custo são todas proporcionais ao número de tokens. Se o prefixo passar de 2000 tokens para 50000 tokens, o número de usos para o equilíbrio não muda — o que muda é apenas o valor absoluto economizado. O pré-requisito é que o prefixo atenda ao limite de 1024 tokens e que o nível de preço seja o mesmo.
Estruturalmente, o prêmio de gravação é um custo único, e a economia trazida por cada acerto é a diferença entre o preço normal de entrada e o preço de leitura do cache, ou seja, $0.09 de economia por milhão de tokens. O prêmio da faixa de 30 minutos é de apenas $0.025, coberto com um único acerto; o prêmio da faixa de 12 horas é de $0.15, e precisa de dois acertos para ser coberto. É justamente por isso que as duas linhas de equilíbrio diferem em um uso.
Um script reutilizável para calcular o ponto de equilíbrio
O script abaixo reproduz o exemplo de cálculo deste artigo com as premissas adotadas. Você pode substituir os preços e o número de usos para avaliar rapidamente o seu cenário. Para os parâmetros de preço, use os valores mais recentes da página oficial de preços.
# Com base nos preços oficiais do gpt-6-luna Standard / Short context (USD / milhão de tokens)
INPUT = 0.10
CACHE_READ = 0.01
WRITE = {"30min": 0.125, "12h": 0.25}

def prefix_cost(prefix_tokens: int, uses: int, mode: str | None) -> float:
    """Calcula apenas o custo do prefixo fixo; assume gravação completa inicial, todas as chamadas seguintes acertam o cache e não há gravações repetidas."""
    m = prefix_tokens / 1_000_000
    if mode is None:
        return INPUT * uses * m
    return (WRITE[mode] + CACHE_READ * (uses - 1)) * m

for n in (1, 2, 3, 10):
    base = prefix_cost(10_000, n, None)
    c30 = prefix_cost(10_000, n, "30min")
    c12 = prefix_cost(10_000, n, "12h")
    print(f"{n:>2} 次  不缓存 ${base:.5f}  30分钟 ${c30:.5f}  12小时 ${c12:.5f}")
O resultado da execução é consistente com a tabela de exemplo acima. Se, no seu caso real, algumas requisições não acertarem o cache, você pode tratar o número de não acertos como “reescrita”; o ponto de equilíbrio será deslocado proporcionalmente para mais usos.
A estrutura do comando importa mais do que o interruptor
Como o cache só reconhece um prefixo exatamente igual, a ordem em que o comando é montado determina diretamente a taxa de acerto. O mais seguro é colocar as regras fixas do sistema, a definição de papel, a definição das ferramentas e os documentos de referência logo no começo, e deixar no final a pergunta do usuário, os resultados de recuperação, o carimbo de data e hora e qualquer outro material que muda a cada chamada. Se um campo que muda acabar entrando no início do prefixo, todo o conteúdo fixo que vem depois, por mais longo que seja, deixa de ser reutilizado.
Há também um equívoco comum que vale destacar separadamente: não compensa encher o comando com conteúdo irrelevante só para atingir o limite de 1024 tokens. Os tokens de preenchimento pagam o preço de gravação na primeira vez e, depois, o preço de leitura do cache a cada uso; além disso, podem atrapalhar o modelo a entender as instruções de verdade. O limite existe para dizer que comandos curtos simplesmente não precisam de cache, e não para incentivar alongar comandos curtos.
O agendamento em lotes determina se dá para “acertar tudo”
Outra premissa crítica do exemplo de cálculo é que todas as requisições seguintes acertem o cache. Na prática, se as requisições com o mesmo prefixo ficam espalhadas ao longo do dia, o tier de 30 minutos provavelmente expira entre uma requisição e outra, e cada uma acaba reescrevendo tudo — o que sai mais caro do que não usar cache. Nesse caso, há duas saídas: agrupar tarefas do mesmo tipo em lotes e enviá-las em sequência dentro de 30 minutos; ou considerar o tier de 12 horas, trocando uma gravação única mais cara por um período de validade maior.
Dá para reduzir a escolha a uma regra prática: requisições densas, com intervalos curtos, pedem o tier padrão de 30 minutos — com 2 usos totais já sai mais barato do que não usar cache; já requisições esparsas, mas que reutilizam o mesmo prefixo várias vezes no mesmo dia e chegam de forma estável a 3 usos ou mais, só então justificam o tier de 12 horas. Se um prefixo provavelmente for usado só 1 vez dentro do período de validade, não usar cache é a opção mais barata.
A parte do cálculo de custos que costuma ser superestimada
O número de ~78,5% de economia em 10 usos chama a atenção, mas ele se refere apenas ao custo de entrada do prefixo fixo. Na estrutura de preços do gpt-6-luna, o preço de saída é 5 vezes o da entrada comum. Se uma aplicação gera saídas longas, ou se cada requisição carrega bastante material novo de busca, o dinheiro que o cache de prefixo economiza pode representar uma fatia pequena da conta total. Ao fazer o orçamento, o mais razoável é dividir a requisição em blocos — “prefixo fixo”, “entrada dinâmica”, “saída”, “ferramentas e retentativas” — estimar cada um separadamente e aplicar a fórmula de cache só ao primeiro.
Além disso, a regra do multiplicador de gravação descrita neste artigo vale para modelos GPT-5.6 e posteriores; os preços concretos do exemplo correspondem apenas ao tier de processamento Standard e ao tier Short context do gpt-6-luna. Se você trocar para modelos antigos, para o tier de contexto longo ou para outro tier de processamento, precisa consultar os preços de novo e recalcular — e o número de reaproveitamentos também pode mudar. A documentação oficial é mantida continuamente; se as regras mudarem mais adiante, a conclusão deve seguir a documentação daquele momento. Isso é uma variável que pede acompanhamento contínuo, e não uma mudança que já aconteceu.
Xunzi escreveu em “Exortação ao Estudo”: “A terra acumulada forma montanhas, e delas nascem ventos e chuvas; a água acumulada forma abismos, e neles surgem dragões.” As contas do cache de prompt funcionam do mesmo jeito: uma gravação é só um custo, e a economia de verdade vem do reaproveitamento estável, repetido várias vezes dentro do período de validade.


