
直接回答:在理想条件下,OpenAI 默认 30 分钟提示缓存从第 2 次使用起就比不缓存便宜,12 小时缓存要到第 3 次使用才开始划算。 这里的理想条件是:同一段固定前缀先完整写入一次缓存,后续请求全部命中,期间没有重复写入。按 gpt-6-luna 标准短上下文档的官方价格计算,一段 10000 Token 的固定前缀总共使用 10 次时,30 分钟缓存比不缓存节省约 78.5%,12 小时缓存节省约 66%。但这只是固定前缀部分的账,不代表整个请求打了折。
您读完此文能了解到什么?
- 提示缓存命中的真实条件,以及它和“语义相似”的区别。
- 30 分钟与 12 小时两种写入费率如何计价,为什么不能再叠加普通输入费。
- 一组可复核的 1、2、3、10 次使用算例,以及适用于任意前缀长度的回本公式。
- 这套规则对开发者设计提示结构、安排批量任务分别意味着什么。
索引: 先用一张概念表和影响速览帮你对齐术语与受影响人群;“客观事实”部分整理官方文档中的缓存规则、价格和算例数据;“分析判断”部分解释回本线背后的数学关系,并讨论提示结构、批次安排和常见误判。
OpenAI 提示缓存 To Know:概念解释
| 概念 | 简要解释 |
|---|---|
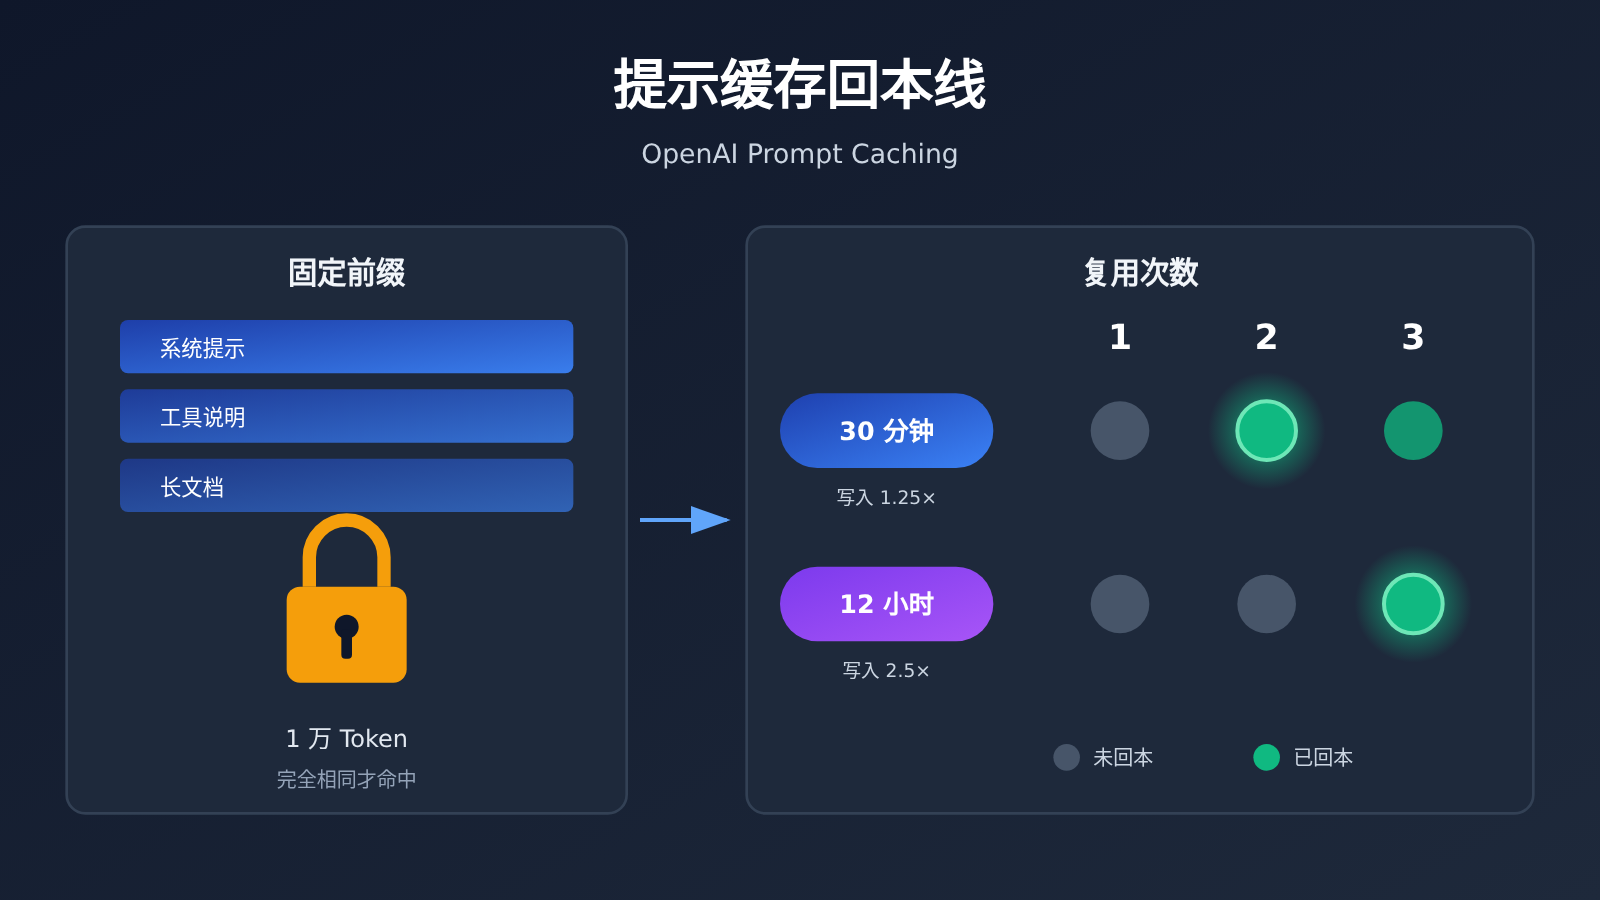
| 提示缓存(Prompt Caching) | OpenAI 对重复出现的提示前缀进行缓存,后续请求命中时按更低的“读缓存”价格计费 |
| 提示前缀 | 一次请求输入中从开头起的连续内容,缓存匹配的是完全相同的前缀,而不是意思相近的内容 |
| 可见输入 Token | 计入缓存门槛的输入 Token,GPT-5.6 及以后模型要求至少 1024 个才可使用缓存 |
| 缓存写入 | 首次把前缀存入缓存时的计费,按普通输入价格的倍数计价,是一个总写入费率 |
| 缓存读取 | 后续请求命中缓存时的计费,价格远低于普通输入 |
| 30 分钟 / 12 小时缓存 | 两种缓存有效时间档位,默认 30 分钟;12 小时档在 Responses API 中提供,写入更贵 |
| Standard 处理档 | 官方价格表中的标准处理档位,不同处理档价格不同,不能混用 |
| Short context 档 | 官方价格表按上下文长度区分档位,本文只使用短上下文档价格 |
OpenAI 提示缓存影响速览
- API 开发者: 缓存是否省钱取决于复用次数和有效时间内的命中率,而不是“开了就省”。30 分钟档只要总使用 2 次(首次写入加一次命中)即可比不缓存更便宜,12 小时档写入成本更高,需要更多复用才能摊平。
- 做 Agent 或长系统提示的团队: 固定规则、工具说明、长文档放在前面,变化内容放在后面,前缀才能稳定命中,这是结构设计问题而不是参数问题。
- 批量处理任务的团队: 把同一前缀的请求集中在缓存有效时间内发送,能显著提高命中率;任务分散在一整天里,则需要评估 12 小时档是否值得。
- 负责成本核算的人: 缓存只影响固定前缀那部分输入费用,输出、新增材料、工具调用和重试都不在其内,预算表里不能把缓存节省比例直接套到总账单上。
OpenAI 提示缓存客观事实
信息来源与时效说明
本文依据的资料核查于 2026-11-17,来源为 OpenAI 持续维护的官方文档:提示缓存指南 developers.openai.com/api/docs/guides/prompt-caching,以及价格页 developers.openai.com/api/docs/pricing.md。这些文档会随时更新,我们没有核实相关规则的首次发布日期,因此本文不是当日新闻,而是对现行规则的整理与测算。
提示缓存的命中规则
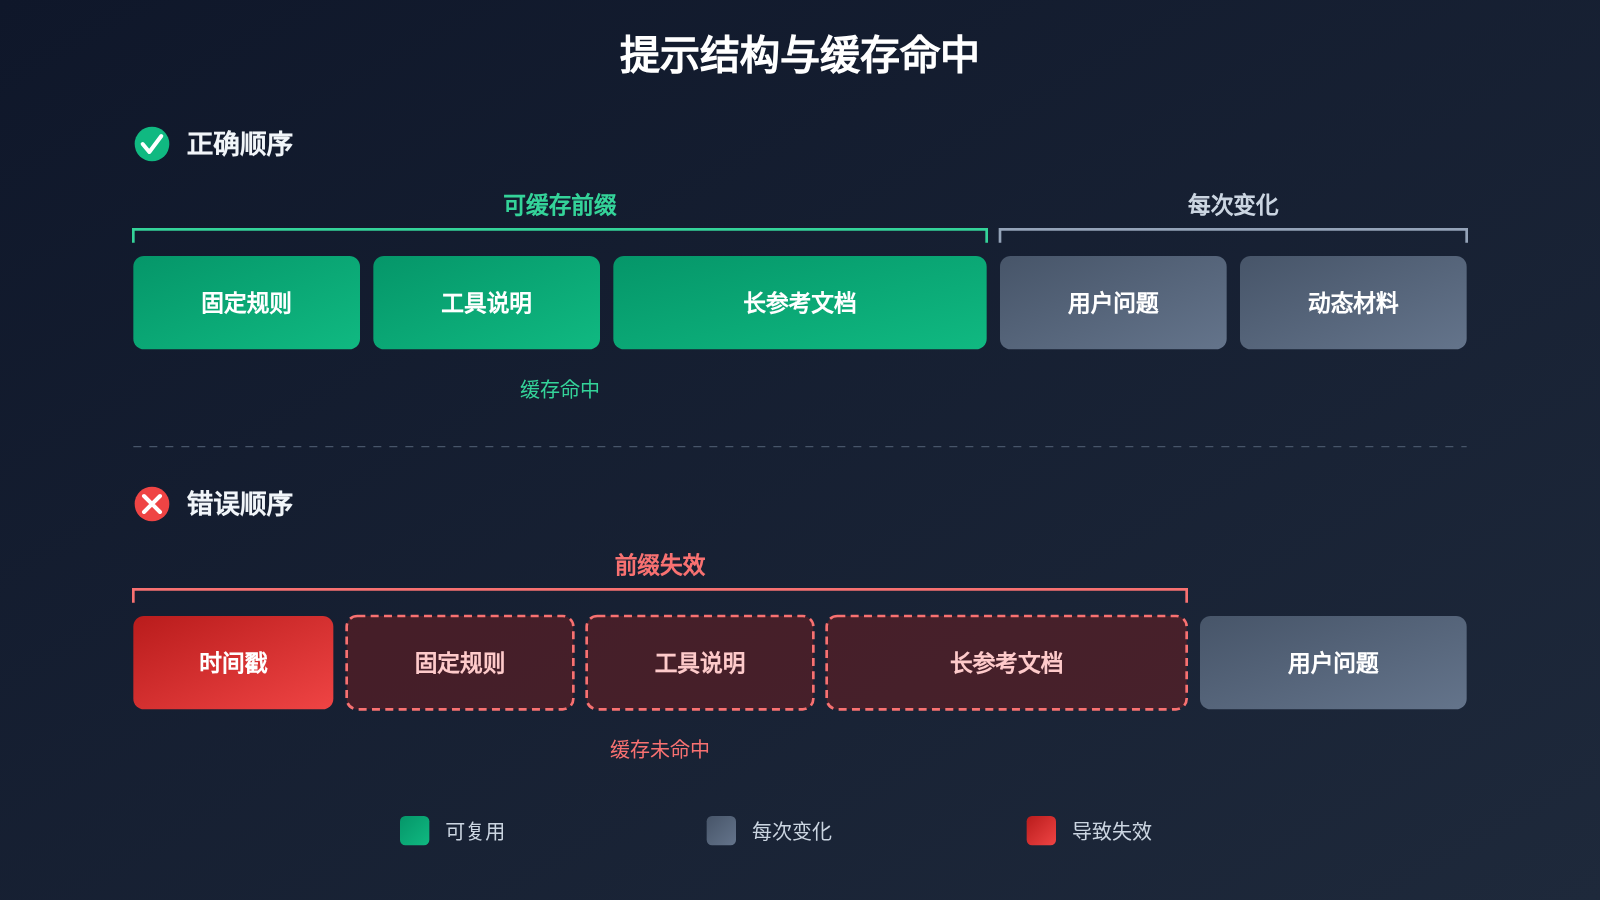
OpenAI 提示缓存的匹配对象是相同的提示前缀。两段提示即使意思几乎一样,只要开头部分的内容不同,就不会命中,它不是语义相似度检索。这意味着前缀中任何一个字符的变化,例如在系统提示开头插入当前时间,都可能让后续内容全部失去命中机会。
对于 GPT-5.6 及以后的模型,缓存门槛是至少 1024 个可见输入 Token。旧模型的规则不同,本文的计价与门槛结论只适用于官方文档中描述的新规则,不能直接套用到旧模型上。
两种缓存写入费率
| 缓存档位 | 写入费率(相对普通输入) | 适用说明 |
|---|---|---|
| 30 分钟(默认) | 1.25 倍 | 默认缓存有效时间 |
| 12 小时 | 2.5 倍 | 在 Responses API 中提供 |
官方文档明确,这两个倍数都是总写入费率,首次写入时按该费率计费,不再另外叠加一遍普通输入费。另外需要注意,12 小时指的是缓存有效时间,不是数据删除期限,两者不能混为一谈。
gpt-6-luna 官方价格
以下为 OpenAI 官方价格页中 gpt-6-luna 在 Standard 处理档、Short context 档的价格,单位为每百万 Token。这组价格不能套用到长上下文档或其他处理档,也不是任何第三方平台的报价。
| 计费项 | 价格(美元 / 百万 Token) |
|---|---|
| 普通输入 | $0.10 |
| 输出 | $0.50 |
| 读缓存 | $0.01 |
| 30 分钟缓存写入 | $0.125 |
| 12 小时缓存写入 | $0.25 |
可以看到,30 分钟写入价 $0.125 正好是普通输入的 1.25 倍,12 小时写入价 $0.25 是 2.5 倍,与文档中的倍数规则一致。读缓存只有普通输入的十分之一。
复用次数算例
以下算例为按官方价格推导的理论计算,并非实测。假设条件为:固定前缀 10000 个计费 Token,第一次使用时完整写入缓存,后续每次都命中,期间没有重复写入。
| 总使用次数 | 不使用缓存 | 30 分钟缓存 | 12 小时缓存 |
|---|---|---|---|
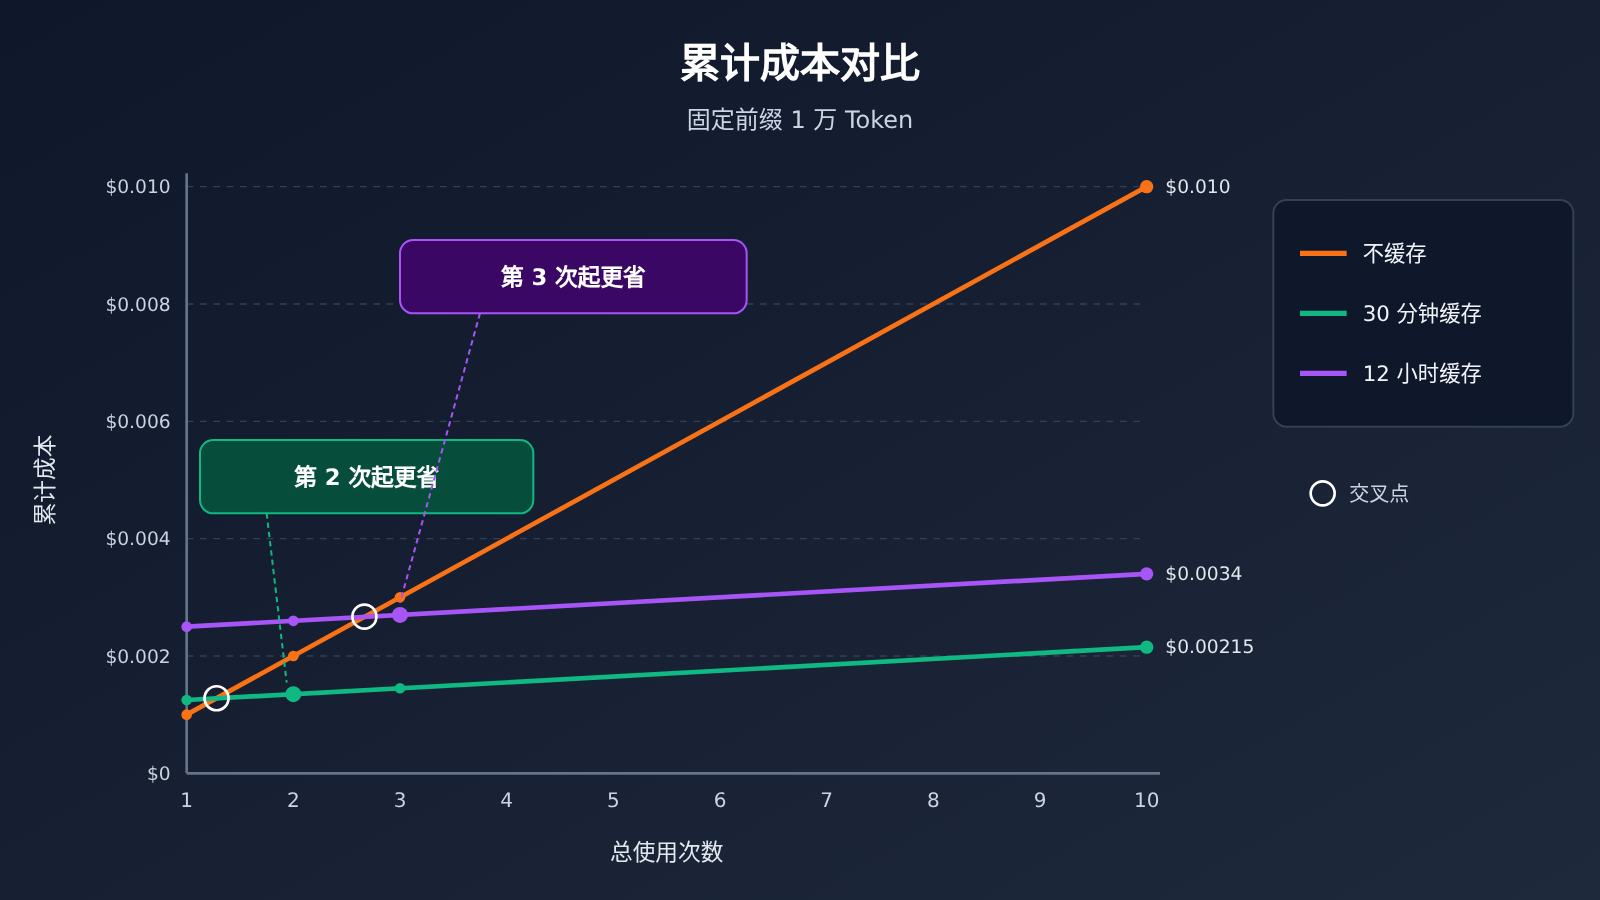
| 1 次 | $0.001 | $0.00125 | $0.0025 |
| 2 次 | $0.002 | $0.00135 | $0.0026 |
| 3 次 | $0.003 | $0.00145 | $0.0027 |
| 10 次 | $0.010 | $0.00215 | $0.0034 |
在这组假设下,30 分钟缓存从第 2 次总使用开始比不缓存便宜,12 小时缓存从第 3 次开始更便宜。只用 1 次时,两种缓存都比不缓存更贵,因为多付了写入溢价却没有享受到读取折扣。
算例的适用边界
这组数字只计算了固定前缀部分。每次请求中新增的材料、模型输出、工具调用以及失败重试,都不在计算范围之内,因此它不是整篇请求的折扣。如果两次使用之间的间隔超过缓存有效时间,后续请求就不能再按“全部命中”计算,需要把重新写入的费用加回去。
OpenAI 提示缓存分析判断
回本线为什么是 2 次和 3 次
把算例推广到任意使用次数 N,可以写出三条成本线(单位为每百万前缀 Token 的美元成本):
- 不缓存:0.10 × N
- 30 分钟缓存:0.125 + 0.01 × (N − 1)
- 12 小时缓存:0.25 + 0.01 × (N − 1)
令缓存成本小于不缓存成本,30 分钟档需要 N 大于约 1.28,即第 2 次起划算;12 小时档需要 N 大于约 2.67,即第 3 次起划算。这个结论与前缀长度无关,因为三条成本线都与 Token 数成正比,前缀从 2000 Token 换成 50000 Token,回本次数不变,变的只是省下的绝对金额。前提是前缀满足 1024 Token 门槛,且价格档位一致。
从结构上看,写入溢价是一次性成本,每次命中带来的节省是普通输入价与读缓存价之差,即每百万 Token 节省 $0.09。30 分钟档的溢价只有 $0.025,一次命中就能覆盖;12 小时档的溢价是 $0.15,需要两次命中才能覆盖。这就是两条回本线差一次的原因。
一个可复用的回本计算脚本
下面的脚本按本文的假设复现算例,你可以替换价格和使用次数,快速判断自己的场景。价格参数请以官方价格页的最新数值为准。
# 按官方 gpt-6-luna Standard / Short context 价格(美元 / 百万 Token)
INPUT = 0.10
CACHE_READ = 0.01
WRITE = {"30min": 0.125, "12h": 0.25}

def prefix_cost(prefix_tokens: int, uses: int, mode: str | None) -> float:
    """只计算固定前缀成本;假设首次完整写入、后续全部命中、无重复写入"""
    m = prefix_tokens / 1_000_000
    if mode is None:
        return INPUT * uses * m
    return (WRITE[mode] + CACHE_READ * (uses - 1)) * m

for n in (1, 2, 3, 10):
    base = prefix_cost(10_000, n, None)
    c30 = prefix_cost(10_000, n, "30min")
    c12 = prefix_cost(10_000, n, "12h")
    print(f"{n:>2} 次  不缓存 ${base:.5f}  30分钟 ${c30:.5f}  12小时 ${c12:.5f}")
运行结果与上文算例表一致。如果你的实际情况是部分请求未命中,可以把未命中的次数按“重新写入”处理,回本线会相应后移。
提示结构比开关更重要
由于缓存只认完全相同的前缀,提示的排列顺序直接决定命中率。较稳妥的做法是把固定的系统规则、角色设定、工具定义和参考文档放在最前面,把用户问题、检索结果、时间戳等每次都会变化的材料放在最后。任何会变化的字段一旦混进前缀开头,后面再长的固定内容也无法复用。
还有一个常见误区值得单独指出:为了凑够 1024 Token 门槛而往提示里填充无关内容并不划算。填充的 Token 首次要按写入价付费,之后每次也要按读缓存价付费,而且可能干扰模型对真正指令的理解。门槛的意义在于说明短提示本来就不需要缓存,而不是鼓励把短提示变长。
批次安排决定能否“全部命中”
算例的另一个关键假设是后续请求全部命中。现实中,如果同一前缀的请求零散分布在一天里,30 分钟档很可能在两次请求之间过期,每次都重新写入,反而比不缓存更贵。这时有两种思路:一是把同类任务集中成批次,在 30 分钟内连续发送;二是评估 12 小时档,用更高的一次性写入换取更长的有效期。
可以把选择简化为一个经验判断:请求密集、间隔短,用默认 30 分钟档,总使用 2 次即可比不缓存更便宜;请求稀疏但同一天内会反复使用同一前缀,且总使用次数能稳定达到 3 次以上,12 小时档才有意义。如果一段前缀在有效期内大概率只用 1 次,不缓存反而是最便宜的选择。
成本核算中容易被高估的部分
10 次使用节省约 78.5% 的数字很醒目,但它针对的只是固定前缀的输入费用。在 gpt-6-luna 的价格结构里,输出价是普通输入的 5 倍,如果一个应用的输出很长,或者每次请求都附带大量新检索材料,前缀缓存省下的钱在总账单中的占比可能并不高。做预算时更合理的做法是把请求拆成“固定前缀”“动态输入”“输出”“工具与重试”几块分别估算,只对第一块套用缓存公式。
此外,本文所述写入倍数规则针对 GPT-5.6 及以后模型;算例中的具体价格仅对应 gpt-6-luna 的 Standard 处理档、Short context 档。换用旧模型、长上下文档或其他处理档时,需要重新查价重新算,回本次数也可能随之改变。官方文档持续维护,后续规则如有调整,结论应以届时的文档为准,这一点属于需要持续关注的变量,而不是已经发生的变化。
荀子在《劝学》中写道:“积土成山,风雨兴焉;积水成渊,蛟龙生焉。”提示缓存的账也是如此,一次写入只是付出,真正的节省来自有效期内一次又一次的稳定复用。


