
作者注:d1.2-ultra 在 Decision Index v2.1 上显示第 1。本文教你先认清自己的活属于抽单据、调工具还是答难题,只看对得上的分项,再用 20 到 50 条自有样本决定换不换。
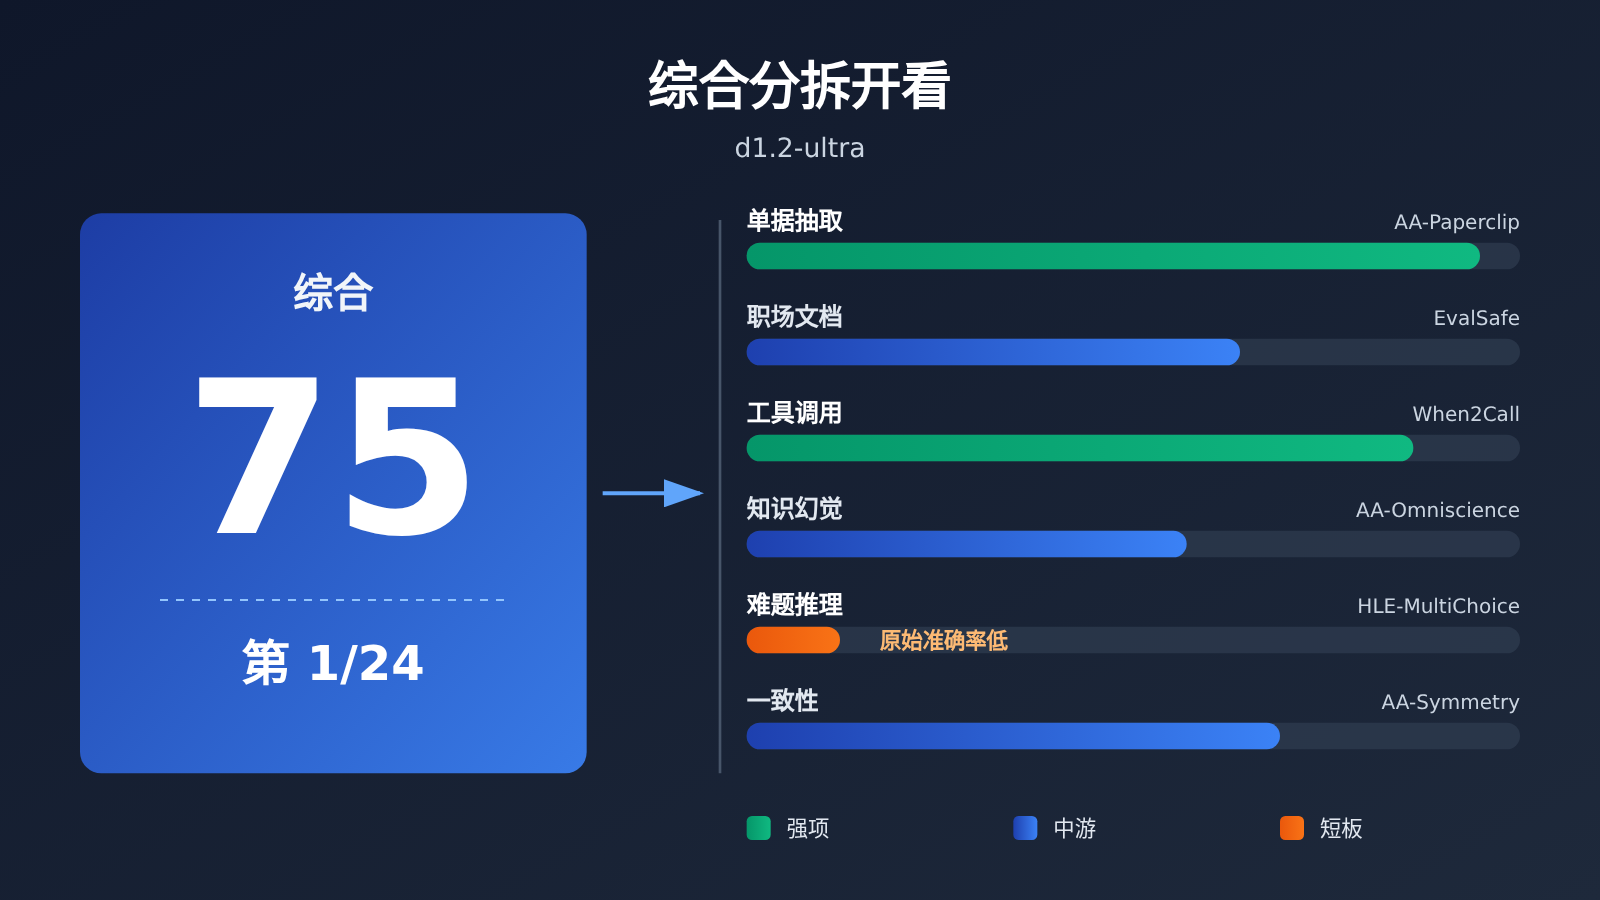
2026-11-16,Liquid AI 发布 d1.2 与 d1.2-ultra。官方博客称 d1.2-ultra 在 Artificial Analysis Decision Index v2.1 上得分 75,是决策模型里最高的。不少正在调接口的开发者看到“第 1”,第一反应就是把生产模型换掉。先别急着换,综合分 75 只是由头,真正该看的是和你业务对得上的那一项分数。
这不是一篇唱衰或吹捧的文章。 同一个模型,在单据抽取上排第 1,在很难的选择题上原始准确率却是 24 个决策模型里最低的。两件事同时成立,综合分会把它们抹平。
核心价值:读完本文,你会知道该看哪一个分项、怎么读决策分和原始准确率,以及怎样用自己的 20 到 50 条样本,在一个下午内得出换不换的结论。
d1.2-ultra 综合第一的核心要点
先把榜单页面上的数字摆清楚。以下数据来自 Artificial Analysis 的 d1.2-ultra 模型页,读取日期为 2026-11-17,参与比较的决策模型共 24 个。
| 项目 | 榜单页面数据 | 读法 |
|---|---|---|
| 综合指数 | 74.85,页面显示 75,第 1/24 | 第 2 名 Drex Max v1.1 为 72.62,差约 2.2 分,与官方说的“两分”是同一件事四舍五入 |
| 耗时 | 218 毫秒/任务,第 14/24 | 页面中位数 209 毫秒,属于中游 |
| 跑完指数的成本 | 133 美元/每百万任务,第 11/24 | 这是任务成本,不是每百万 token 的标价 |
| 输入价 | 0.042 美元/每百万 token | 与 Liquid 官方博客一致,官方只计输入 |
| Brier | 0.150,24 个里最低 | 越低越好,说明给出的概率比较“诚实” |
d1.2-ultra 的综合分是怎么来的
Decision Index v2.1 是六个分项的加权平均。模型页对决策分的定义是:准确率减去所选答案概率的 Brier 分数,范围 0 到 100,越高越好。也就是说,自信地答错比犹豫地答错扣得更多。原始准确率则是模型把最高概率给到正确选项的题目比例,它和决策分不是同一个数。
这个区别直接影响你怎么读 d1.2-ultra。一个模型可以靠经常不猜、少犯自信的错,拿到不算低的决策分,同时原始准确率很低。如果你的业务需要“必须给出答案”,那你该看原始准确率;如果业务允许“不确定就转人工”,决策分更有参考价值。
| 分项 | 权重 | 测什么 | AA 的分类 |
|---|---|---|---|
| AA-Paperclip | 30% | 单据判断与抽取,一份文档 15 个答案算一次判断 | 文档 |
| EvalSafe-O*NET-AA | 15% | 职场文档判断 | 文档 |
| When2Call | 10% | 工具调用 | 工具 |
| AA-Omniscience-Decision v1.1 | 15% | 知识与幻觉 | 知识 |
| HLE-MultiChoice v1.1 | 15% | Humanity’s Last Exam 文本选择题,可以拒答 | 推理 |
| AA-Symmetry v1.1 | 15% | 换说法、换选项顺序、否定之后判断是否不变 | 一致性 |
注意 HLE-MultiChoice 在 AA 那里被标为推理,不是知识。所以下文提到它时,不能写成“知识测试”。
如何对上 d1.2-ultra 的那一项分数
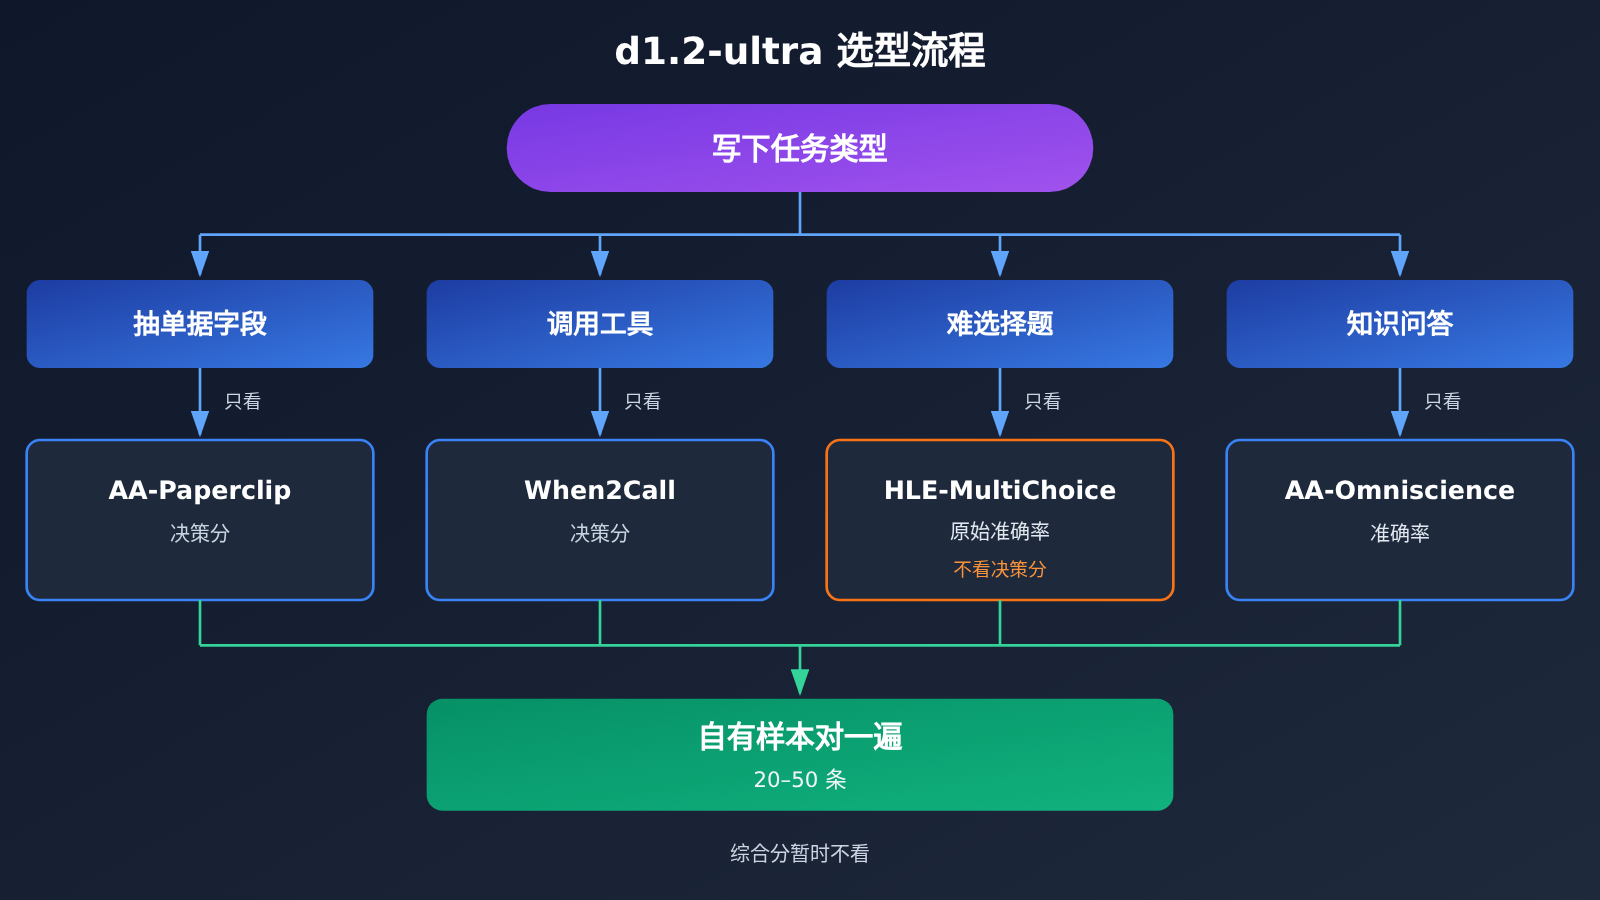
第一步不是看榜,而是拿出一张纸,写下你的活到底属于哪一类:抽单据、调工具、答难题,还是知识问答。写完以后,只看对得上的那一项,其他分项和综合分 75 暂时不看。
| 你要做的事 | 只看这一项 | d1.2-ultra 榜单页面数据 | 怎么理解 |
|---|---|---|---|
| 抽发票、简历、论文字段 | AA-Paperclip | 决策分 75.81,文档全对率 67.7%,两项都是第 1/24 | 第 2 名 Drex Max v1.1 为 72.82 和 63.0%,领先比较明确 |
| 调工具、判断该不该调用 | When2Call | 决策分 96.49,第 1 | SubQ Snap 1.2 为 96.10,d1.2 为 96.09,前几名挤在约 1 分里 |
| 职场文档判断 | EvalSafe-O*NET-AA | 决策分 89.53,第 3 | 前面是 Jev 1.14(91.14)和 GLiDE v1.2(89.67) |
| 答很难的选择题 | HLE-MultiChoice 原始准确率 | 2.36%,24 个决策模型里最低 | 决策分 46.36 并不垫底,不幻觉率 76.1%,它经常选择不猜 |
| 知识问答 | AA-Omniscience 准确率 | 原始准确率 23.6%,第 20/24 | 决策分 60.80 排第 6,不幻觉率 83.8% |
| 换说法后答案稳不稳 | AA-Symmetry 全过率 | 分数 86.34 第 2;全过率 56.7% 第 5 | 分数第二不等于稳定性第二 |
d1.2-ultra 分项里最容易读错的两处
第一处是 HLE-MultiChoice。2.36% 的原始准确率确实是 24 个决策模型里最低的,但它的决策分 46.36 并不垫底,同页还有更低的,例如 Mercury Decide 的 34.79。再加上 76.1% 的不幻觉率,合理的读法是:遇到很难的推理选择题,d1.2-ultra 倾向于不给高置信答案。AA 把这一项归为推理,因此不能把它说成“知识测试倒数第一”。
第二处是 AA-Omniscience。23.6% 的准确率排第 20/24,不是倒数第一。有意思的是,同页较小的 d1.2 在这项上是 30.0%,HLE 原始准确率也有 5.30%,两项都高于 ultra。但 d1.2 的综合指数是 68.69,排第 9/24,所以“更贵的 ultra 知识更差”只适用于这两项,不能推成全面更差。
🎯 读榜建议:如果你的活是抽单据,
d1.2-ultra的 AA-Paperclip 第 1 值得认真对待;如果是工具调用,第 1 是真的,但和后面几名的差距在 1 分以内,换不换要看你自己的样本。
d1.2-ultra 官方自报的数据怎么用
Liquid 在同一篇博客里还给出了五类新任务和内部测试结果。厂商写明这些新任务还没有公开基准覆盖,以下数据都属于官方自报,用的是内部留出集,不是 Artificial Analysis 的成绩。
| 新任务(官方自报) | d1.2-ultra | d1.2 | 备注 |
|---|---|---|---|
| 小票读值(CORD、SROIE) | 98% | 96% | 没有的值答 not found |
| 敏感信息跨度(Nemotron PII)精确率/召回率 | 94% / 93% | 92% / 88% | 给出每一段的位置 |
| 按描述框物体(RefCOCO 系列) | 94% | 94% | 两者持平 |
| 数物体、允许差 1(COCO) | 93% | 92% | 估一个数并给范围 |
| 挑出图里每个物体(COCO) | 87% | 90% | 这一行便宜的 d1.2 更高 |
音频方面,官方称在留出录音上判断声音类别(ESC-50)和语种(FLEURS,43 种语言)时,两者都在约 95% 到 97%。校准误差方面,Liquid 在 13 个基准、22505 道题上测得 d1.2-ultra 为 0.8,d1.2 为 1.2,Jev 1.14 为 2.7,Perplexity Decider v1.3 为 3.7,GPT-6 Luna 的 Decisions API 为 7.2。
这里要特别分清:GPT-6 Luna(Decisions)在 Artificial Analysis 决策榜上综合指数 60.25,排第 22/24,HLE 原始准确率 7.86%。这些都是 Decisions 接口的成绩,不能当成聊天接口 gpt-6-luna 的成绩。官方博客还写了“Coming to OpenRouter and Vercel soon”,这是厂商预告,不代表已经上线。
d1.2-ultra 快速上手:拿自己的样本对一遍
榜单看完,真正决定换不换的是你自己的数据。准备 20 到 50 条真实样本就够了,例如 30 张发票或 30 份简历,每条事先标好正确字段,其中最好有几条故意缺某个字段。
极简操作步骤
- 从业务里挑 20 到 50 条样本,人工标出每个字段的正确值,缺失字段标为 not found。
- 写一段固定的提示词:要求模型按 JSON 输出指定字段,找不到的字段必须填
not found,不许推测。 - 用 OpenAI 兼容 SDK,把
base_url设为https://api.apiyi.com/v1,model先填gpt-6-luna,再换gpt-6.1-sol各跑一遍。 - 逐条比对,记录三个数:字段级准确率、整份全对率、缺失字段被乱填的次数。
- 等目标模型能调用后,用同一批样本、同一段提示词再跑一次,三个数直接对比。
查看完整比对思路
– **输入**:一个样本文件,每行包含原文(或图片)和人工标注的字段字典。
– **调用**:循环读取样本,调用 `client.chat.completions.create` 或 `responses` 端点,`temperature` 设为 0,要求严格 JSON 输出。
– **解析**:输出解析失败单独计数,这本身就是一个可用性指标。
– **比对**:逐字段做规范化比较(去空格、统一日期格式、金额保留两位小数)。
– **幻觉计数**:标注为 not found、模型却填了值的字段,单独记为“乱猜”。
– **汇总**:输出字段准确率、文档全对率、乱猜次数、平均 token 用量,方便后面算钱。
用 API易 先跑基线
这件事要花 token。d1.2 与 d1.2-ultra 不在 API易型号列表里,所以现在可以先在 API易(apiyi.com)用已经在架的 gpt-6.1-sol 或 gpt-6-luna,调用地址 https://api.apiyi.com/v1,把同一批发票或简历跑一遍,看字段对不对、没有的字段会不会乱猜。这样你手里就有了一条可量化的基线。
暂未上架,我们会尽快上架这个模型;型号与价格以平台型号列表为准。
| 自检项 | 怎么记 | 判断标准 |
|---|---|---|
| 字段准确率 | 正确字段数 / 总字段数 | 对比当前生产模型 |
| 整份全对率 | 全部字段都对的文档占比 | 对应 AA-Paperclip 的“文档全对率” |
| 乱猜次数 | not found 字段被填值的次数 | 越少越好,对应不幻觉率的思路 |
| 解析失败 | JSON 无法解析的条数 | 直接影响上线成本 |
| token 用量 | 平均每条输入输出 token | 用来换算真实费用 |
🚀 上手建议:先用 API易 apiyi.com 的新用户免费测试额度跑 20 条,确认提示词和比对脚本没问题,再扩到 50 条,避免一开始就把额度花在调试上。
d1.2-ultra 对价格、对调用方式
价格要分清单位。榜上的 133 美元是“每百万任务”的跑分成本,Liquid 官方价是“每百万输入 token”:d1.2 为 0.02 美元,d1.2-ultra 为 0.042 美元,只计输入。图片按每 32×32 像素 1.5 个 token、按文本价计,1024×1024 约 1536 token;一次请求的文字和图片只计一次,多问一个问题只加该问题自己的文字。
官方调用方式也与常见聊天接口不同:模型 ID 是 d1.2-ultra 和 d1.2,地址为 https://api.liquid.ai/decisions/v1/systemone,密钥在 Liquid 控制台申请。官方博客写了文本、图片和音频输入;Artificial Analysis 页面的技术规格写的是文本和图片,上下文 66k,这个窗口数字只出现在榜单页,并非 Liquid 博客公布的规格。
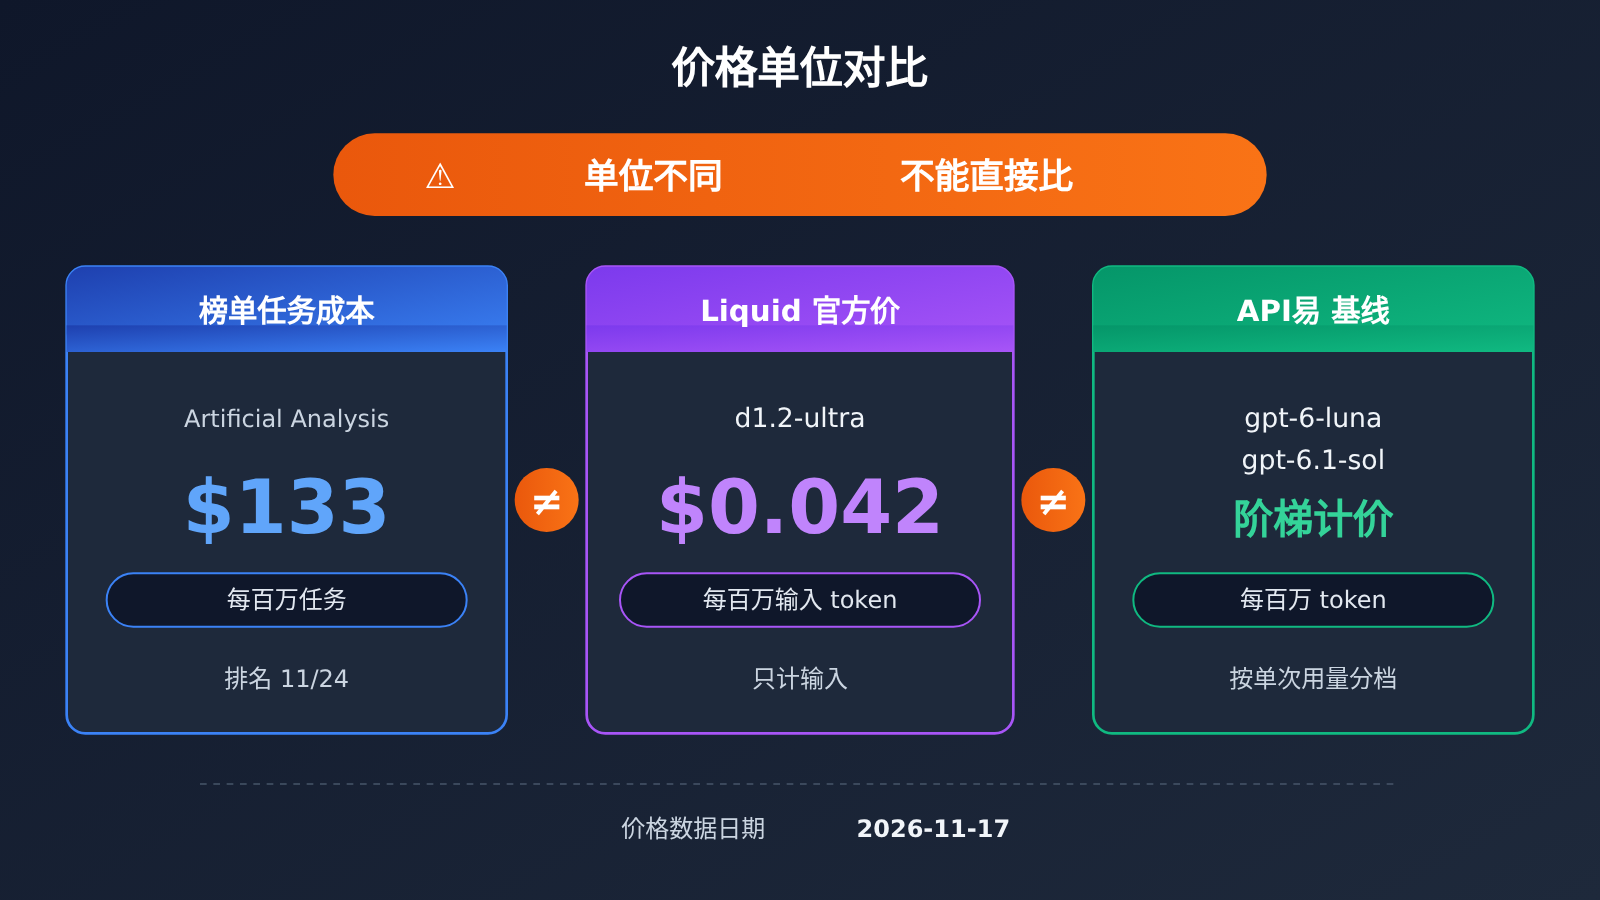
跑基线时用到的 API易 型号,价格如下(单位:美元/每百万 token,按单次请求 token 量分档,数据来自 2026-11-17 的价目接口,与模型总表 2026-11-16 更新一致):
| 型号 | 档位 | 输入 | 输出 | 缓存读 | 端点 |
|---|---|---|---|---|---|
gpt-6-luna |
≤ 272000 | 0.1 | 0.5 | 0.01 | responses 优先,也有 chat |
gpt-6-luna |
≥ 272001 | 0.2 | 0.75 | 未单列 | 同上 |
gpt-6.1-sol |
≤ 272000 | 2 | 10 | 0.1 | responses 优先,也有 chat |
gpt-6.1-sol |
≥ 272001 | 4 | 15 | 未单列 | 同上 |
💰 成本提示:做 50 条样本的对比,
gpt-6-luna适合先跑量,gpt-6.1-sol适合作为高质量参照。API易 apiyi.com 充值按 1:7 计,分组折扣可以叠加,实际扣费以控制台为准。
常见问题 FAQ
Q1:d1.2-ultra 是什么模型?
它是 Liquid AI 于 2026-11-16 发布的决策模型,与较小的 d1.2 同期推出。决策模型的特点是对每个选项给出概率,擅长单据抽取、工具调用判断、分类等“做选择”的任务,而不是长文写作。
Q2:d1.2-ultra 综合第一,是不是全面最强?
不是。综合指数 74.85 第 1/24,但 EvalSafe-O\*NET-AA 排第 3,AA-Symmetry 全过率排第 5,AA-Omniscience 原始准确率排第 20,HLE-MultiChoice 原始准确率是 24 个里最低。综合分只能说明加权后领先。
Q3:HLE-MultiChoice 那一项算不算知识测试倒数第一?
不算。倒数第一的是 HLE-MultiChoice 的原始准确率 2.36%,是 24 个决策模型里的原始准确率;它的决策分 46.36 并不垫底,而且 AA 把这一项标为推理,不是知识。
Q4:d1.2-ultra 最适合什么场景?
从榜单页面看,最对得上的是抽发票、简历、论文字段(AA-Paperclip 决策分和全对率均为第 1)和工具调用判断(When2Call 第 1,但前几名差距约 1 分)。答很难的选择题和知识问答,它的原始准确率不占优。
Q5:现在能在 API易 调用 d1.2-ultra 吗?
目前 d1.2 与 d1.2-ultra 不在 API易型号列表里。暂未上架,我们会尽快上架这个模型;型号与价格以平台型号列表为准。建议先在 API易 apiyi.com 用 `gpt-6-luna` 或 `gpt-6.1-sol` 跑出自家样本的基线,到时候直接换型号对比。
Q6:Liquid 公布的校准误差 0.8 能直接信吗?
那是 Liquid 自己在 13 个基准、22505 道题上的测试,属于官方自报。榜单页面能交叉印证的是 Brier 0.150 为 24 个里最低,方向一致,但具体到你的业务,仍要看自家样本里“乱猜次数”是否真的少。
Q7:GPT-6 Luna 的 7.2 和 API易 上的 gpt-6-luna 是一回事吗?
不是一回事。7.2 是 GPT-6 Luna 的 Decisions API 在 Liquid 测试中的校准误差,榜上 60.25 也是 Decisions 接口的成绩。API易 提供的 `gpt-6-luna` 是聊天接口,表现要用你自己的样本测。
Q8:样本到底要多少条才够?
20 到 50 条足以看出明显差距,关键是覆盖真实分布:常见格式、少见格式、缺字段的样本都要有。如果两款模型在 50 条上差距在一两条以内,说明换不换都行,优先看价格和延迟。
d1.2-ultra 核心要点 Key Takeaways
- 综合 75 只是由头:74.85 第 1/24,领先第 2 名约 2.2 分,不代表每项第一。
- 抽单据看 AA-Paperclip:决策分 75.81、全对率 67.7%,均为第 1。
- 调工具看 When2Call:96.49 第 1,但前几名挤在约 1 分里。
- 难题看原始准确率:HLE-MultiChoice 2.36% 最低,决策分不垫底,AA 标为推理。
- 知识问答看 Omniscience 准确率:23.6% 第 20/24,不是倒数第一。
- 单位别混:133 美元是每百万任务,0.042 美元是每百万输入 token。
- 用样本做决定:先在 API易 apiyi.com 用在架型号跑 20 到 50 条,记录字段准确率和乱猜次数。
总结
读 d1.2-ultra 的榜单,关键在三步:
- 写下任务类型:抽单据、调工具、答难题还是知识问答,只看对得上的分项。
- 分清两个数:决策分奖励“不自信就不猜”,原始准确率衡量“猜对了多少”,按业务需求选看哪个。
- 用自己的样本拍板:20 到 50 条带标注的真实数据,比任何综合分都更能说明问题。
如果你的活正好是单据抽取,d1.2-ultra 值得放进候选名单;如果是难题推理或知识问答,先别因为综合第一就换。推荐现在就在 API易 apiyi.com 用 gpt-6-luna 和 gpt-6.1-sol 建好基线,等目标模型可用时一键对比。
📚 参考资料
-
Liquid AI 官方博客 – d1.2 发布:发布信息、官方价格与自报测试
- 链接:
liquid.ai/blog/d1-2 - 说明: 新任务准确率、校准误差均为官方自报
- 链接:
-
Liquid AI 决策模型文档:模型 ID 与调用地址
- 链接:
docs.liquid.ai/lfm/models/decision-models - 说明: 官方调用方式说明
- 链接:
-
Artificial Analysis – d1.2-ultra 模型页:综合指数与各分项
- 链接:
artificialanalysis.ai/decision-models/d1-2-ultra - 说明: 本文榜单数据均于 2026-11-17 读取
- 链接:
-
Artificial Analysis – Decision Index 方法页:权重与评分定义
- 链接:
artificialanalysis.ai/methodology/decision-index - 说明: 决策分与原始准确率的区别
- 链接:
-
API易 模型总表:在架型号与价格
- 链接:
docs.apiyi.com/models - 说明: 型号与价格以平台型号列表为准
- 链接:
作者:API易 技术团队
技术交流:选型或比对脚本有疑问,欢迎在 API易 官网首页联系我们,更多接入说明见文档中心


