
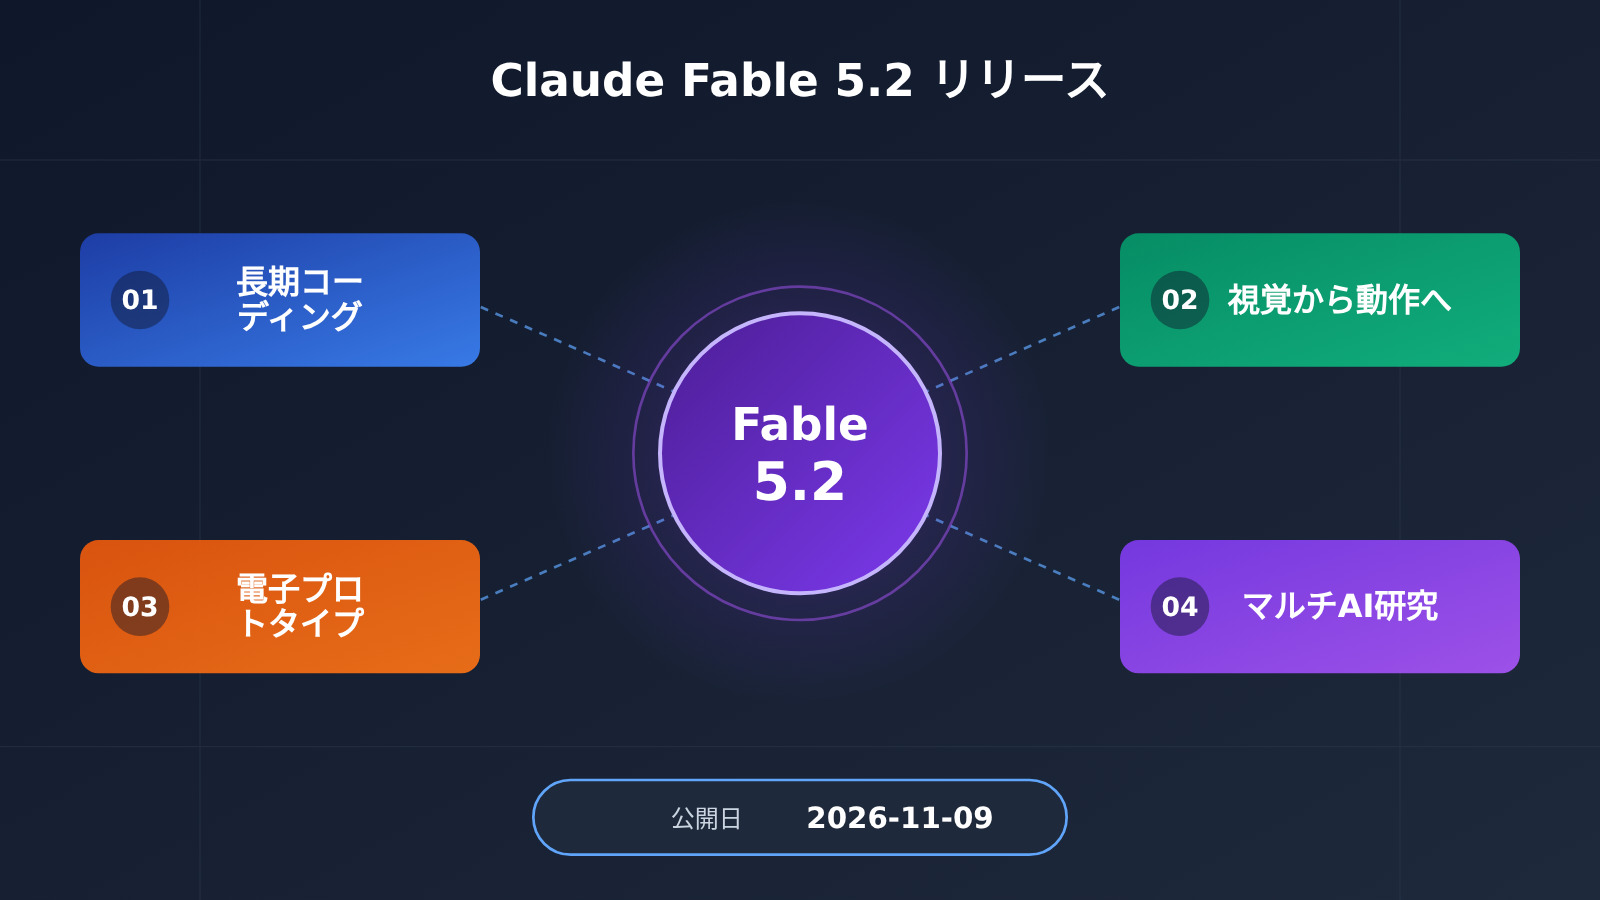
Anthropicは2026年11月9日、Claude Fable 5.2を正式に発表しました。公式の性能表と第三者のランキングによると、難しいタスクや長期にわたる協業で5.1を大きく上回り、標準APIの料金も5.1より20%安くなっています。
この記事のポイント:「まず結論、次に根拠、最後に限界」の順に、Claude Fable 5.2の強みとその程度、そして今すぐ切り替える価値があるタスクかどうかを見極めます。
Claude Fable 5.2の評価を読む前に知っておきたい用語
以下では、評価で使われる指標が何度も登場します。意味を取り違えると、企業によるデモを第三者の検証と誤解したり、一部の得点をタスク全体の合格率と捉えたりしかねません。
- Agent:ツールを呼び出し、複数の手順からなるタスクを続けて実行できるモデルシステムです。
- Intelligence Index:Artificial Analysis(AA)が提供する総合能力指数です。総合スコアであり、正答率ではありません。
- OSWorld partial:デスクトップ操作の評価において、部分的な達成度に応じて採点する指標です。問題全体に対する厳密な合格率とは異なります。
- RoboDojo Sim:シミュレーション環境のロボットを制御する評価です。実機ロボットでの成功率を示すものではありません。
- PCB:電子部品を搭載し、部品同士を接続するためのプリント基板です。
- Lean/形式証明:Leanは、証明をコンピューターで検証できる言語およびツールです。形式証明とは、数学的な論証を、機械が一つずつ検証できる厳密な手順に書き換えたものです。
- マルチAgent協業:複数のモデルインスタンスが作業を分担して互いにやり取りし、最後に結果をまとめる方式です。
Claude Fable 5.2 はどれほど強力か:まず結論、次に発表の背景
一言でまとめると、Claude Fable 5.2 は難度の高いプログラミング、長期的なタスク、視覚情報から行動につなげるタイプの評価で大きく進歩しています。ただし、「あらゆるタスクで1位」とは言えません。 一部の自動評価や選好スコアでは、ほかのモデルに後れを取っています。
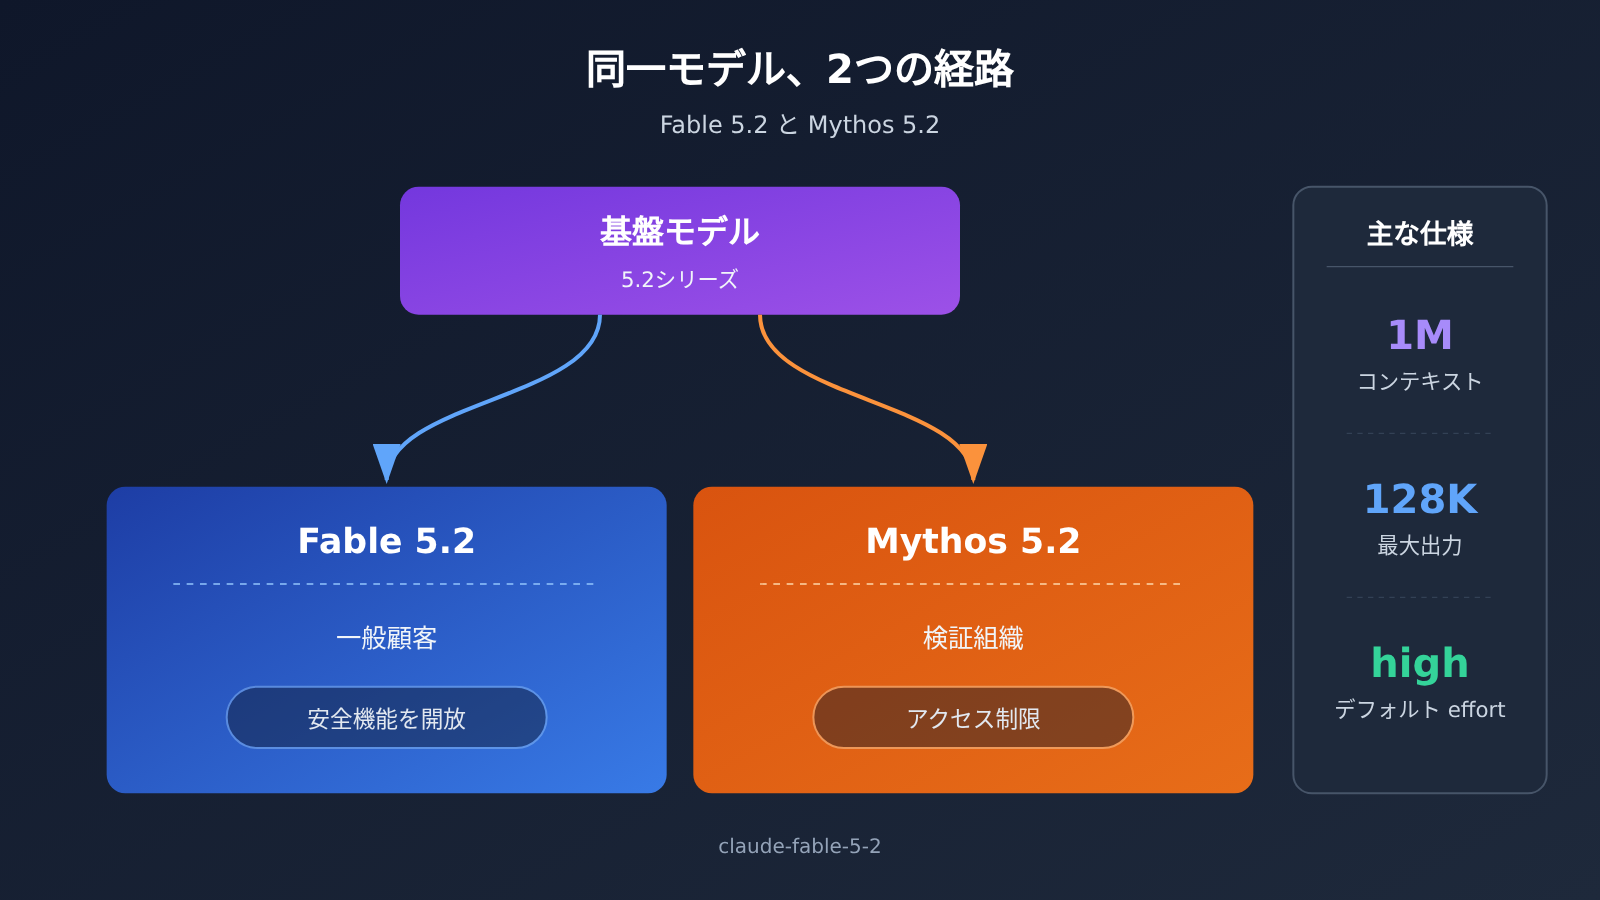
まず、発表の背景を押さえておきましょう。公式発表によると、Fable と Mythos は同じ基盤モデルを使用しています。Fable はサイバーセキュリティとバイオセーフティの保護策により一般ユーザーにも提供されていますが、Mythos は認証を受けた組織のみが利用できます。そのため、Mythos 専用の能力やスコアを、一般向けの Fable の実績として扱うことはできません。
Claude Fable 5.2 の基本情報
| 項目 | 詳細 | 情報の出典 |
|---|---|---|
| 公開日 | 2026 年 11 月 9 日 | 公式発表 |
| API モデルID | claude-fable-5-2 |
公式モデルドキュメント |
| コンテキスト / 最大出力 | 1M token / 128K token | 公式モデルドキュメント |
| 入出力モダリティ | テキストと画像の入力、テキストの出力 | 公式モデルドキュメント |
| 思考モード | アダプティブ思考が常時有効。API のデフォルト effort は high | 公式モデルドキュメント |
| 知識のカットオフ | 2026 年 6 月(リアルタイムのインターネット接続能力を意味するものではありません) | 公式モデルドキュメント |
| 標準価格 | 入力は 100 万 token あたり 8 ドル、出力は 40 ドル。5.1 からそれぞれ 20% 値下げ | 公式価格ページ |
| 速度に関する説明 | 出力生成が 5.1 より「最大 30% 高速」 | メーカー公表の上限 |
誤解しやすい点が2つあります。1つ目は、「最大 30% 高速」という数値はメーカーが示す出力速度の上限であり、すべてのタスクで所要時間が 30% 短縮されるわけではないことです。2つ目は、Fable 5.2 の標準価格が、Opus 5.5(4/20 ドル)の2倍であることです。
公式も、日常的なコーディングや知識労働の多くでは、まず Opus 5.5 を使い、複雑なタスクに取り組む場合に Fable へ切り替えることを推奨しています。
Claude Fable 5.2:プログラミングと長期タスクの性能向上を示すデータ
今回の発表の中心はプログラミングです。まずは提供元が公開したデータを確認し、続いて評価環境の異なる2つの第三者データを見ていきましょう。
公式の性能表:Fable 5.2と5.1、Opus 5.5の比較
| 評価(提供元が公表) | Fable 5.2 | Fable 5.1 | Opus 5.5 | 説明 |
|---|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | — | 両モデルでeffortの設定が異なる |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 長期的なソフトウェアエンジニアリングタスク |
| AutomationBench | 51.4% | 31.4% | 42.5% | 自動化タスク |
| OSWorld 2.1 オフラインサブセット partial | 89.3% | 83.5% | 87.2% | 部分スコアの算出基準 |
| RoboDojo Sim | 64.9% | 27.6% | 39.4% | シミュレーション環境でのロボット制御 |
この表から、Fable 5.2はFrontierSWE v2で5.1を13.6ポイント上回り、Opus 5.5も超えていることが分かります。FrontierCode 2.0の伸びはさらに大きいものの、2つのモデルでeffortの設定が異なるため、推論レベルの違いがスコア上昇の一因となっている可能性があります。
第三者データ:AAとCursorにおけるClaude Fable 5.2の成績
| 評価環境 | 設定 | スコア | タスクあたりの費用(米ドル) |
|---|---|---|---|
| Artificial Analysis | Fable 5.2 medium | 56 | 3.80 |
| Artificial Analysis | Fable 5.2 high | 62 | 9.08 |
| Artificial Analysis | Fable 5.2 xhigh | 62 | 14.83 |
| Artificial Analysis | Fable 5.2 max | 65 | 26.54 |
| Artificial Analysis | Opus 5.5 max | 59 | 10.04 |
| CursorBench 4.0 | Fable 5.2 High | 56.9% | 9.70 |
| CursorBench 4.0 | Fable 5.2 Max | 60.0% | 32.79 |
| CursorBench 4.0 | Opus 5.5 High | 56.0% | 3.97 |
AAは独立した評価機関です。同機関のIntelligence Indexでは、Fable 5.2 maxが65で、Opus 5.5 maxの59を上回っており、公式の評価表と同じ傾向が見られます。
Cursorのデータは、同社独自のタスクとツール環境で測定されたものです。Fable 5.2 Maxは60.0%に達していますが、High設定ではOpus 5.5 Highとの差はわずか0.9ポイントです。
2つの第三者データからは、性能の上限が高くなるほど、タスクあたりの費用も高くなる傾向がうかがえます。AAではhighからmaxに上げるとスコアは3ポイント上昇しますが、タスクあたりの費用は約2.92倍になります。
🎯 技術的なアドバイス:ベンチマークは候補を絞り込むために活用し、最終的な判断は自分のタスクセットで行いましょう。APIYI apiyi.comの同じOpenAI互換インターフェースを使い、同一のプロンプトと評価基準でOpusやFableなど複数のモデルを比較し、設定ごとに品質と費用を記録するのがおすすめです。
Claude Fable 5.2のビジョンとエンジニアリング能力はどこまで進んだのか
画面を理解する段階から、動作を制御する段階へ
ビジョン分野で特に注目したいのは、OSWorld 2.1とRoboDojo Simの2つです。OSWorld 2.1のオフラインサブセットでは、partialスコアが83.5%から89.3%に上昇しました。一方、Opus 5.5もすでに87.2%に達しており、差はそれほど大きくありません。
RoboDojo Simでは、27.6%から64.9%へと大きく伸びています。これは、視覚的な理解を連続した制御動作へ変換する能力が、明確に向上したことを示しています。
Fable 5.2が電子機器のプロトタイプ設計に参加
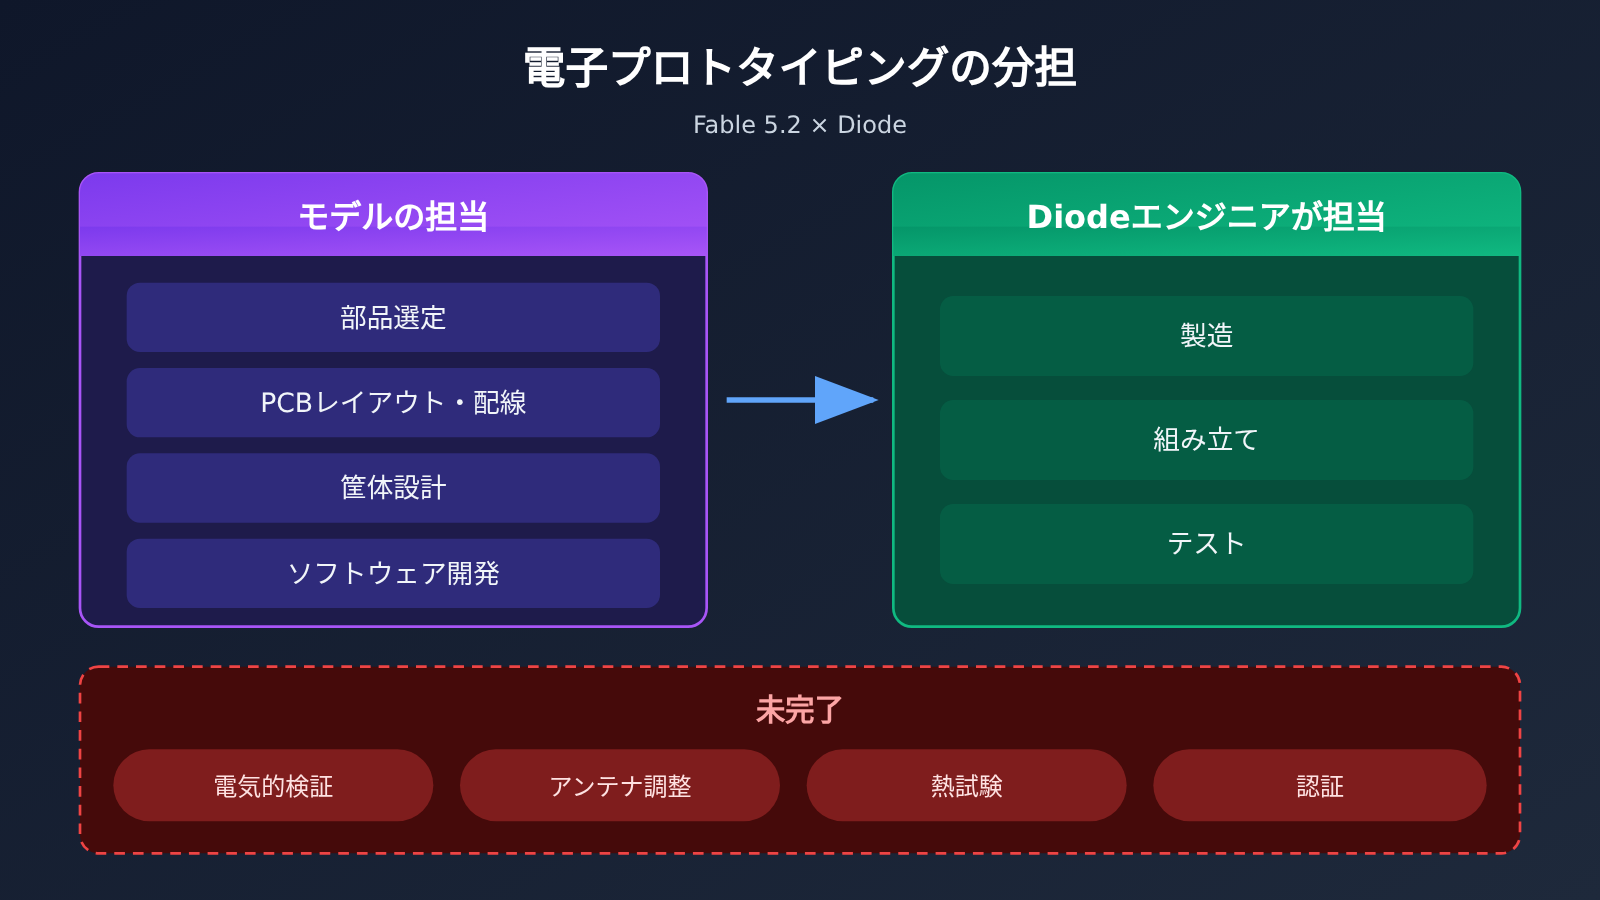
AnthropicはDiodeと協力し、音声アシスタント、USBスピーカーフォン、バーチャルペットという3種類の電子機器のプロトタイプを制作しました。モデルは部品の選定、PCBのレイアウトと配線、筐体の設計、ソフトウェアの作成に参加し、Diodeのエンジニアが実際の製造、組み立て、テストを担当しました。両者には商業的な協力関係があるため、この事例を読む際はその点も考慮する必要があります。
この事例の範囲は明確です。3種類の機器はいずれもプロトタイプにとどまり、電気的な検証、アンテナの調整、熱試験、認証は完了しておらず、量産を前提とした設計でもありません。モデルは工場の設備や試験機器にも接続していません。したがって、正確には「モデルは電子機器のプロトタイプ設計に深く関与できる」と言うべきで、「モデルが量産可能な製品を独力で作り上げた」とは言えません。
同じ研究文書には、設計に関するデータがもう2つ掲載されています。1つ目は、Diodeが実施した社内評価「PCB Gym」です。Fable 5.2のスコアは69%で、比較対象はFable 5(25%)です。Fable 5.1ではありません。2つ目は公開ベンチマークのBenchCAD 2.1です。これは、エンジニアリング図面やレンダリング画像から3D部品、アセンブリ、回路基板を再構築するためのもので、ベンダーの報告によるとFable 5.2のスコアは83.5%でした。ベンチマーク自体は公開されていますが、今回のスコアはまだ独立した再検証を受けていません。
Claude Fable 5.2の科学研究とマルチエージェント事例が注目される理由
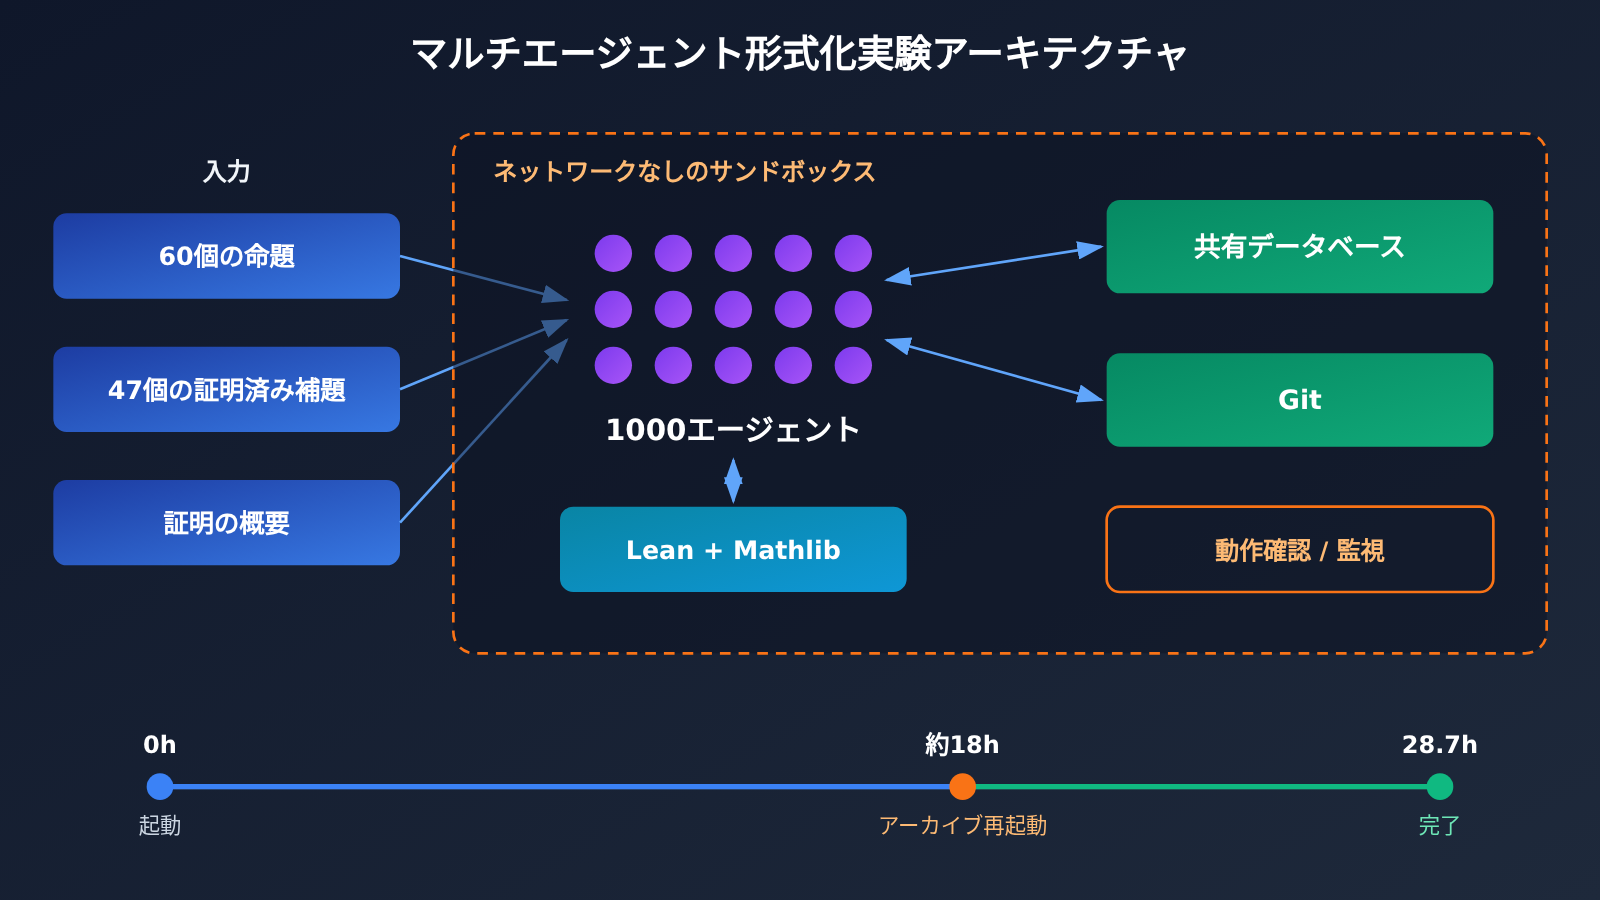
最も注目を集めているのは、数学の形式化実験です。公式開発者ブログによると、初期バージョンのFable 5.2 Agent 1,000体が28.7時間かけて、Leanでフェルマーの最終定理の形式的証明を再現しました。
この事例の価値は、数学上の新発見ではなく、大規模かつ長時間にわたるタスクを遂行する能力にあります。
実験条件を正確に理解するには、次の点を押さえておく必要があります。
- 入力はあらかじめ与えられていた:60個の命題と定義、古典的な証明方針を示す1文の概要、そしてすでに証明されていた47個の補題。
- ツールと環境:Lean、Mathlib、Git、共有データベース、ネットワークに接続されていないサンドボックスを使用し、アクションのチェックとオフライン監視も実施。
- 実行プロセス:Agentは約18時間稼働した時点で保存済みの状態から再起動し、その後さらに12時間実行されました。
- 著者による位置づけ:著者自身が「toy experiment」と呼び、専門的なハーネスの整備や人間による方向づけによって、効率をさらに高められると指摘しています。
つまり、これは既存の数学的証明の形式化です。
こうした制約を踏まえても、この事例はひとつの可能性を示しています。複数のモデルインスタンスが状態を共有しながら、作業を分担し、成果を提出して相互に検証することで、非常に長いタスクを継続して進められるということです。この能力は、大規模なコード移行や複雑なシステムのリファクタリングなど、エンジニアリングの現場でも参考になります。
Claude Fable 5.2が全面的に優れているわけではない領域
能力を責任を持って概説するには、反例も示す必要があります。公式発表の同じ表には、Fable 5.2が優位ではないデータが2つあります。
| 評価 | Fable 5.2 | 比較モデル | 説明 |
|---|---|---|---|
| AutomationBench | 51.4% | Gemini 4 Carbon 53.9% | この項目では競合モデルが上回る |
| AA-Briefcase(評価基準) | 66.1% | Opus 5.5 61.2% | 評価基準に基づく採点ではFableが上回る |
| AA-Briefcase(Elo) | 1785 | Opus 5.5 1800 | 対戦形式の選好評価ではOpusが上回る |
AA-Briefcaseの結果は、特に示唆的です。同じタスクでも、評価基準(rubric)による採点ではFableが上回る一方、Eloによる選好対戦ではOpusが上回ります。評価方法が変われば、順位が逆転することもあります。そのため、1つか2つのランキングだけで「全面的に首位」と結論づけるのは信頼できません。
もう1つのデメリットはコストです。Cursor環境では、Fable 5.2 Maxは1タスクあたり32.79ドル、Opus 5.5 Highは1タスクあたり3.97ドルで、約8倍の差があります。一方、スコアの差は4ポイントです。個人開発者のLex Toumbourouによる小規模な実験でも、5.2 highは5.1より精度が高いものの、出力量と1ラウンドあたりのコストはいずれも約2倍になることが示されています。
また、Mythos専用の安全性や生物関連のスコアを、通常のFableの能力として扱うべきではありません。
Claude Fable 5.2を今試す価値があるユーザー
公式のモデル選択ガイドと上記のデータを踏まえると、対象ユーザーをおおよそ次のように分けられます。
- 優先して試す価値があるユーザー:難易度の高い長期的なコーディング、複雑なシステム設計、複数ステップのツール呼び出しが必要なリサーチタスクに取り組むユーザーです。実際に性能が向上するか、自分のタスクセットで検証しましょう。
- まずは日常的なモデルから始めるユーザー:日常的な知識の質問や一般的なコーディングでは、公式の推奨どおり、まず Opus 5.5 などの日常向けモデルを使い、ボトルネックに直面した場合にアップグレードしましょう。
Claude Fable 5.2を試す前に確認したい5つのポイント
| 項目 | 確認すること | おすすめの対応 |
|---|---|---|
| 利用可否 | 利用中のプラットフォームでこのモデルが提供されているか。モデル ID とエンドポイントは何か | その日のプラットフォームのモデル一覧を確認し、すでに利用可能だと思い込まない |
| データ | タスクのデータをサードパーティのモデルに送信してよいか | データ保持条項と企業のコンプライアンス要件を確認する |
| 合格基準 | タスクの完了をどのように判定するか | 事前にテストケースや評価基準を用意する |
| 時間 | 待ち時間が重要か | 出力速度だけでなく、処理全体にかかった時間も記録する |
| 予算 | 合格したタスク1件あたりの上限コストはいくらか | モデルの各利用区分について、トークン数と合格数を記録し、成功1件あたりのコストを計算する |
共通インターフェースでClaude Fable 5.2を比較テストする
以下の簡単な例では、OpenAI互換インターフェースを使ってモデルを呼び出します。MODEL をプラットフォームのモデル一覧に実際に記載されている ID に置き換えれば、コードを変更せずにモデルを切り替えて比較できます。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI互換インターフェース
)

MODEL = "your-model-id"  # その日のプラットフォームのモデル一覧を確認してください
resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "次の関数にユニットテストを追加してください:..."}]
)
print(resp.choices[0].message.content, resp.usage)
複数モデルの比較と使用量の記録コードを見る
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 候補モデルの ID は、その日のプラットフォームのモデル一覧を確認してください
CANDIDATES = ["daily-model-id", "candidate-model-id"]

def run_task(model: str, prompt: str, check) -> dict:
    """タスクを1回実行し、所要時間、トークン数、合格結果を記録します"""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    text = resp.choices[0].message.content
    return {
        "model": model,
        "seconds": round(time.time() - start, 2),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "passed": bool(check(text)),  # 独自の検収関数を使用してください
    }

def check(text: str) -> bool:
    return "def test_" in text

tasks = ["parse_date 関数にユニットテストを追加してください:..."]
results = [run_task(m, t, check) for m in CANDIDATES for t in tasks]
for r in results:
    print(r)
比較が終わったら、実際の請求明細も確認して費用を計算しましょう。APIYIのログドキュメントには、model_name、prompt_tokens、completion_tokens、quota、request_id などのフィールドが記載されています。quota を 500000 で割るとドル建ての請求額になるため、タスクごとにアップグレード前後の費用を照合できます。なお、公式料金に基づく金額はあくまで推定値です。実際の費用はプラットフォームのログを確認してください。
🚀 すぐに始める:APIYI(apiyi.com)に登録すると、新規ユーザー向けの無料テスト枠を利用できます。まずは実際のタスクを10~20件使って比較の流れを確認し、そのうえで Fable クラスのモデルを使うタスクを増やすか判断しましょう。新モデルの提供状況や価格は、プラットフォームがその日に公開している情報をご確認ください。
よくある質問(FAQ)
Q1:Claude Fable 5.2 とは何ですか?Mythos 5.2 とはどのような関係ですか?
Fable 5.2 は、Anthropic が 2026 年 11 月 9 日にリリースしたモデルで、API のモデル ID は `claude-fable-5-2`、コンテキストウィンドウは 1M です。Mythos 5.2 と同じ基盤モデルを使用していますが、安全対策の違いにより、Fable は一般の顧客にも公開されている一方、Mythos は審査を通過した組織のみに提供されています。
Q2:Claude Fable 5.2 は Opus 5.5 よりどれくらい優れていますか?
公式の比較表では、FrontierSWE v2 のスコアは 69.9% 対 62.3% です。AA 指数は max の設定で 65 対 59 です。CursorBench 4.0 の High 設定では、差はわずか 0.9 ポイントです。全体として、Fable 5.2 はより高い性能を発揮できますが、単価は Opus 5.5 の 2 倍です。上位の設定では、タスクあたりの費用差がさらに大きくなる可能性があります。
Q3:Claude Fable 5.2 は、あらゆるタスクで最も優れていますか?
いいえ。AutomationBench では Gemini 4 Carbon が 53.9% で、Fable 5.2 の 51.4% を上回っています。AA-Briefcase の Elo スコアでは、Opus 5.5 のほうが上位です。評価方法が異なれば、順位も変わります。
Q4:Fable 5.2 を使えば、必ず 5.1 より費用を抑えられますか?
そうとは限りません。単価が 20% 下がっても、20% の節約になるのは利用量が変わらない場合だけです。たとえば、入力が 10 万トークン、出力が 2 万トークンのタスクでは、5.2 の費用は 1.60 ドル、5.1 は 2 ドルです。しかし、出力が 4 万トークンに増えると、5.2 の費用は 2.40 ドルとなり、かえって高くなります。この例は変数間の関係を示すものであり、モデルの出力が必ず増えるという予測ではありません。APIYI(apiyi.com)の呼び出しログを使って、タスクごとの実際のトークン消費量を確認することをおすすめします。
Q5:API を使って Claude Fable 5.2 とほかのモデルをすばやく比較するには?
1. APIYI(apiyi.com)に登録し、APIキーと無料テスト枠を取得します。
2. その日のプラットフォームのモデル一覧で、利用可能な ID を確認します。
3. この記事のコードを使い、base_url を `https://api.apiyi.com/v1` に設定して、同じタスク群で各モデルを呼び出します。
4. 成功した件数、所要時間、トークン数を記録し、成功1回あたりの費用を計算します。
Q6:フェルマーの最終定理に関する実験は、Fable 5.2 が独創的な数学研究をできることを示していますか?
いいえ。この実験では、60 個の命題、証明済みの補題 47 個、証明の概要が与えられ、初期スナップショットの Agent 1,000 個がオフラインのサンドボックスで 28.7 時間動作しました。モデルが行ったのは既存の証明の形式化であり、しかも実行は一度だけです。この実験から長期的な作業を組み立てる能力はうかがえますが、モデルが独創的な数学的発見を行えることの証明にはなりません。
Claude Fable 5.2の主なポイント
- リリースの位置づけ:11月9日にリリース。Mythosと同じ基盤モデルを使用し、一般ユーザー向けに提供されています。
- コーディング性能の上限:FrontierSWE v2で69.9%を記録。公式の比較表では5.1とOpus 5.5を上回っています。
- 第三者による評価:AAのMax枠で65点、CursorBench Maxで60.0%を記録していますが、タスクあたりの費用は大幅に高くなります。
- 視覚から動作へ:RoboDojo Simは27.6%から64.9%に向上しています。ただし、これはシミュレーション環境での評価です。
- エンジニアリングと研究:電子回路のプロトタイプ設計や、大規模なLean形式化に対応できますが、いずれも明確な前提条件があります。
- すべての評価で首位ではない:AutomationBenchやEloの評価では、ほかのモデルが上回るケースもあります。
- 試す方法:APIYI(apiyi.com)の統一インターフェースを使い、自社のタスクで比較してからアップグレードを検討できます。
まとめ
Claude Fable 5.2の主なポイントは次のとおりです。
- 難しいタスクで大きく向上:長時間にわたるコーディングや視覚制御などの評価で、5.1から大幅に進歩しています。
- 評価結果は種類ごとに見る:ベンダーの自己評価、AAの独立ランキング、Cursor独自の環境では、それぞれ評価の対象や適用範囲が異なります。数値を一括りにして比較することはできません。
- 高い性能にはコストが伴う:上位プランでは性能の上限が高まる一方、タスクあたりの費用が数倍になることもあります。単価が下がっても、タスク全体のコストが下がるとは限りません。
難易度の高い長時間のコーディング、複雑なエンジニアリング、研究タスクが中心なら、手持ちのタスクセットを使ってFable 5.2の実際の効果を今すぐ検証する価値があります。日常的な業務では、まずOpusなどの汎用モデルから試すのがおすすめです。APIYI(apiyi.com)で複数のモデルを同じインターフェースから比較し、ログに基づいてコストを計算すれば、ランキングではなく実データをもとにアップグレードを判断できます。
📚 参考資料
- Anthropicの発表:FableとMythos 5.2の提供範囲、公式の性能一覧
- リンク:
anthropic.com/claude-fable-and-mythos-5-2 -
説明:公開日、速度の算出基準、比較データを確認できる一次情報(提供元による自己評価)
-
Fable 5.2のモデル仕様:コンテキスト、出力上限、思考モード
- リンク:
platform.claude.com/docs/en/models/fable-5-2/overview -
説明:公式APIドキュメント
-
Artificial Analysisのモデルランキング:Intelligence Indexとタスクごとのコスト
- リンク:
artificialanalysis.ai/leaderboards/models -
説明:第三者機関による随時更新のスナップショット
-
CursorBench 4.0:Cursor独自の環境で実施した評価
- リンク:
prod.cursor.com/evals -
説明:ツール提供元による評価であり、汎用的な第三者による独立検証ではありません
-
Claudeによる電子機器のプロトタイプ設計に関する研究:Diodeとの共同開発による3種類のプロトタイプ
- リンク:
anthropic.com/research/claude-electronics-design -
説明:PCB Gym、BenchCAD 2.1のデータと、プロトタイプの限界について記載されています
-
Fable 5.2のマルチエージェントチーム実験:Lean形式化実験の条件
- リンク:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2/ -
説明:提供元が公開した初期スナップショットに基づく大規模実行の一例
-
Claudeモデルの選び方ガイド:OpusとFableの使い分け
- リンク:
claude.dev/blog/which-claude-model-should-you-build-with/ - 説明:公式開発者ガイド
著者:APIYI技術チーム
技術的なお問い合わせ:APIYI公式サイトのトップページからお気軽にお問い合わせください。ログの項目や料金に関する説明は、docs.apiyi.comのドキュメントセンターでご確認いただけます。


