
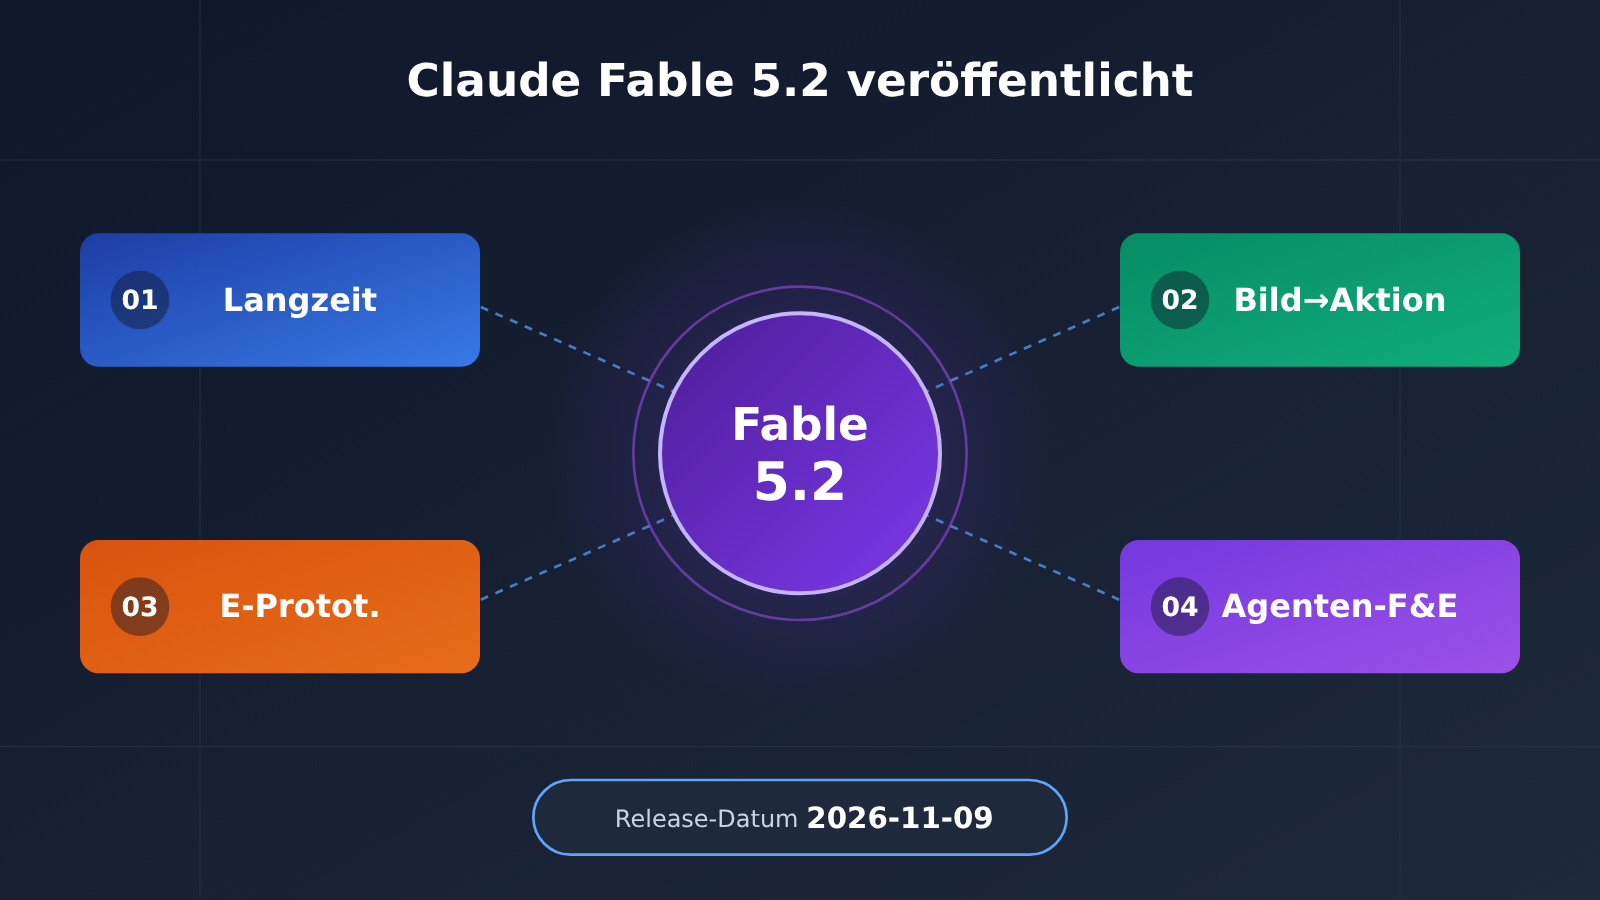
Anthropic hat Claude Fable 5.2 am 9. November 2026 offiziell veröffentlicht. Die offizielle Leistungstabelle und Rankings von Drittanbietern zeigen, dass das Modell bei schwierigen Aufgaben und der Zusammenarbeit über längere Zeiträume deutlich besser abschneidet als Version 5.1. Der Standardpreis der API liegt zudem 20 % unter dem von 5.1.
Der zentrale Nutzen: Dieser Artikel geht nach dem Prinzip „zuerst das Fazit, dann die Belege, anschließend die Grenzen“ vor. So können Sie einschätzen, worin Claude Fable 5.2 wirklich stark ist, wie groß der Vorsprung ausfällt und ob sich ein Wechsel für Ihre Aufgaben jetzt lohnt.
Begriffe zum Verständnis der Claude-Fable-5.2-Bewertungen
Im Folgenden begegnen Ihnen immer wieder bestimmte Bewertungskriterien. Wer sie falsch versteht, könnte Herstellerdemonstrationen für unabhängige Überprüfungen halten oder Teilpunkte mit einer Erfolgsquote verwechseln.
- Agent: Ein Modellsystem, das Tools aufrufen und Aufgaben in mehreren aufeinanderfolgenden Schritten ausführen kann.
- Intelligence Index: Der Gesamtindex von Artificial Analysis (AA) zur Bewertung der Fähigkeiten. Er ist ein zusammengesetzter Wert und keine Genauigkeitsquote.
- OSWorld partial: Ein Bewertungsmaßstab für Desktop-Aufgaben, bei dem Teilerfolge berücksichtigt werden. Er entspricht nicht der strikten Erfolgsquote für vollständige Aufgaben.
- RoboDojo Sim: Eine Bewertung der Steuerungsfähigkeit in einer Robotersimulation. Sie sagt nichts über die Erfolgsquote realer Roboter aus.
- PCB: Leiterplatte, die elektronische Bauteile trägt und miteinander verbindet.
- Lean / formaler Beweis: Lean ist eine Sprache und ein Werkzeug, mit denen Computer Beweise überprüfen können. Bei einem formalen Beweis wird ein mathematisches Argument in strenge, vom Computer Schritt für Schritt überprüfbare Schritte übertragen.
- Zusammenarbeit mehrerer Agents: Mehrere Modellinstanzen teilen die Arbeit untereinander auf, kommunizieren miteinander und fassen anschließend die Ergebnisse zusammen.
Wie leistungsfähig ist Claude Fable 5.2? Erst das Fazit, dann der Hintergrund
Kurz gesagt: Claude Fable 5.2 macht deutliche Fortschritte bei anspruchsvollen Programmieraufgaben, mehrstufigen Aufgaben und Benchmarks zu visueller Wahrnehmung und Handlung. Es lässt sich aber nicht pauschal als „in allen Aufgaben führend“ bezeichnen. Bei einigen automatisierten Bewertungen und Präferenz-Rankings liegt das Modell weiterhin hinter anderen Modellen.
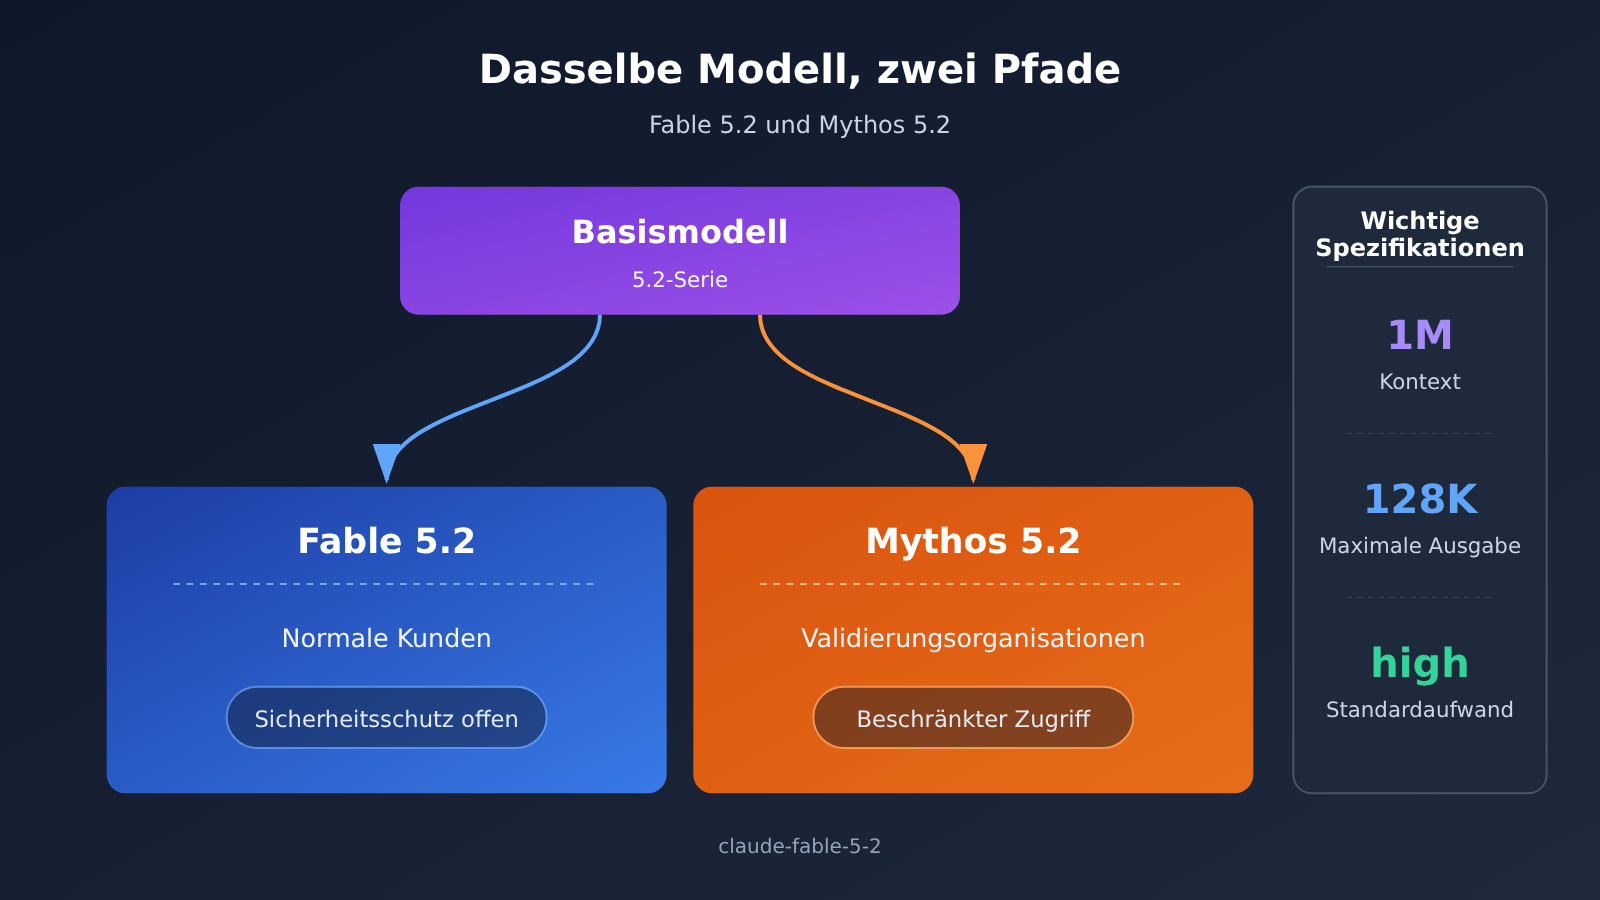
Zunächst zum Hintergrund der Veröffentlichung: Laut Hersteller verwenden Fable und Mythos dasselbe Basismodell. Die Schutzmaßnahmen von Fable für Cybersicherheit und Biosicherheit erlauben den Einsatz durch allgemeine Kunden. Mythos ist dagegen nur für geprüfte Organisationen verfügbar. Die exklusiven Fähigkeiten oder Ergebnisse von Mythos lassen sich daher nicht einfach Fable zuschreiben.
Claude Fable 5.2 im Überblick
| Information | Details | Quellenart |
|---|---|---|
| Veröffentlichungsdatum | 9. November 2026 | Offizielle Ankündigung |
| API-Modell-ID | claude-fable-5-2 |
Offizielle Modelldokumentation |
| Kontextfenster / maximale Ausgabe | 1M Token / 128K Token | Offizielle Modelldokumentation |
| Ein- und Ausgabemodalitäten | Texteingabe und Bildeingabe, Textausgabe | Offizielle Modelldokumentation |
| Denkmodus | Adaptives Denken ist immer aktiviert; der Standardwert für effort in der API ist high |
Offizielle Modelldokumentation |
| Wissensstand bis | Juni 2026 (bedeutet nicht, dass das Modell in Echtzeit auf das Internet zugreifen kann) | Offizielle Modelldokumentation |
| Standardpreis | 8 US-Dollar für Eingaben und 40 US-Dollar für Ausgaben pro Million Token; jeweils 20 % günstiger als bei 5.1 | Offizielle Preisseite |
| Geschwindigkeitsangabe | Ausgabeerzeugung laut Hersteller „bis zu 30 % schneller“ als bei 5.1 | Obergrenze laut Hersteller |
Zwei Punkte werden leicht missverstanden. Erstens ist „bis zu 30 % schneller“ eine vom Hersteller angegebene Obergrenze für die Ausgabegeschwindigkeit. Das bedeutet nicht, dass jede Aufgabe 30 % weniger Zeit benötigt. Zweitens kostet Fable 5.2 zum Standardpreis weiterhin doppelt so viel wie Opus 5.5 (4/20 US-Dollar).
Der Hersteller empfiehlt außerdem ausdrücklich, für die meisten alltäglichen Programmier- und Wissensaufgaben zunächst Opus 5.5 zu verwenden und erst bei komplexen Aufgaben auf Fable umzusteigen.
Belege für die Fortschritte von Claude Fable 5.2 bei Programmier- und Langzeitaufgaben
Programmieren steht bei dieser Veröffentlichung im Mittelpunkt. Sehen wir uns zunächst die vom Anbieter veröffentlichten Daten und anschließend zwei Datensätze von Drittanbietern mit unterschiedlichen Testumgebungen an.
Offizielle Leistungsübersicht: Fable 5.2 im Vergleich zu 5.1 und Opus 5.5
| Benchmark (vom Anbieter veröffentlicht) | Fable 5.2 | Fable 5.1 | Opus 5.5 | Erläuterung |
|---|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | — | Unterschiedliche Effort-Einstellungen |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% | Langfristige Softwareentwicklungsaufgaben |
| AutomationBench | 51.4% | 31.4% | 42.5% | Automatisierungsaufgaben |
| OSWorld 2.1 Offline-Teildatensatz, partial | 89.3% | 83.5% | 87.2% | Teilweise Bewertung |
| RoboDojo Sim | 64.9% | 27.6% | 39.4% | Robotersteuerung in einer Simulation |
Aus der Tabelle geht hervor, dass Fable 5.2 bei FrontierSWE v2 um 13.6 Prozentpunkte vor 5.1 liegt und auch Opus 5.5 übertrifft. Bei FrontierCode 2.0 fällt der Zuwachs noch größer aus. Da für die beiden Ergebnisse jedoch unterschiedliche Effort-Einstellungen verwendet wurden, könnte ein Teil des Anstiegs auf die jeweilige Schlussfolgerungsstufe zurückzuführen sein.
Daten von Drittanbietern: Claude Fable 5.2 bei AA und Cursor
| Testumgebung | Konfiguration | Ergebnis | Kosten pro Aufgabe (US-Dollar) |
|---|---|---|---|
| Artificial Analysis | Fable 5.2 medium | 56 | 3.80 |
| Artificial Analysis | Fable 5.2 high | 62 | 9.08 |
| Artificial Analysis | Fable 5.2 xhigh | 62 | 14.83 |
| Artificial Analysis | Fable 5.2 max | 65 | 26.54 |
| Artificial Analysis | Opus 5.5 max | 59 | 10.04 |
| CursorBench 4.0 | Fable 5.2 High | 56.9% | 9.70 |
| CursorBench 4.0 | Fable 5.2 Max | 60.0% | 32.79 |
| CursorBench 4.0 | Opus 5.5 High | 56.0% | 3.97 |
AA ist eine unabhängige Benchmark-Organisation. In ihrem Intelligence Index erreicht Fable 5.2 max einen Wert von 65 und liegt damit über Opus 5.5 max mit 59 – dieselbe Tendenz wie in der offiziellen Übersicht.
Die Cursor-Daten stammen aus den eigenen Aufgaben und der eigenen Tool-Umgebung. Fable 5.2 Max erreicht 60.0%. Im High-Modus beträgt der Abstand zu Opus 5.5 High jedoch nur 0.9 Prozentpunkte.
Beide Datensätze von Drittanbietern zeigen: Ein höheres Leistungspotenzial geht in der Regel mit höheren Kosten pro Aufgabe einher. Bei AA steigt der Wert von high auf max um 3 Punkte, während sich die Kosten pro Aufgabe etwa auf das 2.92-Fache erhöhen.
🎯 Technische Empfehlung: Benchmarks helfen dabei, die Auswahl einzugrenzen. Die endgültige Entscheidung sollte jedoch anhand Ihrer eigenen Aufgaben getroffen werden. Vergleichen Sie mehrere Modelle wie Opus und Fable über APIYI apiyi.com mit derselben OpenAI-kompatiblen Schnittstelle, denselben Eingabeaufforderungen und denselben Abnahmekriterien. Halten Sie anschließend Qualität und Kosten für jede Stufe fest.
Wo stehen die visuellen und technischen Fähigkeiten von Claude Fable 5.2?
Vom Bildschirmverständnis zur Steuerung von Aktionen
Bei den visuellen Fähigkeiten sind vor allem zwei Benchmarks interessant: OSWorld 2.1 und RoboDojo Sim. Im Offline-Subset von OSWorld 2.1 stieg der Partial-Score von 83,5 % auf 89,3 %. Opus 5.5 erreicht allerdings bereits 87,2 % – der Abstand ist also nicht besonders groß.
Bei RoboDojo Sim fiel der Fortschritt deutlicher aus: Der Wert stieg von 27,6 % auf 64,9 %. Das zeigt, dass das Modell visuelle Informationen deutlich besser in kontinuierliche Steuerungsaktionen umsetzen kann.
Fable 5.2 wirkt an elektronischen Prototypen mit
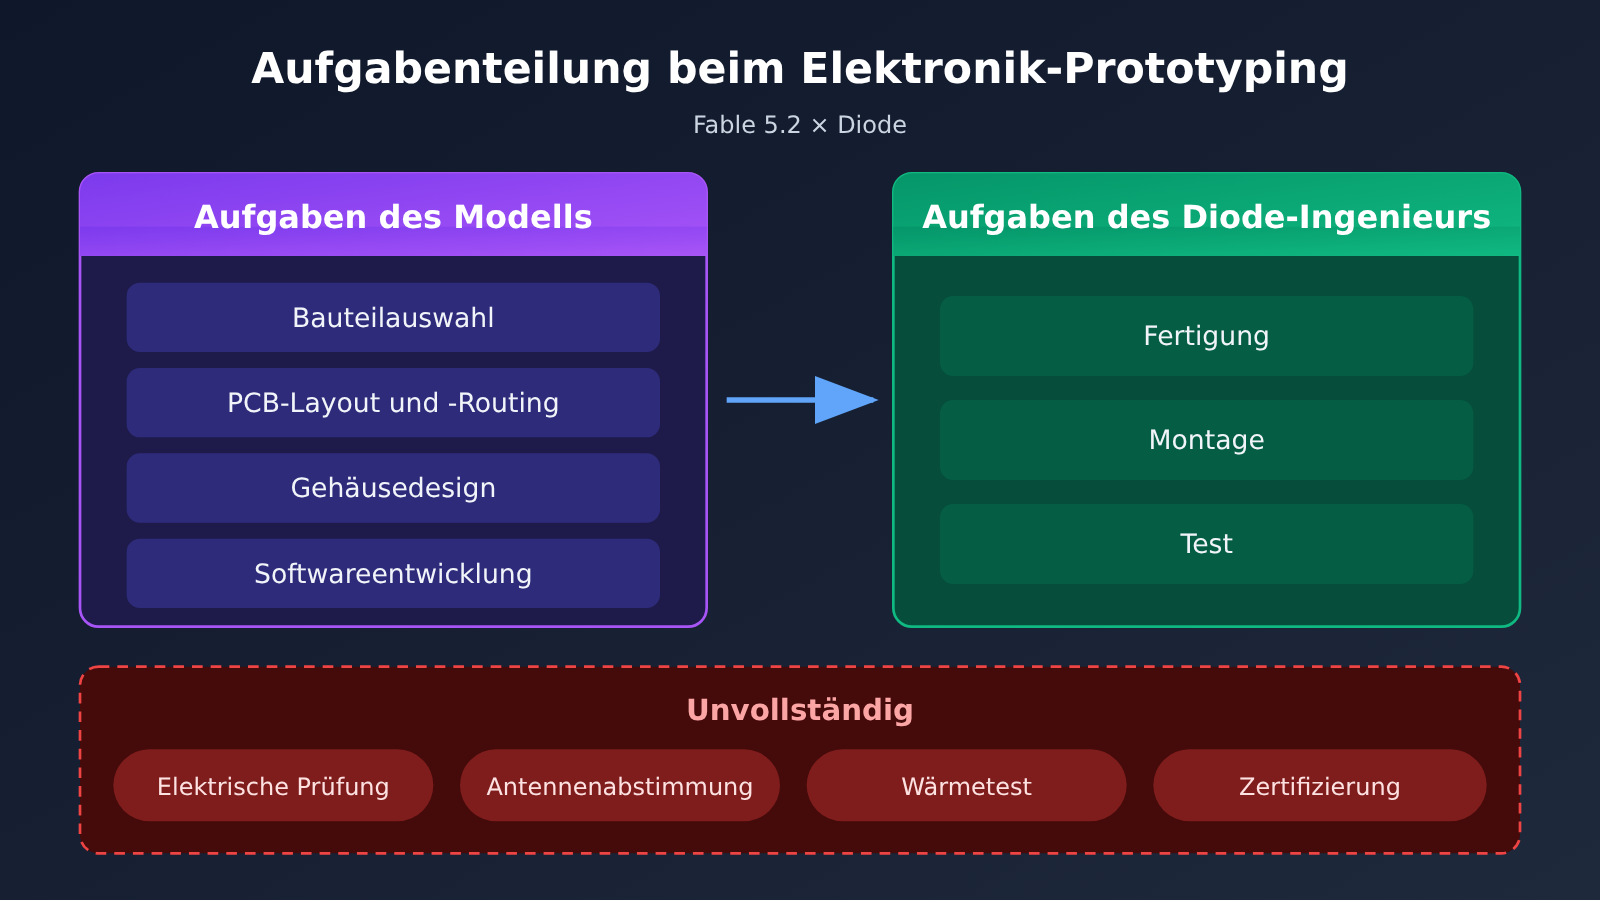
Anthropic und Diode haben gemeinsam drei Prototypen für elektronische Geräte entwickelt: einen Sprachassistenten, ein USB-Freisprechtelefon und ein virtuelles Haustier. Das Modell wirkte bei der Komponentenauswahl, beim Layout und Routing der Leiterplatten, beim Gehäusedesign und bei der Softwareentwicklung mit. Die Ingenieure von Diode übernahmen die Fertigung, Montage und Tests. Da beide Unternehmen eine Geschäftsbeziehung haben, sollte man diesen Fall entsprechend einordnen.
Die Grenzen des Projekts sind klar: Alle drei Geräte sind Prototypen. Es gab keine elektrische Validierung, keine Antennenabstimmung, keine Wärmetests und keine Zertifizierung. Auch wurden die Geräte nicht für die Serienproduktion ausgelegt. Das Modell war weder mit Fertigungsanlagen noch mit Prüfgeräten verbunden. Die treffende Aussage lautet also: „Das Modell kann sich umfassend an der Entwicklung elektronischer Prototypen beteiligen“ – nicht: „Das Modell hat eigenständig ein serienreifes Produkt gebaut.“
Dasselbe Forschungsdokument enthält außerdem zwei Kennzahlen aus dem Designbereich. Die erste stammt aus PCB Gym, einem internen Benchmark von Diode. Fable 5.2 erzielte dort 69 %, verglichen mit 25 % für Fable 5 – nicht 5.1. Die zweite stammt aus dem öffentlichen Benchmark BenchCAD 2.1, bei dem 3D-Bauteile, Baugruppen und Leiterplatten anhand technischer Zeichnungen und Renderings rekonstruiert werden. Laut Herstellerbericht erreichte Fable 5.2 dabei 83,5 %. Der Benchmark ist öffentlich, das Ergebnis wurde jedoch noch nicht unabhängig überprüft.
Warum die Forschungs- und Multi-Agent-Beispiele mit Claude Fable 5.2 Aufmerksamkeit erregen
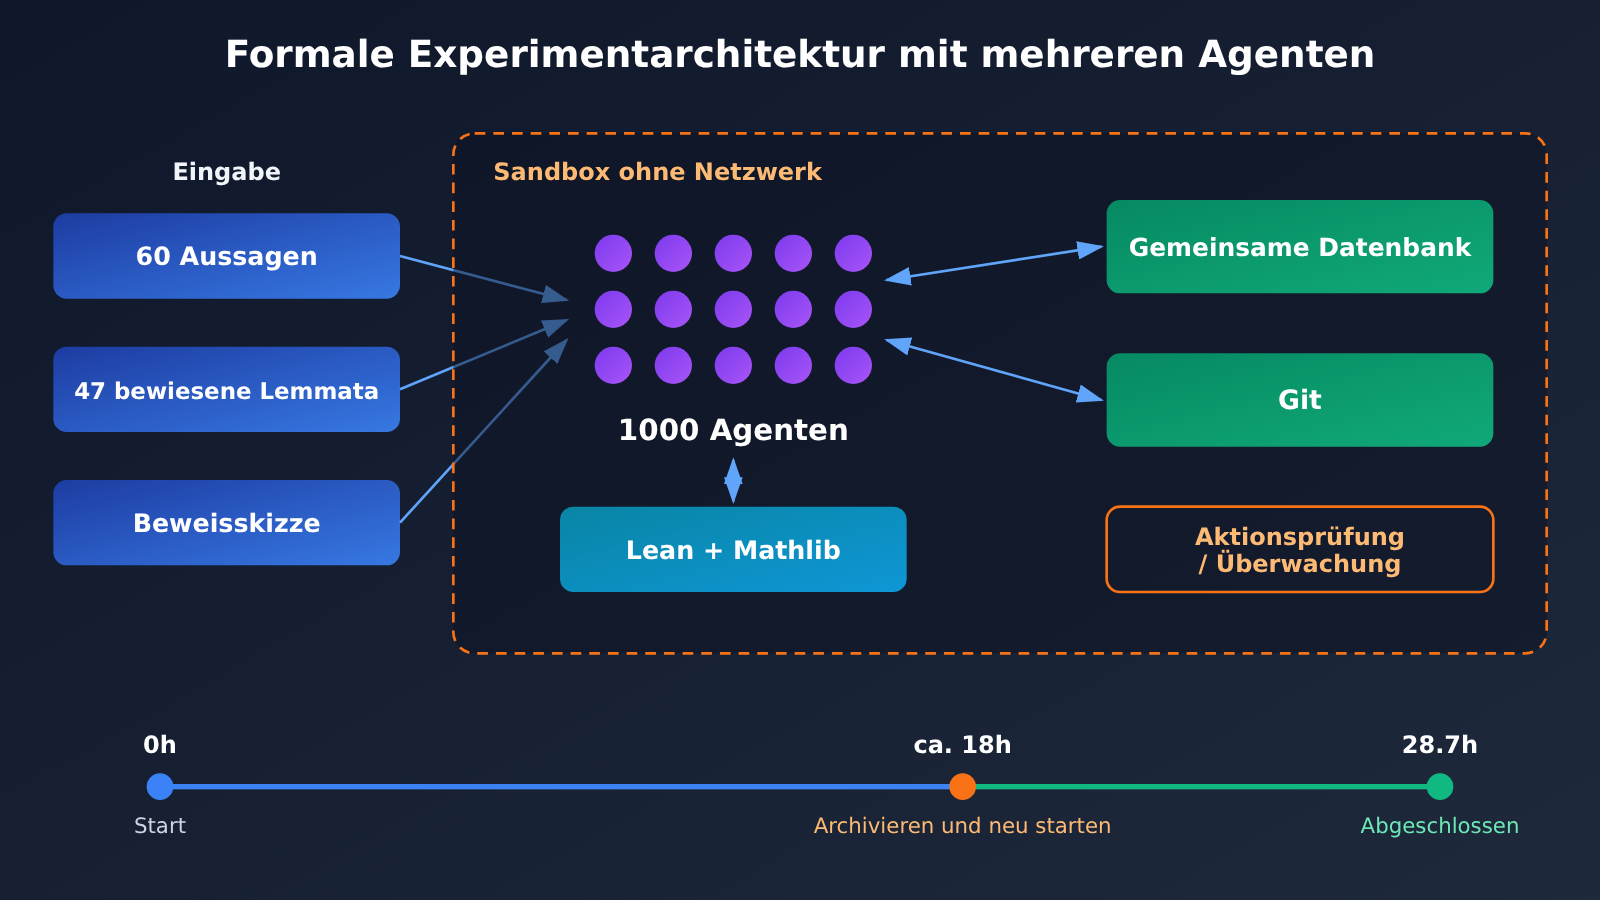
Am meisten Beachtung findet das Experiment zur mathematischen Formalisierung. Laut dem offiziellen Entwicklerblog haben 1.000 Agenten mit einer frühen Version von Fable 5.2 innerhalb von 28,7 Stunden den formalisierten Beweis des großen Satzes von Fermat in Lean reproduziert.
Der Wert dieses Beispiels liegt in der Fähigkeit, Aufgaben über einen langen Zeitraum und in großem Umfang zu organisieren – nicht in einer mathematischen Neuentdeckung.
Die Versuchsbedingungen müssen vollständig beschrieben werden:
- Die Eingaben waren vorgegeben: 60 Sätze und Definitionen, eine einzeilige Skizze des klassischen Beweiswegs sowie 47 zuvor bewiesene Lemmata.
- Werkzeuge und Umgebung: Lean, Mathlib, Git, eine gemeinsam genutzte Datenbank und eine Sandbox ohne Internetzugang, ergänzt durch Aktionsprüfungen und Offline-Überwachung.
- Ablauf: Nach ungefähr 18 Stunden wurden die Agenten aus einem gespeicherten Zustand neu gestartet und liefen weitere 12 Stunden.
- Einordnung durch die Autoren: Die Autoren selbst bezeichnen das Experiment als „Toy-Experiment“ und weisen darauf hin, dass ein professionelles Harness und menschliche Anleitung die Effizienz weiter steigern könnten.
Es handelt sich also um die Formalisierung eines bereits bekannten mathematischen Beweises.
Auch mit diesen Einschränkungen weist das Beispiel auf eine wichtige Entwicklung hin: Mehrere Modellinstanzen können sich einen Auftrag teilen, in einem gemeinsamen Zustand arbeiten, Ergebnisse einreichen und überprüfen – und so eine äußerst langwierige Aufgabe kontinuierlich voranbringen. Das ist auch für technische Arbeiten wie umfangreiche Code-Migrationen und die Umstrukturierung komplexer Systeme relevant.
In welchen Bereichen Claude Fable 5.2 nicht uneingeschränkt überlegen ist
Ein verantwortungsvoller Überblick über die Fähigkeiten muss auch Gegenbeispiele nennen. In derselben Tabelle der offiziellen Ankündigung gibt es zwei Werte, bei denen Fable 5.2 nicht vorne liegt.
| Benchmark | Fable 5.2 | Vergleichsmodell | Hinweis |
|---|---|---|---|
| AutomationBench | 51.4% | Gemini 4 Carbon 53.9% | Das Vergleichsmodell liegt hier vorn |
| AA-Briefcase (Rubrik) | 66.1% | Opus 5.5 61.2% | Nach der Bewertungsrubrik liegt Fable vorn |
| AA-Briefcase (Elo) | 1785 | Opus 5.5 1800 | Bei den Präferenzduellen liegt Opus vorn |
Die Zeile zu AA-Briefcase ist besonders aufschlussreich. Bei derselben Aufgabe liegt Fable nach Punkten gemäß Bewertungsrubrik vorn, während Opus bei den nach Elo gewerteten Präferenzduellen besser abschneidet. Ändert sich die Bewertungsmethode, kann sich auch die Rangfolge umkehren. Deshalb ist es nicht verlässlich, auf Grundlage von ein oder zwei Ranglisten „den eindeutigen Gesamtsieger“ auszurufen.
Ein weiterer Nachteil sind die Kosten. In der Cursor-Umgebung kostet Fable 5.2 Max 32,79 US-Dollar pro Aufgabe, Opus 5.5 High dagegen 3,97 US-Dollar – etwa achtmal weniger. Der Punkteunterschied beträgt dabei vier Prozentpunkte. Auch ein kleines Experiment des unabhängigen Entwicklers Lex Toumbourou zeigt: 5.2 high ist genauer als 5.1, aber sowohl die Ausgabemenge als auch die Kosten pro Durchlauf sind etwa doppelt so hoch.
Außerdem sollten die speziellen Sicherheits- und Biologie-Werte von Mythos nicht als Fähigkeiten des regulären Fable gewertet werden.
Für welche Nutzer lohnt sich ein Test von Claude Fable 5.2?
Anhand des offiziellen Leitfadens zur Modellauswahl und der oben genannten Daten lässt sich die Zielgruppe grob so einteilen:
- Vorrangig testen: bei anspruchsvollen, längerfristigen Programmieraufgaben, komplexem Engineering-Design und Forschungsaufgaben, die mehrere Tool-Aufrufe erfordern. Mit einem eigenen Aufgabensatz lässt sich prüfen, ob sich tatsächlich Verbesserungen ergeben.
- Mit einem Alltagsmodell starten: Bei alltäglichen Wissensfragen und gewöhnlichen Programmieraufgaben empfiehlt es sich, zunächst ein Alltagsmodell wie Opus 5.5 zu verwenden und erst bei konkreten Engpässen auf ein leistungsfähigeres Modell umzusteigen.
Fünf Kriterien für die Entscheidung vor dem Test von Claude Fable 5.2
| Kriterium | Zu klärende Frage | Empfehlung |
|---|---|---|
| Verfügbarkeit | Ist das Modell auf der von dir genutzten Plattform bereits verfügbar, und wie lauten Modell-ID und Endpunkt? | Maßgeblich ist die aktuelle Modellliste der Plattform. Gehe nicht davon aus, dass das Modell bereits verfügbar ist. |
| Daten | Dürfen die Aufgabendaten an ein Modell eines Drittanbieters übermittelt werden? | Prüfe die Bedingungen zur Datenspeicherung und die Compliance-Anforderungen deines Unternehmens. |
| Abnahme | Wann gilt eine Aufgabe als abgeschlossen? | Lege vorab Testfälle oder klare Bewertungskriterien fest. |
| Zeit | Ist die Wartezeit entscheidend? | Erfasse auch die Gesamtdauer vom Start bis zum Ergebnis, nicht nur die Ausgabezeit. |
| Budget | Wie hoch sind die maximalen Kosten pro erfolgreich abgeschlossener Aufgabe? | Erfasse Tokenverbrauch und Zahl erfolgreicher Aufgaben je Modellklasse und berechne die Kosten pro Erfolg. |
Vergleichstests mit Claude Fable 5.2 über eine einheitliche Schnittstelle
Das folgende Minimalbeispiel ruft ein Modell über eine OpenAI-kompatible Schnittstelle auf. Ersetzen Sie MODEL durch eine ID, die in der aktuellen Modellliste der Plattform enthalten ist. So können Sie verschiedene Modelle vergleichen, ohne den Code zu ändern.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

MODEL = "your-model-id"  # Maßgeblich ist die aktuelle Modellliste der Plattform
resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "为下面的函数补充单元测试:..."}]
)
print(resp.choices[0].message.content, resp.usage)
Code für den Vergleich mehrerer Modelle und die Erfassung des Verbrauchs anzeigen
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Maßgeblich für die IDs der Kandidatenmodelle ist die aktuelle Modellliste der Plattform
CANDIDATES = ["daily-model-id", "candidate-model-id"]

def run_task(model: str, prompt: str, check) -> dict:
    """Führt eine Aufgabe aus und erfasst Dauer, Tokenverbrauch und Prüfergebnis."""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    text = resp.choices[0].message.content
    return {
        "model": model,
        "seconds": round(time.time() - start, 2),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "passed": bool(check(text)),  # Verwenden Sie Ihre eigene Prüffunktion
    }

def check(text: str) -> bool:
    return "def test_" in text

tasks = ["为 parse_date 函数补充单元测试:..."]
results = [run_task(m, t, check) for m in CANDIDATES for t in tasks]
for r in results:
    print(r)
Nach dem Vergleich sollten Sie die tatsächlichen Kosten anhand der Rechnung überprüfen. Die APIYI-Dokumentation zu den Logs führt Felder wie model_name, prompt_tokens, completion_tokens, quota und request_id auf. quota geteilt durch 500000 ergibt die Kosten in US-Dollar. So können Sie die Ausgaben vor und nach dem Upgrade für jede Aufgabe einzeln abgleichen. Beachten Sie: Der anhand der offiziellen Tarife berechnete Betrag ist nur ein Schätzwert. Maßgeblich sind die tatsächlichen Logs der Plattform.
🚀 Schnellstart: Registrieren Sie sich bei APIYI unter apiyi.com und sichern Sie sich ein kostenloses Testguthaben für Neukunden. Führen Sie zunächst 10 bis 20 echte Aufgaben durch den Vergleichsprozess, bevor Sie entscheiden, ob Sie den Umfang auf das Niveau von Fable ausweiten. Ob ein neues Modell verfügbar ist und wie viel es kostet, entnehmen Sie bitte den aktuellen Angaben der Plattform.
Häufig gestellte Fragen (FAQ)
F1: Was ist Claude Fable 5.2? Wie hängt das Modell mit Mythos 5.2 zusammen?
Fable 5.2 ist ein Modell, das Anthropic am 9. November 2026 veröffentlicht hat. Die API-Modell-ID lautet `claude-fable-5-2`, und das Modell unterstützt ein Kontextfenster von 1M. Fable 5.2 und Mythos 5.2 verwenden dasselbe Basismodell. Der Unterschied: Dank seiner Sicherheitsvorkehrungen kann Fable für allgemeine Kunden freigegeben werden, während Mythos nur geprüften Organisationen zur Verfügung steht.
F2: Wie viel leistungsfähiger ist Claude Fable 5.2 als Opus 5.5?
In der offiziellen Tabelle erreicht Fable 5.2 bei FrontierSWE v2 69,9 %, Opus 5.5 dagegen 62,3 %. Beim AA-Index liegt Fable 5.2 in der Stufe „max“ mit 65 zu 59 vorn. Bei CursorBench 4.0 beträgt der Vorsprung in der Stufe „High“ nur 0,9 Prozentpunkte. Insgesamt hat Fable 5.2 ein höheres Leistungspotenzial, kostet pro Einheit aber doppelt so viel wie Opus 5.5. In höheren Preisstufen kann der Kostenunterschied pro Aufgabe noch größer ausfallen.
F3: Ist Claude Fable 5.2 bei allen Aufgaben die Nummer eins?
Nein. Bei AutomationBench erreicht Gemini 4 Carbon 53,9 % und liegt damit über Fable 5.2 mit 51,4 %. Bei der Bewertung nach Elo-Punkten belegt Opus 5.5 bei AA-Briefcase einen höheren Rang. Je nach Bewertungsmethode kann sich auch die Rangfolge ändern.
F4: Spare ich mit Fable 5.2 immer Geld gegenüber Version 5.1?
Nicht unbedingt. Die Kosten sinken nur dann um 20 %, wenn die Nutzung gleich bleibt. Angenommen, eine Aufgabe umfasst 100.000 Eingabe- und 20.000 Ausgabetoken: Mit Version 5.2 kostet sie 1,60 US-Dollar, mit Version 5.1 dagegen 2 US-Dollar. Steigt die Ausgabe jedoch auf 40.000 Token, kostet Version 5.2 bereits 2,40 US-Dollar und ist damit teurer. Dieses Beispiel veranschaulicht lediglich den Zusammenhang zwischen den Variablen; es ist keine Prognose, dass das Modell grundsätzlich mehr ausgeben wird. Am besten prüfen Sie den tatsächlichen Tokenverbrauch für jede Aufgabe anhand der Aufrufprotokolle bei APIYI unter apiyi.com.
F5: Wie kann ich Claude Fable 5.2 schnell per API mit anderen Modellen vergleichen?
1. Registrieren Sie sich bei APIYI unter apiyi.com und holen Sie sich einen API-Schlüssel sowie ein kostenloses Testguthaben.
2. Prüfen Sie, welche Modell-IDs an diesem Tag in der Modellliste der Plattform verfügbar sind.
3. Verwenden Sie den Code aus diesem Artikel, setzen Sie `base_url` auf `https://api.apiyi.com/v1` und rufen Sie die Modelle mit denselben Aufgaben auf.
4. Notieren Sie die Zahl der erfolgreichen Durchläufe, die Laufzeit und die Tokenzahl. Berechnen Sie anschließend die Kosten pro erfolgreicher Aufgabe.
F6: Beweist das Fermatsche-Primzahlsatz-Experiment, dass Fable 5.2 eigenständige mathematische Entdeckungen machen kann?
Nein. Das Experiment stellte 60 Aussagen, 47 bereits bewiesene Lemmata und einen Beweisplan bereit. In einer Offline-Sandbox arbeiteten 1.000 Agenten auf Basis früher Modell-Snapshots 28,7 Stunden lang daran. Ihre Aufgabe bestand darin, vorhandene Beweise zu formalisieren – und das Ergebnis stammt aus nur einem einzigen Durchlauf. Das Experiment zeigt, dass das Modell längere Aufgaben organisieren kann, beweist aber nicht, dass es eigenständige mathematische Entdeckungen macht.
Die wichtigsten Erkenntnisse zu Claude Fable 5.2
- Einordnung der Veröffentlichung: Am 9. November veröffentlicht. Claude Fable 5.2 nutzt dasselbe Basismodell wie Mythos und ist für allgemeine Kunden verfügbar.
- Spitzenleistung beim Programmieren: Auf FrontierSWE v2 erreicht das Modell 69,9 % und liegt damit in der offiziellen Tabelle vor 5.1 und Opus 5.5.
- Bestätigung durch Dritte: Im AA-Max-Tier erzielt es 65 Punkte und bei CursorBench Max 60,0 % – allerdings sind die Kosten pro Aufgabe deutlich höher.
- Von visueller Wahrnehmung zu Aktionen: RoboDojo Sim steigt von 27,6 % auf 64,9 %. Dabei handelt es sich jedoch um Ergebnisse in einer Simulation.
- Engineering und Forschung: Das Modell kann bei der Entwicklung elektronischer Prototypen und groß angelegter Formalisierungen mit Lean mitwirken – jeweils unter klar definierten Voraussetzungen.
- Kein uneingeschränkter Sieg: Bei AutomationBench und nach der Elo-Bewertung liegen teilweise andere Modelle vorn.
- Einstieg: Über APIYI apiyi.com lassen sich Modelle mit einer einheitlichen Schnittstelle und eigenen Aufgaben vergleichen. So können Sie entscheiden, ob sich ein Upgrade lohnt.
Zusammenfassung
Die wichtigsten Erkenntnisse zu Claude Fable 5.2:
- Deutliche Fortschritte bei schwierigen Aufgaben: Bei Bewertungen für langwierige Programmieraufgaben und visuelle Steuerung sind die Fortschritte gegenüber 5.1 groß.
- Ergebnisse differenziert betrachten: Herstellerbewertungen, unabhängige AA-Ranglisten und die eigene Umgebung von Cursor decken unterschiedliche Einsatzbereiche ab. Die Zahlen lassen sich nicht direkt miteinander vergleichen.
- Mehr Leistung hat ihren Preis: Die höhere Leistungsfähigkeit geht oft mit mehrfachen Kosten pro Aufgabe einher. Ein niedrigerer Preis pro Einheit bedeutet nicht automatisch geringere Kosten pro Aufgabe.
Wenn Sie vor allem an anspruchsvollen, langwierigen Programmieraufgaben, komplexen Engineering-Projekten oder Forschungsaufgaben arbeiten, sollten Sie die tatsächlichen Fortschritte von Fable 5.2 jetzt mit Ihrem eigenen Aufgabensatz prüfen. Für den Arbeitsalltag empfehlen sich weiterhin zunächst Alltagsmodelle wie Opus. Über APIYI apiyi.com können Sie mehrere Modelle über dieselbe Schnittstelle vergleichen und die Kosten anhand der Protokolle berechnen. Entscheiden Sie anhand der Daten statt anhand von Ranglisten, ob sich ein Upgrade lohnt.
📚 Referenzen
- Ankündigung von Anthropic: Veröffentlichungsumfang von Fable und Mythos 5.2 sowie offizielle Leistungstabelle
- Link:
anthropic.com/claude-fable-and-mythos-5-2 -
Hinweis: Primärquelle für Veröffentlichungsdatum, Geschwindigkeitsangaben und Vergleichsdaten (Selbsteinschätzung des Anbieters)
-
Modellspezifikationen von Fable 5.2: Kontext, Ausgabelimit und Denkmodus
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview -
Hinweis: Offizielle API-Dokumentation
-
Modell-Rangliste von Artificial Analysis: Intelligence Index und Kosten pro Aufgabe
- Link:
artificialanalysis.ai/leaderboards/models -
Hinweis: Dynamische Momentaufnahme einer unabhängigen Drittorganisation
-
CursorBench 4.0: Evaluation in der eigenen Umgebung von Cursor
- Link:
prod.cursor.com/evals -
Hinweis: Evaluation durch den Tool-Anbieter, keine allgemein gültige unabhängige Wiederholungsmessung
-
Studie zum elektronischen Prototypendesign mit Claude: Drei Prototypen in Zusammenarbeit mit Diode
- Link:
anthropic.com/research/claude-electronics-design -
Hinweis: Mit Daten zu PCB Gym und BenchCAD 2.1 sowie den Einschränkungen der Prototypen
-
Experiment mit einem Multi-Agent-Team in Fable 5.2: Versuchsbedingungen für die Lean-Formalisierung
- Link:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2/ -
Hinweis: Eine umfangreiche Ausführung als frühe Momentaufnahme des Anbieters
-
Leitfaden zur Auswahl eines Claude-Modells: Empfehlungen zur Verwendung von Opus und Fable
- Link:
claude.dev/blog/which-claude-model-should-you-build-with/ - Hinweis: Offizieller Entwicklerleitfaden
Autor: Technisches Team von APIYI
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI. Informationen zu Protokollfeldern und Abrechnung finden Sie im Dokumentationszentrum unter docs.apiyi.com.


