
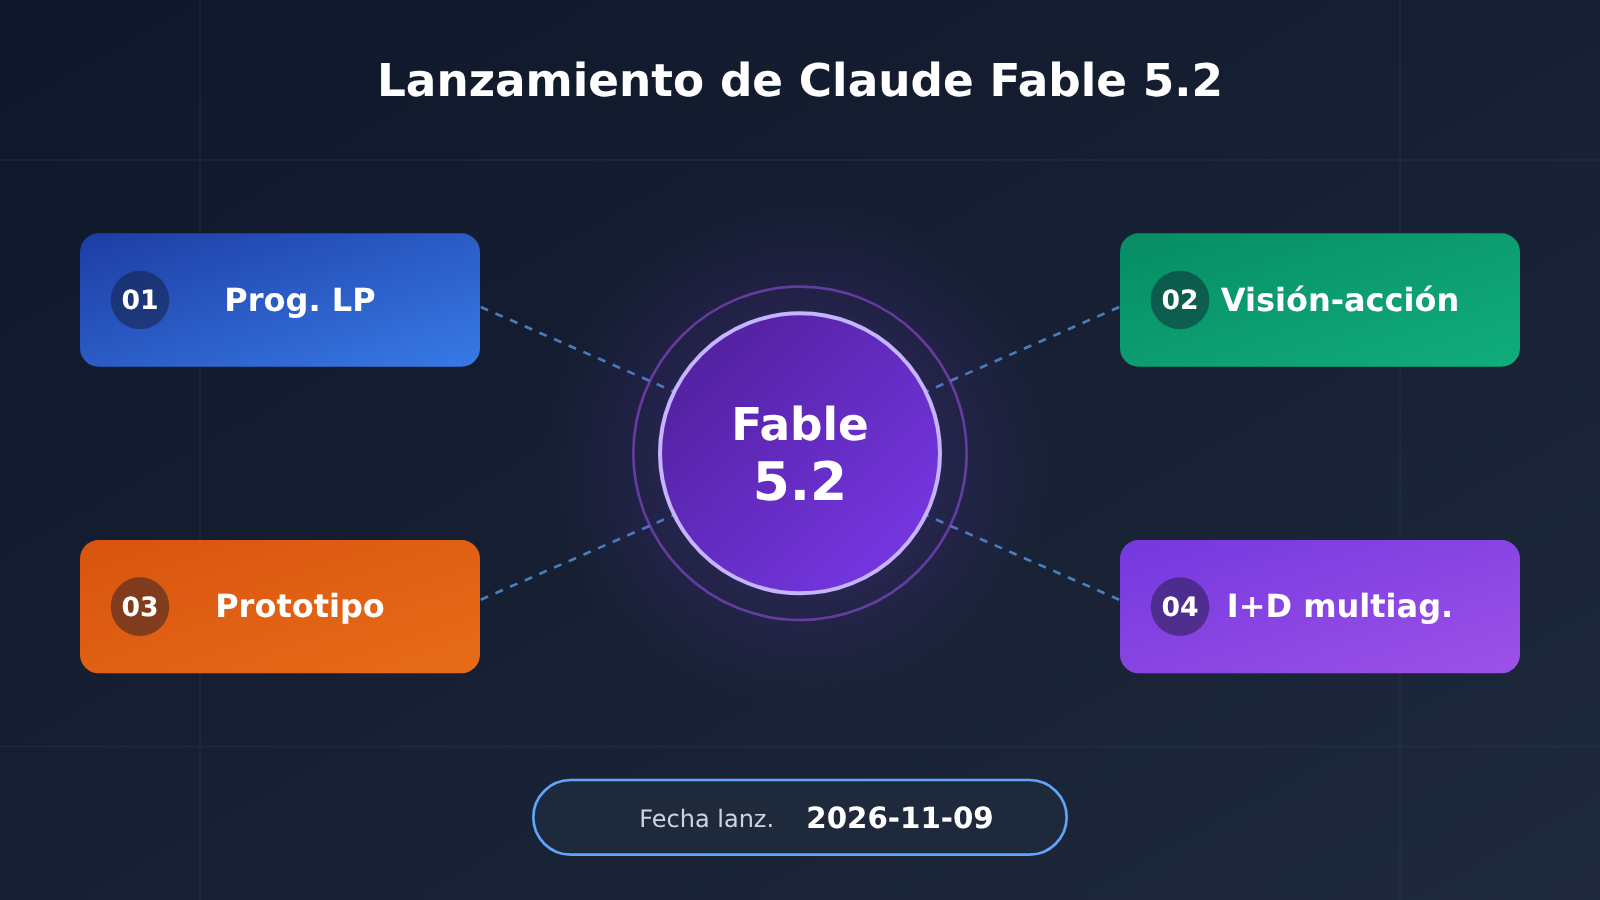
Anthropic lanzó oficialmente Claude Fable 5.2 el 9 de noviembre de 2026. Tanto la tabla oficial de capacidades como las clasificaciones de terceros indican que supera claramente a la versión 5.1 en tareas difíciles y colaboración prolongada. Además, el precio estándar de la API es un 20 % más bajo que el de la versión 5.1.
Valor principal: Este artículo va «primero a las conclusiones, después a las pruebas y, por último, a los límites» para ayudarte a determinar en qué destaca Claude Fable 5.2, hasta qué punto y si tus tareas justifican cambiar ahora.
Guía rápida de términos para entender las evaluaciones de Claude Fable 5.2
A continuación aparecerán repetidamente algunos criterios de evaluación. Si se interpretan mal, es fácil confundir una demostración del proveedor con una verificación independiente, o tomar una puntuación parcial por una tasa de aprobación.
- Agent: sistema basado en un modelo que puede usar herramientas y ejecutar tareas de varios pasos de forma continua.
- Intelligence Index: índice de capacidad global de Artificial Analysis (AA). Es una puntuación compuesta, no una tasa de aciertos.
- OSWorld partial: criterio de puntuación que considera el grado de finalización de las tareas en una evaluación de operaciones de escritorio. No equivale a una tasa de aprobación estricta para tareas completas.
- RoboDojo Sim: evaluación del control en un entorno de robótica simulado; no representa la tasa de éxito de robots reales.
- PCB: placa de circuito impreso que sirve para alojar e interconectar componentes electrónicos.
- Lean / demostración formal: Lean es un lenguaje y una herramienta que permiten que una computadora compruebe demostraciones. Una demostración formal consiste en expresar un razonamiento matemático como una serie de pasos rigurosos que una máquina puede verificar.
- Colaboración multiagente: varios ejemplares de un modelo se reparten el trabajo, se comunican entre sí y, por último, reúnen los resultados.
¿Qué tan potente es Claude Fable 5.2? Primero, las conclusiones; después, el contexto de su lanzamiento
En una frase: Claude Fable 5.2 mejora notablemente en programación difícil, tareas de larga duración y evaluaciones de visión a acción, pero no se puede resumir diciendo que es “el número uno en todas las tareas”. En algunas evaluaciones automatizadas y puntuaciones de preferencia, sigue por detrás de otros modelos.
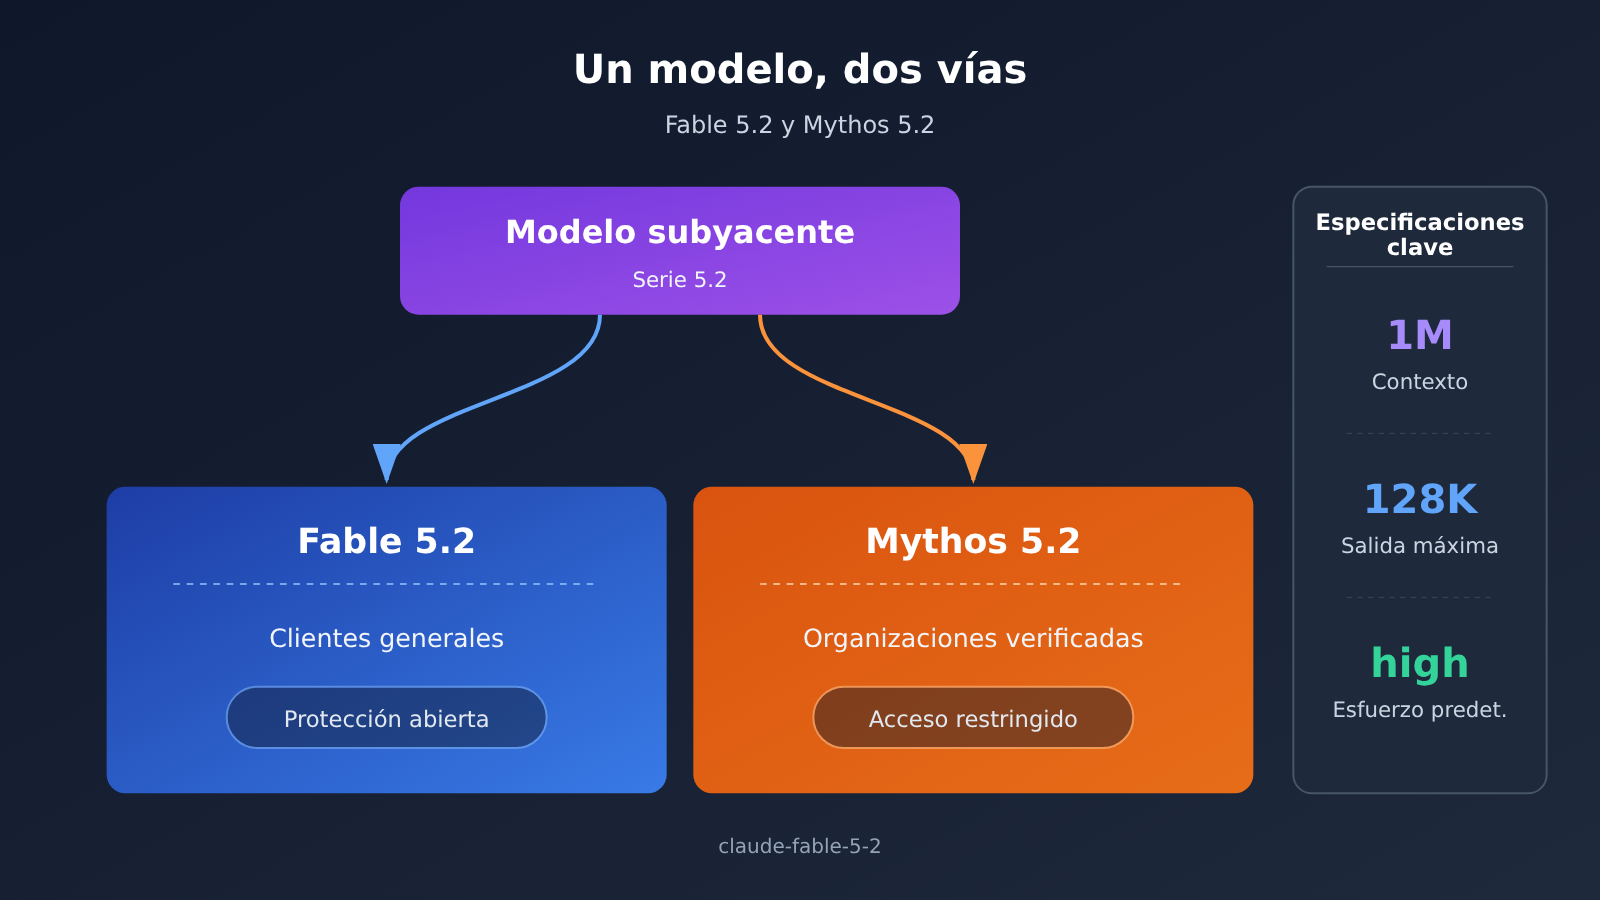
Primero, conviene aclarar el contexto del lanzamiento. Según la información oficial, Fable y Mythos utilizan el mismo modelo base. Las protecciones de ciberseguridad y bioseguridad de Fable permiten que esté disponible para clientes generales, mientras que Mythos solo se ofrece a organizaciones verificadas. Por eso, no se pueden atribuir directamente a Fable las capacidades o puntuaciones exclusivas de Mythos.
Datos clave de Claude Fable 5.2 de un vistazo
| Información | Detalles | Tipo de fuente |
|---|---|---|
| Fecha de lanzamiento | 9 de noviembre de 2026 | Anuncio oficial |
| ID del modelo de API | claude-fable-5-2 |
Documentación oficial del modelo |
| Contexto / salida máxima | 1M tokens / 128K tokens | Documentación oficial del modelo |
| Modalidades de entrada y salida | Entrada de texto e imágenes; salida de texto | Documentación oficial del modelo |
| Modo de razonamiento | El razonamiento adaptativo está siempre activado; el valor predeterminado de effort en la API es high |
Documentación oficial del modelo |
| Fecha de corte del conocimiento | Junio de 2026 (no equivale a tener acceso a Internet en tiempo real) | Documentación oficial del modelo |
| Precio estándar | 8 USD por millón de tokens de entrada y 40 USD por millón de tokens de salida; un 20 % menos que 5.1 en ambos casos | Página oficial de precios |
| Velocidad | La generación de salida es «hasta un 30 % más rápida» que en 5.1 | Límite superior según el fabricante |
Hay dos aspectos que se pueden malinterpretar fácilmente. Primero, «hasta un 30 % más rápida» es el límite superior de velocidad de salida indicado por el fabricante, no significa que todos los tipos de tareas tarden un 30 % menos. Segundo, el precio estándar de Fable 5.2 sigue siendo el doble que el de Opus 5.5 (4/20 USD).
La recomendación oficial también es clara: para la mayoría de las tareas cotidianas de programación y trabajo con conocimiento, conviene empezar con Opus 5.5 y pasar a Fable cuando la tarea sea compleja.
Evidencias de las mejoras de Claude Fable 5.2 en programación y tareas de larga duración
La programación es el eje central de este lanzamiento. Primero, veamos los datos publicados por el fabricante y, después, dos conjuntos de resultados de terceros obtenidos en entornos distintos.
Tabla oficial de capacidades: Fable 5.2 frente a 5.1 y Opus 5.5
| Evaluación (datos publicados por el fabricante) | Fable 5.2 | Fable 5.1 | Opus 5.5 | Descripción |
|---|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | — | La configuración de effort es distinta en ambos casos |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% | Tareas de ingeniería de software de larga duración |
| AutomationBench | 51.4% | 31.4% | 42.5% | Tareas de automatización |
| OSWorld 2.1, subconjunto offline parcial | 89.3% | 83.5% | 87.2% | Criterio de puntuación parcial |
| RoboDojo Sim | 64.9% | 27.6% | 39.4% | Control de robots en simulación |
La tabla confirma que Fable 5.2 supera a la versión 5.1 por 13.6 puntos porcentuales en FrontierSWE v2 y también queda por encima de Opus 5.5. El aumento en FrontierCode 2.0 es mayor, pero los valores de ambas versiones se obtuvieron con distintos niveles de effort, así que parte de la mejora podría deberse al nivel de razonamiento.
Datos de terceros: resultados de Claude Fable 5.2 en AA y Cursor
| Entorno de evaluación | Configuración | Puntuación | Costo por tarea (USD) |
|---|---|---|---|
| Artificial Analysis | Fable 5.2 medium | 56 | 3.80 |
| Artificial Analysis | Fable 5.2 high | 62 | 9.08 |
| Artificial Analysis | Fable 5.2 xhigh | 62 | 14.83 |
| Artificial Analysis | Fable 5.2 max | 65 | 26.54 |
| Artificial Analysis | Opus 5.5 max | 59 | 10.04 |
| CursorBench 4.0 | Fable 5.2 High | 56.9% | 9.70 |
| CursorBench 4.0 | Fable 5.2 Max | 60.0% | 32.79 |
| CursorBench 4.0 | Opus 5.5 High | 56.0% | 3.97 |
AA es una entidad de evaluación independiente. En su Intelligence Index, Fable 5.2 max obtiene 65 puntos, por encima de los 59 de Opus 5.5 max, en la misma línea que la tabla oficial.
Los datos de Cursor proceden de sus propias tareas y herramientas. Fable 5.2 Max alcanza el 60.0%, pero en el nivel High la diferencia frente a Opus 5.5 High es de solo 0.9 puntos porcentuales.
Ambos conjuntos de datos de terceros muestran que un mayor rendimiento suele ir acompañado de un mayor costo por tarea. En AA, pasar de high a max suma 3 puntos y hace que el costo por tarea sea aproximadamente 2.92 veces mayor.
🎯 Recomendación técnica: las clasificaciones sirven para acotar las opciones, pero la decisión final debe basarse en tus propias tareas. Te recomendamos usar APIYI, apiyi.com, con una misma interfaz compatible con OpenAI para comparar Opus, Fable y otros modelos con las mismas indicaciones y criterios de aceptación. Después, registra la calidad y el costo de cada nivel.
Hasta dónde han llegado las capacidades visuales y de ingeniería de Claude Fable 5.2
De entender lo que aparece en pantalla a controlar acciones
En el ámbito visual, los dos resultados más destacados son OSWorld 2.1 y RoboDojo Sim. En el subconjunto sin conexión de OSWorld 2.1, la puntuación parcial subió del 83,5 % al 89,3 %. Sin embargo, Opus 5.5 ya alcanza el 87,2 %, así que la diferencia no es muy grande.
El cambio en RoboDojo Sim es más notable: la puntuación pasó del 27,6 % al 64,9 %. Esto indica una mejora clara en la capacidad del modelo para convertir la comprensión visual en acciones de control continuas.
Fable 5.2 participa en el diseño de prototipos electrónicos
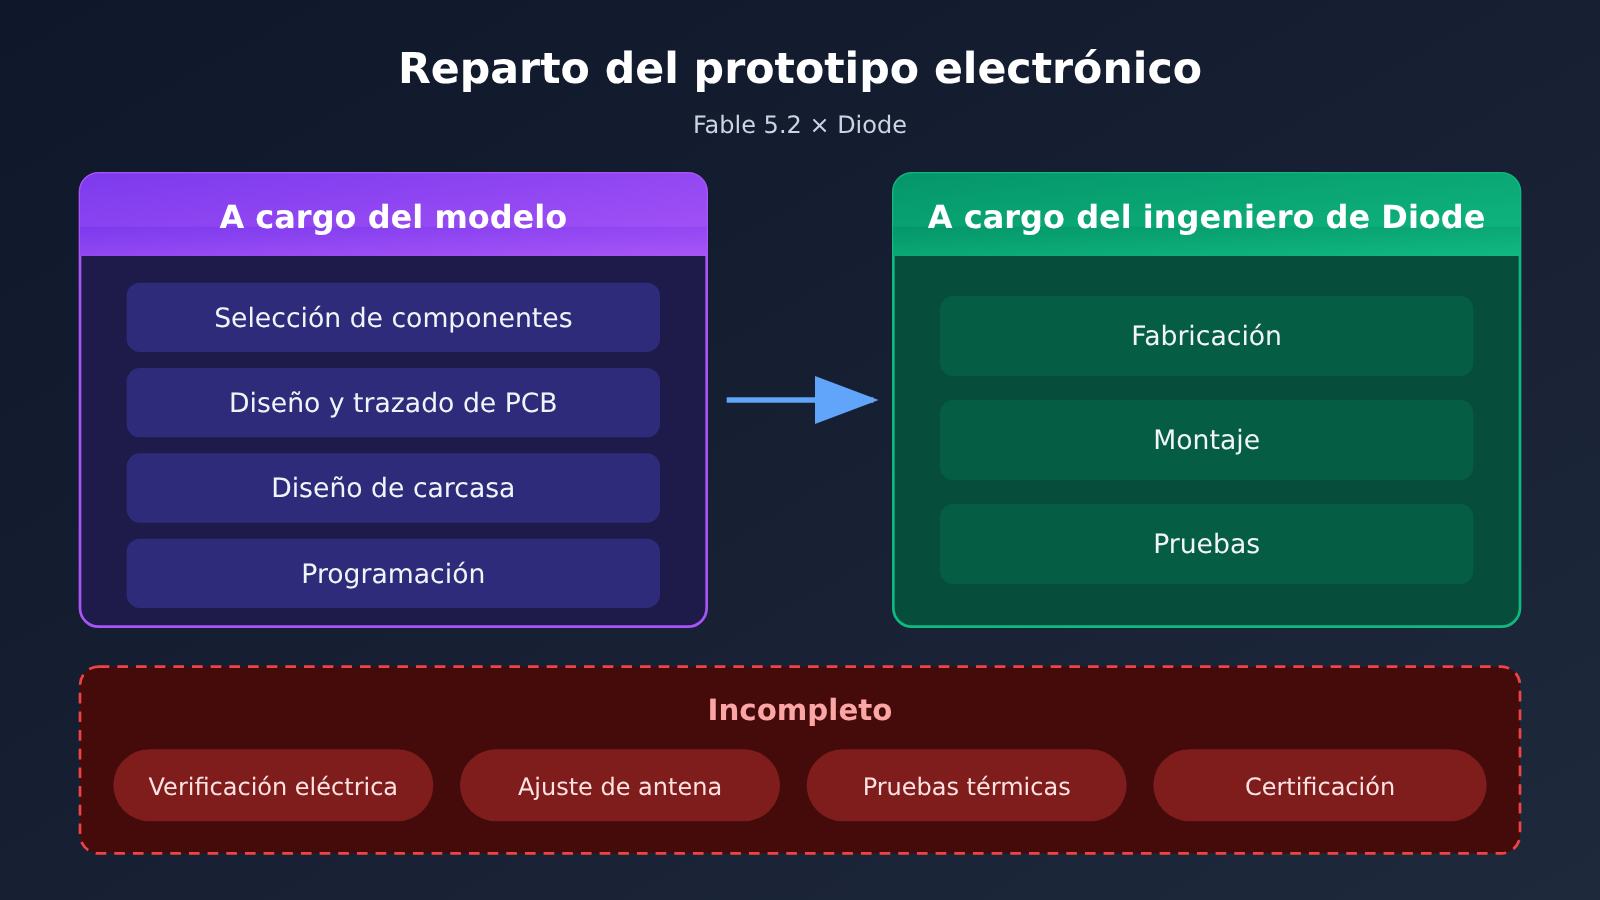
Anthropic y Diode colaboraron en la creación de tres prototipos de dispositivos electrónicos: un asistente de voz, un altavoz con micrófono USB y una mascota virtual. El modelo participó en la selección de componentes, el diseño y el trazado de la PCB, el diseño de la carcasa y la programación. Los ingenieros de Diode se encargaron de la fabricación, el montaje y las pruebas. Como existe una relación comercial entre ambas partes, conviene tenerlo en cuenta al evaluar este caso.
Los límites del proyecto están claros. Los tres dispositivos son prototipos y no han completado la validación eléctrica, el ajuste de antenas, las pruebas térmicas ni la certificación. Tampoco se diseñaron para cumplir los requisitos de producción en serie. El modelo no se conectó a equipos de fábrica ni a instrumentos de prueba. Por eso, la forma precisa de describir el caso es decir que «el modelo puede participar de forma profunda en el diseño de prototipos electrónicos», no que «el modelo fabricó por sí solo un producto listo para la producción en serie».
El mismo documento de investigación incluye otros dos resultados relacionados con el diseño. El primero corresponde a PCB Gym, una evaluación interna realizada por Diode: Fable 5.2 obtuvo un 69 %, frente al 25 % de Fable 5, no de la versión 5.1. El segundo es el benchmark público BenchCAD 2.1, que evalúa la reconstrucción de piezas 3D, ensamblajes y placas de circuito a partir de planos de ingeniería e imágenes renderizadas. Según el proveedor, Fable 5.2 obtuvo un 83,5 %. El benchmark es público, pero una verificación independiente todavía no ha confirmado esta puntuación.
Por qué llaman la atención los casos de investigación científica y multiagente de Claude Fable 5.2
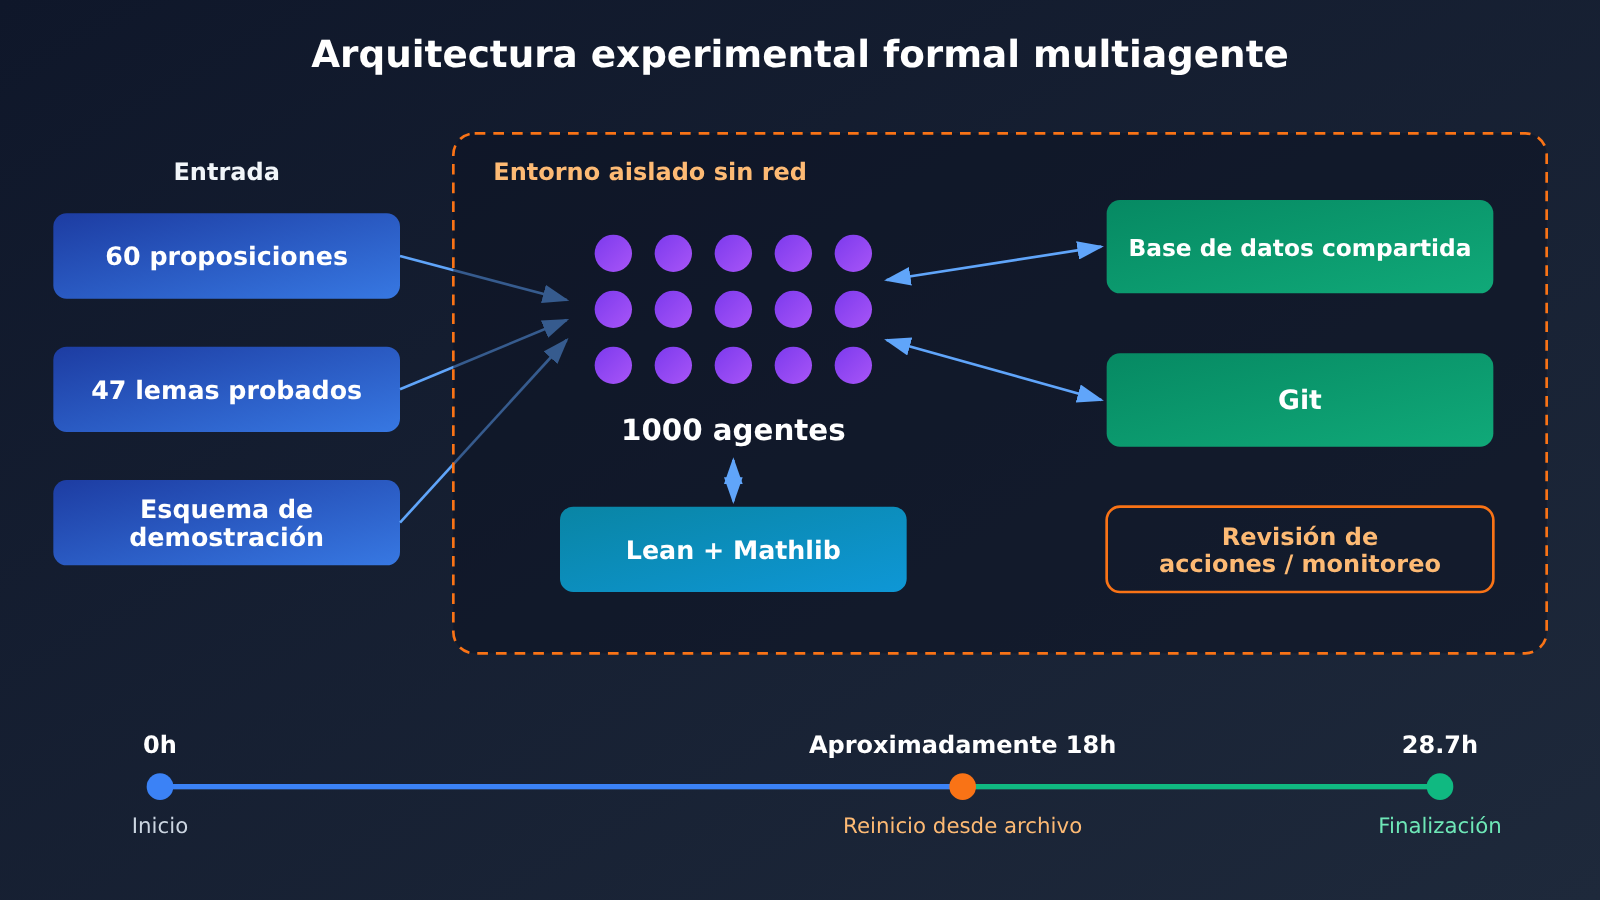
El experimento de formalización matemática es el caso que más interés ha despertado. Según el blog oficial para desarrolladores, 1000 agentes de Fable 5.2 en una versión preliminar reprodujeron en Lean, en 28,7 horas, la demostración formal del último teorema de Fermat.
El valor de este caso está en la capacidad de organizar tareas a gran escala y durante largos periodos, no en un nuevo descubrimiento matemático.
Es importante explicar todas las condiciones del experimento:
- La entrada estaba definida de antemano: 60 proposiciones y definiciones, un esquema de una sola frase con la estrategia clásica de demostración y 47 lemas que ya se habían demostrado.
- Herramientas y entorno: Lean, Mathlib, Git, una base de datos compartida y un entorno aislado sin conexión a Internet, con comprobación de acciones y supervisión sin conexión.
- Proceso de ejecución: los agentes se reiniciaron desde un estado guardado al cabo de unas 18 horas y continuaron durante otras 12.
- Descripción de los autores: los propios autores lo calificaron de toy experiment y señalaron que una infraestructura de ejecución especializada y la orientación humana podrían aumentar aún más la eficiencia.
Por tanto, se trata de la formalización de una demostración matemática existente.
Incluso con estas limitaciones, el caso apunta a una línea de desarrollo prometedora: varias instancias de modelos pueden repartirse el trabajo, enviar cambios y revisarlos desde un estado compartido para avanzar de forma sostenida en una tarea muy larga. Esta capacidad también puede ser útil en trabajos de ingeniería como migraciones de código a gran escala o refactorizaciones complejas de sistemas.
En qué aspectos Claude Fable 5.2 no sale claramente vencedor
Un análisis responsable de las capacidades también debe incluir contraejemplos. En la misma tabla del anuncio oficial hay dos resultados en los que Fable 5.2 no lleva ventaja.
| Evaluación | Fable 5.2 | Modelo de comparación | Nota |
|---|---|---|---|
| AutomationBench | 51.4% | Gemini 4 Carbon 53.9% | El competidor obtiene una puntuación más alta |
| AA-Briefcase (rúbrica) | 66.1% | Opus 5.5 61.2% | Fable obtiene una puntuación más alta según la rúbrica |
| AA-Briefcase (Elo) | 1785 | Opus 5.5 1800 | Opus queda por delante según las preferencias en los enfrentamientos |
La fila de AA-Briefcase es la más representativa. En la misma tarea, Fable queda por delante cuando se puntúa según la rúbrica, mientras que Opus gana cuando se tienen en cuenta las preferencias en los enfrentamientos mediante Elo. Si cambia el criterio de evaluación, la clasificación puede invertirse, así que no es fiable proclamar que un modelo es «el mejor en todo» basándose en uno o dos rankings.
Otro inconveniente es el coste. En el entorno de Cursor, Fable 5.2 Max cuesta 32.79 dólares por tarea, frente a los 3.97 dólares por tarea de Opus 5.5 High: unas 8 veces más, para una diferencia de 4 puntos porcentuales. Un pequeño experimento de Lex Toumbourou, desarrollador independiente, también mostró que 5.2 high alcanza una precisión mayor que 5.1, pero tanto el volumen de salida como el coste por turno se duplican aproximadamente.
Además, las puntuaciones específicas de Mythos en seguridad y biología no deberían considerarse capacidades del Fable estándar.
Qué usuarios deberían probar Claude Fable 5.2 ahora
Según la guía oficial para elegir modelos y los datos anteriores, podemos hacer una clasificación aproximada:
- Vale la pena probarlo primero: tareas de programación complejas y de larga duración, diseño de ingeniería complejo e investigación que requiera varias llamadas a herramientas. Puedes validar si realmente ofrece una mejora con tu propio conjunto de tareas.
- Empieza con un modelo para el uso diario: para preguntas de conocimiento general y tareas de programación habituales, sigue la recomendación oficial y empieza con modelos de uso diario como Opus 5.5. Actualiza a otro modelo solo si encuentras limitaciones.
Cinco aspectos que conviene evaluar antes de probar Claude Fable 5.2
| Aspecto | Qué debes confirmar | Qué hacer |
|---|---|---|
| Disponibilidad | Si el modelo ya está disponible en la plataforma que usas y cuáles son su ID y su endpoint | Consulta la lista de modelos de la plataforma ese mismo día; no des por hecho que ya está disponible |
| Datos | Si las condiciones de la tarea permiten enviar los datos a un modelo de terceros | Revisa las condiciones de conservación de datos y los requisitos de cumplimiento de tu empresa |
| Criterios de aceptación | Qué se considera una tarea completada | Prepara de antemano casos de prueba o criterios de puntuación |
| Tiempo | Si importa el tiempo de espera | Registra también el tiempo total de principio a fin, no solo la velocidad de generación |
| Presupuesto | Cuál es el coste máximo por tarea completada | Registra los tokens y las tareas completadas para cada nivel, y calcula el coste por éxito |
Pruebas comparativas de Claude Fable 5.2 con una interfaz unificada
Este ejemplo mínimo usa una interfaz compatible con OpenAI para invocar el modelo. Solo tienes que cambiar MODEL por un ID que aparezca en la lista de modelos disponible en la plataforma para comparar distintos modelos sin modificar el código.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz de APIYI compatible con OpenAI
)

MODEL = "your-model-id"  # Consulta la lista de modelos disponible en la plataforma ese día
resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "为下面的函数补充单元测试:..."}]
)
print(resp.choices[0].message.content, resp.usage)
Ver el código para comparar varios modelos y registrar el uso
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Consulta la lista de modelos disponible en la plataforma ese día para obtener los ID candidatos
CANDIDATES = ["daily-model-id", "candidate-model-id"]

def run_task(model: str, prompt: str, check) -> dict:
    """Ejecuta una tarea y registra el tiempo, los tokens y el resultado de la validación."""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    text = resp.choices[0].message.content
    return {
        "model": model,
        "seconds": round(time.time() - start, 2),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "passed": bool(check(text)),  # Usa tu propia función de validación
    }

def check(text: str) -> bool:
    return "def test_" in text

tasks = ["为 parse_date 函数补充单元测试:..."]
results = [run_task(m, t, check) for m in CANDIDATES for t in tasks]
for r in results:
    print(r)
Una vez terminada la comparación, también conviene revisar la factura real. La documentación de registros de APIYI incluye campos como model_name, prompt_tokens, completion_tokens, quota y request_id. El valor de quota dividido entre 500000 corresponde al cargo en dólares, así que puedes comparar los gastos de cada tarea antes y después de la actualización. Ten en cuenta que el importe calculado según las tarifas oficiales es solo una estimación: prevalecen los registros reales de la plataforma.
🚀 Inicio rápido: puedes registrarte en APIYI, en apiyi.com, y obtener crédito gratuito de prueba para nuevos usuarios. Empieza probando entre 10 y 20 tareas reales para validar el proceso de comparación antes de ampliar el tráfico a nivel Fable. Consulta la información publicada por la plataforma ese día para saber si el nuevo modelo ya está disponible y cuál es su precio.
Preguntas frecuentes
Q1: ¿Qué es Claude Fable 5.2? ¿Qué relación tiene con Mythos 5.2?
Fable 5.2 es un modelo que Anthropic publicó el 9 de noviembre de 2026. Su ID de API es `claude-fable-5-2` y admite una ventana de contexto de 1M. Comparte el mismo modelo base que Mythos 5.2; la diferencia es que las protecciones de seguridad de Fable permiten ofrecerlo a clientes en general, mientras que Mythos solo está disponible para organizaciones verificadas.
Q2: ¿Cuánto supera Claude Fable 5.2 a Opus 5.5?
En la tabla oficial, los resultados de FrontierSWE v2 son del 69,9 % frente al 62,3 %. En el índice AA, en el nivel max, obtiene 65 frente a 59. En el nivel High de CursorBench 4.0, la diferencia es de solo 0,9 puntos porcentuales. En general, Fable 5.2 tiene un techo de capacidad más alto, pero su precio por unidad es el doble que el de Opus 5.5, y la diferencia de coste por tarea puede ser aún mayor en los niveles más altos.
Q3: ¿Claude Fable 5.2 ocupa el primer puesto en todas las tareas?
No. En AutomationBench, Gemini 4 Carbon obtiene un 53,9 %, por encima del 51,4 % de Fable 5.2. En AA-Briefcase, Opus 5.5 ocupa un puesto más alto según la puntuación Elo. Los rankings pueden variar según el método de evaluación.
Q4: ¿Usar Fable 5.2 siempre cuesta menos que usar 5.1?
No necesariamente. La reducción del 20 % en el precio por unidad solo supone un ahorro del 20 % si el uso se mantiene igual. Supongamos que una tarea tiene 100.000 tokens de entrada y 20.000 de salida: con 5.2 cuesta 1,60 dólares y con 5.1, 2 dólares. Pero si la salida aumenta a 40.000 tokens, el coste de 5.2 será de 2,40 dólares, es decir, más. Este ejemplo solo sirve para ilustrar la relación entre las variables; no predice que el modelo vaya a generar más contenido. Te recomendamos revisar los registros de invocaciones de APIYI, en apiyi.com, para comprobar el consumo real de tokens de cada tarea.
Q5: ¿Cómo puedo comparar rápidamente Claude Fable 5.2 con otros modelos mediante la API?
1. Regístrate en APIYI, en apiyi.com, para obtener una clave API y crédito gratuito para pruebas.
2. Comprueba qué ID están disponibles en la lista de modelos de la plataforma ese día.
3. Usa el código de este artículo, configura `base_url` como `https://api.apiyi.com/v1` y ejecuta las mismas tareas con cada modelo.
4. Registra el número de ejecuciones satisfactorias, el tiempo y los tokens; luego calcula el coste por tarea completada con éxito.
Q6: ¿El experimento sobre el último teorema de Fermat demuestra que Fable 5.2 puede hacer matemáticas originales?
No. El experimento proporcionó 60 proposiciones, 47 lemas demostrados y un esquema de prueba. En un entorno aislado sin conexión, se ejecutaron 1.000 agentes basados en versiones preliminares durante 28,7 horas. Lo que hizo fue formalizar pruebas existentes, y además solo se realizó una ejecución. El experimento permite evaluar la capacidad de organización a largo plazo, pero no demuestra que el modelo pueda hacer descubrimientos matemáticos originales.
Puntos clave de Claude Fable 5.2
- Presentación: se lanzó el 9 de noviembre. Utiliza el mismo modelo base que Mythos y está disponible para clientes generales.
- Máximo en programación: obtuvo un 69,9 % en FrontierSWE v2, por encima de 5.1 y Opus 5.5 en la tabla oficial.
- Validación externa: alcanzó 65 puntos en el nivel AA Max y un 60,0 % en CursorBench Max, aunque el coste por tarea es considerablemente mayor.
- De la visión a la acción: RoboDojo Sim pasó del 27,6 % al 64,9 %, pero estas cifras corresponden a simulaciones.
- Ingeniería e investigación: puede participar en el diseño de prototipos electrónicos y en la formalización Lean a gran escala, aunque en ambos casos hay condiciones claras.
- No gana en todo: otros modelos lideran en AutomationBench y en las clasificaciones basadas en Elo.
- Cómo probarlo: puedes comparar modelos con tus propias tareas mediante la interfaz unificada de APIYI, en apiyi.com, antes de decidir si actualizas.
Resumen
Puntos clave de Claude Fable 5.2:
- Mejoras claras en tareas difíciles: ha avanzado mucho respecto a 5.1 en evaluaciones de programación de larga duración y control visual.
- Las pruebas deben evaluarse por separado: las autoevaluaciones del proveedor, las clasificaciones independientes de AA y el entorno propio de Cursor sirven para propósitos distintos. No conviene mezclar sus cifras.
- Un mayor rendimiento tiene un coste: las capacidades máximas suelen implicar varias veces más coste por tarea. Que baje el precio por unidad no significa que también baje el coste de completar una tarea.
Si tu trabajo se centra en programación compleja y de larga duración, ingeniería avanzada o investigación, merece la pena comprobar desde ahora cómo rinde Fable 5.2 con tu propio conjunto de tareas. Para el trabajo cotidiano, sigue siendo recomendable empezar con modelos de uso diario, como Opus. Puedes comparar varios modelos desde una misma interfaz con APIYI, en apiyi.com, y calcular los costes a partir de los registros. Así podrás decidir si actualizar basándote en datos y no solo en clasificaciones.
📚 Referencias
- Anuncio de Anthropic: alcance del lanzamiento de Fable y Mythos 5.2, y tabla oficial de capacidades
- Enlace:
anthropic.com/claude-fable-and-mythos-5-2 -
Nota: fuente primaria sobre la fecha de lanzamiento, los datos de velocidad y las comparaciones (evaluación del propio proveedor)
-
Especificaciones del modelo Fable 5.2: contexto, límite de salida y modo de razonamiento
- Enlace:
platform.claude.com/docs/en/models/fable-5-2/overview -
Nota: documentación oficial de la API
-
Clasificación de modelos de Artificial Analysis: Intelligence Index y costo por tarea
- Enlace:
artificialanalysis.ai/leaderboards/models -
Nota: instantánea dinámica de una entidad externa
-
CursorBench 4.0: evaluación en el entorno propio de Cursor
- Enlace:
prod.cursor.com/evals -
Nota: evaluación del proveedor de la herramienta, no una repetición independiente de propósito general
-
Investigación sobre diseño electrónico con Claude: tres prototipos desarrollados en colaboración con Diode
- Enlace:
anthropic.com/research/claude-electronics-design -
Nota: incluye datos de PCB Gym y BenchCAD 2.1, así como las limitaciones de los prototipos
-
Experimento con equipos multiagente de Fable 5.2: condiciones del experimento de formalización con Lean
- Enlace:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2/ -
Nota: una ejecución a gran escala en una primera instantánea del proveedor
-
Guía para elegir un modelo de Claude: recomendaciones de uso de Opus y Fable
- Enlace:
claude.dev/blog/which-claude-model-should-you-build-with/ - Nota: guía oficial para desarrolladores
Autor: equipo técnico de APIYI
Intercambio técnico: Puedes contactarnos desde la página principal del sitio web de APIYI. Consulta la documentación sobre campos de registro y facturación en el centro de documentación dedocs.apiyi.com.


