
Anthropic resmi merilis Claude Fable 5.2 pada 9 November 2026. Tabel kemampuan resmi dan peringkat pihak ketiga sama-sama menunjukkan bahwa model ini jauh lebih unggul daripada 5.1 dalam tugas sulit dan kolaborasi jangka panjang. Harga standar API-nya juga 20% lebih rendah dibandingkan 5.1.
Nilai utama: Artikel ini disusun dengan urutan “kesimpulan dulu, lalu bukti, kemudian batasan” untuk membantu Anda menilai keunggulan Claude Fable 5.2, seberapa besar peningkatannya, dan apakah tugas Anda layak dialihkan ke model ini sekarang.
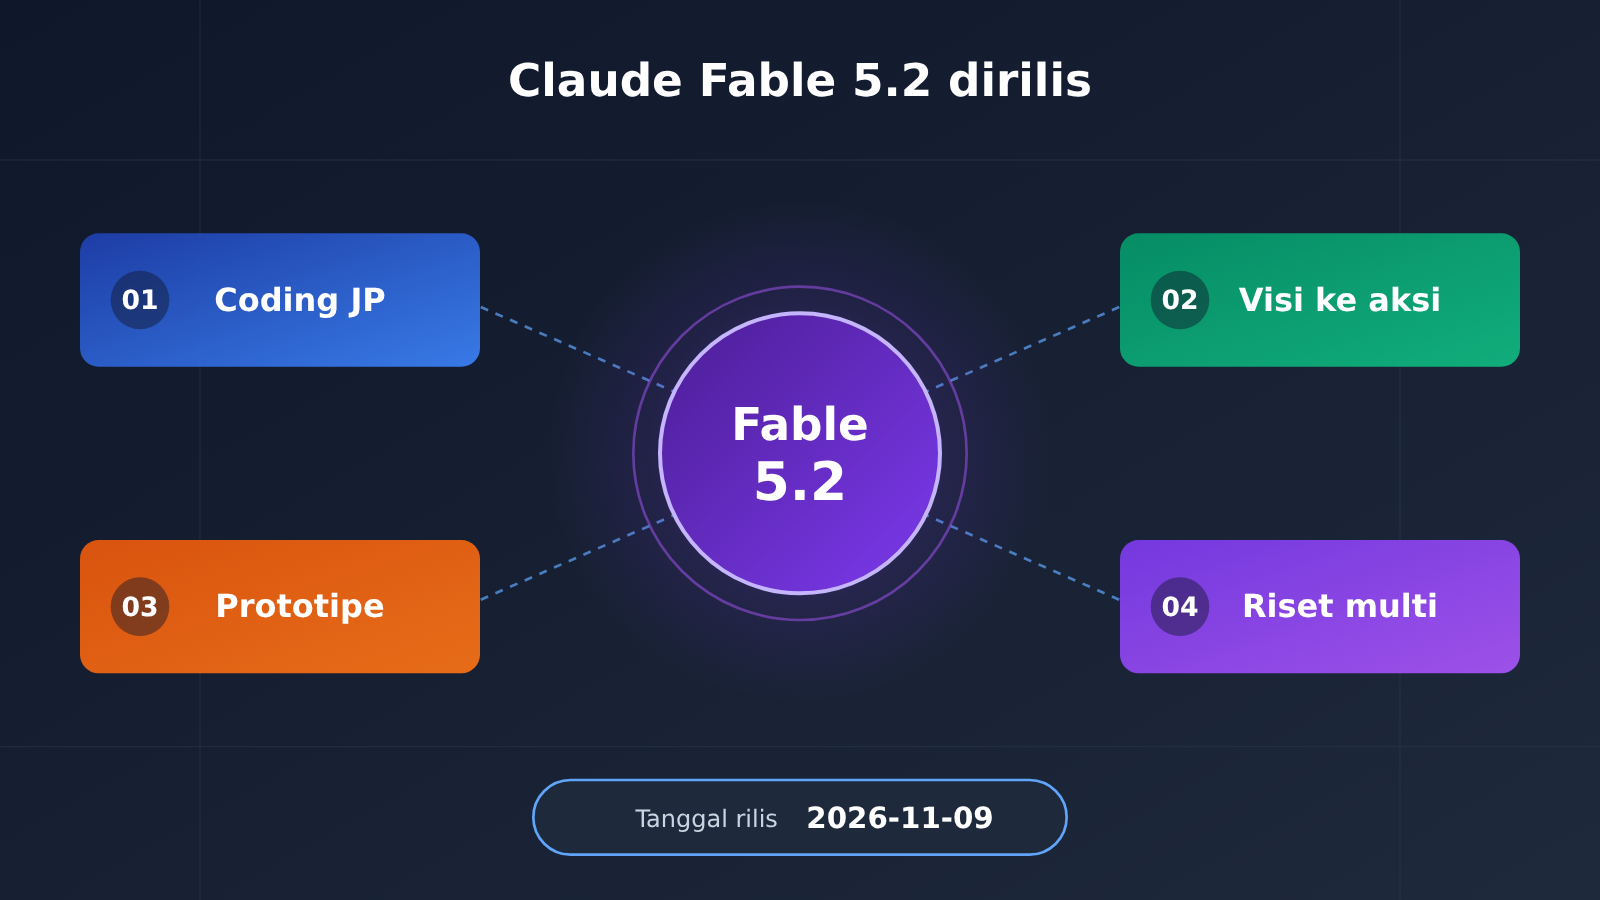
Istilah yang perlu diketahui sebelum membaca evaluasi Claude Fable 5.2
Istilah evaluasi tertentu akan sering muncul di bawah ini. Jika salah memahaminya, Anda bisa mengira demo dari vendor sebagai verifikasi independen, atau menganggap skor parsial sebagai tingkat kelulusan.
- Agen: Sistem model yang dapat menggunakan alat dan menjalankan tugas bertahap secara berkelanjutan.
- Intelligence Index: Indeks kemampuan komposit dari Artificial Analysis (AA). Ini adalah skor gabungan, bukan tingkat akurasi.
- OSWorld partial: Metode penilaian evaluasi penggunaan desktop yang memberikan skor berdasarkan tingkat penyelesaian sebagian; ini tidak sama dengan tingkat kelulusan ketat untuk seluruh soal.
- RoboDojo Sim: Evaluasi kontrol di lingkungan robot simulasi, bukan tingkat keberhasilan robot di dunia nyata.
- PCB: Papan sirkuit cetak, yang digunakan untuk menampung dan menghubungkan komponen elektronik.
- Lean / pembuktian formal: Lean adalah bahasa dan alat yang memungkinkan komputer memeriksa bukti. Pembuktian formal berarti mengubah penalaran matematika menjadi langkah-langkah ketat yang dapat diverifikasi komputer satu per satu.
- Kolaborasi multiagen: Beberapa instans model membagi tugas, berkomunikasi satu sama lain, lalu merangkum hasilnya.
Claude Fable 5.2 sekuat apa: kesimpulan dulu, lalu latar belakang peluncurannya
Kesimpulan singkat: Claude Fable 5.2 menunjukkan peningkatan signifikan dalam pemrograman sulit, tugas jangka panjang, dan evaluasi visual-ke-aksi, tetapi tidak tepat jika disimpulkan sebagai “yang terbaik di semua tugas”. Dalam beberapa evaluasi otomatis dan penilaian preferensi, performanya masih tertinggal dari model lain.
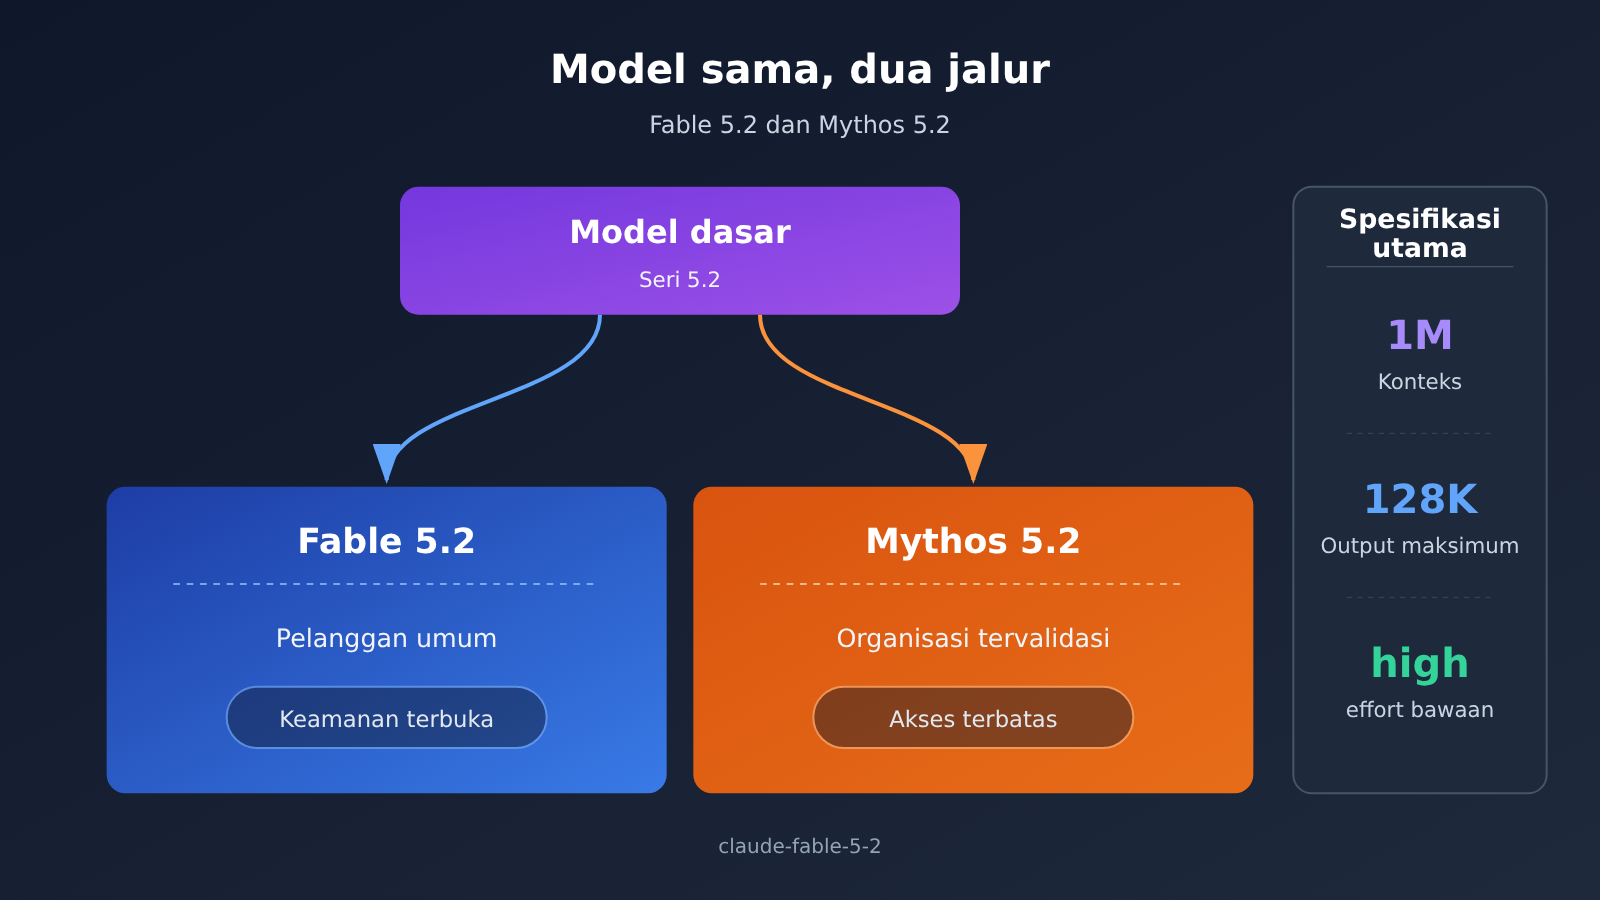
Sebelum membahas lebih jauh, ada baiknya menjelaskan latar belakang peluncurannya. Menurut keterangan resmi, Fable dan Mythos menggunakan model dasar yang sama. Perlindungan keamanan siber dan biosafety pada Fable memungkinkan model ini tersedia bagi pelanggan umum, sedangkan Mythos hanya ditujukan untuk organisasi yang telah terverifikasi. Karena itu, kemampuan atau skor khusus Mythos tidak bisa langsung dianggap sebagai kemampuan Fable biasa.
Ringkasan informasi utama Claude Fable 5.2
| Informasi | Detail | Jenis sumber |
|---|---|---|
| Tanggal rilis | 9 November 2026 | Pengumuman resmi |
| ID model API | claude-fable-5-2 |
Dokumentasi model resmi |
| Konteks / output maksimum | 1M token / 128K token | Dokumentasi model resmi |
| Modalitas input dan output | Input teks dan gambar, output teks | Dokumentasi model resmi |
| Mode berpikir | Adaptive thinking selalu aktif, effort default API adalah high | Dokumentasi model resmi |
| Batas pengetahuan | Juni 2026 (bukan berarti memiliki kemampuan akses internet secara real-time) | Dokumentasi model resmi |
| Harga standar | Input 8, output 40 dolar per juta token; masing-masing turun 20% dibandingkan 5.1 | Halaman harga resmi |
| Kecepatan | “Hingga 30% lebih cepat” dalam menghasilkan output dibandingkan 5.1 | Klaim maksimum dari vendor |
Ada dua hal yang mudah disalahartikan. Pertama, “hingga 30% lebih cepat” adalah batas atas kecepatan output menurut vendor, bukan berarti waktu pengerjaan setiap tugas bisa dipangkas 30%. Kedua, harga standar Fable 5.2 masih dua kali lipat harga Opus 5.5 (4/20 dolar).
Pihak resmi juga menyarankan agar Opus 5.5 digunakan terlebih dahulu untuk sebagian besar pekerjaan coding dan pengetahuan sehari-hari, lalu beralih ke Fable untuk tugas yang kompleks.
Bukti Peningkatan Claude Fable 5.2 untuk Pemrograman dan Tugas Jangka Panjang
Pemrograman menjadi fokus utama dalam rilis kali ini. Mari lihat data yang diumumkan vendor, lalu dua kelompok data pihak ketiga dari lingkungan pengujian yang berbeda.
Tabel kemampuan resmi: Fable 5.2 dibandingkan dengan 5.1 dan Opus 5.5
| Evaluasi (diungkapkan vendor) | Fable 5.2 | Fable 5.1 | Opus 5.5 | Keterangan |
|---|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | — | Pengaturan effort kedua model berbeda |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% | Tugas rekayasa perangkat lunak jangka panjang |
| AutomationBench | 51.4% | 31.4% | 42.5% | Tugas otomasi |
| OSWorld 2.1, subset offline partial | 89.3% | 83.5% | 87.2% | Menggunakan metode penghitungan skor parsial |
| RoboDojo Sim | 64.9% | 27.6% | 39.4% | Kontrol robot dalam simulasi |
Tabel ini menunjukkan bahwa skor Fable 5.2 pada FrontierSWE v2 naik 13.6 poin persentase dibandingkan 5.1, sekaligus melampaui Opus 5.5. Kenaikannya lebih besar pada FrontierCode 2.0, tetapi pengaturan effort untuk kedua baris ini berbeda. Jadi, sebagian kenaikan mungkin berasal dari tingkat penalaran yang digunakan.
Data pihak ketiga: Performa Claude Fable 5.2 di AA dan Cursor
| Lingkungan evaluasi | Konfigurasi | Skor | Biaya per tugas (USD) |
|---|---|---|---|
| Artificial Analysis | Fable 5.2 medium | 56 | 3.80 |
| Artificial Analysis | Fable 5.2 high | 62 | 9.08 |
| Artificial Analysis | Fable 5.2 xhigh | 62 | 14.83 |
| Artificial Analysis | Fable 5.2 max | 65 | 26.54 |
| Artificial Analysis | Opus 5.5 max | 59 | 10.04 |
| CursorBench 4.0 | Fable 5.2 High | 56.9% | 9.70 |
| CursorBench 4.0 | Fable 5.2 Max | 60.0% | 32.79 |
| CursorBench 4.0 | Opus 5.5 High | 56.0% | 3.97 |
AA adalah lembaga evaluasi independen. Dalam Intelligence Index mereka, skor Fable 5.2 max mencapai 65, lebih tinggi daripada Opus 5.5 max yang meraih 59. Hasil ini sejalan dengan arah data resmi.
Data Cursor berasal dari tugas dan lingkungan alatnya sendiri. Fable 5.2 Max meraih 60.0%, tetapi selisih antara Fable 5.2 High dan Opus 5.5 High hanya 0.9 poin persentase.
Kedua kelompok data pihak ketiga menunjukkan bahwa batas kemampuan yang lebih tinggi biasanya disertai biaya per tugas yang lebih besar. Di AA, skor naik 3 poin dari high ke max, sementara biaya per tugas meningkat sekitar 2.92 kali lipat.
🎯 Saran teknis: Peringkat hanya bisa membantu mempersempit pilihan. Untuk mendapatkan kesimpulan akhir, uji model dengan kumpulan tugas Anda sendiri. Sebaiknya gunakan APIYI apiyi.com dengan antarmuka kompatibel OpenAI yang sama, lalu bandingkan beberapa model seperti Opus dan Fable menggunakan petunjuk dan kriteria penerimaan yang sama. Catat kualitas dan biayanya untuk setiap tingkat konfigurasi.
Sejauh Mana Kemampuan Visual dan Rekayasa Claude Fable 5.2?
Dari memahami layar hingga mengendalikan gerakan
Dua hal yang paling menarik dari kemampuan visualnya adalah OSWorld 2.1 dan RoboDojo Sim. Pada subset offline OSWorld 2.1, skor partial naik dari 83,5% menjadi 89,3%. Namun, Opus 5.5 juga sudah mencapai 87,2%, jadi selisihnya tidak terlalu besar.
Perubahan pada RoboDojo Sim lebih signifikan. Skornya naik dari 27,6% menjadi 64,9%, menunjukkan peningkatan nyata dalam kemampuan model mengubah pemahaman visual menjadi rangkaian tindakan kendali.
Fable 5.2 terlibat dalam desain prototipe elektronik
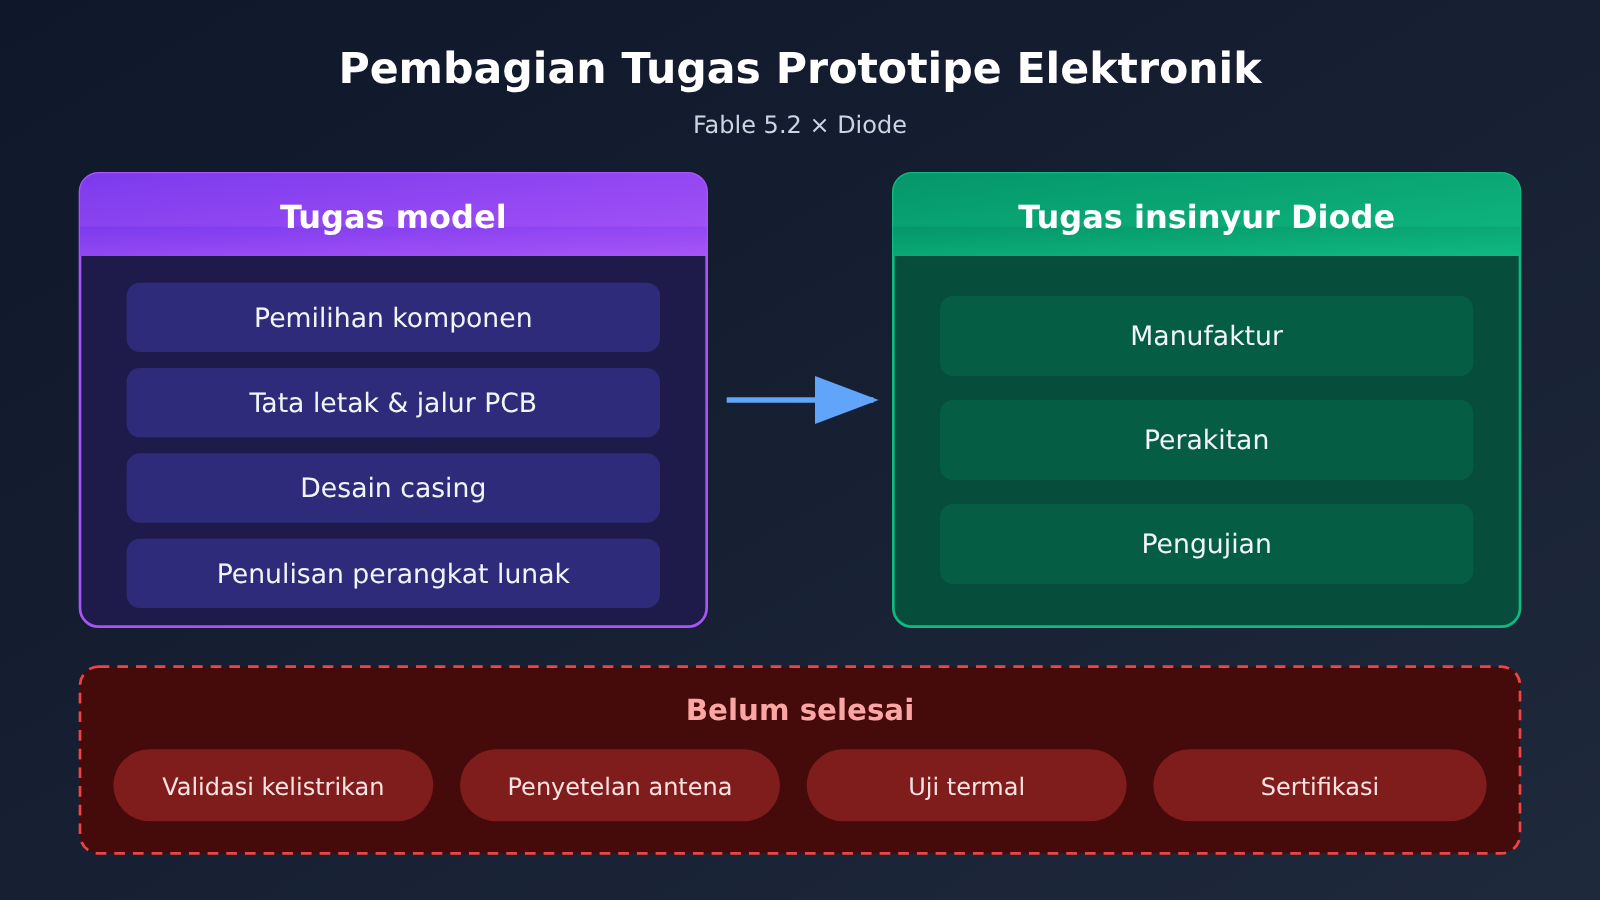
Anthropic dan Diode bekerja sama membuat tiga prototipe perangkat elektronik: asisten suara, speakerphone USB, dan hewan peliharaan virtual. Model terlibat dalam pemilihan komponen, penempatan dan perutean PCB, desain casing, serta penulisan perangkat lunak. Sementara itu, para insinyur Diode menangani proses pembuatan, perakitan, dan pengujian. Karena kedua pihak memiliki hubungan kerja sama komersial, hal ini perlu dipertimbangkan saat membaca contoh tersebut.
Batas kemampuan dalam kasus ini cukup jelas. Ketiga perangkat itu masih berupa prototipe. Semuanya belum melalui validasi kelistrikan, penyetelan antena, pengujian termal, atau sertifikasi, dan belum dirancang sesuai persyaratan produksi massal. Model juga tidak terhubung ke peralatan pabrik atau instrumen pengujian. Jadi, pernyataan yang tepat adalah “model dapat terlibat secara mendalam dalam desain prototipe elektronik”, bukan “model secara mandiri membuat produk yang siap diproduksi massal”.
Dokumen riset yang sama juga memuat dua data lain terkait desain. Pertama, pada evaluasi internal PCB Gym yang dijalankan Diode, Fable 5.2 meraih skor 69%. Skor pembandingnya adalah Fable 5 (25%), bukan 5.1. Kedua, pada tolok ukur publik BenchCAD 2.1, yang digunakan untuk merekonstruksi komponen 3D, rakitan, dan papan sirkuit dari gambar teknik serta gambar render, vendor melaporkan skor Fable 5.2 sebesar 83,5%. Tolok ukurnya bersifat publik, tetapi skor kali ini belum diverifikasi secara independen.
Mengapa Kasus Riset dan Multi-Agen Claude Fable 5.2 Menarik Perhatian
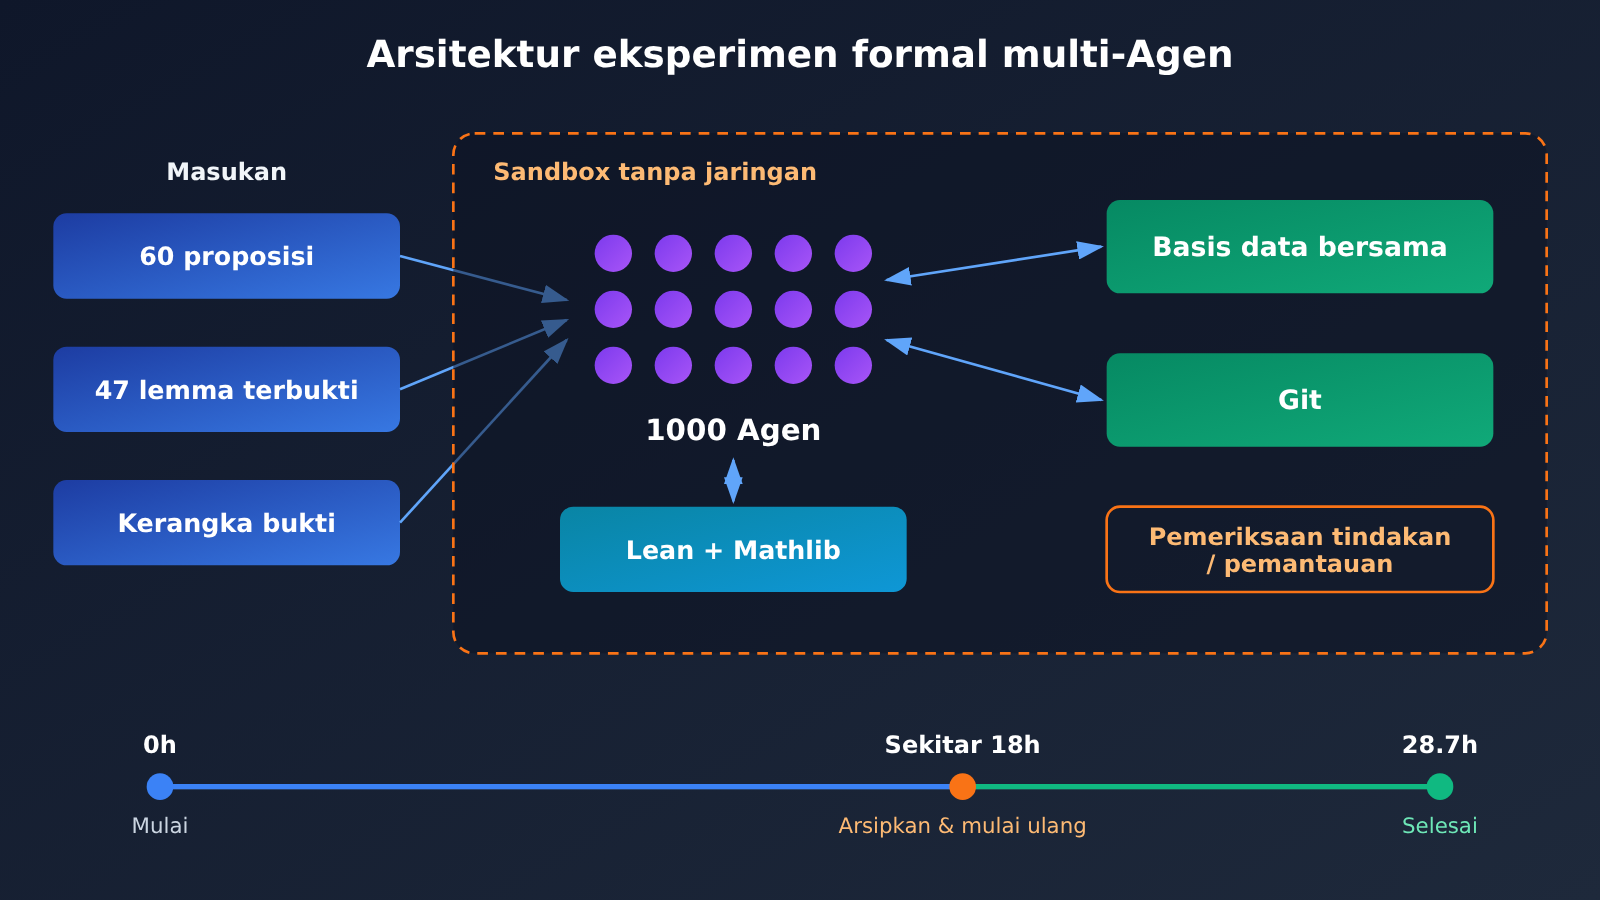
Eksperimen formalisasi matematika menjadi kasus yang paling banyak menarik perhatian. Blog pengembang resmi menyebutkan bahwa 1.000 Agent Fable 5.2 versi awal mereproduksi bukti formal Teorema Terakhir Fermat dalam Lean selama 28,7 jam.
Nilai kasus ini terletak pada kemampuan mengatur tugas berskala besar dalam waktu lama, bukan pada penemuan matematika baru.
Kondisi eksperimennya perlu dijelaskan secara lengkap:
- Masukannya sudah ditentukan: 60 proposisi dan definisi, kerangka singkat jalur pembuktian klasik, serta 47 lemma yang sudah dibuktikan sebelumnya.
- Alat dan lingkungan: Lean, Mathlib, Git, basis data bersama, serta sandbox tanpa koneksi internet yang dilengkapi pemeriksaan tindakan dan pemantauan offline.
- Proses berjalan: Setelah Agent berjalan sekitar 18 jam, proses dimulai ulang dari status yang tersimpan, lalu dilanjutkan selama 12 jam.
- Penjelasan penulis: Penulis menyebutnya sebagai eksperimen main-main (toy experiment) dan menunjukkan bahwa harness khusus serta arahan manusia dapat meningkatkan efisiensi lebih lanjut.
Jadi, ini adalah formalisasi atas bukti matematika yang sudah ada.
Meski memiliki batasan-batasan tersebut, kasus ini tetap menunjukkan satu arah yang menjanjikan: beberapa instans model dapat berbagi tugas, mengirimkan hasil, dan melakukan verifikasi dalam status bersama untuk terus memajukan tugas yang sangat panjang. Kemampuan ini juga relevan untuk pekerjaan rekayasa seperti migrasi kode berskala besar dan refaktor sistem yang kompleks.
Aspek yang Belum Sepenuhnya Dimenangkan Claude Fable 5.2
Ulasan kemampuan yang berimbang harus menyertakan contoh tandingan. Dalam tabel pengumuman resmi yang sama, ada dua hasil yang menunjukkan Fable 5.2 tidak unggul.
| Evaluasi | Fable 5.2 | Model pembanding | Keterangan |
|---|---|---|---|
| AutomationBench | 51.4% | Gemini 4 Carbon 53.9% | Model pesaing unggul pada evaluasi ini |
| AA-Briefcase (rubrik) | 66.1% | Opus 5.5 61.2% | Fable unggul berdasarkan rubrik penilaian |
| AA-Briefcase (Elo) | 1785 | Opus 5.5 1800 | Opus unggul berdasarkan preferensi dalam pertandingan |
Hasil AA-Briefcase adalah contoh yang paling mewakili. Untuk tugas yang sama, Fable unggul saat dinilai berdasarkan rubrik, tetapi Opus unggul saat dinilai berdasarkan preferensi Elo. Peringkat bisa berbalik ketika metode penilaian berubah, jadi tidak bisa diandalkan untuk menyatakan “unggul secara keseluruhan” hanya berdasarkan satu atau dua papan peringkat.
Biaya juga menjadi pertimbangan. Di lingkungan Cursor, Fable 5.2 Max dikenai biaya 32.79 dolar AS per tugas, sedangkan Opus 5.5 High dikenai biaya 3.97 dolar AS per tugas—selisihnya sekitar 8 kali lipat, sementara perbedaan skornya hanya 4 poin persentase. Eksperimen skala kecil oleh pengembang independen Lex Toumbourou juga menunjukkan bahwa akurasi 5.2 high lebih tinggi daripada 5.1, tetapi volume output dan biaya per putaran sama-sama kira-kira dua kali lipat.
Selain itu, skor khusus Mythos untuk keamanan dan bidang biologi tidak seharusnya dianggap sebagai kemampuan Fable biasa.
Pengguna seperti apa yang sebaiknya mencoba Claude Fable 5.2 sekarang?
Berdasarkan panduan resmi pemilihan model dan data di atas, penggunaannya bisa dibagi secara garis besar seperti berikut:
- Layak dicoba lebih dulu: tugas coding jangka panjang yang sulit, desain rekayasa yang kompleks, dan tugas riset yang membutuhkan beberapa langkah pemanggilan alat. Gunakan kumpulan tugas Anda sendiri untuk memverifikasi apakah hasilnya memang meningkat.
- Mulai dengan model sehari-hari: untuk tanya jawab pengetahuan umum dan coding biasa, ikuti saran resmi dengan memulai dari model sehari-hari seperti Opus 5.5. Beralihlah ke model lain hanya jika benar-benar menemui kendala.
Lima aspek yang perlu dipertimbangkan sebelum mencoba Claude Fable 5.2
| Aspek | Pertanyaan yang perlu dipastikan | Saran |
|---|---|---|
| Ketersediaan | Apakah model ini sudah tersedia di platform yang Anda gunakan, dan apa ID model serta endpoint-nya? | Periksa daftar model platform pada hari itu. Jangan berasumsi model sudah tersedia |
| Data | Apakah data tugas boleh dikirim ke model pihak ketiga? | Periksa ketentuan penyimpanan data dan persyaratan kepatuhan perusahaan |
| Kriteria penerimaan | Apa yang dianggap sebagai tugas yang selesai? | Siapkan kasus uji atau kriteria penilaian terlebih dahulu |
| Waktu | Apakah lama waktu tunggu menjadi pertimbangan? | Catat juga waktu dari awal hingga akhir, bukan hanya kecepatan keluaran |
| Anggaran | Berapa batas biaya untuk setiap tugas yang berhasil? | Catat jumlah token dan tugas yang berhasil untuk setiap tingkatan, lalu hitung biaya per keberhasilan |
Lakukan pengujian perbandingan Claude Fable 5.2 dengan antarmuka terpadu
Contoh sederhana berikut menggunakan antarmuka yang kompatibel dengan OpenAI untuk memanggil model. Ganti MODEL dengan ID yang tersedia di daftar model platform. Dengan begitu, Anda dapat membandingkan model yang berbeda tanpa mengubah kode.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka APIYI yang kompatibel dengan OpenAI
)

MODEL = "your-model-id"  # Ikuti daftar model platform pada hari itu
resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "为下面的函数补充单元测试:..."}]
)
print(resp.choices[0].message.content, resp.usage)
Lihat kode perbandingan beberapa model dan pencatatan penggunaan
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Gunakan daftar ID model platform pada hari itu untuk memilih kandidat
CANDIDATES = ["daily-model-id", "candidate-model-id"]

def run_task(model: str, prompt: str, check) -> dict:
    """Jalankan tugas satu kali, lalu catat waktu, token, dan hasil penerimaannya."""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    text = resp.choices[0].message.content
    return {
        "model": model,
        "seconds": round(time.time() - start, 2),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "passed": bool(check(text)),  # Gunakan fungsi pemeriksaan Anda sendiri
    }

def check(text: str) -> bool:
    return "def test_" in text

tasks = ["为 parse_date 函数补充单元测试:..."]
results = [run_task(m, t, check) for m in CANDIDATES for t in tasks]
for r in results:
    print(r)
Setelah perbandingan selesai, periksa kembali tagihan aktual untuk menghitung biayanya. Dokumentasi log APIYI mencantumkan kolom seperti model_name, prompt_tokens, completion_tokens, quota, dan request_id. Nilai quota dibagi 500000 menunjukkan biaya dalam dolar AS. Anda dapat mencocokkan pengeluaran sebelum dan sesudah peningkatan untuk setiap tugas. Perlu diperhatikan bahwa angka berdasarkan tarif resmi hanya perkiraan; gunakan log aktual platform sebagai acuan.
🚀 Mulai cepat: Daftar di APIYI melalui apiyi.com untuk mendapatkan kredit uji coba gratis bagi pengguna baru. Jalankan perbandingan dengan 10 hingga 20 tugas nyata terlebih dahulu, lalu putuskan apakah akan menambah penggunaan hingga tingkat Fable. Pastikan ketersediaan model baru dan harganya berdasarkan informasi yang diumumkan platform pada hari itu.
FAQ
Q1: Apa itu Claude Fable 5.2? Apa hubungannya dengan Mythos 5.2?
Fable 5.2 adalah model yang dirilis Anthropic pada 9 November 2026, dengan ID API `claude-fable-5-2` dan dukungan konteks 1M. Fable dan Mythos 5.2 menggunakan model dasar yang sama. Bedanya, perlindungan keamanan Fable memungkinkan model ini tersedia untuk pelanggan umum, sedangkan Mythos hanya disediakan bagi organisasi yang telah lolos verifikasi.
Q2: Seberapa unggul Claude Fable 5.2 dibandingkan Opus 5.5?
Dalam tabel resmi, skornya pada FrontierSWE v2 adalah 69,9% berbanding 62,3%. Pada indeks AA di tingkat max, skornya 65 berbanding 59. Di tingkat High pada CursorBench 4.0, selisihnya hanya 0,9 poin persentase. Secara keseluruhan, kemampuan maksimum Fable 5.2 lebih tinggi, tetapi harganya dua kali lipat Opus 5.5. Pada tingkat penggunaan yang lebih tinggi, selisih biaya per tugas bisa jadi lebih besar.
Q3: Apakah Claude Fable 5.2 selalu menjadi yang terbaik untuk semua tugas?
Tidak. Pada AutomationBench, Gemini 4 Carbon memperoleh skor 53,9%, lebih tinggi daripada Fable 5.2 yang mendapat 51,4%. Dalam penilaian Elo di AA-Briefcase, Opus 5.5 berada di peringkat lebih tinggi. Hasil pemeringkatan bisa berbeda, tergantung metode penilaian yang digunakan.
Q4: Apakah menggunakan Fable 5.2 pasti lebih hemat daripada 5.1?
Belum tentu. Penurunan harga per unit sebesar 20% hanya menghasilkan penghematan 20% jika penggunaan tetap sama. Misalnya, untuk tugas dengan 100 ribu token input dan 20 ribu token output, biaya 5.2 adalah 1,60 dolar, sedangkan 5.1 sebesar 2 dolar. Namun, jika jumlah output meningkat menjadi 40 ribu token, biaya 5.2 menjadi 2,40 dolar—lebih mahal dari sebelumnya. Contoh ini hanya menjelaskan hubungan antarvariabel, bukan memprediksi bahwa model pasti akan menghasilkan lebih banyak output. Sebaiknya periksa penggunaan token aktual per tugas melalui log pemanggilan di APIYI apiyi.com.
Q5: Bagaimana cara cepat membandingkan Claude Fable 5.2 dengan model lain melalui API?
1. Daftar di APIYI apiyi.com untuk mendapatkan kunci API dan kuota uji coba gratis;
2. Periksa ID model yang tersedia dalam daftar model platform pada hari itu;
3. Gunakan kode dalam artikel ini, atur `base_url` ke `https://api.apiyi.com/v1`, lalu panggil setiap model untuk kumpulan tugas yang sama;
4. Catat jumlah tugas yang berhasil, waktu yang dibutuhkan, dan jumlah token, lalu hitung biaya per keberhasilan.
Q6: Apakah eksperimen Teorema Terakhir Fermat membuktikan bahwa Fable 5.2 mampu melakukan matematika orisinal?
Tidak. Eksperimen tersebut menyediakan 60 proposisi, 47 lemma yang telah dibuktikan, dan kerangka pembuktian. Sebanyak 1.000 Agent dari snapshot awal dijalankan selama 28,7 jam dalam sandbox offline. Yang diselesaikan adalah formalisasi bukti yang sudah ada, dan eksperimen itu hanya dijalankan satu kali. Eksperimen ini menunjukkan kemampuan mengatur proses jangka panjang, tetapi tidak membuktikan bahwa model mampu membuat penemuan matematika orisinal.
Poin Utama Claude Fable 5.2
- Posisi peluncuran: Dirilis pada 9 November. Menggunakan model dasar yang sama dengan Mythos dan tersedia untuk pelanggan umum.
- Batas kemampuan pemrograman: Meraih 69,9% di FrontierSWE v2, lebih tinggi daripada 5.1 dan Opus 5.5 dalam tabel resmi.
- Dukungan dari pihak ketiga: Meraih 65 poin di kelas AA Max dan 60,0% di CursorBench Max, tetapi biaya per tugas jauh lebih tinggi.
- Dari penglihatan ke tindakan: Skor RoboDojo Sim naik dari 27,6% menjadi 64,9%, tetapi angka ini diukur dalam simulasi.
- Rekayasa dan riset: Mampu berkontribusi dalam desain prototipe elektronik dan formalisasi Lean skala besar, tetapi keduanya memiliki prasyarat yang jelas.
- Tidak unggul di semua hal: Model lain unggul dalam beberapa pengukuran AutomationBench dan Elo.
- Cara mencoba: Gunakan antarmuka terpadu di APIYI apiyi.com untuk membandingkan model dengan tugas Anda sendiri, lalu putuskan apakah perlu beralih.
Ringkasan
Poin utama Claude Fable 5.2:
- Peningkatan nyata pada tugas sulit: Dibandingkan 5.1, kemajuannya besar dalam evaluasi pemrograman jangka panjang dan kontrol visual.
- Bukti perlu dilihat secara terpisah: Penilaian vendor, papan peringkat independen AA, dan lingkungan internal Cursor masing-masing memiliki cakupan tersendiri. Angkanya tidak bisa dicampur begitu saja.
- Kemampuan lebih tinggi berarti biaya lebih besar: Kemampuan di kelas atas sering disertai biaya per tugas yang beberapa kali lipat lebih tinggi. Harga per unit yang lebih rendah tidak otomatis berarti biaya per tugas juga lebih rendah.
Jika pekerjaan Anda banyak melibatkan pemrograman jangka panjang yang sulit, rekayasa kompleks, atau riset, ada baiknya menguji langsung peningkatan Fable 5.2 menggunakan kumpulan tugas Anda sendiri. Untuk pekerjaan sehari-hari, sebaiknya mulai dengan model harian seperti Opus. Coba bandingkan beberapa model melalui satu antarmuka di APIYI apiyi.com dan hitung biayanya berdasarkan log. Gunakan data, bukan papan peringkat, untuk menentukan apakah perlu beralih.
📚 Referensi
- Pengumuman peluncuran Anthropic: cakupan peluncuran Fable dan Mythos 5.2, serta tabel kemampuan resmi
- Tautan:
anthropic.com/claude-fable-and-mythos-5-2 -
Keterangan: Sumber primer untuk tanggal peluncuran, klaim kecepatan, dan data perbandingan (penilaian mandiri dari vendor)
-
Spesifikasi model Fable 5.2: konteks, batas output, dan mode berpikir
- Tautan:
platform.claude.com/docs/en/models/fable-5-2/overview -
Keterangan: Dokumentasi API resmi
-
Peringkat model Artificial Analysis: Intelligence Index dan biaya per tugas
- Tautan:
artificialanalysis.ai/leaderboards/models -
Keterangan: Cuplikan dinamis dari lembaga pihak ketiga
-
CursorBench 4.0: evaluasi di lingkungan milik Cursor
- Tautan:
prod.cursor.com/evals -
Keterangan: Evaluasi oleh penyedia alat, bukan pengujian ulang independen yang bersifat umum
-
Riset desain prototipe elektronik Claude: tiga prototipe hasil kolaborasi dengan Diode
- Tautan:
anthropic.com/research/claude-electronics-design -
Keterangan: Mencakup data PCB Gym dan BenchCAD 2.1, serta keterbatasan prototipe
-
Eksperimen tim multiagen Fable 5.2: kondisi eksperimen formalisasi Lean
- Tautan:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2/ -
Keterangan: Satu kali uji coba berskala besar dalam cuplikan awal dari vendor
-
Panduan memilih model Claude: rekomendasi penggunaan Opus dan Fable
- Tautan:
claude.dev/blog/which-claude-model-should-you-build-with/ - Keterangan: Panduan resmi untuk developer
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui beranda situs resmi APIYI. Informasi kolom log dan penagihan tersedia di pusat dokumentasi docs.apiyi.com.


