
Anthropic a officiellement lancé Claude Fable 5.2 le 9 novembre 2026. Les tableaux de capacités officiels et les classements de tiers indiquent qu’il surpasse nettement la version 5.1 pour les tâches difficiles et la collaboration sur le long terme. Le tarif standard de l’API est également inférieur de 20 % à celui de la version 5.1.
L’essentiel : cet article suit l’ordre « conclusion, preuves, limites » pour vous aider à déterminer où Claude Fable 5.2 fait la différence, dans quelle mesure et si vos tâches justifient une migration dès maintenant.
Petit glossaire pour comprendre les évaluations de Claude Fable 5.2
Plusieurs critères d’évaluation reviennent souvent dans la suite. Une mauvaise interprétation peut facilement vous faire prendre une démonstration du fournisseur pour une validation indépendante, ou confondre un score partiel avec un taux de réussite.
- Agent : système de modèle capable d’utiliser des outils et d’exécuter des tâches en plusieurs étapes.
- Intelligence Index : indice de capacité global d’Artificial Analysis (AA). Il s’agit d’un score composite, et non d’un taux de réussite.
- OSWorld partial : méthode de notation des évaluations d’interaction avec un ordinateur de bureau, fondée sur le degré d’achèvement. Elle ne correspond pas au taux de réussite strict à l’ensemble des tâches.
- RoboDojo Sim : évaluation du contrôle dans un environnement robotique simulé, qui ne reflète pas le taux de réussite de robots réels.
- PCB : circuit imprimé, qui accueille et relie les composants électroniques.
- Lean / preuve formelle : Lean est un langage et un outil qui permettent à un ordinateur de vérifier une preuve. Une preuve formelle consiste à reformuler un raisonnement mathématique en une suite rigoureuse d’étapes que la machine peut vérifier.
- Collaboration multi-agent : plusieurs instances de modèle se répartissent le travail, communiquent entre elles, puis mettent leurs résultats en commun.
Claude Fable 5.2 : quelle puissance ? D’abord la conclusion, puis le contexte du lancement
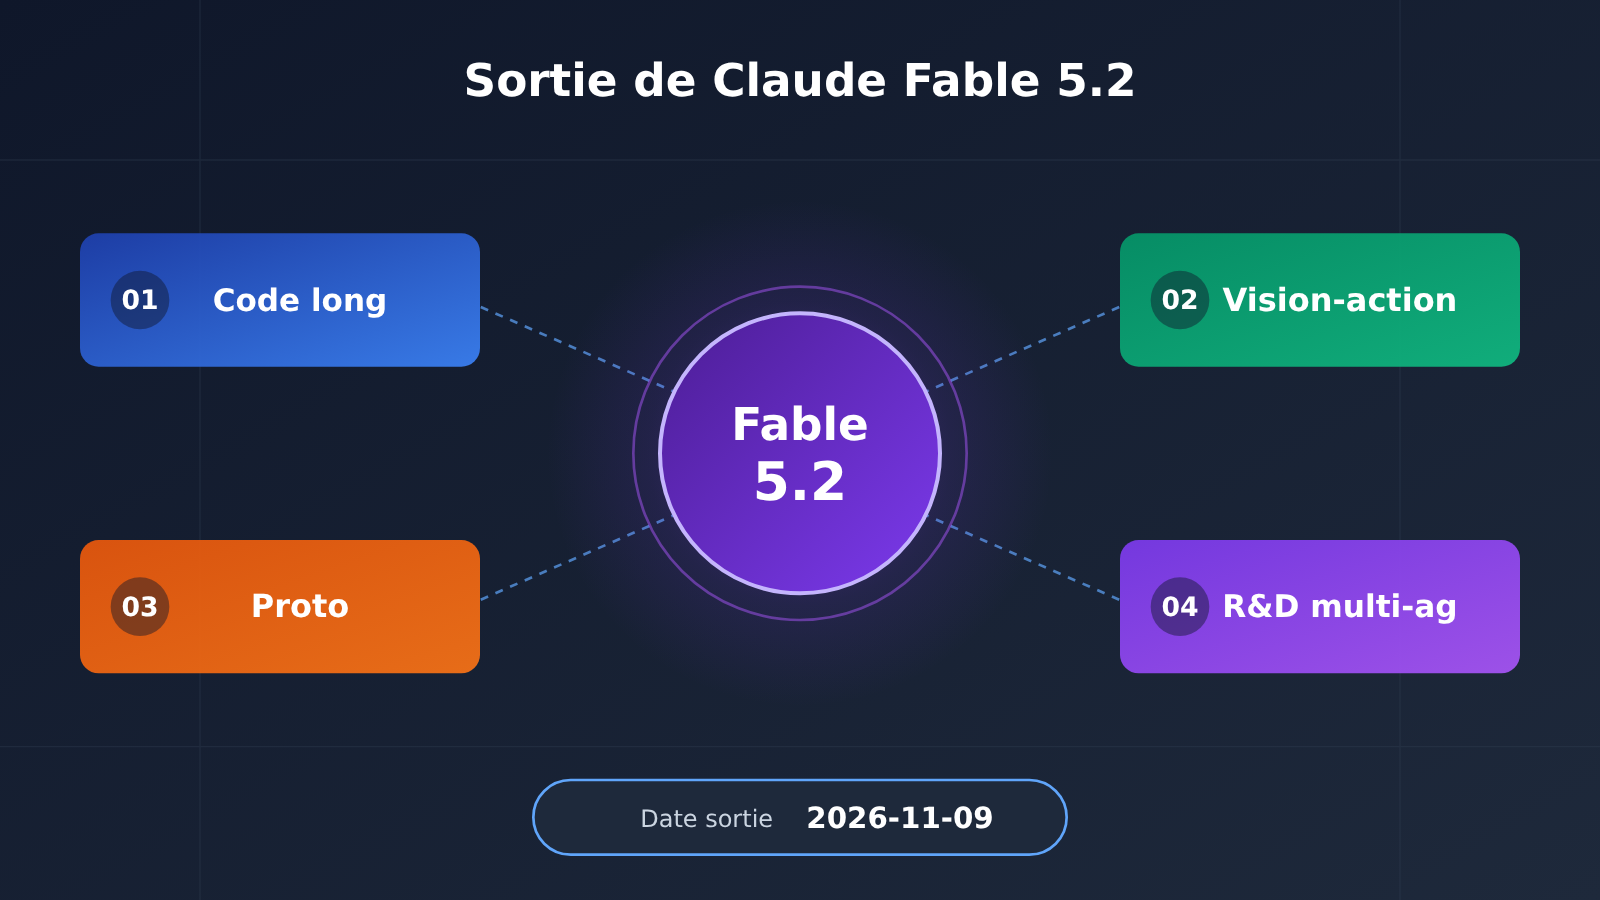
En bref : Claude Fable 5.2 progresse nettement en programmation complexe, sur les tâches de longue durée et dans les évaluations de type vision-action, mais on ne peut pas dire qu’il arrive en tête dans toutes les tâches. Dans certaines évaluations automatisées et certains scores de préférence, il reste derrière d’autres modèles.
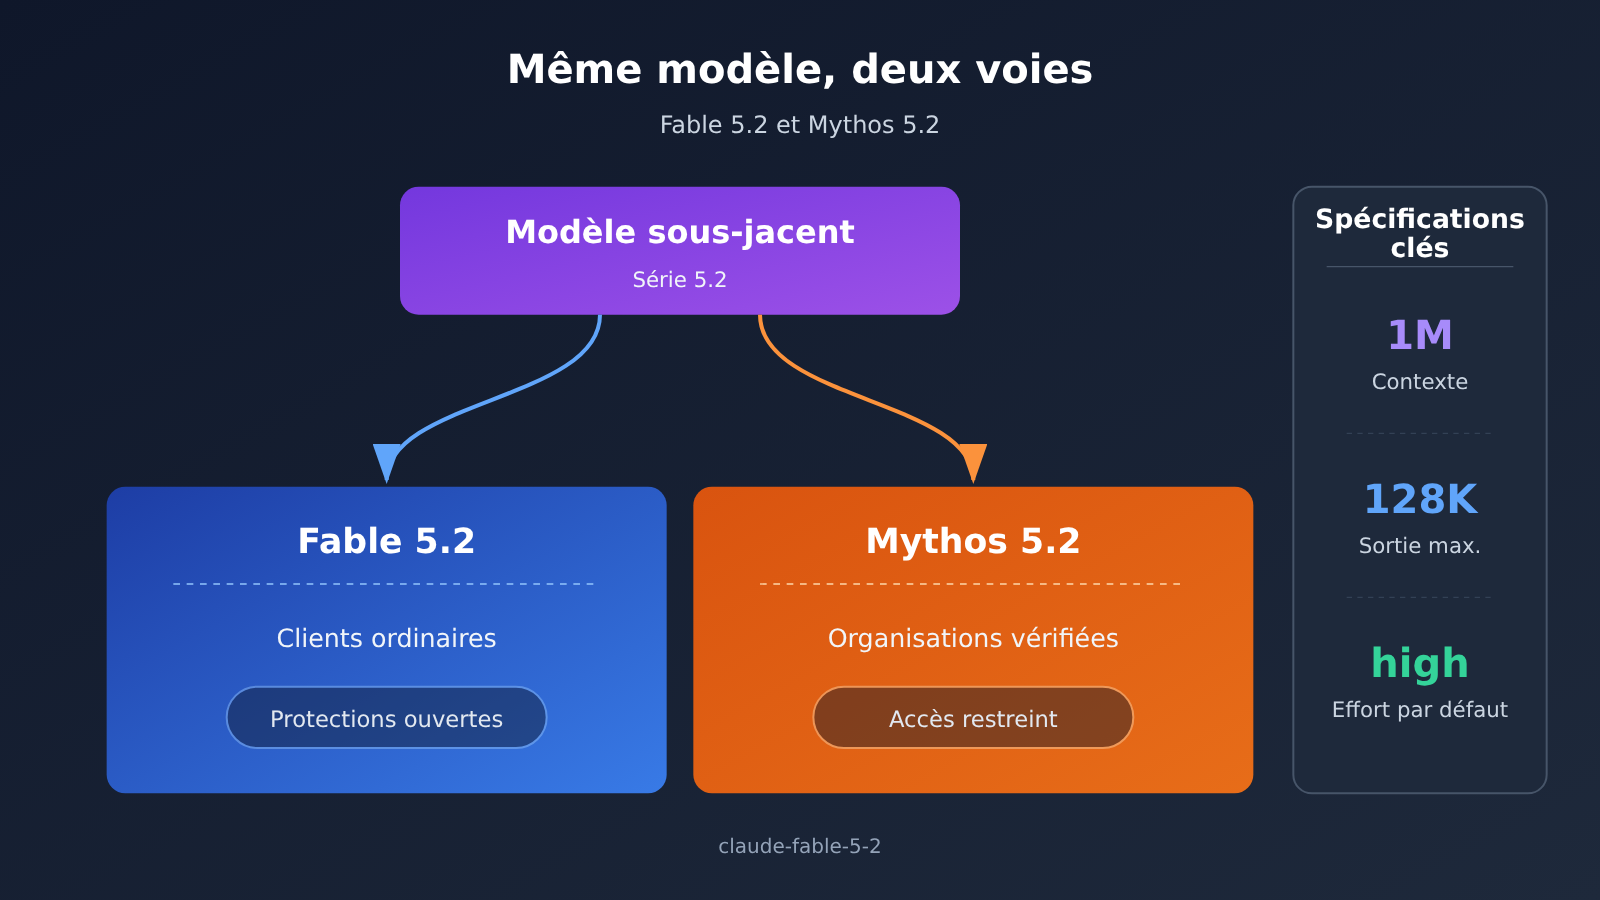
Commençons par le contexte du lancement. Selon l’annonce officielle, Fable et Mythos reposent sur le même modèle sous-jacent. Les protections de Fable contre les risques liés à la cybersécurité et à la biosécurité permettent de le proposer au grand public, tandis que Mythos est réservé aux organisations vérifiées. Il ne faut donc pas attribuer directement à Fable les capacités ou les scores propres à Mythos.
Claude Fable 5.2 : l’essentiel
| Information | Détails | Nature de la source |
|---|---|---|
| Date de sortie | 9 novembre 2026 | Annonce officielle |
| Identifiant API | claude-fable-5-2 |
Documentation officielle du modèle |
| Fenêtre de contexte / sortie maximale | 1M jetons / 128K jetons | Documentation officielle du modèle |
| Modalités d’entrée et de sortie | Entrées textuelles et visuelles, sortie textuelle | Documentation officielle du modèle |
| Mode de raisonnement | Le raisonnement adaptatif est toujours activé ; le niveau d’effort par défaut de l’API est high |
Documentation officielle du modèle |
| Date limite des connaissances | Juin 2026 (ce qui ne signifie pas qu’il peut accéder à Internet en temps réel) | Documentation officielle du modèle |
| Tarif standard | 8 $ par million de jetons en entrée et 40 $ en sortie, soit une baisse de 20 % par rapport à la version 5.1 | Page officielle des tarifs |
| Vitesse annoncée | Génération en sortie « jusqu’à 30 % plus rapide » que la version 5.1 | Valeur maximale annoncée par le fabricant |
Deux points peuvent facilement prêter à confusion. Premièrement, « jusqu’à 30 % plus rapide » correspond à la vitesse maximale annoncée par le fabricant : cela ne signifie pas que chaque tâche prendra 30 % moins de temps. Deuxièmement, le tarif standard de Fable 5.2 reste deux fois plus élevé que celui d’Opus 5.5 (4/20 $).
La recommandation officielle est également claire : pour la plupart des tâches courantes de programmation et de traitement des connaissances, mieux vaut commencer avec Opus 5.5 et ne passer à Fable que pour les tâches complexes.
Éléments montrant les progrès de Claude Fable 5.2 en programmation et sur les tâches longues
La programmation est au cœur de cette version. Commençons par les résultats publiés par le fournisseur, puis examinons deux séries de données indépendantes obtenues dans des environnements différents.
Tableau des capacités officielles : Fable 5.2 face à 5.1 et Opus 5.5
| Évaluation (données du fournisseur) | Fable 5.2 | Fable 5.1 | Opus 5.5 | Remarques |
|---|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | — | Les paramètres d’effort diffèrent entre les deux versions |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% | Tâches de génie logiciel de longue durée |
| AutomationBench | 51.4% | 31.4% | 42.5% | Tâches d’automatisation |
| OSWorld 2.1, sous-ensemble hors ligne partiel | 89.3% | 83.5% | 87.2% | Méthode de calcul du score partiel |
| RoboDojo Sim | 64.9% | 27.6% | 39.4% | Contrôle de robots en simulation |
Le tableau confirme que Fable 5.2 obtient un score supérieur de 13,6 points à celui de la version 5.1 sur FrontierSWE v2, et qu’il dépasse aussi Opus 5.5. La hausse est plus importante sur FrontierCode 2.0, mais les paramètres d’effort diffèrent entre les deux résultats : une partie du gain pourrait donc venir du niveau de raisonnement utilisé.
Données indépendantes : performances de Claude Fable 5.2 sur AA et Cursor
| Environnement d’évaluation | Configuration | Score | Coût par tâche (en dollars) |
|---|---|---|---|
| Artificial Analysis | Fable 5.2 medium | 56 | 3.80 |
| Artificial Analysis | Fable 5.2 high | 62 | 9.08 |
| Artificial Analysis | Fable 5.2 xhigh | 62 | 14.83 |
| Artificial Analysis | Fable 5.2 max | 65 | 26.54 |
| Artificial Analysis | Opus 5.5 max | 59 | 10.04 |
| CursorBench 4.0 | Fable 5.2 High | 56.9% | 9.70 |
| CursorBench 4.0 | Fable 5.2 Max | 60.0% | 32.79 |
| CursorBench 4.0 | Opus 5.5 High | 56.0% | 3.97 |
AA est un organisme d’évaluation indépendant. Dans son Intelligence Index, Fable 5.2 max obtient 65 points, contre 59 pour Opus 5.5 max, ce qui va dans le même sens que les résultats du tableau officiel.
Les données de Cursor proviennent de ses propres tâches et de son environnement d’outils. Fable 5.2 Max atteint 60,0 %, mais l’écart avec Opus 5.5 High n’est que de 0,9 point.
Les deux séries de données indépendantes montrent que des performances maximales plus élevées s’accompagnent généralement d’un coût supérieur par tâche. Sur AA, le score augmente de 3 points entre high et max, tandis que le coût par tâche est multiplié par environ 2,92.
🎯 Conseil technique : les classements servent à réduire le nombre de modèles à tester, mais il faut tirer la conclusion finale à partir de vos propres tâches. Nous vous conseillons de comparer Opus, Fable et d’autres modèles avec la même interface compatible avec OpenAI, via APIYI apiyi.com, en utilisant les mêmes invites et critères d’acceptation. Notez ensuite la qualité et le coût pour chaque niveau de configuration.
Où en sont les capacités visuelles et d’ingénierie de Claude Fable 5.2 ?
De la compréhension de l’écran au contrôle des actions
Les deux résultats les plus intéressants en matière de vision concernent OSWorld 2.1 et RoboDojo Sim. Sur le sous-ensemble hors ligne d’OSWorld 2.1, le score partiel est passé de 83,5 % à 89,3 %. Opus 5.5 atteint toutefois déjà 87,2 % : l’écart reste modeste.
La progression est plus marquée sur RoboDojo Sim : le score est passé de 27,6 % à 64,9 %. Cela montre que le modèle a nettement progressé dans sa capacité à convertir la compréhension visuelle en actions de contrôle continues.
Fable 5.2 participe à la conception de prototypes électroniques
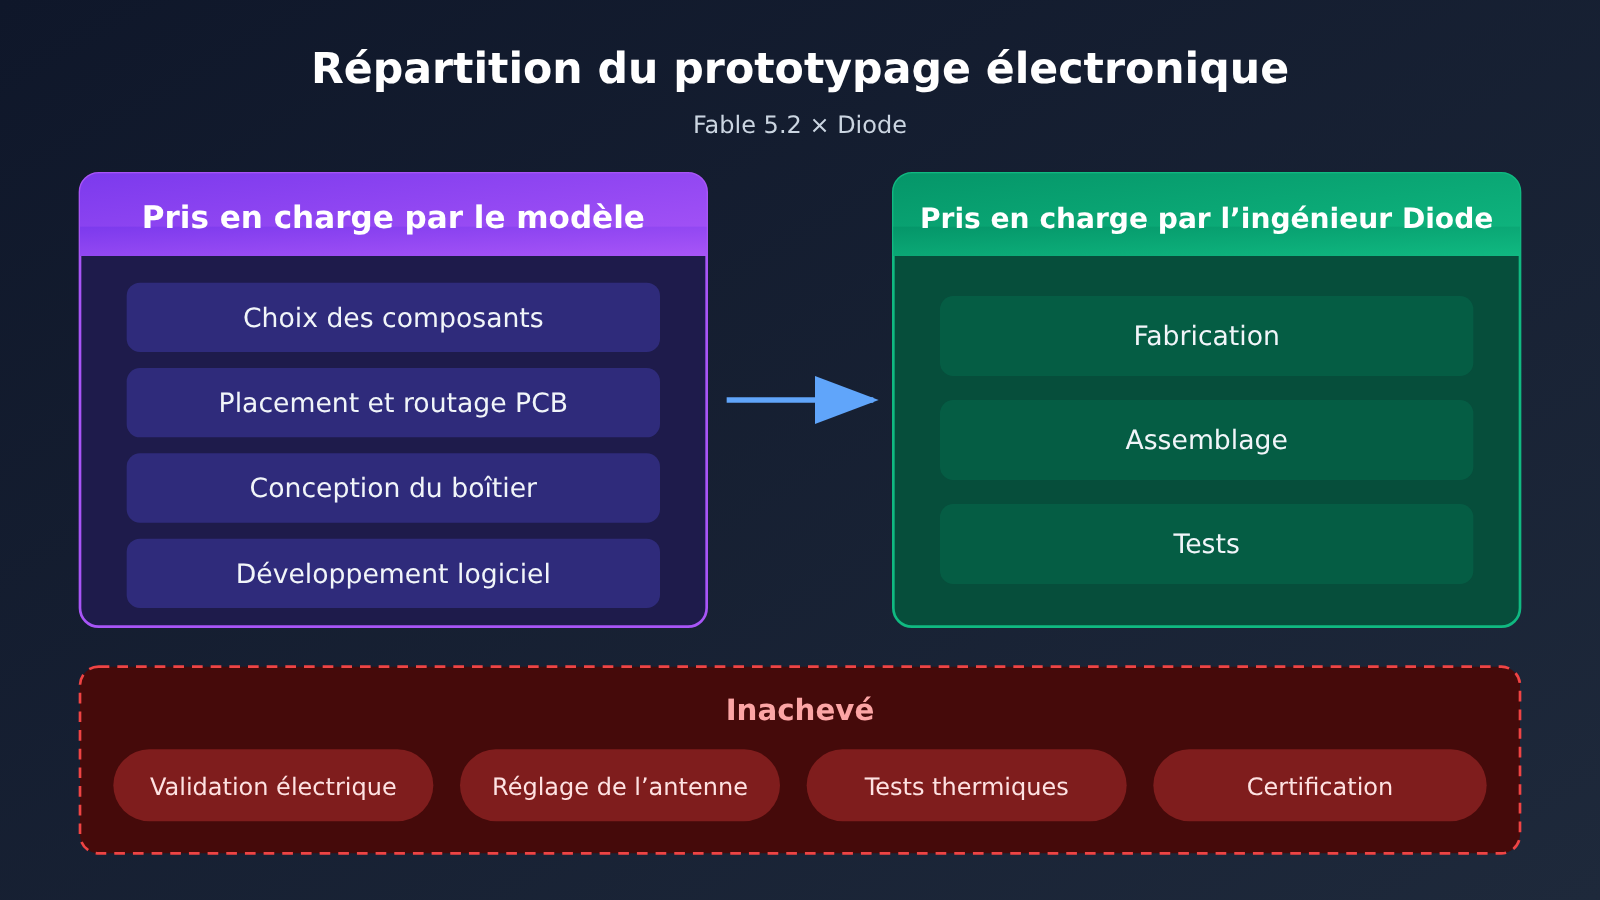
Anthropic et Diode ont collaboré à la création de trois prototypes d’appareils électroniques : un assistant vocal, un haut-parleur mains libres USB et un animal de compagnie virtuel. Le modèle a participé au choix des composants, à la disposition et au routage du circuit imprimé, à la conception du boîtier et à l’écriture du logiciel. Les ingénieurs de Diode se sont chargés de la fabrication, de l’assemblage et des tests. Les deux entreprises ont une relation commerciale : il faut en tenir compte à la lecture de cet exemple.
Les limites de cette démonstration sont claires. Les trois appareils ne sont que des prototypes. Ils n’ont fait l’objet ni d’une validation électrique, ni d’un réglage de l’antenne, ni de tests thermiques ou de certification, et n’ont pas été conçus pour répondre aux exigences de la production en série. Le modèle n’a été connecté ni à des équipements d’usine ni à des instruments de test. La formulation juste est donc : « le modèle peut participer activement à la conception de prototypes électroniques », et non : « le modèle a fabriqué seul un produit prêt pour la production en série ».
Le même document de recherche présente aussi deux résultats liés à la conception. Le premier vient de PCB Gym, une évaluation interne menée par Diode : Fable 5.2 obtient 69 %, contre 25 % pour Fable 5 — et non 5.1. Le second concerne BenchCAD 2.1, un benchmark public qui évalue la reconstruction de pièces 3D, d’assemblages et de circuits imprimés à partir de dessins techniques et d’images rendues. Le fabricant annonce un score de 83,5 % pour Fable 5.2. Le benchmark est public, mais ce résultat n’a pas encore été vérifié de manière indépendante.
Pourquoi les cas d’usage de Claude Fable 5.2 en recherche et avec plusieurs agents attirent l’attention
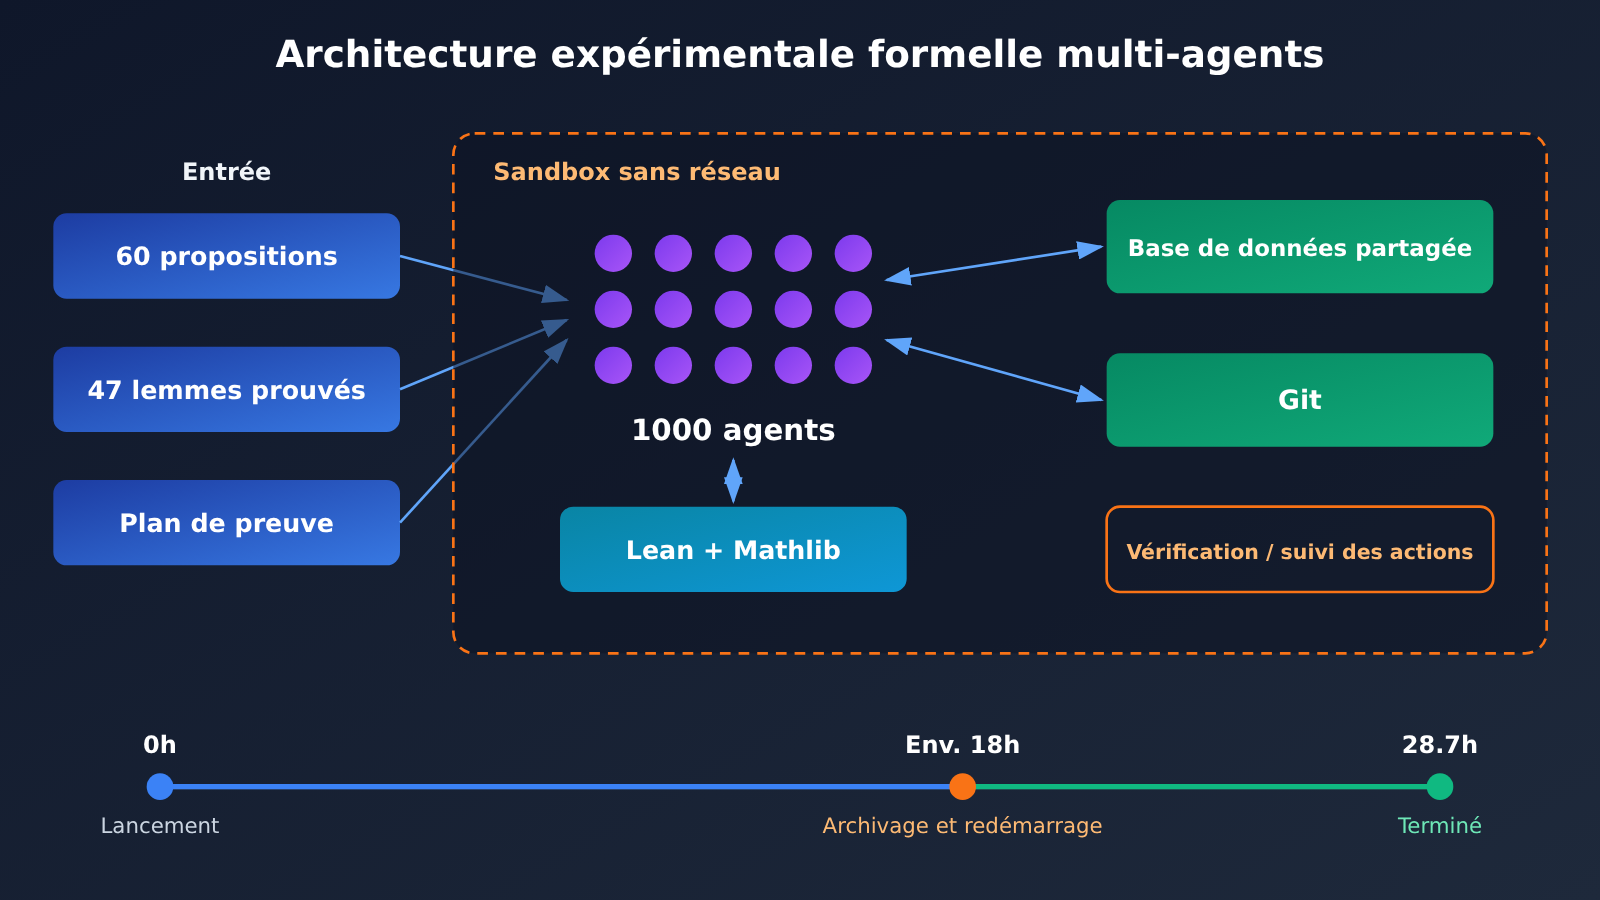
L’expérience de formalisation mathématique est celle qui a suscité le plus d’intérêt. Selon le blog officiel des développeurs, 1 000 agents exécutant une version préliminaire de Fable 5.2 ont reproduit en Lean la démonstration formalisée du dernier théorème de Fermat en 28,7 heures.
L’intérêt de cette expérience tient à sa capacité à organiser une tâche à grande échelle sur une longue durée, et non à une nouvelle découverte mathématique.
Il est important de préciser les conditions de l’expérience :
- Les données d’entrée étaient fournies : 60 propositions et définitions, le plan général de la démonstration classique résumé en une phrase, ainsi que 47 lemmes déjà démontrés.
- Outils et environnement : Lean, Mathlib, Git, une base de données partagée et un bac à sable sans connexion réseau, avec vérification des actions et surveillance hors ligne.
- Déroulement : après environ 18 heures, les agents ont redémarré à partir d’un état sauvegardé, puis ont poursuivi pendant 12 heures supplémentaires.
- Position des auteurs : ils qualifient eux-mêmes l’expérience de « toy experiment » et indiquent qu’un harnais spécialisé et des orientations humaines pourraient encore améliorer l’efficacité.
Il s’agit donc de la formalisation d’une démonstration mathématique déjà établie.
Même avec ces réserves, cette expérience met en lumière une piste prometteuse : plusieurs instances d’un modèle peuvent se répartir le travail, soumettre leurs résultats et les vérifier à partir d’un état partagé, afin de faire avancer durablement une tâche de très longue haleine. Cette capacité peut aussi être utile pour des travaux d’ingénierie comme la migration de grandes bases de code ou la refonte de systèmes complexes.
Dans quels domaines Claude Fable 5.2 ne l’emporte pas sur tous les tableaux
Un bilan sérieux des capacités doit aussi présenter les contre-exemples. Le tableau de l’annonce officielle contient deux résultats où Fable 5.2 n’est pas en tête.
| Évaluation | Fable 5.2 | Modèle de comparaison | Remarque |
|---|---|---|---|
| AutomationBench | 51.4% | Gemini 4 Carbon 53.9% | Le modèle concurrent est devant sur cette évaluation |
| AA-Briefcase (grille d’évaluation) | 66.1% | Opus 5.5 61.2% | Fable est devant selon la grille d’évaluation |
| AA-Briefcase (Elo) | 1785 | Opus 5.5 1800 | Opus est devant selon les préférences mesurées en duel |
La ligne AA-Briefcase est particulièrement révélatrice. Pour une même tâche, Fable est devant quand on applique la grille d’évaluation, tandis qu’Opus l’emporte selon le classement Elo fondé sur les préférences lors des duels. Le classement peut s’inverser selon la méthode de notation : proclamer un modèle « premier sur tous les tableaux » en se fondant sur un ou deux classements n’est donc pas fiable.
Autre contrepartie : le coût. Dans l’environnement Cursor, Fable 5.2 Max revient à 32.79 dollars par tâche, contre 3.97 dollars pour Opus 5.5 High, soit environ 8 fois plus cher, pour un écart de 4 points de pourcentage. Une expérience à petite échelle menée par le développeur indépendant Lex Toumbourou montre aussi que la précision de 5.2 high dépasse celle de 5.1, mais que le volume de sortie et le coût par tour doublent à peu près.
Enfin, les scores spécifiques de Mythos en matière de sécurité et de biologie ne doivent pas être considérés comme des indicateurs des capacités de Fable en général.
Quels utilisateurs devraient essayer Claude Fable 5.2 dès maintenant ?
D’après le guide officiel de sélection des modèles et les données ci-dessus, on peut distinguer deux grandes catégories :
- À essayer en priorité : pour les tâches de programmation complexes qui s’étendent sur plusieurs étapes, la conception de systèmes élaborés et les travaux de recherche nécessitant plusieurs appels à des outils. Vous pouvez vérifier les gains réels sur votre propre jeu de tâches.
- Commencer avec un modèle généraliste : pour les questions de connaissances courantes et la programmation ordinaire, suivez les recommandations officielles et commencez avec un modèle du quotidien comme Opus 5.5. Passez à un modèle supérieur uniquement si vous vous heurtez à des limites.
Cinq critères à évaluer avant d’essayer Claude Fable 5.2
| Critère | Question à vérifier | Recommandation |
|---|---|---|
| Disponibilité | Le modèle est-il déjà disponible sur la plateforme que vous utilisez ? Quel est son ID et quel est son point de terminaison ? | Consultez la liste des modèles de la plateforme le jour même ; ne supposez pas qu’il est déjà disponible |
| Données | Les données de la tâche peuvent-elles être transmises à un modèle tiers ? | Vérifiez les conditions de conservation des données et les exigences de conformité de votre entreprise |
| Évaluation | Comment déterminer si la tâche est terminée ? | Préparez à l’avance des cas de test ou des critères d’évaluation |
| Temps | Le temps d’attente est-il important ? | Mesurez aussi le temps total de bout en bout, pas seulement la vitesse de génération |
| Budget | Quel est le coût maximal acceptable par tâche réussie ? | Consignez les jetons utilisés et le nombre de tâches réussies pour chaque niveau, puis calculez le coût par réussite |
Réaliser des tests comparatifs avec Claude Fable 5.2 via une interface unifiée
Cet exemple minimal appelle un modèle via une interface compatible avec OpenAI. Remplacez MODEL par un identifiant réellement présent dans la liste des modèles de la plateforme pour comparer différents modèles sans modifier le code.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible avec OpenAI d’APIYI
)

MODEL = "your-model-id"  # Vérifiez la liste des modèles du jour sur la plateforme
resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "为下面的函数补充单元测试:..."}]
)
print(resp.choices[0].message.content, resp.usage)
Afficher le code de comparaison des modèles et de suivi de l’utilisation
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Vérifiez les identifiants des modèles candidats dans la liste du jour sur la plateforme
CANDIDATES = ["daily-model-id", "candidate-model-id"]

def run_task(model: str, prompt: str, check) -> dict:
    """Exécute une tâche et enregistre sa durée, le nombre de jetons et le résultat de la vérification."""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    text = resp.choices[0].message.content
    return {
        "model": model,
        "seconds": round(time.time() - start, 2),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "passed": bool(check(text)),  # Utilisez votre propre fonction de vérification
    }

def check(text: str) -> bool:
    return "def test_" in text

tasks = ["为 parse_date 函数补充单元测试:..."]
results = [run_task(m, t, check) for m in CANDIDATES for t in tasks]
for r in results:
    print(r)
Une fois la comparaison terminée, vérifiez également les montants sur la facture réelle. La documentation des journaux d’APIYI répertorie des champs comme model_name, prompt_tokens, completion_tokens, quota et request_id. Divisez quota par 500000 pour obtenir le montant facturé en dollars, puis rapprochez les dépenses avant et après la mise à niveau, tâche par tâche. À noter : le montant calculé selon les tarifs officiels reste une estimation ; les journaux réels de la plateforme font foi.
🚀 Pour commencer rapidement : créez un compte sur APIYI, à l’adresse apiyi.com, et profitez du crédit d’essai gratuit réservé aux nouveaux utilisateurs. Commencez par comparer 10 à 20 tâches réelles, puis décidez si vous souhaitez passer à un volume de requêtes de niveau Fable. Vérifiez les informations publiées par la plateforme le jour même pour savoir si le nouveau modèle est disponible et connaître son prix.
FAQ : questions fréquentes
Q1 : Qu’est-ce que Claude Fable 5.2 ? Quel est son lien avec Mythos 5.2 ?
Fable 5.2 est un modèle publié par Anthropic le 9 novembre 2026. Son identifiant API est `claude-fable-5-2` et il prend en charge une fenêtre de contexte de 1M. Il partage le même modèle sous-jacent que Mythos 5.2. La différence tient aux garde-fous de sécurité : ceux de Fable permettent de le proposer au grand public, tandis que Mythos est réservé aux organisations dont l’accès a été vérifié.
Q2 : De combien Claude Fable 5.2 surpasse-t-il Opus 5.5 ?
Dans le tableau officiel, Fable obtient 69,9 % contre 62,3 % sur FrontierSWE v2. Sur l’indice AA, les scores en mode max sont de 65 contre 59. Sur CursorBench 4.0, l’écart n’est que de 0,9 point de pourcentage dans la catégorie High. Dans l’ensemble, Fable 5.2 a un plafond de capacités plus élevé, mais son prix unitaire est deux fois supérieur à celui d’Opus 5.5. Pour les niveaux les plus élevés, l’écart de coût par tâche peut être encore plus marqué.
Q3 : Claude Fable 5.2 arrive-t-il en tête pour toutes les tâches ?
Non. Sur AutomationBench, Gemini 4 Carbon obtient 53,9 %, contre 51,4 % pour Fable 5.2. Avec le système de score Elo d’AA-Briefcase, Opus 5.5 est mieux classé. Les classements varient selon la méthode d’évaluation.
Q4 : Fable 5.2 revient-il toujours moins cher que la version 5.1 ?
Pas forcément. Une baisse de 20 % du prix unitaire permet d’économiser 20 % uniquement si le volume d’utilisation reste identique. Prenons une tâche avec 100 000 tokens en entrée et 20 000 en sortie : elle coûte 1,60 dollar avec la version 5.2, contre 2 dollars avec la version 5.1. Mais si la sortie passe à 40 000 tokens, le coût de la version 5.2 atteint 2,40 dollars, soit davantage. Cet exemple sert uniquement à illustrer le lien entre les différentes variables ; il ne prédit pas que le modèle produira forcément plus de texte. Il est conseillé de vérifier la consommation réelle de tokens par tâche dans les journaux d’appels d’APIYI apiyi.com.
Q5 : Comment comparer rapidement Claude Fable 5.2 et d’autres modèles via l’API ?
1. Inscrivez-vous sur APIYI apiyi.com pour obtenir une clé API et un crédit d’essai gratuit ;
2. Vérifiez les identifiants disponibles dans la liste des modèles de la plateforme ce jour-là ;
3. Utilisez le code de cet article, définissez `base_url` sur `https://api.apiyi.com/v1`, puis lancez les appels sur les mêmes tâches pour chaque modèle ;
4. Notez le nombre de réussites, le temps d’exécution et le nombre de tokens, puis calculez le coût par tâche réussie.
Q6 : L’expérience sur le dernier théorème de Fermat montre-t-elle que Fable 5.2 peut faire des découvertes mathématiques originales ?
Non. L’expérience fournissait 60 propositions, 47 lemmes déjà démontrés et des grandes lignes de preuve. Elle a fait tourner 1 000 agents issus de snapshots précoces pendant 28,7 heures dans un bac à sable hors ligne. Le modèle a formalisé des preuves existantes, et il ne s’agissait que d’une seule exécution. Cette expérience illustre ses capacités d’organisation sur de longues tâches, mais ne prouve pas qu’il puisse faire des découvertes mathématiques originales.
Points clés de Claude Fable 5.2
- Positionnement au lancement : lancé le 9 novembre, il utilise le même modèle sous-jacent que Mythos et est accessible au grand public.
- Programmation : il atteint 69,9 % sur FrontierSWE v2, un score supérieur à ceux de 5.1 et d’Opus 5.5 dans le tableau officiel.
- Confirmation par des tiers : il obtient 65 points sur AA, dans la catégorie Max, et 60,0 % sur CursorBench Max, mais le coût par tâche est nettement plus élevé.
- De la vision à l’action : le score sur RoboDojo Sim passe de 27,6 % à 64,9 %, mais il s’agit d’une évaluation en simulation.
- Ingénierie et recherche : il peut contribuer à la conception de prototypes électroniques et à des travaux de formalisation Lean à grande échelle, sous réserve de conditions clairement définies.
- Pas gagnant sur tous les tableaux : d’autres modèles arrivent en tête selon les mesures d’AutomationBench et d’Elo.
- Pour le tester : vous pouvez passer par APIYI, sur apiyi.com, pour comparer les modèles avec une interface unifiée et vos propres tâches, puis décider si une mise à niveau vaut le coup.
En résumé
Les points essentiels à retenir sur Claude Fable 5.2 :
- Des progrès nets sur les tâches difficiles : il progresse sensiblement par rapport à 5.1 sur les évaluations de programmation à long terme et de contrôle visuel.
- Les résultats sont à interpréter selon leur contexte : les évaluations du fournisseur, les classements indépendants d’AA et l’environnement propre à Cursor ont chacun leur domaine de validité. Il ne faut pas comparer leurs chiffres directement.
- Des performances de pointe qui ont un coût : les capacités maximales des versions haut de gamme s’accompagnent souvent d’un coût par tâche plusieurs fois supérieur. Un prix unitaire plus bas ne signifie pas forcément une tâche moins coûteuse.
Si votre travail porte surtout sur des tâches complexes de programmation à long terme, d’ingénierie ou de recherche, le mieux est de vérifier dès maintenant les gains réels de Fable 5.2 sur votre propre jeu de tâches. Pour les tâches quotidiennes, mieux vaut commencer par un modèle comme Opus. Nous vous recommandons de comparer plusieurs modèles avec la même interface via APIYI, sur apiyi.com, et de calculer les coûts à partir des journaux d’utilisation : mieux vaut décider à partir de vos données que des classements.
📚 Références
- Annonce d’Anthropic : périmètre de lancement de Fable et Mythos 5.2, tableau officiel des capacités
- Lien :
anthropic.com/claude-fable-and-mythos-5-2 -
À noter : source primaire pour la date de lancement, les chiffres de vitesse et les données comparatives (autoévaluation du fournisseur)
-
Spécifications du modèle Fable 5.2 : contexte, limite de sortie, mode de réflexion
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview -
À noter : documentation officielle de l’API
-
Classement des modèles d’Artificial Analysis : Intelligence Index et coût par tâche
- Lien :
artificialanalysis.ai/leaderboards/models -
À noter : instantané dynamique d’un organisme tiers
-
CursorBench 4.0 : évaluation dans l’environnement propre à Cursor
- Lien :
prod.cursor.com/evals -
À noter : évaluation réalisée par le fournisseur de l’outil, et non par une nouvelle étude indépendante généraliste
-
Étude sur la conception électronique avec Claude : trois prototypes réalisés en collaboration avec Diode
- Lien :
anthropic.com/research/claude-electronics-design -
À noter : comprend les données de PCB Gym et BenchCAD 2.1, ainsi que les limites des prototypes
-
Expérience d’équipe multi-agents avec Fable 5.2 : conditions de l’expérience de formalisation avec Lean
- Lien :
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2/ -
À noter : exécution à grande échelle, présentée dans un premier instantané du fournisseur
-
Guide de sélection des modèles Claude : conseils d’utilisation d’Opus et de Fable
- Lien :
claude.dev/blog/which-claude-model-should-you-build-with/ - À noter : guide officiel destiné aux développeurs
Auteur : équipe technique d’APIYI
Échanges techniques : vous pouvez nous contacter depuis la page d’accueil du site officiel d’APIYI. Pour les champs des journaux et les informations de facturation, consultez le centre de documentation sur docs.apiyi.com.


