
著者注:Claude Fable 5.2がRoboDojo Simで64.9%を記録した条件を解説します。Opus 5.5やGPT-6 Astraとの差、証明できること・できないこと、導入前に確認すべき料金と制限を見ていきます。
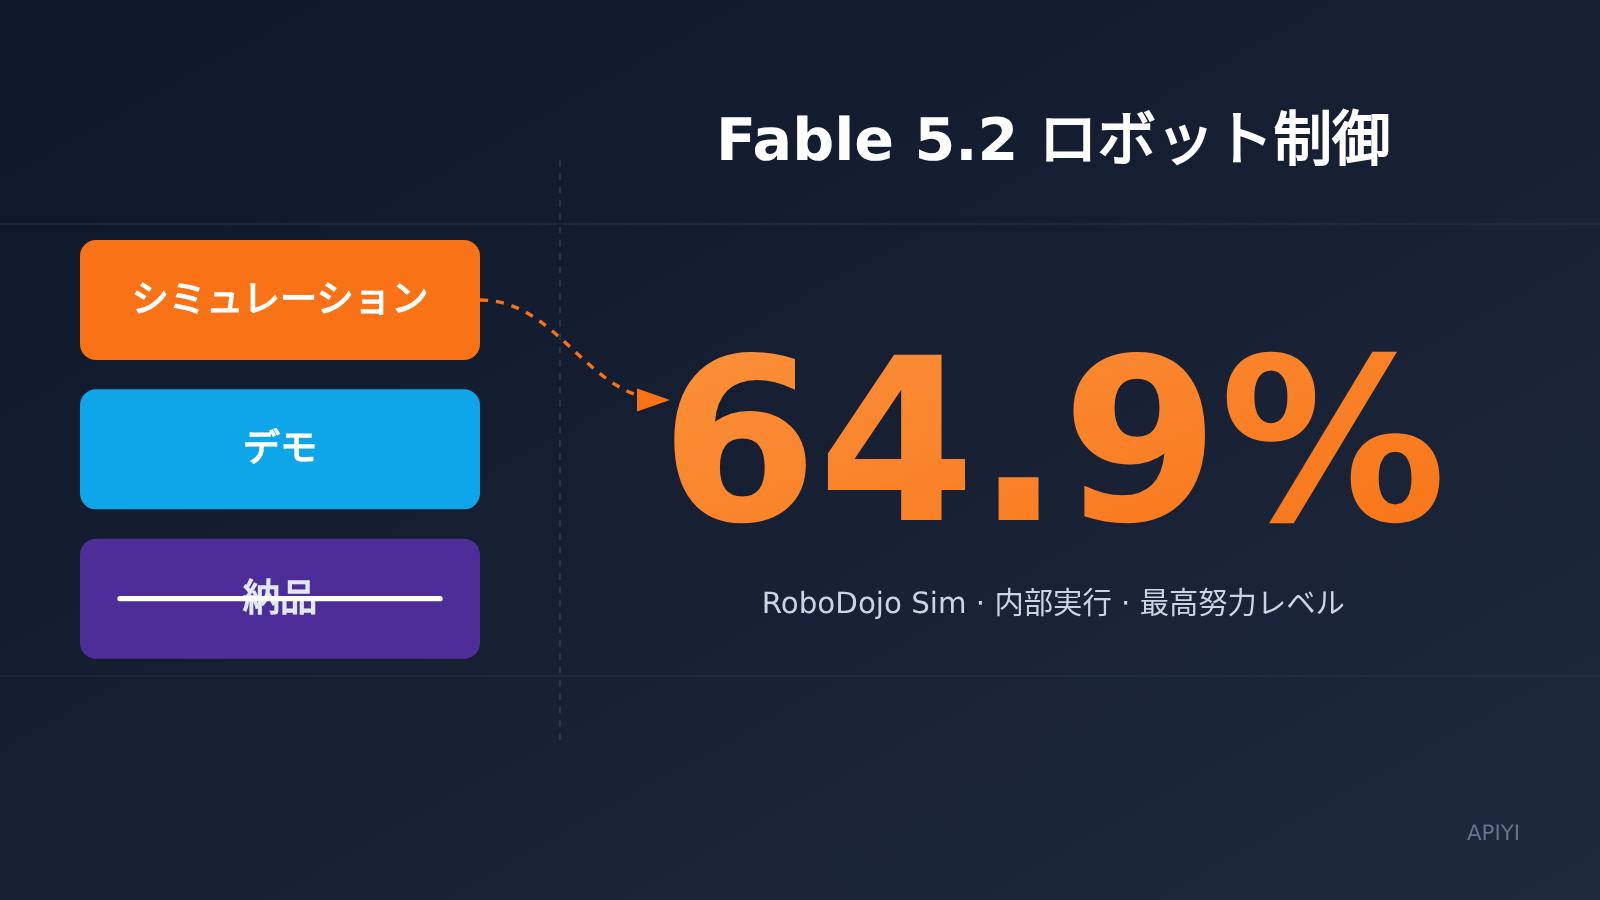
まず結論です。Anthropic社内で最高努力設定を使って実行したRoboDojo Simでは、Claude Fable 5.2が64.9%、Opus 5.5が39.4%、GPT-6 Astraが29.8%、Fable 5.1が27.6%でした。これは、モデルがカメラ画像を見ながらシミュレーション上の双腕ロボットを制御した結果であり、工場への導入実績ではありません。
これは「ロボットの時代が来た」とうたう宣伝記事ではありません。 以下では、シミュレーションのスコア、デモ動画、現実世界での導入を分けて解説します。APIの利用を検討していたり、コストを試算していたりする方は、読み終えるころには、この64.9%を理由に今すぐ技術方針を変えるべきか判断できるはずです。
この記事のポイント:Fable 5.2の64.9%が何を証明し、何を証明しないのか、そして現時点でどのモデルを前期検証に利用できるのかを整理します。
Claude Fable 5.2の64.9%とは何か
この数字は、3つのポイントで説明できます。RoboDojoは公開ベンチマークで、カメラ画像をもとに、シミュレーション環境内の双腕ロボットをモデルが制御できるかを測定します。発表文の脚注によると、64.9%はAnthropicが社内で実行し、利用可能な最高の努力レベルを使って得た結果です。2026-11-10時点で、RoboDojoの公開ランキングページでは同じ数字を確認できていません。そのため、「公開ランキング1位」と表現することはできず、「世界最強のロボットモデル」と言うのも適切ではありません。
以下は、Anthropicが2026-11-09の発表文で示したRoboDojo Simの比較結果です。
| モデル | RoboDojo Sim | Fable 5.2との差 | 説明 |
|---|---|---|---|
| Claude Fable 5.2 | 64.9% | — | 社内で実行、最高努力レベル |
| Claude Opus 5.5 | 39.4% | 25.5ポイント低い | 同じ表に掲載 |
| GPT-6 Astra | 29.8% | 35.1ポイント低い | Anthropicが実行した結果であり、OpenAIの自己申告ではない |
| Claude Fable 5.1 | 27.6% | 37.3ポイント低い | 前世代 |
| Gemini 4 Carbon | 表に記載なし | 比較できない | 数字がないため、0として扱うことはできない |
27.6%から64.9%へと、世代をまたいで2倍以上に向上しており、スコア表全体の中でも際立った伸びです。ただし、このスコアには3つの前提があります。シミュレーション環境であること、社内で実行されたこと、最高努力レベルを使っていることです。たとえば、実機での評価に変える、第三者が再検証する、あるいはデフォルトの努力レベルを使うなど、前提が1つでも変われば、この数字をそのまま当てはめることはできません。
Fable 5.2とMythos 5.2はどう違うのか
発表文では、Claude Fable 5.2とClaude Mythos 5.2は同じ基盤モデルだと明記されています。Fableには、より強力なサイバーセキュリティとバイオセーフティのガードレールが設けられているため、すべてのユーザーが利用できます。一方、Mythosを利用できるのは、ライフサイエンスまたはサイバーセキュリティの審査プログラムを通過した組織に限られます。Mythosは「別の、より強力なモデル」ではありません。ロボット分野の評価では、Fable 5.2を見れば十分です。
公式モデルIDは以下のとおりです。
- Claude API、Google Cloud、Microsoft Foundry、AWS上のClaude Platform:
claude-fable-5-2 - Amazon Bedrock:
anthropic.claude-fable-5-2 - Mythosに対応するID:
claude-mythos-5-2、anthropic.claude-mythos-5-2
Fable 5.2のロボット制御能力:デモで紹介された内容
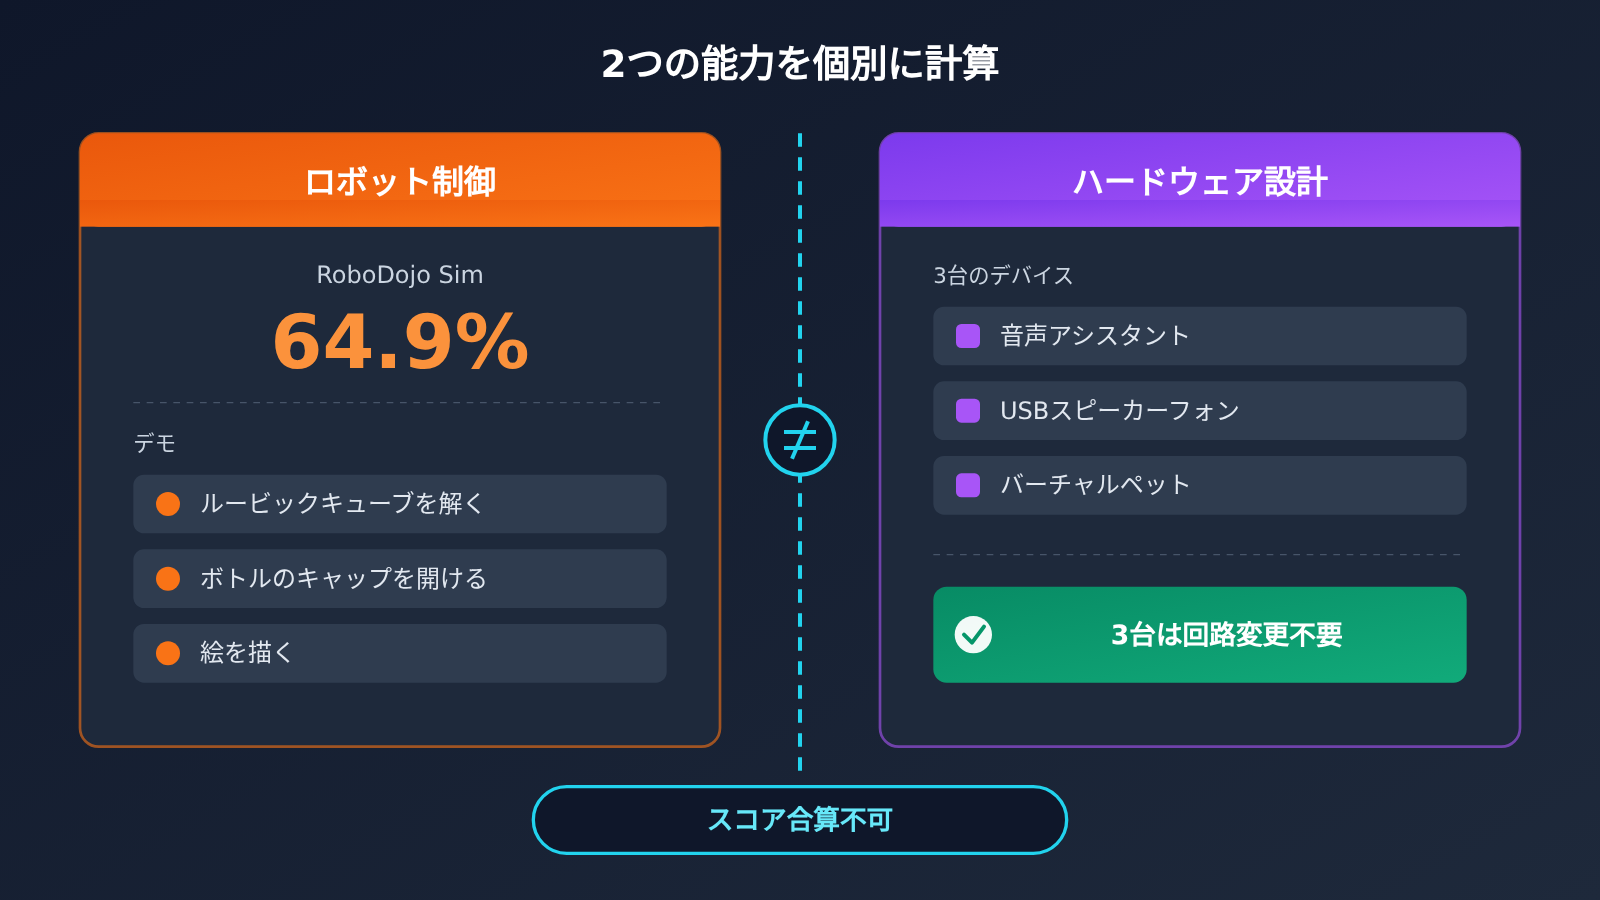
発表文によると、Fable 5.2の物理ロボットを制御する能力は、それ以前のClaudeより明らかに向上しており、専用のトレーニングを受けていないタスクもこなせるとのことです。公開されたデモ動画では、ルービックキューブを解く、瓶のふたを開ける、ロボットの絵を描くという3つの場面が紹介されています。
これらはあくまで「発表文に掲載されたデモ」として捉えるべきです。デモからわかるのは、モデルが特定の設定でこれらの動作を実行したことまでです。成功率や再試行回数、失敗の割合は明らかになっていません。また、Anthropicがそのままインストールできるロボット用スキルパッケージを公開したわけでもありません。専用のトレーニングを受けていないタスクが含まれているという公式の説明は注目に値しますが、独立した再現実験のデータが添えられていない以上、あくまで公式発表にとどまります。
発表文ではさらに、Fable 5.2は同じテストスイートで他の最先端モデルを上回り、ロボット制御専用に設計されたシステムの大半も超えたとしています。ただし、後半の主張には比較対象の一覧がなく、どのシステムのどのバージョンと比較したのかはわかりません。この発言は方向性を示すものとして受け止めるべきで、確定的な結論とは言えません。
モデルが出力するのはテキスト。制御は外部スイートが担う
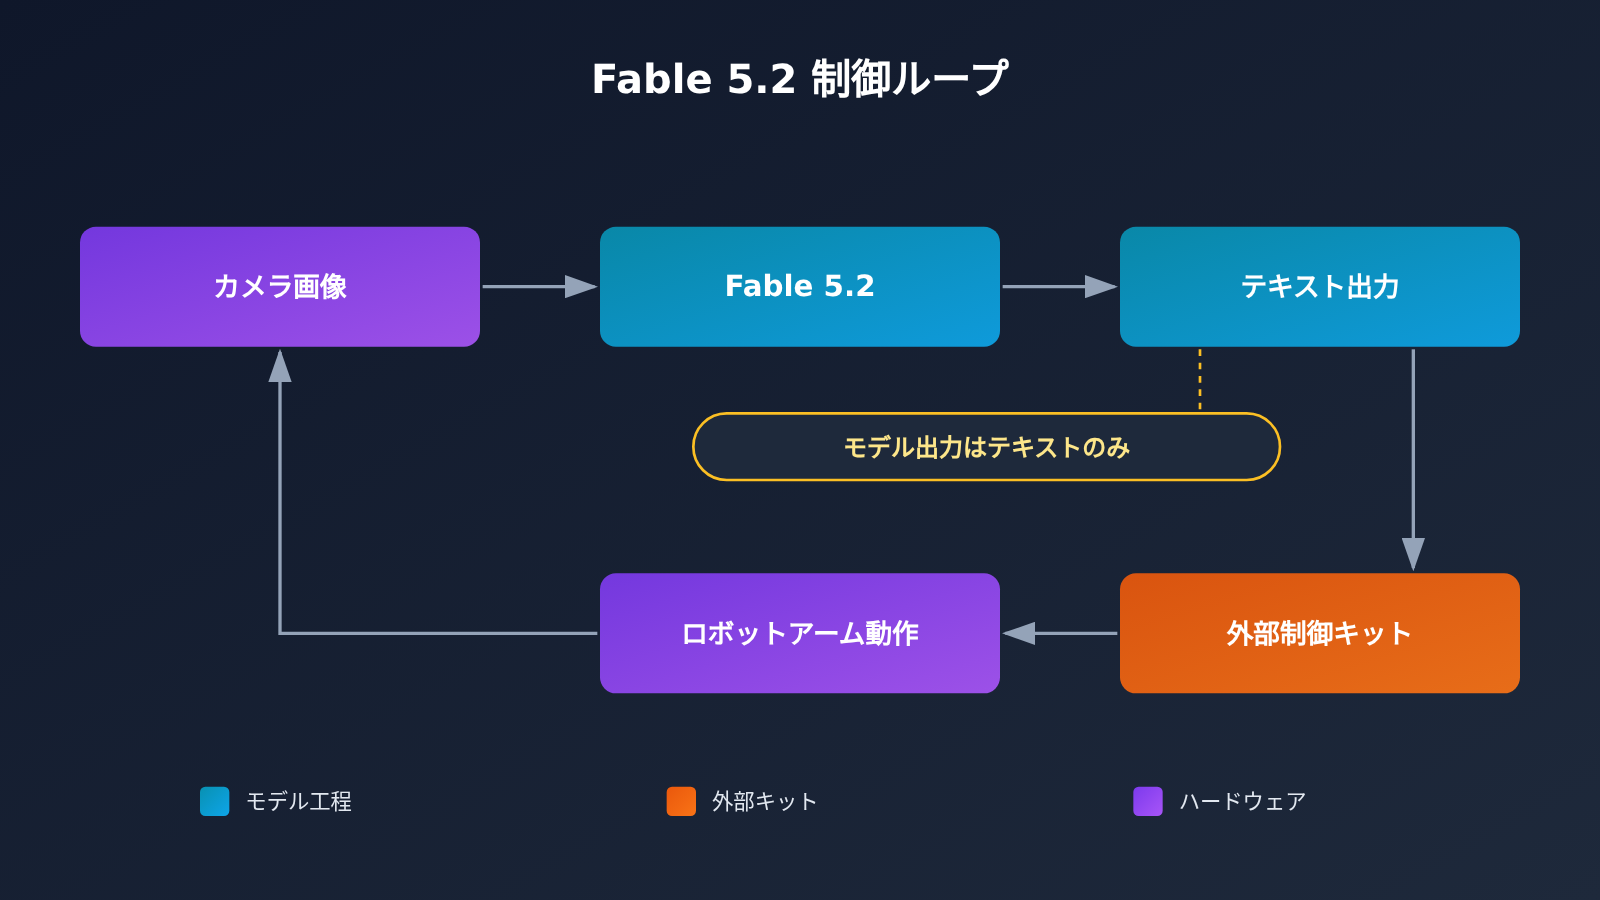
デモ動画では見落とされがちなポイントです。モデルのページによると、Fable 5.2が入力として受け取るのはテキストと画像で、出力はテキストのみです。モデルがモーターに直接指令を送るわけではありません。各ステップで、外部スイートがテキストを動作に変換し、新たに撮影したカメラ画像をモデルに返す必要があります。
そのため、実環境での制御性能はモデルだけでなく、利用するスイートにも左右されます。動作空間をどう定義するか、解析に失敗したときにどう対処するか、各ステップの遅延を許容できるか、といった点が重要です。RoboDojoの64.9%という数値は、Anthropic独自のスイートで測定されたものです。別のスイートを使った場合にスコアがどう変わるかは、現時点ではわかっていません。
Fable 5.2 の実測データ:ロボットとコンピューター操作では、性能差の大きさが違う
「Fable 5.2は非常に優秀」という話を聞くと、ロボット関連のスコアとほかの項目のスコアをまとめて捉えてしまいがちです。以下の表はすべて、Anthropicが2026-11-09に公開した記事のデータです。「操作」に関連するいくつかのテストで、性能差の大きさを比較しています。
| テスト項目 | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Fable 5.2のOpus 5.5に対するリード |
|---|---|---|---|---|
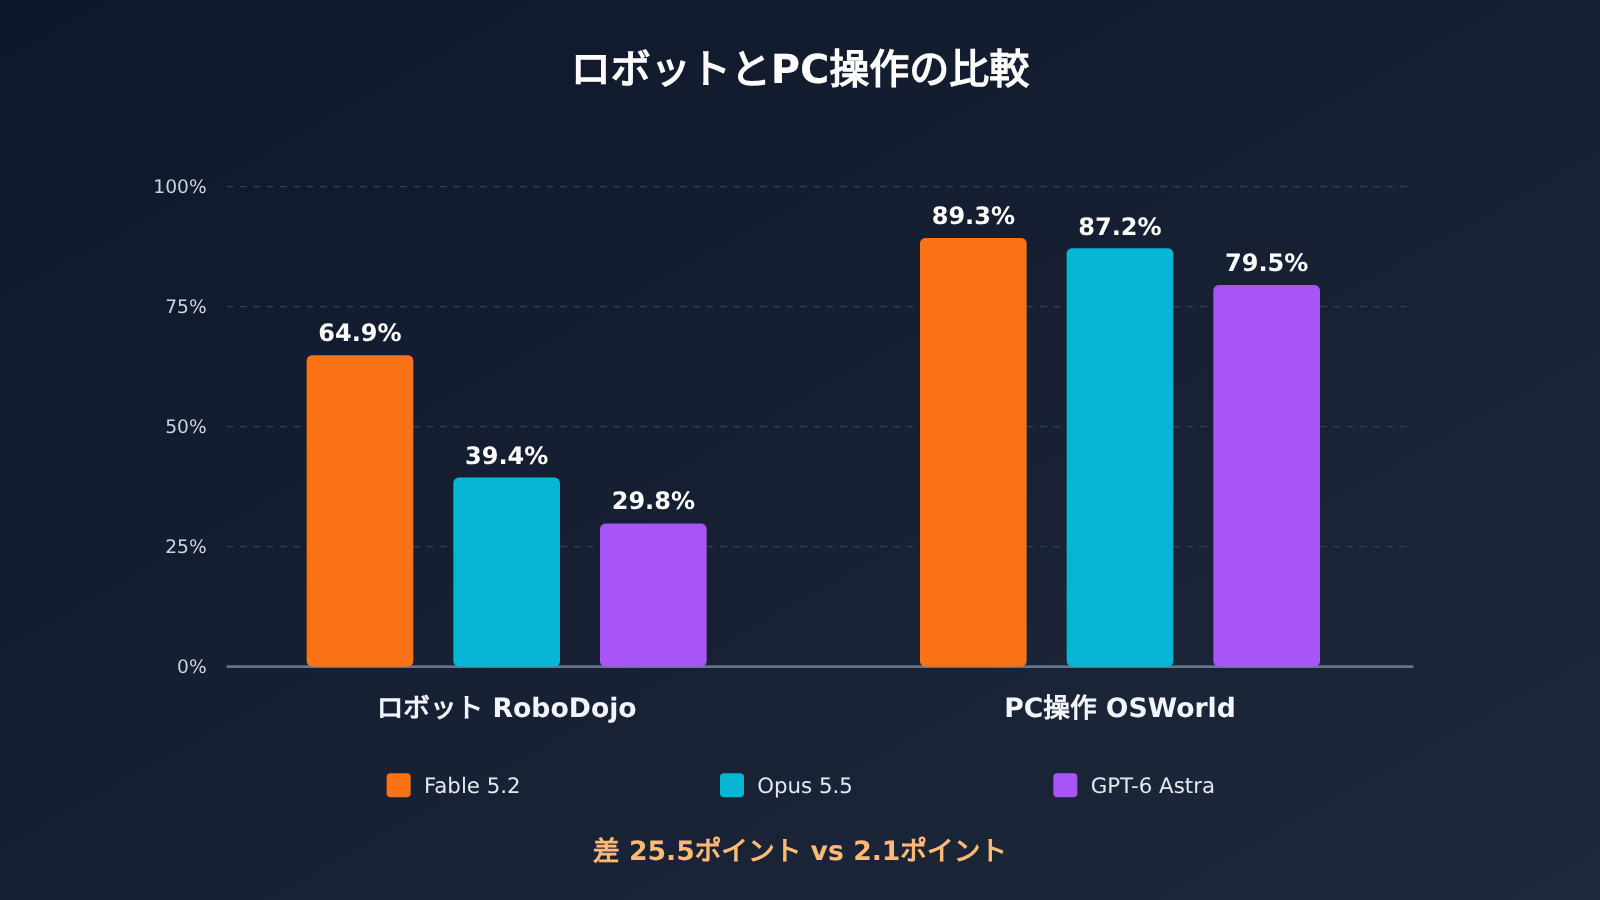
| RoboDojo Sim(双腕のシミュレーション) | 64.9% | 39.4% | 29.8% | 25.5ポイント |
| OSWorld 2.1(コンピューター操作、オフライン部分集合) | 89.3% | 87.2% | 79.5% | 2.1ポイント |
| AutomationBench | 51.4% | 42.5% | 41.4% | 8.9ポイント(Carbonは53.9%で、さらに高い) |
| Remote Labor Index(Highレベル) | 41.3% | 21.3% | 20.8% | 20.0ポイント |
OSWorld 2.1では、Fable 5.2のスコアはOpus 5.5をわずか2.1ポイント上回るだけです。RoboDojoで39.4%から64.9%へと開いた差とは、規模がまったく異なります。コンピューター操作を行うエージェントのタスクが目的なら、Opus 5.5とFable 5.2の差は、ロボット関連のテストほど大きくありません。
努力レベル:64.9%はデフォルト設定でのスコアではない
公開記事のスコア表は、特に記載がない限り、各モデルでその時点に利用できる最高の努力レベルを使用しています。Claude APIでのFable 5.2のデフォルトのeffortはhighですが、ClaudeアプリとClaude CodeではMediumがデフォルトです。つまり、デフォルトのパラメーターで呼び出した場合、64.9%を記録した設定と同じ条件になるとは限りません。
最高レベルでは、より長く思考し、より多くのトークンを使います。繰り返し判断を求められるロボットの制御ループでは、各ステップで最高レベルの推論を行うと、遅延とコストが大きくなります。64.9%のスコアがhighまたはmediumレベルでどこまで下がるかについては、公開記事に記載がありません。
仕様の比較:Fable 5.2、Opus 5.5、GPT-6 Astra
| 項目 | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| コンテキスト | 1M | 1M | 1,050,000 |
| 最大出力 | 128K | 128K | 128,000 |
| 入力/出力モダリティ | テキスト + 画像/テキスト | テキスト + 画像/テキスト | テキスト + 画像/テキスト |
| APIのデフォルト努力レベル | high | medium | lowからmaxまで対応 |
| レイテンシレベル | Moderate | Moderate | 公式ページでは同じ基準での記載なし |
| 知識のカットオフ | 2026年6月 | 2026-06 | 2026-04-30 |
3モデルはいずれも出力がテキストです。ロボット制御を行ううえで、これは避けて通れない共通の前提です。
Fable 5.2のロボットスコアに含めてはいけない実績
3台の電子機器はハードウェア設計の実験
発表記事には、もう1つの事例が紹介されています。短いプロンプトを使って、Fable 5.2に動作する電子機器を3台設計させました。家庭用音声アシスタント、USBスピーカーフォン、携帯型バーチャルペットの3台です。このプロジェクトはDiodeとの共同開発で、各回路基板は1日もかからずに製造でき、3台とも回路を変更せずに動作しました。
これはハードウェア設計の能力を示すもので、RoboDojoとは関係ありません。また、これらの機器自体もロボットではありません。64.9%というスコアと並べると、「設計から制御まで一手に担える」という印象を与えかねませんが、この2つの実績に関連性はありません。
Fable 5.2の能力の限界:制御ループに影響する制約
以下はモデルのページと更新情報に記載された内容です。どの項目も、構築する制御ループに直接影響します。
- ツール呼び出しの強制はエラーになる:
tool_choiceをanyまたはtoolに設定すると、400が返ります。「必ずアクションツールを呼び出す」仕組みに依存している場合は、モデルが自ら選択できるようにし、解析時のフォールバックを用意する必要があります。 - サンプリングパラメーターは設定できない:
temperature、top_p、top_kを渡すと、400が返ります。 - 思考を無効にできない:アダプティブ思考は常に有効で、思考量は
effortで調整するしかありません。更新情報によると、medium以上の設定では、プロンプトに「考えずに、すぐ回答してください」と書いても、思考を止めることはできません。 - ツールチェーンが長いと、発話が少なくなる:ツールを連続して呼び出すと、ユーザー向けの出力が少なくなったり、説明なしにツールを呼び出したりすることがあります。監視画面は、モデルが自発的に進捗を報告することを前提にできません。
- 途中で停止することがある:1ターンで終了し、未完了タスクのリストを残すことがあります。また、よくある障害に阻まれて止まる場合もあります。lowの設定で起こりやすい傾向があります。
- 拒否応答も利用枠を消費する:拒否時もHTTP 200が返り、
stop_reasonはrefusalになります。レート制限の枠も消費します。 - データの保持:データは30日間保持されます。Anthropicから明示的な許可を得ない限り、ゼロデータ保持は利用できません。
ロボットの制御ループでは、各ステップで実行可能なアクションが返ってくることが強く求められます。上記の制約を踏まえると、モデルを制御ループに組み込む前に、タイムアウト、空のアクション、拒否、中途停止を復旧可能な状態として設計しておく必要があります。
Fable 5.2の価格:導入前にコストを確認
公式価格は100万トークンあたりの料金です。モデルページ、更新情報、クイックモードのページを参照しています。
| 課金項目 | Fable 5.2 | Opus 5.5 | GPT-6 Astra(短いコンテキスト) |
|---|---|---|---|
| 標準入力 / 出力 | $8 / $40 | $4 / $20 | $10 / $50 |
| キャッシュ読み取り | $0.20 | $0.20 | $1(キャッシュ入力) |
| キャッシュ書き込み | 5分 $10、1時間 $16 | 公式ページには記載あり。本記事では省略 | $12.5 |
| バッチ処理 | 5割引で $4 / $20 | 同じく5割引 | 本記事では省略 |
| クイックモード | $16 / $80 | $8 / $40 | — |
ほかにも、いくつか注意点があります。Fable 5.2はFable 5.1($10 / $50)より20%安くなっています。クイックモードの機能は変わらず、出力速度は標準モードの最大2.5倍ですが、公式はクイックモードのキャッシュ料金を個別に公表していません。倍率から推定すると、キャッシュ読み取りは約$0.40、5分間のキャッシュ書き込みは約$20、1時間は約$32です。速度モードが異なるとプロンプトキャッシュは共有されないため、クイックモードから標準モードに切り替えるとキャッシュミスが発生します。GPT-6 Astraは入力が272Kトークンを超えると、注文全体に対して入力は2倍、出力は1.5倍の料金が適用されます。
ロボットのループ処理では、各ステップで新しい画像を1枚送信する一方、システムプロンプトや動作の説明はほぼ変わりません。このような構成では、キャッシュを使ってコストを抑えられます。ただし、各ステップの画像入力と推論トークンは削減できません。
現在、Fable 5.2は利用できますか?:APIYIでの提供状況
2026-11-10時点で、APIYI(apiyi.com)のモデル一覧と公開価格APIには、claude-fable-5-2も、Mythosシリーズのモデルも掲載されていません。このモデルはできるだけ早く提供開始する予定です。モデルIDと価格は、プラットフォームのモデル一覧をご確認ください。 提供開始前のため、この記事ではFable 5.2のAPIYIでの価格は紹介せず、グループ別倍率を使った公式価格の換算も行いません。
同日時点で、APIYIのモデル一覧から利用できる関連モデルは次のとおりです(一覧に記載された価格、単位:米ドル/100万トークン)。
| モデルID | 入力/出力 | キャッシュ読み込み | エンドポイント | 主な用途 |
|---|---|---|---|---|
claude-opus-5-5、claude-opus-5-5-thinking |
$4 / $20 | $0.2 | chat、messages | ツール呼び出しやコンピューター操作の一連の処理をまず構築する |
claude-fable-5-1、claude-fable-5-1-thinking |
$10 / $50 | $0.25 | chat、messages | ひとつ前の世代との比較基準にする |
claude-fable-5、claude-fable-5-thinking |
$10 / $50 | $1 | chat、messages | 過去バージョンとの比較 |
gpt-6-astra |
$10 / $50 | $1 | responses(主)、chat | 他社モデルとの比較 |
モデル一覧に記載されているのは表示価格です。実際の請求額にはトークングループごとの倍率が適用されるため、請求明細をご確認ください。gpt-6-astraの脚注には入力の価格区分のみが記載されています(272,000トークン以下は$10、272,001~1,050,000トークンは$20)。長いコンテキストでの出力価格は記載されていないため、コンソールの請求明細をご確認ください。OpenAI互換インターフェースを利用する場合は、base_urlにhttps://api.apiyi.com/v1を設定すれば接続できます。
現実的な進め方としては、まずclaude-opus-5-5で画像入力、アクション解析、エラーからの復旧までの流れを構築し、Fable 5.2がAPIYIで提供されたら、モデルIDを切り替えて比較するのがおすすめです。ロボット分野の差(25.5ポイント)は、コンピューター操作(2.1ポイント)よりもかなり大きいため、Fable 5.2の提供を待つ価値はあります。ただし、デモ動画だけで判断するのは不十分です。
Fable 5.2のロボット操作能力:強みと弱み
強み
- 世代間の伸びが大きい:RoboDojo Simは27.6%から64.9%に向上しており、スコア表の中でも特に伸びが大きい項目の一つです。
- 同クラスのモデルを大きくリード:Anthropicの発表文によると、Opus 5.5を25.5ポイント、GPT-6 Astraを35.1ポイント上回っています。
- 料金が低下:標準料金は5.1より20%安く、キャッシュ読み取りは$0.20です。
- 視覚入力の条件が一貫:画像入力に対応し、コンテキストウィンドウは100万トークンです。長い複数ステップの視覚履歴も扱えます。
限界
- 根拠の信頼性に限りがある:社内での実行結果で、最高の努力レベルにおける数値です。公開ベンチマークでは同じ数値を確認できず、独立した再検証もありません。
- シミュレーションデータのみ:デモ動画には成功率が示されていません。また、「大半の専用ロボットシステムを上回る」という主張にも、比較対象の一覧はありません。
- 実行ループに多くの制約がある:出力はテキストのみで、ツール呼び出しを強制できません。思考を無効化できず、長い処理の途中で自発的に状況を説明することもほとんどありません。
- 最高レベルではコストが高い:スコアは最高の努力レベルで測定されています。実際に導入する場合は、遅延とトークン消費量を自分で測定する必要があります。
これを根拠にモデルを切り替えるべきではないケース
独自のシミュレーション環境や実機の制御ループがなければ、この64.9%という数値を自分で検証できません。つまり、自分の環境でも同じ結果が出るかどうかは確認できません。また、サイバーセキュリティ、生物関連、日常的なコーディングが目的なら、このスコアは判断材料になりません。それぞれの用途に対応したテスト項目を確認してください。発表文では、コーディングや知識労働の大半はまずOpus 5.5から始め、難易度に応じて上位または下位のモデルに切り替えることを推奨しています。
よくある質問(FAQ)
Q1: Fable 5.2 の 64.9% は公開ベンチマークのスコアですか?
いいえ。発表文の脚注には、Anthropic が社内で実行した結果だと記載されています。RoboDojo 自体は公開ベンチマークですが、2026-11-10 時点で、公開ランキングページから同じ数値を確認することはできませんでした。
Q2: 64.9% はデフォルトの努力レベルでのスコアですか?
いいえ。利用可能な最高の努力レベルでのスコアです。Claude API のデフォルトは high、Claude アプリと Claude Code のデフォルトは Medium です。デフォルト設定で何点を獲得できるかは、発表文に記載されていません。
Q3: Fable 5.2 は、ロボット専用のシステムを上回ったのですか?
発表文では「ロボット制御専用に開発されたシステムの大半」を上回ったとしていますが、対象の一覧は示されていません。具体的にどのシステムを上回ったのかは、現時点では分かりません。
Q4: Gemini 4 Carbon の RoboDojo スコアがないのはなぜですか?
発表文の表では該当欄が空白で、理由は説明されていません。空白だからといって 0 点とは限らず、性能を推測する根拠にもなりません。
Q5: 今のうちに API で準備を進めるにはどうすればよいですか?
2026-11-10 時点で、APIYI(apiyi.com)ではまだ `claude-fable-5-2` を提供していません。このモデルはできるだけ早く提供する予定です。モデル名と価格は、プラットフォームのモデル一覧でご確認ください。まずは提供中の `claude-opus-5-5` を使って画像入力とツール呼び出しの一連の処理を確認し、提供開始後にモデルを切り替えて比較する方法があります。
Q6: 3台の電子機器は、ロボットを制御できる証拠になりますか?
なりません。音声アシスタント、USBスピーカー電話、バーチャルペットは、Diode と共同で取り組んだハードウェア設計の実験です。回路設計の能力に関するものであり、RoboDojo の両腕制御スコアとは関係ありません。
Q7: コンピューター操作エージェントは Fable 5.2 を待つべきですか?
待つ必要性はあまり高くありません。OSWorld 2.1 でのスコアは Fable 5.2 が 89.3%、Opus 5.5 が 87.2% で、差は 2.1 ポイントです。一方、Opus 5.5 の標準価格は Fable 5.2 の半額です。
Fable 5.2 ロボット能力の要点
- スコアの意味:64.9%は、社内環境で最高の努力レベルに設定して実行した、シミュレーション上の両腕操作の成績です。
- 差の大きさ:Opus 5.5を25.5ポイント、GPT-6 Astraを35.1ポイント上回っています。
- 比較項目:OSWorldでのリードはわずか2.1ポイントです。この2種類の差を混同しないようにしましょう。
- デモの位置づけ:ルービックキューブを解く、ボトルキャップを回す、絵を描くといった例は、発表記事で紹介されたデモであり、製品化された機能ではありません。
- 制御ループ上の制約:出力はテキストのみです。
tool_choiceを強制すると400エラーが返り、思考を無効にすることもできません。 - 提供状況:2026-11-10時点で、APIYIではまだ提供されていません。先に
claude-opus-5-5を使って制御ループを構築できます。
まとめ
Claude Fable 5.2がロボット制御で進歩したことは、確かな兆候として表れています。RoboDojo Simのスコアは前世代の27.6%から64.9%に向上し、Anthropicが示した比較対象を大きく上回りました。ただし、この数字が当てはまる範囲は限られています。対象はシミュレーション環境での社内実行、かつ最高の努力レベルに限られ、実機での成功率や工場への導入能力を示すものではありません。
すでに独自のシミュレーション環境や実機の制御ループがある場合は、Fable 5.2の提供開始後に比較テストを行う価値があります。その際は、テキスト出力の解析、ツール呼び出しを強制できないこと、思考を無効にできないことといった制約も、あらかじめ設計に織り込んでおきましょう。制御ループがまだない場合や、解決したい課題がコーディングやコンピューター操作に関するものであれば、この64.9%を理由に既存の構成を変更する必要はありません。
著者:APIYI技術チーム
技術に関するお問い合わせ:APIYI(apiyi.com)のトップページからお気軽にご連絡ください。モデルの提供状況は、プラットフォームのモデル一覧をご確認ください。


