
Catatan penulis: Mengulas angka 64,9% Claude Fable 5.2 di RoboDojo Sim: dalam kondisi apa angka itu diperoleh, seberapa jauh selisihnya dari Opus 5.5 dan GPT-6 Astra, apa yang tidak bisa dibuktikannya, serta harga dan batasan yang perlu diperhitungkan sebelum integrasi.
Kesimpulannya: dalam pengujian internal Anthropic di RoboDojo Sim dengan tingkat upaya tertinggi, Claude Fable 5.2 meraih 64,9%, Opus 5.5 meraih 39,4%, GPT-6 Astra meraih 29,8%, dan Fable 5.1 meraih 27,6%. Ini adalah hasil model yang melihat gambar dari kamera dan mengendalikan sepasang lengan robot dalam simulasi—bukan catatan penerapan di pabrik.
Ini bukan artikel promosi yang menyatakan “era robot telah tiba”. Di bawah ini, kita akan membahas secara terpisah skor simulasi, video demonstrasi, dan penerapan di dunia nyata. Jika Anda sedang bersiap mengintegrasikan API dan menghitung biaya, setelah membaca artikel ini Anda bisa menilai apakah angka 64,9% ini memang layak dijadikan alasan untuk mengubah arah teknis sekarang.
Inti pembahasan: Memahami apa yang dibuktikan dan tidak dibuktikan oleh angka 64,9% Fable 5.2, serta model mana yang bisa dipanggil sekarang untuk validasi awal.
Apa arti angka 64,9% pada Claude Fable 5.2?
Angka ini bisa dijelaskan dalam tiga kalimat. RoboDojo adalah tolok ukur publik untuk menguji kemampuan model mengendalikan robot berlengan dua di lingkungan simulasi berdasarkan gambar dari kamera. Catatan kaki dalam pengumuman menyebutkan bahwa angka 64,9% diperoleh Anthropic melalui pengujian internal dengan tingkat upaya tertinggi yang tersedia. Hingga 2026-11-10, kami belum bisa memverifikasi angka yang sama di halaman papan peringkat publik RoboDojo. Jadi, angka ini tidak bisa disebut sebagai “peringkat pertama di papan publik”, apalagi sebagai “model robotika terkuat di dunia”.
Berikut perbandingan RoboDojo Sim yang dicantumkan Anthropic dalam pengumuman pada 2026-11-09:
| Model | RoboDojo Sim | Selisih dari Fable 5.2 | Keterangan |
|---|---|---|---|
| Claude Fable 5.2 | 64,9% | — | Pengujian internal, tingkat upaya tertinggi |
| Claude Opus 5.5 | 39,4% | Lebih rendah 25,5 poin | Tercantum dalam tabel yang sama |
| GPT-6 Astra | 29,8% | Lebih rendah 35,1 poin | Diuji oleh Anthropic, bukan dilaporkan sendiri oleh OpenAI |
| Claude Fable 5.1 | 27,6% | Lebih rendah 37,3 poin | Generasi sebelumnya |
| Gemini 4 Carbon | Kosong di tabel | Tidak bisa dibandingkan | Tidak ada angka; jangan dianggap 0 |
Peningkatan dari 27,6% ke 64,9% berarti lebih dari dua kali lipat dibanding generasi sebelumnya. Selisih ini sangat mencolok di seluruh tabel hasil. Namun, angka ini bergantung pada tiga kondisi: lingkungan simulasi, pengujian internal, dan tingkat upaya tertinggi. Jika salah satu kondisi berubah—misalnya pengujian dilakukan dengan robot sungguhan, diuji ulang oleh pihak ketiga, atau menggunakan tingkat upaya bawaan—angka tersebut tidak bisa langsung disamakan.
Apa hubungan Fable 5.2 dengan Mythos 5.2?
Pengumuman tersebut menjelaskannya dengan gamblang: Claude Fable 5.2 dan Claude Mythos 5.2 menggunakan model dasar yang sama. Fable memiliki perlindungan keamanan siber dan keamanan hayati yang lebih ketat, sehingga tersedia untuk semua pengguna. Mythos hanya tersedia bagi organisasi yang lolos proses verifikasi untuk program ilmu hayati atau keamanan siber. Mythos bukan “model lain yang lebih kuat”. Untuk mengevaluasi kemampuan robotika, cukup lihat Fable 5.2.
ID model resmi:
- Claude API, Google Cloud, Microsoft Foundry, Claude Platform on AWS:
claude-fable-5-2 - Amazon Bedrock:
anthropic.claude-fable-5-2 - ID untuk Mythos:
claude-mythos-5-2dananthropic.claude-mythos-5-2
Fungsi utama Fable 5.2 untuk mengendalikan robot: apa saja yang ada dalam demo
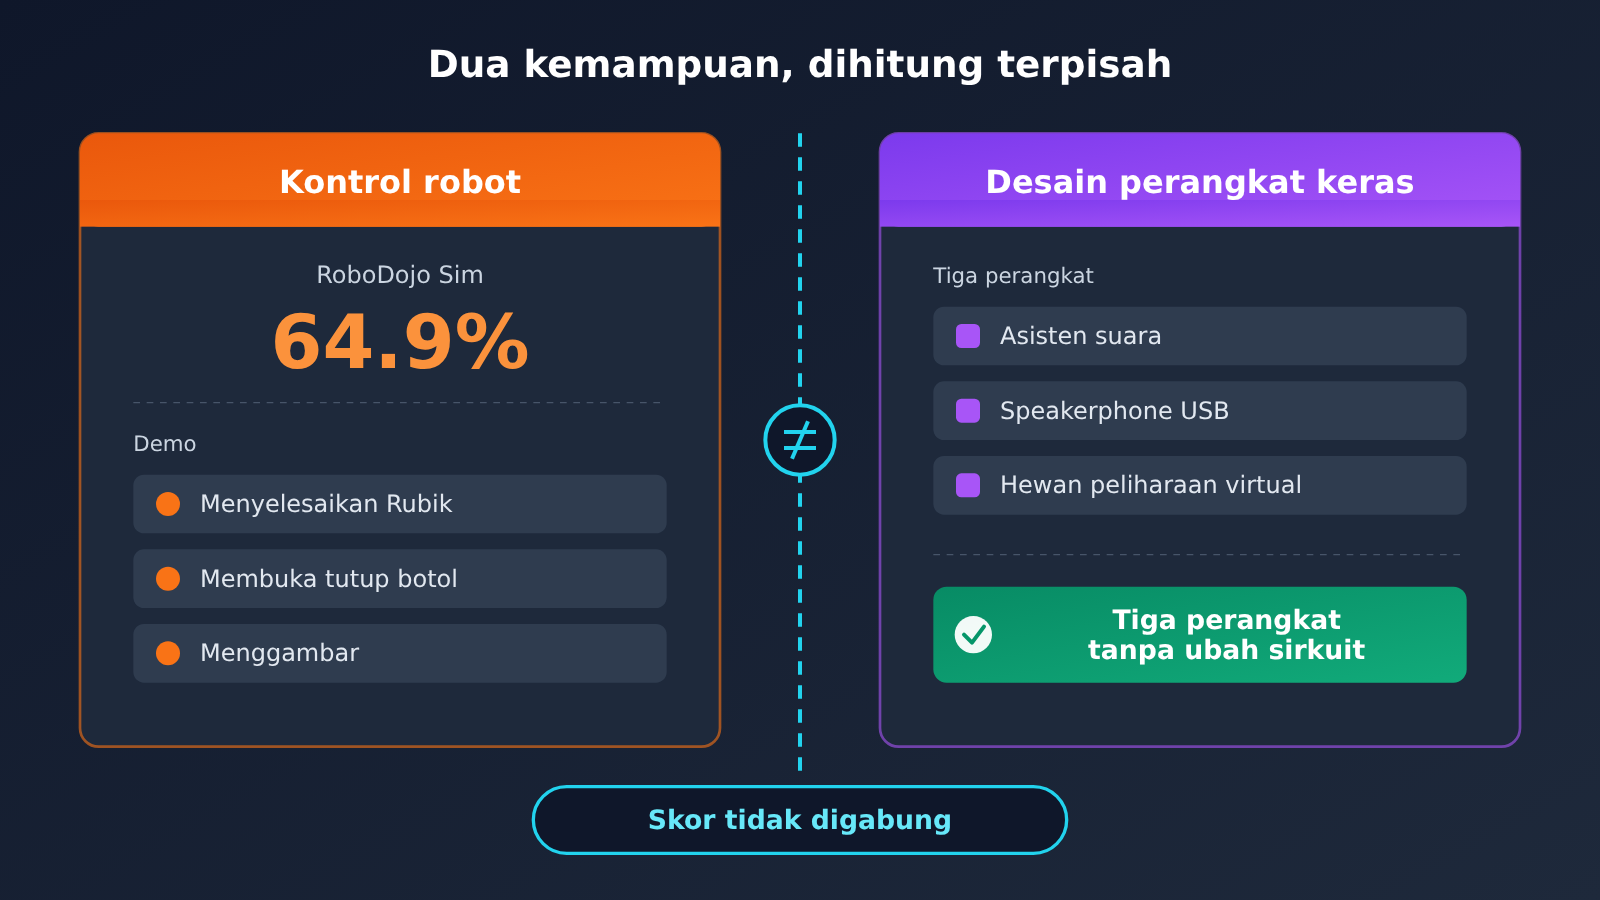
Menurut postingan peluncurannya, kemampuan Fable 5.2 dalam mengendalikan robot fisik jauh lebih baik dibandingkan Claude versi sebelumnya, termasuk untuk tugas yang tidak dilatih secara khusus. Video demo yang menyertainya menampilkan tiga skenario: memecahkan Rubik, membuka tutup botol, dan menggambar robot.
Konten ini sebaiknya dipahami sebagai “demo dalam postingan peluncuran”. Demo menunjukkan bahwa model pernah menyelesaikan tindakan-tindakan ini dalam pengaturan tertentu, tetapi tidak menjelaskan tingkat keberhasilan, jumlah percobaan ulang, ataupun proporsi kegagalan. Demo itu juga bukan berarti Anthropic telah merilis paket keterampilan robot yang bisa langsung dipasang. Pernyataan resmi bahwa beberapa tugas tersebut belum pernah dilatih secara khusus memang menarik, tetapi itu tetap merupakan klaim dari pihak perusahaan, tanpa data replikasi independen.
Postingan tersebut juga menyebutkan bahwa Fable 5.2 mengungguli model-model terdepan lainnya dalam rangkaian pengujian yang sama, serta melampaui sebagian besar sistem yang dirancang khusus untuk mengendalikan robot. Klaim kedua tidak disertai daftar, sehingga pembaca tidak tahu sistem mana yang dibandingkan atau versi apa yang digunakan. Pernyataan ini bisa dianggap sebagai sinyal arah, tetapi bukan kesimpulan.
Model mengeluarkan teks, kendali dilakukan oleh toolkit eksternal
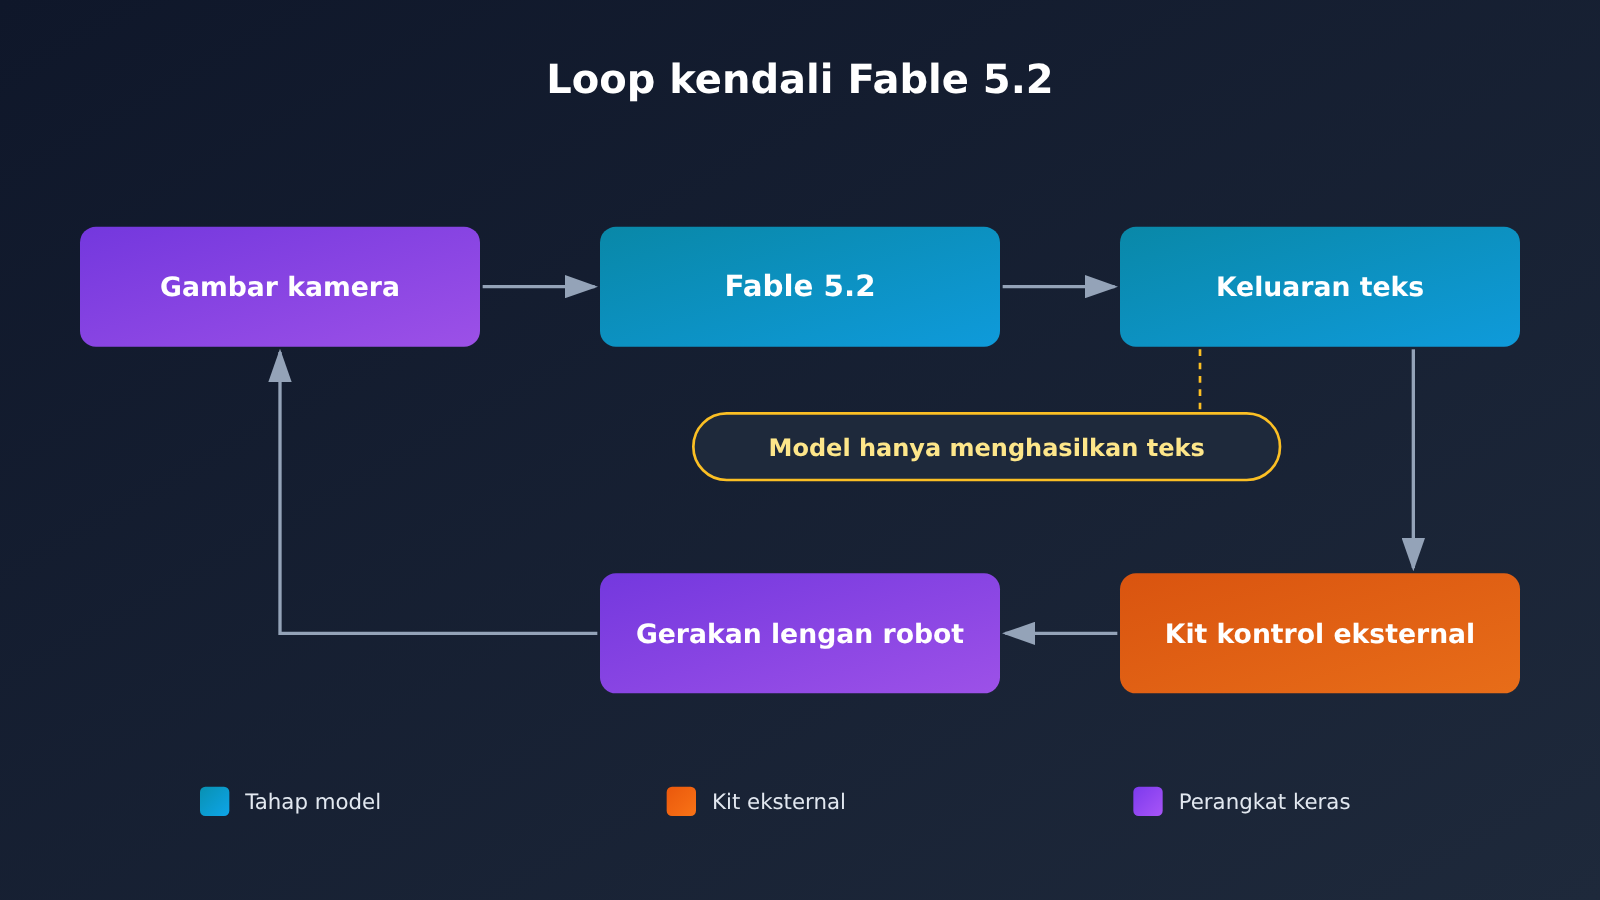
Inilah hal yang paling mudah tersamarkan oleh video demo. Halaman model menyebutkan bahwa Fable 5.2 menerima teks dan gambar, tetapi hanya mengeluarkan teks. Model tidak mengirimkan perintah motor secara langsung. Pada setiap langkah, toolkit eksternal harus mengubah teks menjadi tindakan, lalu mengirimkan kembali gambar kamera terbaru ke model.
Jadi, dalam situasi nyata, efektivitas kendali bergantung pada model dan toolkit yang digunakan: bagaimana ruang tindakan didefinisikan, bagaimana menangani kegagalan penguraian, dan apakah latensi per langkah masih dapat diterima. Skor 64,9% RoboDojo diperoleh dengan toolkit milik Anthropic sendiri. Belum diketahui bagaimana skor itu akan berubah jika menggunakan toolkit lain.
Data pengujian Fable 5.2: Perbedaan pada robotika dan pengoperasian komputer tidaklah sama
Banyak orang melihat klaim “Fable 5.2 sangat kuat”, lalu menganggap skor robotika dan skor di bidang lain bisa dibandingkan begitu saja. Tabel berikut seluruhnya bersumber dari pengumuman Anthropic pada 2026-11-09. Tabel ini membandingkan besarnya selisih pada beberapa pengujian yang berkaitan dengan “kendali”:
| Pengujian | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Keunggulan Fable 5.2 atas Opus 5.5 |
|---|---|---|---|---|
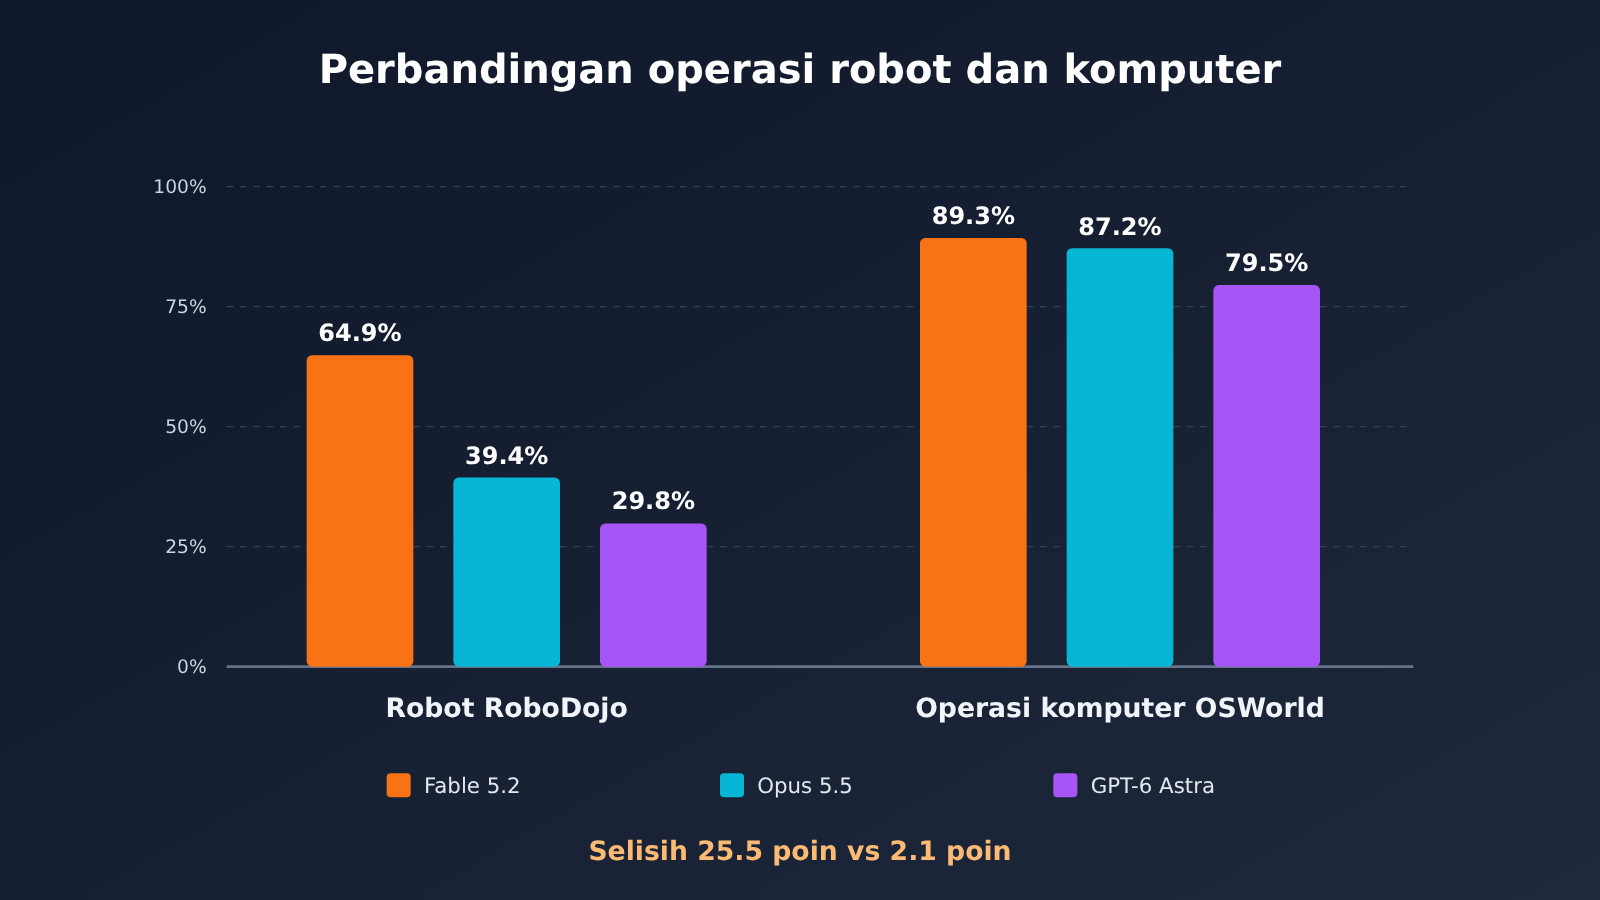
| RoboDojo Sim(simulasi dua lengan) | 64.9% | 39.4% | 29.8% | 25.5 poin |
| OSWorld 2.1(pengoperasian komputer, bagian set offline) | 89.3% | 87.2% | 79.5% | 2.1 poin |
| AutomationBench | 51.4% | 42.5% | 41.4% | 8.9 poin(Carbon mencapai 53.9%, lebih tinggi) |
| Remote Labor Index(tingkat High) | 41.3% | 21.3% | 20.8% | 20.0 poin |
Di OSWorld 2.1, skor Fable 5.2 hanya 2.1 poin lebih tinggi daripada Opus 5.5. Selisih ini tidak sebanding dengan lonjakan dari 39.4% ke 64.9% di RoboDojo. Jika kebutuhan Anda adalah tugas agen untuk mengoperasikan komputer, perbedaan antara Opus 5.5 dan Fable 5.2 jauh lebih kecil dibandingkan pada pengujian robotika.
Tingkat effort: 64.9% bukan hasil pada tingkat default
Kecuali dinyatakan lain, tabel hasil dalam pengumuman menggunakan tingkat effort tertinggi yang tersedia untuk setiap model saat itu. Tingkat effort default Fable 5.2 di Claude API adalah high, sedangkan di aplikasi Claude dan Claude Code adalah Medium. Artinya, jika Anda menggunakan parameter default, konfigurasi yang digunakan belum tentu sama dengan konfigurasi yang menghasilkan skor 64.9%.
Tingkat tertinggi berarti proses berpikir lebih lama dan penggunaan token lebih banyak. Dalam proses robotika yang membutuhkan keputusan berulang, menggunakan penalaran tingkat tertinggi di setiap langkah akan memperbesar latensi dan biaya. Pengumuman tersebut tidak menyebutkan berapa skor 64.9% jika menggunakan tingkat high atau medium.
Perbandingan spesifikasi: Fable 5.2, Opus 5.5, dan GPT-6 Astra
| Aspek | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Jendela konteks | 1M | 1M | 1,050,000 |
| Output maksimum | 128K | 128K | 128,000 |
| Modalitas input / output | Teks + gambar / teks | Teks + gambar / teks | Teks + gambar / teks |
| Tingkat effort default API | high | medium | Mendukung low hingga max |
| Tingkat latensi | Moderate | Moderate | Halaman resmi tidak menggunakan tolok ukur yang sama |
| Batas pengetahuan | Juni 2026 | 2026-06 | 2026-04-30 |
Ketiganya menghasilkan teks. Ini adalah batasan yang sama-sama harus diperhitungkan saat digunakan untuk mengendalikan robot.
Hal yang Tidak Bisa Dihitung sebagai Skor Robot Fable 5.2
Tiga perangkat elektronik adalah eksperimen desain perangkat keras
Dalam pengumuman tersebut, ada bagian lain: dengan satu petunjuk berupa paragraf, Fable 5.2 diminta merancang tiga perangkat elektronik yang berfungsi, yaitu asisten suara rumah, speaker ponsel USB, dan hewan peliharaan virtual genggam. Proyek ini dikerjakan bersama Diode. Setiap papan sirkuit dapat diproduksi dalam waktu kurang dari sehari, dan ketiga perangkat berfungsi tanpa perlu modifikasi rangkaian.
Hal ini menunjukkan kemampuan desain perangkat keras, bukan kemampuan yang berkaitan dengan RoboDojo. Perangkatnya sendiri juga bukan robot. Menempatkan pencapaian ini berdampingan dengan angka 64,9% bisa memberi kesan bahwa model mampu menangani semuanya, dari desain hingga kendali. Padahal, keduanya tidak saling berkaitan.
Batas kemampuan Fable 5.2: keterbatasan yang memengaruhi loop kendali
Informasi berikut berasal dari halaman model dan catatan pembaruan. Setiap poin berdampak langsung pada loop kendali yang kamu bangun:
- Pemanggilan alat wajib akan menghasilkan error: Jika
tool_choicediatur keanyatautool, permintaan akan mengembalikan kode 400. Jika toolkit kamu bergantung pada “alat aksi yang harus dipanggil”, ubah agar model bisa memilih sendiri, lalu siapkan penguraian sebagai langkah cadangan. - Parameter sampling tidak bisa diatur: Mengirim
temperature,top_p, atautop_kakan menghasilkan kode 400. - Mode berpikir tidak bisa dimatikan: Mode berpikir adaptif selalu aktif; jumlah pemikiran hanya bisa diatur melalui
effort. Catatan pembaruan menyebutkan bahwa pada tingkat medium atau lebih tinggi, menulis “jangan berpikir, langsung jawab” di petunjuk tetap tidak akan menghentikan model berpikir. - Jarang memberi kabar saat menjalankan rantai alat yang panjang: Ketika memanggil alat secara beruntun, keluaran model untuk pengguna bisa sangat sedikit. Model juga mungkin langsung memanggil alat tanpa memberi penjelasan. Jadi, jangan mengandalkan model untuk melaporkan progres secara proaktif di antarmuka pemantauan.
- Bisa berhenti lebih awal: Terkadang model berhenti setelah satu giliran dan meninggalkan daftar tugas yang belum selesai, atau terhenti karena kendala biasa. Hal ini lebih sering terjadi pada tingkat low.
- Penolakan tetap menghabiskan kuota: Jika permintaan ditolak, responsnya tetap mengembalikan HTTP 200 dengan
stop_reasonbernilairefusal, dan tetap menggunakan kuota laju. - Retensi data: Data disimpan selama 30 hari. Retensi data nol tidak bisa digunakan kecuali mendapat izin tegas dari Anthropic.
Loop robot membutuhkan tindakan yang bisa dijalankan di setiap langkah. Jika digabung, poin-poin di atas berarti sebelum menghubungkan model ke loop kendali, kamu perlu memastikan bahwa kondisi timeout, aksi kosong, penolakan, dan penghentian di tengah proses semuanya bisa dipulihkan.
Harga Fable 5.2: Hitung Biayanya Sebelum Integrasi
Harga resmi dihitung per satu juta token, berdasarkan halaman model, catatan pembaruan, dan halaman mode cepat:
| Komponen biaya | Fable 5.2 | Opus 5.5 | GPT-6 Astra (konteks pendek) |
|---|---|---|---|
| Input / output standar | $8 / $40 | $4 / $20 | $10 / $50 |
| Baca cache | $0.20 | $0.20 | $1 (input yang di-cache) |
| Tulis cache | 5 menit $10, 1 jam $16 | Tercantum di halaman resmi, tetapi tidak dirinci di artikel ini | $12.5 |
| Pemrosesan batch | Tarif batch dipotong 50% menjadi $4 / $20 | Juga dipotong 50% | Tidak dirinci di artikel ini |
| Mode cepat | $16 / $80 | $8 / $40 | — |
Ada beberapa hal lain yang perlu diperhatikan. Fable 5.2 20% lebih murah dibandingkan Fable 5.1 ($10 / $50). Kemampuan mode cepat tetap sama, dengan kecepatan output hingga 2,5 kali mode standar. Namun, harga cache untuk mode cepat tidak dicantumkan secara terpisah oleh pihak resmi. Jika dihitung berdasarkan pengalinya, biaya baca cache diperkirakan sekitar $0.40, sedangkan biaya tulis cache untuk 5 menit sekitar $20 dan untuk 1 jam sekitar $32. Cache petunjuk tidak digunakan bersama di antara mode kecepatan yang berbeda. Beralih dari mode cepat ke mode standar akan menyebabkan cache tidak ditemukan. Untuk GPT-6 Astra, jika input melebihi 272K token, seluruh permintaan dikenai tarif 2 kali lipat untuk input dan 1,5 kali lipat untuk output.
Dalam siklus kerja robot, setiap langkah mengirim gambar baru, sedangkan petunjuk sistem dan instruksi tindakan dari langkah sebelumnya pada dasarnya tetap sama. Struktur seperti ini cocok untuk menekan biaya dengan cache, tetapi input gambar dan token penalaran di setiap langkah tetap tidak bisa dihemat.
Apakah Fable 5.2 Sudah Bisa Dipanggil: Status Ketersediaan di APIYI
Per 2026-11-10, claude-fable-5-2 belum tersedia di daftar model maupun antarmuka harga publik APIYI apiyi.com. Model apa pun dari seri Mythos juga belum tersedia. Model ini akan segera kami hadirkan. Gunakan daftar model di platform sebagai acuan untuk nama model dan harga. Sebelum model ini tersedia, artikel ini tidak mencantumkan harga Fable 5.2 di APIYI dan tidak mengonversi harga resmi menggunakan pengali kelompok.
Berikut model terkait yang sudah bisa digunakan di daftar model APIYI pada hari itu (harga yang tercantum, dalam dolar AS per satu juta token):
| ID model | Input / output | Cache terbaca | Endpoint | Cocok untuk |
|---|---|---|---|---|
claude-opus-5-5, claude-opus-5-5-thinking |
$4 / $20 | $0.2 | chat, messages | Mulai membangun alur pemanggilan alat dan pengoperasian komputer |
claude-fable-5-1, claude-fable-5-1-thinking |
$10 / $50 | $0.25 | chat, messages | Sebagai patokan untuk membandingkan dengan generasi sebelumnya |
claude-fable-5, claude-fable-5-thinking |
$10 / $50 | $1 | chat, messages | Membandingkan versi terdahulu |
gpt-6-astra |
$10 / $50 | $1 | responses (utama), chat | Perbandingan lintas penyedia |
Harga di daftar model adalah harga yang tercantum. Biaya sebenarnya juga dikalikan dengan pengali kelompok token; jadikan tagihan sebagai acuan. Catatan kaki gpt-6-astra hanya mencantumkan rentang harga input ($10 untuk hingga 272,000 token dan $20 untuk 272,001 hingga 1,050,000 token). Harga output untuk konteks panjang tidak dicantumkan, jadi jadikan tagihan di konsol sebagai acuan. Untuk integrasi, gunakan antarmuka yang kompatibel dengan OpenAI dan isi base_url dengan https://api.apiyi.com/v1.
Langkah yang paling praktis adalah menggunakan claude-opus-5-5 terlebih dahulu untuk menguji input gambar, penguraian tindakan, dan pemulihan dari kegagalan. Setelah Fable 5.2 tersedia di APIYI, ganti ID model untuk membandingkannya. Selisih pada tugas robot (25.5 poin) jauh lebih besar daripada pada pengoperasian komputer (2.1 poin), jadi ada alasan untuk menunggu Fable 5.2. Namun, video demo saja belum cukup untuk mengambil keputusan.
Analisis Kelebihan dan Kekurangan Kemampuan Robot Fable 5.2
Kelebihan
- Lompatan antargenerasi yang besar: Skor RoboDojo Sim naik dari 27,6% menjadi 64,9%, salah satu peningkatan paling mencolok di seluruh tabel hasil.
- Unggul jauh dibandingkan model sejenis: Skornya 25,5 poin lebih tinggi daripada Opus 5.5 dan 35,1 poin lebih tinggi daripada GPT-6 Astra (berdasarkan dokumen yang dirilis Anthropic).
- Harga lebih rendah: Harga standar 20% lebih murah daripada versi 5.1, sementara biaya baca cache adalah $0.20.
- Input visual tetap konsisten: Mendukung input gambar dan konteks 1M, sehingga dapat menampung riwayat visual bertahap yang lebih panjang.
Keterbatasan
- Bukti masih terbatas: Hasilnya berasal dari pengujian internal dengan tingkat upaya tertinggi. Belum ditemukan angka yang sama di papan peringkat publik, dan belum ada pengujian ulang independen.
- Hanya ada data simulasi: Video demonstrasi tidak mencantumkan tingkat keberhasilan, sedangkan klaim “melampaui sebagian besar sistem robot khusus” tidak disertai daftar sistem yang dimaksud.
- Banyak batasan pada alur kerja: Hanya menghasilkan teks, tidak bisa dipaksa untuk memanggil alat, proses berpikirnya tidak bisa dinonaktifkan, dan jarang memberikan penjelasan secara proaktif dalam rangkaian langkah yang panjang.
- Biaya mode tertinggi cukup besar: Skor didasarkan pada mode upaya tertinggi. Latensi dan penggunaan token dalam penerapan nyata perlu diukur sendiri.
Kapan sebaiknya tidak menjadikan skor ini alasan untuk beralih model
Jika kamu tidak memiliki lingkungan simulasi atau rangkaian kendali robot fisik sendiri, skor 64,9% ini tidak bisa diverifikasi untuk kebutuhanmu. Kamu tidak dapat memastikan apakah hasil tersebut berlaku dalam pengaturan yang kamu gunakan. Skor ini juga tidak membuktikan kemampuan untuk kebutuhan keamanan siber, bidang biologi, atau penulisan kode sehari-hari. Untuk skenario tersebut, lihat hasil pengujian yang relevan. Dokumen peluncurannya sendiri menyarankan agar kebanyakan orang memulai pekerjaan pemrograman dan pengetahuan dengan Opus 5.5, lalu beralih ke model yang lebih kuat atau lebih ringan sesuai tingkat kesulitannya.
FAQ
Q1: Apakah angka 64,9% untuk Fable 5.2 merupakan skor di papan peringkat publik?
Bukan. Catatan kaki dalam pengumuman peluncuran menyebutkan bahwa hasil ini diperoleh melalui pengujian internal Anthropic. RoboDojo sendiri merupakan tolok ukur publik, tetapi hingga 2026-11-10, kami belum bisa mencocokkan angka yang sama di halaman papan peringkat publik.
Q2: Apakah 64,9% merupakan skor pada tingkat upaya default?
Bukan, skor tersebut diperoleh pada tingkat upaya tertinggi yang tersedia. Tingkat default Claude API adalah high, sedangkan aplikasi Claude dan Claude Code menggunakan Medium. Pengumuman peluncuran tidak menyebutkan skor pada tingkat default.
Q3: Apakah Fable 5.2 mengungguli sistem robotika khusus?
Menurut pengumuman peluncuran, Fable 5.2 mengungguli “sebagian besar sistem yang dirancang khusus untuk mengendalikan robot”, tetapi tidak menyertakan daftar sistemnya. Belum diketahui sistem mana saja yang berhasil diungguli.
Q4: Mengapa Gemini 4 Carbon tidak memiliki skor di RoboDojo?
Kolomnya kosong di tabel pengumuman peluncuran, tanpa penjelasan. Kolom kosong tidak berarti skornya 0 dan tidak bisa dijadikan dasar untuk menyimpulkan performanya.
Q5: Apa yang bisa disiapkan sekarang melalui API?
Hingga 2026-11-10, APIYI apiyi.com belum menyediakan `claude-fable-5-2`. Kami akan menghadirkan model ini secepatnya; model dan harga yang berlaku bisa dilihat di daftar model platform. Sementara itu, Anda bisa menggunakan `claude-opus-5-5` yang sudah tersedia untuk menguji alur input gambar dan pemanggilan alat, lalu beralih model untuk membandingkan hasilnya setelah tersedia.
Q6: Apakah tiga perangkat elektronik membuktikan bahwa model ini mampu mengendalikan robot?
Tidak. Asisten suara, telepon dengan speaker USB, dan hewan peliharaan virtual merupakan eksperimen desain perangkat keras bersama Diode. Eksperimen tersebut menunjukkan kemampuan desain sirkuit dan tidak berkaitan dengan skor kendali dua lengan di RoboDojo.
Q7: Apakah agen untuk mengoperasikan komputer perlu menunggu Fable 5.2?
Sepertinya tidak perlu. Di OSWorld 2.1, Fable 5.2 meraih 89,3%, sedangkan Opus 5.5 meraih 87,2%—selisihnya hanya 2,1 poin. Sementara itu, harga standar Opus 5.5 hanya setengah dari harga Fable 5.2.
Poin Penting Kemampuan Robotika Fable 5.2
- Arti skor: 64,9% adalah skor simulasi robot berlengan dua yang dijalankan secara internal dengan tingkat upaya tertinggi.
- Besarnya selisih: Unggul 25,5 poin dari Opus 5.5 dan 35,1 poin dari GPT-6 Astra.
- Perbandingan lain: Keunggulannya di OSWorld hanya 2,1 poin. Kedua selisih ini tidak bisa disamakan.
- Posisi demo: Menyelesaikan Rubik, membuka tutup botol, dan menggambar adalah demo dalam pengumuman peluncuran, bukan keterampilan yang siap digunakan sebagai produk.
- Batasan alur kerja: Model hanya menghasilkan teks. Memaksakan
tool_choiceakan menghasilkan respons 400, dan mode berpikir tidak bisa dinonaktifkan. - Status ketersediaan: Per 2026-11-10, APIYI belum menyediakan model ini. Untuk sementara, Anda bisa menggunakan
claude-opus-5-5untuk membangun alur kerja.
Ringkasan
Kemajuan Claude Fable 5.2 dalam kendali robot merupakan sinyal nyata yang terlihat: skor RoboDojo Sim naik dari 27,6% pada generasi sebelumnya menjadi 64,9%, jauh mengungguli model pembanding yang disertakan Anthropic. Namun, angka ini hanya berlaku dalam cakupan yang sempit: simulasi, pengujian internal, dan tingkat upaya tertinggi. Angka tersebut tidak mencakup tingkat keberhasilan pada robot fisik dan bukan pula gambaran kemampuan untuk diterapkan di pabrik.
Jika Anda sudah memiliki alur kerja simulasi atau robot fisik sendiri, ada baiknya melakukan pengujian perbandingan setelah Fable 5.2 tersedia. Siapkan juga penanganan untuk batasan seperti keluaran teks, pemanggilan alat yang tidak bisa dipaksakan, dan mode berpikir yang tidak bisa dinonaktifkan. Jika belum memiliki alur kerja, atau kebutuhan Anda berkaitan dengan penulisan kode maupun pengoperasian komputer, Anda tidak perlu mengubah solusi yang sudah digunakan hanya karena skor 64,9% ini.
Penulis: Tim teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui beranda APIYI di apiyi.com. Status ketersediaan model dapat dilihat di daftar model platform.


