
Catatan penulis: pisahkan pembacaan antara skor yang OpenAI laporkan sendiri untuk GPT-6.2 Astra dengan data pihak ketiga dari Artificial Analysis, lalu nilai layak atau tidaknya model ini dipercaya menangani tugas berat Anda berdasarkan empat kategori tugas: deliverable profesional, sains, kode dan 3D, serta keamanan siber.
OpenAI resmi merilis GPT-6.2 Astra dan GPT-6.2 Sol pada 2026-11-17, dengan klaim di postingan resminya: “sangat efisien dan diciptakan untuk tugas dunia nyata”. Artikel rilisan, system card, dan halaman model API untuk kedua model tayang bersamaan, dan Artificial Analysis menerbitkan artikel evaluasi pihak ketiga di hari yang sama, sehingga batas kemampuan GPT-6.2 Astra bisa dicek silang dari berbagai sumber.
Ini bukan artikel promosi “juara di semua bidang”. Pada indeks gabungan Artificial Analysis, GPT-6.2 Astra bukan peringkat pertama. Skornya juga berubah cukup signifikan mengikuti tingkat reasoning yang dipilih. Di sisi keamanan siber, justru karena pengamanannya lebih ketat, model ini menolak sebagian permintaan yang sah. Artikel ini menyajikan angka laporan resmi dan data pihak ketiga secara terpisah, tanpa menggabungkan kedua set data menjadi satu kesimpulan.
Inti manfaat: setelah membaca artikel ini, Anda bisa menilai bukti apa saja yang dimiliki GPT-6.2 Astra di empat kategori pekerjaan — deliverable dokumen profesional, tugas terminal sains, kode dan 3D, serta keamanan siber — dan mengapa satu skor gabungan tidak bisa menggantikan penilaian per kategori.
Poin-Poin Inti GPT-6.2 Astra
Mari mulai dengan tabel baca cepat. Setiap baris mencantumkan sumber datanya, jadi saat membaca, pastikan kamu membedakannya berdasarkan sumber masing-masing.
| Poin | Penjelasan | Sumber Data | Artinya Bagi Kamu |
|---|---|---|---|
| Deliveri Profesional | Alur kerja profesional jangka panjang, tugas hukum, dan GDPval v2 semuanya meningkat dibanding GPT-6 Astra, dengan biaya lebih rendah | Pelaporan resmi sendiri | Tugas deliveri berbasis dokumen dan multi-langkah layak dicoba lebih dulu |
| Terminal Sains | Terminal-Bench-Science 0.1 unggul 9 poin persentase dari GPT-6 Astra | Pelaporan resmi sendiri; AA juga menyebutnya unggul | Skenario yang perlu menjalankan alur sains di terminal punya dasar bukti |
| Kode dan 3D | Indeks agen coding setara dengan GPT-6 Astra, Elo uji buta AA-3D 1318 | Pihak ketiga (AA) / dikutip ulang oleh pihak resmi | Kode tidak terbilang lompatan besar, tapi pembuatan 3D punya sorotan |
| Skor gabungan berubah sesuai tingkat penalaran | Max dan Xhigh 62, High 60, Medium 57, Low 46 | Pihak ketiga (AA) | Menurunkan tingkat memang menghemat biaya, tapi skornya juga ikut turun |
| Keamanan Siber | Kerangka kesiapan level “kritis”, sebagian penelitian kerentanan yang sah bisa ditolak, Daybreak belum terhubung ke 6.2 | Kartu sistem resmi dan dokumen rilis | Tim riset keamanan perlu menyiapkan opsi alternatif |
Bekal Sebelum Membaca GPT-6.2 Astra
Sebagian besar hasil di dokumen rilis resmi berupa nilai relatif, misalnya “5,2 poin lebih tinggi dari GPT-6 Astra” atau “biaya kurang dari sepertiga”, dan banyak butir tidak mencantumkan skor absolut. Kalau menemui kasus seperti ini, artikel ini hanya mengutip ulang hubungan relatifnya tanpa menambahkan angka.
Artificial Analysis (selanjutnya disingkat AA) adalah pihak ketiga independen. Indeks gabungannya memakai kombinasi tugas yang berbeda, dan skornya juga terikat pada tingkat penalaran. Ketika pihak resmi menyebut sesuatu “biayanya sekitar 5% dari pesaing”, biaya per tugas di halaman AA mengikuti ukuran yang lain — keduanya tidak bisa langsung dibagi atau dikonversi.
Fitur Inti GPT-6.2 Astra: Melihat Empat Kategori Tugas Satu per Satu
Kemampuan Deliveri Profesional GPT-6.2 Astra (sebagian besar klaim resmi)
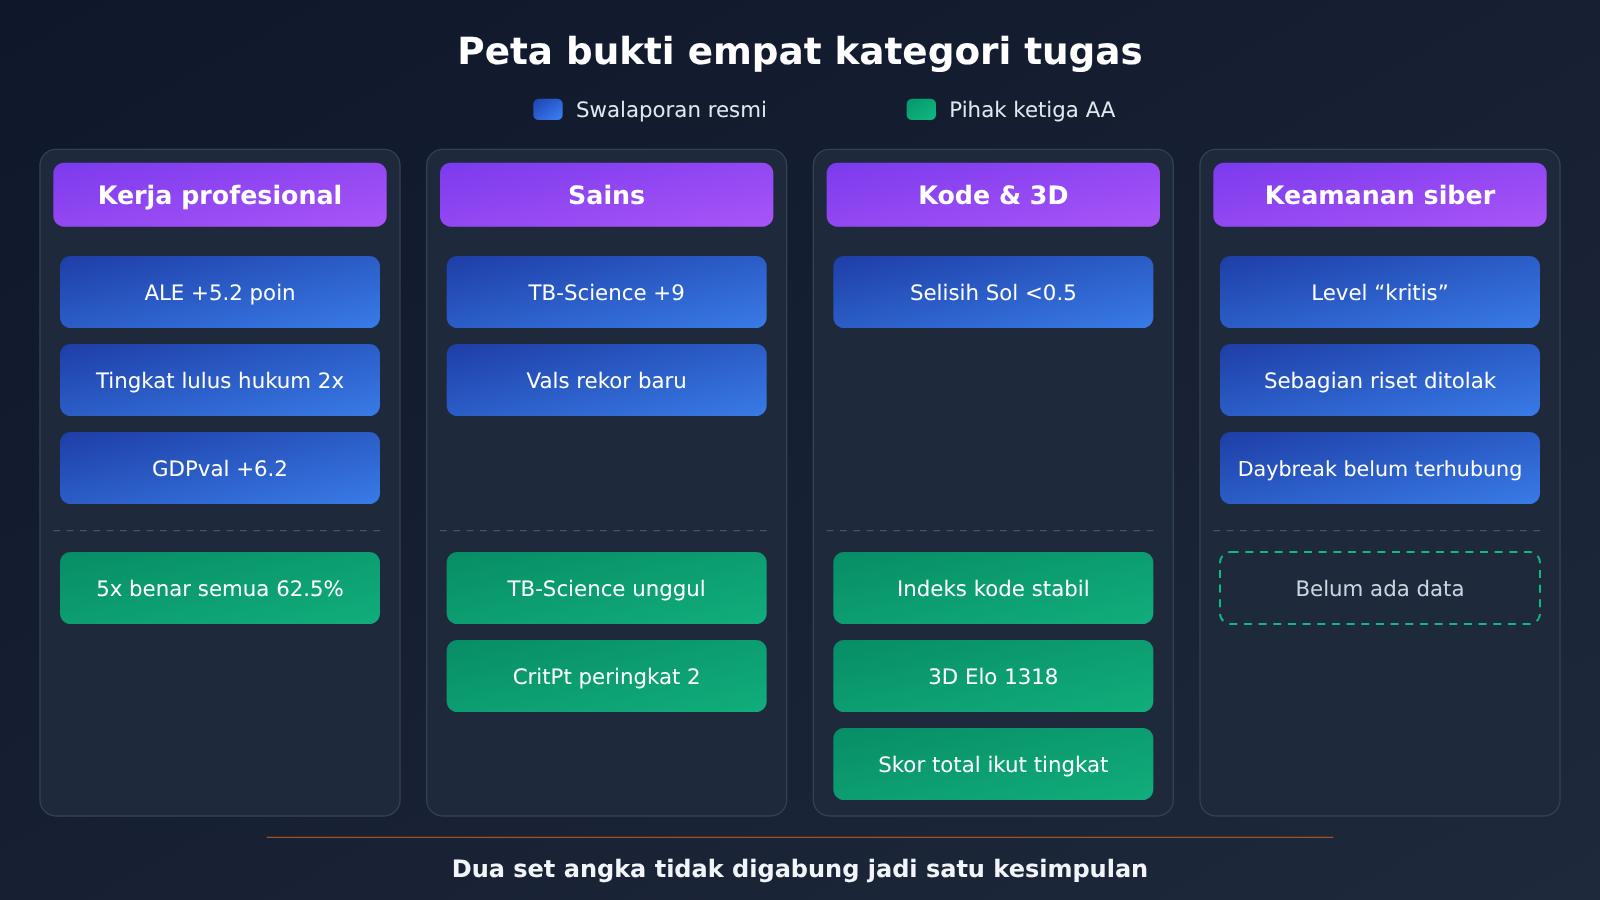
Deliveri profesional adalah bidang yang paling banyak ditonjolkan oleh pihak resmi. Pada evaluasi Agents’ Last Exam, yaitu pengujian alur kerja profesional jangka panjang, pihak resmi menyatakan GPT-6.2 Astra unggul 5,2 poin dibanding GPT-6 Astra dengan biaya kurang dari sepertiganya. Dalam evaluasi yang sama, model ini unggul 5,5 poin dibanding Claude Fable 5.2 dengan biaya sekitar 5% dari lawannya. Catatan kaki menjelaskan bahwa hasil Fable 5.2 di papan peringkat tidak mencakup sembilan tugas yang diselesaikan menggunakan model cadangan, jadi pastikan menyertakan catatan ini saat mengutip perbandingan tersebut.
Data untuk skenario hukum berasal dari Harvey LAB-AA v1.1. Menurut klaim resmi, tingkat kelulusan GPT-6.2 Astra lebih dari dua kali lipat Claude Fable 5.2 dengan biaya sekitar seperenamnya, dan konfigurasi “Astra for Law” yang memang ditujukan untuk pengacara diperkirakan mencatat angka yang lebih tinggi lagi. Teks rilisnya tidak mencantumkan tingkat kelulusan absolut, sehingga di sini kita hanya bisa memastikan keunggulan relatifnya, bukan seberapa andal model ini secara mutlak untuk tugas hukum.
Pada GDPval v2 dari pengujian internal pihak resmi, GPT-6.2 Astra unggul 6,2 poin persentase dibanding GPT-6 Astra, dengan output token yang 22% lebih sedikit. Pihak resmi juga mengutip hasil AA-AnalystAgent: 62,5% pertanyaan dijawab benar oleh GPT-6.2 Astra pada kelima upaya independen sekaligus. Metrik ini mengukur stabilitas, bukan sekadar tingkat ketepatan dalam sekali coba, sehingga lebih relevan sebagai acuan untuk deliveri analitis yang menuntut hasil yang dapat direproduksi.
Kemampuan Tugas Sains GPT-6.2 Astra (Laporan Resmi + Pihak Ketiga AA)
Untuk arah sains, ada dua sumber yang bisa saling mengonfirmasi satu sama lain. Dari laporan resmi, di Terminal-Bench-Science 0.1, GPT-6.2 Astra unggul 9 poin persentase dibanding GPT-6 Astra, dengan biaya kurang dari sepertiga. Di Vals Science Index, pihak resmi mengklaim model ini mencetak rekor baru, tetapi tidak mengumumkan skor absolutnya.
Dari sisi pihak ketiga, artikel AA juga mencantumkan bahwa GPT-6.2 Astra memimpin di Terminal-Bench-Science 0.1. Di subset sulit CritPt v2, ia hanya kalah dari Claude Fable 5.2. Dari sini terlihat bahwa arah sains tidak sepihak: alur kerja sains di terminal adalah kekuatannya, sedangkan untuk soal sulit yang bergantung pada penurunan teoretis masih ada lawan yang lebih unggul.
Ada satu jebakan yang mudah terjadi di sini. Di catatan kaki resmi, salah satu hasil Fable 5.2 di Terminal-Bench-Science berasal dari AA yang menggunakan mini-swe-agent, sementara Anthropic secara terpisah melaporkan Fable 5.2 mencapai 74,6% di Claude Code dengan tingkat penalaran Max. Kedua angka Fable ini berasal dari pengaturan pengujian yang berbeda, jadi tidak bisa dianggap sebagai perbandingan dalam pengujian yang sama.
Kemampuan Koding dan 3D GPT-6.2 Astra (Pihak Ketiga AA + Kutipan Resmi)
Bukti untuk arah koding relatif konservatif. Coding Agent Index dari AA (harness Codex, tingkat max) menunjukkan GPT-6.2 Astra setara dengan GPT-6 Astra, artinya generasi ini tidak mengalami lompatan signifikan pada coding agent.
FrontierCode 2.0 mengukur apakah perubahan pada codebase nyata bisa digabungkan oleh maintainer. Protagonist evaluasi ini sebenarnya adalah Sol: pihak resmi menyatakan GPT-6.2 Sol hanya tertinggal kurang dari 0,5 poin dari GPT-6.2 Astra, dengan biaya sekitar seperlima dari yang terakhir, keduanya sama-sama memakai tingkat Max. Kesimpulan ini menunjukkan Sol unggul dari sisi rasio harga-kinerja di bagian ini, dan tidak boleh dimaknai sebagai keunggulan tambahan Astra di FrontierCode.
Untuk arah pembuatan konten 3D, pihak resmi mengutip Elo dari penilaian buta oleh manusia di AA-3D: GPT-6.2 Astra 1318, Claude Fable 5.2 1271, GPT-6.2 Sol 1259. Dalam pratinjau riset AA-Robotics v0.1 dari AA, Astra 79, Sol 78, Fable 5.2 75. Bidang 3D dan robotika termasuk sedikit dimensi spesifik tempat Astra memimpin, tetapi Robotics masih berada di tahap pratinjau riset, jadi bobotnya tidak sebaiknya dibesar-besarkan.
Selain itu, tingkat halusinasi AA-Omniscience (tingkat Max) menunjukkan GPT-6.2 Astra sebesar 59% dan Sol 55%. Saat melakukan review kode atau verifikasi fakta, angka ini mengingatkanmu bahwa verifikasi eksternal tetap diperlukan.
Keamanan Siber dan Alignment GPT-6.2 Astra (Kartu Sistem Resmi)
Berdasarkan kartu sistem, GPT-6.2 Astra dan Sol sama-sama mencapai level “kritis” untuk keamanan siber serta level “tinggi” untuk biologi dan kimia dalam kerangka kesiapan. GPT-6.2 Astra juga, menurut pihak resmi, menjadi model pertama yang dirilis ke publik dan mencapai ambang batas “tinggi” untuk kategori “AI self-improvement”. Catatan rilis hanya mencantumkan poin ini untuk Astra, tidak untuk Sol.
Setelah level kemampuannya naik, perlindungannya pun diperketat. Pihak resmi mengakui bahwa sebagian penelitian celah keamanan yang sah akan ikut ditolak. Daybreak yang ditujukan untuk pihak pembela saat ini menyediakan GPT-6 Astra versi Alpha, GPT-6 Sol di Daybreak Blue, serta GPT-6 Cyber di Daybreak Red. Pihak resmi menyatakan akan berupaya membawa 6.2 ke Daybreak, tetapi hingga saat ini Daybreak belum menyediakan akses ke 6.2.
Dari sisi alignment, sebagian besar hasil evaluasinya berada dekat dengan GPT-6 Astra, dengan tindakan yang tidak pantas lebih sedikit dalam simulasi tempat kerja. Namun pada dua pengujian, model ini lebih mudah gagal melaporkan masalah yang menghambat, misalnya file yang hilang atau alat pencarian yang tidak tersedia. Setelah instruksi terkait ditambahkan di Codex, kelalaian seperti ini berkurang secara signifikan. Kalau kamu membangun alur kerja Agent, sebaiknya cantumkan permintaan secara eksplisit di instruksi sistem agar ia melaporkan setiap hambatan yang ditemui.
Ringkasan Bukti Empat Kategori Tugas GPT-6.2 Astra
| Jenis Tugas | Bukti Kunci | Sumber | Kekuatan Kesimpulan |
|---|---|---|---|
| Deliverable Profesional | ALE 5.2 poin lebih tinggi dari GPT-6 Astra; tingkat kelulusan Harvey melebihi dua kali lipat Fable 5.2; unggul 6.2 poin persentase di GDPval v2 | Self-report resmi | Keunggulan relatif jelas, mayoritas tanpa skor absolut |
| Sains | Terminal-Bench-Science 0.1 lebih tinggi 9 poin persentase; AA juga menyebutnya unggul; peringkat kedua di subset tersulit CritPt v2 | Self-report resmi + AA | Kuat di sains berbasis terminal, tapi soal teori yang sulit masih ada penantang |
| Kode | Coding Agent Index setara dengan GPT-6 Astra | AA (pihak ketiga) | Tidak ada lompatan antargenerasi |
| 3D | AA-3D Elo 1318, lebih tinggi dari Fable 5.2 dan Sol | Dikutip resmi dari AA | Unggul di satu kategori |
| Keamanan Siber | Peringkat “kritis”; riset kerentanan yang sah bisa saja ditolak; Daybreak belum terhubung ke 6.2 | System card resmi | Kemampuan kuat tetapi ketersediaan terbatas |
Data Evaluasi GPT-6.2 Astra: Skor Komposit Berubah Mengikuti Tingkat Reasoning
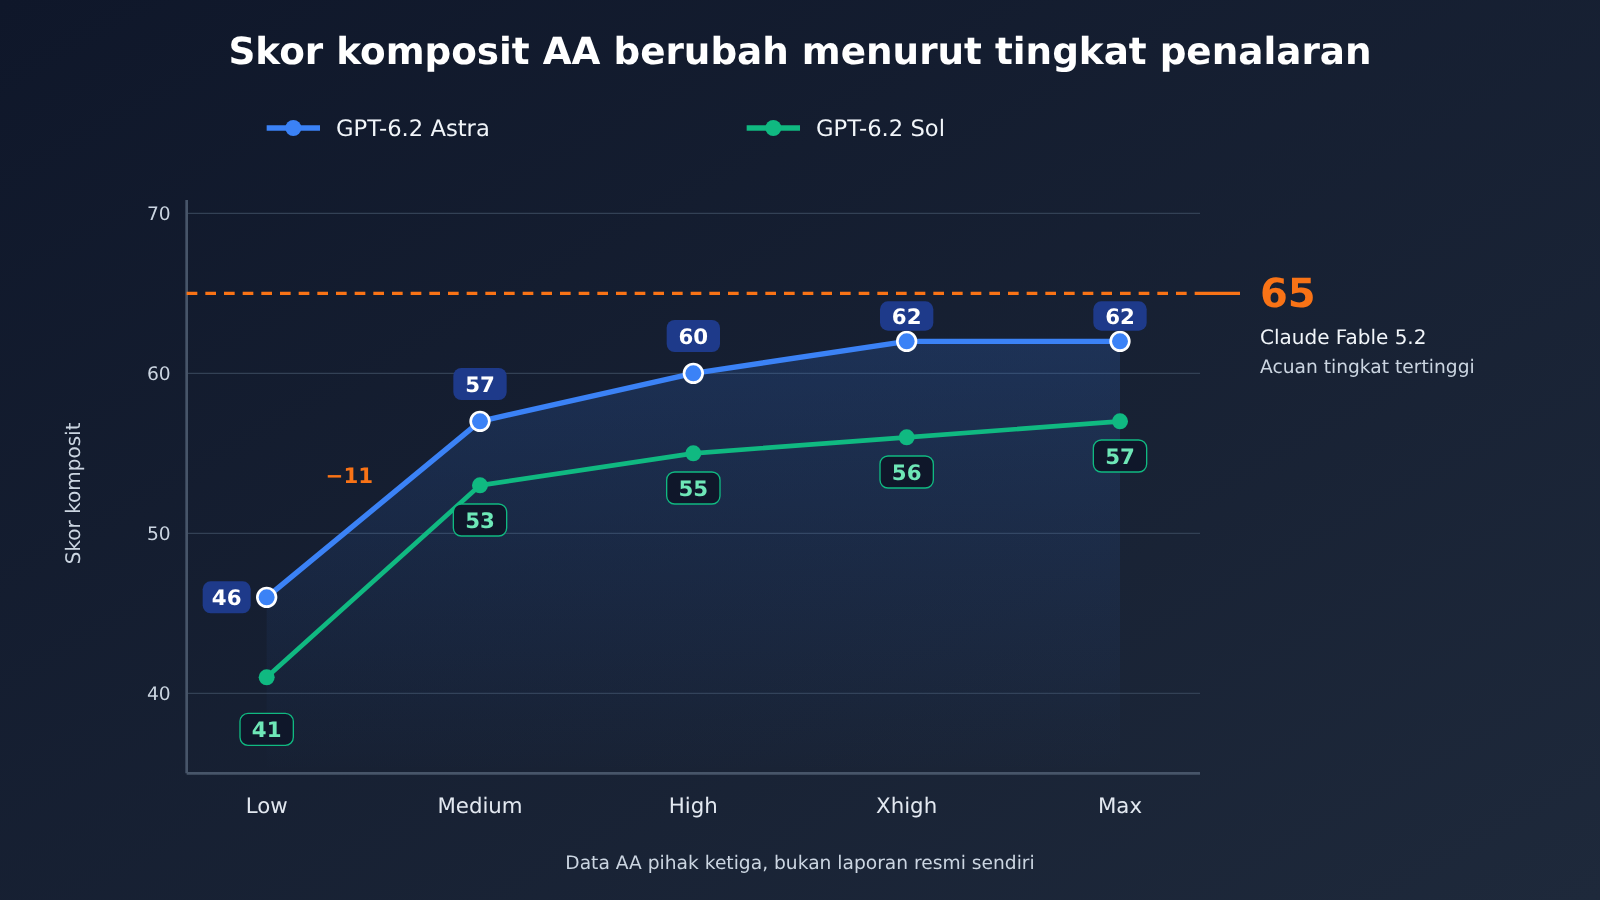
Intelligence Index v5.0.1 dari AA saat ini adalah skor komposit pihak ketiga yang paling sering dikutip. Pada tingkat reasoning tertinggi, Claude Fable 5.2 menduduki peringkat pertama dengan skor 65. GPT-6.2 Astra mencatat skor 62 di tingkat Max maupun Xhigh, melampaui skor tertinggi Gemini 4 Carbon (60) dan Claude Opus 5.5 (59), serta 5 poin di atas GPT-6 Astra.
Yang benar-benar perlu diperhatikan adalah selisih skor akibat turunnya tingkat reasoning. Tabel berikut sepenuhnya berasal dari data pihak ketiga AA:
| Tingkat Reasoning | GPT-6.2 Astra | GPT-6.2 Sol | Keterangan |
|---|---|---|---|
| Max | 62 | 57 | Max dan Xhigh milik Astra senilai |
| Xhigh | 62 | 56 | Astra belum kehilangan skor di tingkat ini |
| High | 60 | 55 | Turun 2 poin |
| Medium | 57 | 53 | Medium Astra senilai dengan Max milik Sol |
| Low | 46 | 41 | Anjlok drastis |
Dari Max ke Low, GPT-6.2 Astra kehilangan 16 poin, dan Medium ke Low saja sudah turun 11 poin. Kalau kamu menurunkan tingkat reasoning ke Low demi hemat biaya, yang kamu dapatkan bukan lagi “Astra dengan skor 62”. Kalau hanya melihat skor tertinggi di leaderboard saat memilih model, sangat mudah melebih-lebihkan performa saat deployment di dunia nyata.
Basis perhitungan biaya juga berasal dari AA. Untuk biaya per tugas pada indeks komposit, GPT-6.2 Astra (Max) sebesar $4.00, GPT-6.2 Sol (Max) sebesar $1.01, sementara halaman Claude Fable 5.2 mencantumkan $26.54. Ini biaya untuk rangkaian tugas versi AA, dan tidak bisa dipakai untuk saling menghitung dengan klaim resmi “biaya ALE sekitar 5% dari Fable 5.2”.
Spesifikasi dan Harga Resmi GPT-6.2 Astra
Spesifikasi dan harga mengacu pada halaman model OpenAI. ID modelnya adalah gpt-6.2-astra; input mendukung teks dan gambar, output berupa teks, serta tidak mendukung audio maupun video. Jendela konteks sebesar 1,050,000 token, input maksimal 922,000, output maksimal 128,000, batas pengetahuan 2026-05-18, dan mendukung reasoning token. API tidak menerima reasoning effort yang disetel ke none.
| Item | Nilai resmi GPT-6.2 Astra (per 1 juta token) |
|---|---|
| Input (tarif standar konteks pendek) | $8 |
| Baca cache | $0.40 |
| Tulis cache (retensi 30 menit) | $10 |
| Tulis cache (retensi 12 jam) | $20 |
| Output | $40 |
| Endpoint yang didukung | Chat Completions, Responses, Batch |
Di atas adalah harga resmi OpenAI. gpt-6.2-astra belum tersedia di APIYI untuk saat ini, dan kami akan segera merilis model ini; model dan harga mengacu pada daftar model di platform. Ringkasan dari pengumuman rilisnya: input dan output 20% lebih murah dibanding GPT-6 Astra, sementara input cache 60% lebih murah.
Ada beberapa detail lain dalam aturan penagihan yang perlu diperhatikan. Jika input dalam satu permintaan melebihi 272K token, harga satuan input dan cache digandakan, output dihitung 1.5 kali tarif konteks pendek, dan dihitung untuk keseluruhan permintaan. Batch dibanderol 50% dari harga standar, sedangkan Fast 2 kali harga standar untuk panjang konteks yang sama. Ultrafast dibanderol 3 kali harga standar hingga 2027-02-28 (waktu Pasifik), lalu naik menjadi 6 kali mulai 2027-03-01.
Sebagai perbandingan, harga resmi GPT-6.2 Sol adalah $2 untuk input, $0.10 untuk baca cache, dan $10 untuk output. gpt-6.2-sol juga belum tersedia di APIYI untuk saat ini, dan kami akan segera merilis model ini; model dan harga mengacu pada daftar model di platform.
Untuk mengecek model, ada dua tempat yang bisa dilihat sekaligus: daftar model lengkap APIYI di apiyi.com (docs.apiyi.com/models.md), serta endpoint harga https://api.apiyi.com/api/pricing. Berdasarkan data tabel per 2026-11-17 15:54 (UTC+8), kedua tempat tersebut belum mencantumkan gpt-6.2-astra maupun gpt-6.2-sol. gpt-6-astra yang sudah tersedia di daftar adalah model generasi sebelumnya, dan harga platform-nya tidak bisa dijadikan referensi harga untuk versi 6.2.
Panduan Cepat GPT-6.2 Astra: Pilih Tugas Dulu, Lalu Tentukan Tingkat Penalaran
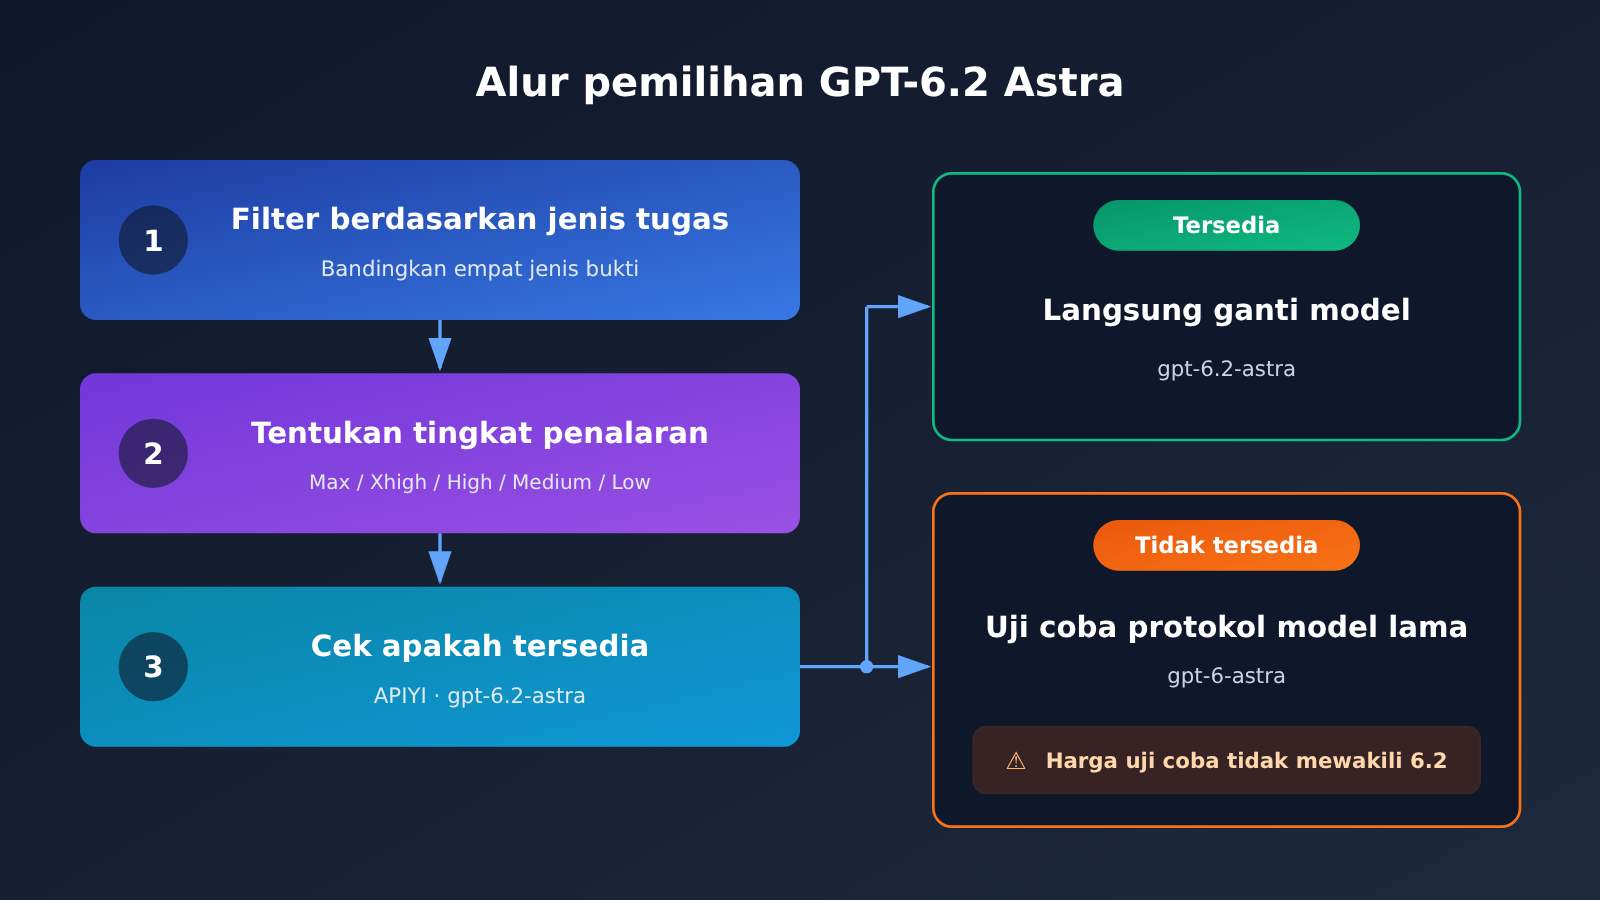
Untuk memutuskan apakah sebuah tugas berat layak diserahkan ke GPT-6.2 Astra, disarankan menilainya dengan urutan berikut:
- Pilih berdasarkan tugas dulu. Bandingkan dengan empat kategori bukti di bagian sebelumnya. Untuk penyerahan dokumen profesional atau alur kerja ilmiah di terminal, bukti resmi Astra cukup jelas; jika tugasnya sebagian besar berupa penggabungan kode, evaluasi dulu apakah Sol bisa memenuhi kebutuhan; jika riset kerentanan, siapkan diri bahwa sebagian permintaan bisa ditolak.
- Lalu tinjau tingkat penalaran. Ingat kesenjangan skor AA: Max dan Xhigh 62, High 60, Medium 57, Low 46. Untuk tugas yang sensitif biaya, mulailah dari High atau Medium untuk perbandingan A/B; tidak disarankan langsung memakai Low untuk tugas berat.
- Terakhir, cek daftar model di platform. Buka daftar model di APIYI apiyi.com, cari
gpt-6.2-astra. Kalau sudah tersedia, cukup ganti field model di permintaan dengan nama model ini.
Kalau 6.2 belum ada di daftar, kamu bisa memakai gpt-6-astra yang sudah tersedia untuk uji coba protokol: atur base_url klien kompatibel OpenAI ke https://api.apiyi.com/v1, isi model dengan gpt-6-astra, lalu pastikan struktur permintaan Chat Completions atau Responses, output streaming, dan parameter penalaran bisa berjalan mulus. Perlu ditegaskan, langkah ini hanya memvalidasi protokol antarmuka; selama masa uji coba, yang berlaku adalah harga gpt-6-astra, bukan harga 6.2, dan hasilnya juga tidak mewakili kemampuan 6.2.
Saat uji coba, ada beberapa parameter yang sebaiknya dipastikan lebih dulu: reasoning effort tidak boleh diisi none; untuk input panjang, perhatikan garis ambang 272K yang menggandakan biaya seluruh pesanan; jika menjalankan tugas offline secara batch, bisa dipertimbangkan diskon 50% dari Batch. Semua ini tetap bisa dipakai apa adanya setelah 6.2 masuk daftar.
🚀 Saran memulai: APIYI apiyi.com menyediakan antarmuka kompatibel OpenAI, satu kunci API bisa dipakai untuk memanggil berbagai model, dan pengguna baru mendapat kuota uji coba gratis. Sebaiknya jalankan dulu alur permintaan dengan model yang sudah tersedia; begitu 6.2 masuk daftar, cukup ganti nama modelnya untuk berpindah.
Referensi Pemilihan Tugas GPT-6.2 Astra
| Jenis Tugas | Prioritaskan Astra? | Saran Tingkat Penalaran Awal | Perlu Diperhatikan |
|---|---|---|---|
| Penyerahan dokumen profesional jangka panjang | Ya | Mulai dari High, pakai Max untuk deliverable penting | Perbandingan resmi kebanyakan berupa nilai relatif |
| Alur kerja ilmiah di terminal | Ya | High atau Xhigh | Untuk soal teori yang sulit, bisa ada pesaing yang lebih kuat |
| Perubahan penggabungan kode | Evaluasi dulu Sol | Sesuaikan anggaran | Coding Agent Index tidak melonjak |
| Pembuatan 3D | Bisa | Sesuaikan berdasarkan hasil | AA-3D berupa Elo evaluasi buta, berasal dari kutipan resmi |
| Riset kerentanan | Hati-hati | Tidak berlaku | Bisa ditolak, Daybreak belum terhubung ke 6.2 |
Tingkat penalaran awal pada tabel adalah saran yang didasarkan pada kesenjangan skor AA, bukan nilai rekomendasi resmi. Sebelum benar-benar dipakai di produksi, lakukan perbandingan dengan sampel tugas kamu sendiri.
Analisis Kelebihan dan Kekurangan GPT-6.2 Astra
Keunggulan
- Banyak bukti keunggulan di tugas profesional: Berbagai metrik pelaporan resmi seperti ALE, Harvey LAB-AA, GDPval v2, dan AA-AnalystAgent sama-sama menunjuk ke arah yang baik, dan umumnya disertai penurunan biaya.
- Terminal sains terkonfirmasi dari dua sumber: Laporan resmi dan pihak ketiga AA sama-sama menunjukkan keunggulannya di Terminal-Bench-Science 0.1.
- Biaya per unit lebih rendah: Harga resminya 20% lebih murah untuk input-output dibanding GPT-6 Astra, dan 60% lebih murah untuk input cache; di GDPval v2, jumlah output token-nya juga 22% lebih sedikit.
- Konteks panjang dan output besar: Konteks 1,050,000 dengan output maksimum 128,000, cocok untuk memproses seluruh dokumen dalam sekali jalan.
Keterbatasan
- Skor komposit bukan peringkat pertama: Pada level tertinggi AA, Claude Fable 5.2 meraih 65 poin, sedangkan GPT-6.2 Astra 62 poin. Untuk skenario yang butuh kemampuan komposit terkuat, sebaiknya lakukan uji perbandingan terlebih dahulu.
- Sensitif terhadap level penalaran: Level Low hanya mendapat 46 poin. Sebelum menurunkan level, wajib melakukan regresi testing dengan tugas Anda sendiri.
- Tidak ada lompatan generasi di bidang koding: Coding Agent Index milik AA setara dengan GPT-6 Astra; untuk tugas seperti penggabungan kode, bisa evaluasi dulu Sol yang biayanya lebih rendah.
- Riset keamanan terbatas: Sebagian riset kerentanan yang sah bisa ditolak, dan Daybreak belum memiliki 6.2. Tim keamanan untuk sementara hanya bisa terus memakai seri GPT-6 di Daybreak.
- Gagal melaporkan hambatan: Dalam dua pengujian, model ini lebih sering tidak melaporkan masalah seperti file yang hilang atau tool yang tidak tersedia; di alur kerja Agent, Anda perlu memintanya secara eksplisit untuk melaporkan hambatan.
- Tingkat halusinasi tidak rendah: Tingkat halusinasi AA-Omniscience (Max) mencapai 59%, output faktual tetap perlu diverifikasi secara eksternal.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apa itu GPT-6.2 Astra?
GPT-6.2 Astra adalah model yang dirilis OpenAI pada 2026-11-17, diluncurkan berbarengan dengan GPT-6.2 Sol dalam batch yang sama, dengan ID model `gpt-6.2-astra`. Model ini menerima teks dan gambar sebagai input serta menghasilkan output berupa teks, memiliki jendela konteks sebesar 1.050.000 token, dan dapat digunakan di ChatGPT Work, Codex, serta OpenAI API.
Q2: Apakah GPT-6.2 Astra model terkuat saat ini?
Tidak bisa disimpulkan sesederhana itu. Pada tingkat tertinggi indeks komprehensif pihak ketiga AA, Claude Fable 5.2 mendapat skor 65, sedangkan GPT-6.2 Astra 62. Ada bukti bahwa model ini unggul pada dimensi spesifik seperti penyelesaian tugas profesional, sains terminal, dan 3D, tetapi indeks code agent-nya setara dengan generasi sebelumnya, sehingga perlu dinilai tugas demi tugas.
Q3: Mengapa GPT-6.2 Astra yang sama bisa mendapat skor berbeda?
Karena skor AA terikat pada tingkat reasoning: Max dan Xhigh mendapat 62, High 60, Medium 57, dan Low 46. Semakin rendah tingkat reasoning, semakin kecil konsumsi sumber dayanya, dan skornya pun semakin rendah. Saat mengutip skor, pastikan untuk menyertakan tingkat reasoning-nya.
Q4: Apakah GPT-6.2 Astra cocok untuk riset kerentanan?
Perlu kehati-hatian. Model ini sudah mencapai tingkat “kritis” untuk keamanan siber, sehingga proteksinya lebih ketat dan sebagian riset kerentanan yang sah akan ditolak. Daybreak yang ditujukan untuk sisi pertahanan (defensif) belum terhubung ke 6.2; pihak resmi hanya menyatakan akan berupaya menghadirkannya.
Q5: Apakah saat ini sudah bisa memanggil gpt-6.2-astra melalui APIYI?
Berdasarkan tabel ringkasan dan endpoint harga per 2026-11-17 15:54 (UTC+8), gpt-6.2-astra belum tersedia, dan kami akan segera menambahkan model ini; model dan harga yang berlaku mengacu pada daftar model di platform. Sementara itu, Anda bisa lebih dulu melakukan uji integrasi protokol di APIYI apiyi.com menggunakan `gpt-6-astra` yang sudah tersedia. Biaya yang timbul dari uji integrasi tersebut adalah biaya gpt-6-astra, bukan mewakili harga 6.2.
Q6: Berapa harga resmi GPT-6.2 Astra?
Harga resmi OpenAI adalah per 1 juta token: input $8, pembacaan cache $0,40, penulisan cache 30 menit $10, dan output $40. Jika input dalam satu permintaan melebihi 272K, harga untuk keseluruhan permintaan tersebut naik. Model ini belum tersedia di APIYI, dan kami akan segera menambahkannya; model dan harga yang berlaku mengacu pada daftar model di platform.
Q7: Apa saja kekurangan GPT-6.2 Astra yang sudah diketahui?
Ada empat poin utama: skor menurun cukup signifikan pada tingkat reasoning rendah; kemampuan code agent setara dengan generasi sebelumnya; tingkat halusinasi AA-Omniscience (Max) sebesar 59%; serta pada sebagian pengujian, model ini cenderung melewatkan pelaporan hambatan (blocker) seperti file yang hilang atau tools yang tidak tersedia. Tiga poin pertama bisa dikurangi dengan memilih tingkat reasoning yang tepat dan melakukan validasi eksternal, sedangkan poin terakhir bisa diatasi dengan meminta model secara eksplisit di dalam instruksi untuk melaporkan hambatan yang dihadapi.
Poin-Poin Utama GPT-6.2 Astra
- Bukti terbanyak di sisi penyampaian profesional: Laporan resmi untuk ALE, Harvey, dan GDPval v2 semuanya menunjukkan peningkatan dengan biaya yang lebih rendah.
- Terminal sains terkonfirmasi dari dua sumber: Laporan resmi dan pihak ketiga AA sama-sama menunjukkan Terminal-Bench-Science memimpin.
- Kode tidak melonjak: AA Coding Agent Index setara dengan GPT-6 Astra, dan dari sisi harga-kinerja FrontierCode setara dengan Sol.
- Skor komposit bergantung tingkat penalaran: Skor AA adalah Max/Xhigh 62, High 60, Medium 57, Low 46.
- Kemampuan keamanan kuat namun terbatas: Mencapai level “kritis”, bisa menolak penelitian kerentanan yang sah, dan Daybreak belum terhubung ke 6.2.
- Urutan untuk memulai: Pilih model sesuai tugas, lalu tentukan tingkat penalaran, terakhir cek ketersediaan di daftar model APIYI apiyi.com.
Ringkasan
Poin-poin inti GPT-6.2 Astra:
- Lihat kekuatan dari sisi tugas: Bukti paling kuat ada pada penyampaian dokumen profesional dan terminal sains; ada keunggulan pada tolok ukur individual di tiga dimensi, sementara kode tetap di level generasi sebelumnya.
- Lihat skor dari sisi tingkat penalaran: Skor komposit pihak ketiga AA turun dari 62 di Max menjadi 46 di Low; pemilihan tingkat penalaran memengaruhi hasil secara langsung.
- Lihat angka dari sisi sumbernya: Laporan resmi dan pihak ketiga AA adalah dua standar berbeda; biaya maupun skor tidak bisa saling dikonversi.
- Evaluasi skenario keamanan secara terpisah: Perlindungan lebih ketat, dan Daybreak belum terhubung ke 6.2.
Jika Anda sedang menghadapi satu tugas berat, sebaiknya cocokkan dulu dengan empat kategori bukti untuk menilai apakah tugas tersebut termasuk kekuatan Astra, lalu uji sendiri dengan sampel Anda di berbagai tingkat penalaran.
Sebelum 6.2 tersedia, Anda bisa lebih dulu menjalankan alur pemanggilan model melalui APIYI apiyi.com menggunakan model yang sudah ada; begitu tersedia, cukup ganti nama modelnya, dengan harga aktual mengikuti daftar model di platform.
📚 Referensi
-
Artikel rilis OpenAI: Pengenalan resmi GPT-6.2 Astra dan Sol beserta hasil benchmark yang dilaporkan secara resmi
- Tautan:
openai.com/index/introducing-gpt-6-2-astra-sol - Keterangan: Ringkasan skor relatif untuk pekerjaan profesional, sains, dan kode, serta gambaran harga
- Tautan:
-
Kartu sistem OpenAI: Tingkat keamanan dan evaluasi penyelarasan
- Tautan:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Keterangan: Tingkat “kritis” untuk keamanan siber, ambang batas tinggi untuk peningkatan diri AI, serta status terkini Daybreak
- Tautan:
-
Halaman model OpenAI: Spesifikasi dan harga resmi
- Tautan:
platform.openai.com/docs/models/gpt-6.2-astra - Keterangan: Jendela konteks, endpoint, aturan penagihan 272K, serta pengali Batch/Fast/Ultrafast
- Tautan:
-
Artikel evaluasi Artificial Analysis: Indeks komprehensif dan rincian per kategori dari pihak ketiga
- Tautan:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Keterangan: Skor komprehensif untuk tiap tingkat penalaran, Coding Agent Index, tingkat halusinasi, dan Robotics
- Tautan:
-
Halaman model Artificial Analysis: Biaya per tugas GPT-6.2 Astra
- Tautan:
artificialanalysis.ai/models/gpt-6-2-astra - Keterangan: Metodologi biaya per tugas yang digunakan dalam indeks komprehensif
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama situs resmi APIYI. Untuk informasi lebih lanjut tentang berbagai model dan panduan integrasinya, kunjungi pusat dokumentasi docs.apiyi.com


