
Catatan penulis: Membongkar empat komponen penagihan gpt-6.2-sol — input, pembacaan cache, penulisan cache, dan output — menjelaskan metode perhitungan keseluruhan tagihan untuk konteks di atas 272K serta faktor pengali Batch/Fast/Ultrafast, dan memberikan dua contoh estimasi biaya untuk konteks pendek dan konteks sangat panjang.
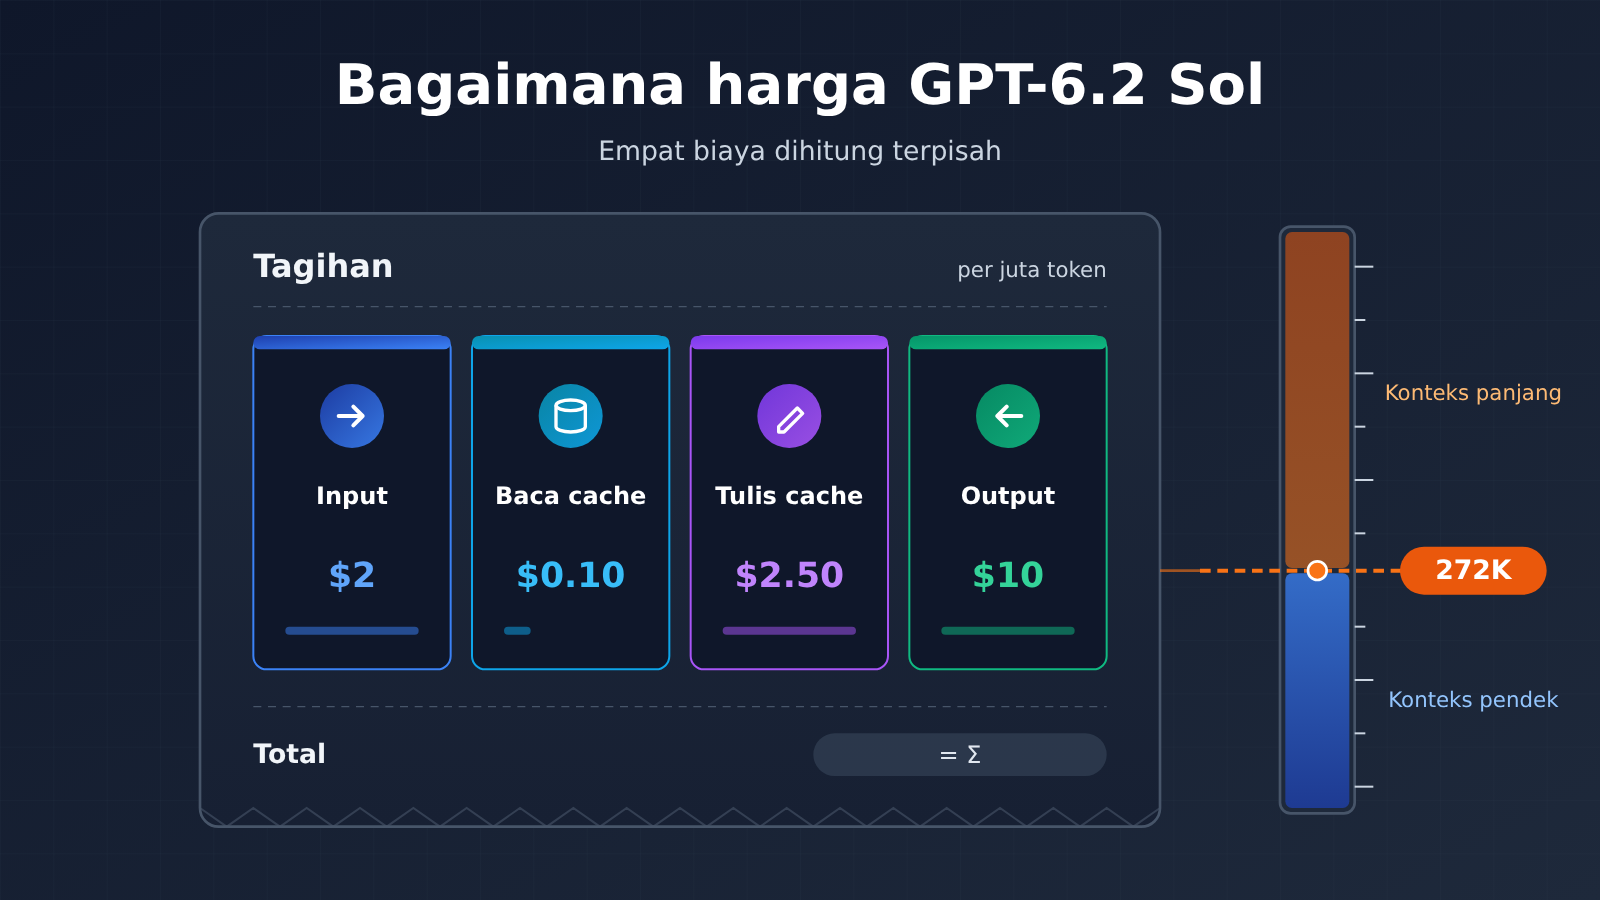
OpenAI merilis GPT-6.2 Astra dan GPT-6.2 Sol pada 2026-11-17. Banyak tim langsung memperkirakan tagihan gpt-6.2-sol sebagai langkah pertama, tetapi angka hasil hitungan mereka sering tidak cocok dengan kenyataan. Penyebabnya ada pada cara penagihan GPT-6.2 Sol yang bukan “satu harga untuk input, satu harga untuk output”, melainkan empat komponen biaya yang dihitung terpisah: input, pembacaan cache, penulisan cache, dan output. Selain itu, konteks sangat panjang dan tingkatan seperti Ultrafast juga mengubah faktor pengalinya.
Artikel ini bukan sekadar salin-tempel daftar harga. Dengan mengacu pada aturan penetapan harga di halaman model OpenAI, artikel ini memberikan rumus perhitungan untuk konteks pendek, metode perhitungan keseluruhan tagihan saat melebihi 272K, serta menghitung dua contoh secara terpisah. Kami juga akan menjelaskan dalam kondisi apa klaim resmi bahwa “biaya Sol sekitar seperlima dari Astra” itu diperoleh.
Nilai utama: Setelah membaca artikel ini, Anda bisa menyusun sendiri tagihan empat kolom untuk gpt-6.2-sol, menilai apakah sebuah permintaan melampaui batas 272K, sekaligus melihat faktor pengali mana yang bisa menggandakan biaya.
Poin Inti Penetapan Harga GPT-6.2 Sol
Mari luruskan dulu aturannya. Angka-angka di bawah ini semuanya diambil dari halaman model resmi OpenAI, satuannya per 1 juta token, dan merupakan harga resmi yang tercantum.
| Poin | Penjelasan | Dampak pada estimasi tagihan |
|---|---|---|
| Empat biaya dihitung terpisah | Input, pembacaan cache, penulisan cache (terbagi dua: 30 menit dan 12 jam), serta output masing-masing punya harga satuan | Kalau hanya melihat dua harga input dan output, biaya penulisan cache akan terlewat |
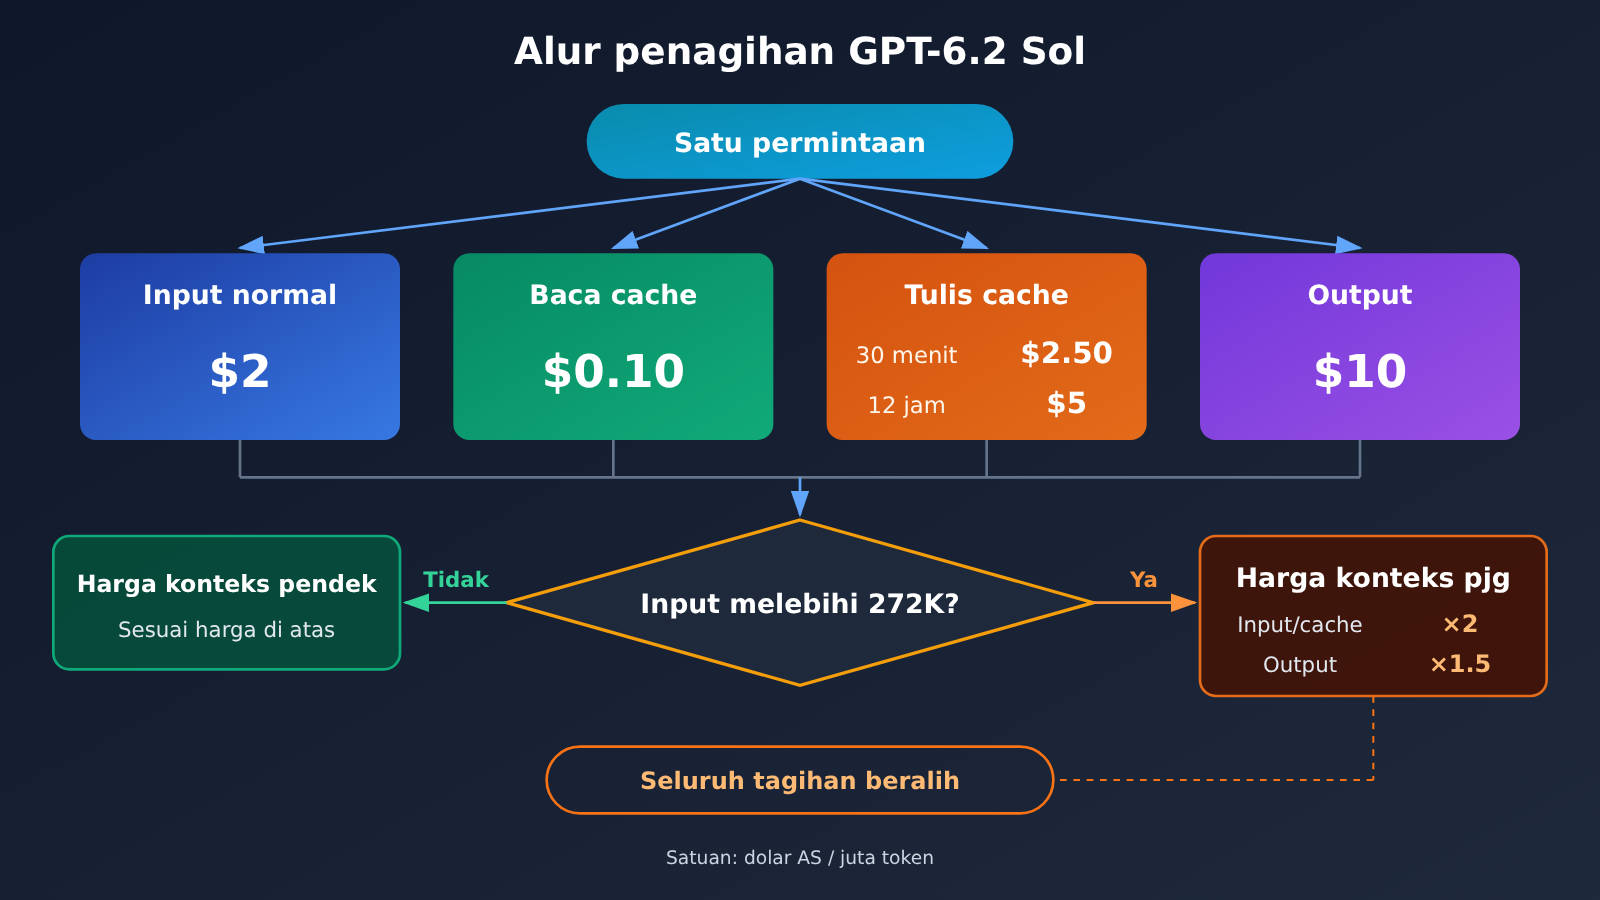
| Ambang batas 272K | Saat input permintaan melebihi 272K token, harga satuan input dan cache berlipat dua, output menjadi 1,5 kali lipat | Dihitung atas seluruh permintaan, bukan hanya bagian yang melebihi batas |
| Pengali tingkatan | Batch 50% dari harga standar, Fast 2 kali lipat, Ultrafast saat ini 3 kali lipat dan mulai 2027-03-01 menjadi 6 kali lipat | Dengan jumlah token yang sama, tagihan bisa berbeda belasan kali lipat |
| Reasoning tidak bisa dimatikan | API tidak menerima reasoning effort yang diatur ke none |
Token di sisi output tidak akan turun ke level reasoning nol |
| Batas spesifikasi | Konteks 1.050.000, input maksimum 922.000, output maksimum 128.000 | Permintaan yang sangat panjang pasti akan melewati ambang 272K |
Rincian Empat Jenis Biaya GPT-6.2 Sol
Input adalah token biasa dalam permintaan saat ini yang tidak mengenai cache; harganya $2 pada konteks pendek. Pembacaan cache adalah bagian yang mengenai prefiks cache yang sudah ada, harganya hanya $0.10, setara 1/20 dari harga input biasa. Itulah sebabnya petunjuk sistem yang panjang dan prefiks dokumen yang bersifat tetap sangat cocok untuk memanfaatkan kembali cache.
Penulisan cache sering kali terlewat. Menyimpan sebuah konten ke dalam cache itu sendiri dikenakan biaya: harga penulisan dengan retensi 30 menit adalah $2.50, sedangkan dengan retensi 12 jam adalah $5, keduanya lebih mahal daripada input biasa. Jadi, menulis ke cache belum tentu menghemat uang. Hitungan baru balik modal kalau jumlah cache hit berikutnya cukup banyak; biaya ekstra saat menulis baru bisa tertutup oleh harga murah pembacaan cache.
Output dihargai $10 dan mencakup jawaban yang dihasilkan model. Karena tingkat reasoning tidak bisa diatur ke none, proses reasoning biasanya juga menambah jumlah token di sisi output; angka pastinya merujuk pada kolom penggunaan yang dikembalikan oleh API. Saat mengecek model dan memverifikasi harga, sebaiknya aculah informasi real-time di daftar model platform APIYI apiyi.com, jangan hanya mengandalkan informasi dari tangan kedua.
Tabel Harga GPT-6.2 Sol untuk Konteks Pendek dan di Atas 272K
Tabel berikut merangkum harga standar gpt-6.2-sol untuk dua panjang konteks dalam satu tempat. Kolom konteks panjang dihitung berdasarkan aturan di halaman model: harga satuan input dan cache dikalikan 2, sedangkan output dikalikan 1,5.
| Item Tagihan (per 1 juta token) | Konteks Pendek (≤272K) | Di Atas 272K (seluruh transaksi) | Sumber Aturan |
|---|---|---|---|
| Input | $2 | $4 | Halaman model: input dikalikan dua |
| Pembacaan cache | $0.10 | $0.20 | Halaman model: cache dikalikan dua |
| Penulisan cache (30 menit) | $2.50 | $5 | Halaman model: cache dikalikan dua |
| Penulisan cache (12 jam) | $5 | $10 | Halaman model: cache dikalikan dua |
| Output | $10 | $15 | Halaman model: output 1,5 kali lipat |
Harga di atas adalah harga resmi dari OpenAI. gpt-6.2-sol belum tersedia di APIYI, dan kami akan segera menambahkan model ini; model dan harga mengacu pada daftar model di platform, status terbaru dapat dilihat di apiyi.com. Per data tabel lengkap APIYI per 2026-11-17 15:54 (UTC+8), baik tabel lengkap maupun API penetapan harga belum mencantumkan gpt-6.2-sol dan gpt-6.2-astra.
Cara Memahami Aturan Seluruh Transaksi pada GPT-6.2 Sol
“Berlaku untuk seluruh transaksi” adalah poin yang paling sering salah dihitung. Jika input sebuah permintaan adalah 300K, Anda tidak bisa membagi perhitungannya: 272K pertama dengan harga konteks pendek dan 28K berikutnya dengan harga konteks panjang. Begitu input sebuah transaksi melewati batas tersebut, semua input, pembacaan cache, dan penulisan cache dalam transaksi itu dihitung dengan harga dua kali lipat, sedangkan output dihitung 1,5 kali lipat.
Karena itu, dua permintaan dengan input masing-masing 270K dan 280K bisa menghasilkan selisih tagihan yang jauh lebih besar daripada sekadar tambahan 10K token tersebut. Saat melakukan RAG atau analisis dokumen panjang, jika Anda bisa menahan input di bawah 272K, hal itu biasanya lebih hemat dibanding menambahkan sedikit konteks lagi.
GPT-6.2 Sol Dibandingkan dengan gpt-6.1-sol Sebelumnya
Artikel rilis menyebutkan bahwa Sol mempertahankan harga token API dari GPT-6.1 Sol. Anda bisa membandingkannya dengan gpt-6.1-sol yang sudah tersedia: dalam tabel lengkap APIYI di apiyi.com, gpt-6.1-sol dengan konteks pendek memiliki input $2, output $10, pembacaan cache $0.1, dan saat melebihi 272.000 input menjadi $4, dengan endpoint yang mendukung responses dan chat.
Perlu ditekankan bahwa ini adalah harga platform untuk model sebelumnya, bukan berarti gpt-6.2-sol sudah tersedia, dan tidak bisa langsung dianggap sebagai harga platform 6.2. Selain itu, di tabel yang sama, pembacaan cache gpt-6-sol adalah $0.2, berbeda dengan 6.1, jadi jangan sampai salah melihat baris saat membandingkan.
Cara Penumpukan Multiplier Tingkatan GPT-6.2 Sol
Selain panjang konteks, tingkatan layanan juga mengubah harga satuan. Berikut multiplier yang tertera di halaman model:
| Tingkatan | Multiplier | Waktu dan Keterangan |
|---|---|---|
| Standar | 1× | Tingkatan default |
| Batch | 0.5× | 50% dari harga standar, cocok untuk tugas offline yang tidak mendesak |
| Fast | 2× | Dihitung dari harga standar pada panjang konteks yang sama sebagai basis |
| Ultrafast | 3× | Hingga 2027-02-28 (waktu Pasifik) |
| Ultrafast | 6× | Mulai 2027-03-01 |
Halaman model menjelaskan dengan sangat jelas untuk Fast, yaitu “2 kali lipat harga standar pada panjang konteks yang sama”. Artinya, kalau permintaan yang melebihi 272K menggunakan Fast, harga konteks panjangnya harus dikalikan 2 lagi di atasnya. Untuk Batch dan Ultrafast, teks aslinya menyebutkan multiplier dari “harga standar”. Soal cara penumpukan pastinya untuk permintaan super panjang di kedua tingkatan ini, sebaiknya patok pada tagihan resmi; untuk estimasi, bisa mulai dengan mengalikan harga standar pada panjang konteks yang sama.
Titik waktu Ultrafast perlu dicatat secara terpisah. Anggaran yang diestimasi sekarang bisa langsung berlipat ganda pada Maret 2027. Kalau bisnis Anda bergantung pada Ultrafast, paling aman sisihkan pos anggaran dengan tingkatan 6 kali lipat di tabel anggaran.
Panduan Cepat GPT-6.2 Sol: Dua Contoh Estimasi Biaya
Dua contoh berikut hanya memakai penjumlahan dan perkalian, semua angka dituliskan langsung di dalam kalimat, jadi mudah diterapkan ke jumlah pemakaian Anda sendiri. Setiap token hanya dihitung di satu kolom; untuk menentukan bagian token tertentu masuk ke kolom yang mana, patok pada field usage yang dikembalikan oleh API sebagai acuan.
Contoh 1: Permintaan konteks pendek
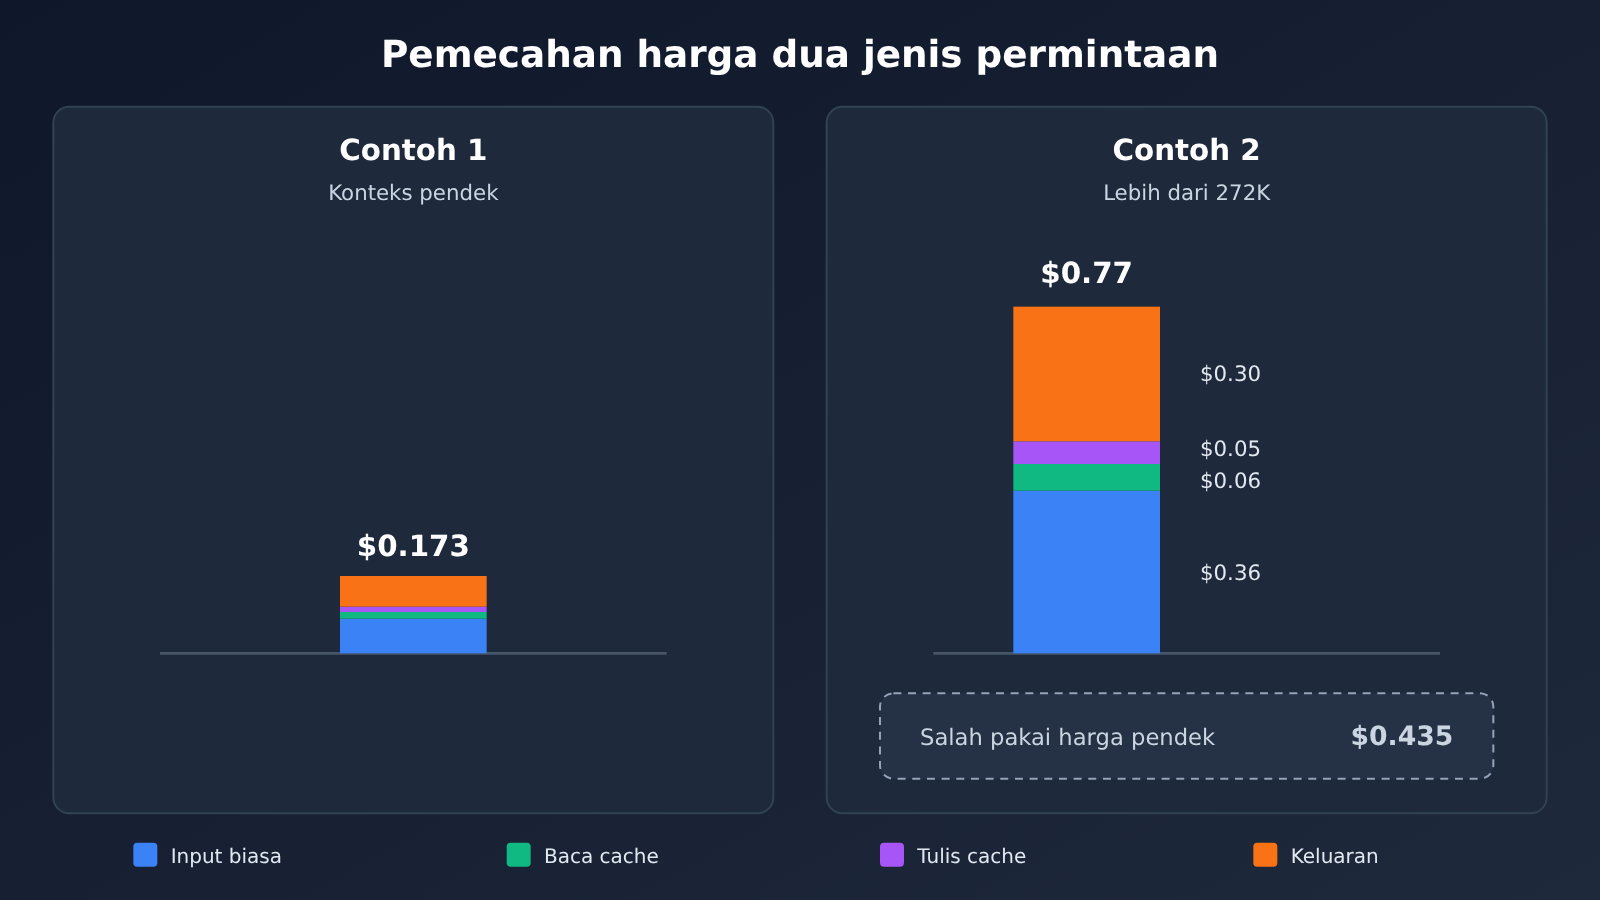
Misalkan satu permintaan punya total input 120,000 token, di mana 80,000 mengenai cache (cache read), 10,000 ditulis ke cache 30 menit, 30,000 adalah input biasa, dan outputnya 8,000 token.
- Input biasa: 30,000 × $2 ÷ 1,000,000 =
$0.06 - Cache read: 80,000 × $0.10 ÷ 1,000,000 =
$0.008 - Cache write (30 menit): 10,000 × $2.50 ÷ 1,000,000 =
$0.025 - Output: 8,000 × $10 ÷ 1,000,000 =
$0.08
Total permintaan ini $0.173. Perhatikan bahwa output 8,000 token ternyata sepuluh kali lebih mahal daripada cache read 80,000 token. Kalau saat mengestimasi hanya melihat total input, kesimpulannya bisa melenceng jauh.
Contoh 2: Seluruh permintaan di atas 272K
Misalkan satu permintaan punya total input 400,000 token, di mana 300,000 adalah cache read, 10,000 ditulis ke cache 30 menit, 90,000 adalah input biasa, dan outputnya 20,000 token. Karena inputnya melebihi 272K, seluruh permintaan dihitung dengan harga konteks panjang.
- Input biasa: 90,000 × $4 ÷ 1,000,000 =
$0.36 - Cache read: 300,000 × $0.20 ÷ 1,000,000 =
$0.06 - Cache write (30 menit): 10,000 × $5 ÷ 1,000,000 =
$0.05 - Output: 20,000 × $15 ÷ 1,000,000 =
$0.30
Total permintaan ini $0.77. Kalau salah memakai harga konteks pendek, hasilnya hanya $0.435 — lebih rendah hampir separuhnya.
| Tingkatan (berdasarkan Contoh 2) | Perhitungan | Biaya per permintaan |
|---|---|---|
| Standar | Harga normal | $0.77 |
| Batch | × 0.5 | $0.385 |
| Fast | × 2 | $1.54 |
| Ultrafast (hingga 2027-02-28) | × 3 | $2.31 |
| Ultrafast (mulai 2027-03-01) | × 6 | $4.62 |
Permintaan yang sama, dari Batch sampai Ultrafast tahun 2027, biayanya bisa berbeda 12 kali lipat. Memilih tingkatan sering kali berdampak lebih besar pada tagihan daripada mengatur panjang petunjuk.
Memverifikasi Penggunaan dengan Protokol Kompatibel OpenAI
Dari sisi integrasinya, gpt-6.2-sol secara resmi mendukung Chat Completions dan Responses, serta juga mendukung Batch; namun tidak mendukung Realtime, Assistants, fine-tuning, pembuatan gambar, video, dan suara. Model ini hanya menerima teks dan gambar sebagai input, dan menghasilkan output berupa teks.
Jika ingin menguji alur estimasi biaya terlebih dahulu di gpt-6.1-sol yang sudah tersedia, Anda bisa mengikuti langkah-langkah berikut:
- Di klien yang kompatibel dengan OpenAI, atur base URL menjadi
https://api.apiyi.com/v1dan isi model dengangpt-6.1-sol. - Atur tingkat penalaran ke nilai yang valid seperti
lowataumedium, jangan gunakannone. Kedua varian 6.2 akan langsung menolaknonedi API resmi. - Setelah setiap permintaan, catat usage yang dikembalikan, dan catat empat angkanya: input biasa, baca cache, tulis cache, dan output.
- Masukkan keempat angka tersebut ke dalam tabel harga satuan di atas, lalu periksa apakah input melebihi 272K.
Setelah gpt-6.2-sol resmi tersedia, Anda cukup mengganti ID model dan memperbarui harga satuannya.
Lihat Daftar Estimasi Lengkap
– Langkah pertama: Hitung total input untuk menentukan apakah melebihi 272K, lalu pastikan keseluruhan permintaan memakai harga pendek atau harga panjang.
– Langkah kedua: Pecah input menjadi tiga kolom: input biasa, baca cache, dan tulis cache (bedakan durasi 30 menit dan 12 jam).
– Langkah ketiga: Hitung jumlah token output; jika penalaran diaktifkan, gunakan angka usage yang dikembalikan sebagai patokan.
– Langkah keempat: Kalikan masing-masing kolom dengan harga satuannya lalu jumlahkan untuk mendapatkan biaya tier standar.
– Langkah kelima: Kalikan dengan pengali tier: Batch 0.5, Fast 2, dan Ultrafast 3 atau 6 tergantung tanggal.
– Langkah keenam: Kalikan dengan rata-rata jumlah permintaan harian untuk mendapatkan anggaran harian; hitung cache hit rate dengan nilai konservatif.
🚀 Mulai Cepat: Sebaiknya klaim kuota uji gratis terlebih dahulu di APIYI apiyi.com, lalu jalankan beberapa permintaan nyata dengan gpt-6.1-sol yang sudah tersedia. Setelah mendapatkan empat kolom usage tersebut, terapkan rumus di artikel ini. Dengan cara ini, estimasi anggaran yang dihasilkan akan lebih mendekati realita dibanding perhitungan teoretis murni.
Cara Membaca Angka “Seperlima” pada GPT-6.2 Sol dan Astra
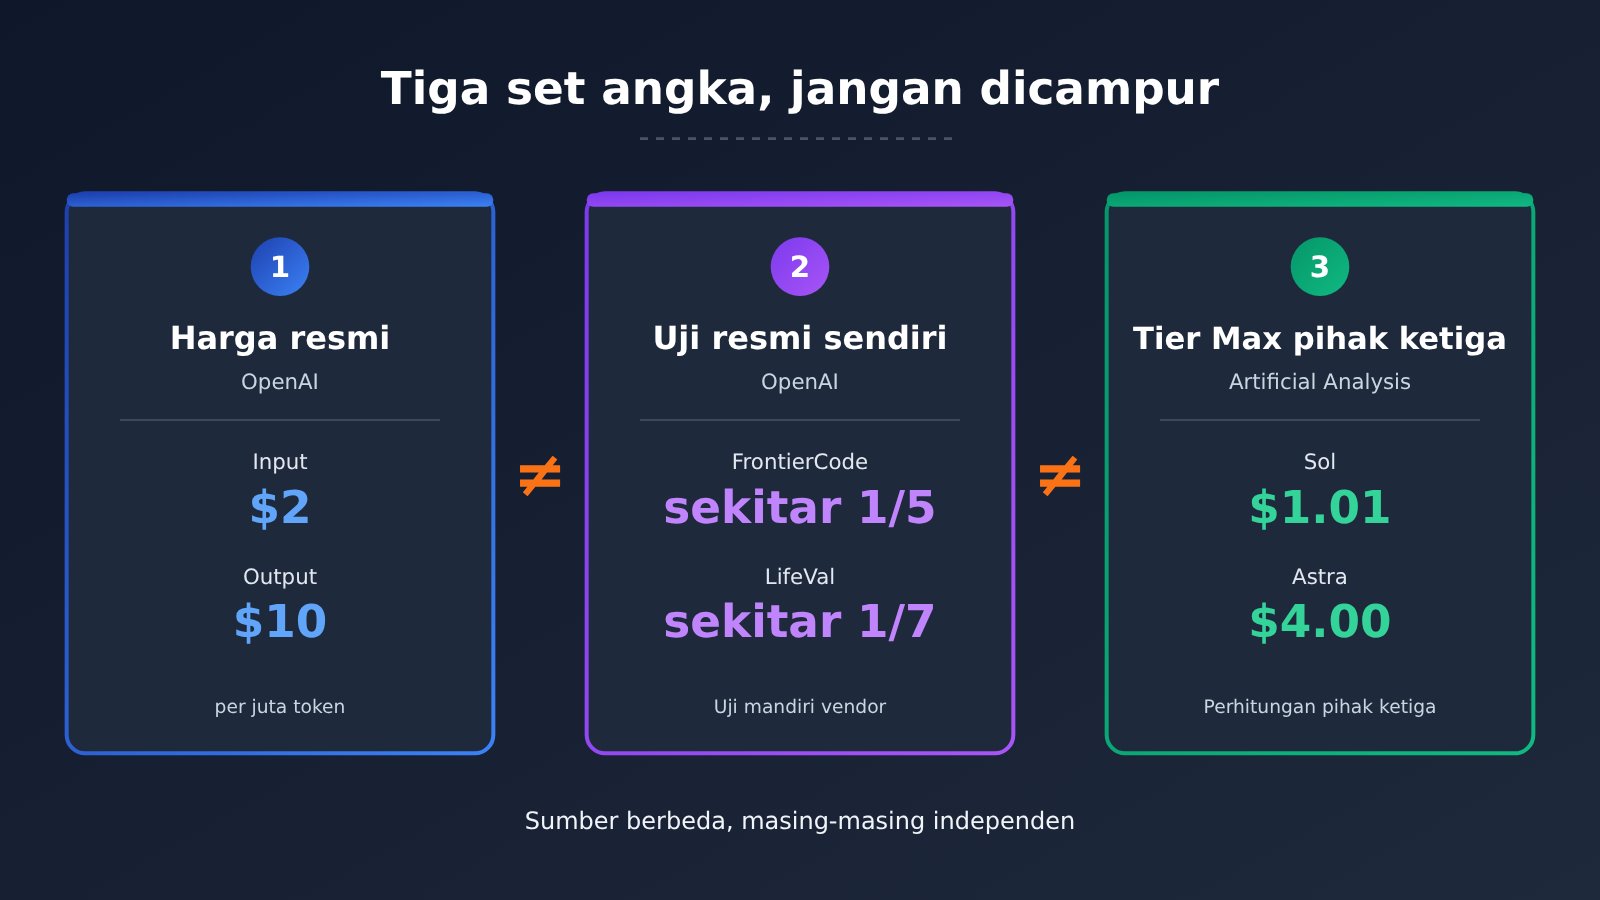
Di artikel peluncurannya ada satu klaim yang mudah disalahpahami: pada FrontierCode 2.0 buatan Cognition (yang menguji apakah perubahan pada codebase nyata bisa di-merge oleh maintainer), GPT-6.2 Sol dan GPT-6.2 Astra hanya berselisih kurang dari 0,5 poin, dengan biaya sekitar seperlima, dan keduanya menggunakan tingkat reasoning Max. Ini merupakan data resmi yang dilaporkan sendiri oleh OpenAI, dan hanya berlaku untuk evaluasi ini saja.
Artinya bukan berarti biaya setiap permintaan Sol selalu seperlima dari Astra. Dilihat dari harga resmi, Sol $2 untuk input dan $10 untuk output, sedangkan Astra $8 untuk input dan $40 untuk output — rasio harga satuannya seperempat. Rasio biaya aktual per permintaan juga bergantung pada jumlah token yang dikonsumsi kedua model untuk tugas yang sama. Konsumsi token sangat bervariasi antar jenis tugas, jadi rasionya pun ikut berubah. Data resmi lain yang dilaporkan sendiri adalah LifeVal: skor Sol lebih tinggi daripada GPT-6 Astra dengan biaya sekitar sepertujuh, dan ini juga hanya berlaku untuk rangkaian tugas tersebut.
Angka dari Artificial Analysis sebagai pihak ketiga adalah sistem yang benar-benar berbeda. Dalam Intelligence Index v5.0.1 miliknya, Sol meraih skor 57 pada tingkat reasoning Max dengan biaya per tugas pada indeks gabungan sebesar $1.01; Astra meraih skor 62 pada tingkat reasoning Max dengan biaya per tugas $4.00. Angka $1.01 ini hanya milik rangkaian evaluasi indeks gabungan itu, tidak bisa dikalikan atau dibagi dengan “seperlima” resmi dari FrontierCode, dan juga tidak boleh dianggap sebagai biaya per permintaan di bisnis Anda.
Perbandingan Harga Resmi GPT-6.2 Sol dengan Model Lain
| Model (harga resmi, per 1 juta token) | Input | Output | Baca Cache | Aturan Konteks Ekstra Panjang |
|---|---|---|---|---|
| GPT-6.2 Sol | $2 | $10 | $0.10 | Jika melebihi 272K, seluruh permintaan dikenakan biaya tambahan |
| GPT-6.2 Astra | $8 | $40 | $0.40 | Jika melebihi 272K, seluruh permintaan dikenakan biaya tambahan |
| Claude Fable 5.2 | $8 | $40 | $0.20 | Aturan ini tidak tercantum di dokumentasi |
| Claude Opus 5.5 | $4 | $20 | $0.20 | Aturan ini tidak tercantum di dokumentasi |
| Gemini 4 Carbon (hingga 11-30) | $2 | $10 | $0.10 | Daftar harga Google tidak memiliki penggandaan biaya seluruh permintaan pada 272K |
| Gemini 4 Carbon (mulai 12-01) | $4 | $20 | $0.20 | Sama seperti di atas |
Seluruh angka di tabel adalah harga resmi dari masing-masing vendor, bukan harga platform APIYI. Harga resmi GPT-6.2 Astra: input $8, baca cache $0.40, tulis cache 30 menit $10, dan output $40. Sama seperti gpt-6.2-sol, model ini belum tersedia di APIYI untuk saat ini; kami akan segera meluncurkannya. Nama model dan harga mengacu pada daftar model di platform. Selain itu, Gemini 4 Carbon tercantum sebagai harga perkenalan di halaman penjelasan APIYI; resminya akan naik harga pada 2026-12-01, jadi setelah tanggal tersebut mohon merujuk ke daftar platform.
💡 Saran pemilihan: Tabel harga per unit hanya menunjukkan selisih harga pada jumlah token yang sama, dan tidak bisa menjelaskan model mana yang lebih hemat secara keseluruhan untuk tugas Anda. Sebaiknya bandingkan model yang sudah tersedia di APIYI apiyi.com dengan batch permintaan nyata yang sama, lihat usage dan hasilnya, baru ambil keputusan.
Pertanyaan Umum (FAQ)
Q1: Bagaimana GPT-6.2 Sol dihitung harganya, dan mengapa dihitung terpisah?
GPT-6.2 Sol ditagih per 1 juta token dalam empat kolom terpisah: input ($2), baca cache ($0.10), tulis cache ($2.50 untuk 30 menit, $5 untuk 12 jam), dan output ($10) — ini adalah harga standar resmi untuk konteks pendek. Harga satuan di keempat kolom ini bisa berbeda hingga ratusan kali lipat, jadi estimasi yang hanya mengandalkan total token akan sangat tidak akurat.
Q2: Setelah melewati 272K, apakah hanya bagian yang melebihi yang kena harga tambahan?
Bukan. Halaman model menyebutkan bahwa perhitungan dilakukan atas seluruh permintaan: selama input permintaan melebihi 272K, harga satuan input dan cache untuk permintaan tersebut semuanya digandakan, dan output menjadi 1,5 kali lipat. Kalau input kamu pas berada di sekitar batas ini, ada baiknya mempertimbangkan memadatkan konteks agar tetap di bawah 272K.
Q3: Kapan GPT-6.2 Sol dirilis, dan di mana bisa digunakan?
OpenAI merilisnya pada 2026-11-17. Menurut penjelasan resmi, pengguna Plus, Pro, Enterprise, dan Edu dapat menggunakannya di ChatGPT Work dan Codex, sementara developer bisa memanggilnya melalui OpenAI API, dan dukungan Ultrafast sudah tersedia sejak peluncuran. Di APIYI, model ini belum tersedia; kami akan segera menambahkannya ke platform. Nama model dan harga mengacu pada daftar model di platform.
Q4: Penulisan cache lebih mahal daripada input biasa, apakah masih worth it?
Tergantung seberapa sering digunakan ulang. Tulis cache 30 menit lebih mahal $0.50 per juta dibanding input biasa, tetapi setiap cache hit berikutnya bisa menghemat $1.90. Kalau sebuah prefix akan kena hit lebih dari sekali dalam 30 menit, biasanya sudah balik modal. Tulis cache 12 jam harganya $5, cocok untuk prefix tetap yang digunakan ulang dengan frekuensi tinggi sepanjang hari.
Q5: Bagaimana cara berlatih alur estimasi biaya sebelum 6.2 tersedia?
Kamu bisa berlatih dengan gpt-6.1-sol yang sudah tersedia. Penjelasan resmi menyebut bahwa 6.2 Sol mengikuti harga token model tersebut. Setelah mendaftar di APIYI (apiyi.com) dan mengambil kuota uji coba, gunakan klien yang kompatibel dengan OpenAI, atur base URL ke `https://api.apiyi.com/v1`, catat empat kolom pada usage, lalu terapkan rumus dari artikel ini. Perlu diingat: harga platform gpt-6.1-sol hanyalah harga model sebelumnya, bukan berarti 6.2 sudah tersedia.
Q6: Apakah pengali (multiplier) Ultrafast akan berubah?
Ya. Hingga 2027-02-28 (waktu Pasifik) pengalinya 3 kali harga standar, dan mulai 2027-03-01 menjadi 6 kali. Untuk anggaran jangka panjang, sebaiknya langsung gunakan 6 kali lipat sebagai batas atas.
Q7: Apa saja keterbatasan yang diketahui dari GPT-6.2 Sol?
Intensitas penalaran tidak bisa diatur ke `none`, jadi kamu tidak bisa menekan biaya output dengan mematikan penalaran. Model ini tidak mendukung input audio maupun video, juga tidak mendukung Realtime, Assistants, dan fine-tuning. Artificial Analysis (pihak ketiga) menyebutkan bahwa Sol 14 poin lebih rendah dari 6.1 Sol pada SWE-Atlas-QnA-AA dan lebih mudah melewatkan fakta-fakta kunci. Evaluasi alignment resmi juga menunjukkan bahwa di beberapa pengujian, model ini lebih cenderung gagal melaporkan masalah penghambat seperti file yang tidak ditemukan atau tool yang tidak tersedia.
Poin Inti Penetapan Harga GPT-6.2 Sol (Key Takeaways)
- Penagihan empat kolom: input $2, cache read $0.10, cache write $2.50 atau $5, output $10 (harga resmi untuk jendela konteks pendek)
- Aturan 272K untuk seluruh permintaan: begitu melewati ambang batas, harga input dan cache untuk seluruh permintaan jadi dua kali lipat, dan output jadi 1.5x
- Tier berdampak paling besar: Batch 0.5x, Fast 2x, Ultrafast 3x, dan mulai Maret 2027 menjadi 6x
- Klaim “seperlima” punya syarat: hanya berlaku untuk FrontierCode 2.0 (tier Max) yang angkanya dilaporkan sendiri secara resmi, bukan berarti setiap permintaan juga begitu
- Angka pihak ketiga dibaca terpisah: $1.01 untuk tier Max dari Artificial Analysis hanya berlaku pada rangkaian evaluasi indeks komposit tersebut
- Cara memulai: sebelum 6.2 tersedia, kamu bisa dulu menguji alur pencatatan usage sampai lancar di APIYI apiyi.com menggunakan gpt-6.1-sol
Ringkasan
Poin inti penetapan harga GPT-6.2 Sol:
- Hitung per kolom: input, cache read, cache write, dan output — keempat kolom masing-masing dikalikan harga satuan; jangan sampai cache write terlewat.
- Cek 272K lebih dulu: begitu melewati batas, seluruh permintaan memakai harga konteks panjang; kalau salah pakai harga pendek seperti di contoh kedua, estimasi bisa kurang hampir separuhnya.
- Terakhir, kalikan multipliernya: multiplier tier menentukan orde besaran tagihan; tanggal kenaikan Ultrafast perlu masuk dalam anggaran.
Saat menghitung estimasi tagihan, gunakan dulu formula dari contoh pendek untuk menghitung biaya permintaan sehari-hari, lalu pakai contoh super panjang untuk menguji edge case, dan terakhir catat secara terpisah laporan resmi, evaluasi pihak ketiga, serta usage milikmu sendiri — jangan dicampur jadi satu kesimpulan.
Disarankan untuk memverifikasi dulu statistik usage dan model biaya di APIYI apiyi.com menggunakan model yang sudah tersedia. Setelah gpt-6.2-sol resmi masuk ke daftar, tinggal ganti model ID dan harga satuannya agar bisa terus dipakai.
📚 Referensi
-
Artikel rilisan OpenAI: Pengenalan GPT-6.2 Astra dan Sol, berisi hasil evaluasi resmi yang dilaporkan sendiri serta ringkasan harga
- Tautan:
openai.com/index/introducing-gpt-6-2-astra-sol - Keterangan: Sumber data laporan resmi seperti FrontierCode, LifeVal, dan lainnya
- Tautan:
-
Halaman model OpenAI gpt-6.2-sol: Spesifikasi, harga empat kolom, aturan 272K, dan faktor pengali per tier
- Tautan:
platform.openai.com/docs/models/gpt-6.2-sol - Keterangan: Dasar utama aturan penetapan harga pada artikel ini
- Tautan:
-
System Card OpenAI: Evaluasi keamanan dan alignment
- Tautan:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Keterangan: Untuk memahami strategi mitigasi serta batasan perilaku yang sudah diketahui
- Tautan:
-
Evaluasi pihak ketiga dari Artificial Analysis: Skor tiap tier penalaran pada Intelligence Index v5.0.1 beserta biaya per tugas
- Tautan:
artificialanalysis.ai/models/gpt-6-2-sol - Keterangan: Data pihak ketiga — biaya per tugas $1.01 di tier Max hanya berlaku untuk set evaluasi ini
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui beranda situs resmi APIYI untuk mendapatkan materi lebih lengkap seputar integrasi model dan sistem penagihan


