
On peut économiser, mais sous conditions. D’après les deux exemples hypothétiques donnés dans la documentation officielle de Google, dans un scénario avec 200 outils et un contexte de base de 2 000 tokens, les tokens d’entrée de Gemini Tool Retrieval passent de 164 000 à 23 650, soit une baisse d’environ 85,6 %. Dans un scénario avec 10 outils et un contexte de base de 30 000 tokens, les tokens d’entrée passent de 68 000 à 92 830, soit une hausse d’environ 36,5 %. Le calcul est-il favorable ? Tout dépend d’une question : les schémas complets des outils économisés compensent-ils le surcoût de contexte engendré par la recherche côté serveur ?
Que retiendrez-vous de cet article ?
- Quelle partie des tokens Tool Retrieval permet d’économiser, et quelle nouvelle partie de tokens ajoute-t-il.
- Les hypothèses complètes et le détail poste par poste des deux exemples officiels, à 200 outils et à 10 outils.
- La formule du seuil de rentabilité déduite des paramètres officiels, ainsi que la méthode pour juger « à partir de combien d’outils cela vaut le coup de l’activer ».
- Comment utiliser le champ
interaction.usageet les règles de cache pour calculer le coût réel d’une tâche d’agent.
Sommaire : commencez par le tableau des concepts et l’aperçu des impacts pour harmoniser les termes et déterminer à quel type de lecteur vous appartenez. La partie « Faits objectifs » expose le mécanisme rendu public par Google, les règles de facturation et les hypothèses exactes des deux exemples. La partie « Analyse et interprétation » présente le point d’équilibre déduit des paramètres officiels, la distinction entre trois formes d’« économie », la formule de facturation par tâche et le tableau d’aide à la décision pour l’activation.
Analyse de coûts de Gemini Tool Retrieval To Know : les concepts expliqués
| Concept | Brève explication |
|---|---|
| Tokens d’entrée | Unité de mesure du texte, de l’historique de contexte et des déclarations d’outils envoyés au modèle pour traitement |
| Schéma d’outil | La définition complète des paramètres sur laquelle le modèle s’appuie pour générer un appel de fonction ; dans l’exemple de calcul, environ 400 tokens par outil |
| Liste d’outils différés | Une fois defer_loading: true défini, le modèle ne voit d’abord que le nom et le résumé de l’outil ; lors des premiers tests officiels, environ 26 tokens par élément |
| Contexte de base B | Dans l’exemple de calcul, les informations d’historique et de tâche que chaque appel au modèle traite de toute façon |
| Inférence après recherche | L’appel supplémentaire au modèle exécuté côté serveur une fois l’outil retrouvé, en repartant du contexte existant plus le schéma nouvellement ajouté |
total_tool_use_tokens |
Dans une même requête, le volume d’entrée des appels au modèle supplémentaires déclenchés par les outils côté serveur et par la recherche |
total_cached_tokens |
La part de l’usage d’entrée traitée par le cache et facturée au tarif cache |
| Seuil de rentabilité | Avec le même jeu d’hypothèses, la limite à laquelle le coût d’entrée du chargement statique et celui du chargement à la demande s’égalisent |
| Coût par tâche réussie | La somme des coûts de tous les appels au modèle et des frais d’outils engagés pour atteindre un objectif métier |
Aperçu rapide des impacts de Gemini Tool Retrieval
- Développeurs d’agents connectés à une grande bibliothèque d’outils : quand les outils sont nombreux mais qu’une tâche n’en utilise que quelques-uns, il y a une vraie possibilité de réduire nettement le coût du schéma réinjecté à chaque fois. C’est exactement le scénario de l’exemple officiel à 200 outils.
- Développeurs d’applications avec un petit jeu d’outils et un contexte long : chaque recherche côté serveur relance une inférence et retraite tout le long contexte ; une fois activée, l’option peut donc coûter plus cher. L’exemple officiel à 10 outils en est le contre-exemple.
- Équipes d’ingénierie ou FinOps chargées du calcul des coûts : ne regarder que le
total_input_tokensde la première requête sous-estime le coût. Il faut compter ensembletotal_tool_use_tokens, les hits de cache et les tokens de sortie. - Équipes plateforme qui maintiennent le registre d’outils de l’entreprise : le mode de récupération côté client permet de combiner son propre filtrage de permissions et des outils dynamiques, mais chaque recherche ajoute un aller-retour API ; le calcul de coût doit donc être évalué séparément.
Faits objectifs : lancement et mécanisme de facturation de Gemini Tool Retrieval
Qu’est-ce que Gemini Tool Retrieval et quand a-t-il été lancé ?
Le 19 novembre 2026, Google a annoncé sur son blog officiel l’ouverture en preview de la fonctionnalité Tool Retrieval dans la Gemini Interactions API. Cette fonctionnalité est en phase Preview, nécessite la version d’API v1beta et n’est pas prise en charge par l’ancienne méthode generateContent. Pour activer le mode côté serveur, il faut ajouter {"type": "tool_search"} dans tools, puis définir defer_loading: true sur les function ou mcp_server que l’on souhaite charger de manière différée.
Au 20 novembre 2026, la documentation développeur liste explicitement quatre ID de modèles compatibles : gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash et gemini-3.6-flash. La formulation de l’annonce, qui évoque « Gemini 3.6 et modèles plus récents », est plus large, mais les modèles non répertoriés dans la documentation doivent être vérifiés par vous-même : définir defer_loading sur un modèle non pris en charge renvoie une erreur HTTP 400.
Il faut souligner un point souvent mal compris : en mode côté serveur, le développeur doit toujours envoyer le tableau tools complet à chaque requête, y compris les paramètres intégrals des outils différés, même en utilisant previous_interaction_id. Tool Retrieval modifie le moment où le schéma complet entre dans le contexte du modèle, et non le fait que ces définitions cessent d’être envoyées dans le corps de la requête.
D’où viennent les coûts du chargement statique et de Gemini Tool Retrieval
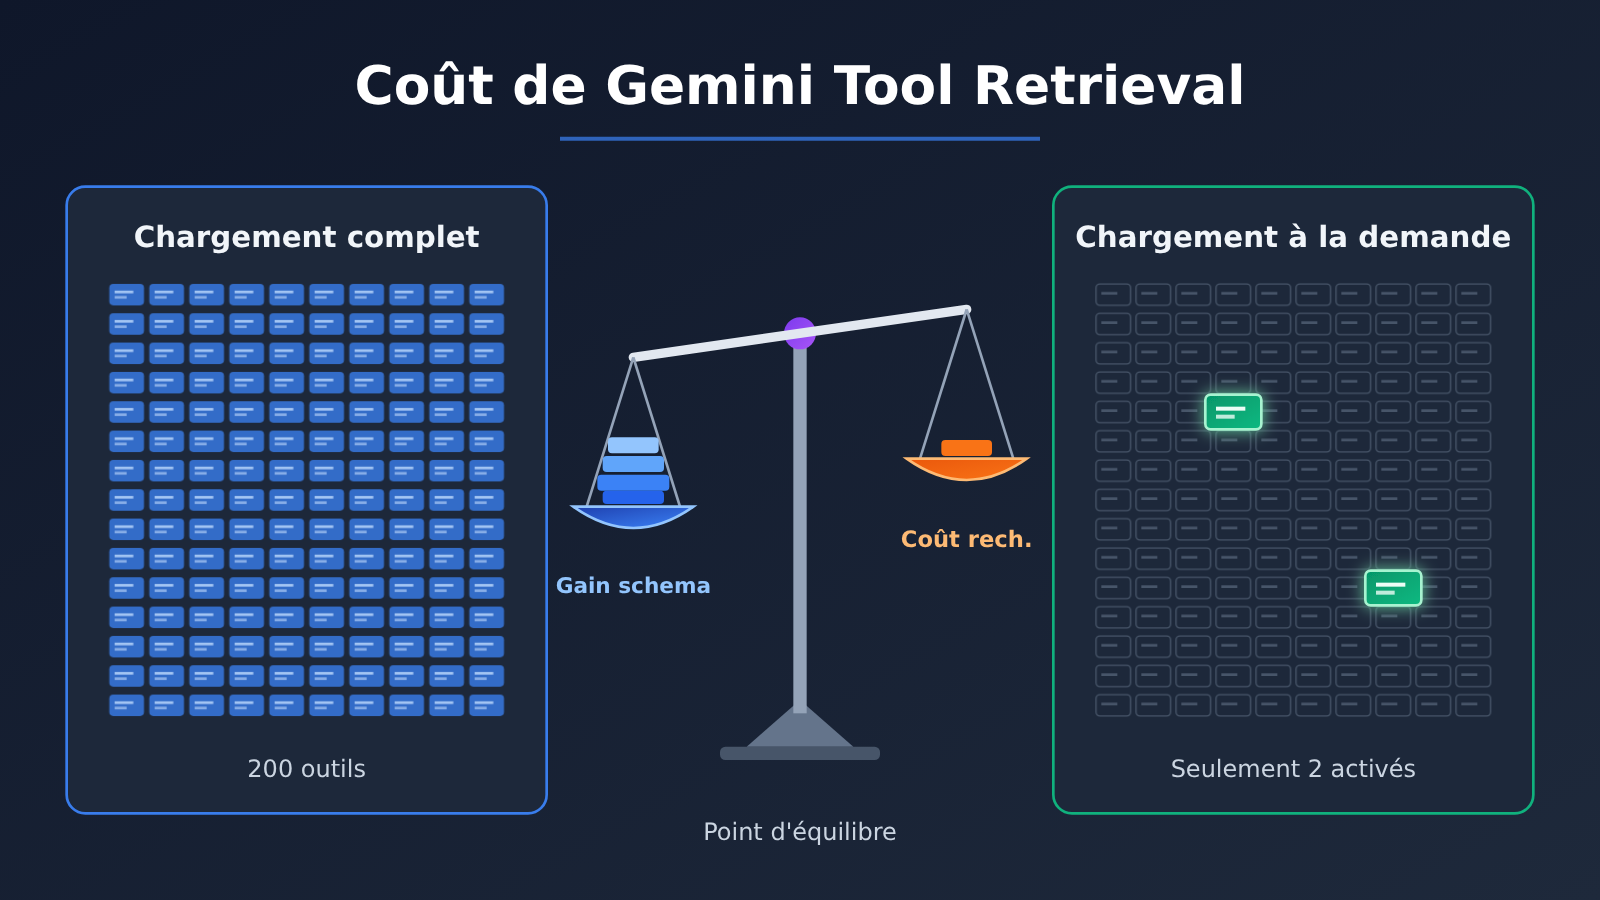
En chargement statique, chaque invocation du modèle doit lire le schéma complet de tous les outils, même si, dans ce tour, on n’utilise qu’une seule fonction de remboursement. Tool Retrieval remplace ces définitions complètes par une courte liste d’outils. Lorsque le modèle en a besoin, il déclenche un tool_search_call, le serveur renvoie un tool_search_result contenant le schéma complet, et le modèle génère ensuite un function_call à partir de celui-ci.
Google indique clairement que Tool Retrieval n’entraîne pas de frais de fonctionnalité séparés, mais les éléments suivants restent facturés au tarif du modèle choisi :
- Tous les éléments de la liste courte des outils à chargement différé.
- Les instructions de recherche fixes ajoutées lorsque
tool_searchest activé. - L’inférence supplémentaire du modèle déclenchée à chaque recherche côté serveur : celle-ci retraite le contexte complet et le schéma nouvellement chargé.
- Le schéma complet des outils chargés, ainsi que leur maintien en contexte lors des tours suivants (la documentation actuelle ne prévoit pas de mécanisme de déchargement).
- Les tokens associés à la sortie normale, au Thinking et aux résultats d’exécution des outils.
Exemples officiels de Gemini Tool Retrieval : 200 outils et 10 outils
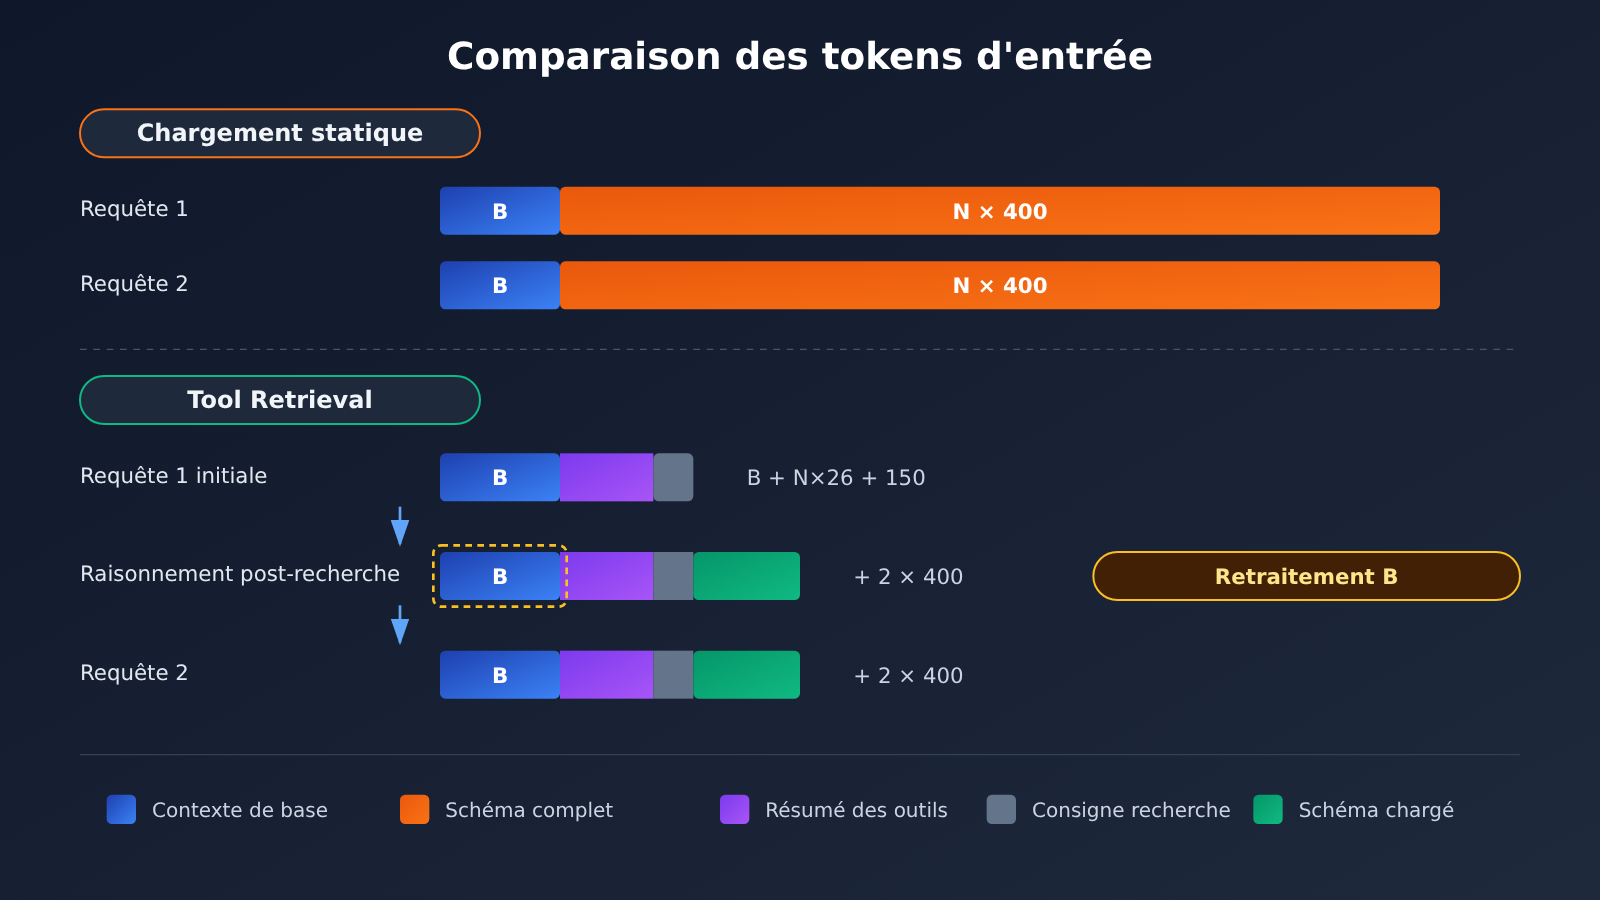
Les deux séries d’exemples proviennent de la documentation Google Tool Retrieval. Il s’agit de calculs hypothétiques indiqués officiellement, et non de benchmarks en environnement de production ; les deux ignorent également les tokens de sortie et les gains liés au cache. Les hypothèses communes sont les suivantes : chaque schéma complet représente 400 tokens, chaque brève description d’outil différé environ 26 tokens, l’instruction de recherche 150 tokens, une tâche comprend 2 requêtes externes, une recherche côté serveur est effectuée lors de la première requête, et 2 outils sont chargés au total.
| Poste de calcul | 200 outils, B=2,000 | 10 outils, B=30,000 |
|---|---|---|
| Chargement statique : 2 × (B + N × 400) | 164,000 | 68,000 |
| Entrée initiale de la requête 1 (B + N × 26 + 150) | 7,350 | 30,410 |
| Inférence après recherche pour la requête 1 (plus 2 schémas) | 8,150 | 31,210 |
| Entrée de la requête 2 | 8,150 | 31,210 |
| Total Tool Retrieval | 23,650 | 92,830 |
| Variation | -140,350 | +24,830 |
| Amplitude de variation (recalculée à partir des chiffres officiels) | environ -85.6% | environ +36.5% |
Le scénario à 200 outils réalise une économie nette parce que l’approche statique doit porter à chaque fois 80,000 tokens de définitions d’outils, alors que le contexte de base ne fait que 2,000 tokens ; le coût d’une inférence supplémentaire pour la recherche reste donc faible. Le scénario à 10 outils est exactement l’inverse : les définitions d’outils totalisent seulement 4,000 tokens, la marge d’économie est donc limitée ; or l’inférence après recherche doit retraiter le long contexte de 30,000 tokens, et le surcoût ajouté l’emporte directement sur les économies réalisées.
Champs Usage, tarifs et règles de cache de Gemini Tool Retrieval
Google met à disposition dans interaction.usage les champs nécessaires pour analyser le coût de Tool Retrieval :
| Champ | Signification | Rôle dans l’analyse des coûts |
|---|---|---|
total_input_tokens |
Entrée du premier appel au modèle dans la requête | Permet seulement de voir « de combien le contexte initial a été raccourci » |
total_tool_use_tokens |
Entrée des appels supplémentaires au modèle déclenchés par les outils côté serveur et la recherche | Principale source du coût de recherche, et celle qu’on oublie le plus facilement |
total_cached_tokens |
Partie déjà incluse dans l’entrée et traitée par le cache | Facturée au tarif du cache, à ne pas additionner une deuxième fois |
total_output_tokens |
Sortie générée par le modèle | Facturée au tarif de sortie |
total_thought_tokens |
Tokens produits par le raisonnement | Facturés au tarif de sortie du modèle choisi |
Côté tarifs, dans la grille Standard de la page de tarification de Google, Gemini 4 Hydrogen est facturé $1.50 par million de tokens en entrée, $7.50 en sortie (Thinking inclus), et $0.075 pour l’entrée mise en cache. Si l’on se contente de multiplier le prix d’entrée par les volumes des exemples officiels, le scénario à 200 outils donne environ $0.246 contre $0.0355, et celui à 10 outils environ $0.102 contre $0.139. Il ne s’agit là que de nombres hypothétiques de tokens multipliés par les tarifs officiels, pas d’une facture réelle.
Deux seuils sont à distinguer dans les règles de cache. Premièrement, l’API Interactions ne prend en charge que le cache implicite. Au 20 novembre 2026, la taille d’entrée minimale pour le cache implicite est de 4,096 tokens pour la série Gemini 4, Gemini 3.8 Flash et Gemini 3.6 Flash. Deuxièmement, dans les conversations multi-tours et l’Agent Loop de Gemini 4, une nouvelle requête doit ajouter au moins 2,050 tokens pour que le système mette en cache l’intégralité de la requête précédente. Sinon, les 2,050 derniers tokens de la requête précédente sont facturés à nouveau au tarif d’entrée standard ; la sortie du modèle, le Thinking et les résultats de fonction comptent tous dans ce volume ajouté.
À la date de vérification des informations, Google n’a pas publié le pourcentage de tokens économisés par Tool Retrieval sur de véritables jeux de tâches, ni l’ampleur de l’amélioration de la latence, ni celle de la précision de sélection des outils. On ne trouve pas non plus de test en production mené par un développeur indépendant et suffisamment vérifiable.
Analyse : quand Gemini Tool Retrieval permet vraiment d’économiser des tokens
Le seuil de rentabilité de Gemini Tool Retrieval : à partir de combien d’outils vaut-il la peine de l’activer
Ce qui suit est un exemple étendu dérivé des paramètres de l’exemple officiel, et non un seuil universel publié par Google. Soit N le nombre total d’outils et B le contexte de base. On reprend S=400, D=26, H=150, K=2 et l’hypothèse « deux requêtes, une recherche » :
- Chargement statique : T_static = 2 × (B + 400N)
- Chargement à la demande : T_retrieval = 3 × (B + 26N + 150) + 2 × 2 × 400
Cette formule reproduit intégralement les deux résultats officiels. En posant T_retrieval < T_static, on obtient après simplification 722N > B + 2050, soit N > (B + 2050) / 722. Le 2050 provient ici de 3 × 150 + 1600 : ce n’est qu’un résultat algébrique, sans aucun rapport avec la condition d’incrément de 2,050 tokens du cache multi-tours de Gemini 4 mentionnée dans la documentation sur le cache — surtout ne confondez pas les deux.
| Contexte de base B | Nombre d’outils N | Chargement statique | Tool Retrieval | Variation | Amplitude | Type de données |
|---|---|---|---|---|---|---|
| 2,000 | 200 | 164,000 | 23,650 | -140,350 | -85.6% | Exemple officiel |
| 30,000 | 10 | 68,000 | 92,830 | +24,830 | +36.5% | Exemple officiel |
| 30,000 | 44 | 95,200 | 95,482 | +282 | +0.3% | Déduction étendue |
| 30,000 | 45 | 96,000 | 95,560 | -440 | -0.5% | Déduction étendue |
| 30,000 | 50 | 100,000 | 95,950 | -4,050 | -4.1% | Déduction étendue |
| 30,000 | 100 | 140,000 | 99,850 | -40,150 | -28.7% | Déduction étendue |
Pour B=30,000, le seuil est N > 44,39 : c’est à partir du 45e outil que le chargement à la demande prend légèrement l’avantage, et près du point d’équilibre, les économies sont quasiment négligeables. Avec la même formule, si B=2,000, le seuil est d’environ 5,6, autrement dit 6 outils suffisent à inverser la tendance. On en déduit que plus le contexte de base est long, plus il faut une bibliothèque d’outils imposante pour amortir le coût de retraitement du contexte lors de la recherche.
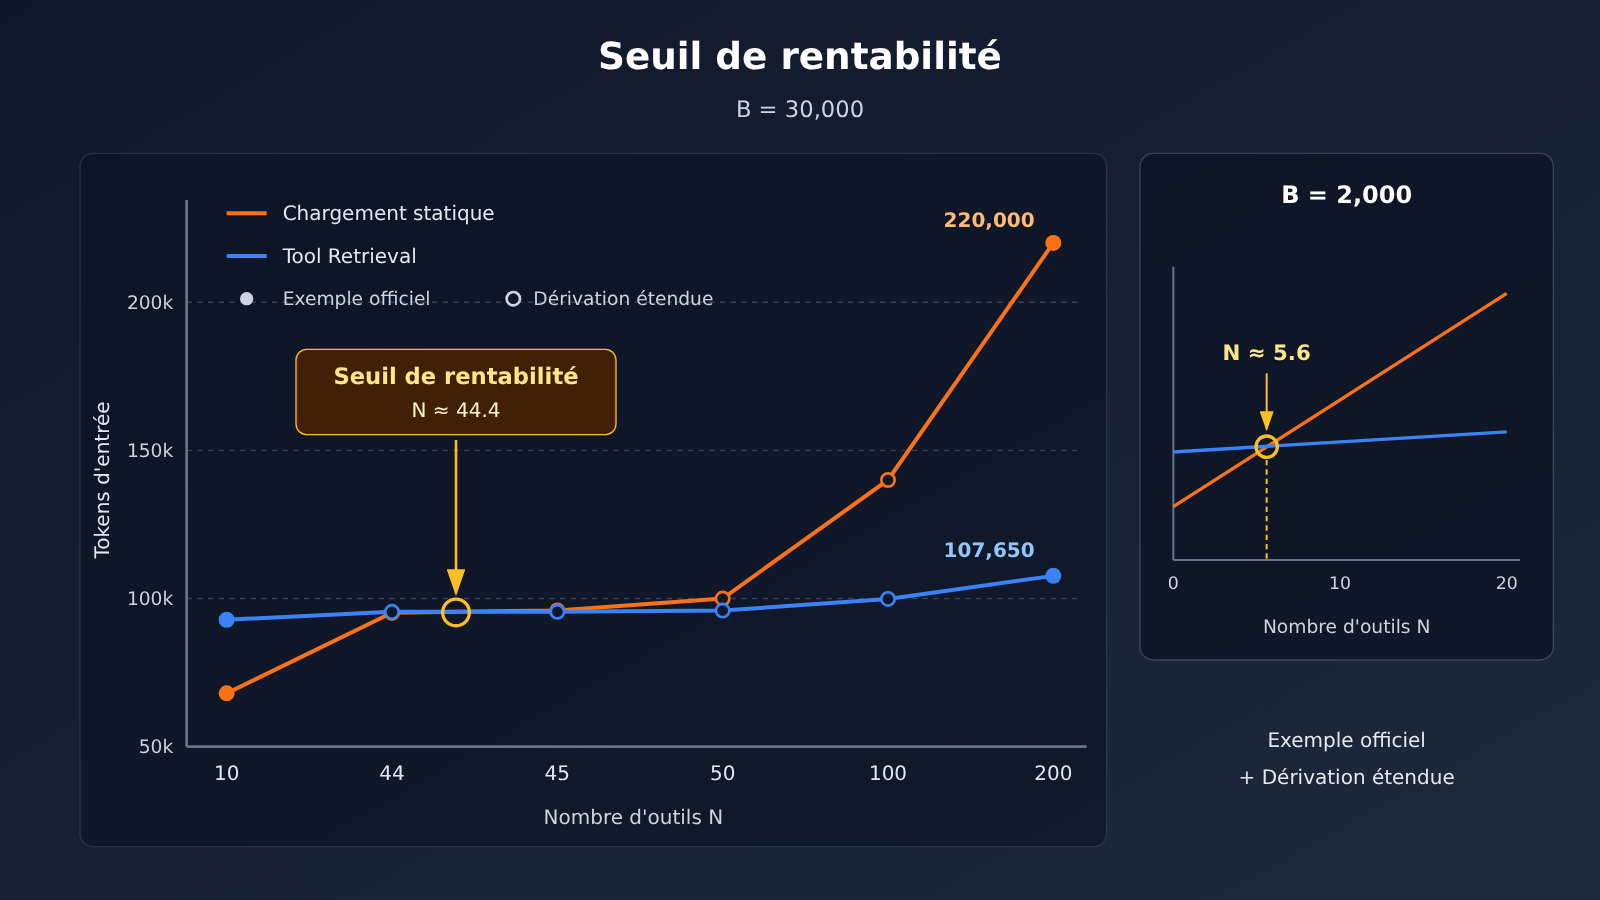
Légende : les deux premières lignes de données sont les exemples officiels de Google, le reste est déduit selon la même méthodologie. Dans une vraie tâche, le nombre de recherches et le volume chargé modifient la courbe ; il est conseillé de refaire le test avec vos propres requêtes métier. Via l’interface unifiée APIYI apiyi.com, vous pouvez rapidement déployer les bases de chargement statique de plusieurs modèles pour comparer.
Les tâches réelles correspondent rarement à ces hypothèses de façon stricte ; les variables suivantes déplacent le point d’équilibre :
- Nombre de recherches : chaque recherche supplémentaire côté serveur ajoute une entrée de modèle d’une taille proche de « B + liste d’outils + schémas déjà chargés » ; dans les scénarios à contexte long, cela revient à repayer B à chaque fois.
- Quantité réellement chargée K : plus on charge d’outils, moins on économise ; les schémas déjà chargés ne peuvent pas être déchargés et s’accumulent au fil d’une longue session.
- Taille d’un schéma individuel S : pour les outils aux paramètres complexes et aux descriptions verbeuses, le chargement à la demande rapporte davantage ; quand le schéma est très court, le gain est absorbé par les entrées de la liste et les instructions de recherche.
- Nombre de tours de conversation : l’approche statique répète l’intégralité des schémas à chaque tour ; plus le nombre de tours est élevé et plus aucune nouvelle recherche n’est déclenchée, plus l’avantage du chargement à la demande devient net.
Moins de tokens d’entrée, facturation totale en baisse, réponses plus rapides : les trois « économies » de Gemini Tool Retrieval
Ces trois choses sont souvent confondues, mais elles ne sont pas équivalentes. La réduction des tokens d’entrée est la plus intuitive, mais si l’on ne regarde que total_input_tokens, on oublie l’inférence après recherche comptabilisée dans total_tool_use_tokens, ce qui conduit à surestimer l’ampleur des économies.
La baisse de la facturation totale dépend aussi du cache et du prix unitaire. Le chargement à la demande raccourcit l’invite initiale ; si à l’origine c’était grâce à un grand nombre de schémas que l’on dépassait le seuil de 4 096 tokens du cache implicite, l’activer peut au contraire faire perdre le cache. Si la boucle courte d’appel de fonction et de retour de résultat n’ajoute pas 2 050 tokens de contenu, Gemini 4 ne bénéficie pas non plus du cache complet de la requête précédente. Autrement dit, il y a moins de tokens, mais la structure du prix unitaire peut se dégrader.
Les réponses plus rapides ne sont étayées aujourd’hui par aucune donnée officielle ni indépendante. La recherche côté serveur n’ajoute pas d’aller-retour client, mais la requête exécute bien une inférence de modèle supplémentaire en interne ; la recherche côté client ajoute un aller-retour API à chaque recherche. Savoir si la latence diminue ou augmente ne peut être tranché que par ses propres tests de bout en bout.
Comment calculer la facture réelle d’une tâche Gemini Tool Retrieval Agent
D’après la sémantique officielle des Usage, en supposant une facturation standard, des tokens mis en cache déjà comptés dans l’entrée et aucun autre outil facturé à l’appel, on peut estimer une requête unique de la façon suivante :
USD ≈ [ (I + U − C) × P_in + C × P_cache + (O + T) × P_out ] / 1,000,000
où I, U, C, O et T correspondent dans l’ordre aux cinq champs du tableau ci-dessus. Or une tâche d’agent passe souvent par plusieurs requêtes : il faut donc additionner les Usage de chaque requête avant de faire le calcul, puis diviser le « coût total ÷ nombre de tâches réussies » pour obtenir le coût d’une tâche menée à bien.
Avant d’activer Tool Retrieval, le plus prudent est de mesurer d’abord une base de chargement statique. Voici un Function Calling statique lancé via l’interface compatible OpenAI, avec relevé de l’Usage de référence :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI, pour établir la référence de chargement statique
)

resp = client.chat.completions.create(
    model="gemini-3.8-flash",  # Nom du modèle : se référer à la liste des modèles de la plateforme
    messages=[{"role": "user", "content": "Refund 40 USD for order A-1042."}],
    tools=[{"type": "function", "function": {"name": "issue_refund",
            "parameters": {"type": "object", "properties": {
                "order_id": {"type": "string"}, "amount": {"type": "number"}},
                "required": ["order_id", "amount"]}}}]
)
print(resp.usage)  # Relevé des tokens d'entrée et de sortie lors du chargement statique complet
Petite précision : Tool Retrieval s’appuie lui-même sur la version v1beta de l’API Google Interactions. L’exemple ci-dessus ne sert qu’à récupérer des données de comparaison en chargement statique ; pour le volet chargement à la demande, utilisez un mode d’appel compatible avec l’API Interactions, puis placez les Usage des deux côtés dans la même formule de coût pour comparer.
Voir le code complet : calcul du seuil de rentabilité + estimation de la facture Usage
import openai

# ---------- 1. Estimation théorique selon le barème officiel (exemple étendu, seuils non officiels) ----------
def static_tokens(B: int, N: int, S: int = 400) -> int:
    return 2 * (B + N * S)

def retrieval_tokens(B: int, N: int, D: int = 26, H: int = 150,
                     K: int = 2, S: int = 400) -> int:
    return 3 * (B + N * D + H) + 2 * K * S

def breakeven_tools(B: int) -> float:
    return (B + 2050) / 722  # Valable uniquement avec S=400, D=26, H=150, K=2

for B, N in [(2000, 200), (30000, 10), (30000, 45), (30000, 100)]:
    s, r = static_tokens(B, N), retrieval_tokens(B, N)
    print(f"B={B:>6} N={N:>3} static={s:>7} retrieval={r:>7} "
          f"change={(r - s) / s:+.1%}")
print("B=30000 nombre critique d'outils :", round(breakeven_tools(30000), 2))

# ---------- 2. Estimation du coût d'une requête (en USD) à partir des champs Usage ----------
def request_cost(I, U, C, O, T, p_in, p_cache, p_out) -> float:
    """I/U/C/O/T correspondent à total_input / tool_use / cached / output / thought tokens"""
    return ((I + U - C) * p_in + C * p_cache + (O + T) * p_out) / 1_000_000

# Exemple : tarif standard Gemini 4 Hydrogen 1,50 / 0,075 / 7,50 (par million de tokens)
print(request_cost(I=7350, U=8150, C=0, O=200, T=0,
                   p_in=1.50, p_cache=0.075, p_out=7.50))

# ---------- 3. Baseline à chargement statique (interface compatible OpenAI) ----------
client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_static_baseline(prompt: str, tools: list, model: str = "gemini-3.8-flash"):
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools
    )
    return resp.usage  # Pour agréger une tâche multi-tours, cumuler requête par requête
🚀 Démarrage rapide : le mieux est de commencer par faire tourner la baseline à chargement statique sur APIYI apiyi.com avec une seule clé API, de noter les tokens consommés et le taux de réussite sur votre vrai jeu de tâches métier, puis de décider seulement ensuite si vous migrez l’Agent vers le chargement à la demande — plutôt que de refondre l’architecture sur la base des chiffres indicatifs officiels.
Décision d’activation de Gemini Tool Retrieval : votre bibliothèque d’outils est-elle prête ?
En combinant les recommandations d’ingénierie officielles et le raisonnement ci-dessus, on peut faire un premier tri à l’aide du tableau suivant. Au final, ce sont surtout le coût par tâche réussie et le taux de réussite sur des tâches réelles qui doivent guider la décision :
| Caractéristiques de la charge de travail | Stratégie recommandée | Raison |
|---|---|---|
| Moins d’environ 20 outils stables, dont la plupart servent à chaque tour | Continuer le chargement statique | Recommandation officielle ; peu de schémas à économiser, et la recherche représente une part élevée des coûts |
| Peu d’outils, mais un contexte de base très long | Chargement statique, ou différer uniquement quelques outils à gros schéma | Chaque recherche retraite le long contexte ; l’exemple de calcul avec 10 outils en est justement un contre-exemple |
| Des dizaines à des centaines d’outils, dont seuls quelques-uns servent à la fois | Évaluer en priorité la recherche côté serveur | Les grandes bibliothèques à longue traîne correspondent au scénario officiel des 200 outils |
| Mélange d’outils très fréquents et d’un grand nombre d’outils spécialisés peu fréquents | Charger directement les outils fréquents, defer_loading pour les outils peu fréquents |
Usage hybride recommandé par la documentation officielle, pour éviter de lancer une recherche même sur des tâches simples |
| Multi-tenant, outils dynamiques, filtrage selon les droits des utilisateurs | Évaluer la recherche côté client | On peut brancher son propre registre, mais chaque recherche ajoute un aller-retour |
| Outils souvent nommés dans les instructions système | Garder le chargement direct | La documentation officielle signale que les outils différés nommés explicitement peuvent être appelés directement en contournant la recherche, ce qui peut provoquer des erreurs |
💡 Conseil de choix : faites tourner la même série de tâches avec les deux approches, statique et à la demande, en gardant identiques le modèle, la bibliothèque d’outils, la longueur du contexte et les conditions de cache. Avec APIYI apiyi.com, vous pouvez passer d’un modèle Gemini à un autre, et à d’autres modèles populaires, derrière une interface unifiée pour établir une base de comparaison. Cela aide à attribuer l’écart de coût à la stratégie de chargement des outils elle-même.
Quelques détails d’ingénierie ont aussi un impact direct sur la facture : avec store=false, si vous gérez l’historique vous-même, vous devez conserver tels quels tool_search_call, tool_search_result et leur signature ; sinon, les requêtes suivantes risquent de renvoyer une erreur HTTP 400. Il ne faut pas non plus omettre les parameters des outils différés pour alléger le corps de la requête. Et lors du débogage, vérifiez les function_call dans interaction.steps, pas seulement interaction.status. Si ces problèmes déclenchent une nouvelle tentative, les tokens de la requête répétée sont eux aussi facturés.
Au fond, Tool Retrieval est un outil d’optimisation des coûts qui repose sur un constat : quelques outils sont utilisés souvent, la plupart restent inactifs longtemps. Les deux exemples officiels, aux conclusions opposées, ont déjà bien tracé les limites : plus la bibliothèque d’outils est grande, plus le contexte est court et moins il y a de recherches, plus les économies sont probables ; dans le cas inverse, on peut payer davantage. Ce qu’il faut vraiment optimiser, ce n’est pas le nombre de tokens de la première requête, mais le total par tâche réussie.
Comme l’écrivait Chen Danran, lettré de la dynastie Qing, dans Wuyan · Qian Du Jian Fan Yi : « Qui ne voit pas l’ensemble ne peut pas gouverner une seule partie. »
Références
- Annonce officielle de Google : Introducing Tool Retrieval in the Gemini API (19/11/2026)
- Lien :
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- Lien :
- Documentation technique de Google Tool Retrieval : configuration, facturation, exemples officiels et limites
- Lien :
aistudio.google.com/docs/tool-retrieval
- Lien :
- Documentation Google Context caching : seuils de cache implicite et règles de cache multi-tours de Gemini 4
- Lien :
aistudio.google.com/docs/caching
- Lien :
- Tarification de l’API Gemini Developer de Google : tarifs d’entrée, de sortie et de cache des modèles
- Lien :
aistudio.google.com/docs/pricing
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : pour comparer les coûts en Tokens de Gemini et d’autres modèles dans des scénarios Agent, n’hésitez pas à visiter APIYI (apiyi.com) pour obtenir des crédits de test ; pour plus de détails sur l’intégration, consultez le centre de documentation docs.apiyi.com


