
Résumé : cet article explique comment déterminer le quota d’essai gratuit d’un produit d’IA, et propose une méthode pour estimer le budget à partir du coût réel des invocations, puis l’ajuster grâce à une rétrospective basée sur les données.
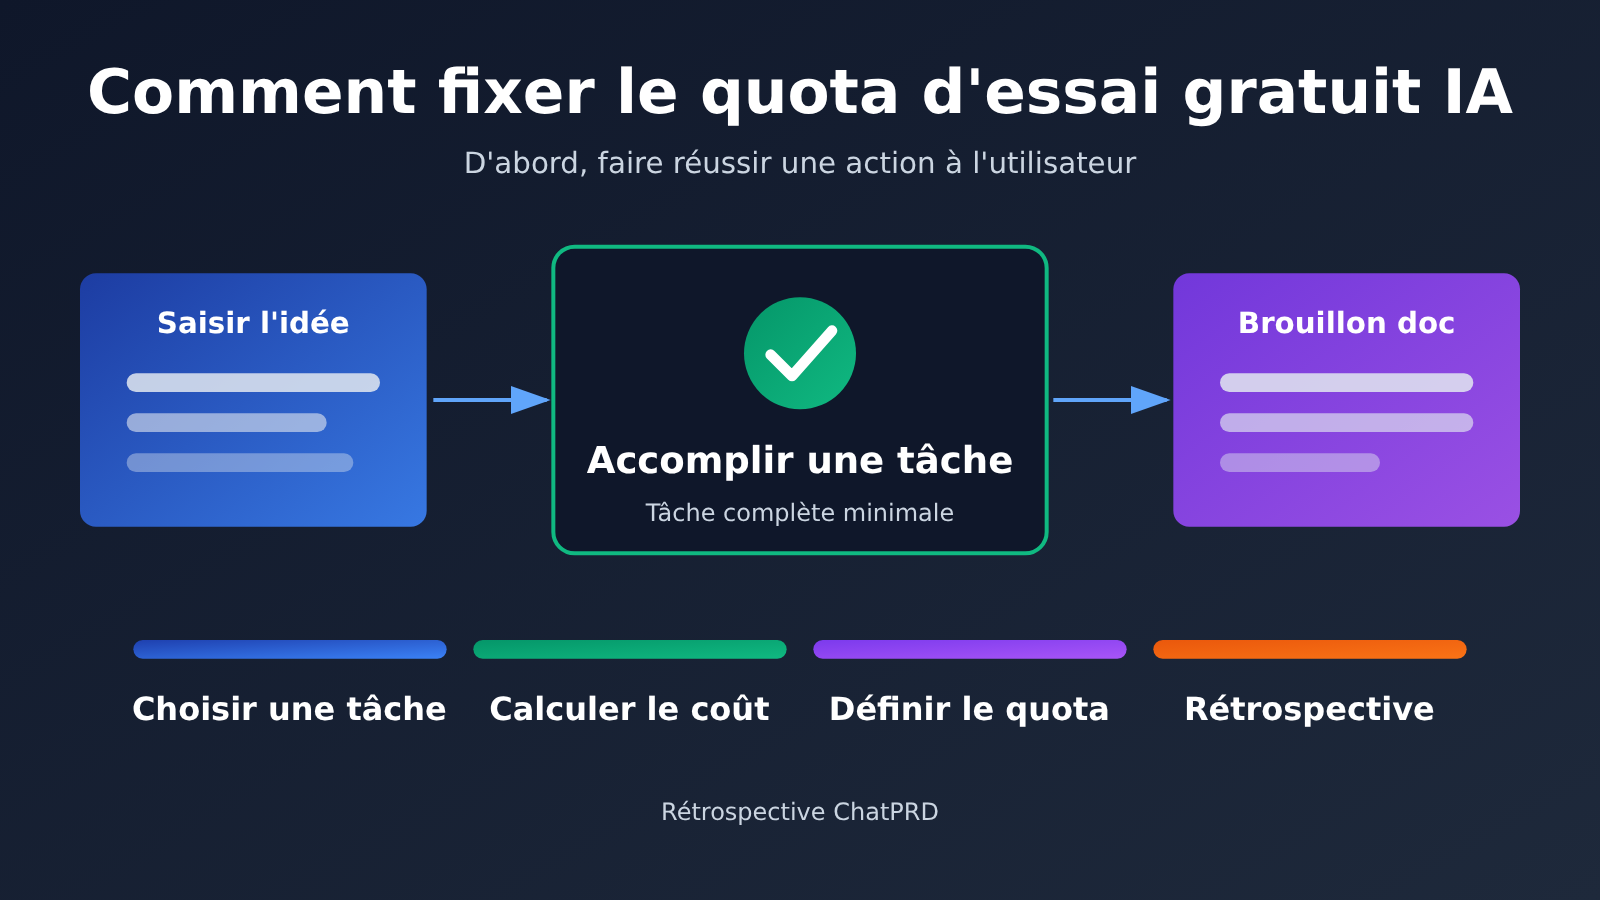
Commençons par la conclusion : le quota d’essai gratuit d’un produit d’IA doit être défini autour d’une seule tâche
Le quota d’essai gratuit d’un produit d’IA ne doit pas être défini à partir du nombre de tokens ou de « combien de crédits offrir ». Il faut d’abord déterminer la tâche unique que l’utilisateur doit accomplir pendant la période d’essai. L’équipe produit doit d’abord identifier la plus petite tâche complète qui apporte une valeur immédiatement perceptible à l’utilisateur, puis mesurer sur des échantillons réels le coût d’invocation nécessaire pour la mener à bien, et enfin multiplier ce coût par un nombre raisonnable de tâches d’essai pour obtenir le quota par compte et le budget total.
Cette réponse dépend de trois conditions. La première est de savoir si la tâche peut réellement être menée à bien dans le cadre de l’essai : une tâche impossible à terminer aura beau recevoir n’importe quel quota, la conversion restera difficile. La deuxième concerne l’origine du coût : vient-il d’échantillons réels, en tenant compte des entrées, des sorties, des nouvelles tentatives et, le cas échéant, des coûts de cache ou d’outils ? La troisième est de savoir si, une fois le quota épuisé, l’utilisateur comprend clairement ce qu’il a obtenu et ce qu’il peut faire ensuite.
La rétrospective de ChatPRD offre un point de comparaison concret : un quota d’essai mal calibré entraîne des pertes de coûts, tandis que couper l’essai de manière uniforme nuit tout autant à l’acquisition de clients. Il faut donc concevoir l’essai comme un dispositif calculable et révisable, plutôt que de choisir entre « tout ouvert » et « tout fermé ».
Carte des connaissances et index pour la conception des crédits d’essai gratuit
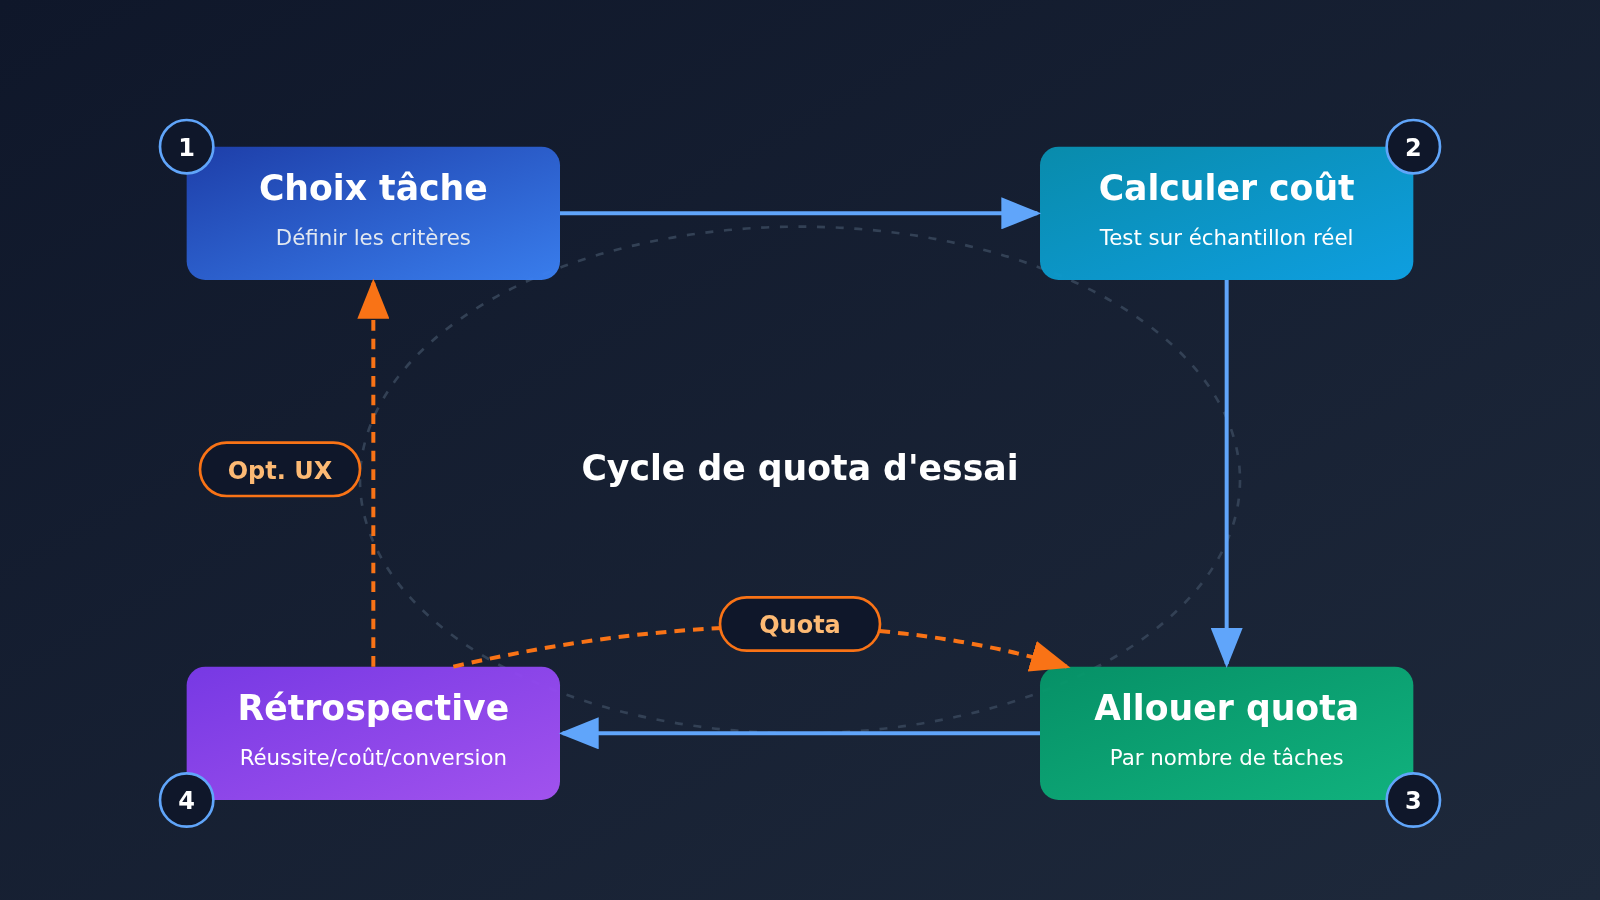
Le tableau ci-dessous sert à la fois de carte des connaissances et d’index de lecture. Les quatre étapes s’enchaînent dans l’ordre d’exécution : la sortie de l’étape précédente devient l’entrée de la suivante.
| Étape | Section correspondante | Pourquoi la faire | Ce qu’il faut | Ce qu’on obtient |
|---|---|---|---|---|
| Choisir la tâche | 2, 2.1, 2.2 | Les crédits n’ont de sens que s’ils servent à accomplir quelque chose d’utile | La valeur centrale du produit, le premier besoin d’un utilisateur typique | Une tâche minimale avec des critères d’achèvement clairs, ainsi que les limites fonctionnelles disponibles pendant l’essai |
| Calculer le coût | 3, 3.1, 3.2 | Sans coût unitaire, les crédits et le budget se fixent au doigt mouillé | Des échantillons réels d’appels, le prix unitaire du modèle, les coûts de relance et les frais annexes | Le coût par tâche réussie, le coût par compte, la limite budgétaire totale |
| Configurer les crédits | 3.3, 4 | L’utilisateur doit comprendre combien de tâches les crédits permettent, pas combien de tokens | Le coût par compte, le nombre de tâches, le message affiché quand les crédits sont épuisés | Des crédits exprimés en « nombre de tâches », et une indication claire de l’épuisement |
| Rétrospective | 4.1 | L’efficacité des crédits doit être vérifiée par les données pour décider s’il faut modifier l’expérience ou les crédits | Le taux de réussite, le coût par réussite, les données de conversion payante | La direction des ajustements du prochain cycle |
L’ordre de lecture recommandé va de la section 1 à la section 4. La section 1 présente le contexte du problème et vous aide à éviter une mauvaise interprétation du cas ChatPRD. La section 2 présente la tâche de démonstration, et tous les calculs de la section 3 reposent sur cette tâche. Les indicateurs de rétrospective de la section 4 vont à leur tour corriger les paramètres des sections 2 et 3, formant ainsi une boucle. Si vous avez déjà une tâche centrale bien définie, vous pouvez commencer directement à la section 3.
À savoir : comprendre les termes indispensables pour estimer un quota d’essai gratuit
| Terme | Explication concise |
|---|---|
| Token | Unité qui mesure la longueur du texte d’entrée et de sortie d’un grand modèle de langage ; la plupart des API facturent séparément les tokens d’entrée et de sortie |
| Tâche minimale complète | Une action que l’utilisateur peut réaliser seul pendant l’essai et qui lui fait directement percevoir la valeur du produit ; c’est l’unité de base pour concevoir un quota |
| Nouvelle tentative | Quand l’utilisateur régénère un résultat qui ne lui convient pas, ou rappelle l’API après un échec, cela génère un coût supplémentaire |
| Coût d’une réalisation | Coût moyen des appels nécessaires pour accomplir une tâche minimale complète, en incluant les nouvelles tentatives et les frais annexes applicables |
| Taux de réussite de la première tâche valide | Proportion des utilisateurs en essai qui ont mené à bien au moins une fois une tâche centrale |
1. Retour d’expérience ChatPRD : ce qui s’est passé quand le quota d’essai gratuit a déraillé
1.1 Les faits clés du retour d’expérience
Claire Vo, fondatrice de ChatPRD, a publié le 2026-11-16 un retour d’expérience sur la fraude aux tokens qui rogne les marges des produits IA. Elle raconte que, pendant près d’un an, elle y a laissé plusieurs dizaines de milliers de dollars, et qu’elle a même un temps désactivé l’essai gratuit — avec pour conséquence de nuire à l’acquisition de clients et à la génération de prospects commerciaux.
Le retour d’expérience contient aussi un chiffre facile à mal interpréter : près de 200 000 dollars. Il s’agit du montant des tentatives de paiement échouées, pas de la perte réellement subie. Quand on rapporte ce cas, il faut bien distinguer « les dizaines de milliers de dollars déjà dépensés » et « les près de 200 000 dollars de tentatives de paiement échouées », sinon on exagère fortement l’ampleur du problème.
1.2 Ne pas conclure de ce cas qu’il faut supprimer l’essai
La page tarifaire publique actuelle de ChatPRD affiche toujours un plan gratuit, et les offres Pro et Teams prévoient elles aussi un essai de 14 jours. On ne peut donc pas lire ce retour d’expérience comme si ChatPRD avait supprimé tous ses essais gratuits, et encore moins extrapoler l’expérience d’un seul produit à l’ensemble du secteur.
Ce que ce cas a vraiment à nous apprendre, ce sont deux leçons qui vont dans des directions opposées. Un quota d’essai abusé grignote directement la marge, mais couper l’essai fait fuir de vrais utilisateurs potentiels et des clients entreprise. Ce dont les équipes produit ont besoin, c’est d’une méthode pour concevoir un quota qui permette aux utilisateurs réels de ressentir la valeur tout en calculant clairement le coût de la subvention ; les sections suivantes tournent autour de cet objectif.
2. Concevoir le quota d’essai gratuit à partir de « générer un brouillon de PRD éditable »
Pour que les calculs qui suivent portent sur un objet concret, on prend ici une tâche de démonstration : l’utilisateur saisit une idée de produit et obtient au final un brouillon de PRD qu’il peut continuer à éditer. Ce choix s’impose parce que cette tâche est au plus près du travail réel d’un chef de produit : dès qu’il reçoit le résultat, il peut juger immédiatement si « ce truc lui est utile ou non ».
Précision : il ne s’agit que d’une tâche d’exemple, destinée à illustrer la méthode ; elle ne représente pas le design réel de l’essai de ChatPRD. Votre produit peut la remplacer par « générer une analyse concurrentielle », « réécrire un texte marketing » ou « effectuer une revue de code » ; la méthode reste la même.
2.1 Définir les critères d’achèvement d’une tâche d’essai gratuit
Les critères d’achèvement doivent être vérifiables, et de préférence pouvoir être déterminés par de l’instrumentation dans les données produit. Pour « générer un brouillon de PRD éditable », on peut les définir ainsi :
- L’utilisateur a soumis une idée de produit et répondu aux questions de clarification nécessaires.
- Le système a généré un brouillon structuré et complet, contenant au minimum les sections contexte, utilisateurs cibles, besoins principaux et critères d’acceptation.
- L’utilisateur a édité le brouillon au moins une fois ou demandé une modification, ce qui montre que le contenu est entré dans son flux de travail réel.
- L’utilisateur a exporté, copié ou enregistré ce brouillon.
Les points 3 et 4 sont essentiels pour distinguer « avoir jeté un œil » et « avoir vraiment utilisé ». Générer sans éditer ni enregistrer indique souvent que le résultat n’a pas convaincu l’utilisateur ; compter ce type d’essai comme une tâche terminée fausserait les données de rétrospective par la suite.
2.2 Choisir les fonctionnalités et les limites disponibles pour l’essai gratuit
Les limites fonctionnelles déterminent quelles capacités doivent être appelées pour accomplir la tâche et, par conséquent, la structure de coûts. Les fonctionnalités ouvertes pendant l’essai doivent couvrir juste ce qu’il faut pour satisfaire aux critères d’achèvement, sans ouvrir d’un coup toutes les capacités avancées.
- À ouvrir : le dialogue de clarification, la génération du brouillon, la modification à partir du dialogue, l’export ou la copie. Ce sont des étapes obligatoires pour accomplir la tâche ; s’il en manque une, l’utilisateur ne peut pas aller au bout.
- À limiter : le téléversement de documents longs, la recherche sur Internet, la comparaison de plusieurs documents et autres capacités coûteuses ou non indispensables. Elles peuvent être réservées à l’offre payante comme argument pour passer à l’offre supérieure.
- À plafonner : la longueur d’une saisie unique, le nombre de tours de modification d’un brouillon. Le rôle de ces plafonds est de rendre les coûts prévisibles, pas de mettre des bâtons dans les roues à l’utilisateur.
Une fois les limites définies, on peut lister le parcours d’appel typique pour accomplir une tâche ; le calcul des coûts de la section 3 s’accumule progressivement le long de ce parcours.
3. Estimer le budget de subvention du quota d’essai gratuit à partir de l’usage réel
La formule centrale de cette section est simple : le budget d’essai correspond au coût d’invocation nécessaire pour accomplir la tâche cible, multiplié par un nombre raisonnable de tâches d’essai. Ce coût d’invocation doit être calculé à partir d’échantillons réels, en tenant compte des tokens d’entrée, des tokens de sortie, des éventuels frais de cache ou d’outils, ainsi que des nouvelles tentatives. Le plafond budgétaire global et le message affiché lorsque le quota est épuisé sont, eux, définis séparément par l’équipe produit.
3.1 Calculer le coût d’une exécution complète à partir d’échantillons réels
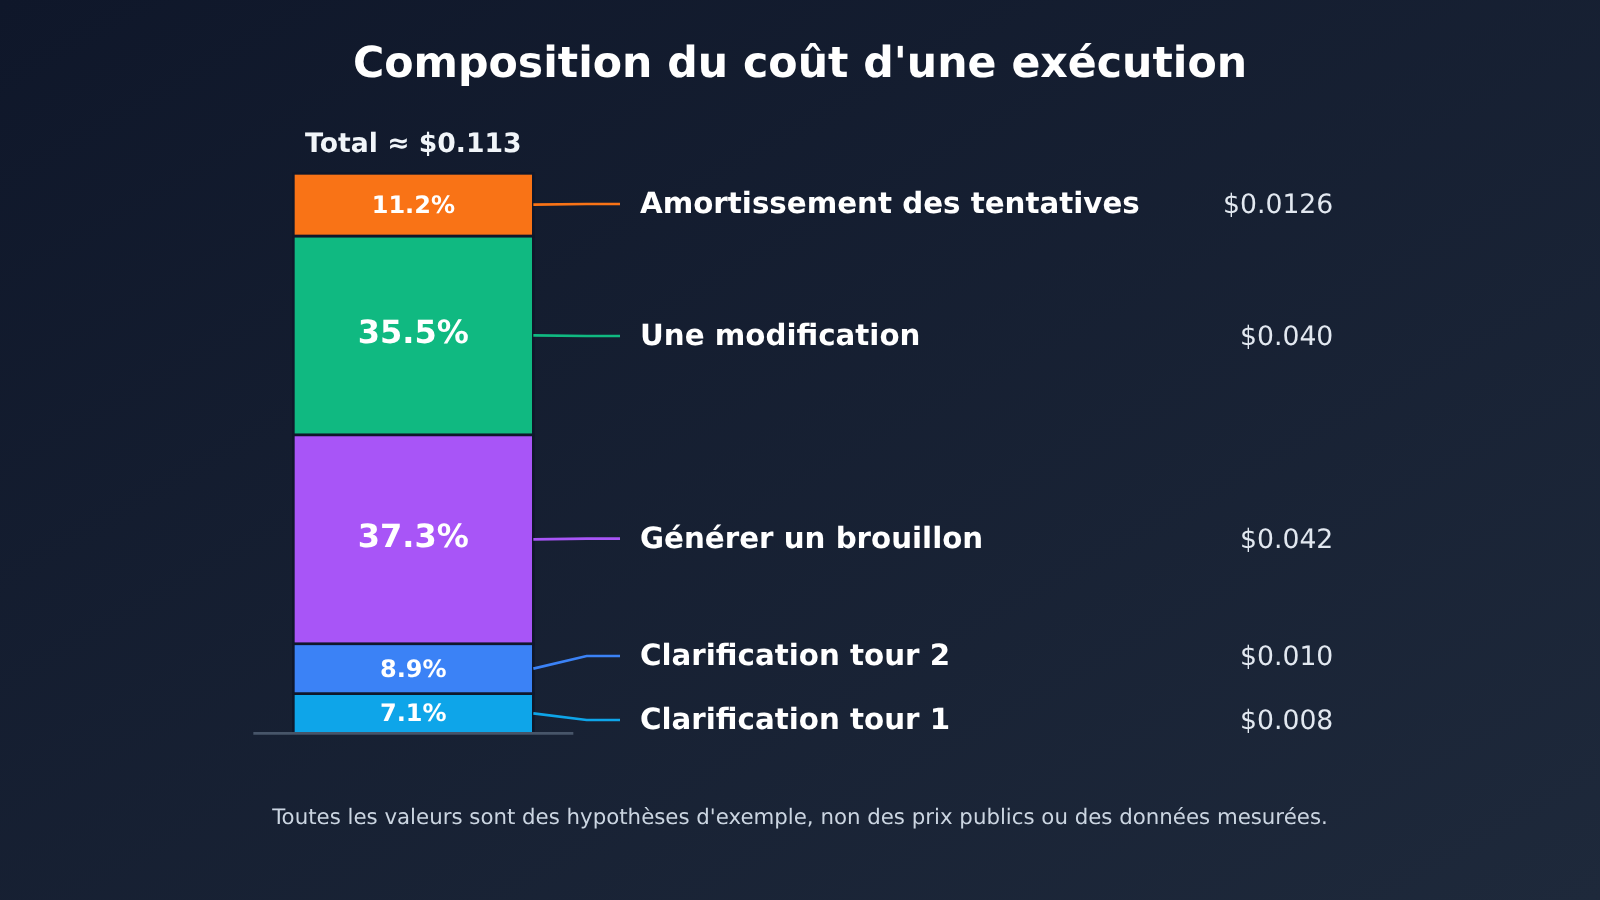
Commençons par préciser le cadre de calcul : les nombres de tokens, les taux de nouvelle tentative et les prix unitaires du tableau ci-dessous sont tous des hypothèses fournies pour la démonstration. Ce ne sont ni des prix publics d’un modèle précis, ni des données mesurées. En pratique, il faut remplacer ces chiffres par les journaux d’appels réels issus de tests internes ou d’utilisateurs en déploiement progressif.
Si vos invocations de modèle passent par une plateforme d’agrégation, vous pouvez vous appuyer sur sa page publique de tarifs des modèles et sur sa fonction de consultation des journaux d’appels, par exemple la documentation des prix des modèles et celle sur la consultation des journaux d’APIYI. À noter : ce type de plateforme ne fournit que des données de coût ; la politique d’essai elle-même reste à concevoir par l’application.
Hypothèses de l’exemple : prix unitaire des entrées fixé à 2 USD par million de tokens, prix unitaire des sorties fixé à 8 USD par million de tokens, aucun outil comme la recherche web utilisé, remise de cache fixée à 0.
| Étape | Tokens d’entrée (hypothèse) | Tokens de sortie (hypothèse) | Coût par appel (USD) |
|---|---|---|---|
| Premier tour du dialogue de clarification | 2,000 | 500 | 0.008 |
| Deuxième tour du dialogue de clarification | 3,000 | 500 | 0.010 |
| Génération d’un brouillon | 5,000 | 4,000 | 0.042 |
| Une modification | 10,000 | 2,500 | 0.040 |
| Sous-total | 20,000 | 7,500 | 0.100 |
| Nouvelle tentative (hypothèse : 30 % des utilisateurs régénèrent une fois un brouillon) | — | — | 0.0126 |
| Coût d’une exécution complète | — | — | environ 0.113 |
Le calcul est direct : le coût de chaque étape est égal au nombre de tokens d’entrée multiplié par le prix unitaire des entrées, plus le nombre de tokens de sortie multiplié par le prix unitaire des sorties. L’entrée de l’étape de modification est nettement plus importante, car elle inclut l’historique de la conversation et l’intégralité du brouillon ; c’est un trait fréquent du coût des tâches multi-tours. La nouvelle tentative n’est prise en compte que pour l’étape de génération du brouillon, la plus fréquente, et elle est répartie à hauteur de 0.042 USD multiplié par 30 %.
3.2 Du coût d’une tâche complétée au budget par compte et au budget total
Une fois le coût d’une tâche complétée connu, il reste à décider combien de tâches chaque compte d’essai est autorisé à réaliser. Dans l’exemple, on fixe ce nombre à 3 : la première sert à découvrir le produit, les deux suivantes permettent à l’utilisateur de l’essayer sur ses propres projets réels. Ce nombre reste une hypothèse : il dépend du nombre d’essais dont vos utilisateurs ont généralement besoin pour se faire un avis.
| Élément budgétaire | Mode de calcul | Résultat d’exemple (hypothèse) |
|---|---|---|
| Coût d’une tâche complétée | Statistiques de l’échantillon de la section 3.1 | Environ 0,113 USD |
| Nombre de tâches d’essai par compte | Défini par l’équipe produit selon les habitudes de décision des utilisateurs | 3 |
| Plafond de coût par compte | Coût d’une tâche complétée × nombre de tâches | Environ 0,34 USD |
| Nouveaux comptes d’essai mensuels prévus | Issu du plan d’acquisition | 5 000 |
| Plafond budgétaire mensuel | Plafond de coût par compte × nombre de comptes | Environ 1 690 USD |
Le montant calculé ici représente le plafond dans le cas où tous les utilisateurs consomment la totalité de leur quota. Les dépenses réelles sont généralement inférieures, car beaucoup d’utilisateurs ne font qu’une ou deux tentatives avant de partir ou de passer directement à un abonnement payant. L’équipe produit peut fixer un budget global sur cette base : si les dépenses réelles dépassent nettement les prévisions, cela indique soit une utilisation anormale, soit un problème de périmètre dans l’échantillon. Il faut alors revenir à la section 3.1 pour vérifier les calculs.
3.3 Tableau budgétaire des quotas d’essai gratuit à compléter
Combinez les étapes ci-dessus dans un modèle vierge que votre équipe peut remplir directement avec ses propres données :
| Élément à remplir | Vos données | Source des données |
|---|---|---|
| Nom de la tâche complète minimale | Définition de la tâche à la section 2 | |
| Nombre moyen de tokens d’entrée par étape | Journaux d’appels réels | |
| Nombre moyen de tokens de sortie par étape | Journaux d’appels réels | |
| Prix unitaire des tokens d’entrée et de sortie | Page tarifaire publique du modèle utilisé | |
| Frais de cache ou d’outils applicables | Facture ou documentation tarifaire | |
| Taux de nouvelle tentative habituel et étapes concernées | Données de télémétrie | |
| Coût d’une exécution complète | Synthèse des éléments ci-dessus | |
| Nombre de tâches d’essai par compte | Décision produit | |
| Nombre de comptes d’essai prévus | Plan d’acquisition | |
| Plafond budgétaire total et traitement du dépassement | Décision commune produit et finance |
Une fois le tableau rempli, le quota présenté aux utilisateurs doit être exprimé en « nombre de tâches » plutôt qu’en tokens ou en crédits, par exemple « 3 brouillons de PRD générables pendant la période d’essai ». Les utilisateurs comprennent ainsi directement combien de choses le quota peut les aider à faire ; côté produit, on effectue ensuite le calcul interne en fonction du plafond de coût.
4. Un message clair lorsque le quota d’essai gratuit est épuisé
Le moment où le quota s’épuise est un point de bascule : c’est là que l’utilisateur décide s’il paie ou non. Si le message est flou, il croira que le produit est en panne ; s’il est trop abrupt, il aura l’impression que toute l’expérience précédente n’était qu’un appât. Un message correct doit contenir trois types d’informations :
- Ce que l’utilisateur a déjà obtenu : par exemple « Vous avez déjà rédigé 3 brouillons de PRD, tous enregistrés dans le projet », pour qu’il confirme que le fruit de son essai reste disponible.
- Ce qu’il ne peut plus faire maintenant : indiquer clairement quelle opération nécessite du quota, pour éviter de le bloquer en cours d’action.
- Les options qui s’offrent à lui : continuer avec les fonctions de base du plan gratuit, souscrire une offre payante, ou contacter l’équipe pour découvrir une solution entreprise.
Il y a un autre détail à anticiper dès la conception : évitez autant que possible d’épuiser le quota au milieu d’une tâche. On peut vérifier, avant de lancer une nouvelle tâche, si le quota restant suffit pour la terminer ; sinon, prévenir avant de commencer. L’utilisateur ressentira alors « j’ai déjà fait plusieurs choses » plutôt que « j’ai été interrompu en plein milieu ».
4.1 Retour d’expérience sur le quota d’essai gratuit : changer l’expérience ou changer le quota
Une fois l’essai en ligne, utilisez trois indicateurs pour déterminer d’où vient le problème :
- Taux de réussite de la première tâche à valeur ajoutée : part des utilisateurs en essai qui ont terminé complètement au moins une tâche selon le critère 2.1. Cela reflète si l’expérience d’essai est fluide.
- Coût par utilisateur ayant terminé : coût total de l’essai divisé par le nombre de personnes ayant terminé. Cela reflète combien de subvention a été dépensée pour chaque utilisateur ayant « ressenti la valeur ».
- Conversion en payant : proportion de ceux qui ont terminé et qui finissent par payer. Cela reflète si la valeur suffit à justifier une décision d’achat.
Ce n’est qu’en combinant les trois indicateurs qu’on peut décider quoi ajuster :
| Données observées | Causes possibles | Axe d’ajustement |
|---|---|---|
| Taux d’achèvement faible, coût par personne ayant terminé élevé | Les utilisateurs bloquent en cours de tâche, la subvention profite à ceux qui n’ont pas terminé | Jouer sur l’expérience : simplifier les étapes, améliorer l’accompagnement, vérifier si les limites fonctionnelles oublient une capacité indispensable |
| Taux d’achèvement faible, et beaucoup d’utilisateurs épuisent leur quota en cours de tâche | Le coût d’une tâche unique est sous-estimé, le quota ne suffit pas à terminer une chose | Ajuster le quota : recalculer le coût d’achèvement sur un nouvel échantillon, ou réduire le périmètre de la tâche |
| Taux d’achèvement élevé, conversion payante faible | La tâche peut être terminée, mais la valeur ne suffit pas à payer, ou le quota est trop généreux et l’utilisateur n’a pas besoin de passer à l’offre supérieure | Vérifier d’abord la valeur de la tâche, puis envisager de réduire le nombre de tâches |
| Taux d’achèvement élevé, conversion normale, coût par personne ayant terminé en hausse continue | Davantage de tentatives ou des entrées plus longues | Revenir à 3.1 pour examiner les causes des tentatives répétées et la longueur du contexte |
Pour l’ordre d’analyse, je recommande de regarder d’abord le taux d’achèvement, ensuite le coût, enfin la conversion. Quand le taux d’achèvement n’est pas au niveau, ajuster le quota n’a généralement pas de sens : l’utilisateur n’a même pas terminé une seule chose, donner plus de quota ne fait qu’amplifier le gaspillage. Une fois le taux d’achèvement stabilisé, on utilise le coût et la conversion pour affiner le nombre de tâches et le budget total, puis on revient à la section 2 vérifier si la définition de la tâche doit être mise à jour.
Une fois toute la méthode en place, vous devriez pouvoir répondre à une question concrète : pour chaque utilisateur en essai qui ressent vraiment la valeur, combien le produit dépense-t-il, et combien cette dépense génère-t-elle de conversions payantes ? Si vous savez calculer ce compte, le quota d’essai gratuit passe d’une dépense difficile à maîtriser à un levier d’acquisition que l’on peut optimiser en continu.
Un voyage de mille lieues commence toujours par un premier pas. — Lao Tseu
Références
-
Article bilan de Claire Vo, fondatrice de ChatPRD : sur la fraude aux tokens qui rogne les profits de l’IA et les moyens de la contrer
- Lien :
chatprd.ai/how-i-ai/token-fraud-is-eating-ai-margins-here-s-how-claire-vo-is-fighting-it - Note : source des faits du cas présenté à la section 1 de cet article
- Lien :
-
Page de tarification de ChatPRD : informations actuelles sur le plan gratuit et sur l’essai de 14 jours des offres Pro et Teams
- Lien :
chatprd.ai/pricing - Note : sert à confirmer la politique d’essai actuelle du produit
- Lien :
-
Documentation tarifaire des modèles APIYI : tarifs publics de chaque modèle
- Lien :
docs.apiyi.com/models - Note : permet de consulter le prix unitaire et de remplir le tableau budgétaire de la section 3.3
- Lien :
-
Documentation sur la consultation des journaux d’appels APIYI : accès aux enregistrements d’appels et à la consommation
- Lien :
docs.apiyi.com/api-capabilities/log-query - Note : permet de comptabiliser les tokens d’entrée et de sortie, ainsi que les relances, sur des échantillons réels
- Lien :


