
Note de l’auteur : cet article s’appuie sur le billet de recherche officiel où Claude Fable 5.2, en configuration multi-agents, a résolu deux problèmes de physique des trous noirs. Il en tire des pratiques concrètes pour les tâches Agent lourdes : choix du modèle, répartition des rôles et définition des lignes d’arrêt.
Le 17 novembre 2026, Anthropic a publié un article de recherche : plusieurs copies de Claude Fable 5.2 ont tourné en arrière-plan pendant environ six semaines et ont bouclé deux problèmes de physique des trous noirs. Pour les développeurs qui font tourner des tâches longues et multi-agents, ce qui mérite l’attention ici n’est pas la physique elle-même, mais la façon de travailler qu’elle illustre : longue durée, parallélisme multi-voies et vérification croisée.
Ce n’est pas un article de vulgarisation physique, et il ne vous dira pas quel fournisseur d’API est le plus stable. L’article ne fait qu’une chose : traduire les signaux d’ingénierie exploitables du billet de recherche en étapes que vous pouvez suivre pour vos propres tâches Agent lourdes.
L’essentiel : à la fin de cet article, vous saurez comment séparer le raisonnement principal et la vérification en rôles distincts, écrire une ligne d’arrêt claire pour chaque voie d’agent, et ne choisir qu’entre des modèles dont la grille tarifaire affiche un prix explicite — de quoi rendre le coût d’une tâche longue prévisible et plafonnable.
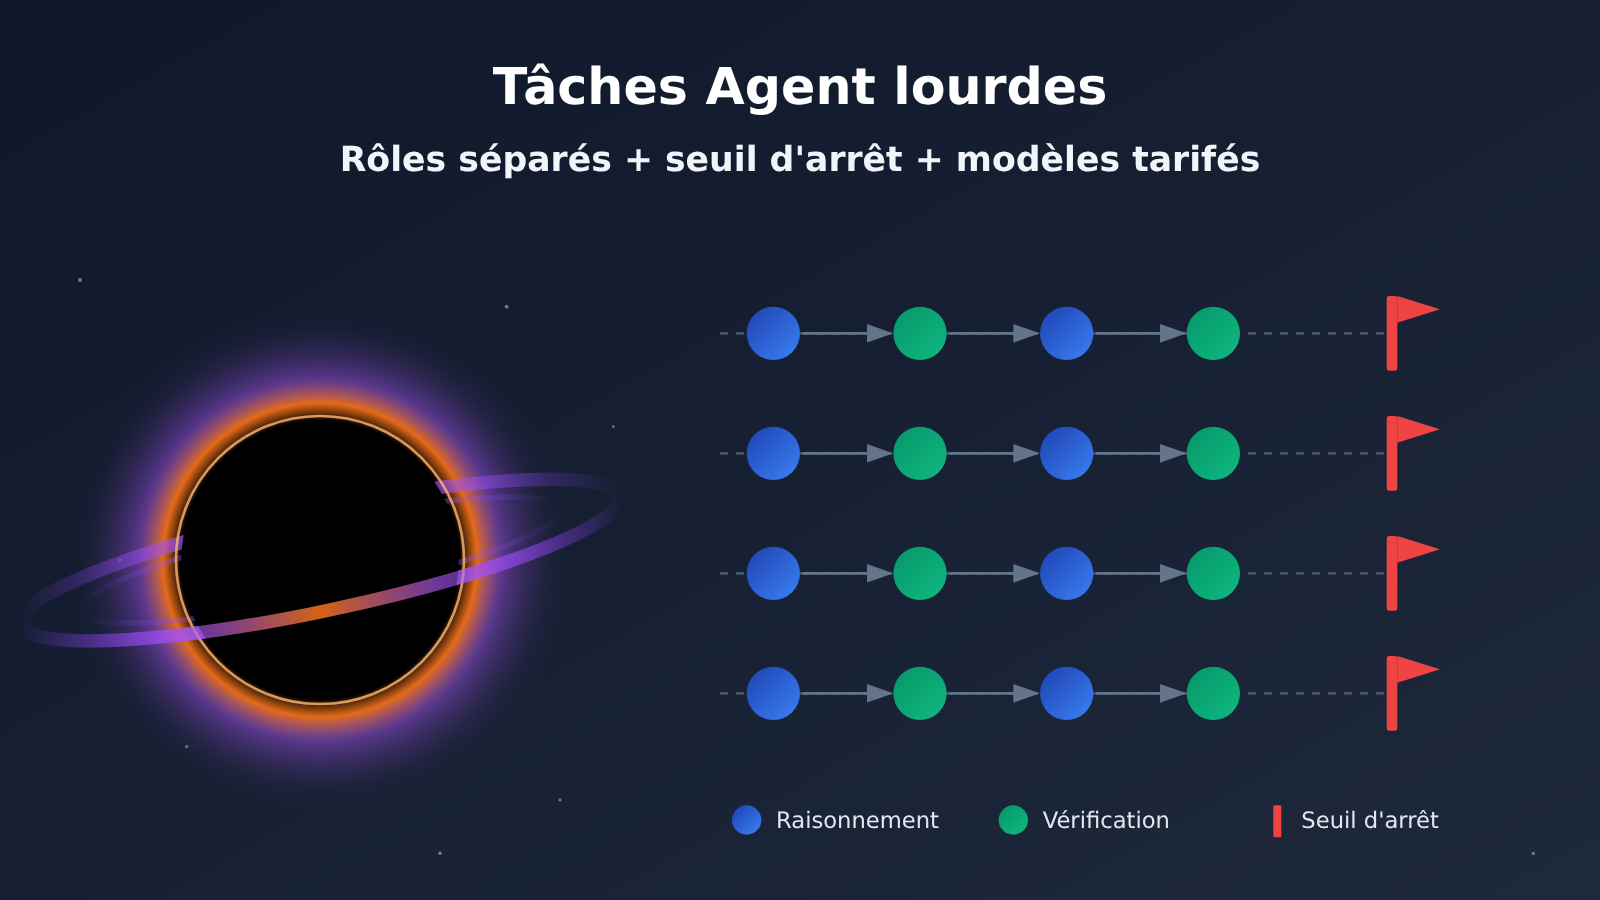
Ce que le post de recherche sur Claude Fable 5.2 nous dit des tâches d’agents intensives
Commençons par poser le contexte en un ou deux paragraphes. Le post de recherche est une présentation officielle d’Anthropic ; les deux articles concernés sont pour l’instant des prépublications, pas des travaux déjà passés par une relecture par les pairs. Les deux problèmes relèvent de la physique théorique, ne décrivent pas l’univers dans lequel nous vivons et n’ont pas d’usage pratique — l’intérêt porte donc avant tout sur la « méthode », pas sur « à quel point les conclusions sont importantes ».
D’après le post, en août 2026, le chercheur Hongbin Chen a demandé à Claude de lister des questions ouvertes sur les trous noirs et le bootstrap ; quelques heures plus tard, il en obtenait 22. Il a attribué un agent séparé à chaque question, les agents pouvaient lire la progression des autres, et le tout a tourné en arrière-plan pendant environ six semaines. Le post dit textuellement « sans configuration particulière », mais c’est la description officielle de la façon dont l’ensemble a été monté : cela ne veut pas dire que ça ne coûte rien, et le post ne fournit pas non plus de facture.
| Fait tiré du post de recherche | Ce que cela suggère pour les tâches d’agents intensives | Ce que vous pouvez faire |
|---|---|---|
| Un agent par question, les agents peuvent lire la progression des autres | La granularité du découpage des tâches doit être claire, l’état partagé doit être lisible | Un agent indépendant par sous-tâche, la progression écrite dans un stockage partagé |
| Presque chaque étape est faite indépendamment par deux agents, puis confrontée à la littérature | Les étapes critiques demandent une revérification indépendante | Séparer le raisonnement principal et la vérification en deux rôles |
| Les premiers agents ont essayé 61 fois en parallèle sans y arriver | L’échec est la norme, mais il doit avoir une limite | Indiquer pour chaque voie le nombre maximal d’échecs et le budget |
| Les résultats sont vérifiés formellement avec Lean, puis examinés par des physiciens | Un résultat machine doit finir par être validé de l’extérieur | Prévoir une étape de validation humaine ou outillée |
| Exécution en arrière-plan pendant environ six semaines | Le coût des tâches longues s’accumule | Estimer d’après les tarifs du tableau des modèles et fixer un plafond de dépense |
Ce que révèlent les deux problèmes des tâches Agent lourdes
Le premier problème est le calcul de la transition de phase de Hawking-Page, posé dès 2003 et jamais mené à terme. Le billet explique que presque chaque étape a été refaite deux fois, indépendamment, par deux agents, puis comparée à la littérature ; la conclusion est que la transition reste brusque en couplage faible. Un autre physicien a obtenu indépendamment le même résultat par une méthode différente, ce qui constitue une contre-validation croisée. Pour la pratique de l’ingénierie, ce problème illustre l’approche de vérification « répétition indépendante + comparaison externe ».
Le deuxième problème concerne la borne supérieure de la version la plus simple du bootstrap modulaire. Un lot plus ancien d’agents Claude a tenté le coup 61 fois en parallèle sans aboutir ; des agents venus ensuite ont repéré une régularité dans les résultats numériques, emprunté la méthode d’un autre problème — celui de l’empilement de sphères — et démontré que la borne supérieure de la masse du trou noir le plus léger vaut environ c/9.1266, en établissant au passage que cette méthode ne permet pas de descendre plus bas. En septembre 2026, ce résultat a été vérifié formellement avec Lean ; l’article a été rédigé par Claude et des physiciens ont contrôlé les principaux résultats. Ce que ce problème apprend à l’ingénierie : un grand nombre de tentatives ratées fait partie du processus, donc chaque voie doit avoir son budget et ses conditions d’arrêt.
Une précision importante : l’approche décrite dans le billet consiste à « faire vérifier mutuellement plusieurs copies du même modèle », et non à « planifier avec un modèle coûteux, vérifier avec un modèle bon marché ». Le schéma d’économie par répartition des rôles présenté plus bas est une pratique d’ingénierie que le lecteur peut essayer, et non une conclusion déjà validée par cette étude.
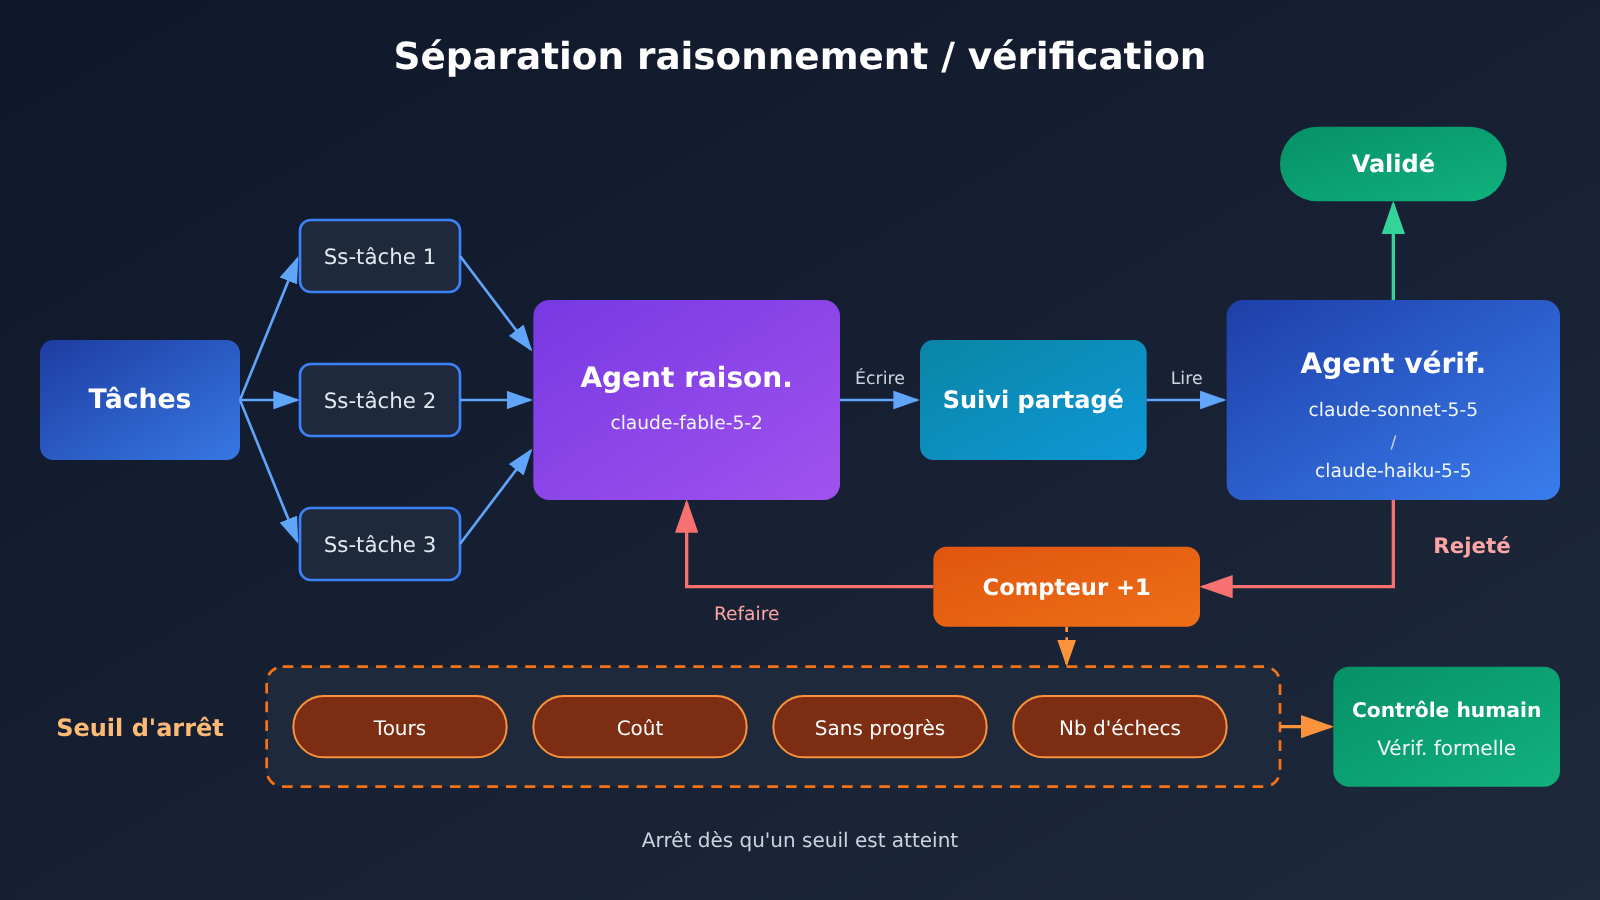
Comment répartir les rôles dans les tâches d’Agent intensives : séparer le raisonnement principal de la vérification
Dans les tâches d’Agent intensives, ce qui coûte généralement le plus cher, c’est la voie qui exige une réflexion approfondie ; ce qui est le plus fréquent, en revanche, ce sont les actions de vérification : contrôle, comparaison, validation de format, etc. Si tous les appels passent par le même modèle le plus coûteux, les frais augmentent de façon linéaire, voire super-linéaire, avec le nombre de tours. Séparer « réflexion » et « vérification » en deux rôles est le moyen le plus direct de maîtriser les coûts.
Le principe de la séparation peut se résumer ainsi : les étapes qui demandent une réflexion ouverte et une planification à longue chaîne sont confiées au rôle de raisonnement principal ; les contrôles qui disposent de critères explicites — « cette étape est-elle cohérente avec la précédente », « le format de sortie est-il conforme », « la conclusion entre-t-elle en conflit avec la littérature connue » — sont confiés au rôle de vérification. Ce dernier doit rendre un jugement structuré, et non refaire tout le raisonnement.
| Rôle | Responsabilités | ID de modèle candidat | Exigences de sortie |
|---|---|---|---|
| Raisonnement principal | Déduction ouverte, génération de solutions, étapes clés | claude-fable-5-2, claude-fable-5-2-thinking |
Processus de raisonnement complet et conclusions intermédiaires |
| Vérification de premier niveau | Cohérence logique, comparaison des étapes, vérification des citations | claude-sonnet-5-5 |
PASS / FAIL avec justification |
| Vérification légère | Contrôle de format, intégrité des champs, comparaison simple | claude-haiku-5-5 |
Résultat JSON structuré |
| Vérification externe | Preuve formelle, validation numérique, relecture humaine | Outil ou humain | Confirmation finale |
Avec cette répartition, tous les rôles peuvent passer par le même point d’entrée d’appel. Via APIYI apiyi.com, une seule clé API suffit pour basculer entre les modèles du tableau ci-dessus ; l’interface est compatible OpenAI, et le raisonnement principal comme la vérification n’ont qu’à modifier le paramètre model, sans maintenir plusieurs SDK ni plusieurs jeux de clés. Pour les tâches longues qui nécessitent plusieurs exécutions en parallèle, un point d’entrée unifié permet aussi de regrouper les statistiques d’utilisation au même endroit, ce qui facilite la reconciliation.
Attention toutefois : un modèle de vérification moins cher n’est pas pour autant plus fiable. La capacité du rôle de vérification dépend de la clarté des critères que vous lui donnez. Il vaut mieux commencer par un petit lot d’échantillons dont vous connaissez déjà la réponse, vérifier que les jugements de validation et de rejet du modèle de vérification correspondent globalement à ce qu’on attend, puis l’intégrer dans les tâches longues.
Comment choisir une API pour les tâches d’agent exigeantes : prix et ID de modèle
Le contrôle budgétaire d’une tâche longue suppose que le prix unitaire de chaque appel soit déterminé. Une règle à tenir : n’appeler que des modèles dont le tarif figure explicitement dans le tableau des modèles, et coder en dur dans le code l’ID du modèle et son prix unitaire correspondant, plutôt que de changer de modèle à la volée pendant l’exécution.
D’après la page officielle des modèles d’Anthropic, Claude Fable 5.2 est sorti le 9 novembre 2026 ; l’ID du modèle est claude-fable-5-2, la fenêtre de contexte est de 1 million de tokens, la sortie maximale de 128 000 tokens, et la réflexion est activée par défaut. Le tableau ci-dessous reprend les tarifs des modèles concernés par cet article, relevés dans le tableau général des modèles d’APIYI apiyi.com à la date de vérification (2026-11-19), en dollars par million de tokens.
| ID du modèle | Entrée | Lecture de cache | Sortie | Rôle suggéré dans cet article |
|---|---|---|---|---|
claude-fable-5-2 |
8 | 0,2 | 40 | Raisonnement principal |
claude-fable-5-2-thinking |
8 | 0,2 | 40 | Raisonnement principal (version réflexion) |
claude-fable-5-1 |
10 | 0,25 | 50 | Version voisine, pour comparaison |
claude-sonnet-5-5 |
2 | 0,1 | 10 | Vérification de premier niveau |
claude-haiku-5-5 |
0,1 | 0,01 | 0,5 | Validation légère |
Le tableau livre plusieurs informations décisives pour les tâches longues. Premièrement, le tarif de claude-fable-5-2 est inférieur à celui du claude-fable-5-1 voisin : si votre raisonnement principal tourne encore sur l’ancienne version, une migration mérite d’être évaluée. Deuxièmement, la lecture de cache ne coûte que 2,5 % du prix d’entrée ; dans une tâche longue, l’agent relit sans cesse la progression partagée, l’invite système et les documents de contexte — si cette partie tombe dans le cache, l’écart de coût sera net. Le fait de toucher ou non le cache dépend de la méthode d’appel et des règles de la plateforme : référez-vous à la documentation. Troisièmement, l’écart de prix unitaire entre le modèle de vérification et le raisonnement principal est d’un ordre de grandeur.
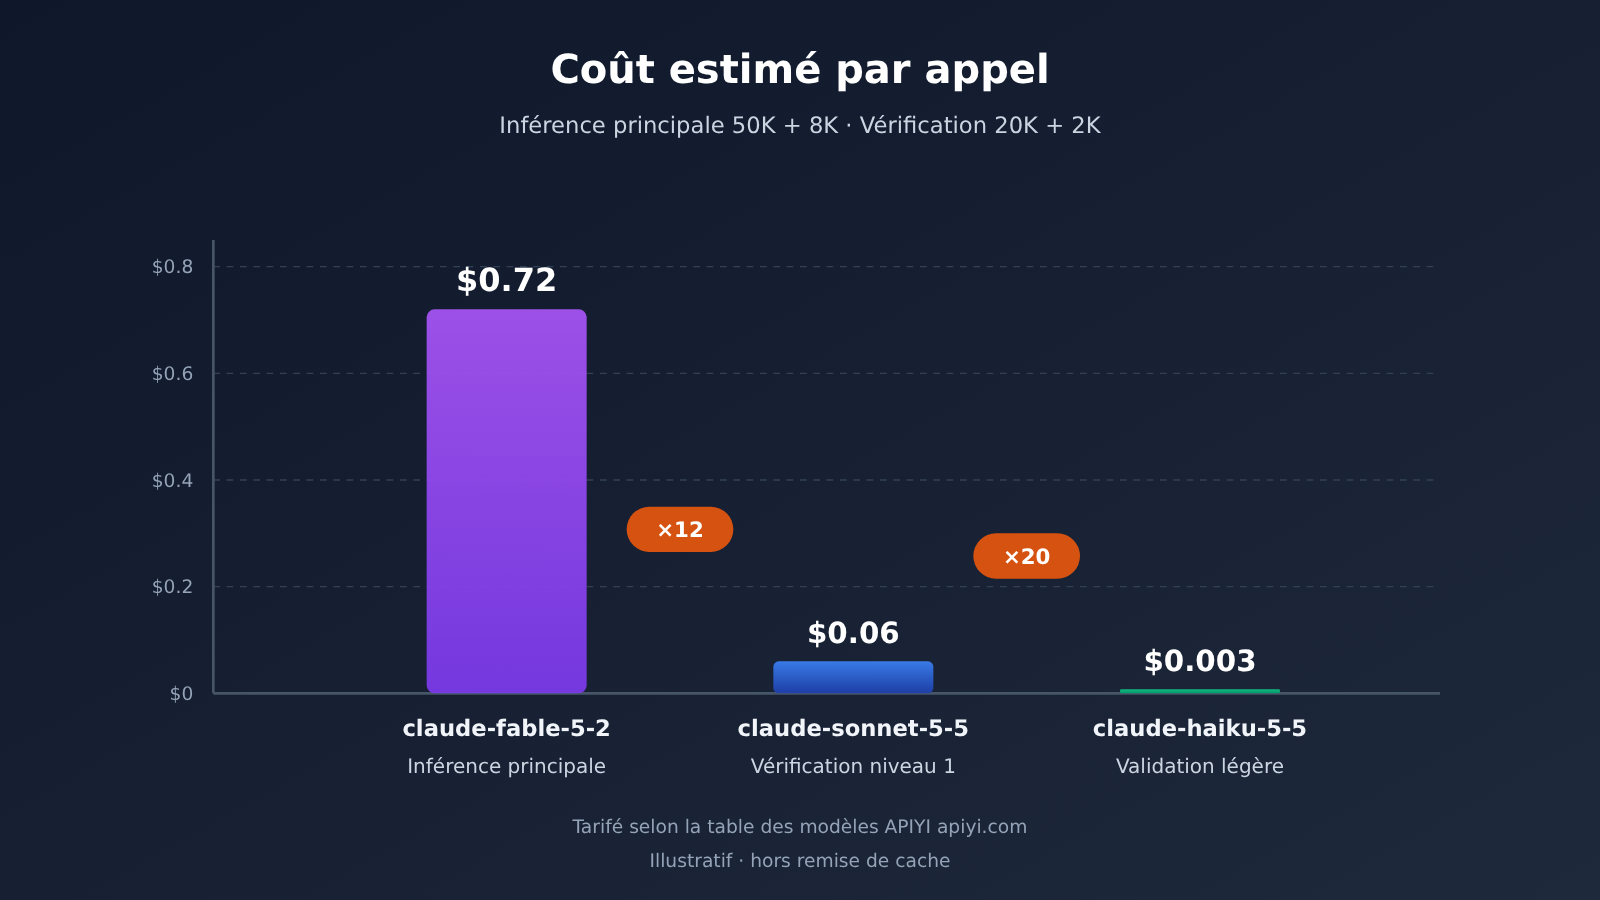
Voyons ce que cela donne avec des chiffres hypothétiques : un appel de raisonnement principal avec 50 000 tokens en entrée et 8 000 tokens en sortie coûte environ 0,4 + 0,32 = 0,72 USD sur claude-fable-5-2 ; une vérification avec 20 000 tokens en entrée et 2 000 en sortie coûte environ 0,04 + 0,02 = 0,06 USD sur claude-sonnet-5-5, et environ 0,003 USD sur claude-haiku-5-5. Si la vérification utilisait elle aussi le modèle de raisonnement principal, le même appel de vérification coûterait environ 0,16 + 0,08 = 0,24 USD. Ce n’est qu’une illustration arithmétique : le nombre réel de tokens dépend de votre tâche.
Autre repère : sur la page officielle des modèles, Opus 5.5 est tarifé à 4 en entrée et 20 en sortie, Sonnet 5.5 à 2 et 10, et Haiku 5.5 à partir de 0,10 et 0,50 — de quoi situer la grille tarifaire officielle. Au moment de l’appel réel, le modèle et le prix font foi selon la liste des modèles de la plateforme ; la série claude-fable-5-2 d’APIYI prend en charge les deux points de terminaison chat et messages, avec une entrée unique : https://api.apiyi.com/v1.
Prise en main rapide des tâches Agent lourdes : code d’orchestration avec seuil d’arrêt
Exemple minimal
Commencez par vérifier que le modèle de raisonnement principal répond correctement et que le champ usage est bien renvoyé — c’est la base de tout calcul de coût par la suite :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Interface compatible OpenAI d'APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "列出这一步推导需要独立核对的三个关键假设"}],
    max_tokens=2000,
)
print(resp.choices[0].message.content)
print(resp.usage)  # Pour comptabiliser les tokens et estimer les coûts
Définir clairement une ligne d’arrêt pour chaque agent
Dans l’article de recherche, les premiers essais parallèles d’agents ont échoué 61 fois. Cela nous rappelle une chose : les tâches d’Agent intensives comportent forcément beaucoup de tentatives ratées, et l’échec lui-même coûte de l’argent. Le rôle de la ligne d’arrêt, c’est de permettre à chaque agent de s’arrêter automatiquement avant de perdre le contrôle, afin de laisser un humain ou un outil trancher.
| Ligne d’arrêt | Signification | Valeur initiale suggérée (à ajuster selon la tâche) |
|---|---|---|
| Nombre maximum de tours | Plafond des allers-retours entre raisonnement principal et vérification | 10 à 30 tours |
| Plafond de coût | Plafond du coût cumulé estimé pour un agent | À définir selon le budget par question |
| Absence de progrès consécutive | La vérification renvoie l’agent en boucle sans nouvelle conclusion | 3 à 5 fois |
| Nombre maximum d’échecs | Nombre cumulé de rejets par la vérification | Environ la moitié du nombre de tours |
| Longueur de sortie | Plafond de tokens pour une seule sortie | Bien inférieure à la sortie maximale de 128 000 tokens |
Voir le code d’implémentation complet
from dataclasses import dataclass, field
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Point d'entrée unifié APIYI, partagé entre l'inférence principale et la révision
)

# Tarifs unitaires : dollars / million de tokens, codés en dur selon la table des modèles de la plateforme, à mettre à jour manuellement en cas de changement
PRICES = {
    "claude-fable-5-2": (8.0, 40.0),
    "claude-sonnet-5-5": (2.0, 10.0),
    "claude-haiku-5-5": (0.1, 0.5),
}

SOLVER = "claude-fable-5-2"
REVIEWER = "claude-sonnet-5-5"


@dataclass
class StopLine:
    max_rounds: int = 20
    max_cost_usd: float = 5.0
    max_no_progress: int = 4
    max_failures: int = 10
    max_output_tokens: int = 8000


@dataclass
class RunState:
    rounds: int = 0
    cost_usd: float = 0.0
    failures: int = 0
    no_progress: int = 0
    notes: list = field(default_factory=list)


def estimate_cost(model: str, usage) -> float:
    """Estimation au tarif affiché, sans remise de cache, résultat volontairement conservateur."""
    price_in, price_out = PRICES[model]
    return (usage.prompt_tokens * price_in + usage.completion_tokens * price_out) / 1_000_000


def call(model: str, messages: list, max_tokens: int, state: RunState) -> str:
    resp = client.chat.completions.create(
        model=model, messages=messages, max_tokens=max_tokens
    )
    state.cost_usd += estimate_cost(model, resp.usage)
    return resp.choices[0].message.content


def should_stop(state: RunState, line: StopLine) -> str | None:
    if state.rounds >= line.max_rounds:
        return "达到最大轮数"
    if state.cost_usd >= line.max_cost_usd:
        return "达到费用封顶"
    if state.no_progress >= line.max_no_progress:
        return "连续无进展"
    if state.failures >= line.max_failures:
        return "失败次数过多"
    return None


def run_task(task: str, line: StopLine = StopLine()) -> dict:
    state = RunState()
    progress = "(尚无进展)"

    while True:
        reason = should_stop(state, line)
        if reason:
            return {"status": "stopped", "reason": reason, "progress": progress,
                    "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}

        state.rounds += 1
        draft = call(SOLVER, [
            {"role": "system", "content": "你是主推理代理,只推进一步,写清依据。"},
            {"role": "user", "content": f"任务:{task}\n当前进展:{progress}\n请推进下一步。"},
        ], line.max_output_tokens, state)

        verdict = call(REVIEWER, [
            {"role": "system", "content": "你是复核代理,不重新推导,只判断。"
                                          "第一行只输出 PASS 或 FAIL,第二行给理由。"},
            {"role": "user", "content": f"已有进展:{progress}\n新的一步:{draft}"},
        ], 500, state)

        if verdict.strip().upper().startswith("PASS"):
            progress = draft
            state.no_progress = 0
            if "已完成" in draft:
                return {"status": "done", "progress": progress,
                        "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}
        else:
            state.failures += 1
            state.no_progress += 1
            state.notes.append(verdict)


if __name__ == "__main__":
    print(run_task("核对给定推导中每一步的符号约定是否一致,完成后写“已完成”"))
Ce code comporte trois choix de conception volontaires. Premièrement, la table des prix unitaires est codée en dur : toute personne qui change de modèle doit aussi changer le prix unitaire, ce qui évite que le budget devienne faux parce qu’on est « passé à un modèle sans tarif renseigné ». Deuxièmement, le rôle de vérificateur doit uniquement produire PASS ou FAIL accompagné d’une justification, sans refaire la dérivation : cela permet de maîtriser la longueur de sa sortie. Troisièmement, en cas d’arrêt, le système renvoie l’avancement actuel et le coût cumulé, afin de faciliter une reprise humaine plutôt que de laisser l’agent réessayer sans fin.
🚀 Démarrage rapide : je vous conseille de commencer par APIYI apiyi.com avec le crédit d’essai gratuit réservé aux nouveaux utilisateurs, de faire tourner le processus ci-dessus sur un petit problème dont vous connaissez déjà la réponse, de vérifier que le jugement du vérificateur et l’estimation des coûts correspondent bien à ce que vous attendez, puis d’augmenter progressivement le nombre de voies parallèles et de tours.
FAQ : choisir une API pour les tâches d’agent lourdes
Q1 : Peut-on croire que Claude Fable 5.2 a résolu un problème de physique des trous noirs ?
C’est une déclaration officielle tirée d’un billet de recherche d’Anthropic daté du 17 novembre 2026. Les deux articles concernés sont des préprints, pas encore évalués par les pairs. Le résultat de la deuxième question a été formellement vérifié avec Lean en septembre 2026, et pour la première, un autre physicien est arrivé à la même réponse par une méthode différente. À lire donc au niveau « déclaration officielle + préprint ».
Q2 : Le billet parle de « aucune configuration particulière » : cela veut-il dire que c’est bon marché ?
Non. « Aucune configuration particulière » décrit la façon dont le dispositif a été monté ; le billet ne fournit aucune facture de coûts. 22 questions, un agent par question, environ six semaines de calcul en arrière-plan : le volume d’appels n’a rien de négligeable. Si vous lancez vous-même des tâches d’une ampleur comparable, estimez le coût à partir des tarifs du tableau des modèles et fixez un plafond de dépenses.
Q3 : Utiliser un modèle bon marché pour la vérification, est-ce une pratique validée par le billet de recherche ?
Non. La méthode du billet consiste à faire refaire le travail indépendamment par plusieurs copies du même modèle, puis à croiser leurs résultats. « Raisonnement principal avec un modèle coûteux, vérification avec un modèle bon marché » est une pratique d’ingénierie que cet article vous suggère d’essayer ; son efficacité reste à valider sur vos propres tâches. Pour les étapes où l’exactitude est critique, vous pouvez aussi conserver l’approche « deux raisonnements principaux refaits indépendamment ».
Q4 : Comment choisir entre `claude-fable-5-2` et `claude-fable-5-2-thinking` ?
Les deux ont le même tarif dans le tableau des modèles d’APIYI : 8 en entrée, 0.2 en lecture de cache, 40 en sortie, en dollars par million de tokens. La page officielle du modèle indique que la réflexion de Fable 5.2 est activée par défaut. Les différences concrètes de comportement entre les deux ID sont à vérifier dans la documentation des modèles de la plateforme ; le mieux est de lancer plusieurs fois la même tâche avec chacun, de comparer la longueur des sorties et le champ `usage`, puis de choisir celui qui servira au raisonnement principal.
Q5 : Comment appeler le raisonnement principal et le modèle de vérification via une seule interface ?
Après vous être inscrit sur APIYI (apiyi.com) et avoir récupéré une clé API, il suffit de régler le `base_url` du SDK sur `https://api.apiyi.com/v1` : pour le raisonnement principal et la vérification, il n’y a qu’à changer le paramètre `model`, par exemple `claude-fable-5-2` et `claude-sonnet-5-5`. Les nouveaux utilisateurs disposent d’un quota d’essai gratuit, idéal pour valider d’abord le seuil d’arrêt et la logique de vérification.
Q6 : Quel est l’intérêt du prix de lecture du cache dans les tâches longues ?
Le prix de lecture du cache de Fable 5.2 représente 2.5 % du prix d’entrée, soit 0.2 dollar par million de tokens. Les tâches longues multi-agents relisent sans cesse l’invite système, les documents de contexte et l’état d’avancement partagé : garder ces contenus stables et placés en tête de l’invite augmente les chances de toucher le cache. Pour savoir si le cache est touché et comment la facturation s’applique, référez-vous à la documentation de la plateforme.
Q7 : Quel seuil d’arrêt choisir ?
Il n’existe pas de chiffre universel. Je conseille de commencer par des valeurs prudentes : 10 à 30 tours, 3 à 5 arrêts consécutifs pour absence de progrès, et un plafond de coût par exécution fixé selon la valeur de la tâche. Une fois une série terminée, regardez la répartition des motifs d’arrêt. Si la plupart des arrêts sont dus au « plafond de coût » alors que la tâche touchait presque au but, assouplissez un peu les limites ; si la majorité vient de l’« absence de progrès consécutive », c’est que la tâche n’a pas été découpée assez finement.
Q8 : Quelles sont les limites de cette approche ?
Premièrement, le modèle de vérification peut laisser passer une erreur ou en signaler une à tort ; il faut donc le calibrer sur des échantillons dont la réponse est connue. Deuxièmement, l’estimation des coûts se base sur les prix catalogue, sans tenir compte des remises liées au cache ni des fluctuations provoquées par les tentatives échouées. Troisièmement, comme dans le cas du billet de recherche, la conclusion finale demande toujours une validation externe — preuve formelle ou relecture par un expert du domaine — car le fait que les agents se valident mutuellement ne garantit pas que le résultat soit correct.
Choisir son API pour les tâches Agent lourdes : les points clés
- Qualifier la source : l’étude Fable 5.2 sur les trous noirs est un récit officiel, et l’article est un preprint — regardez la méthode, pas la conclusion
- Séparer les rôles : le raisonnement ouvert revient au modèle de raisonnement principal, les vérifications à critères explicites reviennent au modèle de vérification
- La vérification doit être indépendante : elle juge sans refaire le raisonnement et renvoie PASS / FAIL avec une justification
- Des seuils d’arrêt obligatoires : nombre de tours, coût, absence de progrès consécutive, nombre d’échecs — ces quatre lignes sont indispensables
- N’utilisez que des modèles dont le prix est connu : l’ID du modèle et le prix unitaire sont codés en dur ; tout changement de modèle doit s’accompagner d’une mise à jour du prix
- Exploitez la lecture du cache : placez en tête les éléments stables (contexte de fond, progression), car la lecture du cache ne coûte que 2,5 % du prix d’entrée
- Un point d’entrée unique pour démarrer : avec une seule clé APIYI, basculez entre modèle de raisonnement principal et modèle de vérification, et commencez par de petits exercices avec le quota gratuit
Résumé
En partant de ce cas où Claude Fable 5.2 vient à bout d’un problème de physique des trous noirs, trois enseignements sont particulièrement utiles pour les tâches d’agent lourdes :
- Séparer le raisonnement principal de la vérification : dans le billet de recherche, plusieurs copies du même modèle se contrôlent mutuellement. À partir de cette base, vous pouvez essayer de choisir des modèles de gammes de prix différentes selon les rôles, et valider la qualité de la vérification sur des échantillons.
- Définir clairement une ligne d’arrêt pour chaque voie : les 61 tentatives infructueuses montrent que l’échec est la norme. Le nombre de tours, le coût, l’absence de progrès et le nombre d’échecs doivent tous avoir une limite.
- N’appeler que des modèles dont le prix figure dans la table des modèles : inscrivez dans le code les ID de modèles et les prix unitaires, comme
claude-fable-5-2,claude-sonnet-5-5,claude-haiku-5-5, pour que les coûts soient prévisibles et plafonnables.
Le succès d’une tâche longue dépend rarement de l’intelligence d’un seul appel : il dépend surtout de la capacité du flux global à progresser dans un budget maîtrisé, tout en laissant des résultats vérifiables. Je recommande de commencer par une petite tâche avec les crédits d’essai gratuits sur APIYI apiyi.com, puis d’ajuster progressivement les paramètres selon la raison d’arrêt et d’élargir l’échelle.
📚 Références
-
Billet de recherche Anthropic : le récit officiel de Claude Fable 5.2 résolvant deux problèmes de physique des trous noirs avec plusieurs agents
- Lien :
anthropic.com/research/claude-black-hole-physics - Description : une source de première main pour comprendre la répartition des agents, la durée et la méthode de vérification
- Lien :
-
Premier preprint : le preprint associé au billet de recherche, non relu par les pairs
- Lien :
hexagonmath.org/2611.00175v1 - Description : pour les lecteurs qui souhaitent consulter le texte original des résultats
- Lien :
-
Second preprint : l’autre preprint associé au billet de recherche, non relu par les pairs
- Lien :
hexagonmath.org/2611.00174v1 - Description : à lire en regard du précédent
- Lien :
-
Page officielle du modèle Claude Fable 5.2 : ID du modèle, contexte, sortie maximale et prix officiels
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview - Description : pour vérifier les spécifications du modèle et la grille tarifaire officielle
- Lien :
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; les informations sur les modèles et les prix sont disponibles dans le centre de documentation docs.apiyi.com


