
작성자 주: 이 글은 Claude Fable 5.2 멀티 에이전트가 블랙홀 물리 문제 두 개를 완료한 공식 연구 글을 바탕으로, 고강도 에이전트 작업에서 모델 선택, 역할 분리, 정지선 설정에 바로 적용할 수 있는 방법을 정리해요.
2026년 11월 17일, Anthropic은 연구 글을 하나 발표했어요: Claude Fable 5.2의 여러 복제본이 백그라운드에서 약 6주 동안 실행되며 블랙홀 물리 문제 두 개를 완료했어요. 장시간 작업과 멀티 에이전트를 운영하는 개발자에게 이 사건에서 볼 만한 점은 물리 자체가 아니라, 오랜 시간 동안 여러 경로로 병렬 실행하고 서로 교차 검증하는 작업 방식이에요.
이 글은 물리학 교양 글이 아니에요, 어느 쪽 API가 더 안정적인지 판단해 주지도 않아요. 이 글은 딱 한 가지 일만 해요: 연구 글에서 참고할 만한 엔지니어링 신호를, 여러분이 직접 고강도 에이전트 작업을 운영할 때 따라 할 수 있는 단계로 옮겨 놓는 거예요.
핵심 가치: 이 글을 다 읽으면, 주 추론과 검증을 서로 다른 역할로 나누는 방법, 각 에이전트 경로마다 정지선을 분명히 적는 방법, 그리고 모델 목록에 가격이 명확히 표시된 모델 사이에서만 선택하는 방법을 알게 될 거예요. 그렇게 하면 장시간 작업의 비용을 예측할 수 있고 상한도 정할 수 있어요.
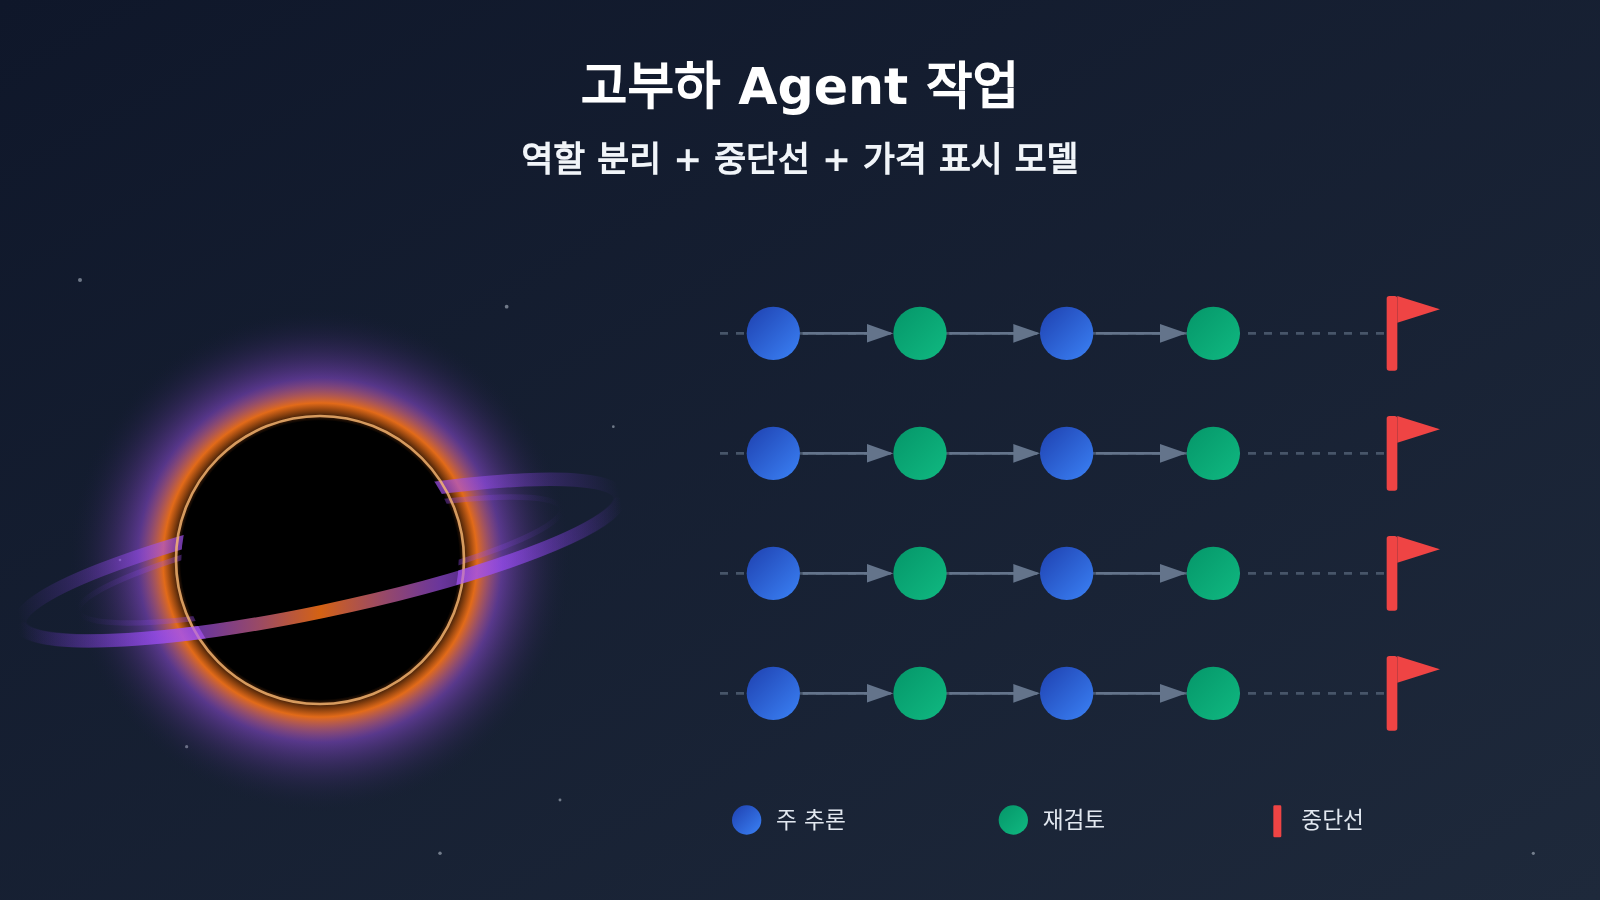
Claude Fable 5.2 연구 포스트에서 본 고강도 에이전트 작업의 핵심 포인트
먼저 배경부터 한두 문단으로 정리해 볼게요. 이 연구 포스트는 Anthropic이 직접 쓴 공식 설명이고, 여기서 언급된 두 편의 논문은 아직 프리프린트(preprint) 단계로 동료 검토를 거친 논문은 아니에요. 두 문제 모두 이론 물리학에 속하고, 우리가 사는 우주를 서술하지도 않으며 실용적인 용도도 없어요. 그래서 이 포스트의 의미는 “결론이 얼마나 중요한가”보다 “방법” 쪽에 있어요.
포스트에 따르면, 2026년 8월에 연구원 Hongbin Chen이 Claude에게 블랙홀과 bootstrap 방향의 미해결 문제를 나열해 달라고 했고, 몇 시간 뒤 22문제를 받았어요. 그는 문제마다 에이전트를 하나씩 따로 붙여 주었고, 에이전트끼리는 서로의 진행 상황을 읽을 수 있었으며, 이렇게 백그라운드에서 약 6주간 돌렸어요. 포스트 원문은 “특별한 설정은 없었다”고 하지만, 이건 공식 측이 구축 방식을 설명한 것일 뿐 비용이 0이라는 뜻은 아니고, 포스트에도 비용 내역은 나오지 않아요.
| 연구 포스트의 사실 | 고강도 에이전트 작업에 주는 시사점 | 이렇게 해볼 수 있어요 |
|---|---|---|
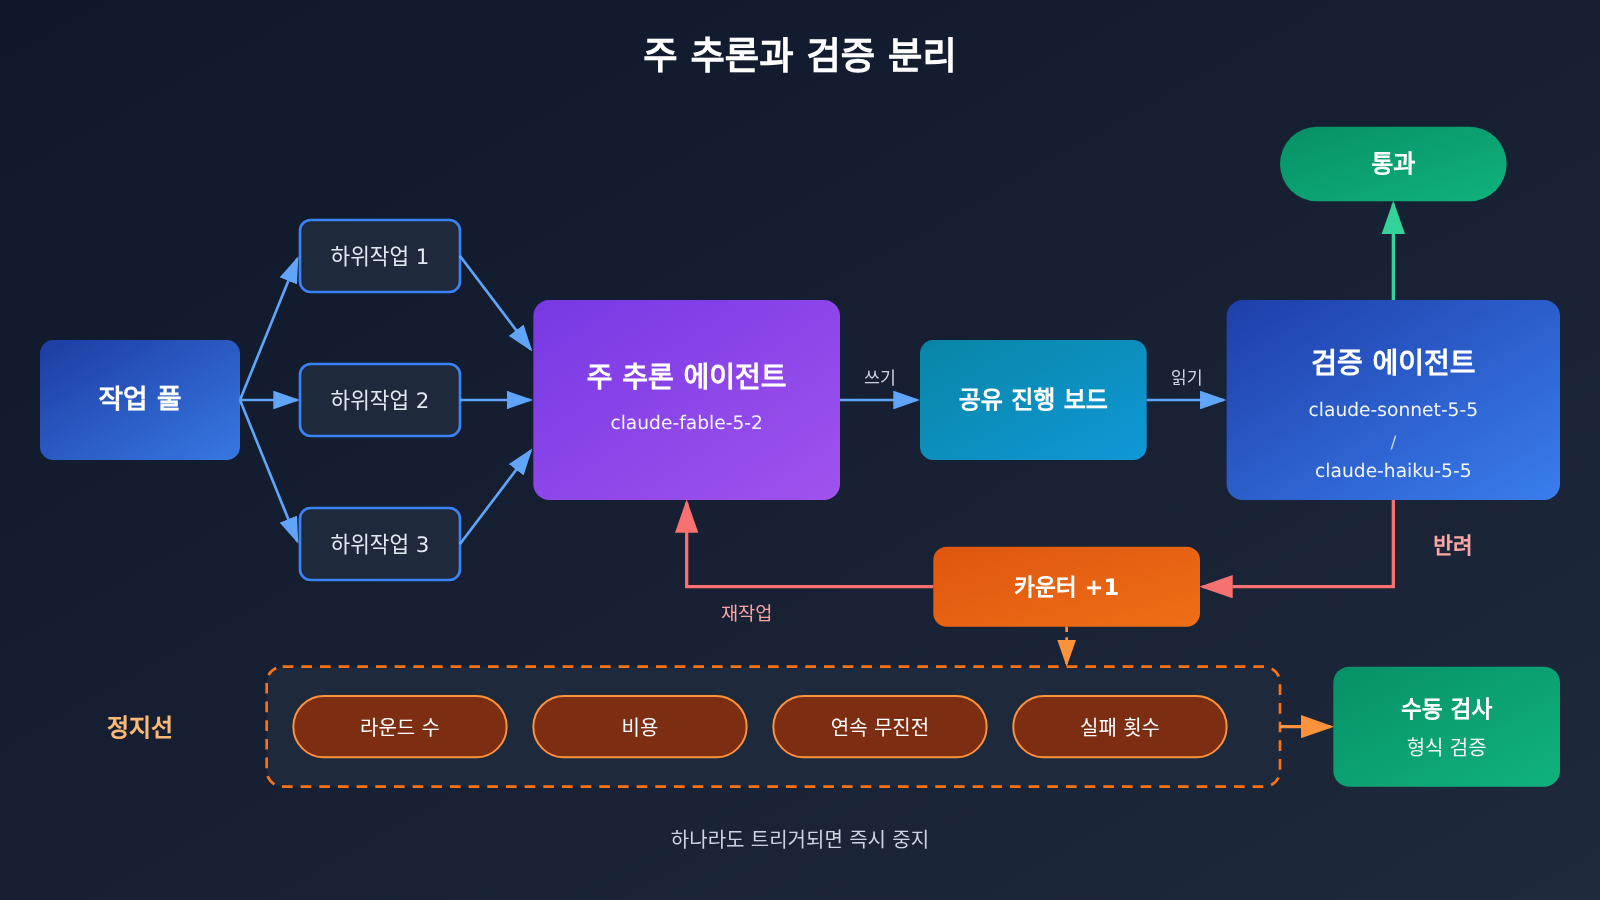
| 문제 하나당 에이전트 하나, 에이전트끼리 서로의 진행 상황을 읽을 수 있음 | 작업 분할 단위가 명확해야 하고, 공유 상태는 읽기 가능해야 해요 | 하위 작업마다 독립 에이전트를 두고, 진행 상황을 공유 스토리지에 기록 |
| 거의 모든 단계를 두 개의 에이전트가 독립적으로 수행한 뒤 문헌과 대조 | 핵심 단계에는 독립적인 재검증이 필요해요 | 주 추론과 재검증을 두 개의 역할로 분리 |
| 초기 에이전트들이 병렬로 61번 시도했지만 실패 | 실패는 당연한 것이고, 실패에는 상한이 있어야 해요 | 경로마다 최대 실패 횟수와 예산을 명확히 지정 |
| 결과는 Lean 형식화 검증과 물리학자 검사로 확인 | 기계의 결과는 최종적으로 외부 검증이 필요해요 | 사람 또는 도구에 의한 검증 단계를 남겨 두기 |
| 백그라운드에서 약 6주간 실행 | 긴 작업은 비용이 누적돼요 | 모델별 가격표를 기준으로 비용을 추정하고 비용 상한을 설정 |
고난도 Agent 작업, 두 문제가 각각 무엇을 보여주나
첫 번째 문제는 2003년에 제기된 뒤로 계속 계산이 마무리되지 않았던 호킹-페이지 상전이 계산이에요. 글에 따르면 거의 매 단계마다 두 개의 Agent가 독립적으로 한 번씩 수행한 다음 문헌과 대조했고, 결론은 약결합에서도 전이가 여전히 갑작스럽게 일어난다는 것이었어요. 또 다른 물리학자가 다른 방법으로 독립적으로 같은 답을 얻으면서 교차 검증이 이루어졌죠. 엔지니어링 실무 관점에서 이 문제가 말해주는 것은 “독립 반복 + 외부 대조”라는 검증 방식이에요.
두 번째 문제는 모듈러 bootstrap의 가장 단순한 버전에서 상한을 구하는 문제예요. 더 이전에 투입된 Claude Agent들이 병렬로 61번이나 시도했지만 모두 실패했고, 이후의 Agent는 수치 결과에서 규칙성을 발견해 다른 구 채우기(sphere packing) 문제의 방법을 빌려서 가장 가벼운 블랙홀 질량의 상한이 대략 c/9.1266임을 증명했어요. 그리고 이 방법으로는 상한을 더 낮출 수 없다는 점도 지적했죠. 2026년 9월에는 이 결과가 Lean으로 형식 검증을 거쳤고, 논문은 Claude가 작성했으며 물리학자가 주요 결과를 검토했어요. 이 문제가 엔지니어링에 주는 시사점은, 대량의 실패 시도가 과정의 일부이므로 각 경로마다 예산과 중단 조건이 반드시 있어야 한다는 것이에요.
특별히 짚고 넘어갈 점은, 글에서 소개한 방식이 “같은 모델의 여러 복사본이 서로 검증하는 것”이지 “계획은 비싼 모델, 검증은 저렴한 모델”이 아니라는 거예요. 아래에서 소개할 역할 분리로 비용을 아끼는 방안은 독자가 시도해볼 수 있는 엔지니어링 접근이지, 이 연구에서 이미 검증된 결론은 아니에요.
무거운 Agent 작업에서 역할을 나누는 방법: 주 추론과 재검토를 분리하기
무거운 Agent 작업에서는 가장 비싼 것이 보통 깊은 추론이 필요한 경로이고, 가장 빈번한 것은 검사, 비교, 형식 검증 같은 재검토 작업이에요. 모든 호출이 똑같이 가장 비싼 모델을 거친다면 비용은 라운드 수에 따라 선형, 심지어 초선형으로 증가해요. “생각해내기”와 “한 번 확인하기”를 두 역할로 나누는 것이 비용을 통제하는 가장 직접적인 수단이에요.
분리의 원칙은 이렇게 요약할 수 있어요. 개방형 추론과 긴 사슬의 계획이 필요한 단계는 주 추론角色에 맡기고, “이 단계가 이전 단계와 일치하는가”, “출력 형식이 규정을 지켰는가”, “결론이 알려진 문헌과 충돌하는가”처럼 명확한 기준이 있는 검사는 재검토 역할에 맡겨요. 재검토 역할이 내놓아야 하는 것은 다시 한 번 추론하는 것이 아니라 구조화된 판단이에요.
| 역할 | 담당 내용 | 후보 모델 ID | 출력 요구 사항 |
|---|---|---|---|
| 주 추론 | 개방형 추론, 방안 생성, 핵심 단계 | claude-fable-5-2, claude-fable-5-2-thinking |
완전한 추론 과정과 중간 결론 |
| 1차 재검토 | 논리 일관성, 단계 대조, 인용 확인 | claude-sonnet-5-5 |
PASS / FAIL과 이유 |
| 경량 검증 | 형식 검사, 필드 완전성, 단순 비교 | claude-haiku-5-5 |
구조화된 JSON 결과 |
| 외부 검증 | 형식적 증명, 수치 검증, 사람 검토 | 도구 또는 사람 | 최종 확인 |
이렇게 역할을 나누면 모든 역할이 같은 호출 진입점을 거칠 수 있어요. APIYI apiyi.com을 통해 하나의 API 키로 위 표에 있는 모델들 사이를 오갈 수 있고, 인터페이스는 OpenAI 호환 방식이라 주 추론과 재검토는 model 파라미터만 바꾸면 돼요. 여러 SDK와 여러 개의 키를 관리할 필요가 없어요. 여러 경로를 병렬로 돌려야 하는 긴 작업에서는 통합 진입점 덕분에 사용량 통계도 한곳에 모여 대조하기 쉬워요.
다만 유의할 점은, 재검토 모델이 더 저렴하다고 해서 더 신뢰할 수 있다는 뜻은 아니에요. 재검토 역할이 제 역할을 할 수 있는지는 여러분이 준 판단 기준이 충분히 명확한지에 달려 있어요. 먼저 정답을 알고 있는 소량의 샘플로 한 번 돌려서, 재검토 모델의 통과와 반려 판단이 대체로 예상에 부합하는지 확인한 다음 긴 작업에 투입하는 걸 권해요.
장기·고부하 Agent 작업에서 API 고르는 법: 가격과 모델 ID
장기 작업의 예산을 통제하려면 모든 호출의 단가가 확정되어 있어야 해요. 한 가지 원칙을 지키는 게 좋아요. 모델 표에 가격이 명확히 적힌 모델만 호출하고, 코드에는 모델 ID와 해당 단가를 고정해 두며, 실행 중에 임의로 모델을 바꾸지 않는 거예요.
Anthropic 공식 모델 페이지에 따르면 Claude Fable 5.2는 2026년 11월 9일에 출시됐어요. 모델 ID는 claude-fable-5-2이고, 컨텍스트 윈도우는 100만 tokens, 최대 출력은 12.8만 tokens이며, 사고(thinking) 기능은 기본으로 켜져 있어요. 아래 표는 확인일(2026-11-19) 기준으로 APIYI apiyi.com 모델 전체 목록에서 이 글과 관련된 모델의 가격을 정리한 거예요. 단위는 100만 tokens당 미국 달러예요.
| 모델 ID | 입력 | 캐시 읽기 | 출력 | 이 글에서 권장하는 역할 |
|---|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 | 메인 추론 |
claude-fable-5-2-thinking |
8 | 0.2 | 40 | 메인 추론(사고 버전) |
claude-fable-5-1 |
10 | 0.25 | 50 | 인접 버전, 비교용 |
claude-sonnet-5-5 |
2 | 0.1 | 10 | 1차 검토 |
claude-haiku-5-5 |
0.1 | 0.01 | 0.5 | 경량 검증 |
표에서 장기 작업에 중요한 정보 몇 가지를 읽을 수 있어요. 첫째, claude-fable-5-2의 가격은 인접한 claude-fable-5-1보다 낮아요. 기존 메인 추론에 구버전을 쓰고 있다면 마이그레이션을 평가해 볼 만해요. 둘째, 캐시 읽기 가격은 입력 가격의 2.5%에 불과해요. 장기 작업에서 Agent가 공유 진행 상황, 시스템 프롬프트, 배경 문서를 반복해서 읽는데, 이 부분이 캐시에 적중하면 비용 차이가 확실히 커져요. 적중 여부는 호출 방식과 플랫폼 규칙에 따라 달라지니, 문서 설명을 기준으로 판단하세요. 셋째, 검토 모델과 메인 추론 모델의 단가 차이는 자릿수 단위로 벌어져요.
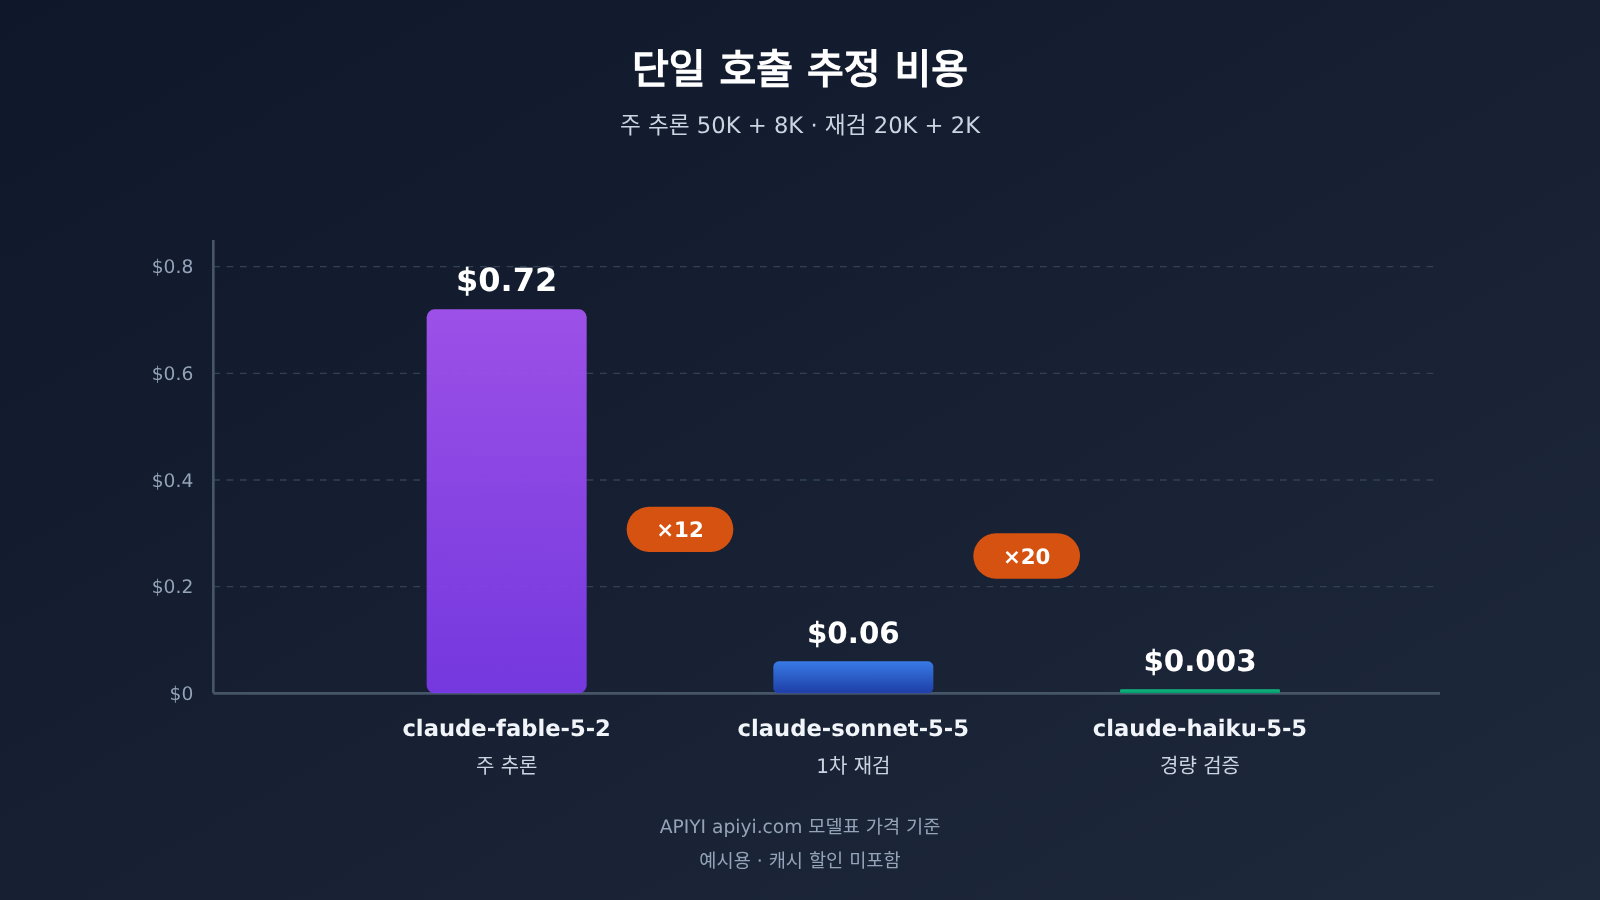
가상의 숫자로 한번 감을 잡아 볼까요? 메인 추론 호출 한 번에 입력 5만 tokens, 출력 8천 tokens라면 claude-fable-5-2에서 약 0.4 + 0.32 = 0.72달러예요. 검토 호출 한 번에 입력 2만, 출력 2천 tokens라면 claude-sonnet-5-5에서 약 0.04 + 0.02 = 0.06달러, claude-haiku-5-5에서는 약 0.003달러예요. 검토에도 메인 추론 모델을 쓴다면 같은 검토 호출이 약 0.16 + 0.08 = 0.24달러예요. 이건 산술적인 예시일 뿐이고, 실제 token 수는 여러분의 작업에 따라 달라져요.
또한 공식 모델 페이지에서 Opus 5.5의 가격은 입력 4, 출력 20이고, Sonnet 5.5는 2와 10, Haiku 5.5는 0.10과 0.50부터 시작해요. 공식 가격 구조를 가늠하는 참고 자료로 삼을 수 있어요. 실제 호출 시 모델과 가격은 플랫폼 모델 목록을 기준으로 하고, APIYI의 claude-fable-5-2 시리즈는 chat과 messages 두 엔드포인트를 지원하며, 진입점은 https://api.apiyi.com/v1로 통일되어 있어요.
고부하 에이전트 작업 빠르게 시작하기: 중단 기준선이 있는 스케줄링 코드
아주 간단한 예제
먼저 메인 추론 모델이 정상적으로 호출되는지, 그리고 usage 필드를 받을 수 있는지 확인해 보세요. 이 필드는 뒤에서 비용을 집계할 때 기초가 돼요.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # APIYI OpenAI 호환 인터페이스
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "列出这一步推导需要独立核对的三个关键假设"}],
    max_tokens=2000,
)
print(resp.choices[0].message.content)
print(resp.usage)  # 토큰 집계 및 비용 추산에 사용
각 에이전트 경로에 정지 조건을 명확히 정의하기
연구 글에서 초기 에이전트가 병렬로 61회나 시도했지만 끝내 성공하지 못했다는 점은 중요한 교훈을 줘요. 대규모 에이전트 작업에는 반드시 많은 실패 시도가 뒤따르고, 실패 자체도 비용을 쓴다는 사실이죠. 정지 조건의 역할은 각 에이전트 경로가 통제를 벗어나기 전에 스스로 멈추고, 판단을 사람이나 도구에 넘기는 거예요.
| 정지 조건 | 의미 | 권장 초기값 (작업에 따라 조정) |
|---|---|---|
| 최대 라운드 수 | 주 추론과 재검토 왕복의 상한 | 10~30 라운드 |
| 비용 상한 | 단일 경로 누적 추정 비용 상한 | 문제당 예산에 맞춰 설정 |
| 연속 무진전 | 재검토가 연속 반려되고 새 결론이 없음 | 3~5회 |
| 최대 실패 횟수 | 누적 재검토 반려 횟수 | 라운드 수의 절반 정도 |
| 출력 길이 | 단일 출력 token 상한 | 최대 출력 12.8만보다 훨씬 낮게 |
전체 구현 코드 보기
from dataclasses import dataclass, field
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # APIYI 통합 엔트리, 메인 추론과 재검증에서 공용
)

# 단가: 달러 / 백만 tokens, 플랫폼 모델 표 기준으로 하드코딩, 변경 시 수동 갱신
PRICES = {
    "claude-fable-5-2": (8.0, 40.0),
    "claude-sonnet-5-5": (2.0, 10.0),
    "claude-haiku-5-5": (0.1, 0.5),
}

SOLVER = "claude-fable-5-2"
REVIEWER = "claude-sonnet-5-5"


@dataclass
class StopLine:
    max_rounds: int = 20
    max_cost_usd: float = 5.0
    max_no_progress: int = 4
    max_failures: int = 10
    max_output_tokens: int = 8000


@dataclass
class RunState:
    rounds: int = 0
    cost_usd: float = 0.0
    failures: int = 0
    no_progress: int = 0
    notes: list = field(default_factory=list)


def estimate_cost(model: str, usage) -> float:
    """표시 단가로 추정하며, 캐시 할인은 반영하지 않아 결과가 보수적입니다."""
    price_in, price_out = PRICES[model]
    return (usage.prompt_tokens * price_in + usage.completion_tokens * price_out) / 1_000_000


def call(model: str, messages: list, max_tokens: int, state: RunState) -> str:
    resp = client.chat.completions.create(
        model=model, messages=messages, max_tokens=max_tokens
    )
    state.cost_usd += estimate_cost(model, resp.usage)
    return resp.choices[0].message.content


def should_stop(state: RunState, line: StopLine) -> str | None:
    if state.rounds >= line.max_rounds:
        return "达到最大轮数"
    if state.cost_usd >= line.max_cost_usd:
        return "达到费用封顶"
    if state.no_progress >= line.max_no_progress:
        return "连续无进展"
    if state.failures >= line.max_failures:
        return "失败次数过多"
    return None


def run_task(task: str, line: StopLine = StopLine()) -> dict:
    state = RunState()
    progress = "(尚无进展)"

    while True:
        reason = should_stop(state, line)
        if reason:
            return {"status": "stopped", "reason": reason, "progress": progress,
                    "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}

        state.rounds += 1
        draft = call(SOLVER, [
            {"role": "system", "content": "你是主推理代理,只推进一步,写清依据。"},
            {"role": "user", "content": f"任务:{task}\n当前进展:{progress}\n请推进下一步。"},
        ], line.max_output_tokens, state)

        verdict = call(REVIEWER, [
            {"role": "system", "content": "你是复核代理,不重新推导,只判断。"
                                          "第一行只输出 PASS 或 FAIL,第二行给理由。"},
            {"role": "user", "content": f"已有进展:{progress}\n新的一步:{draft}"},
        ], 500, state)

        if verdict.strip().upper().startswith("PASS"):
            progress = draft
            state.no_progress = 0
            if "已完成" in draft:
                return {"status": "done", "progress": progress,
                        "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}
        else:
            state.failures += 1
            state.no_progress += 1
            state.notes.append(verdict)


if __name__ == "__main__":
    print(run_task("核对给定推导中每一步的符号约定是否一致,完成后写“已完成”"))
이 코드에는 의도된 설계가 세 가지 있어요. 첫째, 단가표를 코드 안에 하드코딩해서 모델을 바꾸는 사람은 반드시 단가도 함께 바꿔야 하도록 만들었어요. “가격이 표시되지 않은 모델로 교체”해서 예산이 왜곡되는 상황을 막는 거죠. 둘째, 검증 역할에는 PASS 또는 FAIL과 그 이유만 출력하도록 요구하고 재추론은 금지해서 검증 출력의 길이를 통제해요. 셋째, 중단된 뒤에 현재 진행 상황과 누적 비용을 함께 반환해서 사람이 이어받기 쉽게 하고, 에이전트가 무한히 재시도하는 일을 막아요.
🚀 빠른 시작: 먼저 APIYI apiyi.com에서 신규 사용자에게 제공되는 무료 테스트 크레딧을 사용해, 이미 정답을 알고 있는 간단한 문제로 앞서 설명한 과정을 끝까지 실행해 보세요. 검토 판단과 비용 추정이 예상과 맞는지 확인한 다음, 병렬 경로 수와 라운드 수를 점진적으로 늘려가면 돼요.
대규모 에이전트 작업에 쓸 API 선택, 자주 묻는 질문 FAQ
Q1: Claude Fable 5.2가 블랙홀 물리 난제를 푼这个故事, 믿을 만한가요?
이 내용은 Anthropic이 2026년 11월 17일 올린 연구 게시물에서 직접 밝힌 설명이에요. 관련된 두 편의 논문은 프리프린트라 아직 동료 검토를 거치지 않았어요. 그중 두 번째 문제의 결과는 2026년 9월 Lean으로 형식 검증을 거쳤고, 첫 번째 문제는 다른 물리학자가 다른 방법으로 같은 답을 얻었어요. 읽을 때는 “공식 자술 + 프리프린트” 수준으로 이해하면 돼요.
Q2: 연구 게시물에서 “특별한 설정 없음”이라고 했는데, 그럼 아주 저렴하다는 뜻인가요?
아니요. “특별한 설정 없음”은 구축 방식을 말하는 것이지, 게시물이 비용 내역을 공개한 건 아니에요. 22개 문제에 문제마다 에이전트 하나씩, 백그라운드에서 약 6주를 돌렸으니 호출량 자체가 적지 않아요. 비슷한 규모의 작업을 직접 돌려볼 때는 모델표의 가격을 보고 직접 견적을 내고, 비용 상한을 꼭 설정해 두세요.
Q3: 저렴한 모델로 재검토하는 방식, 연구 게시물에서 검증된 방법인가요?
아니요. 게시물의 방식은 같은 모델의 여러 복사본이 각자 독립적으로 다시 풀고 서로 교차 확인하는 거예요. “주 추론은 비싼 모델, 재검토는 저렴한 모델”은 이 글에서 권하는 엔지니어링 방식이며, 효과는 여러분의 작업에서 직접 검증해 봐야 해요. 정확성이 아주 중요한 단계라면 “주 추론 두份을 독립적으로 다시 풀기” 방식을 유지해도 좋아요.
Q4: `claude-fable-5-2`와 `claude-fable-5-2-thinking`은 어떻게 고르나요?
둘은 APIYI 모델표에서 표가 가격이 같고, 모두 입력 8, 캐시 읽기 0.2, 출력 40달러(100만 tokens당)예요. 공식 모델 페이지에서는 Fable 5.2의 사고(thinking)가 기본으로 켜져 있다고 설명해요. 두 ID의 호출 동작상 구체적인 차이는 플랫폼 모델 설명을 기준으로 확인하고, 같은 작업을 각각 몇 번씩 돌려 출력 길이와 `usage`를 비교한 뒤 주 추론에 쓸 ID를 정하는 걸 권해요.
Q5: 하나의 인터페이스로 주 추론과 재검토 모델을 동시에 호출하려면 어떻게 하나요?
APIYI apiyi.com에서 가입하고 API 키를 발급받은 뒤, SDK의 base_url을 `https://api.apiyi.com/v1`로 설정하면 주 추론과 재검토는 `model` 파라미터만 바꾸면 돼요. 예를 들어 `claude-fable-5-2`와 `claude-sonnet-5-5`죠. 신규 사용자에게는 무료 테스트 할당량이 있어서, 정지 조건과 재검토 로직을 먼저 검증하기에 적합해요.
Q6: 긴 작업에서 캐시 읽기 가격이 무슨 의미가 있나요?
Fable 5.2의 캐시 읽기 가격은 입력 가격의 2.5%, 즉 100만 tokens당 0.2달러예요. 다중 에이전트 장기 작업은 시스템 프롬프트, 배경 자료, 공유 진행 상황을 반복해서 읽게 되는데, 이런 내용을 안정적으로 유지하고 프롬프트 앞부분에 두면 캐시 적중 가능성이 더 높아져요. 실제 적중 여부와 과금 방식은 플랫폼 문서를 기준으로 확인하세요.
Q7: 정지 조건은 얼마로 잡는 게 적당한가요?
보편적인 숫자는 없어요. 우선 보수적인 값에서 시작하는 걸 권해요. 라운드는 10~30회, 연속 무진전은 3~5회, 단일 경로 비용은 문제의 가치에 맞춰 상한을 두는 식이죠. 한 배치를 돌린 뒤 정지 사유 분포를 보세요. 대부분이 “비용 상한”인데 완료에 거의 도달한 상태라면 조금 넉넉하게 풀고, 대부분이 “연속 무진전”이라면 작업을 충분히 잘게 쪼개지 못했다는 신호예요.
Q8: 이런 방식에는 어떤 한계가 있나요?
첫째, 검수 모델이 놓치거나 잘못 판정할 수 있으니 정답을 알고 있는 샘플로 보정해야 해요. 둘째, 비용 추정은 정가를 기준으로 한 것이며 캐시 할인과 실패 재시도에 따른 변동은 반영하지 않았어요. 셋째, 연구 게시글에서처럼 최종 결론은 여전히 외부 검증이 필요해요. 예를 들어 형식적 증명이나 분야 전문가의 검토 같은 것이죠. 에이전트끼리 서로 통과했다고 해서 결과가 옳다는 뜻은 아니에요.
고강도 Agent 작업을 위한 API 선택 핵심 포인트 Key Takeaways
- 배경 정의: Fable 5.2 블랙홀 연구는 공식적인 자체 설명이고, 논문은 프리프린트이므로 결론보다 방법을 봐야 해요
- 역할 분리: 개방형 추론은 주 추론 모델에, 명확한 기준이 있는 검사는 검수 모델에 맡겨요
- 검수는 독립적으로: 검수는 판단만 하고 다시 추론하지 않으며, PASS / FAIL과 이유를 출력해요
- 중단 기준은 반드시 명시: 라운드 수, 비용, 연속 무진행, 실패 횟수 이 네 가지 기준이 모두 필요해요
- 가격이 표시된 모델만 사용: 모델 ID와 단가를 코드에 고정하고, 모델을 바꾸면 가격도 반드시 함께 수정해요
- 캐시 읽기 활용: 안정적인 배경과 진행 상황을 앞부분에 두면, 캐시 읽기는 입력 가격의 2.5%에 불과해요
- 통합 진입점으로 시작: APIYI의 Key 하나로 주 추론 모델과 검수 모델을 전환하고, 먼저 무료 할당량으로 작은 문제를 실행해 보세요
요약
Claude Fable 5.2가 블랙홀 물리 난제를 풀어낸 이 사례에서, 에이전트 중심의 대규모 작업에서 가장 참고할 만한 점은 세 가지예요:
- 주 추론과 검수를 분리하기: 연구 글에서는 같은 모델의 여러 복사본이 서로 교차 검증하는 방식을 썼는데, 여기에 더해 역할별로 다른 가격대의 모델을 선택하고 샘플로 검증 품질을 확인해 볼 수 있어요.
- 각 경로마다 중단 기준을 명확히 쓰기: 61번의 실패 시도가 보여주듯 실패는 일상이에요. 라운드 수, 비용, 진전 없음, 실패 횟수 모두 상한을 두어야 해요.
- 모델 표에 가격이 명시된 모델만 호출하기:
claude-fable-5-2,claude-sonnet-5-5,claude-haiku-5-5등 모델 ID와 단가를 코드에 적어 넣어야 비용을 예측하고 상한을 정할 수 있어요.
긴 작업의 성패는 개별 호출이 얼마나 똑똑한지에 달려 있는 게 아니라, 전체 흐름이 통제 가능한 예산 안에서 계속 진행되며 검증 가능한 결과를 남길 수 있는지에 달려 있어요. APIYI apiyi.com의 무료 테스트 한도로 먼저 작은 문제 하나를 끝까지 돌려 본 뒤, 중단 원인에 따라 파라미터를 조정하고 규모를 확장하는 것을 권장해요.
📚 참고 자료
-
Anthropic 연구 글: Claude Fable 5.2 멀티 에이전트가 블랙홀 물리 문제 두 개를 완수한 공식 설명
- 링크:
anthropic.com/research/claude-black-hole-physics - 설명: 에이전트 분담, 소요 시간, 검수 방식에 대한 1차 서술
- 링크:
-
프리프린트 논문 1: 연구 글과 연관된 프리프린트, 동료 심사 미완료
- 링크:
hexagonmath.org/2611.00175v1 - 설명: 결과 원문을 확인하고 싶은 독자에게 적합
- 링크:
-
프리프린트 논문 2: 연구 글과 연관된 또 다른 프리프린트, 동료 심사 미완료
- 링크:
hexagonmath.org/2611.00174v1 - 설명: 앞 논문과 대조해 읽기
- 링크:
-
Claude Fable 5.2 공식 모델 페이지: 모델 ID, 컨텍스트, 최대 출력, 공식 가격
- 링크:
platform.claude.com/docs/en/models/fable-5-2/overview - 설명: 모델 사양과 공식 가격 구간 확인
- 링크:
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 첫 페이지에서 문의해 주세요. 모델과 가격 설명은 docs.apiyi.com 문서 센터에서 확인할 수 있어요


