
Intégrer l’API d’un grand modèle de langage tiers en production : la vraie difficulté n’a jamais été l’instant où la première ligne de code tourne. Ce qui décide vraiment si le projet sera livré de façon stable, ce sont les problèmes du premier mois après la mise en ligne — ceux qu’on ne peut pas anticiper : une requête qui revient mais dans un format incorrect, un client qui expire alors que la plateforme a déjà facturé, le canal principal qui tombe et le repli qui bascule discrètement sur un modèle plus cher, ou un bilan à faire trois mois plus tard avec des logs déjà effacés.
Ce n’est pas un énième article du type « quelle plateforme d’API est la plus pratique » : on ne reprend pas ici les adjectifs des pages marketing des fournisseurs, et on ne classe aucune plateforme. On parle d’une seule chose, concrète et actionnable : avant la mise en ligne, quelles preuves vérifiables pouvez-vous produire pour juger si un service proxy API et une passerelle de grands modèles sont fiables ?
L’essentiel : à la fin de cet article, vous aurez en main une méthode de vérification composée d’une checklist de validation en 7 points et d’un tableau de conclusion, pour passer de « ça a l’air d’aller » à « c’est documenté et vérifiable ».
Le vocabulaire d’abord : comprendre ces 6 termes avant de parler de mise en production
Avant d’entrer dans les méthodes de recette, commençons par aligner les quelques termes qui reviennent sans arrêt. Leur usage varie souvent d’une documentation fournisseur à l’autre et d’un article technique à l’autre — et c’est précisément ce décalage de définition qui constitue un risque en soi au moment de la mise en production.
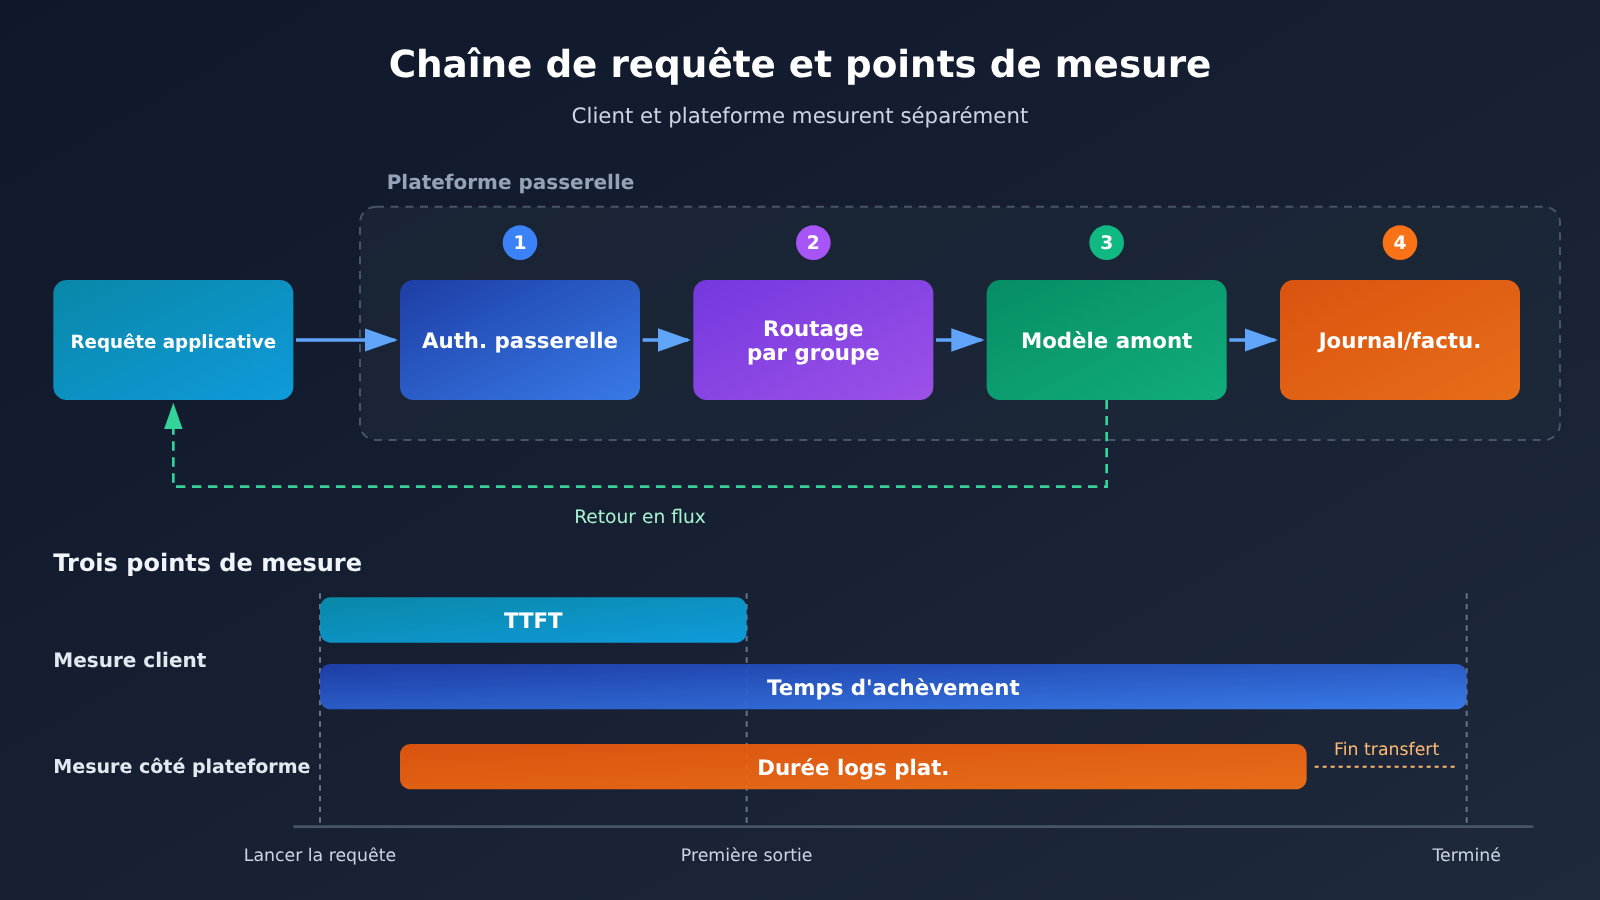
- Passerelle API : le point d’entrée qui reçoit les requêtes de l’application et les transmet au service de modèle en amont. Elle assume généralement quatre rôles à la fois — authentification, facturation, routage et journalisation —, si bien qu’un échec d’appel peut survenir à n’importe quel maillon de la chaîne. Il faut donc commencer par établir clairement à qui incombe la responsabilité.
- TTFT (temps jusqu’au premier token utile) : le délai entre l’envoi de la requête et l’arrivée du premier token de sortie utile. En interaction en streaming, c’est cette valeur que perçoit l’utilisateur, pas la durée totale de la réponse complète.
- p95 : la valeur que 95 % environ des échantillons ne dépassent pas. La moyenne masque les requêtes lentes ; seule la p95 fait apparaître cette petite minorité d’appels qui « bloquent parfois une dizaine de secondes ».
- RPM et concurrence : le RPM, c’est le nombre de requêtes lancées par minute ; la concurrence, c’est le nombre de requêtes encore en cours d’exécution au même instant. Plus une requête s’exécute longtemps, plus un RPM faible peut malgré tout générer une concurrence élevée en vol — d’où la nécessité de relever ces deux mesures séparément.
- Fallback (repli) : le mécanisme qui consiste à basculer vers un canal ou un modèle de secours lorsque le service principal ne peut pas satisfaire la requête. À la recette, il faut vérifier en même temps le modèle réellement utilisé, les fonctionnalités couvertes, le plafond de coût et la politique de données — et pas seulement se demander si la requête a abouti.
- SLA : le contrat de niveau de service, qui fixe la définition des indicateurs, le périmètre statistique, la responsabilité en cas d’incident et les conditions de compensation. C’est un engagement exécutable, pas un pourcentage qu’on peut citer isolément.
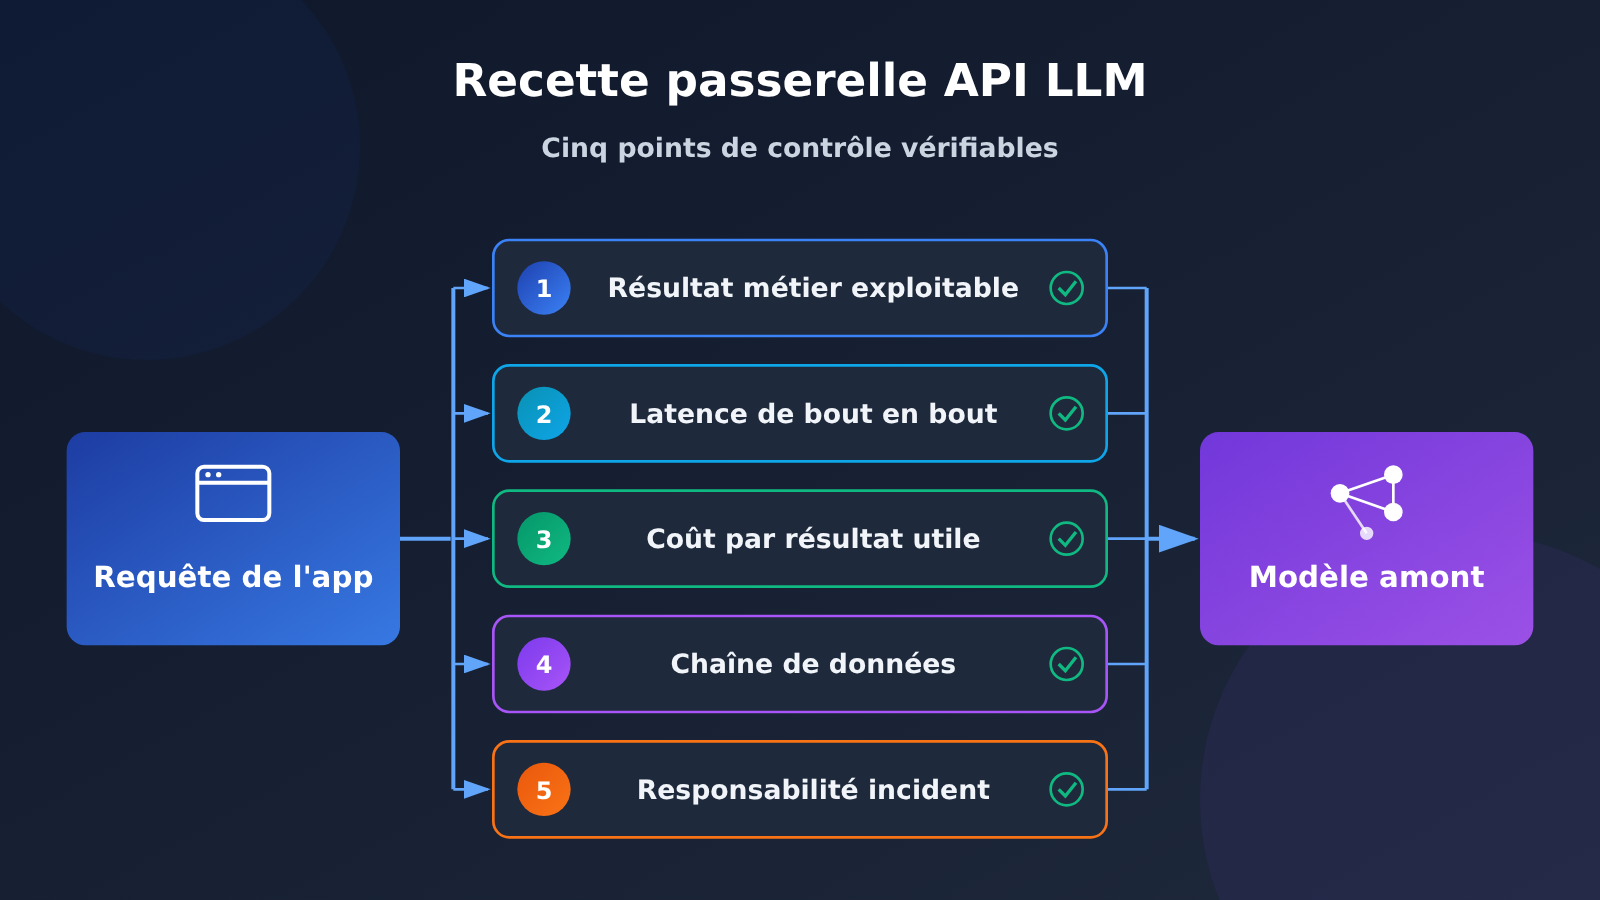
L’essentiel : la fiabilité d’une passerelle se décompose en 5 niveaux de vérification
La valeur d’un service proxy API pour grands modèles de langage et d’une passerelle, c’est l’interface unifiée. Mais ce confort d’un point d’entrée unique masque justement les différences qui se cachent dessous. Derrière une même base_url compatible OpenAI, on peut trouver des fournisseurs en amont totalement différents, des politiques de limitation de débit différentes, des règles de conservation des journaux différentes et des procédures de gestion des incidents différentes.
Le feu vert pour la mise en production ne peut donc pas se résumer à « est-ce que l’appel aboutit ? ». Il faut regarder trois choses en même temps : le résultat est-il exploitable, l’attente est-elle acceptable, l’anomalie est-elle traçable. Le tableau ci-dessous déploie ces trois points en 5 niveaux de vérification, qui forment aussi l’ossature des cinq sections qui suivent.
| Niveau de vérification | La question à trancher | Sur quoi se prononcer | Erreur d’appréciation fréquente |
|---|---|---|---|
| Résultat exploitable | Le contenu renvoyé peut-il entrer tel quel dans le processus métier | Nombre de retours complets, nombre de formats exploitables, nombre de validations métier réussies | Prendre un HTTP 200 pour un succès |
| Latence de bout en bout | Combien de temps l’utilisateur attend-il avant le premier fragment de sortie utile | p50 et p95 du TTFT et du temps de complétion, chronométrés séparément côté client et côté plateforme | Ne regarder que la durée moyenne |
| Coût par résultat exploitable | Combien coûte réellement chaque résultat utilisable | Total des dépenses réglées divisé par le nombre de résultats exploitables | Comparer seulement le prix unitaire, sans compter les reprises et les solutions de repli |
| Chaîne de données | Par qui les entrées et sorties transitent, combien de temps elles sont conservées, qui peut les consulter | Politiques par couche : passerelle, amont, journaux, artefacts asynchrones | Confondre chiffrement en transit et contenu illisible |
| Responsabilité en cas d’incident | Sur quelle base le problème est-il qualifié, et comment est-on dédommagé | Période de calcul du SLA, exclusions, procédure de réclamation et forme de compensation | Prendre une communication publique pour un engagement contractuel |
🎯 Conseil technique : recopiez ce tableau pour en faire la grille de recette de votre équipe, chaque ligne doit être renseignée avec la source de la preuve. S’il vous faut d’abord valider la chaîne d’appel de bout en bout, vous pouvez obtenir des crédits de test via APIYI apiyi.com, puis utiliser le même script pour consigner côte à côte les résultats de plusieurs modèles.
Pourquoi faire de la fiabilité un critère de recette métier
Une interface unifiée fait baisser le coût d’intégration, mais elle place aussi entre les mains des équipes applicatives un paquet de décisions qui relevaient jusque-là de l’infrastructure. Avant, il fallait maintenir soi-même sa logique de nouvelle tentative et jongler avec plusieurs SDK ; désormais, changer un base_url suffit pour appeler tout un tas de modèles — en contrepartie, votre visibilité sur la chaîne diminue.
La première étape de la recette n’est donc pas de mesurer les performances, mais de commencer par définir clairement ce que « disponible » signifie. Sur une même requête, trois choses distinctes se produisent : la plateforme facture avec succès, le client reçoit un 200, le métier parse sans erreur. Il faut les compter séparément. Un JSON structurellement invalide reste, côté métier, une production nulle — même si la plateforme a correctement traité la requête — et il est facturé quand même.
Deuxième étape : découper les jeux de test selon la forme du métier. Pour le questions-réponses interactif, on surveille la première sortie valide et le délai de réponse complète ; pour l’appel d’outils, la validité structurelle des paramètres et la présence de tous les champs ; pour le traitement par lots, combien de résultats exploitables on arrive à produire avant l’échéance de livraison. Fusionner ces trois catégories dans une « durée moyenne » ne peut donner qu’une conclusion faussée.
Troisième étape : aligner les conventions de chronométrage. Le temps d’attente côté client et la durée enregistrée dans les journaux de la plateforme ne couvrent pas les mêmes phases. La documentation officielle décrit d’ailleurs explicitement le cas où « la plateforme enregistre un succès et facture, alors que le client expire à cause du transfert de la réponse ou de la fermeture de la connexion ». Le fait que le backend tente automatiquement d’autres routes allonge lui aussi l’attente globale. Donc à chaque anomalie, il faut d’abord rapprocher l’enregistrement client, les journaux de la plateforme et la variation de solde à l’aide de l’identifiant métier et du request_id — et seulement ensuite décider s’il faut réessayer.
Comment tester les capacités d’une passerelle et sa charge de pointe avec des tâches fixes
Pour qu’un test soit reproductible, il faut d’abord figer les variables : version du modèle cible, canal ou groupe, interface d’appel, paramètres clés, point d’entrée réseau, volume d’entrée et de sortie, et mode de diffusion en flux ou non. Dès qu’un seul de ces éléments change, les données avant et après ne sont plus comparables. Les échantillons doivent provenir de données métier réelles, anonymisées, et pas d’entrées jouets du type « Bonjour ».
Le tableau ci-dessous est un modèle de fiche de recette que vous pouvez utiliser tel quel. Il s’agit de conseils de méthode, sans aucune conclusion issue de mesures sur une plateforme. Les seuils dépendent de vos besoins métier : par exemple, pour une tâche interactive, en combien de secondes le premier résultat exploitable doit arriver ; pour une tâche hors ligne, combien de résultats utilisables doivent être livrés en quelques heures.
| Dimension | À consigner | Méthode d’évaluation |
|---|---|---|
| Succès de livraison métier | Nombre total de requêtes, de réponses complètes, de réponses au format exploitable, de réponses validées par le métier | Écrire le dénominateur en entier, et regarder au final la proportion de résultats utilisables côté métier |
| Latence | Heure d’envoi, heure du premier résultat exploitable, heure de fin, durée relevée dans les logs de la plateforme | Chronométrer séparément côté client et côté plateforme, puis calculer p50 et p95 |
| Capacités clés | Fin correcte du flux, validité des paramètres d’outils, analyse des sorties structurées, traitement des entrées longues | Valider une à une les capacités dont votre produit dépend réellement |
| Charge de pointe | Nombre de requêtes simultanées en cours, requêtes par minute, taux de 429, mise en file d’attente et nouvelles tentatives | Garder un volume de requêtes identique, monter en charge par paliers et prévoir une fenêtre d’observation |
| Coûts | Montant débité par appel, remboursements, coûts de repli, nombre de résultats métier utilisables | Calculer le coût total supporté par chaque résultat utilisable |
| Facilité de diagnostic | Identifiant métier, request_id, modèle et groupe, code d’erreur, réponse du ticket | Pouvoir rattacher une commande anormale à l’enregistrement correspondant sur la plateforme |
Le script ci-dessous ne fait qu’une seule chose : en appel en flux, il enregistre à la fois le délai du premier résultat exploitable et la durée totale, pour vous permettre de comparer le chronométrage client et les logs de la plateforme sur une même ligne de temps.
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée d'APIYI
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话说明什么是 API 网关"}],
    stream=True,
)
ttft = None
for chunk in stream:
    delta = chunk.choices[0].delta.content
    if delta and ttft is None:
        ttft = time.perf_counter() - start
total = time.perf_counter() - start
print(f"TTFT {ttft:.3f}s / total {total:.3f}s")
Afficher le code de test de charge par lots et de calcul des percentiles
import statistics
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI
)

def one_call(prompt: str) -> dict:
    start = time.perf_counter()
    ok, ttft = False, None
    try:
        stream = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user", "content": prompt}],
            stream=True,
        )
        for chunk in stream:
            delta = chunk.choices[0].delta.content
            if delta and ttft is None:
                ttft = time.perf_counter() - start
        ok = True
    except Exception as exc:
        return {"ok": False, "ttft": None,
                "total": time.perf_counter() - start, "err": type(exc).__name__}
    return {"ok": ok, "ttft": ttft,
            "total": time.perf_counter() - start, "err": None}

def summarize(rows: list) -> None:
    done = [r for r in rows if r["ok"]]
    totals = sorted(r["total"] for r in done)
    print(f"成功率 {len(done)}/{len(rows)}")
    if totals:
        print(f"p50 {statistics.median(totals):.3f}s")
        print(f"p95 {totals[int(len(totals) * 0.95) - 1]:.3f}s")

rows = [one_call("把下面这句话翻译成英文:请检查订单状态。") for _ in range(50)]
summarize(rows)
L’erreur la plus courante en test de charge, c’est de confondre le RPM et la concurrence. Le nombre de requêtes par minute, le nombre de tokens par minute et le nombre de requêtes simultanément en vol décrivent trois contraintes distinctes, et aucune ne remplace les autres. Et quand la latence grimpe, les retries viennent encore alourdir la pression sur le système : le script doit donc embarquer une file d’attente locale, un temps d’attente maximal et des retries avec backoff plafonné.
Il y a aussi un détail facile à négliger : dans la documentation APIYI, la page « Concurrence » et la page « Jetons et groupes » ne formulent pas exactement de la même manière la portée de la limitation de débit. La première évoque des quotas indépendants pour plusieurs jetons, la seconde précise que la limite suit le compte. Pour la recette, la bonne approche consiste donc à mesurer les quotas réels avec votre propre compte cible et votre propre canal cible, en relevant séparément la concurrence et le RPM — sans reprendre les chiffres figés des captures d’écran de quelqu’un d’autre, et sans chercher à contourner la limite en multipliant les clés.
Comment vérifier le coût par résultat exploitable et le comportement de repli
Plus que le prix unitaire, ce qui vaut la peine d’être comparé, c’est le « coût réel par résultat exploitable côté métier ». Le calcul est simple : au numérateur, toutes les dépenses réglées (retries et replis compris) ; au dénominateur, le nombre de résultats exploitables côté métier. Les remboursements confirmés sont déduits du numérateur.
Voici un exemple purement hypothétique, qui sert uniquement à illustrer l’algorithme et ne reflète les prix d’aucun fournisseur.
| Solution | Dépenses nettes réglées | Résultats exploitables | Coût par résultat exploitable |
|---|---|---|---|
| Solution A | 3,0 dollars | 90 | environ 0,0333 dollar |
| Solution B | 3,2 dollars | 98 | environ 0,0327 dollar |
Si l’on ne regarde que la dépense, la solution A est la moins chère ; si l’on raisonne en résultats exploitables, c’est la solution B qui s’avère plus avantageuse. C’est pourquoi la question « qui est le moins cher ? » n’a pas de sens sans dénominateur métier. Deux autres points à garder en tête : le quota prélevé d’avance mais pas encore réglé pour les tâches asynchrones doit être indiqué à part ; et si vous ne cumulez que les enregistrements de consommation, vous risquez de surestimer la dépense nette, car les remboursements des tâches asynchrones apparaissent sur la facture sous forme de montants négatifs.
Pour le repli, il faut distinguer deux changements totalement différents. Le changement de canal consiste à passer par une autre route avec le même modèle : les capacités du modèle et le prix restent, en théorie, identiques. Le changement de modèle, lui, consiste à essayer d’autres modèles d’une liste lorsque le modèle principal est indisponible. C’est un mécanisme courant dans le secteur : les model fallbacks d’OpenRouter, par exemple, précisent que la facturation se fait au prix du modèle effectivement utilisé, et que le modèle final est indiqué dans le champ model de la réponse. Cet exemple ne sert qu’à illustrer le mécanisme ; la signification des champs ne se transpose pas telle quelle à une autre plateforme.
Les critères de recette doivent donc couvrir au minimum quatre points : quel est le modèle final après repli, les fonctionnalités essentielles sont-elles toujours assurées, le coût d’un appel est-il plafonné, et quel est le temps d’attente maximal. Si, pour certains cas d’usage, le changement de modèle est inacceptable, vérifiez aussi qu’on peut désactiver le repli. Le streaming demande un test à part : lorsqu’une panne survient après qu’une partie de la sortie a déjà été renvoyée, la reprise se fait-elle sans rupture ? On ne peut pas le déduire d’un repli réussi en mode non streaming.
💡 Conseil : mettez le prix en appel direct et le chemin de repli dans un même tableau pour voir le coût réel. Pour récupérer rapidement des relevés de facturation de plusieurs modèles et les comparer, vous pouvez lancer un petit échantillon via APIYI (apiyi.com), puis refaire le calcul dans votre propre grille de recette.
Comment vérifier la chaîne de données et la responsabilité en cas d’incident
Ces deux points sont les plus faciles à expédier d’un « nous sommes sécurisés » ou d’un « nous sommes stables » — et pourtant, ce sont exactement les seules choses qui vous sauveront une fois l’incident survenu. La méthode : aligner passerelle, fournisseur de modèle en amont, journaux de dépannage détaillés et résultats asynchrones sur une même chaîne de données, puis interroger la politique de chaque maillon, couche par couche.
| Étape de la chaîne | Politique à vérifier | Comment vérifier |
|---|---|---|
| La passerelle elle-même | Les entrées/sorties sont-elles conservées par défaut, qui peut activer les journaux de dépannage, combien de temps sont-ils gardés | Lire la documentation officielle sur la sécurité des données et les journaux |
| Le fournisseur de modèle en amont | Usage pour l’entraînement, durée de conservation, autorisation explicite requise ou non | Lire les politiques de chaque fournisseur en amont séparément, sans les fondre en une seule |
| Journaux de dépannage détaillés | Périmètre enregistré, personnes ayant accès, durée de conservation par défaut, moment de suppression après désactivation | Vérifier que couper l’interrupteur ne revient pas à supprimer immédiatement les enregistrements déjà présents |
| Résultats des tâches asynchrones | Emplacement de stockage des résultats, durée de validité des liens de téléchargement | Sauvegarder côté métier sans traîner, ne pas dépendre de liens temporaires |
D’après la documentation publique, la politique habituelle d’APIYI est de ne pas conserver par défaut les entrées et sorties des clients ; les journaux de dépannage détaillés peuvent être activés temporairement par un administrateur pour enregistrer l’entrée complète, le contexte et la sortie, le contenu n’étant visible que par l’administrateur, avec une durée de conservation par défaut annoncée de 7 à 30 jours sur la page. Cette même page précise aussi que l’action de désactiver l’enregistrement ne peut pas être interprétée comme une suppression immédiate des enregistrements existants. Ce genre de formulation doit rester attribué à « la documentation officielle » : ce n’est ni une certification de conformité, ni une conclusion juridique.
Il y a un autre fait opérationnel souvent négligé : les journaux ont eux-mêmes un cycle de vie. La note dédiée à la conservation des journaux chez APIYI indique que les journaux d’appel sont conservés en flux glissant sur environ deux mois, avec suppression les 5, 15 et 25 de chaque mois des enregistrements antérieurs de plus de deux mois — un nettoyage irréversible. Les détails nécessaires à la réconciliation et à l’audit sur longue période doivent donc être exportés et conservés par vos soins. La durée de stockage des résultats synchrones et des résultats asynchrones diffère encore : la page annonce une validité d’environ un jour pour les liens de téléchargement des résultats. Passé cette fenêtre, vous n’avez plus de preuve en main pour faire le point.
La responsabilité en cas d’incident doit, elle, descendre au niveau de clauses exécutables. La page SLA dédiée d’APIYI décrit le réapprovisionnement en crédits lorsque la perte est imputable à la plateforme, ainsi que la possibilité pour une entreprise de contractualiser le périmètre de garantie, les indicateurs de disponibilité, les délais de réponse et le plafond d’indemnisation. Cette page ne donne pas à tous les clients un taux de disponibilité fixe et uniforme. Lorsque vous comparez des fournisseurs, notez la période de calcul des indicateurs, la définition du dénominateur, les exclusions de panne, la procédure de réclamation et la forme de la compensation — et distinguez clairement, dans la valeur d’achat, un crédit de service d’une indemnisation en numéraire.
Décider du périmètre de mise en production avec une seule grille d’acceptation
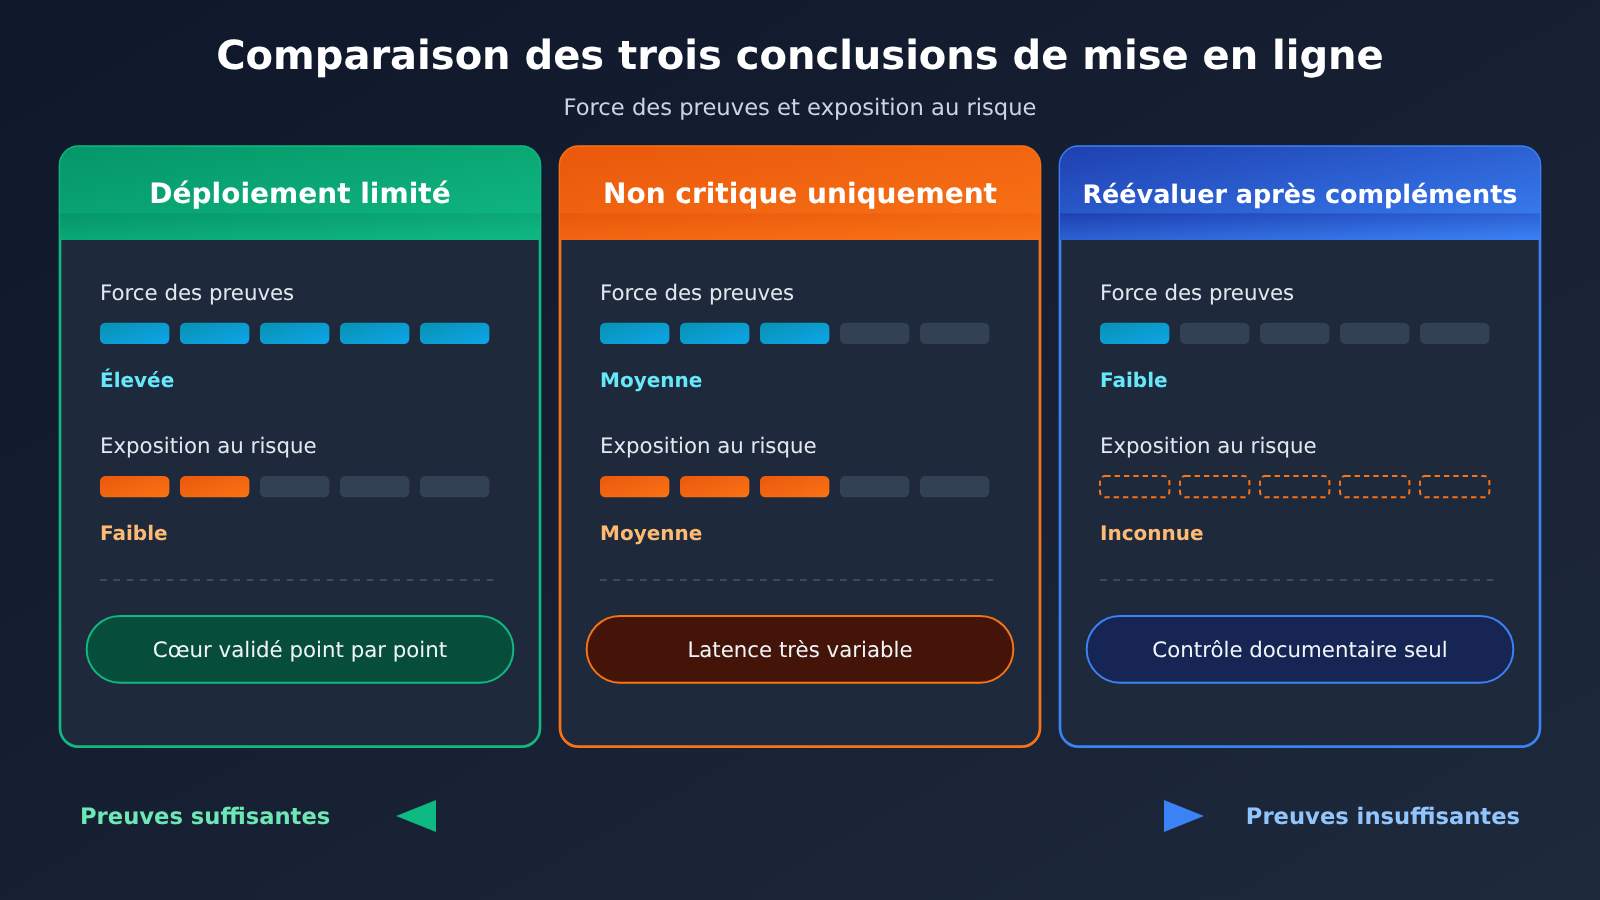
Quand il s’agit de transformer tous les relevés en conclusion, ne cherchez pas à produire un « classement de fiabilité » : ce qu’il faut, c’est un jugement de périmètre. Un même fournisseur peut très bien ne suffire que pour des « tâches non critiques » dans vos activités interactives, et convenir parfaitement à vos traitements par lots hors ligne.
| Conclusion | Preuves à fournir | Conditions de bascule ou d’arrêt |
|---|---|---|
| Mise en production sur un périmètre limité | Chaque capacité clé validée point par point, p95 sous le seuil métier, coût par résultat exploitable acceptable, chaîne de données et SLA vérifiés | Le taux de disponibilité métier passe sous le seuil de façon répétée, ou des anomalies de facturation impossibles à réconcilier |
| Usage réservé aux tâches non critiques | Capacités validées mais latence très variable, ou le repli change de modèle et de coût | Le chemin critique repasse en interne ou en direct, et la stratégie de repli est explicitement désactivée |
| Réévaluation une fois les conditions réunies | Vérification documentaire uniquement, absence de mesures réelles sur votre propre compte, ou clauses de SLA non inscrites au contrat | Nouvelle conclusion après obtention des mesures réelles et des clauses contractuelles |
Si vous ne pouvez pour l’instant faire qu’une vérification documentaire, écrivez la conclusion telle quelle : « capacités publiques et conditions d’achat vérifiées », et renvoyez l’acceptation réelle à la prochaine itération. Pour vérifier le comportement en cas d’incident, utilisez la configuration de test ou l’environnement isolé autorisé par le fournisseur, sans perturber un service partagé en production ; en cas de dépassement de délai au résultat incertain, vérifiez d’abord l’exécution et la facturation, histoire de ne pas rejouer deux fois la même action métier.
🚀 Démarrage rapide : si vous n’avez pas envie de monter un script de test de zéro, commencez par dérouler les colonnes « capacités » et « latence » de la liste des 7 points ci-dessus avec le crédit d’essai gratuit d’APIYI (apiyi.com), puis voyez si vous passez à une phase de test de charge plus lourde.
FAQ : questions fréquentes
Q1 : Au juste, qu’est-ce qu’un service proxy API pour grands modèles et une passerelle (gateway) ?
C’est la couche d’entrée placée entre votre application et les services de modèles en amont : elle reçoit la requête puis se charge de l’authentification, de la facturation, du routage et de la journalisation. Le mot « proxy » souligne surtout qu’elle fait converger plusieurs fournisseurs vers une interface compatible : vous gagnez en simplicité d’intégration, vous perdez en visibilité sur la chaîne sous-jacente.
Q2 : En matière de fiabilité, qu’est-ce qui distingue un appel direct à l’API officielle d’un passage par une passerelle ?
Le nombre de maillons dans la chaîne et la répartition des responsabilités. En direct, un seul fournisseur amont est à surveiller ; via une passerelle, la passerelle elle-même, le canal du groupe et le fournisseur amont peuvent chacun devenir un point de défaillance — mais vous gagnez en contrepartie une couche de repli et la possibilité d’un journal unifié. La bonne méthode n’est pas de comparer les vitesses, mais de réunir des preuves sur les 5 axes décrits dans cet article, séparément.
Q3 : Pourquoi ne pas se contenter de la latence moyenne ?
Parce qu’une moyenne masque la poignée de requêtes très lentes — et ce sont précisément celles qui déclenchent les réclamations des utilisateurs. En mode streaming, il faut aussi compter séparément le TTFT et le temps de complétion total, en précisant la taille de l’échantillon, la fenêtre temporelle, et si les échecs, la mise en file et les nouvelles tentatives sont inclus. Sans cela, même le p95 n’est pas comparable.
Q4 : Une requête réussie mais dont le contenu est inexploitable, est-ce un problème de la plateforme ?
En général non, mais le coût, lui, compte. Dès lors que la plateforme a traité la requête normalement, elle facture ; une sortie structurellement invalide relève des nouvelles tentatives côté métier, et cette dépense répétée doit figurer au numérateur du « coût par résultat exploitable ». C’est pourquoi votre tableau de recette doit comporter deux colonnes distinctes : succès d’exécution côté plateforme, et validation côté métier.
Q5 : Comment vérifier rapidement qu’une passerelle peut supporter mon activité ?
Prenez vos propres échantillons anonymisés, figez le modèle, le canal, les paramètres et le volume d’entrée, puis lancez une petite série de tests en relevant le TTFT, le p95, la part de résultats exploitables côté métier et le détail de la facturation. Vous pouvez obtenir un crédit de test via APIYI apiyi.com pour boucler cette première manche, puis reporter les données dans le tableau de recette — plutôt que de conclure sur un simple test de connectivité.
Q6 : Quelles sont les limites connues de cette méthode ?
Sur un petit échantillon, le p95 varie beaucoup et ne peut pas servir d’engagement de service à long terme ; les écarts de charge côté amont selon les plages horaires influencent aussi les conclusions, d’où la nécessité de répéter à plusieurs moments de la journée. Enfin, tous les modes de calcul présentés ici sont des recommandations méthodologiques : ils ne contiennent aucune donnée de performance mesurée ni aucune facture réelle d’une plateforme quelconque. Le jugement final reste à construire à partir de vos propres seuils métier et des clauses de votre contrat.
Points clés à retenir pour une passerelle proxy d’API de grands modèles de langage
- La fiabilité se définit par les critères d’acceptation métier : la facturation réussie côté plateforme, le code 200 reçu par le client et le parsing réussi côté application sont trois choses à compter séparément.
- La latence se mesure en deux points : le TTFT détermine l’expérience interactive, le temps de complétion totale détermine la capacité de livraison — et dans les deux cas, il faut regarder le p95.
- RPM et concurrence doivent être suivis séparément : un RPM faible peut malgré tout produire une forte concurrence en vol ; le débit réellement autorisé doit se mesurer par des tests sur le compte cible.
- Le coût se calcule par résultat exploitable : l’ensemble des dépenses réglées divisé par le nombre de résultats métier exploitables, avec les tentatives de reprise et les dispositifs de repli inclus dans le numérateur.
- Le repli doit distinguer changement de canal et changement de modèle : modèle final, fonctionnalités clés, plafond de coût, attente maximale — quatre points à valider un par un.
- Données et responsabilités : ne regardez que les clauses réellement applicables : les logs ont une fenêtre de conservation, et un SLA doit préciser sa méthode de calcul, ses exclusions et la forme de la compensation.
- Chemin d’entrée : commencez par un petit échantillon sur APIYI apiyi.com pour valider les deux colonnes capacité et latence, puis passez aux tests de charge et à la vérification du contrat.
En résumé
Déterminer si un service proxy API et une passerelle de grands modèles de langage sont fiables est avant tout un travail de collecte de preuves, pas une affaire d’impression. En décomposant « est-ce que ça marche » en cinq niveaux — résultats métier exploitables, latence de bout en bout, coût par résultat exploitable, chaîne de traitement des données et responsabilité en cas d’incident — et en conservant pour chacun une trace vérifiable, vous transformez d’avance la plupart des mauvaises surprises en points connus avant la mise en production.
Trois règles pour la mise en production : ne formulez que des conclusions sur un périmètre, jamais un classement ; ne consignez que vos propres mesures, pas celles d’une capture d’écran trouvée ailleurs ; ne documentez que des preuves reproductibles, car les logs finissent par expirer. Avec ces trois réflexes, le débat de sélection ne dépend plus de qui parle le plus fort.
Nous recommandons de passer d’abord par une première passe d’acceptation sur petit échantillon via APIYI apiyi.com : la plateforme propose une interface unifiée et un quota de test gratuit, ce qui permet de comparer plusieurs modèles dans un même tableau.
Un sujet qui revient à chaque incident
Dès qu’un client signale un écart entre ce qu’il voit dans ses journaux et ce qu’il a réellement reçu, la discussion part souvent dans trois directions à la fois : la facturation, la conservation des traces, et la responsabilité en cas de panne. Ce guide rassemble les points à vérifier dans l’ordre, en s’appuyant sur la documentation APIYI et, pour la partie routage, sur les pratiques décrites par OpenRouter.
L’idée directrice est simple : une requête peut très bien être facturée côté plateforme sans que le client n’ait jamais vu la réponse. Tant qu’on ne distingue pas ces deux chaînes — la chaîne de traitement et la chaîne de livraison — on cherche au mauvais endroit.
1. Clés, quotas et groupes de ressources
Avant même de parler d’argent, il faut savoir quelle clé a servi. Un compte APIYI peut contenir plusieurs clés, chacune avec son propre quota, rattachée à un groupe de ressources précis. La documentation sur les jetons et les groupes (docs.apiyi.com/faq/token-and-groups) décrit également un mécanisme de groupe de secours : quand le canal principal d’un groupe n’est plus disponible, la requête peut être servie ailleurs.
Conséquence pratique pour le support : deux clés du même compte peuvent produire des résultats différents sur la même invite, sans qu’aucune n’ait de bug. Vérifiez systématiquement la clé, puis le groupe, avant de conclure à une régression du modèle.
2. Ce que les journaux conservent, et pour combien de temps
Les journaux ne sont pas éternels. La politique de rétention et de nettoyage (docs.apiyi.com/faq/log-retention-policy) précise que les entrées défilent et sont purgées au bout d’une certaine fenêtre. Autrement dit : si vous avez besoin des détails pour un rapprochement comptable ou un audit, il faut les exporter vous-même, en amont.
C’est un point à cadrer dès la mise en production. Une équipe qui attend la fin du mois pour reconstituer sa consommation à partir des journaux de la plateforme court un risque réel de trous dans les données.
3. Journaux détaillés : à activer seulement quand ça casse
À côté des journaux standards existent des journaux détaillés, dont l’étendue et la durée de conservation sont décrites dans docs.apiyi.com/faq/user-logs-control. Ils répondent à la question « qu’est-ce qui a traversé la chaîne de traitement ? », pas à la question « qu’est-ce que le client a affiché ? ».
La bonne habitude : les activer pendant une fenêtre de dépannage, puis les désactiver. Les laisser allumés en permanence alourdit inutilement la surface de données personnelles à gouverner.
4. Sécurité des données : le comportement par défaut
La politique par défaut d’APIYI, documentée dans docs.apiyi.com/faq/data-security, est de ne pas conserver les entrées et les sorties des requêtes. C’est le point de départ, et c’est aussi celui qu’il faut citer à vos propres clients quand ils remplissent un questionnaire de conformité.
Mais lisez-la en couches : la politique d’APIYI ne dit rien de ce que fait le fournisseur du modèle en amont. Si votre cas d’usage impose des garanties fortes, il faut empiler les deux politiques — plateforme d’accès d’un côté, fournisseur du modèle de l’autre — et vérifier qu’elles sont compatibles.
5. SLA : ce qui est réellement couvert
La page docs.apiyi.com/faq/sla-guarantee décrit un mécanisme de réémission de quota en cas de défaillance, encadré par des conditions contractuelles. Deux choses à retenir :
- la compensation prend la forme d’un crédit, pas d’un remboursement ;
- elle s’applique dans le périmètre défini au contrat, pas à toute déviation imaginable.
Une indisponibilité de trois secondes sur une requête n’ouvre pas les mêmes droits qu’une panne de deux heures. Clarifiez ce périmètre avant de promettre quoi que ce soit à vos propres utilisateurs.
6. Lire correctement un montant facturé
Une ligne de journal avec un montant n’est pas une ligne de facture. docs.apiyi.com/faq/log-billing-explained détaille les champs et les coefficients appliqués (les « multiplicateurs » liés au modèle ou au canal). C’est ce document qui permet de calculer le coût réel par résultat exploitable, et non par requête envoyée.
La nuance compte : si vous envoyez dix requêtes et n’en exploitez que six, le coût unitaire pertinent est celui des six, pas des dix. C’est souvent là que se cache l’écart entre le budget prévu et la facture observée.
7. Le cas d’école : journal clôturé, client sans réponse
docs.apiyi.com/faq/log-duration-vs-client-wait traite précisément de ce scénario, et c’est le document à lire en premier lors d’un litige. Le raisonnement :
- La plateforme traite la requête, la termine, et la facture.
- Le client, lui, a un délai d’attente (timeout) plus court que le temps de traitement. Il ferme la connexion.
- Résultat : la ligne de journal est complète et facturée, côté client il n’y a rien à afficher.
Ce n’est ni une double facturation ni une perte de données — c’est un décalage entre deux horloges qui ne mesurent pas la même chose. La correction se fait côté client : augmenter le timeout, ou passer en flux (streaming) pour que les premiers octets arrivent avant l’expiration.
8. Basculer de fournisseur n’est pas basculer de modèle
Attention à une confusion fréquente. La sélection de fournisseur (openrouter.ai/docs/guides/routing/provider-selection) et le basculement de modèle sont deux mécanismes distincts :
| Sélection de fournisseur | Basculement de modèle | |
|---|---|---|
| Ce qui change | qui exécute le même modèle | quel modèle exécute |
| Impact sur la sortie | généralement nul | peut être significatif |
| Cas typique | un hôte saturé ou en panne | modèle indisponible ou trop cher |
Une panne d’hôte se règle par le premier mécanisme, sans toucher à la qualité de la réponse. Un basculement de modèle, lui, change le comportement — et donc le prix.
9. Modèles de secours : qui est facturé ?
openrouter.ai/docs/guides/routing/model-fallbacks décrit la pratique du secteur : quand une chaîne de repli s’active, la facturation suit le modèle qui a effectivement servi la requête, pas celui qui était demandé en premier. Les plateformes sérieuses exposent d’ailleurs le modèle final dans la réponse ou dans les métadonnées.
D’où une recommandation concrète : journalisez toujours le modèle réellement utilisé, pas seulement celui demandé. Sans ce champ, vous ne pourrez pas expliquer un écart de coût le jour où une chaîne de secours s’active discrètement.
Check-list avant de clore un incident
- Quelle clé, quel groupe, quel canal a traité la requête ?
- Le journal est-il encore dans la fenêtre de rétention, ou faut-il se rabattre sur vos propres exports ?
- Le client a-t-il expiré avant la fin du traitement ?
- Le montant observé inclut-il le bon multiplicateur ?
- Un modèle de secours a-t-il pris le relais, et à quel prix ?
- Le cas entre-t-il dans le périmètre du SLA, ou relève-t-il du contrat ?
Cette séquence, appliquée dans l’ordre, élimine la majorité des faux litiges en quelques minutes.
Références
-
Jetons et groupes APIYI — clés multiples, quotas, groupes de ressources et groupe de secours
docs.apiyi.com/faq/token-and-groups -
Politique de rétention et de nettoyage des journaux — roulement, conservation et export
docs.apiyi.com/faq/log-retention-policy -
Journaux détaillés — périmètre d’activation et durée de conservation pour le dépannage
docs.apiyi.com/faq/user-logs-control -
Sécurité des données — politique par défaut de non-conservation des entrées/sorties
docs.apiyi.com/faq/data-security -
Garantie SLA — réémission de quota et périmètre contractuel
docs.apiyi.com/faq/sla-guarantee -
Comprendre le montant facturé dans les journaux — champs de facturation et coefficients
docs.apiyi.com/faq/log-billing-explained -
Journal clôturé et facturé, mais aucune réponse côté client — timeout client vs temps de traitement
docs.apiyi.com/faq/log-duration-vs-client-wait -
OpenRouter — sélection de fournisseur — comprendre la différence entre basculement de canal et basculement de modèle
openrouter.ai/docs/guides/routing/provider-selection -
OpenRouter — modèles de secours — chaînes de repli et attribution de la facturation
openrouter.ai/docs/guides/routing/model-fallbacks
Auteur : l’équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI sur apiyi.com ; la documentation complète est sur docs.apiyi.com.


