
Подключить сторонний API большой языковой модели к продакшену — и главная сложность тут вовсе не тот момент, когда заработала первая строка кода. Судьбу проекта решают проблемы первого месяца после запуска, которые заранее не разглядеть: запрос вернулся, но формат не тот; клиент упал по таймауту, а платформа уже списала деньги; основной канал лёг, и фолбэк тихо подменил модель на более дорогую; через три месяца садишься разбирать инцидент — а логи уже вычищены.
Это не очередная подборка «у какого провайдера API удобнее», здесь нет пересказа прилагательных с рекламных страниц вендоров и нет рейтинга платформ. Разберём одну вещь, которую можно сделать руками: какие проверяемые доказательства вы способны собрать до запуска, чтобы понять, можно ли полагаться на сервис-прокси API и шлюз для больших языковых моделей.
Что вы получите: дочитав до конца, вы получите методику сверки — чек-лист приёмки из 7 пунктов и одну сводную таблицу, — которая превращает «вроде работает» в «есть чем подтвердить».
Сначала термины: разберём 6 понятий, прежде чем выходить в продакшен
Прежде чем обсуждать методику приёмки, давайте договоримся о значении нескольких терминов, которые постоянно встречаются дальше. В документации поставщиков и в технических статьях их употребляют по-разному, а расхождение в трактовках само по себе уже риск для запуска.
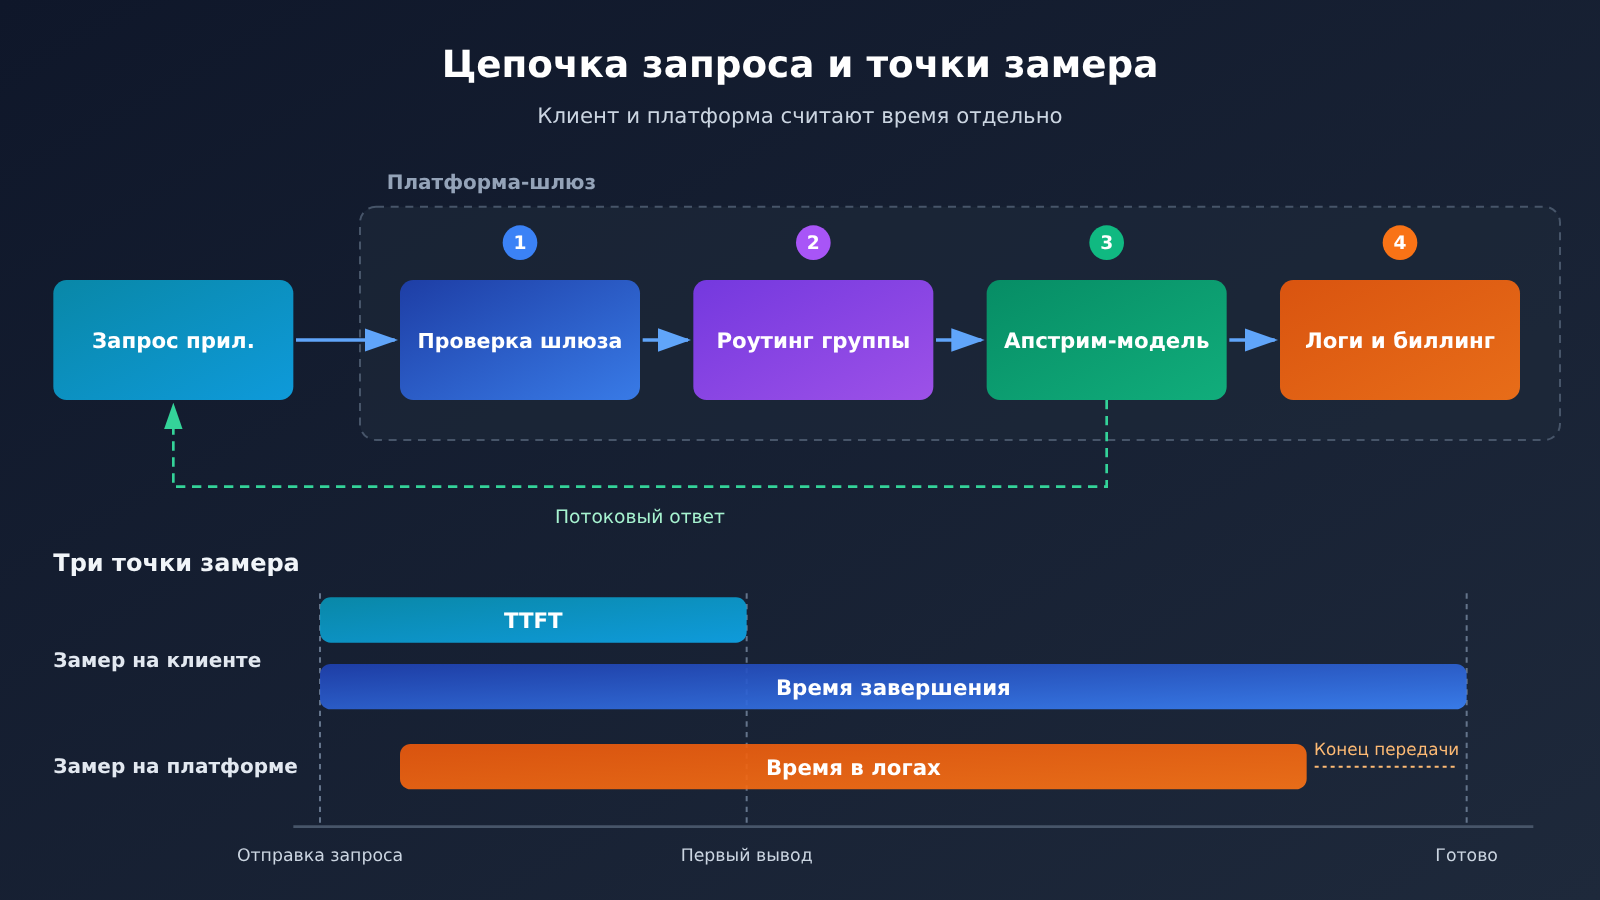
- API-шлюз: точка входа, которая принимает запросы приложения и передаёт их вышестоящему сервису модели. Обычно он одновременно отвечает за аутентификацию, тарификацию, маршрутизацию и логирование, поэтому сбой вызова может произойти на любом звене цепочки. Поэтому сначала нужно чётко определить, кто за какое звено отвечает.
- TTFT (Time To First Token, время до первого значимого вывода): время от отправки запроса до прихода первого полезного выходного токена. В потоковом режиме пользователь замечает именно это значение, а не общее время генерации всего ответа.
- p95: значение метрики, которое не превышают примерно 95% запросов. Среднее скрывает медленные запросы, и только p95 показывает ту небольшую долю вызовов, которые «иногда зависают секунд на пятнадцать».
- RPM и параллелизм: RPM — это число запросов, отправленных за минуту, а параллелизм — число запросов, которые выполняются в один и тот же момент. Чем дольше выполняется запрос, тем больше запросов «висит в полёте» даже при низком RPM, поэтому эти два показателя нужно фиксировать отдельно.
- Fallback (резервный механизм): схема, при которой, если основной сервис не может обработать запрос, система пробует запасной канал или другую модель. При приёмке нужно проверять сразу несколько вещей: итоговую модель, работоспособность ключевых функций, лимит расходов и политику обработки данных. Одного лишь факта, что запрос прошёл успешно, недостаточно.
- SLA (соглашение об уровне сервиса): документ, который фиксирует методику расчёта метрик, область измерений, ответственность за сбои и условия компенсации. Это исполнимое соглашение, а не отдельный процент, на который можно сослаться в разговоре.
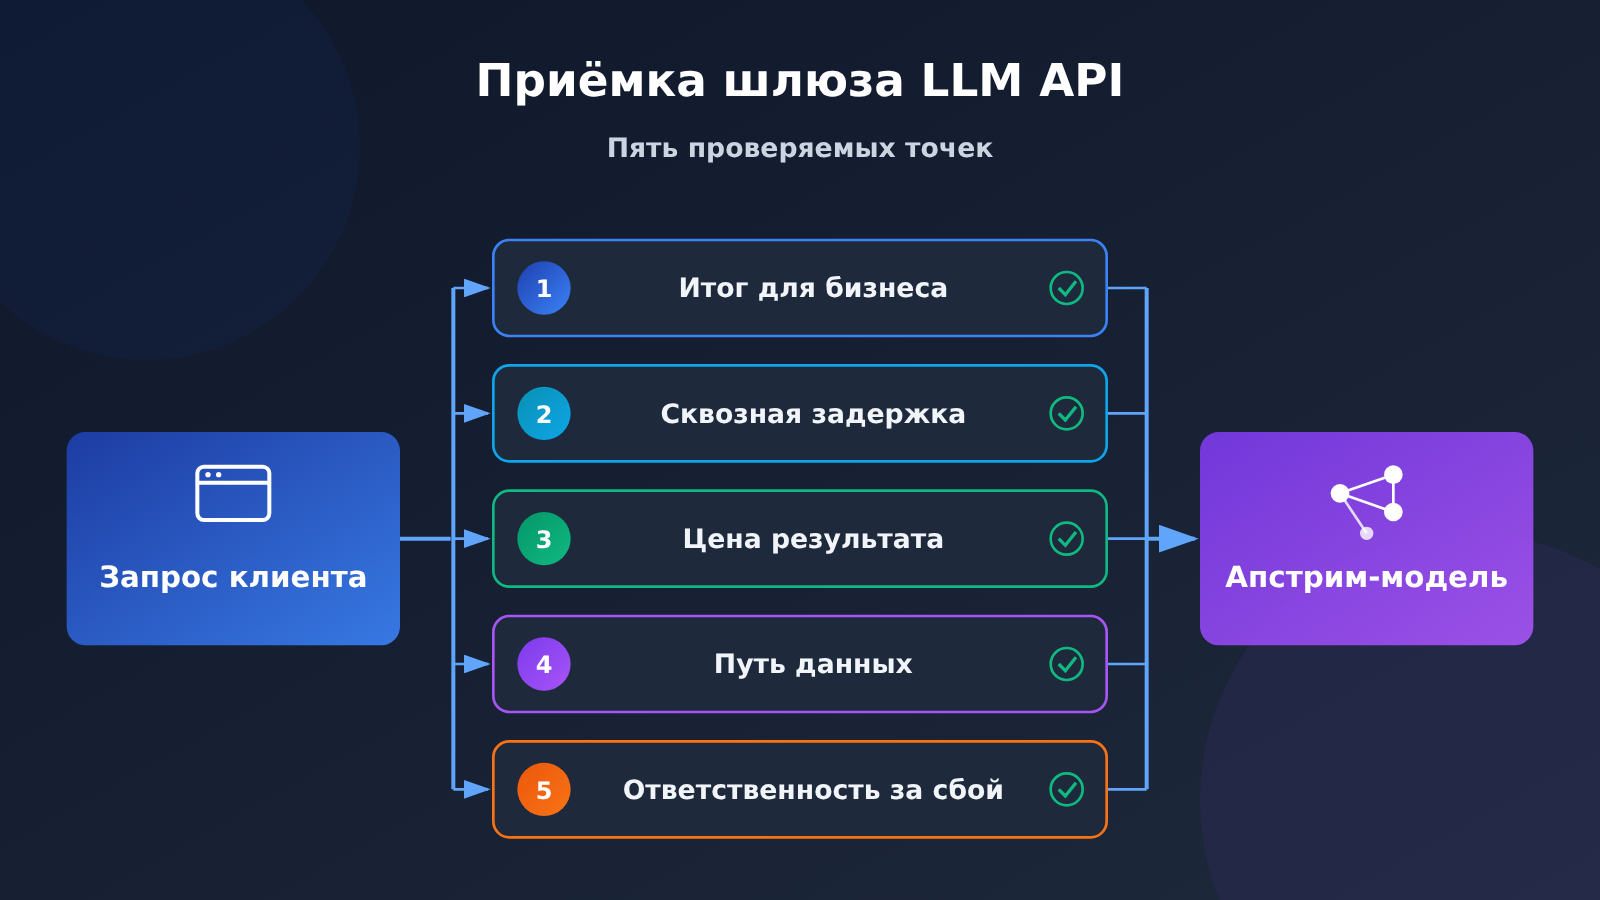
Ключевая идея: надёжность шлюза нужно проверять по 5 слоям
Ценность прокси-сервисов и шлюзов для API больших языковых моделей — в едином интерфейсе. Но удобство единого интерфейса как раз маскирует различия на нижних уровнях. За OpenAI-совместимым base_url могут скрываться совершенно разные upstream-поставщики, разные политики лимитов, разные правила хранения логов и разные процедуры обработки сбоев.
Поэтому решение о запуске в продакшен нельзя сводить к вопросу «получается ли вообще вызвать». Нужно смотреть сразу на три вещи: можно ли использовать результат, приемлемо ли ожидание и можно ли отследить аварийные ситуации. В таблице ниже эти три вещи развёрнуты в 5 слоёв проверки — на них же построены следующие пять разделов статьи.
| Слой проверки | На какой вопрос отвечает | На что опираться | Типичная ошибка в оценке |
|---|---|---|---|
| Бизнес-пригодный результат | Можно ли сразу пустить ответ в бизнес-процесс | Число полных ответов, число ответов в годном формате, число ответов, прошедших бизнес-проверку | Считать успехом любой HTTP 200 |
| Сквозная задержка | Сколько пользователь ждёт, прежде чем увидит первый осмысленный фрагмент | p50 и p95 для TTFT и времени завершения, отдельные замеры на клиенте и на платформе | Смотреть только на среднее время |
| Стоимость пригодного результата | Сколько реально стоит каждый годный результат | Все оплаченные расходы, делённые на число бизнес-пригодных результатов | Сравнивать только цену за единицу, не учитывая ретраи и резервные маршруты |
| Цепочка данных | Через чьи руки проходят вход и выход, как долго хранятся и кто может их видеть | Многоуровневые политики шлюза, upstream, логов и асинхронных артефактов | Думать, что шифрование при передаче делает содержимое нечитаемым |
| Ответственность за сбои | По каким критериям фиксируется инцидент и как выплачивается компенсация | Период учёта SLA, исключения, порядок подачи заявки, форма компенсации | Принимать публичное описание за договорное обязательство |
🎯 Совет от практиков: скопируйте эту таблицу в приёмочный чек-лист своей команды — по каждой строке должен быть указан источник доказательств. Если сначала нужно просто запустить цепочку вызовов, получите тестовый баланс на APIYI (apiyi.com) и прогоните один и тот же скрипт на нескольких моделях, чтобы сравнить результаты.
Почему надёжность нужно закрепить как бизнес-критерий приёмки
Единый интерфейс снижает стоимость интеграции, но заодно перекладывает на прикладную команду ряд решений, которые раньше относились к инфраструктуре. Раньше вы сами поддерживали логику повторных запросов и несколько SDK, теперь достаточно сменить base_url, и можно вызывать множество моделей. Цена вопроса — вы хуже видите, что происходит на пути запроса.
Поэтому первый шаг приёмки — не замерять производительность, а сначала чётко определить, что значит «доступно». Один и тот же запрос может быть успешно оплачен на стороне платформы, вернуть клиенту код 200 и пройти разбор на стороне бизнес-логики — это три разные вещи, и считать их нужно по отдельности. JSON с неверной структурой даже при нормально выполненном на платформе запросе для бизнеса остаётся нулевым результатом, а деньги за него всё равно спишутся.
Второй шаг — разделить тестовый набор по сценариям использования. Для интерактивных вопросов и ответов смотрят на время до первого валидного вывода и на лимит времени полного ответа. Для вызова инструментов проверяют, корректна ли структура параметров и все ли поля на месте. Для пакетной обработки считают, сколько пригодных результатов успевает получиться до дедлайна сдачи. Если смешать все три типа в одно «среднее время», вывод неизбежно получится искажённым.
Третий шаг — выровнять способ измерения времени. Время ожидания на клиенте и время, записанное в логах платформы, охватывают разные этапы. В официальной документации прямо описаны случаи, когда платформа фиксирует успех и списывает оплату, а клиент получает таймаут из-за передачи ответа или закрытия соединения. Кроме того, если в фоне автоматически пробуются другие маршруты, общее время ожидания тоже растёт. Поэтому при каждой аномалии сначала сопоставьте по бизнес-номеру и request_id три источника: записи клиента, логи платформы и изменения баланса. И только потом решайте, нужен ли повторный запрос.
Как проверить возможности шлюза и пиковую нагрузку на фиксированных задачах
Чтобы тест можно было воспроизвести, сначала нужно зафиксировать переменные: версию целевой модели, канал или группу, интерфейс вызова, ключевые параметры, сетевую точку входа, объём входа и выхода, а также режим — потоковый или нет. Если изменилось хотя бы одно, данные двух прогонов нельзя сравнивать между собой. Образцы должны быть взяты из реальных бизнес-данных с удалённой конфиденциальной информацией, а не из игрушечных входов вроде «Привет».
Ниже — шаблон протокола приёмки, который можно сразу использовать. Это методические рекомендации, в них нет результатов реальных замеров какой-либо платформы. Пороги задайте сами под свои бизнес-требования: например, за сколько секунд должен прийти первый полезный фрагмент ответа в интерактивной задаче или сколько пригодных результатов нужно сдать за несколько часов в офлайн-задаче.
| Измерение | Что записывать | Как оценивать |
|---|---|---|
| Успешная бизнес-доставка | Общее число запросов, число полных ответов, число ответов в пригодном формате, число ответов, прошедших бизнес-проверку | Указывайте полный знаменатель; итоговый ориентир — доля бизнес-пригодных результатов |
| Задержка | Время отправки, время первого полезного фрагмента, время завершения, время по логам платформы | Замеряйте отдельно на клиенте и на платформе, считайте p50 и p95 |
| Ключевые возможности | Корректное завершение потока, валидность параметров инструментов, разбор структурированного вывода, обработка длинного входа | Проверяйте по пунктам именно те возможности, от которых зависит ваш продукт |
| Пиковая нагрузка | Число одновременных запросов в обработке, запросов в минуту, доля 429, очереди и повторы | Держите объём запросов постоянным, повышайте нагрузку ступенями и оставляйте окно наблюдения |
| Стоимость | Списание за каждый запрос, возвраты, резервные расходы, число бизнес-пригодных результатов | Считайте полную стоимость на один пригодный результат |
| Возможность разбора инцидентов | Бизнес-номер, request_id, модель и группа, код ошибки, ответ по тикету | Должна быть возможность сопоставить проблемный заказ с записью на платформе |
Этот скрипт делает одно: в потоковом вызове одновременно фиксирует время первого полезного фрагмента и общее время выполнения, чтобы вы могли свести клиентские замеры и логи платформы на одну временную шкалу.
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话说明什么是 API 网关"}],
    stream=True,
)
ttft = None
for chunk in stream:
    delta = chunk.choices[0].delta.content
    if delta and ttft is None:
        ttft = time.perf_counter() - start
total = time.perf_counter() - start
print(f"TTFT {ttft:.3f}s / total {total:.3f}s")
Показать код пакетного стресс-теста и расчёта квантилей
import statistics
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI
)

def one_call(prompt: str) -> dict:
    start = time.perf_counter()
    ok, ttft = False, None
    try:
        stream = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user", "content": prompt}],
            stream=True,
        )
        for chunk in stream:
            delta = chunk.choices[0].delta.content
            if delta and ttft is None:
                ttft = time.perf_counter() - start
        ok = True
    except Exception as exc:
        return {"ok": False, "ttft": None,
                "total": time.perf_counter() - start, "err": type(exc).__name__}
    return {"ok": ok, "ttft": ttft,
            "total": time.perf_counter() - start, "err": None}

def summarize(rows: list) -> None:
    done = [r for r in rows if r["ok"]]
    totals = sorted(r["total"] for r in done)
    print(f"成功率 {len(done)}/{len(rows)}")
    if totals:
        print(f"p50 {statistics.median(totals):.3f}s")
        print(f"p95 {totals[int(len(totals) * 0.95) - 1]:.3f}s")

rows = [one_call("把下面这句话翻译成英文:请检查订单状态。") for _ in range(50)]
summarize(rows)
Самая частая ошибка при нагрузочном тестировании — путать RPM и параллельность. Число запросов в минуту, число токенов в минуту и число одновременно выполняющихся запросов — это три разных ограничения, и одно не заменяет другое. К тому же, когда задержки растут, повторные попытки только усиливают нагрузку на систему. Поэтому в скрипте обязательно должны быть локальная очередь, максимальное время ожидания и ограниченный по числу попыток экспоненциальный backoff.
Есть и ещё одна деталь, которую легко упустить: в документации APIYI страница о параллельности и страница о токенах и группах описывают область действия лимитов не совсем одинаково. Первая говорит, что квоты у разных токенов независимы, вторая — что лимиты привязаны к аккаунту. Поэтому при приёмке правильнее всего замерить фактические квоты на своём целевом аккаунте и целевом канале, отдельно записав параллельность и RPM. Не копируйте цифры из чужих скриншотов и не пытайтесь обойти ограничения, создавая лишние ключи.
Как проверить стоимость каждого пригодного результата и поведение при отказе
Сравнивать стоит не цену за единицу, а «фактическую стоимость одного результата, пригодного для бизнеса». Формула простая: в числитель идут все фактически списанные расходы (включая повторы и срабатывание фолбэка), в знаменатель — количество пригодных результатов, а подтверждённые возвраты вычитаются из числителя.
Ниже чисто гипотетический расчёт — он показывает только логику, а не цены какого-либо поставщика.
| Вариант | Чистые списания | Пригодные результаты | Стоимость одного результата |
|---|---|---|---|
| Вариант A | 3,0 доллара | 90 | около 0,0333 доллара |
| Вариант B | 3,2 доллара | 98 | около 0,0327 доллара |
По расходам вариант A дешевле; по стоимости пригодного результата выгоднее уже вариант B. Именно поэтому вопрос «у кого дешевле» без бизнес-знаменателя смысла не имеет. Ещё два момента: предварительно зарезервированные, но ещё не рассчитанные средства по асинхронным задачам нужно выносить отдельной строкой; а если считать только записи о потреблении, можно завысить чистые расходы — возвраты по асинхронным задачам попадают в счёт отрицательными суммами.
Часть про фолбэк нужно разложить на два принципиально разных сценария. Переключение канала — это смена линии внутри одной и той же модели, возможности модели и цена при этом теоретически не меняются. Переключение модели — это попытки других моделей по списку, когда основная недоступна; в отрасли это распространённый механизм, например model fallbacks у OpenRouter прямо оговаривают, что в итоге списание идёт по цене фактически использованной модели, а сама модель указывается в поле model ответа. Этот пример приведён только для иллюстрации механизма, переносить смысл полей на другие платформы нельзя.
Поэтому приёмка должна покрывать как минимум четыре пункта: какая модель в итоге отработала после фолбэка, сохранилась ли работоспособность ключевой функции, есть ли потолок стоимости одного вызова и сколько максимум длится ожидание. Если для какого-то типа задач смена модели недопустима, нужно ещё убедиться, что фолбэк можно отключить. Отдельно тестируйте стриминг: если сбой случился после того, как часть вывода уже ушла, подхватится ли поток без разрыва — по успешному фолбэку в нестриминговом режиме об этом судить нельзя.
💡 Совет по выбору: только когда цена прямого подключения и путь с фолбэком стоят в одной таблице, видна реальная стоимость. Если нужны быстрые записи о фактических списаниях по нескольким моделям для сравнения, прогоните небольшую выборку через APIYI apiyi.com и вернитесь с этими данными к своей таблице приёмки.
Как проверить цепочку данных и ответственность за сбои
Именно эти два пункта чаще всего прячутся за формулировками вроде «у нас всё безопасно» и «у нас всё стабильно», хотя при реальной аварии только они и смогут вас выручить. Проверять нужно так: выстроить шлюз, вышестоящих поставщиков моделей, подробные отладочные логи и артефакты асинхронных задач в одну цепочку данных и по каждому звену отдельно выяснить, какая политика действует.
| Звено цепочки | Какую политику проверять | Как проверять |
|---|---|---|
| Сам шлюз | Сохраняются ли входные и выходные данные по умолчанию, кто может включить отладочные логи, сколько они хранятся | Прочитать официальное описание по безопасности данных и логированию |
| Вышестоящий поставщик модели | Использование для обучения, сроки хранения, требуется ли явное разрешение | Читать политику каждого поставщика отдельно, не сводя всё в один общий пункт |
| Подробные отладочные логи | Что именно записывается, кто имеет доступ, срок хранения по умолчанию, когда удаляются данные после отключения | Убедиться, что выключение переключателя не означает немедленного удаления уже записанных данных |
| Артефакты асинхронных задач | Где хранятся артефакты, сколько действует ссылка на скачивание | Сразу сохранять результаты на своей стороне, не полагаясь на временные ссылки |
Согласно публичной документации, стандартная политика APIYI — по умолчанию не сохранять входные и выходные данные клиента; подробные отладочные логи администратор может временно включить, чтобы записывать полный ввод, контекст и вывод, причём содержимое видит только администратор, а срок хранения по умолчанию, указанный на странице, — 7—30 дней. Там же отдельно оговорено, что выключение переключателя записи нельзя трактовать как немедленное удаление уже существующих записей. У таких формулировок нужно сохранять привязку «так сказано в официальной документации» — это не сертификат соответствия и не юридическое заключение.
Есть ещё один операционный факт, который часто упускают: у самих логов есть жизненный цикл. В отдельном разъяснении APIYI о хранении логов сказано, что журналы вызовов хранятся скользящим окном примерно за последние два месяца: 5, 15 и 25 числа каждого месяца удаляются записи старше двух месяцев от текущей даты, восстановить их невозможно, а детали, нужные для долгосрочной сверки и аудита, придётся выгружать и хранить самостоятельно. Сроки хранения синхронных результатов и асинхронных артефактов при этом различаются — по данным той же страницы, ссылка на скачивание артефактов действует около суток. Если разбирать инцидент позже этого окна, доказательств у вас на руках уже не будет.
Ответственность за сбои должна быть закреплена в исполнимых пунктах договора. Отдельная страница SLA у APIYI описывает компенсацию в виде пополнения баланса при потерях по вине платформы, а также возможность для компаний прописать в контракте охват гарантий, показатели доступности, сроки реакции и предел компенсации — единого фиксированного процента доступности для всех клиентов эта страница не устанавливает. При сравнении поставщиков стоит фиксировать период расчёта показателя, что берётся в знаменатель, какие сбои исключаются, порядок подачи заявки и форму компенсации, а также чётко различать пополнение сервисного баланса и денежное возмещение — с точки зрения закупочной ценности это разные вещи.
Как одной таблицей приёмки определить масштаб запуска
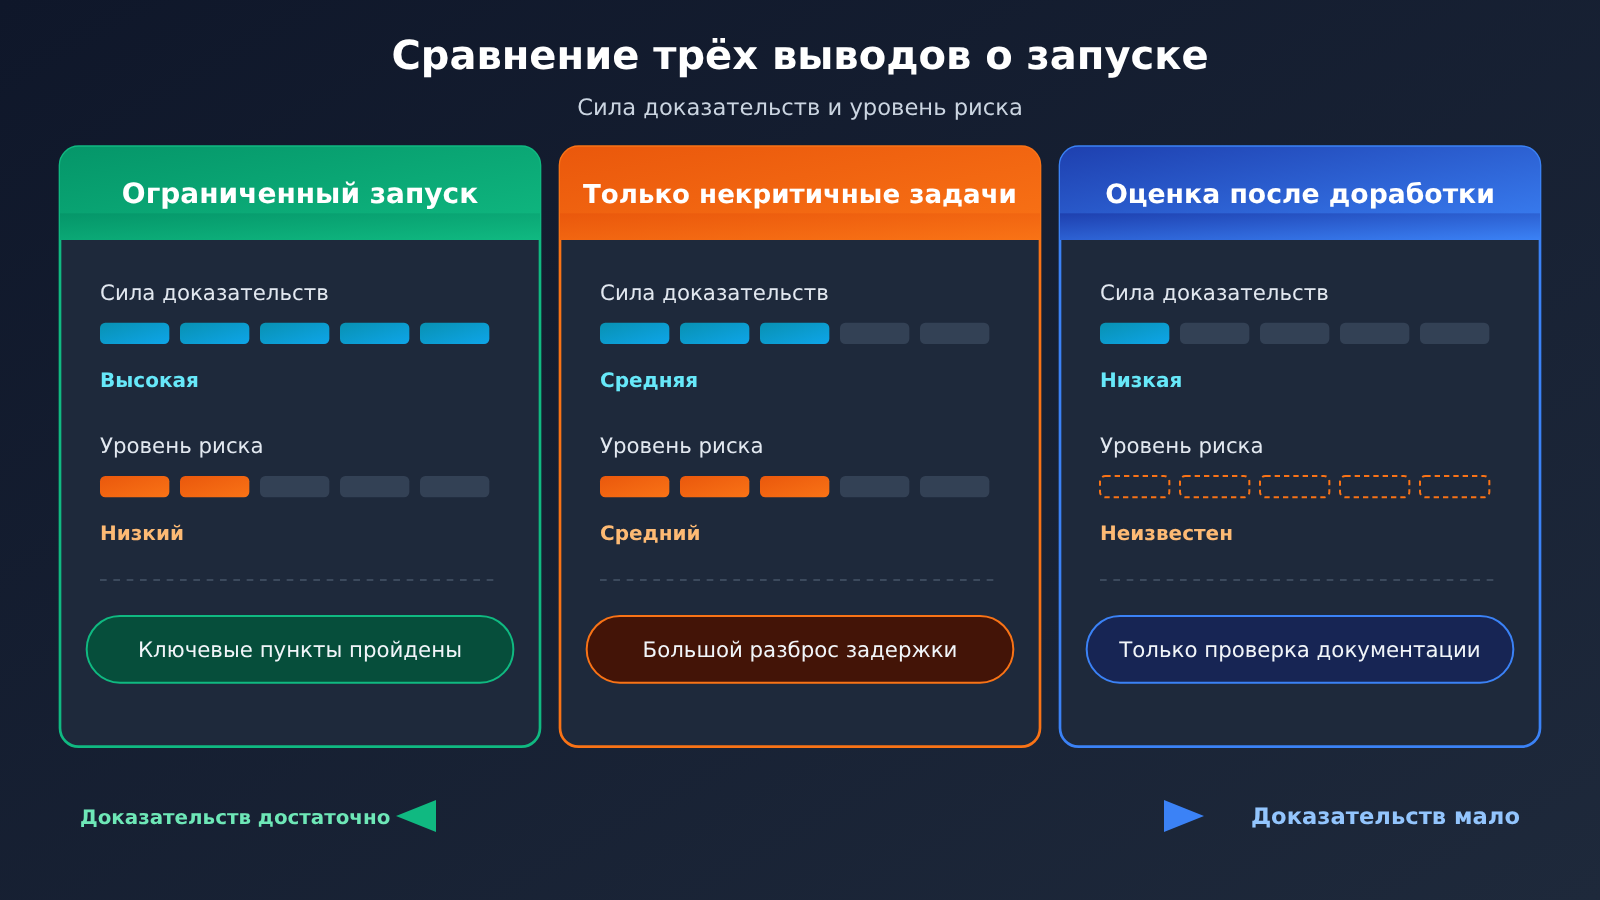
Когда вы сводите все наблюдения к выводу, не составляйте «рейтинг надёжности» — давайте оценку по области применения. Один и тот же провайдер в вашем интерактивном сервисе может тянуть только «некритичные задачи», а в офлайн-пакетной обработке окажется полностью достаточным.
| Вывод | Какие доказательства нужны | Триггер для переключения или остановки |
|---|---|---|
| Можно запускать в ограниченном объёме | Ключевые возможности пройдены по каждому пункту, p95 в пределах бизнес-порога, стоимость пригодного результата приемлема, цепочка данных и SLA проверены | Подряд идут падения доступности сервиса ниже порога или расхождения в биллинге, которые не удаётся свести |
| Только для некритичных задач | Возможности проходят, но задержка сильно колеблется, либо fallback меняет модель и стоимость | Критический путь возвращается на собственное решение или прямое подключение, стратегия fallback явно отключается |
| Пересмотреть после устранения пробелов | Есть только проверка документации, нет собственных замеров на аккаунте, либо условия SLA не закреплены в договоре | Пересмотреть вывод после получения замеров и условий договора |
Если пока доступна только проверка документации, так и запишите вывод: «публичные возможности и условия закупки проверены», а реальную приёмку отложите до следующего раунда. Когда нужно проверить поведение при сбоях, используйте разрешённые провайдером тестовые конфигурации или изолированное окружение — не мешайте вручную общему продовому сервису. Если запрос ушёл в таймаут и результат неясен, сначала сверьте выполнение и биллинг, чтобы не запустить одно и то же бизнес-действие повторно.
🚀 Быстрый старт: если не хочется писать тестовые скрипты с нуля, прогоните сначала две колонки из чек-листа выше — «возможности» и «задержку» — на бесплатном тестовом лимите APIYI apiyi.com, а потом решайте, пора ли переходить к более тяжёлому нагрузочному тестированию.
Частые вопросы (FAQ)
В1: Что такое прокси и шлюз API для больших языковых моделей?
Это входной слой между приложением и вышестоящим сервисом модели: он принимает запрос и выполняет аутентификацию, биллинг, маршрутизацию и логирование. Слово «прокси» здесь подчёркивает, что несколько моделей сводятся к одному совместимому интерфейсу. То есть вы получаете удобство подключения, а взамен теряете видимость нижних уровней цепочки.
В2: Чем отличается надёжность при прямом подключении к официальному API и при работе через прокси-шлюз?
Разницей в количестве звеньев цепочки и в границах ответственности. При прямом подключении вы оцениваете только один источник. При работе через шлюз точками отказа становятся сам шлюз, групповые каналы и вышестоящий провайдер — три уровня, зато появляется дополнительная страховка и возможность единого логирования. И проверять нужно не «кто быстрее», а собирать доказательства отдельно по 5 уровням, разобранным в этой статье.
В3: Почему нельзя смотреть только на среднюю задержку?
Потому что среднее скрывает небольшое число очень медленных запросов, а именно они чаще всего и становятся источником жалоб пользователей. При потоковом взаимодействии стоит считать TTFT и полное время до завершения отдельно, а также явно указывать размер выборки, временное окно и то, вошли ли в статистику ошибки, ожидание в очереди и повторы — иначе даже p95 окажется несравнимым.
В4: Запрос прошёл успешно, но результат непригоден — это проблема платформы?
Обычно нет, но стоимость посчитать всё равно надо. Если платформа корректно выполнила запрос, он тарифицируется, а невалидная структура вывода — это та часть, которую бизнес-сторона должна повторять, и эти повторные расходы логично закладывать в числитель «стоимости одного пригодного результата». Поэтому в приёмочной таблице обязательно нужны две отдельные колонки: успешное выполнение на стороне платформы и прохождение проверки по бизнес-критериям.
В5: Как быстро проверить, выдержит ли шлюз мою задачу?
Возьмите свои обезличенные образцы, зафиксируйте модель, канал, параметры и объём входных данных, прогоните небольшую выборку и запишите TTFT, p95, долю пригодных для бизнеса результатов и детализацию списаний. Тестовый лимит для такого прогона можно получить через APIYI apiyi.com, а потом внести данные в приёмочную таблицу — вместо того чтобы делать выводы по одной проверке на связность.
В6: Какие известные ограничения есть у этого подхода?
p95 на маленькой выборке сильно колеблется, и его нельзя воспринимать как долгосрочное обязательство по уровню сервиса. Нагрузка на вышестоящих провайдерах в разное время суток тоже различается, так что замеры нужно повторять в нескольких временных окнах. Кроме того, все расчётные формулы в статье — это методические рекомендации: здесь нет ни фактических данных о производительности какой-либо платформы, ни реальных счетов. Окончательное решение всё равно принимайте исходя из собственных бизнес-порогов и условий договора.
Ключевые тезисы о прокси-шлюзе для API больших языковых моделей
- Надёжность определяется критериями приёмки по бизнесу: успешное списание на платформе, получение кода 200 на клиенте и успешный разбор ответа в приложении — это три события, которые нужно считать по отдельности.
- Задержку считают в двух точках: TTFT определяет комфорт взаимодействия, полное время выполнения — способность выдать результат; смотреть надо на p95 по обоим показателям.
- RPM и параллелизм необходимо учитывать раздельно: низкий RPM тоже может сложиться в высокую одновременную нагрузку в полёте, а реальные лимиты скорости определяются только замерами на целевом аккаунте.
- Стоимость считают по пригодным результатам: все уже оплаченные расходы делятся на количество пригодных для бизнеса результатов, а повторные попытки и резервные маршруты идут в числитель.
- В резервировании важно различать переключение канала и переключение модели: итоговая модель, ключевой функционал, потолок расходов и максимальное время ожидания проверяются отдельно.
- Данные и ответственность определяются исполняемыми условиями: у логов есть окно хранения, а в SLA должны быть методика подсчёта, исключения и форма компенсации.
- Как начать: сначала прогнать небольшой набор запросов через APIYI apiyi.com и заполнить две колонки — возможности и задержка, а уже потом переходить к нагрузочным тестам и сверке договора.
Итог
Оценить, надёжен ли сервис-прокси API и шлюз для больших языковых моделей, — по сути задача сбора доказательств, а не задача о впечатлениях. Разложите «работает или нет» на пять уровней — пригодный для бизнеса результат, сквозная задержка, стоимость пригодного результата, путь данных и ответственность за сбои — и по каждому оставьте проверяемую запись. Так большинство неприятных сюрпризов вы превратите в известные пункты ещё до запуска.
При внедрении держите в голове три правила: в выводах указывайте только область действия, а не рейтинги; в методике — только собственные замеры, а не чужие скриншоты; в доказательствах — только то, что можно перепроверить, потому что логи имеют свойство истекать. Выполните эти три условия, и обсуждение выбора перестанет зависеть от того, чей голос громче.
Рекомендуем сначала пройти один круг приёмки на небольшой выборке через APIYI apiyi.com: платформа даёт единый интерфейс и бесплатную квоту на тестирование, так что несколько моделей удобно сравнивать в одной таблице.
Справочные материалы
- Токены и группы APIYI: несколько ключей, квоты, группы ресурсов и резервные группы
- Ссылка:
docs.apiyi.com/faq/token-and-groups -
Описание: проверка распределения ключей, групп ресурсов и механизма основного и резервного каналов
-
Политика хранения и очистки логов APIYI: ротация логов и экспорт
- Ссылка:
docs.apiyi.com/faq/log-retention-policy -
Описание: уточняем, в течение какого срока нужно самостоятельно хранить детализацию для сверки и аудита
-
Подробные логи APIYI: что попадает в логи для диагностики и сколько они хранятся
- Ссылка:
docs.apiyi.com/faq/user-logs-control -
Описание: проверка уровней логирования на всём пути данных
-
Безопасность данных в APIYI: политика, по которой входные и выходные данные по умолчанию не сохраняются
- Ссылка:
docs.apiyi.com/faq/data-security -
Описание: читайте вместе с политиками вышестоящих провайдеров, чтобы увидеть разницу между уровнями
-
Гарантии SLA в APIYI: пополнение квоты и условия договора
- Ссылка:
docs.apiyi.com/faq/sla-guarantee -
Описание: как компенсируются сбои и где проходят границы ответственности
-
Как читать сумму списания в логах: поля счёта и логика множителей
- Ссылка:
docs.apiyi.com/faq/log-billing-explained -
Описание: пригодится, чтобы посчитать реальную стоимость каждого удачного результата
-
Лог завершён и средства списаны, но клиент не получил ответ: чем таймаут клиента отличается от биллинга платформы
- Ссылка:
docs.apiyi.com/faq/log-duration-vs-client-wait -
Описание: обязательный материал для разбора проблемных заказов
-
Ссылка:
openrouter.ai/docs/guides/routing/provider-selection -
Описание: объясняет разницу между переключением канала и переключением модели
-
OpenRouter Model Fallbacks: резервные модели и принцип тарификации
- Ссылка:
openrouter.ai/docs/guides/routing/model-fallbacks - Описание: как в индустрии определяют итоговую модель и к кому относится списание
Автор: техническая команда APIYI
Техническое общение: пишите нам на главной странице APIYI apiyi.com, а больше документации ищите в центре документации docs.apiyi.com


