
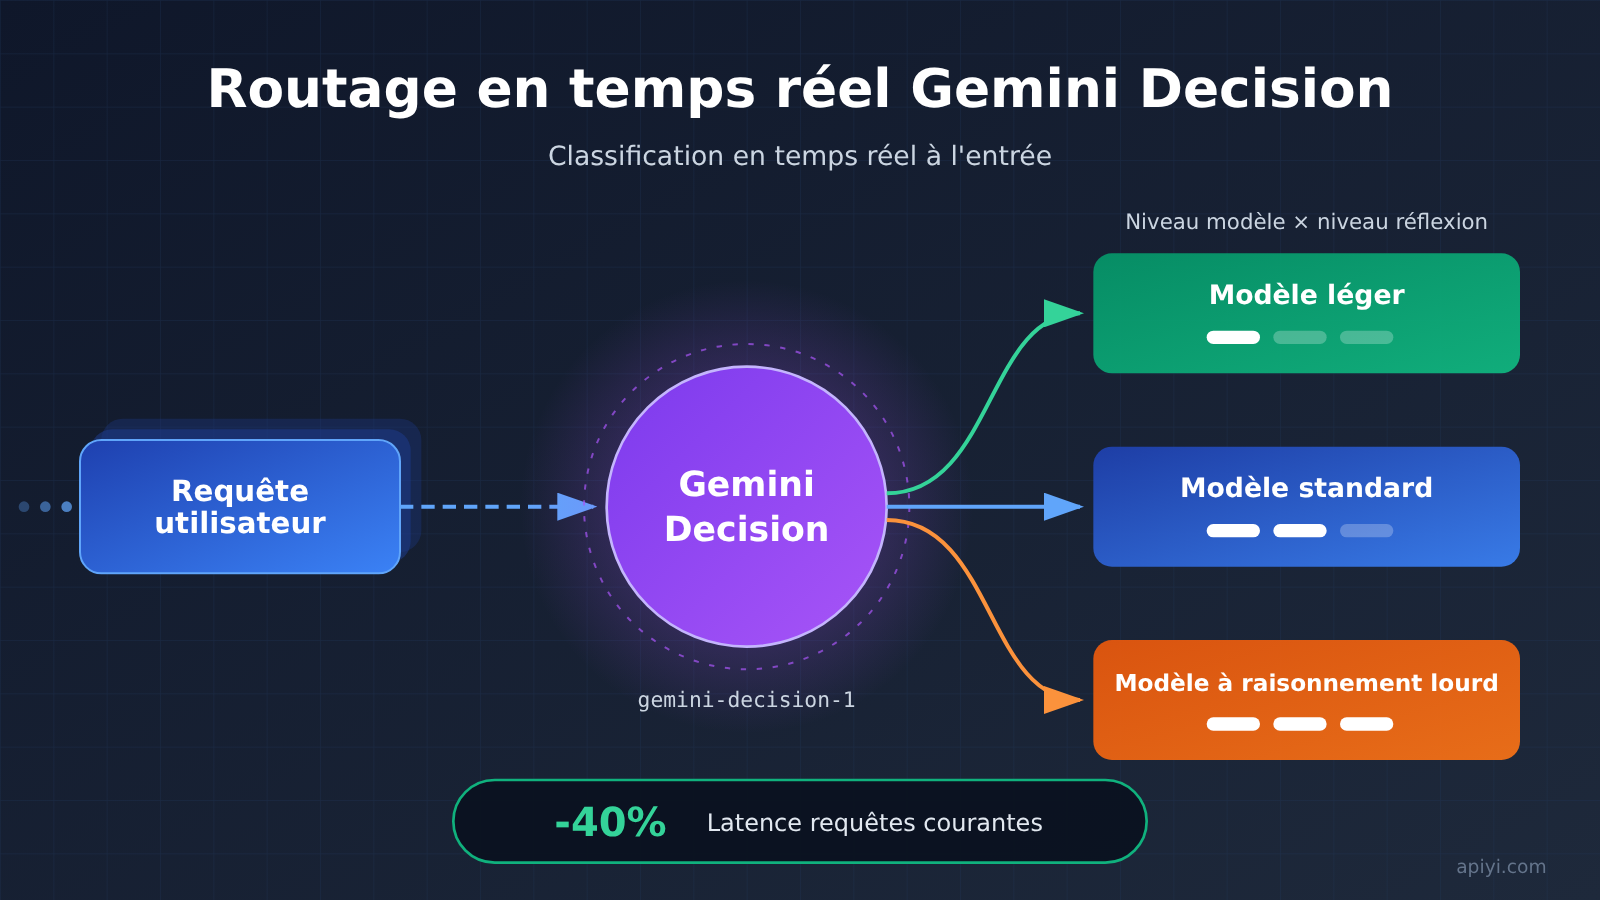
Dans un article du blog développeurs de Google daté du 2026-11-11, on trouve un cas d’usage très concret : Gemini Notebook utilise la Decisions API comme routeur en temps réel. Dès l’arrivée d’une requête, elle oriente les questions courantes vers le bon niveau de modèle et le bon niveau de réflexion. Selon Google, la latence des requêtes courantes baisse jusqu’à 40 %. Attention : ce chiffre est communiqué par Google lui-même. Ce n’est ni un test de charge indépendant, ni le résultat d’une mesure réalisée par une plateforme.
Il ne s’agit pas d’une nouvelle montée en gamme des capacités d’un modèle. Le choix du modèle quitte le code du développeur pour s’installer directement sur le chemin de la requête.
L’essentiel : en 3 minutes, comprenez ce qu’est vraiment gemini-decision-1, comment il est facturé et ce qu’il change pour votre chaîne d’appels.
Gemini Decision : l’essentiel en un coup d’œil
| Élément | Détails |
|---|---|
| Date d’annonce | 2026-11-11, blog développeurs de Google |
| ID du modèle | gemini-decision-1 |
| Positionnement | Routage et décision en temps réel, pas génération de contenu |
| Premier cas d’usage public | Classement des questions courantes par niveau dans Gemini Notebook |
| Prix en entrée | 0,10 $ / 1M tokens |
| Prix en sortie | 0 $ |
| Gain de latence | Jusqu’à 40 % sur les requêtes courantes, d’après Google |
| Disponibilité sur les plateformes d’agrégation | Au 2026-11-12, cet ID ne figure pas encore dans la grille tarifaire d’APIYI (apiyi.com) |
Dans ce tableau, la ligne la plus facile à manquer est le prix en sortie à 0 $. Elle indique que gemini-decision-1 ne produit pas un texte, mais un verdict extrêmement court : quel niveau choisir, avec quel budget de réflexion. Comparer son prix unitaire à celui des modèles de conversation, comme s’ils figuraient dans la même grille, mène à des conclusions totalement erronées.
Autre détail : il existe déjà un vrai cas d’usage en production, et pas seulement un exemple dans la documentation. Gemini Notebook est un produit maison de Google. Ce routage a donc d’abord tourné dans leur propre produit avant d’être présenté publiquement. C’est plus crédible qu’un simple benchmark, mais cela reste une description émanant d’une seule source, Google.
Comment fonctionne Gemini Decision : un cas de routage auto-déclaré par Google
D’après le blog de Google, les questions courantes posées à Gemini Notebook passent d’abord par une Decisions API, qui détermine quel niveau de modèle et quel niveau de réflexion utiliser. Autrement dit, la décision de routage est elle-même devenue un appel de modèle, et non plus un bloc if-else codé en dur ou un seuil réglé à la main.
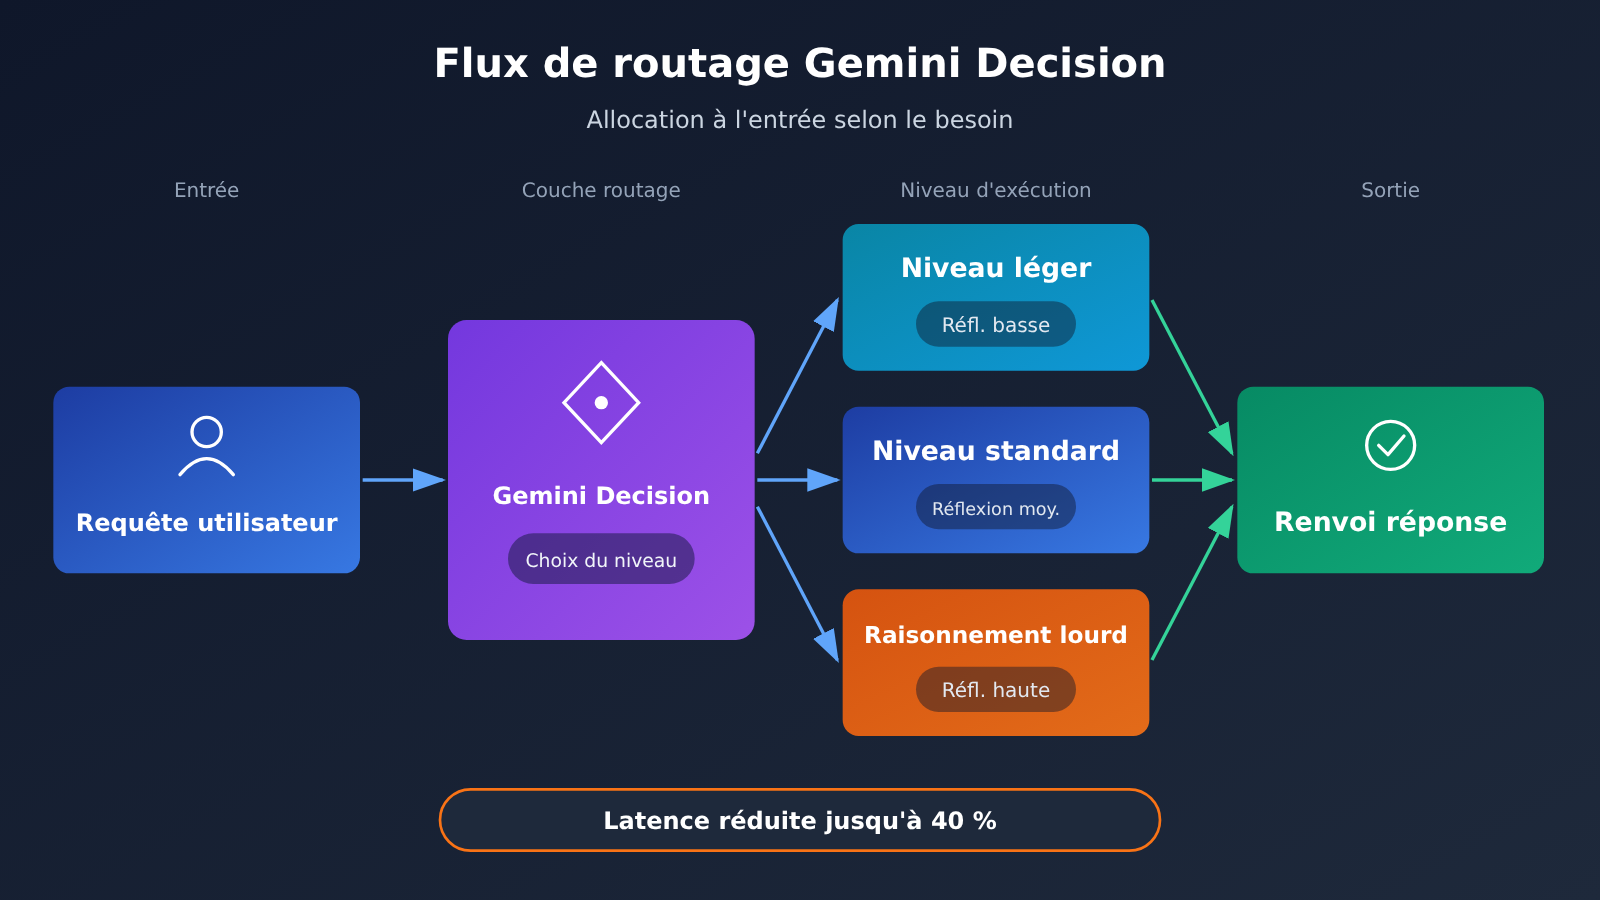
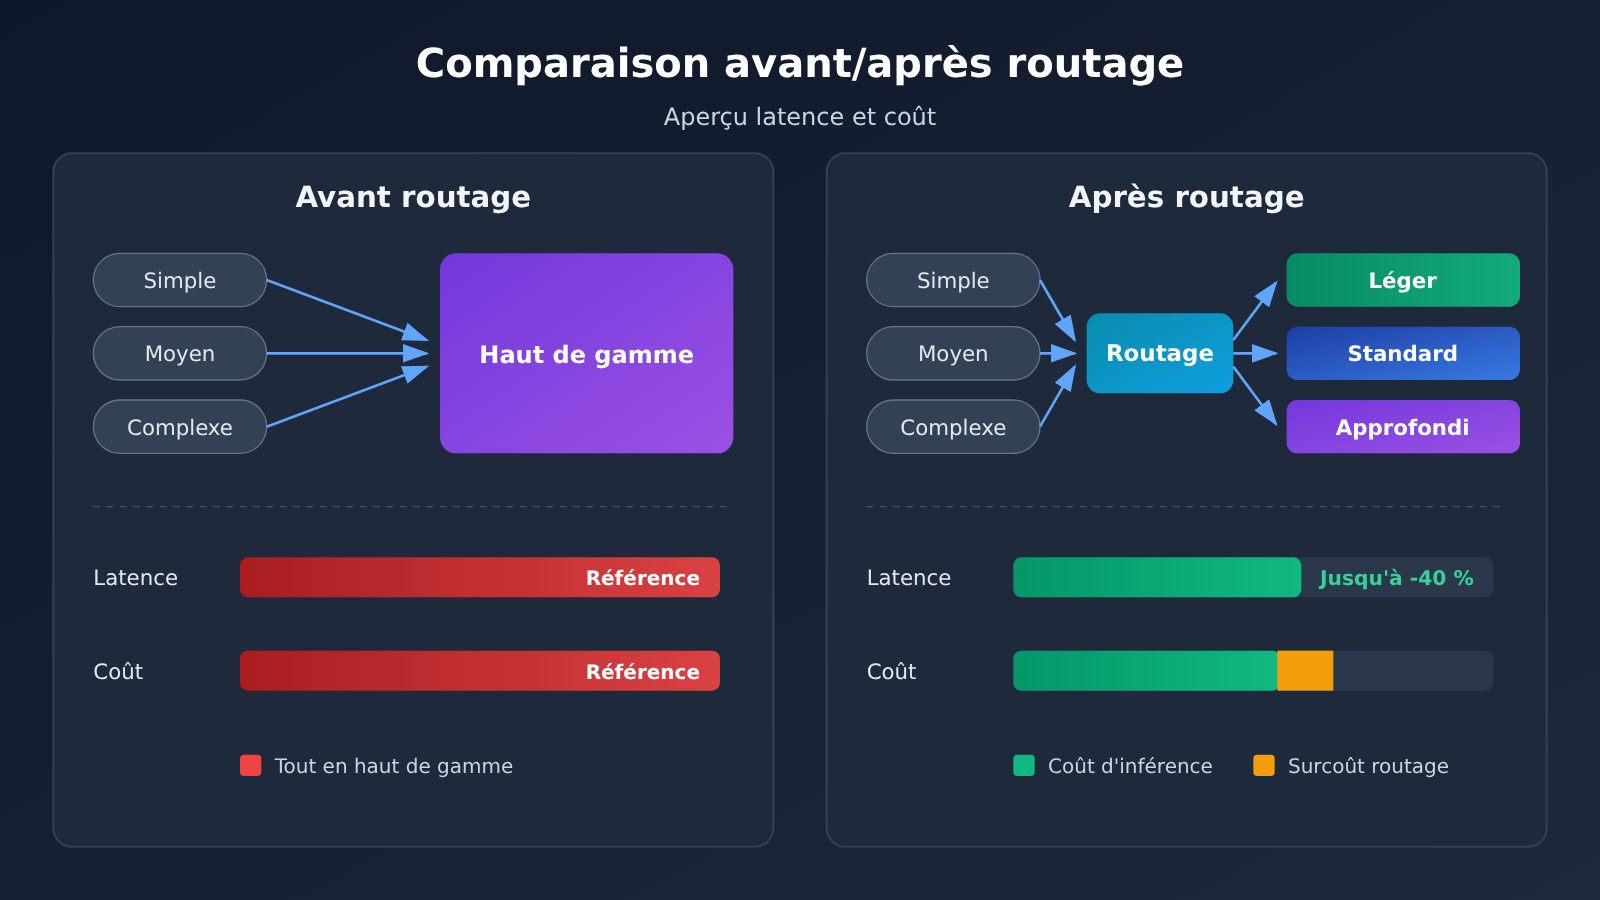
Le problème que cette conception cherche à résoudre est très concret : dans un même produit, la plupart des requêtes sont de simples questions du quotidien, et seule une minorité demande un vrai raisonnement poussé. Si tout passe par le même niveau, les requêtes légères sont ralenties par un modèle trop lourd, et la latence comme les coûts grimpent ensemble ; si tout passe par le niveau léger, les questions complexes sont mal traitées. Placer un modèle de décision dédié à l’entrée pour faire ce tri revient à transformer l’« allocation à la demande » en infrastructure.
| Étape | Pratique courante avant le routage | Après l’introduction de Decision |
|---|---|---|
| Choix du niveau | Règles écrites dans le code ou correspondance par mots-clés | Le modèle juge d’après le contenu de la requête |
| Maintenance | Les seuils doivent être ajustés à la main selon l’évolution du métier | La logique de décision évolue avec les mises à jour du modèle |
| Impact sur la latence | Quand les requêtes lourdes sont nombreuses, tout ralentit | Jusqu’à 40 % de réduction pour les requêtes du quotidien, selon Google |
| Impact sur les coûts | Toutes les requêtes sont facturées au même niveau | Les requêtes légères tombent sur le niveau léger, la structure de la facture change |
Il faut bien préciser que ce chiffre de 40 % correspond au scénario des « requêtes du quotidien », et non à l’ensemble des requêtes. Google parle d’un plafond : le gain réel dépend de la part de vos requêtes qui peuvent effectivement être rétrogradées vers un niveau inférieur. Si votre produit ne traite que de l’analyse de longs documents ou des tâches de code complexes, la marge de rétrogradation sera naturellement plus faible.
🎯 Conseil technique : pour vérifier ce que ce type de routage pourrait vous apporter, vous pouvez commencer par faire tourner chaque niveau de modèle via l’interface unifiée d’APIYI (apiyi.com), comparer la latence et la qualité des sorties sur un même lot de requêtes, puis décider s’il vaut la peine d’ajouter une couche de routage.
Structure de facturation de Gemini Decision et implications sur les coûts
Avec une entrée à 0,10 $ / 1M tokens et une sortie à 0 $, la tarification revient en gros à facturer « la quantité de contexte lue ». Pour décider d’un routage, le modèle doit voir le contenu de la requête, donc facturer l’entrée est logique. En revanche, il ne renvoie qu’un seul verdict (le palier à utiliser) : la sortie ne coûte quasiment rien, et le tarif officiel l’a donc tout simplement fixée à 0.
Concrètement, il faut faire un calcul supplémentaire : la couche de routage consomme elle aussi des tokens. Pour que l’opération soit rentable, le coût de raisonnement économisé grâce au passage à un palier inférieur doit couvrir ce surcoût de décision. Plus la requête est longue et plus l’écart entre les paliers est grand, plus le calcul a de chances d’être positif. À l’inverse, pour des requêtes courtes qui passent déjà par un palier léger, ajouter une couche de routage peut coûter plus cher qu’elle ne rapporte.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# gemini-decision-1 n'est pas encore disponible dans la grille tarifaire de la plateforme
# On peut d'abord remplacer model par un modèle de conversation existant pour valider la chaîne métier
response = client.chat.completions.create(
    model="YOUR_MODEL",
    messages=[{"role": "user", "content": "这个问题需要多深的推理?"}]
)
print(response.choices[0].message.content)
🚀 Démarrage rapide : au 2026-11-12, gemini-decision-1 ne figure pas encore dans la liste tarifaire d’APIYI (apiyi.com), mais la plateforme prévoit de l’ajouter dès que possible. En attendant, vous pouvez valider votre chaîne en appelant d’autres modèles via la même interface compatible OpenAI : le coût de bascule est quasi nul. Pour les modèles disponibles et les prix, référez-vous à la liste sur apiyi.com.
Qui est concerné : les changements concrets sur trois types de chaînes d’appel
Côté application : le routage n’est plus à écrire soi-même, on appelle une interface
Jusqu’ici, pour répartir les requêtes entre plusieurs modèles, les équipes devaient maintenir une table de règles et la réajuster à chaque nouvelle génération de modèles. Si la décision de routage peut être confiée à un modèle dédié, la logique côté application s’allège nettement : il ne reste plus qu’à définir « quels paliers existent » et « quel modèle placer dans chaque palier ». La contrepartie, c’est un appel séquentiel supplémentaire : la qualité du réseau au niveau de la couche d’entrée influence donc directement la latence totale.
Côté coûts : une latence plus basse ne veut pas dire une facture plus basse
Latence et coût suivent deux courbes différentes. Descendre d’un palier fait baisser les deux en même temps, mais le routage lui-même est facturé selon les tokens d’entrée, ce qui fait grimper le coût marginal pour les requêtes courtes. L’approche la plus prudente consiste à regrouper d’abord les requêtes par type, puis à n’activer le routage que sur la part du trafic où l’écart de complexité est important. Le reste du trafic passe par un palier fixe.
| Type d’équipe | Principal bénéfice | Postes de coût à surveiller |
|---|---|---|
| Produit de questions-réponses grand public | Latence réduite sur les questions courantes, amélioration nette de l’expérience | Tokens supplémentaires consommés par l’appel de routage |
| Outils internes d’entreprise | Mélange de requêtes simples et complexes, forts écarts entre paliers | Redéfinition du découpage des paliers à prévoir |
| Services à requêtes courtes et très fréquentes | Gain limité, peu de marge pour descendre de palier | Un saut séquentiel de plus peut coûter plus qu’il ne rapporte |
Côté plateforme : la rapidité de prise en charge des nouveaux ID de modèles devient un critère de choix
Le rythme de mise à jour des modèles s’accélère, et il y a souvent une période d’attente entre l’annonce d’un ID et le moment où il est réellement stable. Pour les équipes qui passent par une plateforme d’agrégation, la capacité à obtenir rapidement une interface appelable pendant cette période pèse directement sur le calendrier de validation. C’est aussi là que des plateformes comme APIYI (apiyi.com) trouvent leur utilité : une seule clé API, une interface compatible OpenAI, et une fois le modèle mis en ligne, on peut basculer dessus sans modifier la structure du code. Pour l’avancement des mises en ligne et les détails de facturation, référez-vous aux informations affichées sur apiyi.com.
Foire aux questions (FAQ)
Q1 : Qu’est-ce que Gemini Decision ?
gemini-decision-1, annoncé par Google, est un modèle conçu pour le routage et la prise de décision en temps réel. Il ne génère pas de texte : il détermine quel palier de modèle et quel palier de réflexion doivent traiter une requête. Gemini Notebook est pour l’instant son premier cas d’usage en production rendu public.
Q2 : En quoi diffère-t-il d’un modèle Gemini classique ?
Un modèle de conversation classique produit du contenu. Lui ne renvoie qu’un verdict extrêmement court, ce qui change complètement la structure de facturation : 0,10 $ / 1M tokens en entrée, 0 $ en sortie. Le voir comme un « modèle de génération moins cher » serait donc une erreur d’interprétation.
Q3 : D’où vient la réduction de latence « jusqu’à 40 % » ?
Ce chiffre vient du blog officiel de Google, c’est donc une donnée communiquée par l’éditeur. Il correspond à l’amélioration maximale de latence de Gemini Notebook sur des requêtes courantes, et non au résultat d’un test de charge indépendant. Le gain réel dépend de la proportion de vos requêtes légères qui peuvent être rétrogradées vers un palier inférieur.
Q4 : Combien cela peut-il me faire économiser ?
Il n’y a pas de réponse universelle. L’économie sur l’inférence vient du fait que les requêtes sont aiguillées vers des paliers plus légers, alors que le routage lui-même est facturé selon les tokens d’entrée. Plus vos requêtes sont longues et plus l’écart entre les paliers est grand, plus le gain net est visible. Pour des scénarios à forte fréquence avec des requêtes courtes, mieux vaut évaluer avec prudence.
Q5 : Peut-on déjà appeler Gemini Decision ?
Au 12/11/2026, gemini-decision-1 ne figure pas encore dans la grille tarifaire d’APIYI (apiyi.com), mais la plateforme l’ajoutera dès que possible. En attendant, vous pouvez utiliser l’interface unifiée d’apiyi.com pour mettre en place votre chaîne de traitement, puis simplement remplacer le nom du modèle une fois l’ID disponible. Les modèles exacts et les prix à jour sont ceux affichés dans la liste d’apiyi.com.
Q6 : Quels sont les inconvénients connus d’une couche de routage ?
Il y en a trois principaux : un appel séquentiel supplémentaire sur le chemin de la requête, ce qui rend la qualité du réseau à l’entrée plus critique ; la décision de routage consomme elle-même des tokens d’entrée, ce qui augmente le coût marginal des requêtes courtes ; enfin, la définition des paliers doit être repensée selon votre activité, on ne peut pas simplement copier le découpage d’un autre.
Gemini Decision : les points clés (Key Takeaways)
- Positionnement : gemini-decision-1 est un modèle de routage en temps réel. Il renvoie un niveau de décision, mais ne génère pas de texte.
- Cas d’usage : Gemini Notebook s’en sert pour orienter les questions du quotidien vers le bon niveau de modèle et le bon niveau de réflexion.
- Gain : selon Google, la latence des requêtes courantes baisse jusqu’à 40 %. Ce chiffre est déclaré par l’éditeur lui-même.
- Tarification : 0,10 $ / 1M tokens en entrée, 0 $ en sortie, facturé selon le contexte lu.
- Contrepartie : le routage consomme lui-même des tokens. Pour les requêtes courtes, il faut donc évaluer séparément le gain net.
- Disponibilité : au 12/11/2026, APIYI (apiyi.com) ne propose pas encore cet ID. Nous le mettrons en ligne dès que possible, et les prix à consulter sont ceux de la liste sur apiyi.com.
- Méthode de validation : commencez par faire fonctionner toute la chaîne via une interface unifiée, puis décidez si vous introduisez une couche de routage en production.
Conclusion
L’intérêt de cette annonce ne tient pas à la puissance du modèle en lui-même. Google a transformé le « choix du modèle » en une interface accessible de l’extérieur, et l’a d’abord rodée dans ses propres produits. Pour les développeurs, trois points sont à retenir : la décision de routage passe d’une logique dans le code à un appel de modèle ; le gain de latence annoncé est une valeur haute déclarée par l’éditeur, qu’il faut réestimer selon la structure de votre propre trafic ; enfin, cette nouvelle ligne de facturation modifie la structure des coûts, et on ne peut pas se contenter de regarder ce que fait économiser la rétrogradation vers un modèle plus léger.
Pour tester cette approche dès maintenant, vous pouvez déjà mettre en place votre logique de répartition par niveaux avec les modèles existants. Une fois gemini-decision-1 disponible sur APIYI (apiyi.com), il suffira de changer le nom du modèle pour basculer. Le modèle et les prix sont ceux indiqués dans la liste sur apiyi.com.
Références
- Blog officiel de Google : Gemini Decisions API
- Lien :
blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/ -
Description : seule source originale pour cet article concernant l’ID du modèle, les cas d’usage de routage, les chiffres de latence et la tarification
-
Liste des prix d’APIYI (apiyi.com)
- Lien :
apiyi.com - Description : sert à vérifier l’état de mise en ligne de gemini-decision-1 et le mode de facturation définitif
Auteur : l’équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI (apiyi.com). Les nouveautés sur les modèles mis en ligne et les nouvelles interfaces sont à retrouver dans le centre de documentation du site.


