
Integrar uma API de Modelo de Linguagem Grande de terceiros em produção nunca foi difícil por causa do momento em que a primeira linha de código roda. O que decide se o projeto vai ser entregue de forma estável são os problemas do primeiro mês depois do lançamento, aqueles que ninguém consegue ver antes: a requisição volta, mas com o formato errado; o cliente estoura o timeout e a plataforma já cobrou; o canal principal cai e o fallback troca, sem avisar, para um modelo mais caro; três meses depois você precisa fazer uma retrospectiva e descobre que os logs já foram apagados.
Este não é mais um artigo do tipo “qual plataforma de API é melhor”. Aqui não repetimos os adjetivos das páginas de divulgação dos fornecedores nem montamos ranking de plataformas. Falamos só de uma coisa prática: antes de ir para produção, quais evidências verificáveis você consegue colocar na mesa para julgar se um serviço proxy de API e gateway de Modelos de Linguagem Grandes é confiável.
Valor central: ao terminar a leitura, você terá um método de verificação com um checklist de aceite de 7 itens e uma tabela de conclusões, que transforma o “parece que funciona” em “está documentado e dá para conferir”.
Termos primeiro: entenda estas 6 palavras antes de falar em produção
Antes de entrar nos métodos de aceitação, vale alinhar alguns termos que aparecem o tempo todo. Acontece que a documentação dos fornecedores e os artigos técnicos nem sempre os usam do mesmo jeito — e essa falta de padrão, por si só, já é um risco para o lançamento.
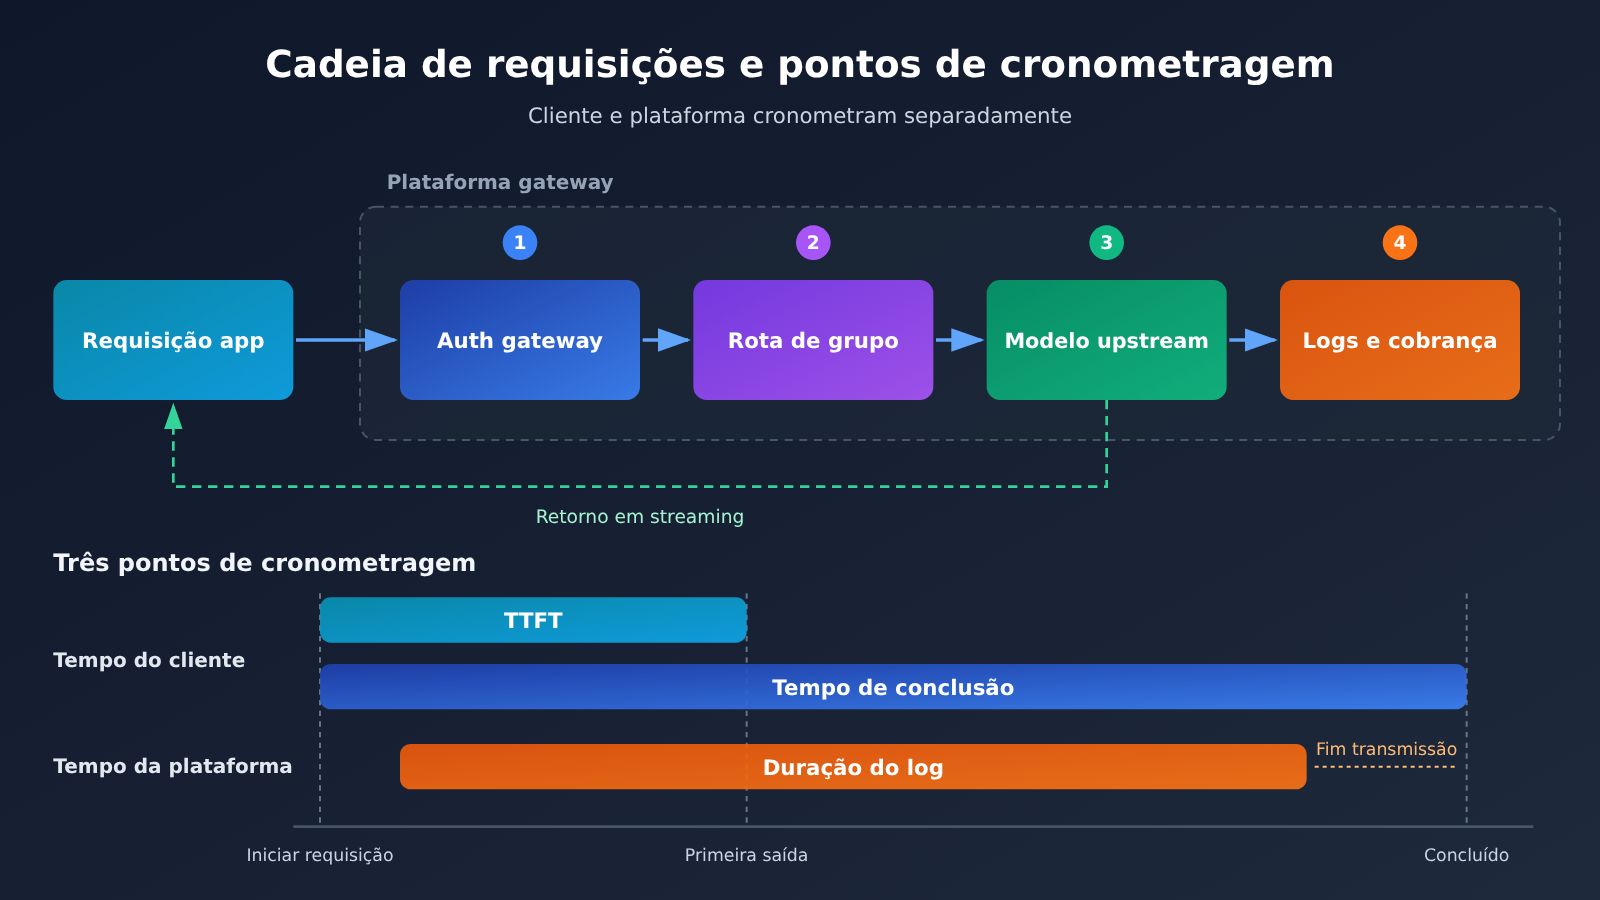
- Gateway de API: a porta de entrada que recebe as requisições da aplicação e as encaminha ao serviço de modelo a montante. Normalmente ele acumula quatro funções — autenticação, cobrança, roteamento e logs —, então uma chamada que falha pode ter quebrado em qualquer ponto da cadeia. Antes de tudo, é preciso saber de quem é a responsabilidade.
- TTFT (tempo até o primeiro token de saída válido): o intervalo entre o envio da requisição e a chegada do primeiro token válido. Em interações por streaming, é esse valor que o usuário percebe, não o tempo total da resposta inteira.
- p95: o valor que cerca de 95% das amostras não ultrapassam. A média esconde as requisições lentas; só o p95 revela aquela pequena leva de chamadas que às vezes travam por dez segundos ou mais.
- RPM e concorrência: RPM é o número de requisições disparadas por minuto; concorrência é quantas requisições ainda estão em execução no mesmo instante. Quanto mais longa a execução, mais um RPM baixo pode empilhar concorrência em voo — por isso os dois precisam ser registrados separadamente.
- Fallback (rede de segurança): o mecanismo de tentar um canal alternativo ou outro modelo quando o serviço principal não consegue atender. Na aceitação, é preciso conferir ao mesmo tempo qual modelo realmente respondeu, se as funcionalidades essenciais funcionaram, o teto de custo e a política de dados — não basta ver se a requisição retornou sucesso.
- SLA: o acordo de nível de serviço, que define a métrica, o escopo de apuração, a responsabilidade em caso de falha e as condições de compensação. É um compromisso executável, não um percentual que se cita fora de contexto.
Informação central: a confiabilidade de um gateway se divide em 5 camadas de verificação
O valor de um proxy/gateway de API de Modelo de Linguagem Grande está em unificar a interface, mas a comodidade dessa interface unificada acaba escondendo as diferenças que existem por baixo. Por trás de um base_url compatível com a OpenAI, pode haver fornecedores upstream completamente diferentes, políticas de limite de taxa distintas, regras de retenção de logs diversas e fluxos de tratamento de falhas bem diferentes.
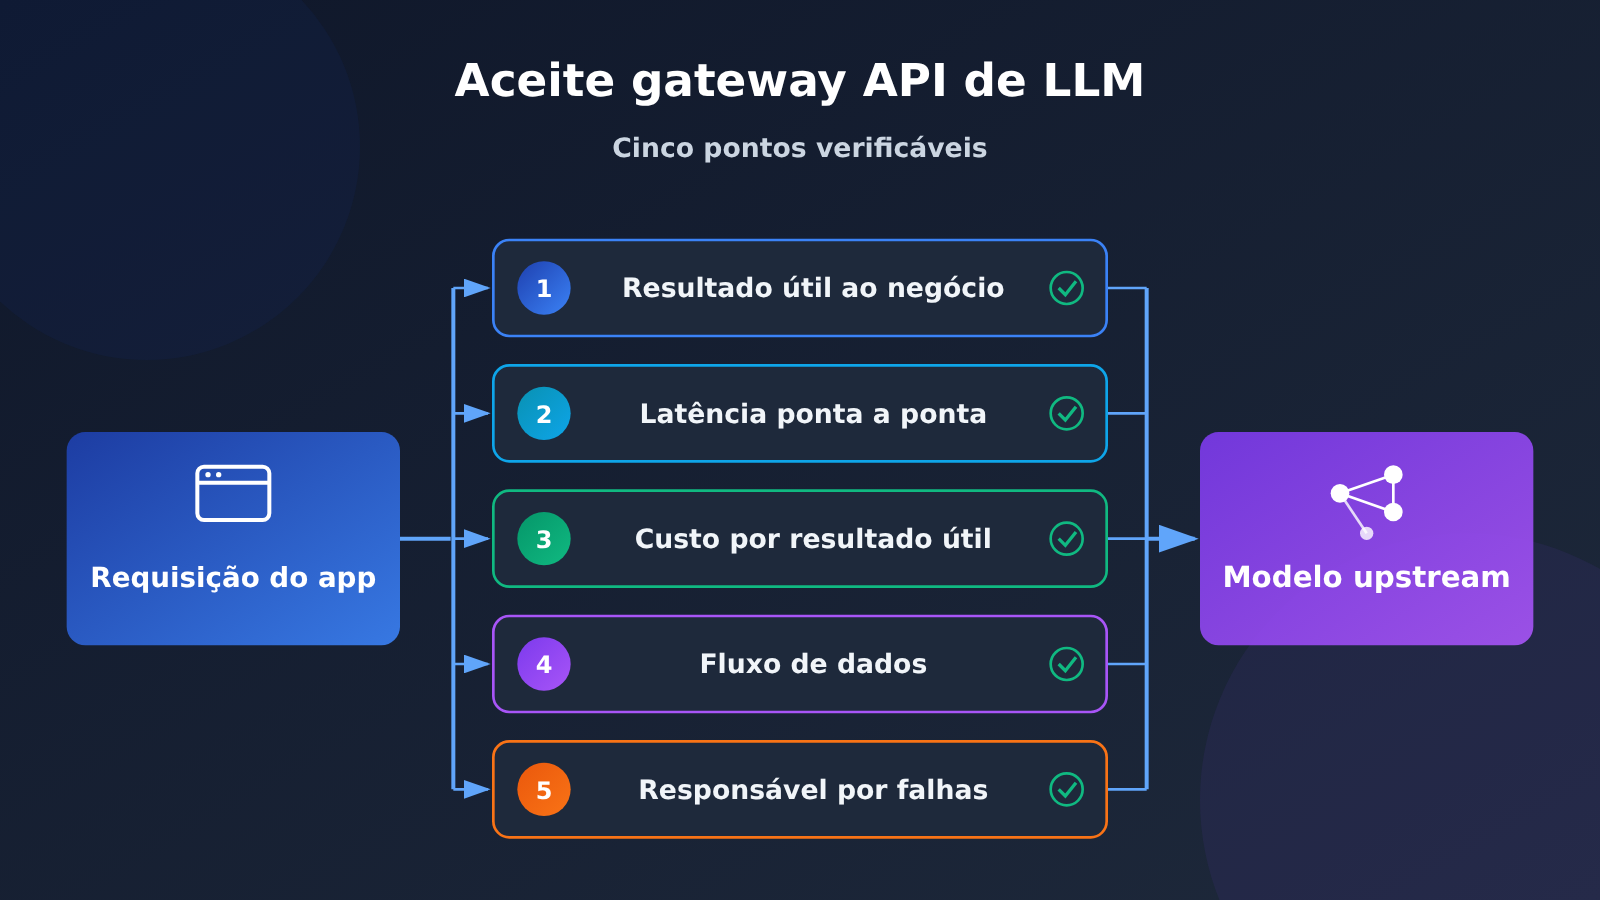
Por isso, na hora de decidir se vai para produção, não basta perguntar “a chamada funciona?”. É preciso observar três coisas ao mesmo tempo: se o resultado é utilizável, se a espera é aceitável e se as exceções podem ser rastreadas. A tabela abaixo desdobra essas três coisas em 5 camadas de verificação, e elas também formam o esqueleto das cinco seções seguintes.
| Camada de verificação | Pergunta a responder | Base para o julgamento | Erro de avaliação comum |
|---|---|---|---|
| Resultado útil para o negócio | O conteúdo retornado pode entrar direto no fluxo de negócio? | Número de respostas completas, de formatos utilizáveis e de aprovações na validação de negócio | Tratar HTTP 200 como sucesso |
| Latência ponta a ponta | Quanto o usuário espera até ver o primeiro trecho útil da saída? | p50 e p95 de TTFT e do tempo de conclusão, cronometrados separadamente no cliente e na plataforma | Olhar só o tempo médio |
| Custo por resultado útil | Quanto cada resultado aproveitável realmente custou? | Todo o gasto já cobrado dividido pelo número de resultados úteis para o negócio | Comparar só o preço unitário, ignorando retentativas e fallback |
| Cadeia de dados | Por quem a entrada e a saída passam, por quanto tempo ficam retidas e quem pode vê-las? | Políticas em camadas do gateway, do upstream, dos logs e dos artefatos assíncronos | Achar que criptografia em trânsito significa que o conteúdo não pode ser lido |
| Responsabilidade por falhas | Depois de um incidente, qual critério se aplica e como é a compensação? | Período de apuração do SLA, exclusões, processo de solicitação e forma de compensação | Tratar uma declaração pública como compromisso contratual |
🎯 Dica técnica: copie esta tabela e transforme-a na planilha de aceitação da sua equipe; cada linha precisa ter a fonte da evidência preenchida. Se você precisa primeiro validar a cadeia de chamadas, dá para conseguir créditos de teste pela APIYI (apiyi.com) e usar o mesmo script para registrar, lado a lado, o comportamento de vários modelos.
Por que definir a confiabilidade como critério de aceitação do negócio
Uma interface unificada reduz o custo de integração — e, ao mesmo tempo, empurra para o time de aplicação uma série de decisões que antes eram território da infraestrutura. Antes você mantinha sua própria lógica de retry e um punhado de SDKs; hoje basta trocar o base_url para chamar vários modelos. O preço disso é menos visibilidade sobre a cadeia inteira.
Por isso o primeiro passo da aceitação não é medir desempenho, e sim deixar claro o que significa “disponível”. Numa mesma requisição, três coisas diferentes podem acontecer: a plataforma cobra com sucesso, o cliente recebe um 200, e o lado do negócio consegue interpretar o conteúdo. São eventos distintos e precisam ser contados em separado. Um JSON com estrutura inválida continua sendo resultado zero para o negócio mesmo quando a plataforma concluiu a requisição normalmente — e, ainda assim, gerou custo.
O segundo passo é dividir os conjuntos de teste conforme o formato de uso. Em perguntas e respostas interativas, olhe para o primeiro resultado útil e para o prazo da resposta completa. Em chamadas de ferramentas, verifique se a estrutura dos parâmetros é válida e se todos os campos estão presentes. Em processamento em lote, meça quantos resultados aproveitáveis saem antes do prazo de entrega. Misturar as três categorias num único “tempo médio” garante uma conclusão distorcida.
O terceiro passo é alinhar a métrica de tempo. O tempo de espera do cliente e a duração registrada no log da plataforma não cobrem as mesmas fases — a documentação oficial já descreve explicitamente o cenário em que “a plataforma registra sucesso e cobra, enquanto o cliente estoura o tempo na transmissão da resposta ou no encerramento da conexão”. Tentativas automáticas em rotas alternativas, feitas em segundo plano, também aumentam a espera total. Então, diante de qualquer anomalia, primeiro cruze o identificador do negócio e o request_id nos três lados — registro do cliente, log da plataforma e variação de saldo — e só depois decida se vale repetir a chamada.
Como testar a capacidade do gateway e a carga de pico com tarefas fixas
Para o teste ser reproduzível, você precisa fixar as variáveis antes: versão do modelo-alvo, canal ou grupo, interface de invocação, parâmetros principais, ponto de entrada de rede, volume de entrada e saída e se a resposta é em streaming ou não. Se qualquer um desses itens mudar, os dados das duas rodadas não podem ser comparados. As amostras devem vir de dados reais do negócio, devidamente anonimizados, e não de entradas de brinquedo como “olá”.
A tabela abaixo é um modelo de registro de aceitação que você pode usar direto. É uma sugestão de método e não traz nenhuma conclusão de medição de plataforma. Os limites ficam por conta da sua necessidade de negócio. Por exemplo: em quantos segundos a primeira saída válida precisa aparecer numa tarefa interativa, ou quantos resultados utilizáveis precisam ser entregues em quantas horas numa tarefa offline.
| Dimensão | O que registrar | Como avaliar |
|---|---|---|
| Sucesso na entrega de negócio | Total de requisições, respostas completas, respostas com formato utilizável, respostas aprovadas pelo critério de negócio | Escreva o denominador completo e olhe, no fim, a proporção de resultados utilizáveis para o negócio |
| Latência | Horário de início, horário da primeira saída válida, horário de conclusão, tempo no log da plataforma | Meça separadamente no cliente e na plataforma, e calcule p50 e p95 |
| Capacidades centrais | Fechamento correto do streaming, validade dos parâmetros de ferramentas, parsing de saída estruturada, tratamento de entradas longas | Verifique, um a um, os recursos de que o seu produto realmente depende |
| Carga de pico | Requisições simultâneas em andamento, requisições por minuto, proporção de 429, filas e retentativas | Mantenha o volume de requisições constante, aumente a carga por etapas e deixe uma janela de observação |
| Custo | Cobrança por chamada, estornos, custo de fallback, número de resultados utilizáveis | Calcule o custo total por resultado utilizável |
| Rastreabilidade | ID de negócio, request_id, modelo e grupo, código de erro, resposta do ticket | Consiga ligar um pedido com problema ao registro da plataforma |
O script abaixo faz uma coisa só: numa chamada em streaming, registra o tempo até a primeira saída válida e o tempo total, para você conseguir comparar o cronômetro do cliente com o log da plataforma na mesma linha do tempo.
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话说明什么是 API 网关"}],
    stream=True,
)
ttft = None
for chunk in stream:
    delta = chunk.choices[0].delta.content
    if delta and ttft is None:
        ttft = time.perf_counter() - start
total = time.perf_counter() - start
print(f"TTFT {ttft:.3f}s / total {total:.3f}s")
Ver o código de teste de carga em lote e estatísticas de percentis
import statistics
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada do APIYI
)

def one_call(prompt: str) -> dict:
    start = time.perf_counter()
    ok, ttft = False, None
    try:
        stream = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user", "content": prompt}],
            stream=True,
        )
        for chunk in stream:
            delta = chunk.choices[0].delta.content
            if delta and ttft is None:
                ttft = time.perf_counter() - start
        ok = True
    except Exception as exc:
        return {"ok": False, "ttft": None,
                "total": time.perf_counter() - start, "err": type(exc).__name__}
    return {"ok": ok, "ttft": ttft,
            "total": time.perf_counter() - start, "err": None}

def summarize(rows: list) -> None:
    done = [r for r in rows if r["ok"]]
    totals = sorted(r["total"] for r in done)
    print(f"成功率 {len(done)}/{len(rows)}")
    if totals:
        print(f"p50 {statistics.median(totals):.3f}s")
        print(f"p95 {totals[int(len(totals) * 0.95) - 1]:.3f}s")

rows = [one_call("把下面这句话翻译成英文:请检查订单状态。") for _ in range(50)]
summarize(rows)
O erro mais comum em testes de carga é confundir RPM com concorrência. Requisições por minuto, tokens por minuto e requisições simultâneas em andamento são três restrições diferentes, e uma não substitui a outra. Além disso, quando a latência sobe, as retentativas ainda amplificam a pressão sobre o sistema. Por isso, o script precisa ter uma fila local, um tempo máximo de espera e retentativas com backoff limitado.
Há ainda um detalhe que costuma passar batido: na documentação do APIYI, a página de “concorrência” e a página de “tokens de acesso e grupos” não descrevem exatamente da mesma forma o escopo do limite de taxa. A primeira menciona que a cota de cada token de acesso é independente, enquanto a segunda diz que o limite acompanha a conta. Na hora de validar, o jeito certo é medir a cota real usando a sua própria conta e o canal que você vai usar de fato, registrando concorrência e RPM separadamente. Não aplique números fixos que viu no print de outra pessoa, e não tente driblar o limite criando várias chaves API.
Como conferir o custo por resultado utilizável e o comportamento de fallback
Mais importante do que comparar o preço unitário é comparar o “custo real por resultado utilizável pelo negócio”. A conta é simples: no numerador entra todo o gasto já liquidado (incluindo novas tentativas e fallbacks), no denominador entra o número de resultados utilizáveis, e os reembolsos já confirmados são descontados do numerador.
A seguir, um exemplo puramente hipotético, só para ilustrar o algoritmo. Ele não representa o preço de nenhum fornecedor.
| Opção | Gasto líquido liquidado | Resultados utilizáveis | Custo por resultado utilizável |
|---|---|---|---|
| Opção A | US$ 3,0 | 90 | cerca de US$ 0,0333 |
| Opção B | US$ 3,2 | 98 | cerca de US$ 0,0327 |
Olhando só o gasto, a opção A sai mais barata. Mas pelo custo por resultado utilizável, a opção B compensa mais. É por isso que a pergunta “quem é mais barato?” não faz sentido sem um denominador de negócio. Vale prestar atenção em mais duas coisas: o crédito pré-retido de tarefas assíncronas que ainda não foram liquidadas deve ser listado separadamente; e somar apenas os registros de consumo pode superestimar o gasto líquido, porque os reembolsos de tarefas assíncronas aparecem como valores negativos na fatura.
Já o fallback precisa ser dividido em dois tipos de mudança bem diferentes. A troca de canal muda a rota dentro do mesmo modelo, então, em teoria, a capacidade e o preço do modelo continuam iguais. A troca de modelo tenta outros modelos de uma lista quando o modelo principal está indisponível. É um mecanismo comum no mercado: o model fallbacks do OpenRouter, por exemplo, informa explicitamente que a cobrança final segue o preço do modelo efetivamente usado e que o modelo final aparece no campo model da resposta. Esse exemplo serve só para ilustrar o mecanismo, e o significado dos campos não pode ser transposto para outras plataformas.
Por isso, os itens de aceitação devem cobrir pelo menos quatro pontos: qual é o modelo final depois do fallback, se a funcionalidade central continua funcionando, se existe um teto de custo por chamada e qual é o tempo máximo de espera. Se algum tipo de negócio não permite trocar de modelo, você ainda precisa confirmar se o fallback pode ser desativado. Cenários de streaming precisam ser testados separadamente: se a falha acontece depois que parte da saída já foi retornada, é preciso saber se a continuação é transparente, algo que não dá para deduzir de um fallback bem-sucedido em modo não streaming.
💡 Dica de escolha: coloque o preço de conexão direta e o caminho de fallback na mesma tabela para enxergar o custo real. Se quiser obter rapidamente registros de cobrança reais de vários modelos para comparar, dá para rodar um pequeno lote de amostras pelo APIYI (apiyi.com) e depois voltar à sua tabela de aceitação para fazer a conta.
Como conferir a cadeia de dados e a responsabilidade por falhas
Esses dois pontos costumam ser varridos para baixo do tapete com frases como “somos muito seguros” ou “somos muito estáveis”, mas são justamente o que pode te salvar quando algo dá errado. Para verificar, coloque na mesma cadeia de dados o gateway, os provedores upstream dos modelos, os logs detalhados de diagnóstico e os artefatos de tarefas assíncronas, e pergunte sobre a política de cada camada.
| Etapa da cadeia | Política a conferir | Como conferir |
|---|---|---|
| O próprio gateway | Se guarda entradas e saídas por padrão, quem pode ativar os logs de diagnóstico e por quanto tempo eles ficam retidos | Ler a documentação oficial de segurança de dados e logs |
| Provedores upstream dos modelos | Uso para treinamento, prazo de retenção, se é preciso autorizar ativamente | Ler a política de cada upstream separadamente, sem juntar tudo numa só |
| Logs detalhados de diagnóstico | Escopo do registro, quem pode ver, prazo de retenção padrão, momento da exclusão após o desligamento | Confirmar que desligar a chave não significa apagar na hora os registros já existentes |
| Artefatos de tarefas assíncronas | Onde os artefatos são armazenados, validade dos links de download | Salvar no seu lado o quanto antes, sem depender de links temporários |
Segundo a documentação pública, a política geral da APIYI é não guardar por padrão as entradas e saídas dos clientes. Os logs detalhados de diagnóstico podem ser ativados temporariamente por um administrador para registrar a entrada completa, o contexto e a saída, com conteúdo visível apenas para administradores. O prazo de retenção padrão indicado na página é de 7 a 30 dias. A mesma página também explica que desligar a chave de registro não deve ser interpretado como exclusão imediata dos registros existentes. Vale manter, nesse tipo de afirmação, a atribuição de “conforme a documentação oficial”: ela não equivale a uma certificação de conformidade, nem a uma conclusão jurídica.
Há ainda um fato operacional que muita gente ignora: os próprios logs têm ciclo de vida. A página específica da APIYI sobre retenção de logs informa que os logs de invocação são mantidos em rotação pelos últimos dois meses, aproximadamente. Nos dias 5, 15 e 25 de cada mês, os registros com mais de dois meses de antiguidade são excluídos, e essa limpeza não pode ser desfeita. Os detalhes necessários para conciliação e auditoria de longo prazo precisam ser exportados e guardados por você. O prazo de armazenamento dos resultados síncronos e dos artefatos assíncronos também é diferente: a página diz que os links de download dos artefatos valem por cerca de um dia. Se você for fazer a análise depois dessa janela, não vai ter mais evidência nenhuma em mãos.
A responsabilidade por falhas, por sua vez, precisa se traduzir em cláusulas executáveis. A página específica de SLA da APIYI trata da reposição de créditos quando a perda é causada pela plataforma, e de como empresas podem definir em contrato o escopo da garantia, os indicadores de disponibilidade, o tempo de resposta e o teto de indenização. A página não oferece a todos os clientes uma taxa de disponibilidade fixa e única. Ao comparar fornecedores, registre o período de apuração do indicador, a definição do denominador, as exclusões de falhas, o processo de solicitação e a forma de compensação. Deixe bem claro também a diferença de valor, na hora de comprar, entre compensação em créditos de serviço e indenização em dinheiro.
Use uma tabela de aceite para decidir o escopo do lançamento
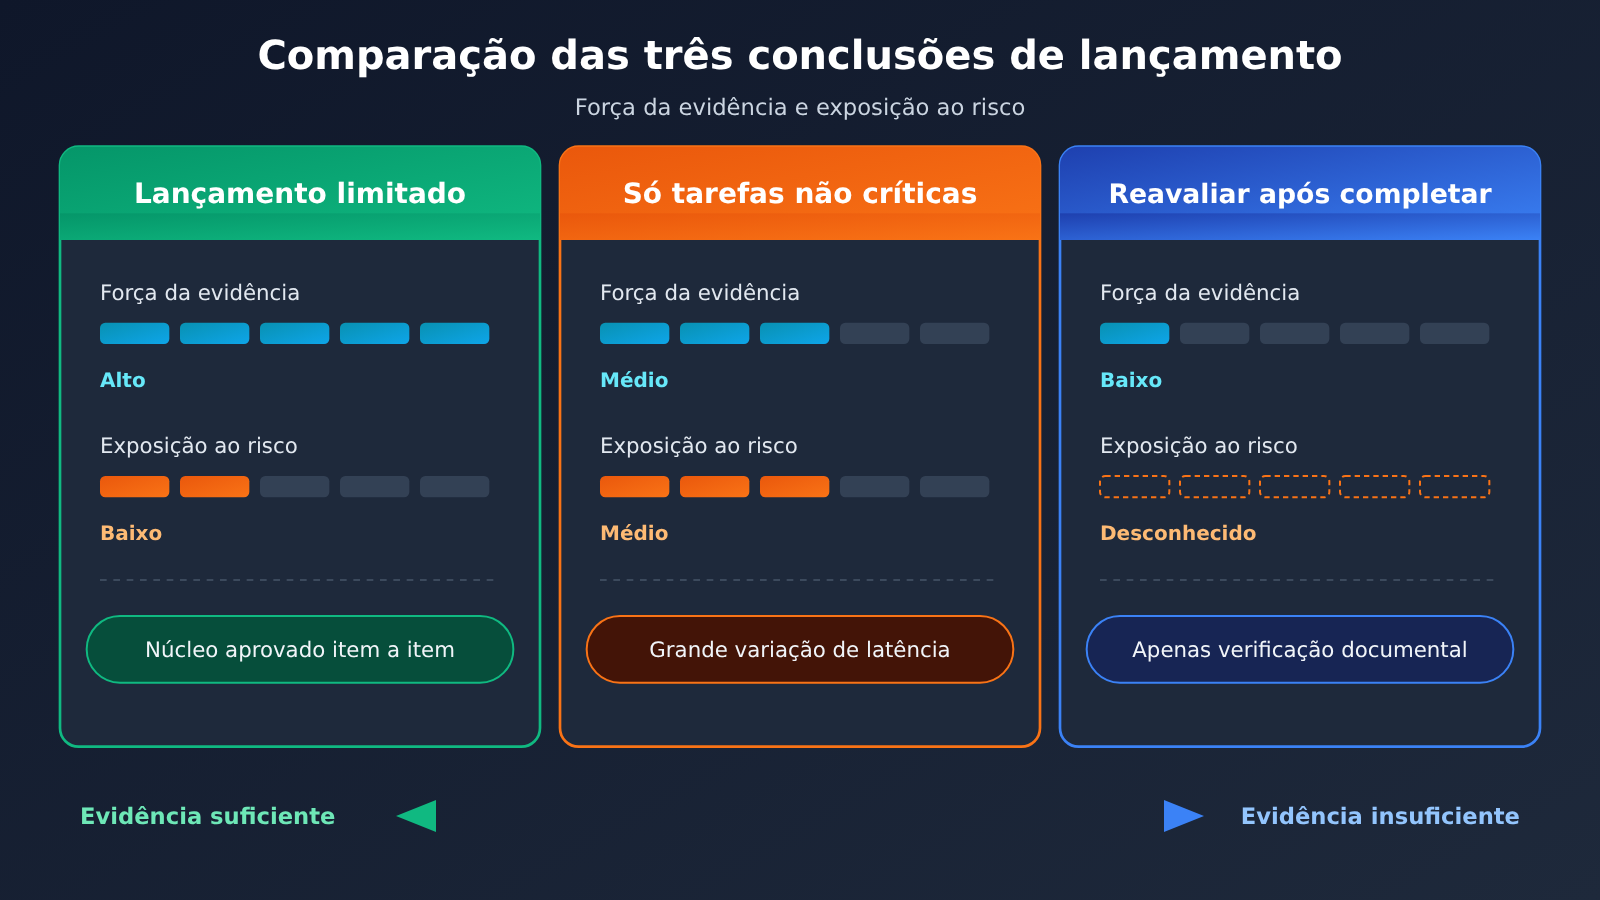
Na hora de transformar todos os registros em uma conclusão, não entregue um “ranking de confiabilidade”. Entregue um julgamento de escopo. O mesmo fornecedor pode ser suficiente só para “tarefas não críticas” no seu negócio interativo e, ao mesmo tempo, atender perfeitamente o seu processamento em lote offline.
| Conclusão | Evidências necessárias | Gatilhos para trocar ou parar |
|---|---|---|
| Pode entrar em produção em pequena escala | Capacidades centrais aprovadas item a item, p95 dentro do limite do negócio, custo por resultado utilizável aceitável, pipeline de dados e SLA conferidos | Taxa de disponibilidade do negócio abaixo do limite de forma consecutiva, ou divergência de cobrança que não consegue ser reconciliada |
| Apenas para tarefas não críticas | Capacidades aprovadas, mas com grande oscilação de latência, ou o fallback altera o modelo e o custo | Caminho crítico volta para infraestrutura própria ou conexão direta, e a estratégia de fallback é desativada explicitamente |
| Reavaliar depois de completar as condições | Só houve checagem de documentação, faltam testes reais na sua conta, ou as cláusulas de SLA ainda não estão no contrato | Concluir de novo depois de completar os dados de testes reais e as cláusulas contratuais |
Se por enquanto só dá para fazer a checagem de documentação, escreva a conclusão com honestidade: “capacidades públicas e condições de contratação conferidas”, e deixe o aceite real para a próxima rodada. Para validar o comportamento em caso de falha, use as configurações de teste permitidas pelo fornecedor ou um ambiente isolado, e não interfira de propósito em serviços de produção compartilhados. Se der timeout e o resultado for incerto, confira primeiro a execução e a cobrança, para não executar duas vezes a mesma ação de negócio.
🚀 Início rápido: se você não quer montar scripts de teste do zero, dá para usar a cota de testes gratuita do APIYI (apiyi.com) para rodar as colunas de “capacidade” e “latência” da lista de 7 itens acima e só depois decidir se vale partir para um teste de carga mais pesado.
Perguntas frequentes (FAQ)
P1: O que é, afinal, um serviço proxy de API (ou gateway) para Modelos de Linguagem Grandes?
É a camada de entrada entre a sua aplicação e os serviços de modelo upstream. Ao receber uma requisição, ela cuida de autenticação, cobrança, roteamento e registro de logs. O “proxy” aqui serve para reunir vários modelos em uma única interface compatível. Ou seja: você ganha praticidade na integração, mas paga com menos visibilidade sobre o caminho que a requisição percorre por baixo dos panos.
P2: Qual é a diferença de confiabilidade entre usar a API oficial diretamente e usar um gateway?
A diferença está no número de camadas do caminho e na divisão de responsabilidades. Na conexão direta, você só precisa avaliar um upstream. Com o gateway, o próprio gateway, o canal de grupo e o fornecedor upstream podem virar pontos de falha. Em compensação, você também ganha uma camada extra de contingência e a possibilidade de ter logs unificados. O critério não é “quem é mais rápido”, e sim coletar evidências em cada um dos 5 níveis descritos neste artigo.
P3: Por que não basta olhar a latência média?
Porque a média esconde as poucas requisições muito lentas, e são justamente elas que costumam gerar reclamação dos usuários. Em interações com streaming, o ideal é medir separadamente o TTFT (tempo até o primeiro token) e o tempo total de conclusão. Também é preciso informar o tamanho da amostra, a janela de tempo e se foram incluídas falhas, filas e retentativas. Sem isso, nem o p95 serve para comparação.
P4: Se a requisição teve sucesso, mas o conteúdo não serve, o problema é da plataforma?
Em geral, não, mas o custo conta. Se a plataforma conclui a requisição normalmente, ela cobra. Uma saída com estrutura inválida é algo que o lado do negócio precisa tentar de novo, e esse gasto repetido deve entrar no numerador do “custo por resultado utilizável”. Por isso, a sua tabela de aceitação precisa ter duas colunas separadas: execução bem-sucedida na plataforma e aprovação segundo o critério do negócio.
P5: Como validar rapidamente se um gateway aguenta o meu negócio?
Use suas próprias amostras anonimizadas e fixe o modelo, o canal, os parâmetros e o tamanho da entrada. Rode uma rodada pequena e registre TTFT, p95, a proporção de resultados utilizáveis e o detalhamento das cobranças. Você pode pegar um crédito de teste na APIYI (apiyi.com) para fazer essa rodada e depois preencher a tabela de aceitação com os dados, em vez de tirar conclusões a partir de um único teste de conectividade.
P6: Quais são as limitações conhecidas deste método?
O p95 de amostras pequenas oscila bastante e não pode ser tratado como promessa de serviço de longo prazo. A carga do upstream também varia ao longo do dia e afeta as conclusões, então é preciso repetir os testes em horários diferentes. Além disso, todos os critérios de cálculo deste artigo são sugestões de método e não incluem dados de desempenho medidos nem faturas reais de nenhuma plataforma. A decisão final ainda deve considerar os limites do seu próprio negócio e os termos do contrato.
Pontos essenciais do gateway proxy de API para Modelos de Linguagem Grande — principais conclusões
- Confiabilidade precisa ser definida pelo aceite do negócio: o faturamento bem-sucedido na plataforma, o 200 recebido pelo cliente e a validação do parsing pela aplicação são três coisas que precisam ser contadas separadamente.
- Latência exige dois pontos de medição: o TTFT define a experiência de interação, e o tempo total de conclusão define a capacidade de entrega — ambos precisam ser olhados no p95.
- RPM e concorrência precisam ser registrados separadamente: um RPM baixo ainda pode acumular muita concorrência em voo; a referência de limitação de taxa deve vir da medição real na conta alvo.
- Custo se calcula por resultado utilizável: todo o gasto já liquidado dividido pelo número de resultados utilizáveis pelo negócio, com retentativas e fallbacks entrando no numerador.
- O fallback precisa distinguir troca de canal de troca de modelo: modelo final, funcionalidade central, teto de custo e tempo máximo de espera — quatro itens validados um a um.
- Dados e responsabilidade dependem de cláusulas executáveis: os logs têm janela de retenção, e o SLA precisa de critério estatístico, itens de exclusão e forma de compensação.
- Caminho para começar: primeiro rode uma amostra pequena no APIYI apiyi.com cobrindo as colunas de capacidade e de latência, e só depois avance para teste de carga e conferência de contrato.
Resumo
Julgar se um serviço proxy de API e gateway de Modelos de Linguagem Grande é confiável é, no fundo, uma questão de levantamento de evidências, não de impressão. Se você decompor o “dá para usar ou não” em cinco camadas — resultados utilizáveis pelo negócio, latência ponta a ponta, custo por resultado utilizável, cadeia de dados e responsabilidade em falhas — e deixar um registro verificável em cada uma, a maior parte dos imprevistos vira item conhecido antes do go-live.
Na hora de colocar em prática, lembre de três coisas: a conclusão descreve apenas o escopo, nunca um ranking; o critério traz só o que você mesmo mediu, nunca o print de tela de outra pessoa; e a evidência vai só até onde dá para reconferir, porque logs expiram. Com esses três pontos, a discussão de seleção deixa de depender de quem fala mais alto.
A recomendação é começar com uma rodada de aceite de amostra pequena no APIYI apiyi.com — a plataforma oferece interface unificada e cota gratuita de testes, o que facilita colocar vários modelos na mesma tabela de comparação.
Materiais de referência
- Tokens e grupos da APIYI: explicação sobre múltiplas Keys, cotas, grupos de recursos e grupos de fallback
- Link:
docs.apiyi.com/faq/token-and-groups -
Descrição: conferir a alocação de Keys, os grupos de recursos e o mecanismo de canais principal/backup
-
Política de retenção e limpeza de logs da APIYI: detalhes sobre a rotação, retenção e exportação de logs
- Link:
docs.apiyi.com/faq/log-retention-policy -
Descrição: confirmar a janela de armazenamento próprio dos detalhes necessários para conciliação e auditoria
-
Detalhamento dos logs da APIYI: escopo de ativação e período de retenção dos logs de troubleshooting
- Link:
docs.apiyi.com/faq/user-logs-control -
Descrição: verificar os níveis de log em toda a cadeia de dados
-
Nota de segurança de dados da APIYI: política de não armazenar entradas e saídas por padrão
- Link:
docs.apiyi.com/faq/data-security -
Descrição: ler em conjunto com as políticas da camada upstream, camada por camada
-
Garantia de SLA da APIYI: reposição de cota e escopo previsto em contrato
- Link:
docs.apiyi.com/faq/sla-guarantee -
Descrição: entender a forma de compensação por falhas e seus limites de responsabilidade
-
Como entender o valor cobrado nos logs: campos de faturamento e critérios de multiplicador
- Link:
docs.apiyi.com/faq/log-billing-explained -
Descrição: usado para calcular o custo real de cada resultado aproveitável
-
Log concluído e cobrado, mas o cliente não recebe a resposta: diferença entre timeout do cliente e cobrança da plataforma
- Link:
docs.apiyi.com/faq/log-duration-vs-client-wait -
Descrição: leitura obrigatória para investigar pedidos anômalos
-
Link:
openrouter.ai/docs/guides/routing/provider-selection -
Descrição: entender a diferença entre troca de canal e troca de modelo
-
Model Fallbacks do OpenRouter: fallback de modelos e critérios reais de cobrança
- Link:
openrouter.ai/docs/guides/routing/model-fallbacks - Descrição: como o mercado trata o modelo final efetivo e a atribuição da cobrança
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial da APIYI apiyi.com; mais documentos estão disponíveis no centro de documentação em docs.apiyi.com


