
Ein Large-Language-Model-API (Großes Sprachmodell) von einem Drittanbieter in die Produktion zu bringen, ist nie deshalb schwierig, weil die erste Codezeile endlich läuft. Ob ein Projekt stabil ausgeliefert werden kann, entscheidet sich an den Problemen im ersten Monat nach dem Go-live, die man vorher nicht sieht: Die Anfrage kommt zurück, aber im falschen Format. Der Client läuft in einen Timeout, die Plattform bucht aber trotzdem ab. Der Hauptkanal fällt aus, und der Fallback wechselt unbemerkt auf ein teureres Modell. Und drei Monate später will man etwas nachvollziehen und stellt fest, dass die Logs längst gelöscht sind.
Dies ist nicht schon wieder ein Empfehlungsartikel nach dem Motto „Welche API-Plattform ist die beste“. Ich wiederhole hier keine Adjektive von den Werbeseiten der Anbieter und erstelle auch kein Plattform-Ranking. Es geht um eine konkrete, praktisch umsetzbare Frage: Welche überprüfbaren Belege haben Sie vor dem Go-live in der Hand, um zu beurteilen, ob ein API-Proxy-Dienst bzw. Gateway für Große Sprachmodelle verlässlich ist?
Der Nutzen für Sie: Nach der Lektüre haben Sie eine Prüfmethode aus einer Abnahme-Checkliste mit 7 Punkten und einer Ergebnistabelle. Damit wird aus „fühlt sich okay an“ ein „belegbar“.
Erst die Begriffe: diese sechs Wörter verstehen, bevor es um den Livegang geht
Bevor wir über Abnahmeverfahren sprechen, sollten wir ein paar Begriffe klären, die immer wieder auftauchen. In Anbieterdokumentationen und Fachartikeln werden sie oft unterschiedlich verwendet – und genau diese Uneinheitlichkeit ist selbst ein Risiko für den Livegang.
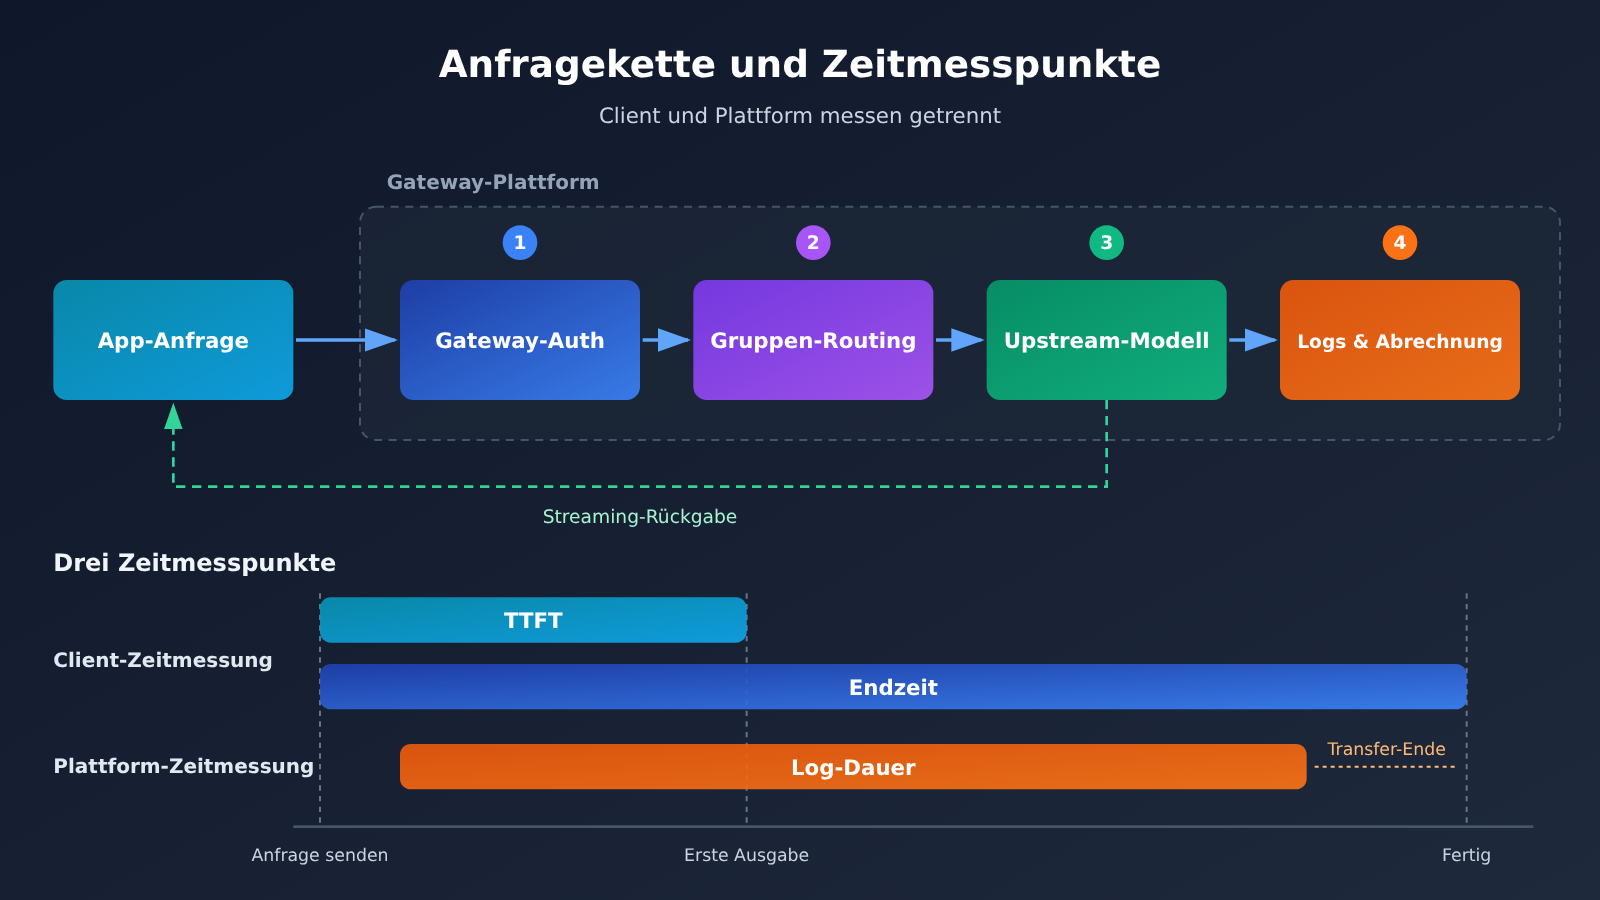
- API-Gateway: der Einstiegspunkt, der Anfragen der Anwendung entgegennimmt und an den vorgelagerten Modelldienst weiterreicht. Meist übernimmt er gleichzeitig vier Aufgaben – Authentifizierung, Abrechnung, Routing und Logging. Ein fehlgeschlagener Aufruf kann daher in jeder dieser Schichten auftreten; die Zuständigkeit muss vorab geklärt sein.
- TTFT (Time to First Token): die Zeit von der Anfrage bis zum Eintreffen des ersten gültigen Ausgabe-Tokens. Bei interaktiven Streaming-Anwendungen nimmt der Nutzer diesen Wert wahr, nicht die Gesamtdauer der kompletten Antwort.
- p95: der Kennwert, den rund 95 % der Stichproben nicht überschreiten. Ein Mittelwert verdeckt langsame Anfragen – erst p95 macht die kleine Gruppe von Aufrufen sichtbar, die „gelegentlich mal eben zehn Sekunden hängen“.
- RPM und Parallelität: RPM ist die Anzahl der pro Minute gestarteten Anfragen, Parallelität die Anzahl der Anfragen, die im selben Moment noch in Ausführung sind. Je länger eine Anfrage läuft, desto höher kann die Zahl der gleichzeitig offenen Anfragen selbst bei niedriger RPM werden – beide Werte müssen deshalb getrennt erfasst werden.
- Fallback (Ausweichlösung): der Mechanismus, mit dem bei nicht erfüllbaren Anfragen ein Ersatzkanal oder ein Ersatzmodell versucht wird. Bei der Abnahme sind dann auch das tatsächlich verwendete Modell, die Kernfunktionen, die Kostengrenze und die Datenrichtlinien zu prüfen – nicht nur, ob die Anfrage überhaupt erfolgreich war.
- SLA: Service Level Agreement, also die vertragliche Regelung zu Kennzahlen, Messumfang, Verantwortung bei Störungen und Entschädigungsbedingungen. Es ist eine durchsetzbare Vereinbarung, kein Prozentsatz, den man für sich allein zitieren kann.
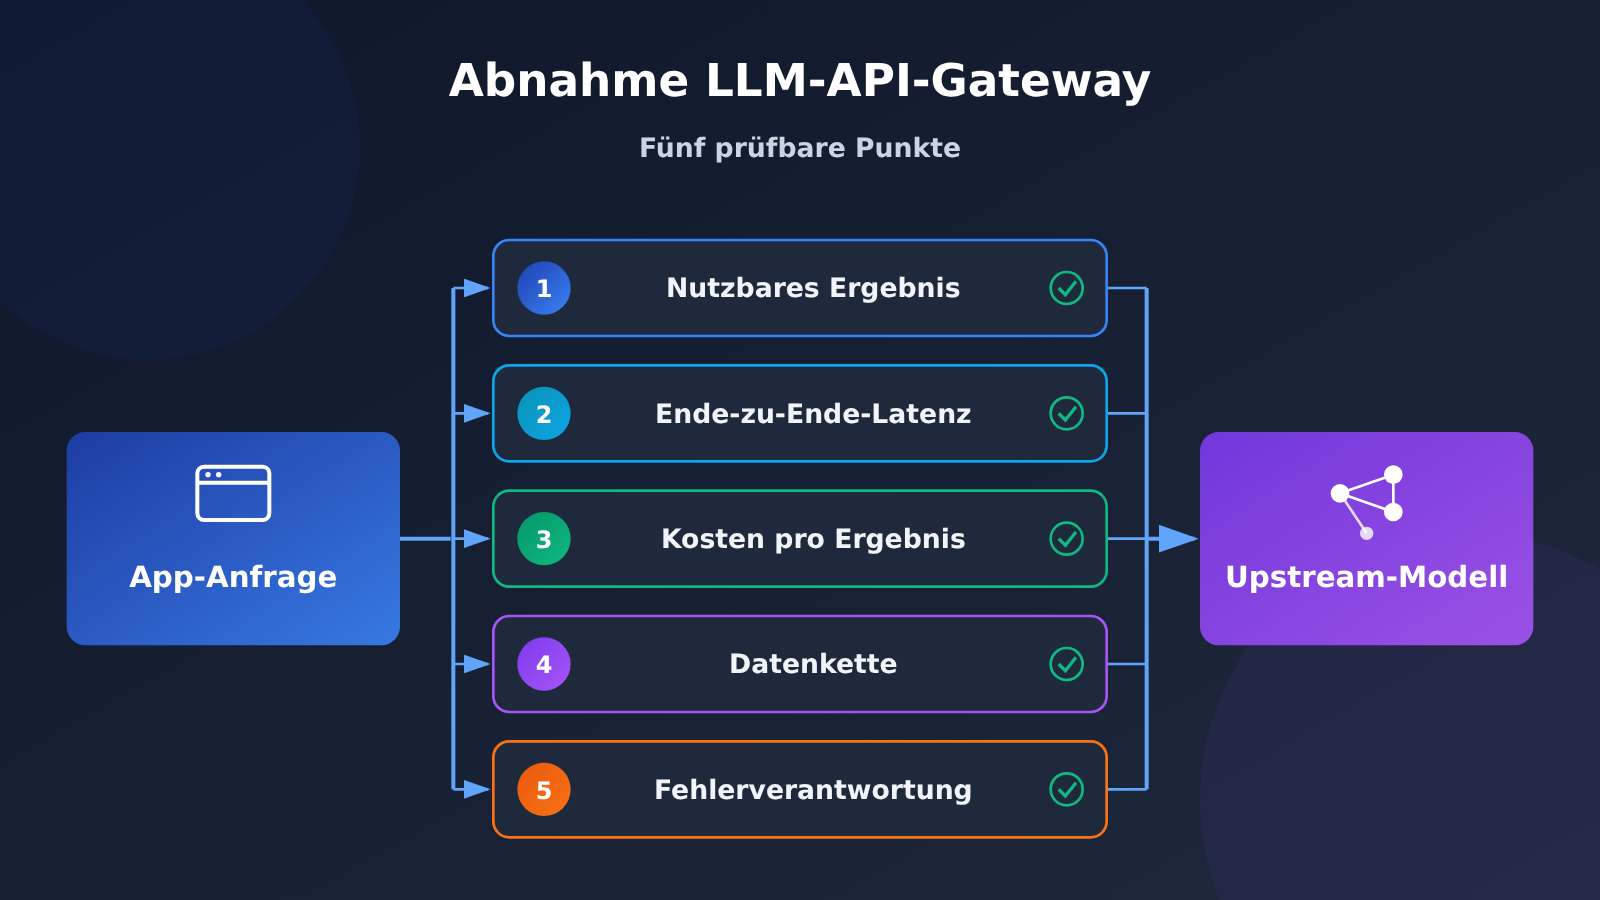
Kerninfo: Die Zuverlässigkeit eines Gateways lässt sich in 5 Prüfebenen aufteilen
Der Wert eines Großes-Sprachmodell-API-Proxys bzw. -Gateways liegt in der einheitlichen Schnittstelle. Genau diese Bequemlichkeit verdeckt aber Unterschiede in den darunterliegenden Schichten. Hinter einer OpenAI-kompatiblen base_url können völlig unterschiedliche Upstream-Anbieter, Ratenbegrenzungen, Log-Aufbewahrungsregeln und Störungsprozesse stecken.
Für die Entscheidung über den Produktivbetrieb reicht deshalb die Frage „Läuft der Aufruf durch?“ nicht aus. Drei Dinge müssen gleichzeitig betrachtet werden: Ist das Ergebnis brauchbar? Ist die Wartezeit akzeptabel? Lassen sich Auffälligkeiten nachverfolgen? Die folgende Tabelle schlüsselt diese drei Fragen in 5 Prüfebenen auf. Sie bildet zugleich das Gerüst der fünf Abschnitte dieses Artikels.
| Prüfebene | Zu beantwortende Frage | Beurteilungsgrundlage | Typische Fehleinschätzung |
|---|---|---|---|
| Geschäftlich nutzbares Ergebnis | Kann die zurückgegebene Antwort direkt in den Geschäftsprozess übernommen werden? | Anzahl vollständiger Antworten, Anzahl formal verwendbarer Antworten, Anzahl der Antworten, die die fachliche Prüfung bestehen | HTTP 200 mit Erfolg gleichsetzen |
| End-to-End-Latenz | Wie lange wartet der Nutzer, bis er den ersten brauchbaren Ausgabeabschnitt sieht? | p50 und p95 von TTFT und Abschlusszeit, getrennt auf Client- und Plattformseite gemessen | Nur auf die durchschnittliche Dauer schauen |
| Kosten pro nutzbarem Ergebnis | Wie viel kostet jedes brauchbare Ergebnis tatsächlich? | Alle abgerechneten Ausgaben geteilt durch die Anzahl geschäftlich nutzbarer Ergebnisse | Nur Einzelpreise vergleichen, nicht aber Wiederholungen und Fallbacks |
| Datenpfad | Wer sieht Ein- und Ausgaben, wie lange werden sie gespeichert, und wer darf sie einsehen? | Richtlinien je Schicht: Gateway, Upstream, Logs, asynchrone Artefakte | Transportverschlüsselung mit Unlesbarkeit der Inhalte verwechseln |
| Störungsverantwortung | Nach welchen Maßstäben wird ein Vorfall bewertet, und wie wird entschädigt? | Erfassungszeitraum des SLA, Ausschlüsse, Antragsprozess und Form der Entschädigung | Öffentliche Hinweise mit vertraglichen Zusagen verwechseln |
🎯 Technischer Tipp: Kopieren Sie diese Tabelle als Abnahmetabelle in Ihr eigenes Team. Jede Zeile braucht eine Nachweisquelle. Wenn Sie zunächst die Aufrufkette zum Laufen bringen wollen, können Sie über APIYI (apiyi.com) ein Testguthaben erhalten und mit demselben Skript mehrere Modelle im Vergleich protokollieren.
Warum Zuverlässigkeit als fachliche Abnahmebedingung definiert werden sollte
Eine einheitliche Schnittstelle senkt den Integrationsaufwand, schiebt aber auch eine Reihe von Entscheidungen, die früher zur Infrastruktur gehörten, zu den Anwendungsteams. Früher mussten Sie Retry-Logik und mehrere SDKs selbst pflegen. Heute genügt es, die base_url auszutauschen, um viele Modelle anzusprechen. Der Preis dafür: Sie sehen weniger von dem, was auf dem Weg zwischen Ihrer Anwendung und dem Modell passiert.
Der erste Schritt der Abnahme ist deshalb nicht der Performance-Test, sondern eine klare Definition von „verfügbar“. Dass die Plattform eine Anfrage erfolgreich abrechnet, der Client ein 200 erhält und die fachliche Auswertung durchläuft, sind drei verschiedene Dinge, und sie müssen getrennt gezählt werden. Ein JSON mit ungültiger Struktur bleibt für das Geschäft ein Ergebnis von null, selbst wenn die Plattform die Anfrage ordnungsgemäß abgeschlossen hat. Kosten verursacht es trotzdem.
Der zweite Schritt: das Testset nach Geschäftsszenario aufteilen. Bei interaktiven Frage-Antwort-Szenarien zählen die Zeit bis zur ersten brauchbaren Ausgabe und das Zeitlimit für die vollständige Antwort. Bei Tool-Aufrufen prüft man, ob die Parameterstruktur gültig ist und alle Felder vorhanden sind. Bei Batch-Verarbeitung ist entscheidend, wie viele brauchbare Ergebnisse bis zum Abgabetermin vorliegen. Wer alle drei Szenarien in einer „durchschnittlichen Antwortzeit“ zusammenwirft, kommt zwangsläufig zu einem verzerrten Ergebnis.
Der dritte Schritt: die Zeitmessung vereinheitlichen. Die Wartezeit auf dem Client und die in den Plattform-Logs erfasste Dauer decken nicht dieselben Phasen ab. Die offizielle Dokumentation beschreibt ausdrücklich Fälle, in denen die Plattform eine Anfrage als erfolgreich verbucht und abrechnet, der Client aber wegen der Antwortübertragung oder des Verbindungsabschlusses in ein Timeout läuft. Auch wenn im Hintergrund automatisch andere Routen probiert werden, verlängert sich die Gesamtwartezeit. Bei jeder Auffälligkeit sollten Sie daher zuerst anhand von Geschäftsnummer und request_id den Client-Eintrag, das Plattform-Log und die Guthabenänderung abgleichen. Erst danach entscheiden Sie, ob ein Retry sinnvoll ist.
Wie man Gateway-Fähigkeiten und Spitzenlast mit einer festen Testaufgabe prüft
Soll ein Test reproduzierbar sein, müssen zuerst die Variablen fixiert werden: Zielmodellversion, Kanal oder Gruppe, Aufrufschnittstelle, Kernparameter, Netzzugang, Größe von Eingabe und Ausgabe, Streaming ja oder nein. Ändert sich auch nur einer dieser Punkte, lassen sich die Daten zweier Durchläufe nicht mehr nebeneinander stellen. Die Stichproben müssen aus echten, anonymisierten Geschäftsdaten stammen – nicht aus Spielzeug-Eingaben wie „Hallo“.
Die folgende Tabelle ist eine Vorlage für ein Abnahmeprotokoll, das man direkt einsetzen kann. Sie ist eine Methodenempfehlung und enthält keine Messergebnisse irgendeiner Plattform. Die Schwellenwerte setzt der Geschäftsbedarf selbst: Ein interaktiver Task verlangt vielleicht, dass die erste brauchbare Ausgabe innerhalb einer bestimmten Sekundenzahl vorliegt, ein Offline-Job, dass innerhalb weniger Stunden eine bestimmte Menge verwertbarer Ergebnisse geliefert wird.
| Dimension | Empfohlene Erfassung | Bewertung |
|---|---|---|
| Erfolgreiche Lieferung im Geschäftssinn | Anzahl Anfragen, vollständig zurückgegeben, formal verwertbar, fachlich abgenommen | Nenner vollständig angeben, am Ende zählt der Anteil geschäftlich nutzbarer Ergebnisse |
| Latenz | Startzeit, Zeitpunkt der ersten brauchbaren Ausgabe, Abschlusszeit, Dauer laut Plattform-Log | Client und Plattform getrennt messen, p50 und p95 ausweisen |
| Kernfähigkeiten | Streaming-Abschluss, Gültigkeit der Tool-Parameter, Parsen strukturierter Ausgaben, Verarbeitung langer Eingaben | Punkt für Punkt abnehmen, entlang der Fähigkeiten, auf die das eigene Produkt wirklich angewiesen ist |
| Spitzenlast | Gleichzeitig laufende Anfragen, Anfragen pro Minute, 429-Anteil, Warteschlange und Retries | Anfrageumfang konstant halten, stufenweise erhöhen und Beobachtungsfenster einplanen |
| Kosten | Abbuchung pro Aufruf, Rückerstattungen, Auffangkosten, Anzahl nutzbarer Ergebnisse | Gesamtkosten pro nutzbarem Ergebnis berechnen |
| Nachvollziehbarkeit | Geschäftsvorgangsnummer, request_id, Modell und Gruppe, Fehlercode, Antwort auf das Ticket | Jeder auffällige Auftrag muss sich einer Plattform-Aufzeichnung zuordnen lassen |
Das folgende Skript tut nur eines: Es hält beim Streaming-Aufruf gleichzeitig den Zeitpunkt der ersten brauchbaren Ausgabe und die Gesamtdauer fest, damit man die Client-Messung und das Plattform-Log auf derselben Zeitachse vergleichen kann.
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话说明什么是 API 网关"}],
    stream=True,
)
ttft = None
for chunk in stream:
    delta = chunk.choices[0].delta.content
    if delta and ttft is None:
        ttft = time.perf_counter() - start
total = time.perf_counter() - start
print(f"TTFT {ttft:.3f}s / total {total:.3f}s")
Code für Batch-Lasttest und Quantilsstatistik anzeigen
import statistics
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle
)

def one_call(prompt: str) -> dict:
    start = time.perf_counter()
    ok, ttft = False, None
    try:
        stream = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user", "content": prompt}],
            stream=True,
        )
        for chunk in stream:
            delta = chunk.choices[0].delta.content
            if delta and ttft is None:
                ttft = time.perf_counter() - start
        ok = True
    except Exception as exc:
        return {"ok": False, "ttft": None,
                "total": time.perf_counter() - start, "err": type(exc).__name__}
    return {"ok": ok, "ttft": ttft,
            "total": time.perf_counter() - start, "err": None}

def summarize(rows: list) -> None:
    done = [r for r in rows if r["ok"]]
    totals = sorted(r["total"] for r in done)
    print(f"成功率 {len(done)}/{len(rows)}")
    if totals:
        print(f"p50 {statistics.median(totals):.3f}s")
        print(f"p95 {totals[int(len(totals) * 0.95) - 1]:.3f}s")

rows = [one_call("把下面这句话翻译成英文:请检查订单状态。") for _ in range(50)]
summarize(rows)
Der häufigste Fehler beim Lasttest: RPM und Nebenläufigkeit werden in einen Topf geworfen. Anfragen pro Minute, Tokens pro Minute und gleichzeitig laufende Anfragen sind drei verschiedene Beschränkungen, und keine ersetzt die andere. Steigt die Latenz, verstärken Wiederholungsversuche zusätzlich die Last auf das System. Deshalb gehören in jedes Skript eine lokale Warteschlange, eine maximale Wartezeit und Retries mit begrenztem Backoff.
Ein Detail geht dabei leicht unter: Die Dokumentation von APIYI beschreibt den Geltungsbereich der Ratenbegrenzung auf der Seite „Nebenläufigkeit“ nicht ganz deckungsgleich mit der Seite „Tokens und Gruppen“. Die erste erwähnt, dass die Kontingente mehrerer Tokens unabhängig voneinander gelten, die zweite sagt, dass die Begrenzung dem Konto folgt. Bei der Abnahme gehst du am besten so vor: Miss das tatsächliche Kontingent mit deinem eigenen Zielkonto und dem Zielkanal und halte Nebenläufigkeit und RPM getrennt fest. Übernimm also keine festen Zahlen aus fremden Screenshots, und versuche nicht, die Begrenzung durch das Anlegen zusätzlicher Keys zu umgehen.
Wie man Kosten pro nutzbarem Ergebnis und das Fallback-Verhalten prüft
Aussagekräftiger als der Stückpreis ist der Blick auf die tatsächlichen Kosten pro geschäftlich nutzbarem Ergebnis. Die Rechnung ist simpel: In den Zähler kommen alle abgerechneten Ausgaben – inklusive Wiederholungen und Fallbacks –, in den Nenner die Zahl der nutzbaren Ergebnisse. Bestätigte Erstattungen werden vom Zähler abgezogen.
Das folgende Beispiel ist rein hypothetisch und zeigt nur die Rechenlogik, nicht die Preise irgendeines Anbieters.
| Variante | Abgerechnete Nettoausgaben | Geschäftlich nutzbare Ergebnisse | Kosten pro nutzbarem Ergebnis |
|---|---|---|---|
| Variante A | 3,0 US-Dollar | 90 Stück | ca. 0,0333 US-Dollar |
| Variante B | 3,2 US-Dollar | 98 Stück | ca. 0,0327 US-Dollar |
Nur auf die Ausgaben geschaut, ist Variante A günstiger; rechnet man pro nutzbarem Ergebnis, steht Variante B besser da. Genau deshalb ist die Frage „Wer ist billiger?“ ohne den geschäftlichen Nenner sinnlos. Zwei Dinge sollte man dabei im Auge behalten: Asynchrone Aufgaben, deren Kontingent bereits reserviert, aber noch nicht abgerechnet ist, gehören in eine eigene Position. Und wer nur die Verbrauchsaufzeichnungen aufsummiert, überschätzt unter Umständen die Nettoausgaben, weil Erstattungen für asynchrone Aufgaben als negative Posten in der Abrechnung auftauchen.
Beim Fallback muss man zwei grundlegend verschiedene Vorgänge auseinanderhalten. Kanalwechsel bedeutet: Unter demselben Modell wird auf eine andere Leitung ausgewichen, Modellfähigkeiten und Preis bleiben theoretisch unverändert. Modellwechsel bedeutet: Ist das Hauptmodell nicht verfügbar, werden der Reihe nach andere Modelle aus einer Liste probiert – branchenüblich ist das etwa bei den model fallbacks von OpenRouter, die ausdrücklich sagen, dass am Ende zum Preis des tatsächlich genutzten Modells abgerechnet wird und dass das Feld model der Antwort das endgültig verwendete Modell ausweist. Dieses Beispiel dient nur der Erläuterung des Mechanismus; die Bedeutung der Felder lässt sich nicht auf andere Plattformen übertragen.
Die Abnahmekriterien sollten daher mindestens vier Punkte abdecken: welches Modell nach dem Fallback letztlich läuft, ob die Kernfunktion noch erfüllt ist, ob es eine Obergrenze für die Kosten eines einzelnen Aufrufs gibt und wie lang die maximale Wartezeit ist. Ist bei einer Geschäftsart ein Modellwechsel nicht zulässig, muss zusätzlich geklärt sein, ob sich der Fallback abschalten lässt. Streaming-Fälle sind separat zu testen: ob sich nach einem Fehler, wenn bereits ein Teil der Ausgabe zurückgekommen ist, nahtlos anknüpfen lässt – das kann man nicht aus einem erfolgreichen nicht-streamenden Fallback ableiten.
💡 Empfehlung für die Auswahl: Erst wenn Direktpreise und Fallback-Pfad in einer gemeinsamen Tabelle stehen, werden die echten Kosten sichtbar. Wer schnell echte Abrechnungsdaten über mehrere Modelle als Vergleichsbasis braucht, kann über APIYI (apiyi.com) eine kleine Stichprobe laufen lassen und die Werte anschließend in die eigene Abnahmetabelle eintragen.
Wie Sie Datenpfad und Haftung bei Störungen prüfen
Aussagen wie „Wir sind sicher“ oder „Wir sind stabil“ lassen diese beiden Punkte gern unter den Tisch fallen. Dabei sind es genau die Punkte, die Ihnen im Ernstfall helfen. Am besten prüfen Sie sie, indem Sie Gateway, vorgelagerte Modellanbieter, detaillierte Fehlersuch-Logs und asynchrone Ergebnisse auf demselben Datenpfad aufreihen und für jede Stufe die jeweilige Richtlinie hinterfragen.
| Stufe im Datenpfad | Zu prüfende Richtlinie | Vorgehen bei der Prüfung |
|---|---|---|
| Gateway selbst | Werden Ein- und Ausgaben standardmäßig gespeichert? Wer kann Fehlersuch-Logs aktivieren, und wie lange werden sie aufbewahrt? | Offizielle Hinweise zu Datensicherheit und Logs lesen |
| Vorgelagerter Modellanbieter | Verwendung für Trainingszwecke, Aufbewahrungsdauer, ob eine aktive Einwilligung nötig ist | Die Richtlinien der einzelnen Anbieter getrennt lesen und nicht zu einer zusammenfassen |
| Detaillierte Fehlersuch-Logs | Umfang der Aufzeichnung, wer sie einsehen kann, Standard-Aufbewahrungsdauer, Löschzeitpunkt nach dem Abschalten | Klären, dass das Abschalten nicht bedeutet, dass bestehende Einträge sofort gelöscht werden |
| Ergebnisse asynchroner Aufgaben | Speicherort der Ergebnisse, Gültigkeitsdauer der Download-Links | Ergebnisse rechtzeitig auf Ihrer Seite sichern und sich nicht auf temporäre Links verlassen |
Laut öffentlicher Dokumentation speichert APIYI Ein- und Ausgaben von Kunden standardmäßig nicht. Administratoren können detaillierte Fehlersuch-Logs vorübergehend aktivieren, die vollständige Eingaben, Kontext und Ausgaben erfassen. Die Inhalte sind nur für Administratoren sichtbar, und die auf der Seite genannte Standard-Aufbewahrungsdauer beträgt 7 bis 30 Tage. Zugleich weist die Seite darauf hin, dass das Abschalten des Aufzeichnungsschalters nicht so zu verstehen ist, dass bestehende Einträge sofort gelöscht wurden. Solche Angaben sollten Sie stets als „laut offizieller Dokumentation“ kennzeichnen. Sie sind weder eine Compliance-Zertifizierung noch eine rechtliche Bewertung.
Eine weitere Betriebsrealität wird oft übersehen: Logs haben selbst einen Lebenszyklus. In der Sonderseite von APIYI zur Log-Aufbewahrung steht, dass Aufruf-Logs rollierend für die letzten rund zwei Monate gespeichert werden. Am 5., 15. und 25. jedes Monats werden Einträge gelöscht, die älter als zwei Monate sind. Die Bereinigung lässt sich nicht rückgängig machen, und Details, die Sie für langfristigen Abgleich und Audits brauchen, müssen Sie selbst exportieren und archivieren. Bei synchronen Ergebnissen und asynchronen Ergebnissen gelten wiederum andere Aufbewahrungsfristen: Laut Seite sind Download-Links für Ergebnisse etwa einen Tag lang gültig. Wer erst nach Ablauf dieses Fensters nachforscht, hat keine Belege mehr in der Hand.
Die Haftung bei Störungen muss sich an konkreten, umsetzbaren Klauseln festmachen lassen. Die SLA-Sonderseite von APIYI beschreibt, dass bei Verlusten, die auf die Plattform zurückgehen, Guthaben nachgebucht wird. Unternehmen können außerdem im Vertrag den Leistungsumfang, Verfügbarkeitskennzahlen, Reaktionszeiten und Haftungsobergrenzen vereinbaren. Eine einheitliche, feste Verfügbarkeitsquote für alle Kunden nennt die Seite nicht. Wenn Sie Anbieter vergleichen, notieren Sie sich daher den Messzeitraum der Kennzahlen, die Definition des Nenners, Ausschlüsse für Störungen, den Antragsprozess und die Form der Entschädigung. Achten Sie dabei klar auf den Unterschied im Einkaufswert zwischen einer Entschädigung in Serviceguthaben und einer Entschädigung in Geld.
Mit einer Abnahmetabelle den Einsatzbereich festlegen
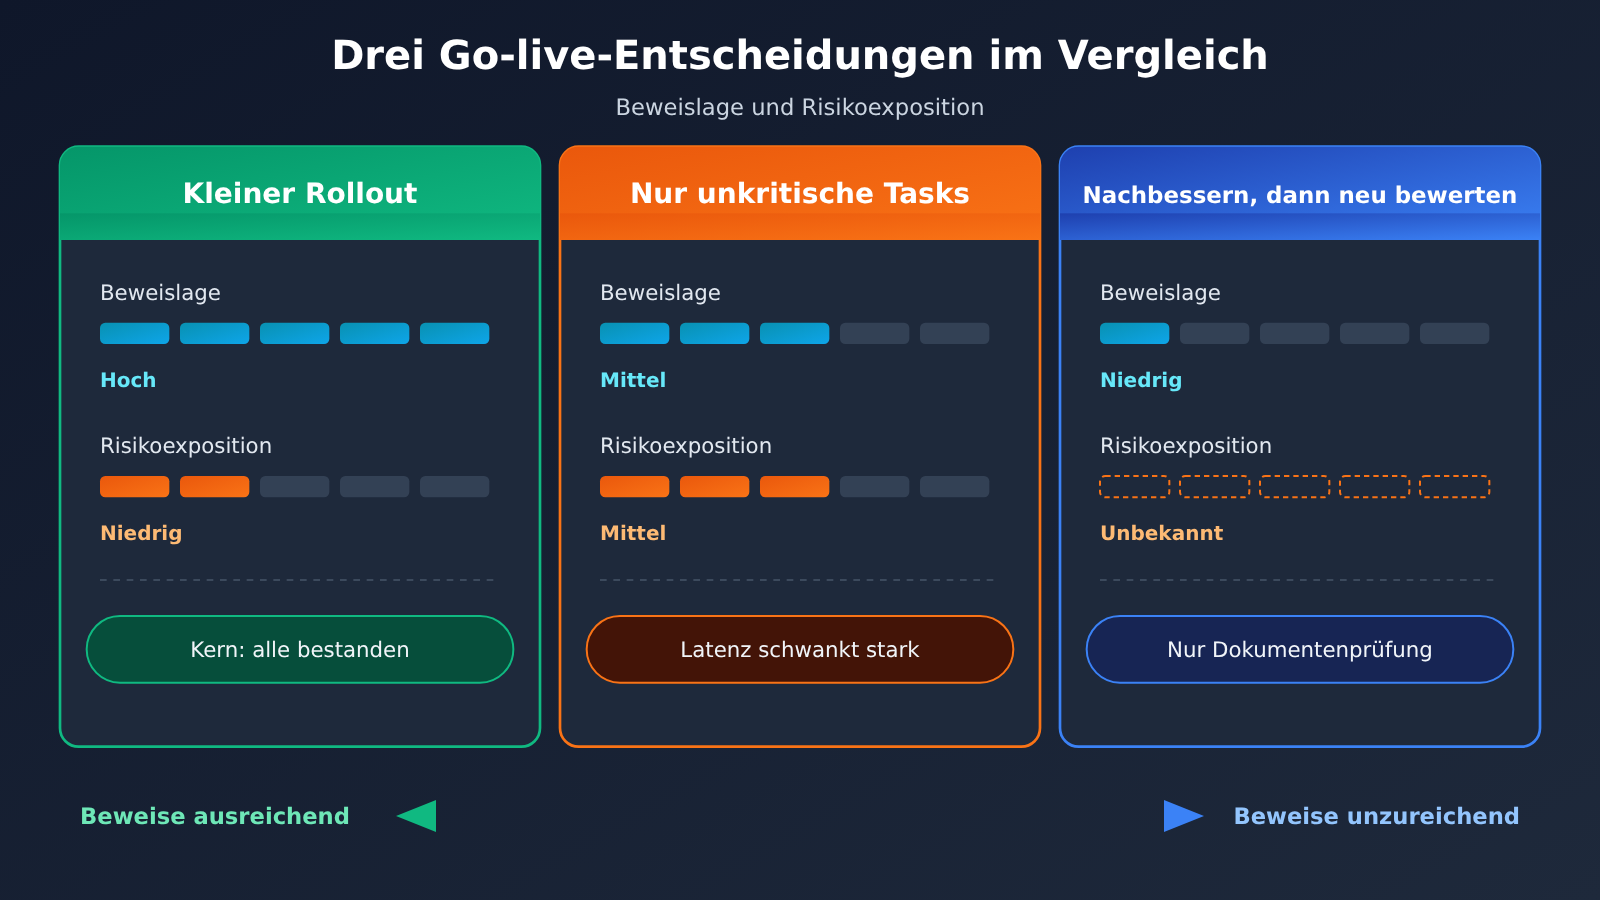
Wenn Sie alle Aufzeichnungen zu einem Fazit bündeln, liefern Sie kein „Zuverlässigkeits-Ranking“, sondern eine Einschätzung des Einsatzbereichs. Derselbe Anbieter mag für Ihre interaktiven Anwendungen nur für „unkritische Aufgaben“ reichen – für Ihre Offline-Batchverarbeitung ist er womöglich völlig ausreichend.
| Fazit | Erforderliche Nachweise | Auslöser für Wechsel oder Abbruch |
|---|---|---|
| Begrenzter Produktivstart möglich | Kernfähigkeiten Punkt für Punkt bestanden, p95 innerhalb der Geschäftsschwellen, Kosten für brauchbare Ergebnisse akzeptabel, Datenkette und SLA geprüft | Die geschäftliche Verfügbarkeitsquote fällt wiederholt unter den Schwellenwert, oder Abrechnungsauffälligkeiten lassen sich nicht klären |
| Nur für unkritische Aufgaben | Fähigkeiten bestehen, aber die Latenz schwankt stark, oder ein Fallback verändert Modell und Kosten | Kritische Pfade zurück auf Eigenbetrieb oder Direktverbindung, Fallback-Strategie explizit abgeschaltet |
| Erst nach Vervollständigung der Bedingungen neu bewerten | Nur Dokumentenprüfung, eigene Messungen im eigenen Konto fehlen, oder SLA-Klauseln sind nicht vertraglich verankert | Nach Ergänzung der Messdaten und Vertragsklauseln neu bewerten |
Wenn vorerst nur eine Dokumentenprüfung möglich ist, formulieren Sie das Fazit wahrheitsgemäß als „öffentlich dokumentierte Fähigkeiten und Beschaffungsbedingungen geprüft“ und verschieben Sie die eigentliche Abnahme auf die nächste Runde. Müssen Sie das Störungsverhalten prüfen, nutzen Sie die vom Anbieter freigegebene Testkonfiguration oder eine isolierte Umgebung und beeinträchtigen Sie keinen gemeinsam genutzten Produktivdienst. Bei Timeouts mit unklarem Ergebnis prüfen Sie zuerst Ausführung und Abrechnung, damit dieselbe Geschäftsaktion nicht doppelt ausgeführt wird.
🚀 Schnellstart: Wenn Sie das Testskript nicht von Grund auf selbst bauen möchten, können Sie mit dem kostenlosen Testkontingent von APIYI apiyi.com zunächst die Spalten „Fähigkeiten“ und „Latenz“ aus der obigen 7-Punkte-Checkliste durchlaufen und danach entscheiden, ob Sie in die aufwendigere Lasttestphase einsteigen.
Häufig gestellte Fragen (FAQ)
Q1: Was sind LLM-API-Proxys und Gateways eigentlich?
Sie bilden die Eingangsschicht zwischen Ihrer Anwendung und den vorgelagerten Modelldiensten. Nach dem Empfang einer Anfrage übernehmen sie Authentifizierung, Abrechnung, Routing und Logging. Das Wort „Proxy“ betont, dass mehrere Modellanbieter hinter einer einzigen kompatiblen Schnittstelle zusammengeführt werden. Sie gewinnen dadurch Komfort bei der Anbindung, verlieren aber ein Stück Einblick in die darunterliegende Strecke.
Q2: Wo liegt der Zuverlässigkeitsunterschied zwischen direkter Anbindung an die offizielle API und einem Proxy-Gateway?
Der Unterschied liegt in der Zahl der Schichten und in der Verteilung der Verantwortung. Bei der direkten Anbindung müssen Sie nur einen Upstream beurteilen. Mit einem Gateway kann jede von drei Schichten zur Fehlerquelle werden: das Gateway selbst, der Gruppenkanal und der Upstream-Anbieter. Dafür gibt es aber auch eine zusätzliche Absicherung und die Chance auf einheitliche Logs. Entscheidend ist nicht, wer schneller ist, sondern dass Sie die fünf Ebenen aus diesem Artikel einzeln belegen.
Q3: Warum reicht die durchschnittliche Latenz nicht aus?
Der Durchschnitt verdeckt einzelne extrem langsame Anfragen, und genau diese lösen oft die Beschwerden der Nutzer aus. Bei Streaming-Interaktionen sollten Sie außerdem TTFT (Time to First Token) und die Gesamtdauer bis zum Abschluss getrennt erfassen. Geben Sie dazu Stichprobengröße und Zeitfenster an und vermerken Sie, ob Fehler, Warteschlangen und Wiederholungsversuche enthalten sind. Sonst ist auch ein p95-Wert nicht vergleichbar.
Q4: Die Anfrage war erfolgreich, aber der Inhalt ist unbrauchbar – ist das ein Plattformproblem?
In der Regel nicht, aber die Kosten fallen trotzdem an. Schließt die Plattform die Anfrage normal ab, wird sie abgerechnet. Ungültige Ausgabestrukturen müssen auf Ihrer Seite per Wiederholung abgefangen werden. Diese doppelten Ausgaben gehören in den Zähler der „Kosten pro nutzbarem Ergebnis“. Deshalb sollte Ihre Abnahmetabelle zwei Spalten haben: „Plattform hat erfolgreich ausgeführt“ und „fachlich als bestanden bewertet“.
Q5: Wie prüfe ich schnell, ob ein Gateway meine Anwendung tragen kann?
Nehmen Sie Ihre eigenen anonymisierten Stichproben und legen Sie Modell, Kanal, Parameter und Eingabegröße fest. Führen Sie dann eine kleine Testrunde durch und halten Sie TTFT, p95, den Anteil fachlich nutzbarer Ergebnisse und die Abrechnungsdetails fest. Ein Testkontingent dafür können Sie über APIYI (apiyi.com) erhalten. Tragen Sie die Daten anschließend in die Abnahmetabelle ein, statt aus einem einzigen Verbindungstest ein Urteil abzuleiten.
Q6: Welche bekannten Einschränkungen hat diese Methode?
Das p95 schwankt bei kleinen Stichproben stark und taugt nicht als langfristiges Leistungsversprechen. Auch unterschiedliche Upstream-Lasten zu verschiedenen Tageszeiten beeinflussen das Ergebnis, daher sollten Sie die Tests zu mehreren Zeitpunkten wiederholen. Zudem sind alle Berechnungsansätze in diesem Artikel Methodenvorschläge. Sie enthalten weder gemessene Leistungsdaten noch echte Rechnungen einer Plattform. Das endgültige Urteil müssen Sie weiterhin anhand Ihrer eigenen fachlichen Schwellenwerte und Vertragsbedingungen treffen.
Kernpunkte für API-Proxy-Gateways großer Sprachmodelle – Key Takeaways
- Zuverlässigkeit wird über die Abnahme im Geschäftsbetrieb definiert: eine erfolgreiche Abrechnung auf der Plattform, ein HTTP-200 beim Client und eine sauber durchlaufende Auswertung im Fachprozess sind drei Dinge, die getrennt voneinander gezählt werden müssen.
- Latenz braucht zwei Messpunkte: Die TTFT entscheidet über das Interaktionsgefühl, die vollständige Durchlaufzeit über die Lieferfähigkeit – beide gehören als p95 auf den Tisch.
- RPM und Parallelität getrennt erfassen: Auch eine niedrige RPM-Zahl kann viele gleichzeitig laufende Anfragen erzeugen. Wie die Drosselungsgrenze tatsächlich liegt, zeigt erst der Test mit dem Zielaccount.
- Kosten pro nutzbarem Ergebnis rechnen: alle abgerechneten Ausgaben geteilt durch die Zahl der betrieblich nutzbaren Ergebnisse – Retries und Fallbacks gehören in den Zähler.
- Beim Fallback Kanalwechsel und Modellwechsel auseinanderhalten: Endmodell, Kernfunktion, Kostenobergrenze und maximale Wartezeit – vier Punkte, einzeln abzunehmen.
- Daten und Verantwortung: nur durchsetzbare Klauseln zählen: Logs haben ein Aufbewahrungsfenster, und ein SLA braucht eine klare statistische Definition, benannte Ausschlüsse und eine festgelegte Form der Kompensation.
- Einstiegspfad: Zuerst mit einem kleinen Sample über APIYI apiyi.com die beiden Spalten „Fähigkeit“ und „Latenz“ durchlaufen, danach Lasttest und Vertragsprüfung.
Fazit
Ob ein API-Proxy-Dienst und Gateway für große Sprachmodelle belastbar ist, ist im Kern eine Frage der Beweisführung und keine des Bauchgefühls. Zerlegt man „läuft es?“ in fünf Ebenen – nutzbare Ergebnisse im Betrieb, End-to-End-Latenz, Kosten pro nutzbarem Ergebnis, Datenweg und Verantwortung im Störfall – und hinterlässt zu jeder Ebene nachprüfbare Aufzeichnungen, dann werden die meisten Überraschungen schon vor dem Go-live zu bekannten Größen.
Für den Rollout drei Dinge merken: In den Schlussfolgerungen nur den Messbereich nennen, kein Ranking; bei den Kennzahlen nur schreiben, was man selbst gemessen hat, nicht was auf fremden Screenshots steht; bei den Belegen nur so weit gehen, wie eine Nachprüfung möglich bleibt – denn Logs verfallen. Wer diese drei Punkte einhält, muss in der Auswahlentscheidung nicht mehr danach gehen, wer lauter ruft.
Für den Start empfiehlt es sich, über APIYI apiyi.com zunächst eine Abnahmerunde mit einem kleinen Sample zu fahren. Die Plattform bietet eine einheitliche Schnittstelle und ein kostenloses Testkontingent, sodass sich mehrere Modelle bequem in einer einzigen Tabelle vergleichen lassen.
Referenzen
- APIYI Token und Gruppen: Erläuterung zu mehreren Keys, Kontingenten, Ressourcengruppen und Fallback-Gruppen
- Link:
docs.apiyi.com/faq/token-and-groups -
Hinweis: Zur Prüfung der Key-Zuweisung, der Ressourcengruppen und des Primär-/Backup-Kanal-Mechanismus
-
APIYI Richtlinie zur Aufbewahrung und Bereinigung von Logs: Rollierende Aufbewahrung und Export von Logs
- Link:
docs.apiyi.com/faq/log-retention-policy -
Hinweis: Klärt, in welchem Zeitfenster Sie die für Abgleich und Audit nötigen Details selbst sichern müssen
-
APIYI Erläuterung zu detaillierten Logs: Aktivierungsumfang und Aufbewahrungsdauer der Logs für die Fehlersuche
- Link:
docs.apiyi.com/faq/user-logs-control -
Hinweis: Zur Prüfung der Log-Ebenen entlang der Datenstrecke
-
APIYI Datensicherheit: Erläuterung der Richtlinie, standardmäßig weder Eingaben noch Ausgaben zu speichern
- Link:
docs.apiyi.com/faq/data-security -
Hinweis: Am besten im Vergleich mit den Richtlinien der Upstream-Anbieter lesen
-
APIYI SLA-Garantie: Nachvergütung von Kontingent und vertraglich vereinbarter Umfang
- Link:
docs.apiyi.com/faq/sla-guarantee -
Hinweis: Zeigt, in welcher Form und in welchem Rahmen bei Störungen entschädigt wird
-
So verstehen Sie die Abrechnungsbeträge im Log: Abrechnungsfelder und Multiplikatoren
- Link:
docs.apiyi.com/faq/log-billing-explained -
Hinweis: Dient zur Berechnung der tatsächlichen Kosten pro nutzbarem Ergebnis
-
Log zeigt „abgeschlossen und abgerechnet“, aber der Client erhält keine Antwort: Unterschied zwischen Client-Timeout und Plattformabrechnung
- Link:
docs.apiyi.com/faq/log-duration-vs-client-wait -
Hinweis: Pflichtlektüre bei der Untersuchung auffälliger Aufträge
-
Link:
openrouter.ai/docs/guides/routing/provider-selection -
Hinweis: Hilft, den Unterschied zwischen Kanalwechsel und Modellwechsel zu verstehen
-
OpenRouter Model Fallbacks: Modell-Fallback und tatsächliche Abrechnungslogik
- Link:
openrouter.ai/docs/guides/routing/model-fallbacks - Hinweis: Zeigt, wie die Branche das finale Modell und die Zuordnung der Abrechnung handhabt
Autor: APIYI Technik-Team
Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI (apiyi.com). Weitere Dokumentation finden Sie im Dokumentationszentrum unter docs.apiyi.com


