
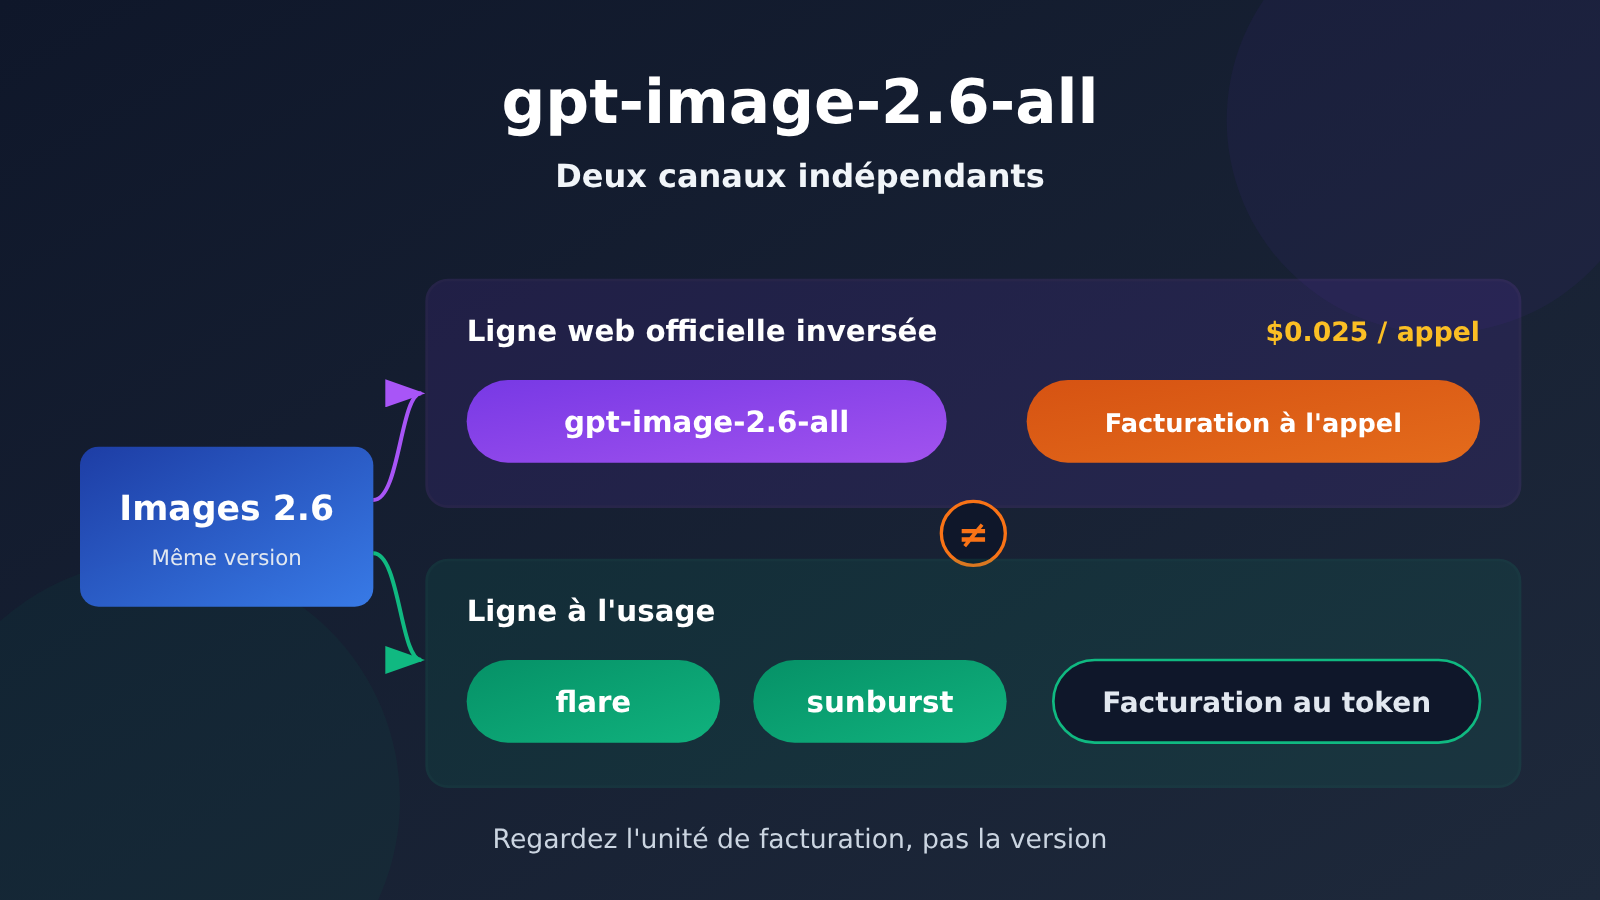
gpt-image-2.6-all est sorti le 2026-11-11 à 20h30. Le all dans son nom a poussé beaucoup de monde à penser que « toute la gamme 2.6 est fusionnée en un seul modèle ». Ce n’est pas le cas : les notes de version d’APIYI (apiyi.com) sont claires, ce modèle correspond à la ligne « officielle rétro-conçue » (官逆) d’Images 2.6 sur la version web de ChatGPT. Il reprend donc la logique d’appel de l’interface web, et c’est un canal indépendant de la ligne à l’usage utilisée par flare et sunburst.
Ce n’est pas un simple empilement de numéros de version. flare et sunburst forment l’autre ligne de la 2.6 et sont facturés au volume de tokens. all, lui, est facturé à l’appel, à 0,025 $ par requête. Deux modes de facturation différents, c’est le signe que les deux lignes ne reposent pas sur le même service en coulisses.
L’essentiel : après cette lecture, vous pourrez déterminer en 30 secondes, grâce à 4 paramètres, à quelle ligne appartient un nom de modèle. Vous éviterez ainsi de calculer vos coûts pour all (à l’appel) comme s’il s’agissait de flare (à l’usage).
gpt-image-2.6-all : l’essentiel en un coup d’œil
Commençons par poser les informations clés de l’annonce, pour éviter les confusions dues aux noms similaires.
| Élément | Détail | Remarque |
|---|---|---|
| Date de mise en ligne | 2026-11-11 20:30 | Heure de l’annonce, données datées du 2026-11-12 |
| Ligne d’appartenance | Ligne officielle rétro-conçue d’Images 2.6 sur ChatGPT web | Logique d’appel identique à la version web |
| Mode de facturation | À l’appel, 0,025 $ / requête | Indépendant de la consommation de tokens |
| Paramètres de requête pris en charge | size, n, background, output_format | Nouveaux par rapport à 2.5-all |
| Autres modèles de la même famille | gpt-image-2.6-flare, gpt-image-2.6-sunburst | Appartiennent à la ligne à l’usage |
| Plateforme disponible | APIYI apiyi.com | Appel via une interface unifiée |
Un mot sur le terme « officielle rétro-conçue » (官逆). Il désigne une ligne d’appel obtenue en reconstituant, par rétro-ingénierie, l’interface du client web officiel. La structure des requêtes reste identique à celle de la version web : les paramètres contrôlables depuis le web le sont donc généralement aussi sur cette ligne. Cela explique pourquoi all propose justement quelques paramètres de plus que 2.5-all : il suit le comportement du client web, pas les conventions de paramètres de la ligne à l’usage.
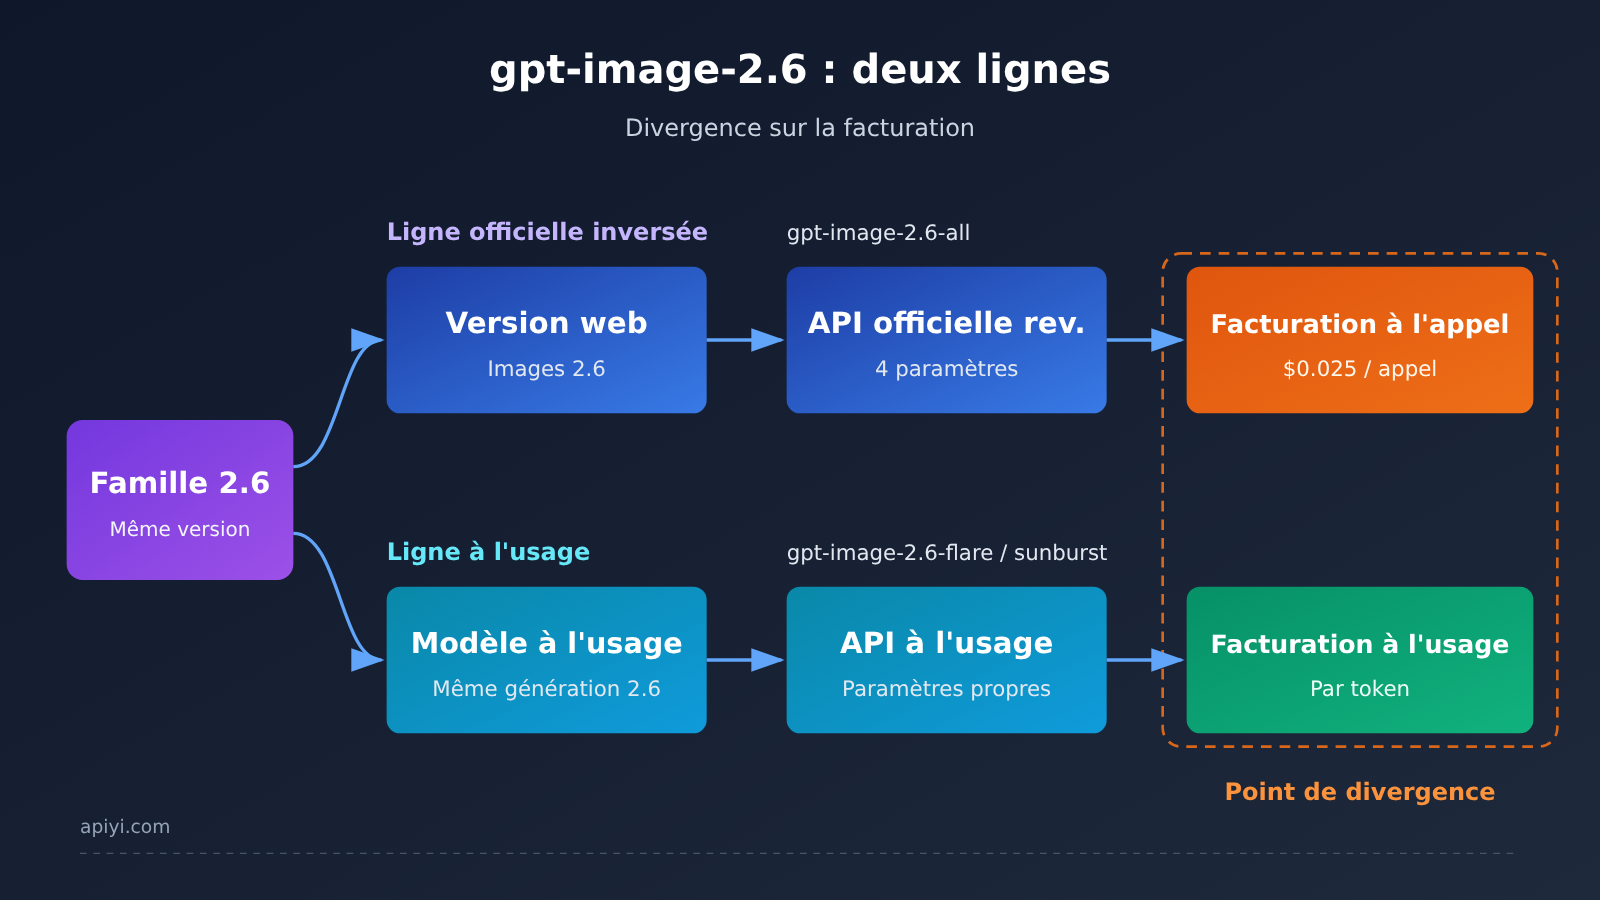
Légende : les deux lignes se séparent sur le mode de facturation, pas sur le numéro de version du modèle. Pour vérifier à quelle ligne appartient un modèle, comparez point par point avec les notes de version d’APIYI sur apiyi.com.
gpt-image-2.6-all et Flare : les vraies différences
L’erreur la plus fréquente, c’est de traiter 2.6 comme un bloc unique. En réalité, dès qu’on sépare les modèles par ligne d’accès, les différences se concentrent sur trois points.
| Critère | gpt-image-2.6-all | gpt-image-2.6-flare / sunburst |
|---|---|---|
| Nature de la ligne | Ligne officielle en rétro-ingénierie de la version web | Ligne à l’usage |
| Unité de facturation | Par appel, 0,025 $ / appel | Facturation au volume de tokens |
| Contrôle des paramètres | Prend en charge size, n, background, output_format | Conventions de paramètres propres à la ligne à l’usage |
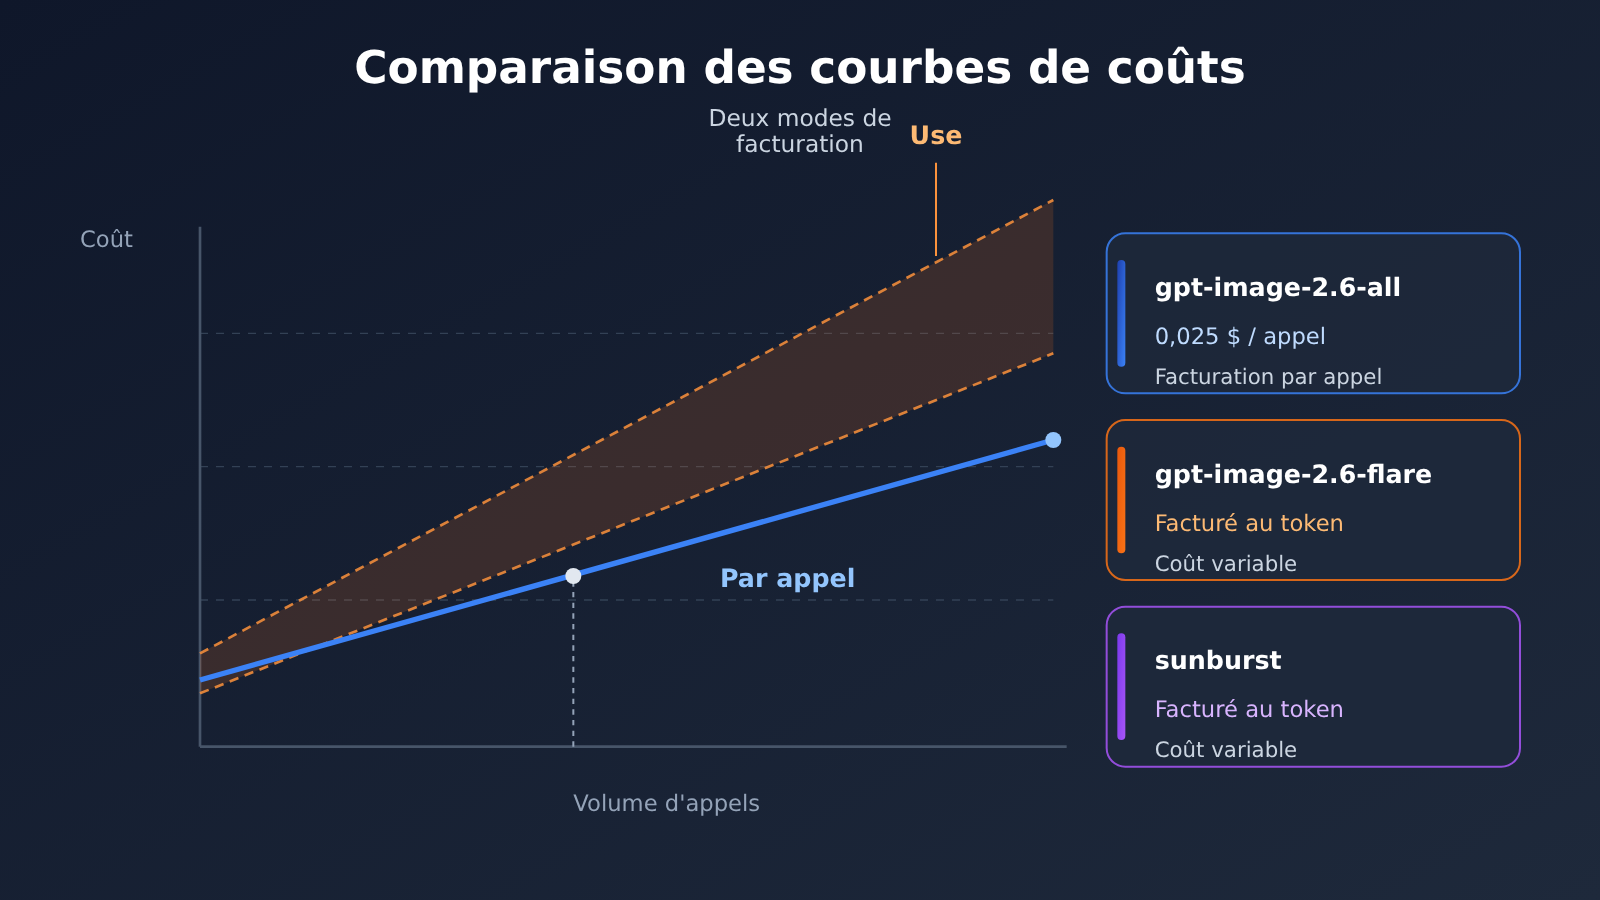
| Évolution du coût selon le nombre d’appels | Proportionnelle au nombre d’appels | Dépend du nombre de tokens réellement consommés |
| Mode de calcul adapté | Budget par nombre d’images | Budget par volume de trafic |
gpt-image-2.6-flare est plus souple pour la facturation à l’usage : il convient bien aux situations où le volume de requêtes fluctue beaucoup et où l’on accepte que le coût varie avec la longueur du contenu. En revanche, son coût ne suit pas le nombre d’images, donc il faut d’abord estimer la consommation de tokens pour établir un budget. À l’inverse, gpt-image-2.6-all est plus simple à prévoir côté coûts : 1 000 appels, c’est le prix de 1 000 appels, sans conversion supplémentaire.
Cet écart se creuse encore dans les scénarios de traitement par lots. Pour un projet facturé à l’appel, on peut inscrire directement le coût unitaire par image dans le devis ; pour un projet facturé à l’usage, il faut d’abord lancer un échantillon, puis faire le calcul à rebours. Aucune des deux approches n’est meilleure que l’autre : tout dépend de leur adéquation avec votre modèle économique.
💡 Conseil de choix : si vous ne savez pas à quelle ligne appartient votre modèle, regardez d’abord l’unité de facturation plutôt que le numéro de version. La liste des modèles sur APIYI (apiyi.com) affiche les points d’entrée des deux lignes, ce qui permet de les tester en parallèle.
Ce que révèlent les 4 paramètres de gpt-image-2.6-all
Dans l’annonce, la phrase « contrairement à 2.5-all, il accepte size, n, background et output_format » en dit plus qu’il n’y paraît.
| Paramètre | Rôle | Ce qu’il nous apprend |
|---|---|---|
size |
Définit la taille de sortie | Les formats d’image proposés dans la version web peuvent être reproduits au niveau de l’API |
n |
Renvoie plusieurs images en une seule requête | On peut générer des images par lots en un seul appel, ce qui est plus avantageux avec une facturation à l’appel |
background |
Contrôle le traitement de l’arrière-plan | L’interrupteur clé pour les besoins de fond transparent |
output_format |
Définit le format de sortie | Détermine directement si un post-traitement de conversion est nécessaire |
Ces 4 paramètres relèvent tous du « contrôle à la requête » : on dit au serveur ce qu’on veut au moment de l’envoi, plutôt que de retoucher le résultat après coup. La ligne facturée à l’usage a généralement son propre jeu de paramètres, mais ce n’est pas celui-ci. Quand un modèle prend en charge ces 4 paramètres, on peut donc en déduire qu’il repose sur la ligne « officielle rétro-conçue » de la version web.
À l’inverse, le fait que 2.5-all ne les prenne pas en charge montre que la couverture des paramètres sur cette ligne se complète progressivement, au fil des évolutions de la version web. La génération 2.6 comble ce manque. Le « all » du nom désigne une prise en charge complète des paramètres, pas la fusion de tous les modèles de la gamme.
🎯 Conseil technique : ajoutez dans votre service une couche de validation des paramètres, en utilisant
size,n,backgroundetoutput_formatcomme critères de routage. Vos requêtes seront alors automatiquement dirigées vers la bonne ligne. APIYI apiyi.com propose une interface compatible OpenAI : pour changer de modèle, il suffit de modifier le champmodel.
Comment appeler gpt-image-2.6-all
L’appel ne diffère pas d’une API d’images classique : il suffit de pointer base_url vers le point d’entrée unifié, et le plus important est d’écrire correctement le nom du modèle.
- Adresse de l’API :
https://api.apiyi.com/v1 - Nom du modèle :
gpt-image-2.6-all - Paramètres recommandés :
size,n,background,output_format
Ce sont ces quelques champs du corps de la requête qui reflètent la différence entre les lignes. Si le serveur renvoie une erreur de paramètre non pris en charge, c’est généralement que le nom du modèle est flare ou sunburst alors que la requête contient une combinaison de paramètres propre à la version web.
🚀 Démarrage rapide : APIYI (apiyi.com) offre un crédit de test gratuit. Après inscription, les nouveaux utilisateurs obtiennent une clé API : remplacez
base_urlparhttps://api.apiyi.com/v1, utilisez le même code pour basculer entre all et flare et comparer. En quelques minutes, vous saurez quelle ligne correspond le mieux à votre structure de coûts.
Ce que le lancement de gpt-image-2.6-all change pour les développeurs
Cette nouveauté a un impact sur trois plans.
- Le calcul des coûts change : avec une facturation à l’appel à 0,025 $, le coût par image devient une constante. Le budget d’un projet en lot se calcule directement par multiplication, sans avoir à lancer d’abord un échantillon pour estimer les tokens. Pour les équipes qui doivent chiffrer un devis client, c’est plus utile que les paramètres de performance.
- Les paramètres s’alignent sur la version web : avec
size,n,backgroundetoutput_formatdésormais disponibles, la plupart des réglages possibles sur le web peuvent être reproduits au niveau de l’API, ce qui réduit l’écart du type « réglable sur le web, impossible via l’API ». - Identifier la ligne devient indispensable : pour une même génération de modèle, il existe désormais deux lignes, l’une facturée à l’appel et l’autre à l’usage, et le suffixe du nom du modèle est le seul critère de distinction. Noter uniquement le numéro de version dans la gestion de configuration ne suffit plus.
Un point facile à négliger : combiné à la facturation à l’appel, le paramètre n fait baisser encore le coût unitaire quand un seul appel produit plusieurs images. Cela ne change pas le mode de facturation, mais cela influence la stratégie : combien d’images demander par requête ?
💰 Optimisation des coûts : pour les projets sensibles au budget, vous pouvez d’abord utiliser le crédit gratuit d’APIYI (apiyi.com) pour valider toute la chaîne d’appel, puis déduire la dépense mensuelle à partir du nombre réel d’images. C’est plus proche de la réalité qu’une estimation basée sur une grille tarifaire.
FAQ sur gpt-image-2.6-all
Q1 : Qu’est-ce que gpt-image-2.6-all, concrètement ?
C’est un modèle issu de la ligne « officielle rétro-conçue » (官逆) de Images 2.6, la fonctionnalité de génération d’images de ChatGPT version web. Il est facturé à l’appel, au prix de 0,025 $ par requête. Le `all` dans le nom indique que l’ensemble des paramètres est pris en charge, pas qu’il regroupe toute la gamme.
Q2 : Quelle différence entre gpt-image-2.6-all et gpt-image-2.6-flare ?
Ni la ligne d’accès ni la facturation ne sont les mêmes. Le modèle all passe par la ligne rétro-conçue de la version web et se facture à l’appel. Flare et sunburst appartiennent à la ligne à l’usage et se facturent au volume de tokens. Il ne s’agit pas de deux niveaux d’un même modèle, mais de deux canaux indépendants.
Q3 : Pourquoi all prend-il en charge size, n, background et output_format ?
Parce qu’il reproduit la structure de requête de l’interface web. Ce que l’on peut contrôler côté web, la ligne rétro-conçue peut généralement le contrôler aussi. La version 2.5-all, elle, ne dispose pas de ces paramètres, ce qui suggère que la couverture des paramètres s’est complétée au fil des itérations de la version web.
Q4 : Dans quels cas la facturation à l’appel est-elle adaptée ?
Elle convient surtout quand le nombre d’appels est prévisible et que le coût par image doit figurer dans un devis. La facturation à l’usage convient mieux aux projets dont le trafic fluctue beaucoup et qui acceptent que le coût varie selon le contenu.
Q5 : Comment appeler gpt-image-2.6-all rapidement ?
Inscrivez-vous sur une plateforme qui prend en charge ce modèle et récupérez votre clé API. Définissez ensuite `base_url` sur `https://api.apiyi.com/v1` et indiquez `gpt-image-2.6-all` comme nom de modèle. APIYI (apiyi.com) propose une interface compatible OpenAI ainsi qu’un crédit de test gratuit. Avec le même code, il suffit de changer le champ `model` pour basculer entre all et flare et comparer les résultats.
Q6 : Y a-t-il des points d’attention pour ce lancement ?
Le principal : ne considérez pas `2.6` comme un bloc unique. Dans cette même génération, une ligne à l’appel et une ligne à l’usage coexistent. Si vous ne notez que le numéro de version dans votre configuration, vous risquez des erreurs dans le calcul des coûts. Par ailleurs, l’annonce se concentre sur trois points : la ligne d’accès, les paramètres et la facturation. Pour le reste, reportez-vous à la documentation à venir.
gpt-image-2.6-all : les points clés (Key Takeaways)
- Origine de la ligne : correspond à la ligne de rétro-ingénierie officielle (« 官逆 ») de Images 2.6 dans la version web de ChatGPT, et non à une ligne facturée à l’usage.
- Facturation : à l’appel, 0,025 $ par requête, sans lien avec la consommation de tokens.
- Paramètres pris en charge :
size,n,backgroundetoutput_formatsont supportés, ce qui n’est pas le cas de 2.5-all. - Distinction au sein de la famille : flare et sunburst appartiennent à une autre ligne, facturée à l’usage, avec un mode de facturation totalement différent.
- Comment les reconnaître : l’unité de facturation et la combinaison de paramètres sont plus fiables que le numéro de version.
- Pour démarrer : via l’interface unifiée d’APIYI (apiyi.com), il suffit de faire pointer
base_urlvershttps://api.apiyi.com/v1pour vérifier tout ça.
Conclusion
À propos de gpt-image-2.6-all, il y a trois choses à retenir :
- C’est la ligne web en rétro-ingénierie officielle, pas Flare : elle appartient à un canal distinct de flare et sunburst, il ne s’agit pas du même modèle décliné en plusieurs niveaux.
- Facturation à l’appel, pas à l’usage : 0,025 $ par requête, le coût évolue donc linéairement avec le nombre d’appels, ce qui rend le budget plus simple à calculer qu’avec une ligne facturée à l’usage.
- Les 4 paramètres font foi : si
size,n,backgroundetoutput_formatapparaissent dans les capacités du modèle, vous pouvez à peu près être sûr qu’il s’appuie sur la ligne web en rétro-ingénierie officielle.
Un même numéro de version ne signifie pas une même ligne. La prochaine fois que vous verrez un nom de modèle commençant par 2.6 dans une configuration, vérifiez d’abord le mode de facturation, puis décidez où le placer.
Si vous voulez comparer les performances réelles des deux lignes, le plus simple est de les tester via APIYI (apiyi.com) : la plateforme propose des crédits gratuits et une interface unifiée pour plusieurs modèles, et il suffit de modifier le champ model pour passer de l’un à l’autre.
Références
- Notes de version APIYI – Mise en ligne de gpt-image-2.6-all : source d’origine pour le rattachement des lignes, la prise en charge des paramètres et le mode de facturation
- Lien :
docs.apiyi.com/live/2026-11/gpt-image-2-6-all-launch -
Description : contient la date de mise en ligne, le prix à l’appel et la présentation des modèles de la même famille ; données datées du 12 novembre 2026
-
Liste des modèles APIYI : permet de consulter les modèles disponibles et leurs points d’accès
- Lien :
apiyi.com - Description : sert à vérifier le rattachement des lignes all, flare et sunburst
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI (apiyi.com). Pour en savoir plus, rendez-vous dans le centre de documentation : docs.apiyi.com


