
서드파티 대규모 언어 모델 API를 프로덕션 환경에 연결할 때 어려운 부분은 첫 줄의 코드가 돌아가는 순간이 아니에요. 프로젝트를 안정적으로 납품할 수 있는지는 오픈 후 첫 한 달 동안 미리 볼 수 없었던 문제들이 결정해요. 요청은 돌아왔는데 형식이 틀렸거나, 클라이언트는 타임아웃이 났는데 플랫폼은 이미 과금했거나, 메인 채널이 죽자 폴백이 슬쩍 더 비싼 모델로 바꿔치기했거나, 석 달 뒤 복기하려고 보니 로그가 이미 지워진 경우처럼요.
이 글은 “어느 API 플랫폼이 더 좋은가”를 추천하는 또 하나의 글이 아니에요. 공급업체 홍보 페이지의 수식어를 되풀이하지도 않고, 플랫폼 순위를 매기지도 않아요. 여기서는 실제로 해볼 수 있는 한 가지만 다뤄요. 오픈 전에 어떤 검증 가능한 증거를 손에 쥐어야 대규모 언어 모델 API 중계 서비스와 게이트웨이가 믿을 만한지 판단할 수 있는가 하는 점이에요.
핵심 가치: 이 글을 읽고 나면 7개 항목의 검수 체크리스트와 결론표 1장으로 이루어진 점검 방법을 얻게 돼요. “그럭저럭 괜찮은 것 같은데”를 “근거가 있는 판단”으로 바꿔 보세요.
용어부터 정리해요: 오픈 전에 알아둘 6가지 용어
검수 방법을 이야기하기 전에, 이 글에서 반복해서 나오는 용어부터 맞춰 둘게요. 이 용어들은 공급업체 문서와 기술 문서마다 쓰임이 제각각인 경우가 많아요. 그리고 기준이 서로 다르다는 사실 자체가 오픈 리스크예요.
- API 게이트웨이: 애플리케이션의 요청을 받아 업스트림 모델 서비스로 넘겨 주는 진입점이에요. 보통 인증, 과금, 라우팅, 로그를 한꺼번에 맡기 때문에, 호출 한 번이 실패하더라도 원인은 경로상의 어느 계층에나 있을 수 있어요. 그래서 책임 소재를 먼저 구분해 둬야 해요.
- TTFT(첫 유효 출력까지의 시간): 요청을 보낸 시점부터 첫 번째 유효한 출력 토큰이 도착하기까지 걸리는 시간이에요. 스트리밍 방식 인터랙션에서 사용자가 체감하는 값은 전체 응답의 총 소요 시간이 아니라 이 값이에요.
- p95: 샘플의 약 95%가 넘지 않는 지표 값이에요. 평균은 느린 요청을 가려 버리지만, p95는 “가끔 십수 초씩 멈추는” 소수의 호출을 드러내 줘요.
- RPM과 동시성: RPM은 분당 보내는 요청 수이고, 동시성은 같은 시점에 아직 실행 중인 요청 수예요. 요청이 오래 걸리면 RPM이 낮아도 처리 중인 동시 요청이 많이 쌓일 수 있어서, 두 값은 따로 기록해야 해요.
- Fallback(폴백): 메인 서비스가 요청을 처리하지 못할 때 대체 채널이나 대체 모델을 시도하는 메커니즘이에요. 검수할 때는 요청이 성공했는지만 볼 게 아니라 최종 모델, 핵심 기능, 비용 상한, 데이터 정책을 함께 확인해야 해요.
- SLA: 서비스 수준 협약이에요. 지표의 산정 기준, 집계 범위, 장애 책임, 보상 조건을 약속해 두는 문서예요. 따로 떼어 인용할 수 있는 퍼센트 숫자가 아니라, 실제로 이행할 수 있는 약속이에요.
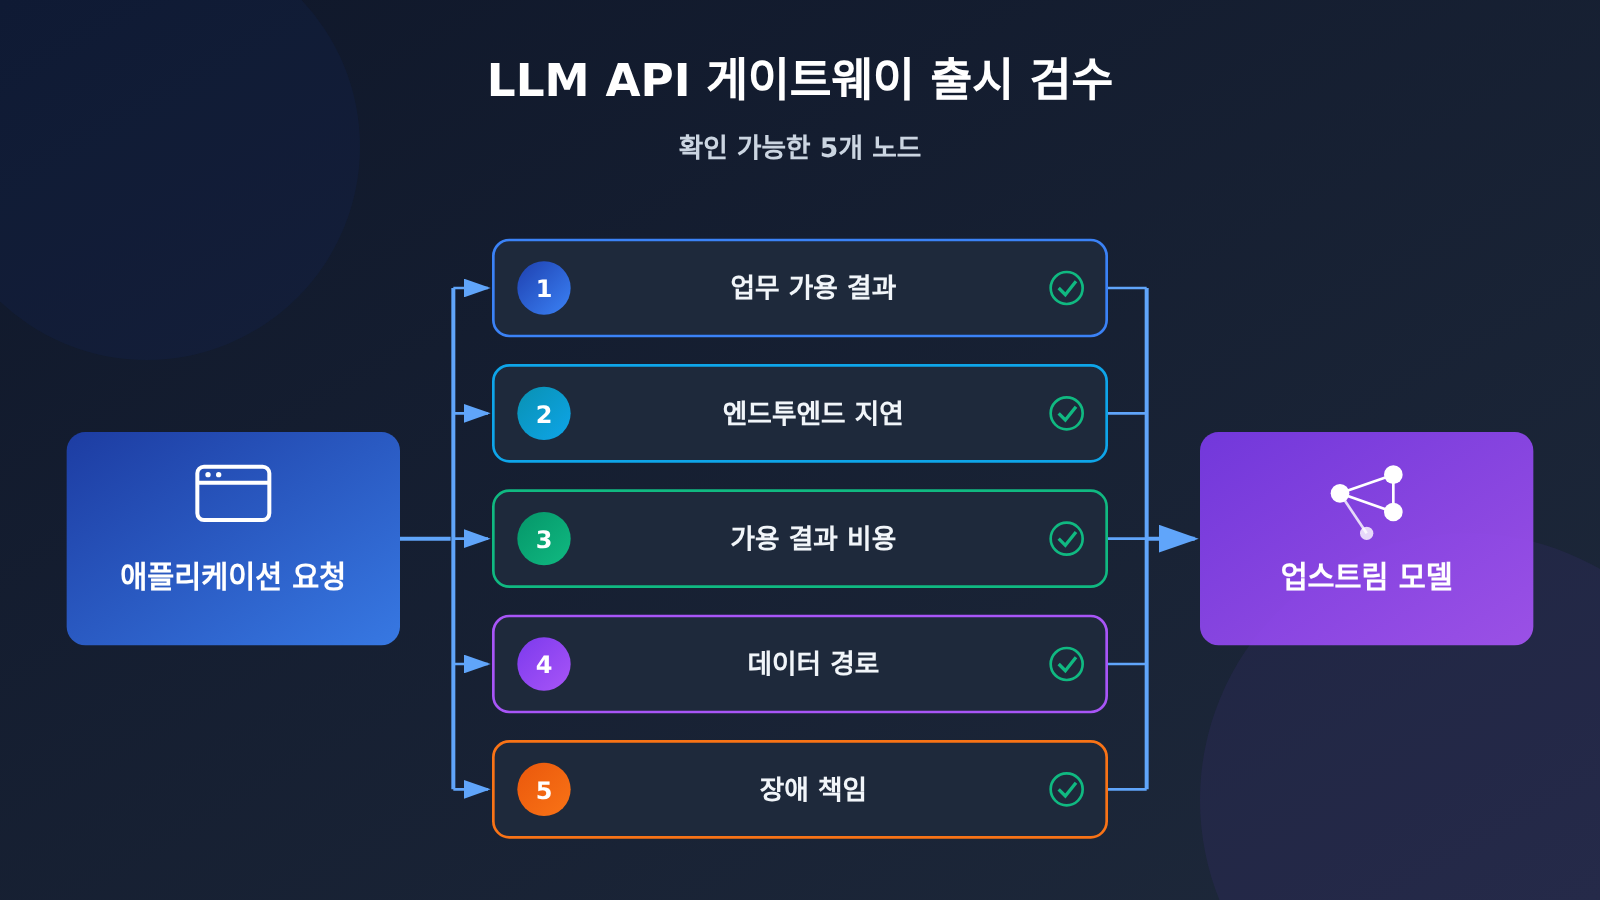
핵심 정보: 게이트웨이 신뢰성은 5가지 점검 층위로 나눠서 봐야 해요
대규모 언어 모델 API 중계와 게이트웨이의 가치는 인터페이스를 통일한다는 데 있어요. 그런데 그 통일된 인터페이스의 편리함 때문에 오히려 아래쪽의 차이가 가려지기도 해요. OpenAI 호환 base_url 뒤에는 전혀 다른 업스트림 공급업체, 서로 다른 속도 제한 정책, 다른 로그 보관 규칙, 다른 장애 처리 절차가 숨어 있을 수 있어요.
그래서 서비스 투입 여부를 판단할 때는 “호출이 되는가”만 물어서는 안 돼요. 결과를 쓸 수 있는지, 대기 시간을 받아들일 수 있는지, 이상이 생겼을 때 추적할 수 있는지를 함께 살펴봐야 해요. 아래 표는 이 세 가지를 5가지 점검 층위로 풀어 낸 것이고, 이 글 뒷부분의 다섯 개 절의 뼈대이기도 해요.
| 점검 층위 | 답해야 할 질문 | 판단 근거 | 흔한 오판 |
|---|---|---|---|
| 업무에서 쓸 수 있는 결과 | 반환된 내용을 바로 업무 흐름에 넣을 수 있는가 | 완전하게 반환된 건수, 형식이 유효한 건수, 업무 판정을 통과한 건수 | HTTP 200을 성공으로 간주함 |
| 엔드투엔드 지연 | 사용자가 첫 번째 유효한 출력을 보기까지 얼마나 기다리는가 | TTFT와 완료 시간의 p50, p95, 클라이언트와 플랫폼의 별도 측정 | 평균 소요 시간만 봄 |
| 사용 가능한 결과당 비용 | 쓸 수 있는 결과 하나에 실제로 얼마가 들었는가 | 정산이 끝난 전체 지출을 업무에서 쓸 수 있는 결과 수로 나눈 값 | 단가만 비교하고 재시도와 폴백은 비교하지 않음 |
| 데이터 경로 | 입력과 출력이 누구를 거치고, 얼마나 보관되고, 누가 볼 수 있는가 | 게이트웨이, 업스트림, 로그, 비동기 산출물별 정책 | 전송 구간 암호화를 내용을 읽을 수 없다는 뜻으로 오해함 |
| 장애 책임 | 사고가 났을 때 어떤 기준으로 인정하고 어떻게 보상하는가 | SLA의 집계 주기, 제외 항목, 신청 절차, 보상 형태 | 공개 설명을 계약상 약속으로 착각함 |
🎯 기술 팁: 이 표를 복사해서 팀만의 검수표로 만들어 보세요. 모든 행에는 반드시 근거 출처를 채워 넣어야 해요. 먼저 호출 경로를 돌려 봐야 한다면 APIYI(apiyi.com)에서 테스트 크레딧을 받아, 같은 스크립트로 여러 모델을 나란히 기록해 볼 수 있어요.
왜 신뢰성을 비즈니스 인수 조건으로 정의해야 할까요
통합 인터페이스 덕분에 연동 비용은 낮아졌지만, 원래 인프라 영역이던 판단 몇 가지가 애플리케이션 팀 앞으로 넘어왔어요. 예전에는 재시도 로직과 여러 SDK를 직접 관리해야 했지만, 이제는 base_url 하나만 바꾸면 다양한 모델을 호출할 수 있어요. 대신 요청이 지나가는 경로가 어떻게 흘러가는지는 잘 보이지 않게 됐죠.
그래서 인수 테스트의 첫 단계는 성능 측정이 아니라 ‘사용 가능’의 기준부터 분명히 정하는 일이에요. 같은 요청이라도 플랫폼에서 과금이 성공한 것, 클라이언트가 200을 받은 것, 비즈니스 쪽 파싱을 통과한 것은 서로 다른 세 가지 사건이므로 각각 따로 집계해야 해요. 구조가 올바르지 않은 JSON은 플랫폼이 요청을 정상적으로 끝냈더라도 비즈니스 입장에서는 결과물이 0인 셈인데, 비용은 그대로 발생해요.
두 번째 단계는 비즈니스 형태에 따라 테스트 세트를 나누는 거예요. 대화형 질의응답은 첫 유효 출력이 나오기까지의 시간과 전체 응답 완료 제한 시간을 봐요. 도구 호출은 파라미터 구조가 올바른지, 필드가 빠짐없이 채워졌는지를 보고요. 배치 처리는 납기 전까지 쓸 수 있는 결과가 얼마나 나오는지를 확인해요. 이 세 가지를 하나의 ‘평균 소요 시간’으로 뭉뚱그리면 결론은 반드시 왜곡돼요.
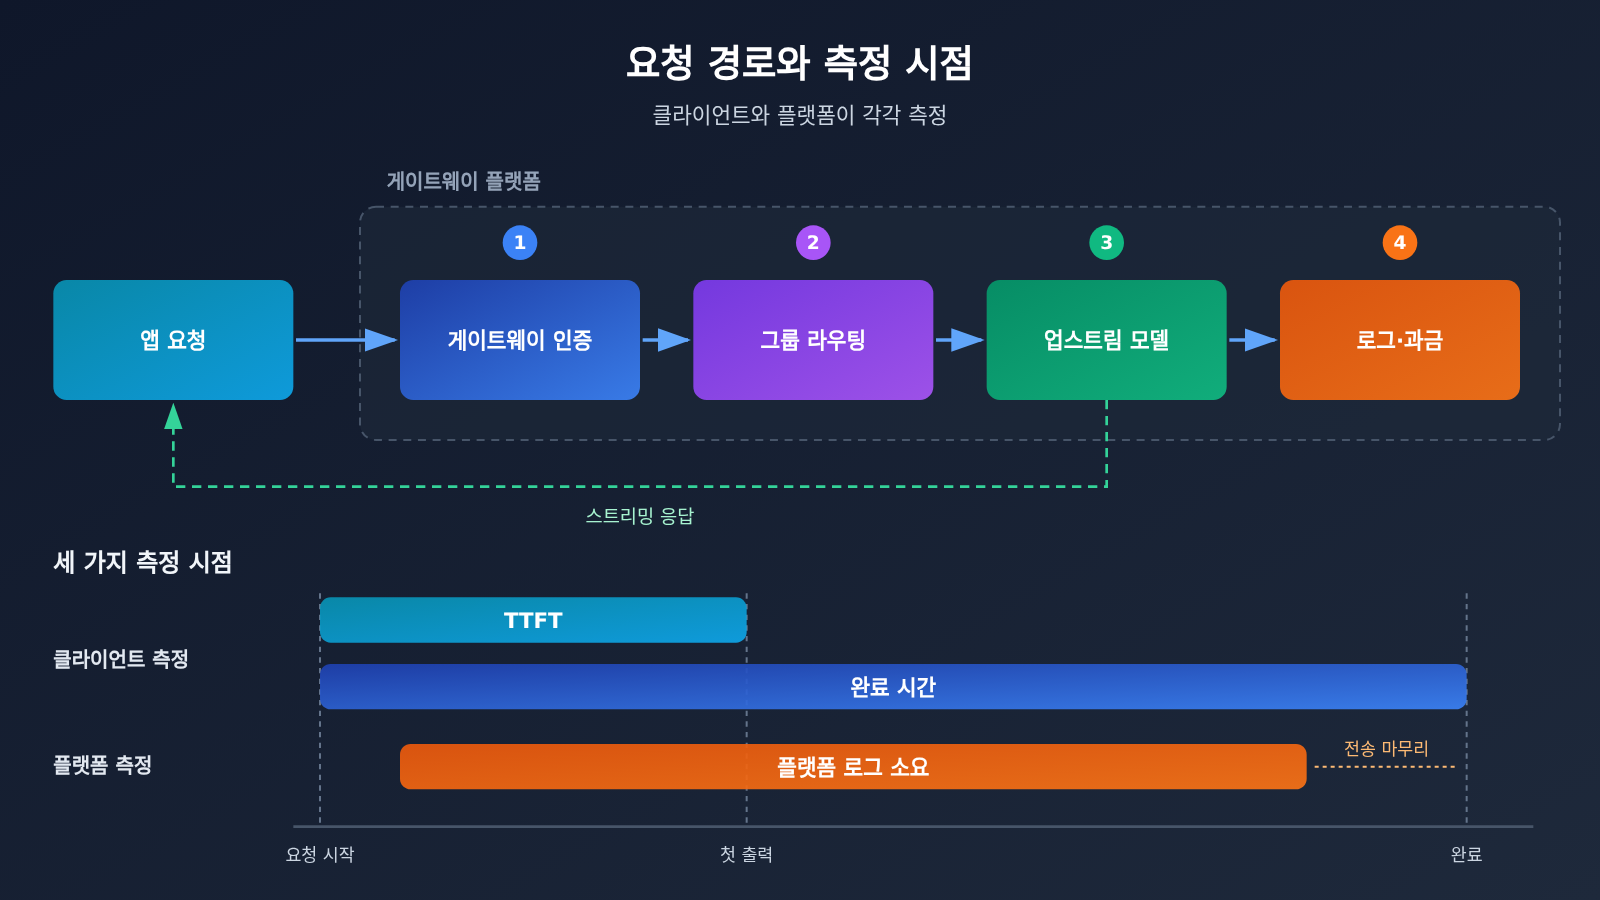
세 번째 단계는 시간 측정 기준을 맞추는 거예요. 클라이언트가 기다린 시간과 플랫폼 로그에 기록된 소요 시간은 포함하는 구간이 서로 달라요. 공식 문서에서도 “플랫폼에는 성공 및 과금으로 기록됐는데, 클라이언트는 응답 전송이나 연결 종료 과정에서 타임아웃이 난” 사례를 이미 분명하게 밝히고 있어요. 백그라운드에서 다른 경로를 자동으로 시도하는 경우에도 전체 대기 시간이 길어지고요. 그래서 이상이 생길 때마다 먼저 비즈니스 ID와 request_id로 클라이언트 기록, 플랫폼 로그, 잔액 변동을 서로 대조한 다음, 재시도할지 결정해야 해요.
고정된 작업으로 게이트웨이 성능과 피크 부하를 테스트하는 방법
테스트가 재현되려면 먼저 변수부터 고정해야 해요. 대상 모델 버전, 채널이나 그룹, 호출 인터페이스, 핵심 파라미터, 네트워크 진입점, 입출력 규모, 스트리밍 여부까지요. 이 중 하나라도 달라지면 앞뒤 두 번의 데이터를 같은 선상에 놓고 비교할 수 없습니다. 샘플은 “안녕하세요” 같은 장난감 입력이 아니라 실제 업무에서 나온 비식별화 데이터여야 하고요.
아래 표는 바로 적용할 수 있는 검수 기록 템플릿입니다. 방법론 제안일 뿐, 특정 플랫폼의 실측 결과는 담고 있지 않아요. 임계값은 비즈니스 요구사항에 맞춰 직접 정하세요. 예를 들어 대화형 작업이라면 첫 유효 출력이 몇 초 안에 나와야 하는지, 배치 작업이라면 몇 시간 안에 쓸 만한 결과를 몇 건 납품해야 하는지 같은 식으로요.
| 차원 | 기록 권장 항목 | 판단 방식 |
|---|---|---|
| 업무 납품 성공 | 요청 총수, 완전 반환 수, 형식 사용 가능 수, 업무 판정 통과 수 | 분모를 빠짐없이 적고, 최종적으로는 업무에서 쓸 수 있는 결과의 비율로 판단 |
| 지연 | 시작 시각, 첫 유효 출력 시각, 완료 시각, 플랫폼 로그 소요 시간 | 클라이언트와 플랫폼에서 각각 계측하고 p50과 p95를 산출 |
| 핵심 역량 | 스트리밍 마무리, 도구 파라미터 유효성, 구조화 출력 파싱, 긴 입력 처리 | 이 제품이 실제로 의존하는 역량별로 항목 하나씩 통과 여부 확인 |
| 피크 부하 | 동시 처리 중 요청 수, 분당 요청 수, 429 비율, 대기열과 재시도 | 요청 규모를 일정하게 유지한 채 단계별로 부하를 올리고 관찰 구간 확보 |
| 비용 | 호출당 과금, 환불, 폴백 비용, 업무 사용 가능 결과 수 | 사용 가능한 결과 하나가 부담하는 총비용 계산 |
| 문제 추적 가능성 | 업무 번호, request_id, 모델과 그룹, 오류 코드, 티켓 답변 | 이상이 있는 주문을 플랫폼 기록에 다시 대응시킬 수 있는지 확인 |
아래 스크립트가 하는 일은 딱 하나예요. 스트리밍 호출에서 첫 유효 출력 시간과 총 소요 시간을 함께 기록해서, 클라이언트 계측값과 플랫폼 로그를 같은 타임라인 위에서 비교할 수 있게 해줍니다.
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话说明什么是 API 网关"}],
    stream=True,
)
ttft = None
for chunk in stream:
    delta = chunk.choices[0].delta.content
    if delta and ttft is None:
        ttft = time.perf_counter() - start
total = time.perf_counter() - start
print(f"TTFT {ttft:.3f}s / total {total:.3f}s")
배치 부하 테스트와 분위수 통계 코드 보기
import statistics
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스
)

def one_call(prompt: str) -> dict:
    start = time.perf_counter()
    ok, ttft = False, None
    try:
        stream = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user", "content": prompt}],
            stream=True,
        )
        for chunk in stream:
            delta = chunk.choices[0].delta.content
            if delta and ttft is None:
                ttft = time.perf_counter() - start
        ok = True
    except Exception as exc:
        return {"ok": False, "ttft": None,
                "total": time.perf_counter() - start, "err": type(exc).__name__}
    return {"ok": ok, "ttft": ttft,
            "total": time.perf_counter() - start, "err": None}

def summarize(rows: list) -> None:
    done = [r for r in rows if r["ok"]]
    totals = sorted(r["total"] for r in done)
    print(f"成功率 {len(done)}/{len(rows)}")
    if totals:
        print(f"p50 {statistics.median(totals):.3f}s")
        print(f"p95 {totals[int(len(totals) * 0.95) - 1]:.3f}s")

rows = [one_call("把下面这句话翻译成英文:请检查订单状态。") for _ in range(50)]
summarize(rows)
부하 테스트에서 가장 흔한 실수는 RPM과 동시성을 같은 것으로 뭉뚱그리는 거예요. 분당 요청 수, 분당 토큰 수, 동시에 처리 중인 요청 수는 각각 서로 다른 제약을 설명하는 값이고, 서로 대신할 수 없어요. 지연이 올라가면 재시도가 오히려 시스템 부하를 키우기 때문에 스크립트에는 로컬 큐, 최대 대기 시간, 상한이 걸린 백오프 재시도를 반드시 넣어야 해요.
여기에 놓치기 쉬운 디테일이 하나 더 있어요. APIYI 문서에서 ‘동시성’ 페이지와 ‘토큰과 그룹’ 페이지가 속도 제한의 적용 범위를 서술하는 방식이 완전히 같지는 않아요. 전자는 여러 토큰의 할당량이 서로 독립적이라고 언급하고, 후자는 속도 제한이 계정을 따라간다고 설명해요. 검증 단계에서 옳은 방법은 **여러분의 목표 계정과 목표 채널에서 실제 할당량을 직접 측정하는 것**이에요. 동시성과 RPM을 따로 기록하고, 남이 캡처한 스크린샷에 찍힌 고정 숫자를 그대로 갖다 쓰지도 말고, 키를 여러 개 만들어 제한을 우회하려 하지도 마세요.
—
## 쓸 수 있는 결과 하나당 비용과 폴백 동작은 어떻게 확인할까
단가보다 비교할 가치가 있는 건 “비즈니스에서 실제로 쓸 수 있는 결과 하나당 비용”이에요. 계산 방식은 간단해요. 분자에는 정산이 끝난 모든 지출(재시도와 폴백 포함)을 넣고, 분모에는 비즈니스에서 사용 가능한 결과 수를 넣어요. 확정된 환불은 분자에서 빼면 돼요.
아래는 순전히 가상의 계산 예시예요. 계산 방식을 설명할 뿐, 어떤 공급자의 가격도 나타내지 않아요.
| 방안 | 정산 후 순지출 | 비즈니스 사용 가능 결과 | 결과 하나당 비용 |
|——|—————-|————————–|——————|
| 방안 A | 3.0달러 | 90건 | 약 0.0333달러 |
| 방안 B | 3.2달러 | 98건 | 약 0.0327달러 |
지출만 보면 방안 A가 더 싸요. 그런데 사용 가능한 결과로 나눠 보면 방안 B가 오히려 더 이득이에요. “어디가 싸냐”는 질문이 비즈니스 분모 없이는 의미가 없는 이유가 바로 여기 있어요. 두 가지도 함께 봐야 해요. 선차감됐지만 아직 정산되지 않은 비동기 작업 한도는 따로 표기해야 하고, 소비 기록만 누적하면 순지출을 과대평가할 수 있어요. 비동기 작업 환불이 음수 기록으로 청구서에 나타나기 때문이에요.
폴백 부분은 성격이 전혀 다른 두 가지 변화로 나눠야 해요. **채널 전환**은 같은 모델에서 회선만 바꾸는 것이라 모델 성능과 가격이 이론상 그대로예요. 반면 **모델 전환**은 주 모델을 쓸 수 없을 때 목록에 따라 다른 모델을 시도하는 방식인데, 업계에서 흔한 구조예요. 예를 들어 OpenRouter의 model fallbacks는 최종적으로 실제 사용한 모델의 가격으로 과금하고, 응답의 model 필드에 최종 모델을 표시한다고 명시하고 있어요. 이 예시는 구조를 설명하기 위한 것일 뿐이고, 필드 의미를 다른 플랫폼에 그대로 옮겨 적용할 수는 없어요.
그래서 검증 항목은 최소한 네 가지를 덮어야 해요. 폴백 후 최종 모델이 무엇인지, 핵심 기능이 여전히 성립하는지, 요청 한 건당 비용에 상한이 있는지, 최대 대기 시간이 얼마인지예요. 만약 특정 업무에서 모델을 바꾸면 안 된다면 폴백을 끌 수 있는지도 확인해야 해요. 스트리밍 시나리오는 따로 테스트해야 해요. 일부 출력이 이미 나간 뒤에 실패했을 때 끊김 없이 이어붙일 수 있는지는 비스트리밍의 성공 폴백 결과로 유추할 수 없어요.
> 💡 **선택 가이드**: 직결 가격과 폴백 경로를 같은 표에 놓고 비교해야 진짜 비용이 보여요. 여러 모델의 실제 과금 기록을 빠르게 모아 비교하고 싶다면 APIYI apiyi.com에서 작은 샘플로 한 번 돌려 보고, 다시 여러분의 검증 표로 돌아와 계산해 보세요.
—
## 데이터 경로와 장애 책임, 어떻게 확인할까
이 두 항목은 “저희는 안전해요”, “저희는 안정적이에요”라는 말로 가장 쉽게 얼버무려지는 부분이에요. 그런데 정작 사고가 터진 뒤에 나를 구해줄 수 있는 것도 바로 이것들이죠. 확인하는 방법은 게이트웨이, 업스트림 모델 사업자, 상세 트러블슈팅 로그, 비동기 산출물을 하나의 데이터 경로 위에 나란히 올려놓고, 계층마다 정책을 하나씩 따져 묻는 거예요.
| 경로 구간 | 확인해야 할 정책 | 확인 방법 |
|———-|—————-|———-|
| 게이트웨이 자체 | 기본적으로 입출력을 저장하는지, 트러블슈팅 로그를 누가 열 수 있는지, 보존 기간은 얼마인지 | 공식 데이터 보안 및 로그 안내 문서를 읽기 |
| 업스트림 모델 사업자 | 학습 용도, 보존 기간, 사전 승인이 필요한지 | 각 업스트림 정책을 계층별로 읽기, 하나로 합쳐버리지 않기 |
| 상세 트러블슈팅 로그 | 기록 범위, 열람 가능 인원, 기본 보존 기간, 기록을 끈 뒤 삭제되는 시점 | 스위치를 끄는 것이 기존 기록의 즉시 삭제를 뜻하지는 않는다는 점 확인 |
| 비동기 작업 산출물 | 산출물 저장 위치, 다운로드 링크 유효 기간 | 임시 링크에 기대지 말고 비즈니스 측에서 바로 저장 |
공개 문서 기준으로 APIYI의 일반 정책은 고객 입출력을 기본적으로 저장하지 않는 것이고, 상세 트러블슈팅 로그는 관리자가 일시적으로 켜서 전체 입력과 컨텍스트, 출력을 기록할 수 있으며 내용은 관리자만 볼 수 있어요. 페이지에 제시된 기본 보존 기간은 7~30일이고, 같은 페이지에서 기록 스위치를 끄는 동작을 기존 기록이 즉시 삭제된 것으로 해석할 수는 없다고 밝히고 있죠. 이런 서술은 “공식 문서에 이렇게 적혀 있다”는 출처를 그대로 달고 가야 해요. 규정 준수 인증도 아니고 법적 결론도 아니니까요.
자주 놓치는 운영상의 사실이 하나 더 있어요. 로그 자체에도 수명이 있다는 점이에요. APIYI의 로그 보존 관련 별도 안내를 보면 호출 로그는 최근 약 두 달치를 롤링 보관하고, 매월 5일·15일·25일에 당일 기준 두 달 이전 기록을 삭제하며, 정리는 복구되지 않아요. 장기 대사와 감사에 필요한 상세 내역은 직접 내려받아 보관해야 하죠. 동기 결과와 비동기 산출물의 보관 기간은 또 다르고, 페이지에는 산출물 다운로드 링크가 약 하루 동안 유효하다고 나와 있어요. 이 창을 넘긴 뒤에 되짚어보면 손에 남는 증거가 없어요.
장애 책임은 실행 가능한 조항까지 내려와야 해요. APIYI의 SLA 전용 페이지는 플랫폼 측 원인으로 손실이 발생했을 때의 서비스 크레딧 재지급, 그리고 기업이 계약에서 보장 범위와 가용성 지표, 대응 시간, 배상 상한을 정할 수 있다는 점을 다루고 있어요. 이 페이지가 모든 고객에게 똑같은 고정 가용률을 제시하는 건 아니죠. 공급자를 비교할 때는 지표의 집계 주기, 분모 정의, 장애 제외 항목, 신청 절차, 보상 형태를 기록해 두고, 서비스 크레딧 보상과 현금 배상이 구매 가치에서 갖는 차이를 분명히 구분해야 해요.
## 검수표 한 장으로 출시 범위 결정하기
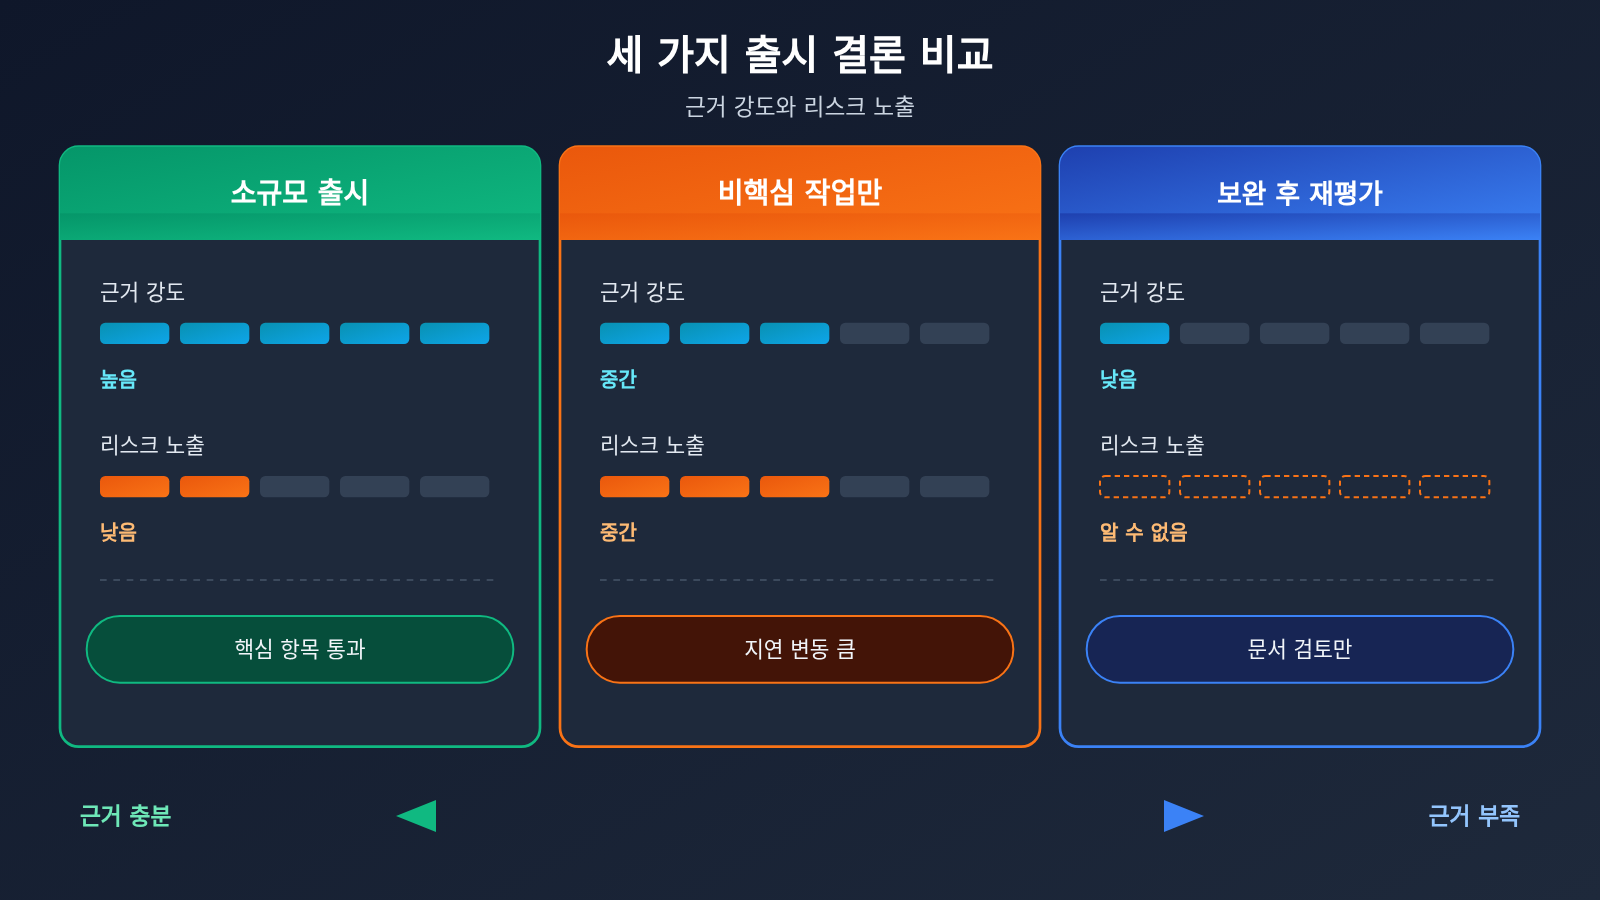
모든 기록을 결론으로 정리할 때는 “신뢰도 순위”를 매기지 마세요. 필요한 건 범위 판단이에요. 같은 공급업체라도 인터랙티브 서비스에서는 “비핵심 작업”에만 쓸 수 있는 수준이고, 오프라인 배치 처리에서는 충분히 쓸 만할 수 있어요.
| 결론 | 제시해야 할 근거 | 전환 또는 중단 트리거 조건 |
|——|—————-|———————-|
| 소규모 출시 가능 | 핵심 기능 항목별 통과, p95가 업무 임계값 이내, 사용 가능한 결과 기준 비용 수용 가능, 데이터 경로와 SLA 확인 완료 | 업무 가용률이 임계값 아래로 연속 하락하거나, 과금 이상을 대조할 수 없는 경우 |
| 비핵심 작업에만 사용 | 기능은 통과했지만 지연 시간 편차가 크거나, 폴백 시 모델과 비용이 바뀌는 경우 | 핵심 경로를 자체 구축 또는 직접 연동으로 되돌리고, 폴백 전략을 명시적으로 끄는 경우 |
| 조건 보완 후 재평가 | 문서 검토만 했고 자사 계정 실측 데이터가 없거나, SLA 조항이 계약에 반영되지 않은 경우 | 실측 데이터와 계약 조항을 보완한 뒤 결론을 다시 내는 경우 |
당장은 문서 검토만 할 수 있다면, 결론을 “공개된 기능과 구매 조건 확인 완료”라고 있는 그대로 적고, 실제 검수는 다음 라운드로 넘기세요. 장애 처리 동작을 검증해야 할 때는 공급업체가 허용하는 테스트 설정이나 격리된 환경을 사용하세요. 공유 중인 프로덕션 서비스를 일부러 방해하면 안 돼요. 타임아웃이 났는데 결과를 알 수 없다면, 먼저 실행 여부와 과금 내역을 확인해서 같은 업무 동작이 중복 실행되지 않도록 하세요.
> 🚀 **빠른 시작**: 테스트 스크립트를 처음부터 만들고 싶지 않다면, APIYI(apiyi.com)의 무료 테스트 크레딧으로 위 7개 항목 체크리스트 중 “기능”과 “지연 시간” 두 항목을 먼저 돌려 보세요. 그런 다음 더 무거운 부하 테스트 단계로 넘어갈지 결정하면 돼요.
—
## 자주 묻는 질문 FAQ
Q1: 대규모 언어 모델 API 중계 서비스와 게이트웨이는 정확히 무엇인가요?
애플리케이션과 상위 모델 서비스 사이에 놓이는 진입 계층으로, 요청을 받은 뒤 인증, 과금, 라우팅·포워딩, 로그 기록을 처리해요. 여기서 말하는 ‘중계’는 여러 모델을 하나의 호환 인터페이스로 모아준다는 점을 강조한 표현이에요. 그래서 여러분이 얻는 것은 연동 편의성이고, 내주는 것은 하위 경로에 대한 가시성이에요.
Q2: 공식 API 직접 연결과 중계 게이트웨이 사용은 안정성에서 무엇이 다른가요?
차이는 링크의 계층 수와 책임 경계에 있어요. 직접 연결할 때는 상위 업체 하나만 판단하면 되지만, 게이트웨이를 거치면 게이트웨이 자체, 그룹 채널, 상위 공급업체라는 세 계층이 모두 장애 지점이 될 수 있어요. 대신 한 겹의 보완 장치와 통합 로그라는 가능성도 생기고요. 판단 방법은 누가 더 빠른지를 겨루는 게 아니라, 이 글에서 말하는 5개 계층별로 각각 증거를 확보하는 것이에요.
Q3: 평균 지연만 봐서는 왜 안 되나요?
평균값은 소수의 아주 느린 요청을 가려버리는데, 그 요청들이 바로 사용자 불만의 근원이기 때문이에요. 스트리밍 상호작용이라면 TTFT와 전체 완료 시간을 따로 통계 내고, 샘플 수와 시간 구간, 실패·대기·재시도 포함 여부를 명시해야 해요. 그렇지 않으면 p95조차 비교할 수 없어요.
Q4: 요청은 성공했는데 내용을 쓸 수 없다면, 플랫폼 문제인가요?
보통은 아니에요. 다만 비용은 계산에 넣어야 해요. 플랫폼은 요청을 정상적으로 완료하면 과금하고, 출력 구조가 유효하지 않은 것은 비즈니스 측에서 재시도해야 하는 부분이에요. 이 중복 지출은 ‘사용 가능한 결과 한 건당 비용’의 분자에 들어가야 하죠. 그래서 검수표에서는 플랫폼 실행 성공과 비즈니스 판정 통과를 반드시 두 개의 열로 나눠야 해요.
Q5: 어떤 게이트웨이가 내 비즈니스를 지탱할 수 있는지 어떻게 빠르게 검증하나요?
직접 비식별화한 샘플로 모델, 채널, 파라미터, 입력 규모를 고정하고 소규모로 한 라운드 돌려보세요. TTFT, p95, 비즈니스 사용 가능 결과 비율, 과금 내역을 기록하면 돼요. APIYI apiyi.com에서 테스트 크레딧을 받아 이 라운드를 진행한 뒤 데이터를 검수표에 채워 넣으면 되고, 연결 테스트 한 번으로 결론을 내리면 안 돼요.
Q6: 이 방법에는 어떤 알려진 한계가 있나요?
소규모 샘플의 p95는 변동이 커서 장기 서비스 약속으로 삼을 수 없어요. 시간대별 상위 업체 부하 차이도 결론에 영향을 주기 때문에 여러 시간대에 반복해야 하고요. 또한 이 글의 모든 계산 기준은 방법 제안일 뿐, 어떤 플랫폼의 실측 성능 데이터나 실제 청구서도 담고 있지 않아요. 최종 판단은 여러분의 비즈니스 임계값과 계약 조건을 함께 놓고 내려야 해요.
—
## 대규모 언어 모델 API 중계 게이트웨이 핵심 요점 Key Takeaways
– **신뢰성은 비즈니스 검수 기준으로 정의해야 해요**: 플랫폼 과금 성공, 클라이언트가 200을 받은 것, 비즈니스 파싱 통과는 각각 따로 집계해야 하는 세 가지 일이에요.
– **지연은 두 개의 측정 지점으로 나눠야 해요**: TTFT는 인터랙션 경험을 좌우하고, 전체 완료 시간은 실제 전달 능력을 좌우해요. 둘 다 p95로 봐야 해요.
– **RPM과 동시성은 반드시 따로 기록해야 해요**: RPM이 낮아도 처리 중인 요청이 쌓여 동시성이 높아질 수 있으니, 속도 제한 기준은 대상 계정에서 직접 측정한 값을 따라야 해요.
– **비용은 쓸 수 있는 결과를 기준으로 계산해요**: 정산된 총지출을 비즈니스에서 실제로 쓸 수 있었던 결과 수로 나누고, 재시도와 폴백에 들어간 비용도 모두 분자에 넣어요.
– **폴백은 채널 전환과 모델 전환을 구분해야 해요**: 최종 모델, 핵심 기능, 비용 상한, 최대 대기 시간 네 가지를 하나씩 검수해요.
– **데이터와 책임은 실행 가능한 조항으로 확인해요**: 로그에는 보존 기간이 있고, SLA에는 통계 기준과 제외 항목, 보상 형태가 명시돼 있어야 해요.
– **시작 경로**: 먼저 APIYI apiyi.com에서 소규모 샘플로 기능과 지연 두 항목을 통과시킨 다음, 부하 테스트와 계약 검토로 넘어가요.
—
## 정리
대규모 언어 모델 API 중계 및 게이트웨이가 믿을 만한지 판단하는 일은 본질적으로 증거를 모으는 문제이지, 인상을 따지는 문제가 아니에요. “쓸 수 있느냐”를 비즈니스에서 실제로 쓸 수 있었던 결과, 엔드투엔드 지연, 쓸 수 있는 결과당 비용, 데이터 흐름, 장애 책임이라는 다섯 층으로 쪼개고, 각 항목마다 대조 가능한 기록을 남겨두면 대부분의 돌발 변수를上线 전에 미리 알려진 항목으로 바꿔놓을 수 있어요.
실제로 적용할 때 기억할 세 가지가 있어요. 결론에는 범위만 쓰고 순위는 쓰지 않기, 기준값은 남이 캡처한 화면이 아니라 내가 직접 측정한 값만 쓰기, 증거는 다시 확인 가능한 데까지만 남기기(로그는 만료되니까요). 이 세 가지만 지키면 모델 선정 논의는 더 이상 누구 목소리가 큰지에 좌우되지 않아요.
APIYI apiyi.com에서 먼저 한 차례 소규모 샘플 검수를 마쳐보시는 걸 권해요. 통합 인터페이스와 무료 테스트 크레딧을 제공하니, 여러 모델을 같은 표에 놓고 비교하기 편해요.
—
## 참고 자료
1. **APIYI 토큰과 그룹**: 다중 키, 할당량, 리소스 그룹, 폴백(fallback) 그룹 안내
– 링크: `docs.apiyi.com/faq/token-and-groups`
– 설명: 키 할당, 리소스 그룹, 주/백업 채널 메커니즘을 확인할 때 참고하세요
2. **APIYI 로그 보관 및 정리 정책**: 로그 롤링 보관 및 내보내기 안내
– 링크: `docs.apiyi.com/faq/log-retention-policy`
– 설명: 정산 대조와 감사에 필요한 상세 내역을 직접 보관해야 하는 기간을 확인할 수 있어요
3. **APIYI 상세 로그 안내**: 문제 해결용 로그의 활성화 범위와 보관 기간
– 링크: `docs.apiyi.com/faq/user-logs-control`
– 설명: 데이터 경로상의 로그 계층을 확인할 수 있어요
4. **APIYI 데이터 보안 안내**: 입력과 출력을 기본적으로 저장하지 않는 정책 설명
– 링크: `docs.apiyi.com/faq/data-security`
– 설명: 업스트림 정책과 계층별로 비교하면서 읽어보세요
5. **APIYI SLA 보장**: 할당량 재지급 및 계약상 적용 범위
– 링크: `docs.apiyi.com/faq/sla-guarantee`
– 설명: 장애 책임에 따른 보상 형태와 한계를 파악할 수 있어요
6. **로그에 표시된 과금 금액 이해하기**: 청구서 필드와 배율 기준
– 링크: `docs.apiyi.com/faq/log-billing-explained`
– 설명: 사용 가능한 결과 한 건당 실제 비용을 계산할 때 활용하세요
7. **로그상 완료 및 과금되었지만 클라이언트가 응답을 받지 못하는 경우**: 클라이언트 타임아웃과 플랫폼 과금의 차이
– 링크: `docs.apiyi.com/faq/log-duration-vs-client-wait`
– 설명: 이상 주문을 조사할 때 꼭 읽어야 할 자료예요
– 링크: `openrouter.ai/docs/guides/routing/provider-selection`
– 설명: 채널 전환과 모델 전환의 차이를 이해할 수 있어요
9. **OpenRouter Model Fallbacks**: 모델 폴백과 실제 과금 기준
– 링크: `openrouter.ai/docs/guides/routing/model-fallbacks`
– 설명: 최종 모델과 과금 귀속에 대한 업계 관행을 설명해요
—
> **작성자**: APIYI 기술팀
> **기술 문의**: APIYI apiyi.com 홈페이지에서 언제든 문의해 주세요. 더 많은 문서는 docs.apiyi.com 문서 센터에서 확인할 수 있어요


