
Nota del autor: desglosamos los cuatro conceptos de facturación de gpt-6.2-sol —entrada, lectura de caché, escritura de caché y salida—, explicamos cómo se calcula la factura completa al superar los 272K y los multiplicadores de Batch/Fast/Ultrafast, y ofrecemos dos ejemplos de estimación: uno con contexto corto y otro con contexto ultra largo.
OpenAI lanzó GPT-6.2 Astra y GPT-6.2 Sol el 17 de noviembre de 2026 (2026-11-17). Para muchos equipos, lo primero fue estimar la factura de gpt-6.2-sol, pero el número obtenido rara vez coincide con el real. La razón es que la facturación de GPT-6.2 Sol no es «un precio para la entrada y otro para la salida», sino que entrada, lectura de caché, escritura de caché y salida se cobran por separado, como cuatro conceptos distintos. Además, los contextos ultra largos y los niveles como Ultrafast también modifican los multiplicadores.
Este artículo no es una simple copia de precios. Tomando como referencia las reglas de precios de la página de modelos de OpenAI, aquí presentamos la fórmula de cálculo para contextos cortos, el algoritmo de la factura completa cuando se superan los 272K, y resolvemos dos ejemplos por separado. También explicamos bajo qué condiciones se sostiene la afirmación oficial de que Sol «cuesta aproximadamente una quinta parte de Astra».
Valor clave: al terminar de leer, podrás elaborar tú mismo la factura de cuatro columnas de gpt-6.2-sol, determinar si una solicitud cruza el umbral de 272K y detectar qué multiplicador puede duplicar el costo.
Puntos clave de la tarificación de GPT-6.2 Sol
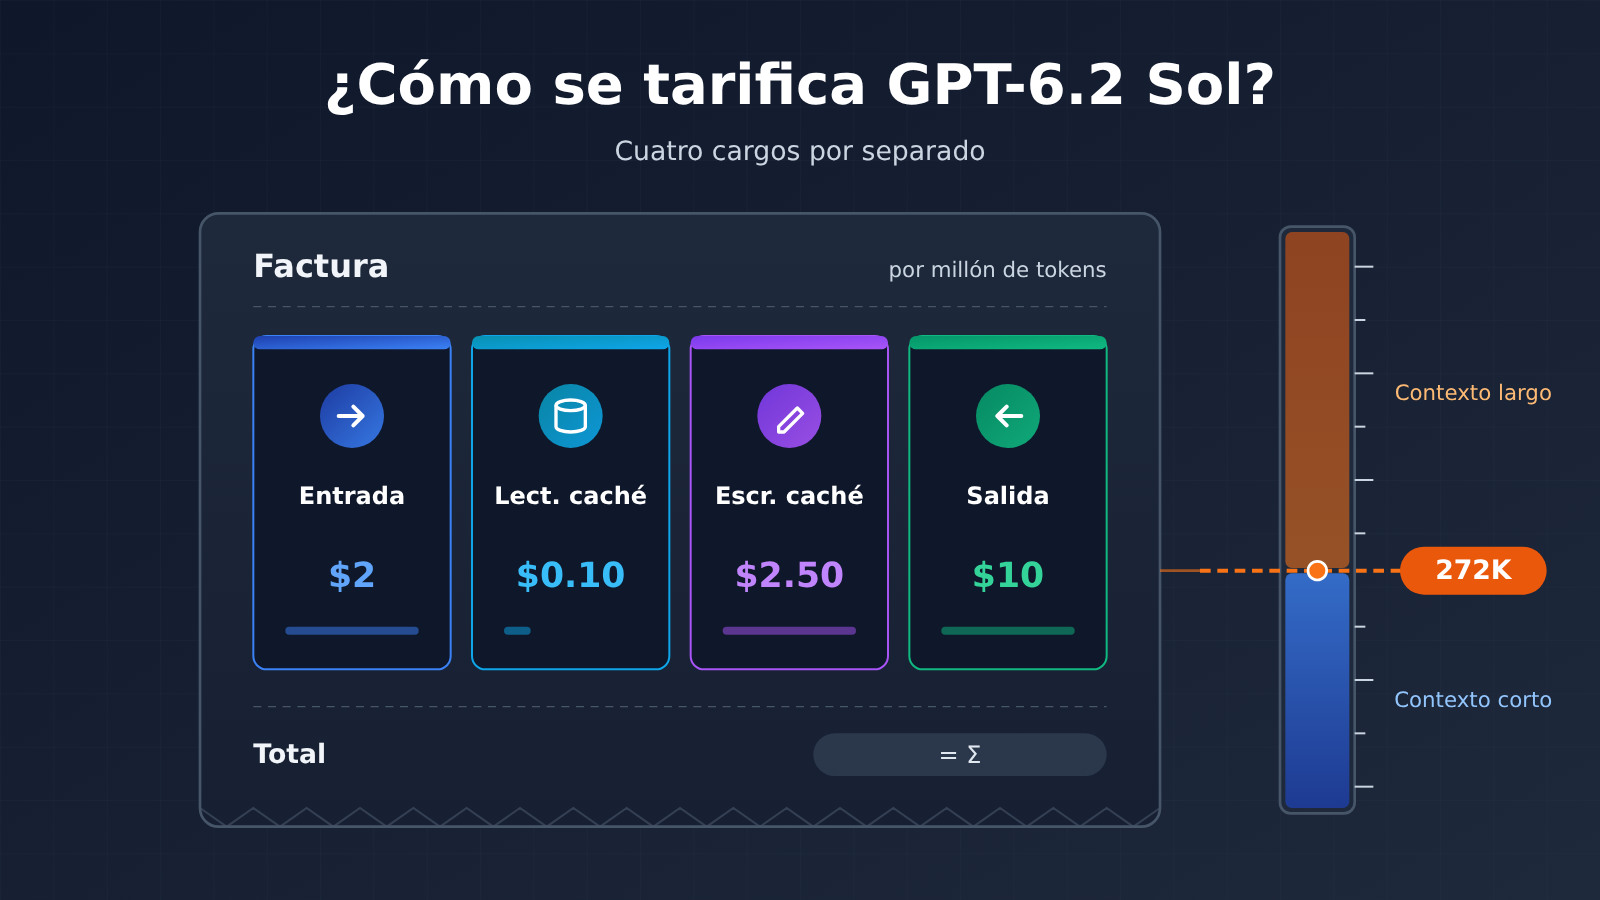
Antes de entrar en materia, dejemos claras las reglas. Las cifras siguientes provienen todas de la página oficial de modelos de OpenAI, están expresadas por cada millón de tokens y corresponden a los precios de lista oficiales.
| Punto clave | Explicación | Impacto en la estimación de costos |
|---|---|---|
| Cuatro cobros por separado | La entrada, la lectura de caché, la escritura en caché (en dos modalidades: 30 minutos y 12 horas) y la salida tienen cada una su precio unitario | Si solo miras los precios de entrada y salida, se te escapa el cobro por escritura en caché |
| Umbral de 272K | Cuando la entrada de la solicitud supera los 272K tokens, los precios de entrada y de caché se duplican y la salida pasa a 1.5 veces | Se aplica sobre la solicitud completa, no solo sobre la porción que excede el umbral |
| Multiplicadores por nivel | Batch cuesta el 50 % del precio estándar, Fast el doble, y Ultrafast por ahora el triple (a partir del 2027-03-01, el séxtuple) | Con la misma cantidad de tokens, la factura puede variar más de diez veces |
| El razonamiento no se puede desactivar | La API no acepta fijar el reasoning effort en none |
Los tokens del lado de la salida nunca bajan a un nivel de razonamiento cero |
| Límites de especificación | Ventana de contexto de 1,050,000, entrada máxima de 922,000, salida máxima de 128,000 | Las solicitudes muy largas cruzarán inevitablemente el umbral de 272K |
Desglose de los cuatro cobros de GPT-6.2 Sol
La entrada se refiere a los tokens ordinarios de la solicitud actual que no obtienen coincidencia de caché; el precio de lista con contexto corto es de $2. La lectura de caché es la porción que sí coincide con un prefijo ya almacenado en caché, con un precio unitario de solo $0.10, es decir, una vigésima parte de la entrada normal. Precisamente por eso, las indicaciones de sistema largas y los prefijos de documentos fijos son candidatos ideales para reutilizar la caché.
La escritura en caché pasa fácilmente desapercibida. Escribir un fragmento de contenido en la caché tiene un costo en sí mismo: la tarifa de escritura con retención de 30 minutos es de $2.50 y la de retención de 12 horas, de $5; ambas superan el precio de la entrada normal. Por lo tanto, escribir en la caché no significa necesariamente ahorrar. Solo cuando los aciertos posteriores son suficientemente numerosos, el dinero extra pagado al escribir se recupera gracias al bajo precio de la lectura de caché.
La salida tiene un precio de lista de $10 e incluye la respuesta generada por el modelo. Como la intensidad de razonamiento no puede establecerse en none, el proceso de razonamiento suele aumentar también la cantidad de tokens del lado de la salida; para el detalle exacto, atente al campo de uso que devuelve la API. Al consultar modelos y verificar precios, conviene guiarse por la información en tiempo real de la lista de modelos de la plataforma APIYI (apiyi.com) y no fiarse solo de lo que digan terceros.
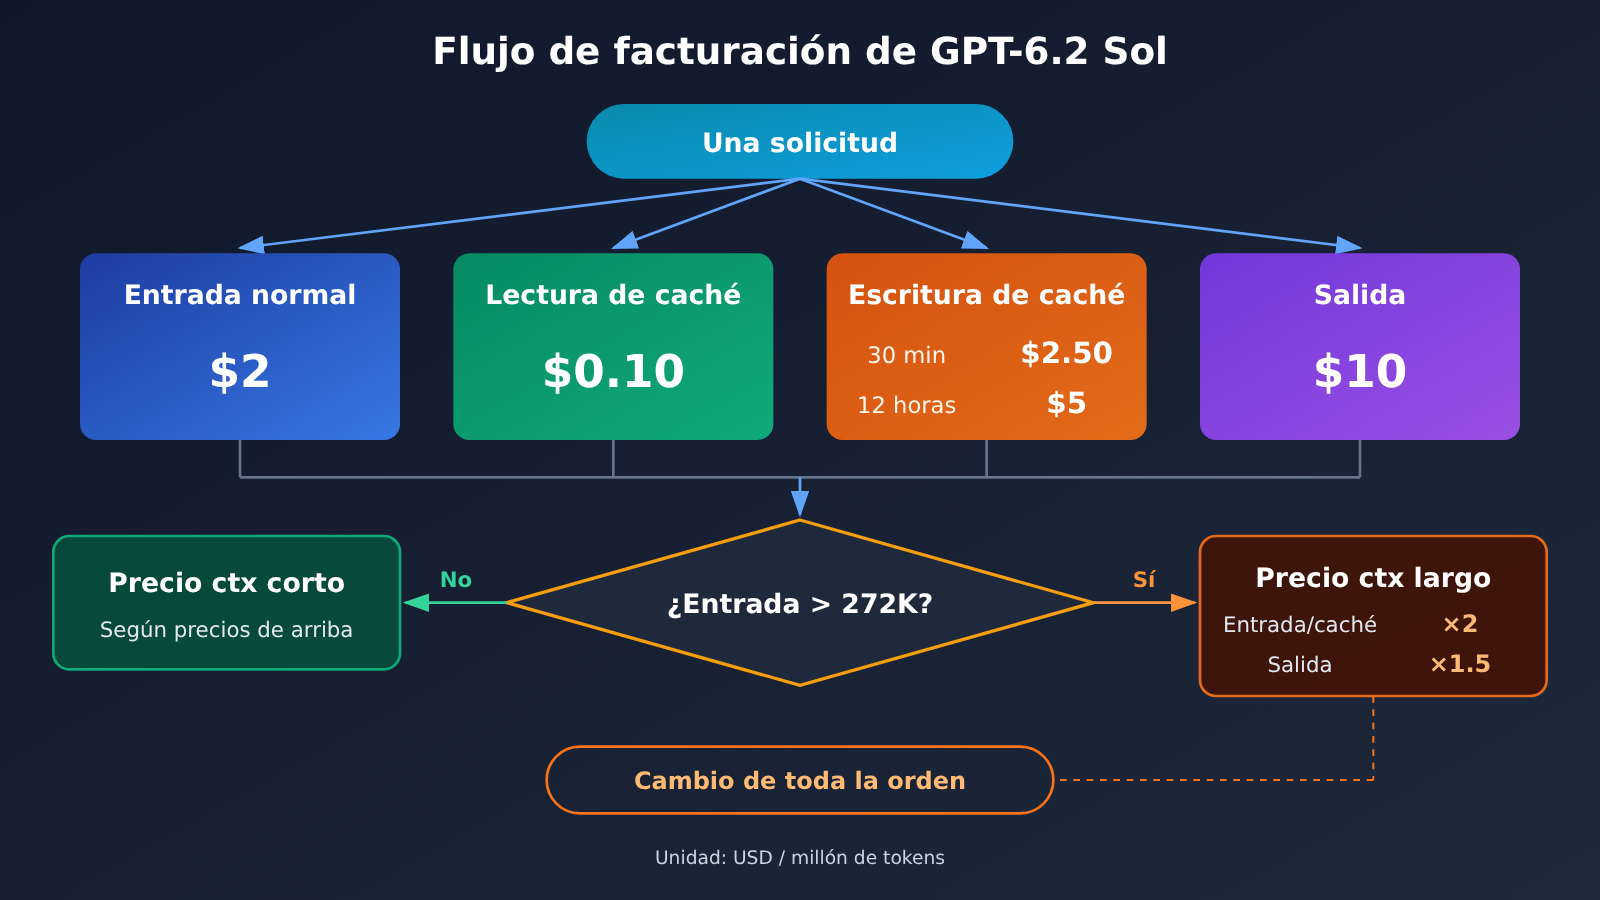
Tabla de precios de GPT-6.2 Sol: contexto corto y más de 272K
La siguiente tabla reúne los precios estándar de gpt-6.2-sol en las dos longitudes de contexto. La columna de contexto largo se calcula según las reglas de la página del modelo: los precios unitarios de entrada y de caché se multiplican por 2, y el de salida por 1.5.
| Concepto de facturación (por cada 1 millón de tokens) | Contexto corto (≤272K) | Más de 272K (toda la solicitud) | Fuente de la regla |
|---|---|---|---|
| Entrada | $2 | $4 | Página del modelo: la entrada se duplica |
| Lectura de caché | $0.10 | $0.20 | Página del modelo: la caché se duplica |
| Escritura de caché (30 minutos) | $2.50 | $5 | Página del modelo: la caché se duplica |
| Escritura de caché (12 horas) | $5 | $10 | Página del modelo: la caché se duplica |
| Salida | $10 | $15 | Página del modelo: la salida se multiplica por 1.5 |
Los precios anteriores son los oficiales de OpenAI. gpt-6.2-sol todavía no está disponible en APIYI, y lo agregaremos a la plataforma cuanto antes; el modelo y los precios están sujetos a la lista de modelos de la plataforma, donde puedes consultar el estado más reciente en apiyi.com. A la fecha de los datos de la tabla general de APIYI, 2026-11-17 15:54 (UTC+8), ni la tabla general ni el endpoint de precios incluyen todavía gpt-6.2-sol ni gpt-6.2-astra.
Cómo entender la regla de «toda la solicitud» en GPT-6.2 Sol
«Se aplica a toda la solicitud» es el punto donde más fácil es equivocarse al calcular. Si la entrada de una solicitud es de 300K, no puedes calcular los primeros 272K con el precio corto y los últimos 28K con el precio largo. En cuanto la entrada de una solicitud cruza el límite, toda la entrada, la lectura de caché y la escritura de caché de esa solicitud se facturan al precio duplicado, y la salida a 1.5 veces su valor normal.
Por eso, entre dos solicitudes con entradas de 270K y de 280K, la diferencia en la factura va mucho más allá de los 10K tokens extra. Cuando hagas RAG o análisis de documentos largos, mantener la entrada por debajo de 272K suele ser más conveniente que meter un poco más de contexto.
GPT-6.2 Sol frente al anterior gpt-6.1-sol
El anuncio de lanzamiento indica que Sol mantiene los precios de token de API de GPT-6.1 Sol. Puedes tomar como referencia gpt-6.1-sol, que ya está disponible: en la tabla general de APIYI en apiyi.com, gpt-6.1-sol con contexto corto tiene una entrada de $2, una salida de $10 y una lectura de caché de $0.1; cuando supera los 272,000, la entrada es de $4, y los endpoints admiten responses y chat.
Hay que subrayar que estos son los precios de plataforma del modelo anterior: no significan que gpt-6.2-sol ya esté disponible, ni pueden tomarse directamente como los precios de plataforma del 6.2. Además, en esa misma tabla la lectura de caché de gpt-6-sol es $0.2, distinta de la del 6.1, así que no vayas a confundir de fila al comparar.
¿Cómo se acumulan los multiplicadores por nivel de GPT-6.2 Sol?
Además de la longitud del contexto, el nivel de servicio también modifica el precio unitario. Los multiplicadores que muestra la página del modelo son los siguientes:
| Nivel | Multiplicador | Vigencia y detalles |
|---|---|---|
| Estándar | 1× | Nivel predeterminado |
| Batch | 0.5× | 50 % del precio estándar, ideal para tareas offline sin prisa |
| Fast | 2× | Se calcula sobre el precio estándar de la misma longitud de contexto |
| Ultrafast | 3× | Hasta el 2027-02-28 (hora del Pacífico) |
| Ultrafast | 6× | A partir del 2027-03-01 |
La página del modelo lo deja bien claro con Fast: es «el doble del precio estándar de la misma longitud de contexto». Es decir, si una solicitud que supera los 272K se procesa con Fast, hay que multiplicar por 2 sobre la base del precio de contexto largo. Para Batch y Ultrafast, el texto original habla de multiplicadores sobre el «precio estándar»; en cuanto a cómo se acumulan exactamente en estos dos niveles para solicitudes de contexto muy largo, lo más prudente es atenerse a la factura oficial. Para hacer estimaciones, puedes partir multiplicando por el precio estándar de la misma longitud de contexto.
Las fechas clave de Ultrafast conviene anotarlas aparte. El presupuesto que calcules hoy podría duplicarse de golpe hacia marzo de 2027. Si tu negocio depende de Ultrafast, lo mejor es reservar en tu hoja de presupuesto la franja de 6×.
GPT-6.2 Sol: guía rápida con dos ejemplos de cálculo de costos
Los dos ejemplos siguientes usan únicamente sumas y multiplicaciones, y todos los números aparecen dentro de las propias frases, para que puedas aplicarlos directamente a tu propio consumo. Cada token se contabiliza en una sola categoría; a cuál de ellas corresponde cada grupo de tokens lo determina el campo usage que devuelve la API.
Ejemplo 1: solicitud con contexto corto
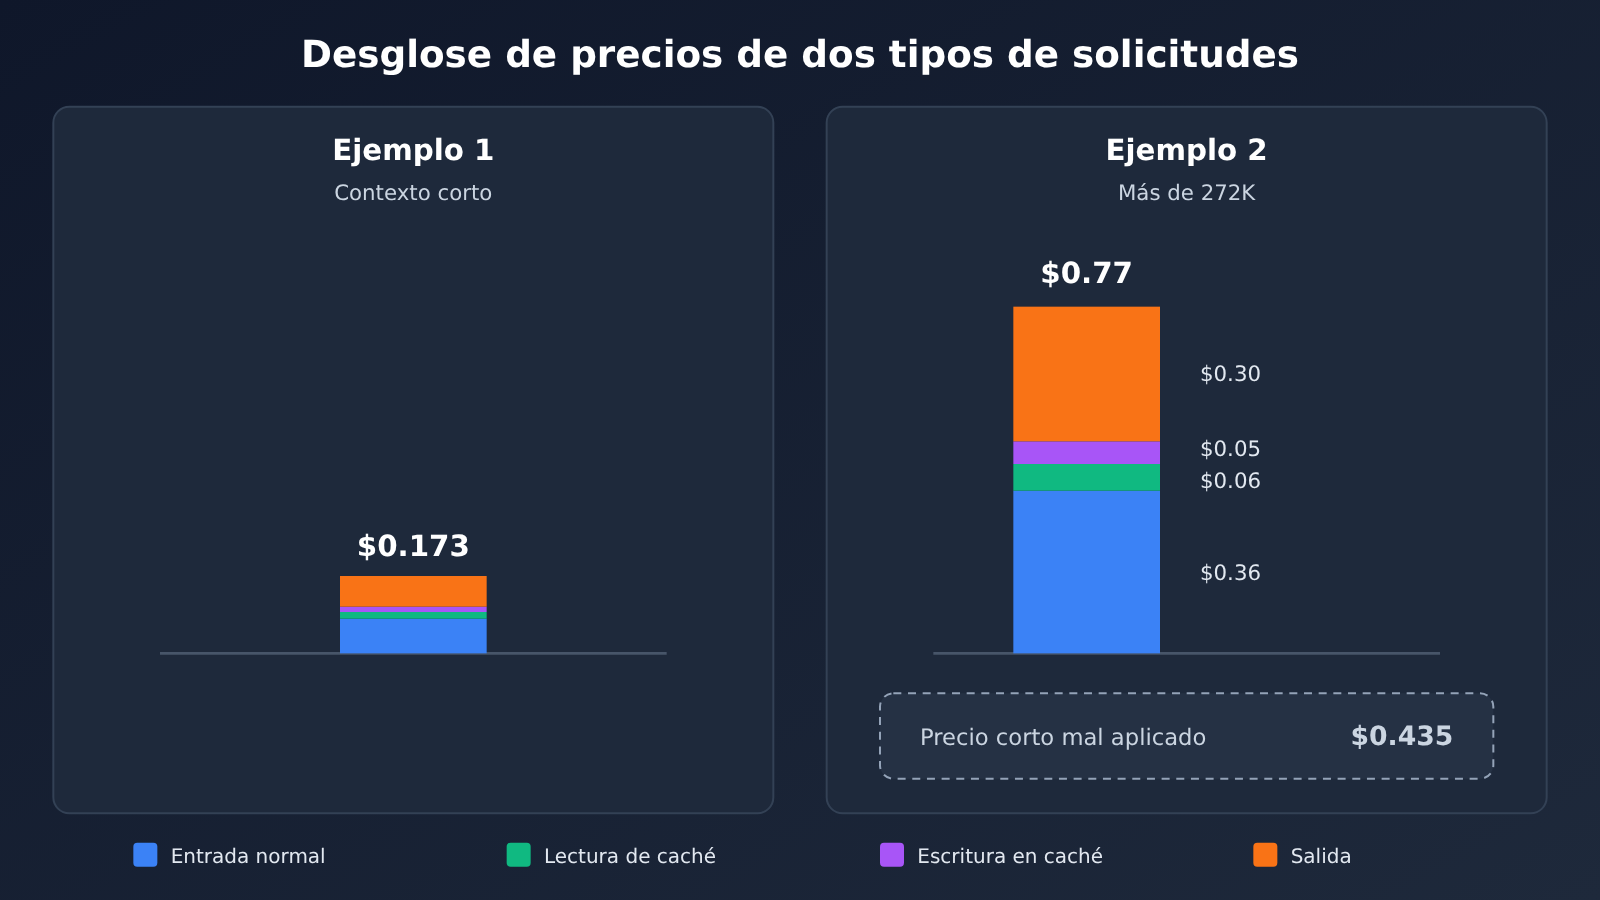
Supongamos que una solicitud tiene 120,000 tokens de entrada en total, de los cuales 80,000 son aciertos de caché (lectura de caché), 10,000 se escriben en la caché de 30 minutos, 30,000 son entrada normal y la salida es de 8,000 tokens.
- Entrada normal: 30,000 × $2 ÷ 1,000,000 =
$0.06 - Lectura de caché: 80,000 × $0.10 ÷ 1,000,000 =
$0.008 - Escritura en caché (30 minutos): 10,000 × $2.50 ÷ 1,000,000 =
$0.025 - Salida: 8,000 × $10 ÷ 1,000,000 =
$0.08
Esta solicitud suma en total $0.173. Como ves, 8,000 tokens de salida cuestan diez veces más que 80,000 tokens de lectura de caché. Si al estimar te fijas solo en el volumen total de entrada, la conclusión puede desviarse bastante.
Ejemplo 2: una solicitud que supera los 272K
Supongamos que una solicitud tiene 400,000 tokens de entrada en total, de los cuales 300,000 son lecturas de caché, 10,000 se escriben en la caché de 30 minutos, 90,000 son entrada normal y la salida es de 20,000 tokens. Como la entrada supera los 272K, toda la solicitud se factura con la tarifa de contexto largo.
- Entrada normal: 90,000 × $4 ÷ 1,000,000 =
$0.36 - Lectura de caché: 300,000 × $0.20 ÷ 1,000,000 =
$0.06 - Escritura en caché (30 minutos): 10,000 × $5 ÷ 1,000,000 =
$0.05 - Salida: 20,000 × $15 ÷ 1,000,000 =
$0.30
Esta solicitud suma un total de $0.77. Si se usara por error la tarifa de contexto corto, solo se calcularían $0.435, casi la mitad de lo que realmente cuesta.
| Nivel (basado en el Ejemplo 2) | Cálculo | Costo por solicitud |
|---|---|---|
| Estándar | Precio original | $0.77 |
| Batch | × 0.5 | $0.385 |
| Fast | × 2 | $1.54 |
| Ultrafast (hasta 2027-02-28) | × 3 | $2.31 |
| Ultrafast (desde 2027-03-01) | × 6 | $4.62 |
Para una misma solicitud, pasar de Batch al Ultrafast de 2027 implica una diferencia de costo de 12 veces. Elegir el nivel suele afectar la factura más que ajustar la longitud de la indicación.
Verificar el consumo con el protocolo compatible con OpenAI
En cuanto a la integración, gpt-6.2-sol admite oficialmente Chat Completions y Responses, además de Batch; no admite Realtime, Assistants, fine-tuning, generación de imágenes, video ni voz. Solo acepta texto e imágenes como entrada, y produce texto como salida.
Si quieres probar primero el flujo de estimación de costos con el gpt-6.1-sol, que ya está disponible, puedes seguir estos pasos:
- En tu cliente compatible con OpenAI, configura la URL base como
https://api.apiyi.com/v1y el modelo comogpt-6.1-sol. - Establece la intensidad de razonamiento en valores válidos como
lowomedium; no usesnone. Los dos modelos 6.2 en la API oficial rechazan directamentenone. - Después de cada solicitud, registra el usage devuelto y anota por separado los cuatro valores: entrada normal, lectura de caché, escritura de caché y salida.
- Sustituye los cuatro valores en la tabla de precios unitarios de arriba y verifica si la entrada supera los 272K.
Cuando gpt-6.2-sol esté disponible, bastará con reemplazar el ID del modelo y actualizar los precios unitarios.
Ver la lista completa de estimación
– Primer paso: calcula el total de tokens de entrada y verifica si supera los 272K para decidir si toda la cuenta usa el precio corto o el precio largo.
– Segundo paso: divide la entrada en tres columnas: entrada normal, lectura de caché y escritura de caché (distinguiendo entre 30 minutos y 12 horas).
– Tercer paso: cuenta los tokens de salida; cuando el razonamiento está activado, tómalo del usage devuelto.
– Cuarto paso: multiplica cada una de las cuatro columnas por su precio unitario, súmalas y obtendrás el costo del nivel estándar.
– Quinto paso: multiplica por el factor del nivel: Batch es 0.5, Fast es 2 y Ultrafast es 3 o 6 según la fecha.
– Sexto paso: multiplica por el número promedio de solicitudes diarias para obtener el presupuesto diario; estima la tasa de acierto de caché con un valor conservador.
🚀 Inicio rápido: te recomendamos reclamar primero el crédito de prueba gratuito en APIYI (apiyi.com) y ejecutar algunas solicitudes reales con el gpt-6.1-sol, ya disponible. Con los cuatro valores de usage en mano, aplica las fórmulas de este artículo. Así el presupuesto estimado será mucho más cercano a la realidad que un cálculo puramente teórico.
Cómo interpretar el «un quinto» entre GPT-6.2 Sol y Astra
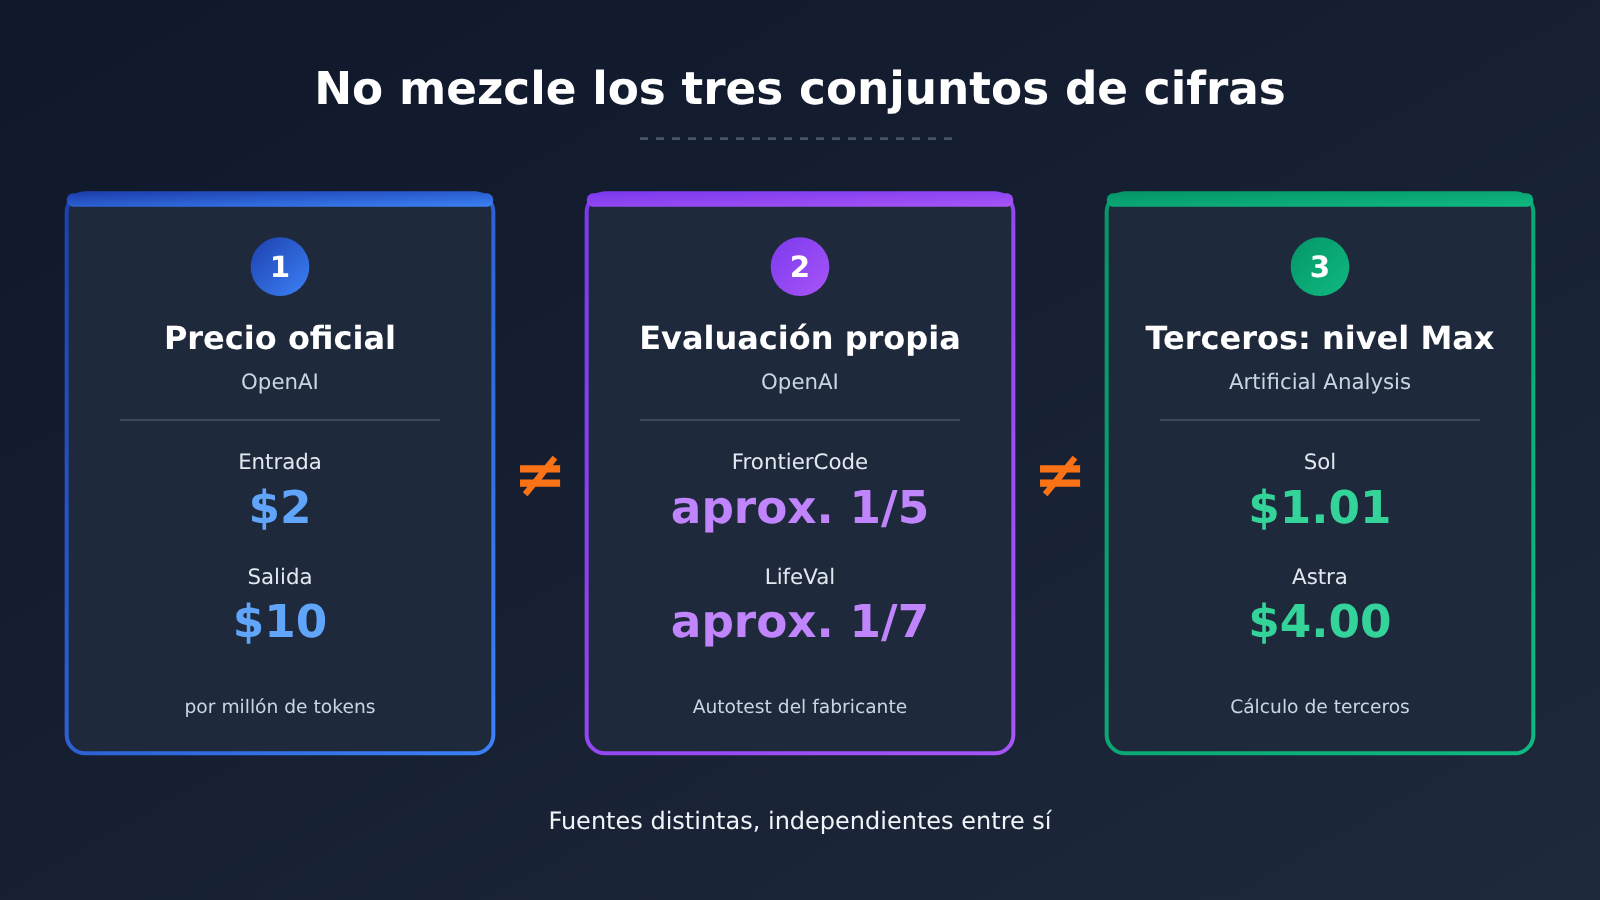
En el anuncio hay una afirmación que se presta a malentendidos: en FrontierCode 2.0 de Cognition (que evalúa si los cambios realizados sobre repositorios de código reales logran ser fusionados por los mantenedores), GPT-6.2 Sol y GPT-6.2 Astra difieren en menos de 0.5 puntos, con un costo de aproximadamente un quinto, y ambos usan el nivel de razonamiento Max. Es un dato autodeclarado por la propia OpenAI y corresponde únicamente a esa evaluación.
Eso no significa que cada solicitud con Sol cueste un quinto de lo que cuesta con Astra. Según las tarifas oficiales, Sol cuesta $2 en entrada y $10 en salida, mientras que Astra cuesta $8 y $40; la relación de precio unitario es de un cuarto. La proporción real de costo por solicitud también depende de cuántos tokens consuma cada modelo en la misma tarea. El consumo de tokens varía mucho entre tareas distintas, así que la proporción cambia de forma natural. Otro dato autodeclarado oficialmente es LifeVal: Sol obtiene una puntuación más alta que GPT-6 Astra con un costo de aproximadamente un séptimo, y de nuevo aplica solo a ese conjunto de tareas.
Las cifras de Artificial Analysis, un tercero independiente, pertenecen a otro sistema distinto. En su Intelligence Index v5.0.1, Sol obtiene 57 puntos en el nivel de razonamiento Max, con un costo por tarea de $1.01 en el índice compuesto; Astra obtiene 62 puntos en el nivel Max, con un costo por tarea de $4.00. Ese $1.01 pertenece únicamente a la evaluación del índice compuesto: no se puede multiplicar ni dividir con el «un quinto» oficial de FrontierCode, ni tomarlo como el costo de cada solicitud en tu negocio.
Comparación de tarifas oficiales de GPT-6.2 Sol con otros modelos
| Modelo (precio oficial, por 1 millón de tokens) | Entrada | Salida | Lectura de caché | Reglas de contexto ultralargo |
|---|---|---|---|---|
| GPT-6.2 Sol | $2 | $10 | $0.10 | Recargo sobre toda la solicitud al superar 272K |
| GPT-6.2 Astra | $8 | $40 | $0.40 | Recargo sobre toda la solicitud al superar 272K |
| Claude Fable 5.2 | $8 | $40 | $0.20 | La documentación no recoge esta regla |
| Claude Opus 5.5 | $4 | $20 | $0.20 | La documentación no recoge esta regla |
| Gemini 4 Carbon (hasta 11-30) | $2 | $10 | $0.10 | La lista de precios de Google no duplica el precio de toda la solicitud por 272K |
| Gemini 4 Carbon (desde 12-01) | $4 | $20 | $0.20 | Ídem |
Todos los precios de la tabla son tarifas oficiales de cada fabricante, no precios de la plataforma APIYI. El precio oficial de GPT-6.2 Astra es: entrada $8, lectura de caché $0.40, escritura de caché de 30 minutos $10 y salida $40. Igual que gpt-6.2-sol, todavía no está disponible en APIYI; lo añadiremos a la plataforma lo antes posible. Los modelos y precios de referencia son los que figuran en la lista de modelos de la plataforma. Además, Gemini 4 Carbon aparece en la página de descripción de APIYI con precio introductorio, y el aumento oficial está previsto para el 2026-12-01; a partir de ese momento, atente a la lista de la plataforma.
💡 Consejo para elegir: la tabla de precios unitarios solo refleja la diferencia de precio con la misma cantidad de tokens; no indica qué modelo resulta más económico en conjunto para tus tareas. Se recomienda comparar los modelos ya disponibles en APIYI (apiyi.com) con un mismo lote de solicitudes reales, revisar el usage y los resultados, y luego decidir.
Preguntas frecuentes (FAQ)
P1: ¿Cómo se factura GPT-6.2 Sol y por qué se calcula por separado?
GPT-6.2 Sol se factura por cada millón de tokens en cuatro categorías separadas: entrada ($2), lectura de caché ($0.10), escritura en caché ($2.50 para 30 minutos, $5 para 12 horas) y salida ($10). Estos son los precios estándar oficiales para contextos cortos. Los precios unitarios de las cuatro categorías llegan a diferir en más de cien veces, por lo que estimar solo con el total de tokens genera distorsiones graves.
P2: ¿Después de 272K el recargo se aplica solo a la parte que excede?
No. La página del modelo lo aclara: se calcula sobre la solicitud completa. En cuanto la entrada de una solicitud supera 272K, los precios de entrada y caché de toda esa solicitud se duplican, y la salida pasa a 1.5 veces. Cuando la entrada queda justo cerca del límite, vale la pena considerar comprimir el contexto para mantenerlo por debajo de 272K.
P3: ¿Cuándo se lanzó GPT-6.2 Sol y dónde se puede usar?
OpenAI lo lanzó el 2026-11-17. Según la información oficial, los planes Plus, Pro, Enterprise y Edu pueden usarlo en ChatGPT Work y Codex, los desarrolladores pueden invocarlo mediante la API de OpenAI, y contó con soporte para Ultrafast desde el lanzamiento. Todavía no está disponible en APIYI; lo incorporaremos a la plataforma lo antes posible. El modelo y el precio definitivos son los que figuren en la lista de modelos de la plataforma.
P4: Si la escritura en caché cuesta más que la entrada normal, ¿vale la pena usarla?
Depende de cuántas veces se reutilice. La escritura de 30 minutos cuesta $0.50 más por millón que la entrada normal, y cada acierto posterior ahorra $1.90. Si un prefijo se va a consultar más de una vez dentro de 30 minutos, normalmente ya se amortiza. La escritura de 12 horas cuesta $5 y es ideal para prefijos fijos que se reutilizan con alta frecuencia durante todo el día.
P5: ¿Cómo ensayar el proceso de estimación de costos antes de que 6.2 esté disponible?
Puedes practicar con gpt-6.1-sol, que ya está disponible. Según la información oficial, 6.2 Sol mantiene sus precios por token. Regístrate en APIYI (apiyi.com) y reclama el crédito de prueba; luego, con un cliente compatible con OpenAI, configura la base URL como `https://api.apiyi.com/v1`, registra las cuatro categorías del campo usage y aplica las fórmulas de este artículo. Ten en cuenta que el precio de plataforma de gpt-6.1-sol corresponde al modelo anterior y no significa que 6.2 ya esté disponible.
P6: ¿Cambiará el multiplicador de Ultrafast?
Sí. Hasta el 2027-02-28 (hora del Pacífico) será 3 veces el precio estándar, y a partir del 2027-03-01 pasará a 6 veces. Para presupuestos a largo plazo, se recomienda usar directamente 6 veces como tope.
P7: ¿Qué limitaciones conocidas tiene GPT-6.2 Sol?
La intensidad de razonamiento no se puede configurar como `none`, por lo que no es posible reducir el costo de salida desactivando el razonamiento. No admite entradas de audio ni de video, ni tampoco Realtime, Assistants ni fine-tuning. Artificial Analysis, un evaluador externo, señala que Sol obtiene 14 puntos menos que 6.1 Sol en SWE-Atlas-QnA-AA y tiende a omitir hechos clave. Las evaluaciones oficiales de alineación también indican que, en algunas pruebas, el modelo es más propenso a no reportar problemas bloqueantes como archivos faltantes o herramientas no disponibles.
Puntos clave de la tarificación de GPT-6.2 Sol (Key Takeaways)
- Facturación en cuatro columnas: entrada $2, lectura de caché $0.10, escritura de caché $2.50 o $5, salida $10 (precios oficiales para contexto corto)
- Regla del umbral de 272K para toda la solicitud: una vez superado el límite, los precios de entrada y caché de toda la solicitud se duplican y la salida pasa a 1.5 veces
- El nivel tiene el mayor impacto: Batch 0.5x, Fast 2x, Ultrafast 3x, y 6x a partir de marzo de 2027
- El «un quinto» tiene condiciones: solo aplica al FrontierCode 2.0 reportado por el propio proveedor (nivel Max), no significa que cada solicitud funcione así
- Los números de terceros se analizan por separado: los $1.01 del nivel Max de Artificial Analysis solo corresponden a esa evaluación del índice compuesto
- Cómo empezar: antes de que la 6.2 esté disponible, puedes probar primero en APIYI apiyi.com el flujo de registro de usage con gpt-6.1-sol
Resumen
Los puntos clave de la tarificación de GPT-6.2 Sol:
- Cálculo por columnas: multiplica cada una de las cuatro columnas (entrada, lectura de caché, escritura de caché y salida) por su precio unitario; no olvides incluir la escritura de caché.
- Primero verifica los 272K: al cruzar el umbral, toda la solicitud se cobra con precios de contexto largo; en el segundo ejemplo, usar por error los precios cortos subestima el costo casi a la mitad.
- Al final, aplica el multiplicador: el factor del nivel determina el orden de magnitud de la factura; la fecha de cambio de Ultrafast debe quedar reflejada en el presupuesto.
Al estimar costos, primero calcula el gasto de las solicitudes cotidianas con la fórmula del ejemplo corto, luego revisa los casos límite con el ejemplo ultralargo y, por último, registra por separado las cifras oficiales, las evaluaciones de terceros y tu propio usage; no los mezcles en una sola conclusión.
Se recomienda validar primero las estadísticas de usage y el modelo de costos en APIYI apiyi.com con los modelos ya disponibles. Cuando gpt-6.2-sol esté en el catálogo, bastará con reemplazar el ID del modelo y los precios unitarios para seguir utilizándolo.
📚 Referencias
-
Artículo de lanzamiento de OpenAI: Presentación de GPT-6.2 Astra y Sol, que incluye las evaluaciones oficiales autoreportadas y un resumen de precios
- Enlace:
openai.com/index/introducing-gpt-6-2-astra-sol - Nota: Fuente de los datos oficiales autoreportados como FrontierCode, LifeVal y otros
- Enlace:
-
Página del modelo gpt-6.2-sol de OpenAI: Especificaciones, tabla de precios de cuatro columnas, regla de 272K y multiplicadores por nivel
- Enlace:
platform.openai.com/docs/models/gpt-6.2-sol - Nota: Base principal de las reglas de facturación de este artículo
- Enlace:
-
System Card de OpenAI: Evaluaciones de seguridad y alineación
- Enlace:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Nota: Para conocer las estrategias de protección y las limitaciones de comportamiento conocidas
- Enlace:
-
Evaluación de terceros de Artificial Analysis: Puntuaciones por nivel de razonamiento del Intelligence Index v5.0.1 y costo por tarea
- Enlace:
artificialanalysis.ai/models/gpt-6-2-sol - Nota: Datos de terceros; el costo por tarea de $1.01 en el nivel Max corresponde únicamente a este conjunto de evaluaciones
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: Te invitamos a contactarnos a través de la página principal del sitio web oficial de APIYI para obtener más recursos sobre la integración de modelos y la facturación


