
Nota del autor: este artículo se basa en la publicación oficial de investigación de Claude Fable 5.2, en la que completó dos problemas de física de agujeros negros con múltiples agentes, para ordenar prácticas aplicables cuando se ejecutan tareas intensivas con agentes: elegir modelos, separar roles y definir líneas de parada.
El 17 de noviembre de 2026, Anthropic publicó una investigación: varias copias de Claude Fable 5.2 se ejecutaron en segundo plano durante unas seis semanas y resolvieron dos problemas de física de agujeros negros. Para quienes desarrollan tareas largas y sistemas multiagente, lo interesante no es la física en sí, sino que muestra una forma de trabajar prolongada en el tiempo, paralela en varios frentes y con verificación mutua.
Esto no es un artículo de divulgación científica sobre física, ni tampoco va a determinar qué interfaz es más estable. Este artículo hace solo una cosa: traducir las señales de ingeniería que se pueden aprovechar de la investigación en pasos que puedas seguir cuando ejecutes tus propias tareas intensivas con agentes.
Valor central: después de leer esto, sabrás cómo separar la inferencia principal y la revisión en roles distintos, cómo escribir una línea de parada clara para cada ruta de agente, y cómo elegir solo entre modelos que tienen precios explícitos en la tabla de modelos, de modo que el coste de las tareas largas sea predecible y se pueda poner un tope.
Lo que una publicación de investigación sobre Claude Fable 5.2 revela sobre las tareas intensivas con agentes
Primero, un poco de contexto. La publicación de investigación es una declaración oficial de Anthropic; los dos artículos mencionados son por ahora prepublicaciones, no artículos que ya hayan pasado por revisión por pares. Ambos problemas pertenecen a la física teórica, no describen el universo en el que vivimos y no tienen aplicaciones prácticas, así que su relevancia está sobre todo en el “método”, no en “cuán importantes son las conclusiones”.
Según la publicación, en agosto de 2026 el investigador Hongbin Chen pidió a Claude que enumerara problemas abiertos en el área de agujeros negros y bootstrap, y en pocas horas obtuvo 22. Asignó un agente independiente a cada problema; los agentes podían leer el progreso de los demás y luego se ejecutaron en segundo plano durante unas seis semanas. La publicación afirma textualmente: “sin configuración especial”, pero esa es la descripción oficial de cómo se montó, no equivale a costo cero, y la publicación tampoco presenta un desglose de costos.
| Hechos de la publicación de investigación | Lecciones para tareas intensivas con agentes | Qué puedes hacer |
|---|---|---|
| Un agente por problema, los agentes pueden leer el progreso de los demás | La granularidad de la división de tareas debe ser clara y el estado compartido debe ser legible | Un agente independiente por subtarea; el progreso se escribe en almacenamiento compartido |
| Casi cada paso lo realizan de forma independiente dos agentes y luego se contrasta con la literatura | Los pasos críticos necesitan una revisión independiente | Separar la inferencia principal y la revisión en dos roles |
| Los agentes iniciales lo intentaron en paralelo 61 veces sin conseguirlo | El fracaso es la norma; debe haber un límite para los fracasos | Define claramente para cada vía el número máximo de fallos y el presupuesto |
| Los resultados se verifican formalmente con Lean y los revisan físicos | Los resultados de la máquina deben validarse externamente al final | Reserva una etapa de validación humana o con herramientas |
| Se ejecutó en segundo plano durante unas seis semanas | El costo de las tareas largas se acumula | Estima con los precios de la tabla de modelos y establece un tope de gasto |
Qué nos enseñan los dos problemas de las tareas intensivas con agentes
El primer problema es el cálculo de la transición de fase de Hawking-Page, planteado en 2003 y que nunca se había terminado de resolver. El post cuenta que casi todos los pasos los realizaron dos agentes de forma independiente y luego los contrastaron con la literatura; la conclusión es que, con acoplamiento débil, la transición sigue siendo abrupta. Otro físico llegó por su cuenta al mismo resultado con un método distinto, lo que aportó una validación cruzada. Para la práctica de la ingeniería, este problema ilustra la idea de revisión basada en “repetición independiente + contraste externo”.
El segundo problema es el de la cota superior de la versión más simple del bootstrap modular. Un grupo anterior de agentes Claude lo intentó en paralelo 61 veces sin éxito; los agentes posteriores detectaron un patrón en los resultados numéricos, tomaron prestado el método de otro problema de empaquetamiento de esferas y demostraron que la masa del agujero negro más ligero tiene una cota superior de aproximadamente c/9.1266, además de señalar que este método no permite bajar más esa cota. En septiembre de 2026, el resultado se verificó formalmente con Lean; el artículo fue redactado por Claude y los físicos revisaron los resultados principales. La lección para la ingeniería que deja este problema es que una gran cantidad de intentos fallidos forma parte del proceso, así que cada vía debe tener un presupuesto y condiciones de parada.
Conviene aclarar algo: lo que describe el post es “varias copias del mismo modelo se comprueban entre sí”, no “usar un modelo caro para planificar y uno barato para revisar”. El esquema de ahorro basado en separar roles que aparece más abajo es una práctica de ingeniería que los lectores pueden probar, no una conclusión ya validada por esta investigación.
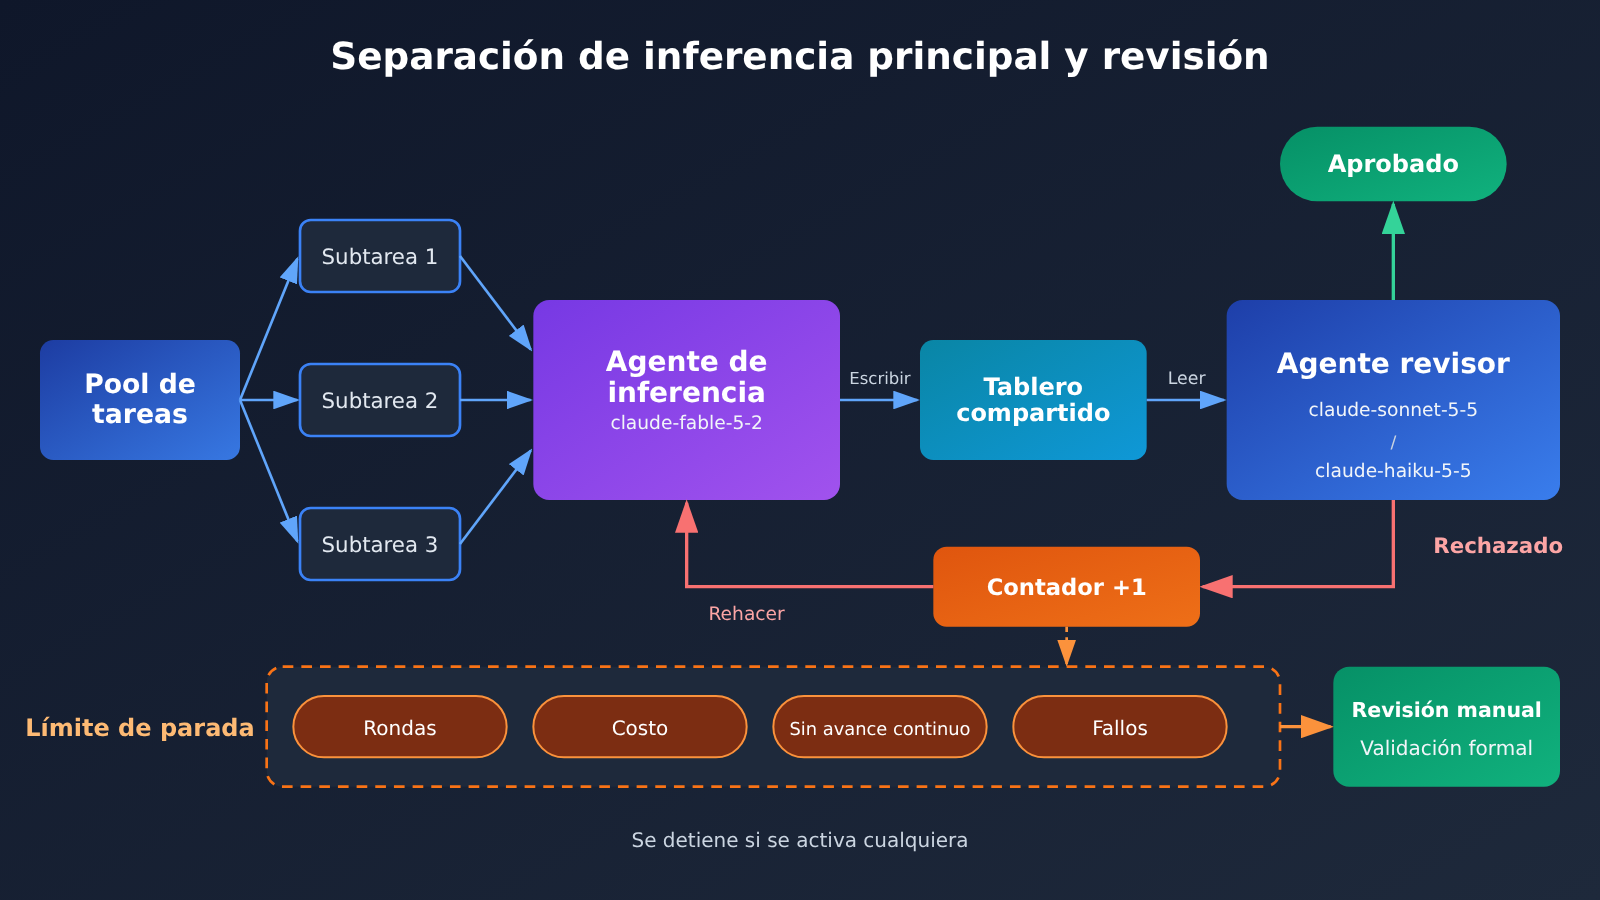
Cómo dividir roles en tareas intensivas de Agent: inferencia principal y revisión por separado
En las tareas intensivas de Agent, lo más caro suele ser la ruta que requiere razonamiento profundo, mientras que lo más frecuente son las acciones de revisión: comprobaciones, comparaciones, validación de formato, etc. Si todas las invocaciones usan el mismo modelo más costoso, el gasto crecerá de forma lineal o incluso superlineal con cada ronda. Dividir “pensarlo” y “comprobarlo” en dos roles es la forma más directa de controlar los costos.
El principio de división se puede resumir así: los pasos que requieren razonamiento exploratorio y planificación de cadenas largas se asignan al rol de inferencia principal; las comprobaciones con criterios claros, como “¿este paso coincide con el anterior?”, “¿el formato de salida cumple las reglas?” o “¿la conclusión entra en conflicto con literatura conocida?”, se asignan al rol de revisión. El rol de revisión debe emitir un juicio estructurado, no volver a hacer toda la inferencia.
| Rol | Responsabilidades | ID de modelo candidato | Salida requerida |
|---|---|---|---|
| Inferencia principal | Derivación exploratoria, generación de soluciones, pasos clave | claude-fable-5-2、claude-fable-5-2-thinking |
Proceso de razonamiento completo y conclusiones intermedias |
| Revisión primaria | Coherencia lógica, comparación de pasos, verificación de citas | claude-sonnet-5-5 |
PASS / FAIL con justificación |
| Validación ligera | Comprobación de formato, integridad de campos, comparaciones simples | claude-haiku-5-5 |
Resultado JSON estructurado |
| Validación externa | Prueba formal, verificación numérica, revisión humana | Herramientas o personas | Confirmación final |
Con esta división, todos los roles pueden usar el mismo punto de entrada de invocación. A través de APIYI (apiyi.com), una sola clave API permite alternar entre los modelos de la tabla anterior; la interfaz es compatible con OpenAI, así que para la inferencia principal y la revisión solo hay que cambiar el parámetro model, sin mantener varios SDK ni varias claves. Para tareas largas que requieren varias rutas en paralelo, un punto de entrada unificado también centraliza las estadísticas de consumo, lo que facilita la conciliación.
Sin embargo, que el modelo de revisión sea más barato no significa que sea más fiable. Que el rol de revisión esté a la altura depende de si los criterios de juicio que le das son suficientemente claros. Se recomienda ejecutar primero una muestra pequeña con respuestas conocidas, confirmar que sus decisiones de aprobación y rechazo coinciden en lo esencial con lo esperado, y luego incorporarlo a tareas largas.
Cómo elegir APIs para tareas intensivas de Agent: precios e IDs de modelo
El control de presupuesto en tareas largas parte de una premisa: el precio unitario de cada llamada debe ser determinístico. Recomiendo aferrarse a un principio: invoca únicamente modelos que tengan un precio explícito en la tabla de modelos, y fija en el código el ID del modelo junto con su precio unitario correspondiente, en lugar de cambiar de modelo sobre la marcha durante la ejecución.
Según la página oficial de modelos de Anthropic, Claude Fable 5.2 se lanzó el 9 de noviembre de 2026, su ID de modelo es claude-fable-5-2, tiene una ventana de contexto de 1 millón de tokens, una salida máxima de 128 mil tokens, y el razonamiento viene activado por defecto. La siguiente tabla recoge los precios de la tabla general de modelos de APIYI apiyi.com correspondientes a los modelos relevantes para este artículo, en la fecha de verificación (2026-11-19), en dólares por millón de tokens.
| ID del modelo | Entrada | Lectura de caché | Salida | Rol sugerido en este artículo |
|---|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 | Razonamiento principal |
claude-fable-5-2-thinking |
8 | 0.2 | 40 | Razonamiento principal (versión con razonamiento) |
claude-fable-5-1 |
10 | 0.25 | 50 | Versión adyacente, para comparación |
claude-sonnet-5-5 |
2 | 0.1 | 10 | Revisión de primer nivel |
claude-haiku-5-5 |
0.1 | 0.01 | 0.5 | Verificación ligera |
De la tabla se pueden extraer varias ideas clave para tareas largas. Primero, el precio de claude-fable-5-2 es menor que el de la versión adyacente claude-fable-5-1; si tu razonamiento principal venía usando la versión anterior, vale la pena evaluar la migración. Segundo, el precio de lectura de caché es solo el 2.5% del precio de entrada; en tareas largas, el agente lee repetidamente el progreso compartido, la indicación del sistema y los documentos de contexto, y si esta parte logra aprovechar la caché, la diferencia de costos será muy notable. Que se aproveche o no depende de la forma de invocación y de las reglas de la plataforma, y se rige por lo que indique la documentación. Tercero, la diferencia de precio unitario entre el modelo de revisión y el de razonamiento principal es de un orden de magnitud.
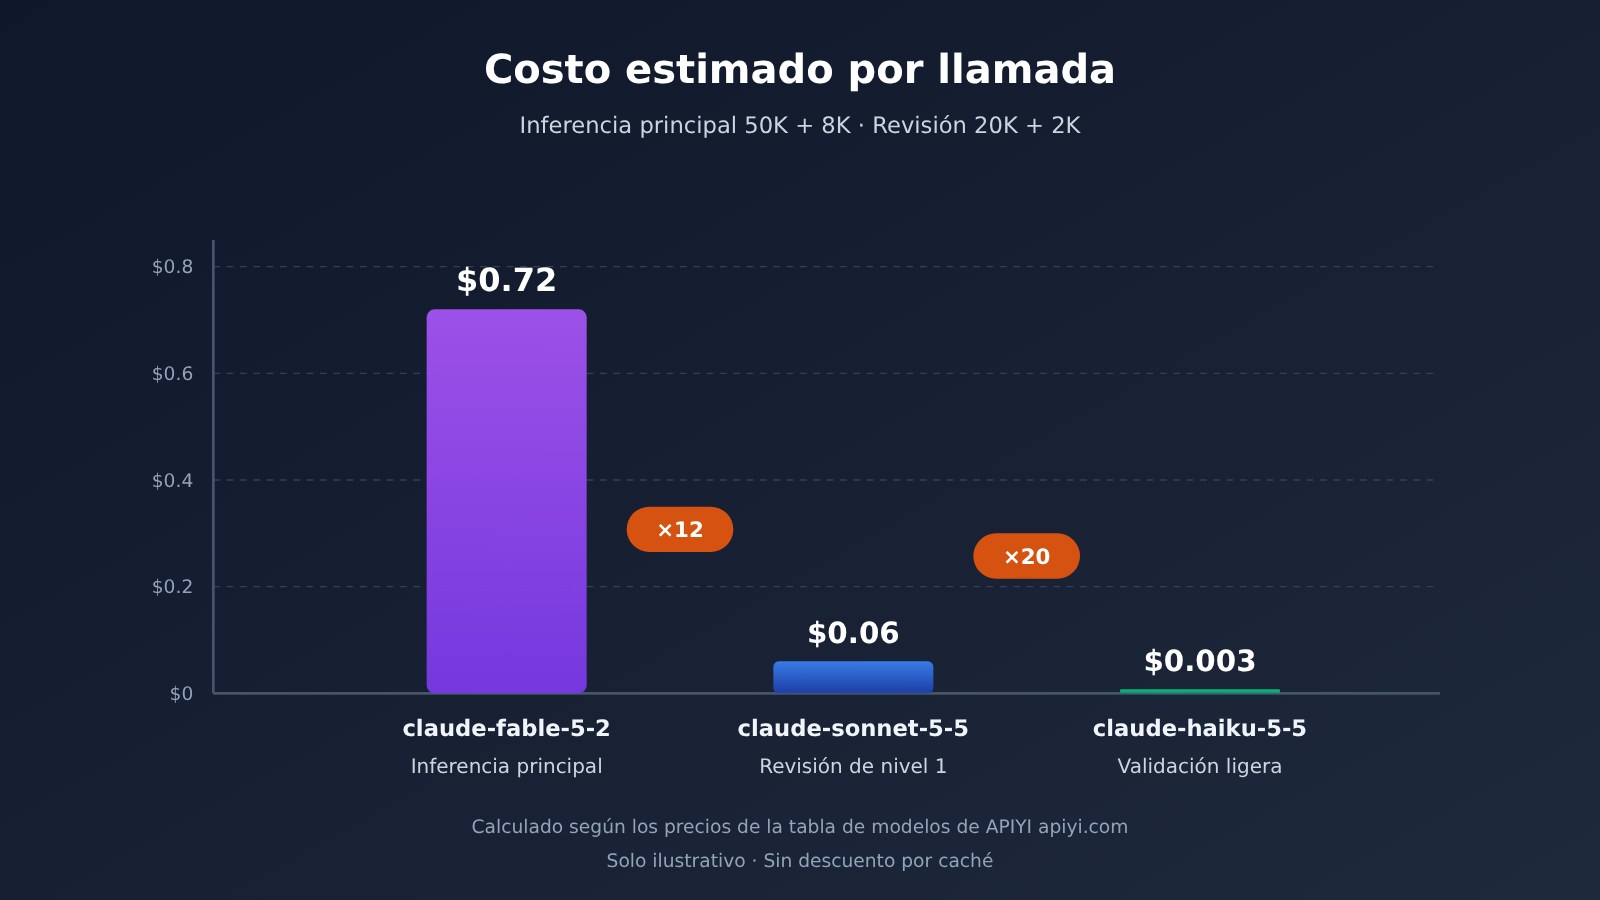
Veamos con un conjunto de números hipotéticos: una llamada de razonamiento principal con 50 mil tokens de entrada y 8 mil de salida cuesta aproximadamente 0.4 + 0.32 = 0.72 USD en claude-fable-5-2; una revisión con 20 mil de entrada y 2 mil de salida cuesta aproximadamente 0.04 + 0.02 = 0.06 USD en claude-sonnet-5-5, y aproximadamente 0.003 USD en claude-haiku-5-5. Si la revisión también usara el modelo de razonamiento principal, la misma llamada de revisión costaría aproximadamente 0.16 + 0.08 = 0.24 USD. Esto es solo un ejemplo aritmético; el número real de tokens depende de tu tarea.
Además, en la página oficial de modelos, el precio de Opus 5.5 es de 4 de entrada y 20 de salida, Sonnet 5.5 es de 2 y 10, y Haiku 5.5 parte de 0.10 y 0.50, lo que sirve como referencia para entender el gradiente de precios oficial. En la práctica, el modelo y el precio se rigen por la lista de modelos de la plataforma; la serie claude-fable-5-2 de APIYI admite tanto el endpoint chat como el de messages, con una entrada unificada en https://api.apiyi.com/v1.
Inicio rápido para tareas intensivas de Agent: código de orquestación con línea de parada
Ejemplo minimalista
Primero confirma que el modelo principal de inferencia se puede invocar correctamente y que devuelve el campo usage; esto es la base para el cálculo de costos más adelante:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Interfaz compatible con OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "列出这一步推导需要独立核对的三个关键假设"}],
    max_tokens=2000,
)
print(resp.choices[0].message.content)
print(resp.usage)  # Para contar tokens y estimar costos
Definir líneas de parada claras para cada ruta de agente
En los posts de investigación, los agentes iniciales hicieron 61 intentos en paralelo sin lograr éxito, y eso nos recuerda algo: las tareas de Agente pesadas siempre van a acumular muchos intentos fallidos, y los fallos también cuestan dinero. La función de la línea de parada es hacer que cada ruta de agente se detenga automáticamente antes de descontrolarse, para que una persona o una herramienta decida qué hacer.
| Línea de parada | Significado | Valor inicial recomendado (ajustar según la tarea) |
|---|---|---|
| Número máximo de rondas | Límite superior de idas y vueltas entre el razonamiento principal y la revisión | 10-30 rondas |
| Tope de coste | Límite superior del coste estimado acumulado por ruta | Según el presupuesto por problema |
| Sin progreso consecutivo | La revisión devuelve repetidamente sin nuevas conclusiones | 3-5 veces |
| Número máximo de fallos | Número acumulado de devoluciones por la revisión | Alrededor de la mitad del número de rondas |
| Longitud de salida | Límite superior de tokens por salida individual | Muy por debajo del máximo de salida de 128 mil |
Ver el código de implementación completo
from dataclasses import dataclass, field
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Entrada unificada de APIYI, compartida por la inferencia principal y la revisión
)

# Precio unitario: USD / millón de tokens, fijado según la tabla de modelos de la plataforma; actualizar a mano cuando cambie
PRICES = {
    "claude-fable-5-2": (8.0, 40.0),
    "claude-sonnet-5-5": (2.0, 10.0),
    "claude-haiku-5-5": (0.1, 0.5),
}

SOLVER = "claude-fable-5-2"
REVIEWER = "claude-sonnet-5-5"


@dataclass
class StopLine:
    max_rounds: int = 20
    max_cost_usd: float = 5.0
    max_no_progress: int = 4
    max_failures: int = 10
    max_output_tokens: int = 8000


@dataclass
class RunState:
    rounds: int = 0
    cost_usd: float = 0.0
    failures: int = 0
    no_progress: int = 0
    notes: list = field(default_factory=list)


def estimate_cost(model: str, usage) -> float:
    """Estimación según el precio de lista, sin descuentos de caché; el resultado es conservador."""
    price_in, price_out = PRICES[model]
    return (usage.prompt_tokens * price_in + usage.completion_tokens * price_out) / 1_000_000


def call(model: str, messages: list, max_tokens: int, state: RunState) -> str:
    resp = client.chat.completions.create(
        model=model, messages=messages, max_tokens=max_tokens
    )
    state.cost_usd += estimate_cost(model, resp.usage)
    return resp.choices[0].message.content


def should_stop(state: RunState, line: StopLine) -> str | None:
    if state.rounds >= line.max_rounds:
        return "达到最大轮数"
    if state.cost_usd >= line.max_cost_usd:
        return "达到费用封顶"
    if state.no_progress >= line.max_no_progress:
        return "连续无进展"
    if state.failures >= line.max_failures:
        return "失败次数过多"
    return None


def run_task(task: str, line: StopLine = StopLine()) -> dict:
    state = RunState()
    progress = "(尚无进展)"

    while True:
        reason = should_stop(state, line)
        if reason:
            return {"status": "stopped", "reason": reason, "progress": progress,
                    "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}

        state.rounds += 1
        draft = call(SOLVER, [
            {"role": "system", "content": "你是主推理代理,只推进一步,写清依据。"},
            {"role": "user", "content": f"任务:{task}\n当前进展:{progress}\n请推进下一步。"},
        ], line.max_output_tokens, state)

        verdict = call(REVIEWER, [
            {"role": "system", "content": "你是复核代理,不重新推导,只判断。"
                                          "第一行只输出 PASS 或 FAIL,第二行给理由。"},
            {"role": "user", "content": f"已有进展:{progress}\n新的一步:{draft}"},
        ], 500, state)

        if verdict.strip().upper().startswith("PASS"):
            progress = draft
            state.no_progress = 0
            if "已完成" in draft:
                return {"status": "done", "progress": progress,
                        "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}
        else:
            state.failures += 1
            state.no_progress += 1
            state.notes.append(verdict)


if __name__ == "__main__":
    print(run_task("核对给定推导中每一步的符号约定是否一致,完成后写“已完成”"))
Este código tiene tres decisiones de diseño deliberadas. Primera, la tabla de precios está escrita directamente en el código, así que cualquiera que cambie de modelo tiene que cambiar también los precios: así se evita que «cambiar a un modelo sin precio listado» distorsione el presupuesto. Segunda, al rol de revisión se le pide que solo emita PASS o FAIL más una razón, sin volver a deducir nada, para controlar la longitud de su salida. Tercera, al detenerse devuelve el progreso actual y el costo acumulado, para que una persona pueda retomar el trabajo fácilmente, en lugar de dejar al agente reintentando sin fin.
🚀 Inicio rápido: Se recomienda empezar con el crédito de prueba gratuito para nuevos usuarios en APIYI apiyi.com, ejecutar de principio a fin el flujo anterior con una pregunta pequeña cuya respuesta ya conozcas, comprobar que el juicio de revisión y la estimación de costos cumplen con lo esperado, y luego aumentar poco a poco el número de rutas paralelas y de rondas.
Preguntas frecuentes sobre cómo elegir una API para tareas de agentes de alta exigencia
Q1: ¿Es creíble que Claude Fable 5.2 haya resuelto un problema difícil de física de agujeros negros?
Se trata de una declaración de la propia Anthropic en su publicación de investigación del 17 de noviembre de 2026. Los dos artículos relacionados son preprints y aún no han pasado revisión por pares. El resultado del segundo problema se verificó formalmente con Lean en septiembre de 2026; para el primero, otro físico llegó a la misma respuesta usando un método diferente. Conviene interpretarlo como «declaración oficial + preprint».
Q2: La publicación dice «sin configuración especial». ¿Eso significa que es muy barato?
No. «Sin configuración especial» describe la forma de montaje; la publicación no incluye un desglose de costes. Eran 22 problemas, un agente por problema y unas seis semanas de ejecución en segundo plano: el volumen de llamadas no es pequeño. Si ejecutas tareas de escala similar por tu cuenta, calcula el coste con los precios de la tabla de modelos y establece un tope de gasto.
Q3: ¿Usar un modelo barato para verificar es una práctica validada en la publicación de investigación?
No. Lo que hace la publicación es que varias copias del mismo modelo rehagan la tarea de forma independiente y se comprueben entre sí. «Inferencia principal con un modelo caro y verificación con uno barato» es una práctica de ingeniería que este artículo te sugiere probar; sus resultados debes validarlos en tus propias tareas. Para pasos con requisitos de corrección muy altos, también puedes mantener la modalidad de «dos inferencias principales rehechas de forma independiente».
Q4: ¿Cómo elegir entre `claude-fable-5-2` y `claude-fable-5-2-thinking`?
Ambos tienen el mismo precio de lista en la tabla de modelos de APIYI: entrada 8, lectura de caché 0.2 y salida 40 USD por millón de tokens. La página oficial del modelo indica que el modo thinking de Fable 5.2 está activado por defecto. Las diferencias concretas de comportamiento de invocación entre ambos ID deben consultarse en la descripción del modelo de la plataforma; se recomienda ejecutar la misma tarea varias veces con cada uno, comparar la longitud de salida y `usage`, y luego decidir cuál usar para la inferencia principal.
Q5: ¿Cómo llamar a la vez al modelo de inferencia principal y al de verificación mediante un solo endpoint?
Después de registrarte en APIYI apiyi.com y obtener una clave API, configura el base_url del SDK como `https://api.apiyi.com/v1`; para la inferencia principal y la verificación solo tienes que cambiar el parámetro `model`, por ejemplo entre `claude-fable-5-2` y `claude-sonnet-5-5`. Los usuarios nuevos tienen crédito de prueba gratuito, ideal para validar primero el límite de parada y la lógica de verificación.
Q6: ¿Qué importancia tiene el precio de lectura de caché en tareas largas?
El precio de lectura de caché de Fable 5.2 es el 2.5 % del precio de entrada, es decir, 0.2 USD por millón de tokens. Las tareas largas con múltiples agentes leen repetidamente las indicaciones del sistema, los materiales de contexto y el progreso compartido; si ese contenido se mantiene estable y se coloca al principio de la indicación, hay más probabilidades de acertar en la caché. Que se acierte o no y cómo se factura debe consultarse en la documentación de la plataforma.
Q7: ¿Qué valor es adecuado para el límite de parada?
No hay una cifra universal. Se recomienda empezar con valores conservadores: 10-30 rondas, 3-5 ausencias consecutivas de progreso y un tope de coste por ruta según el valor del problema. Después de completar un lote, revisa la distribución de motivos de parada; si la mayoría es «tope de coste» pero ya está cerca de completarse, relájalo un poco; si la mayoría es «sin progreso consecutivo», significa que la tarea no está desglosada con suficiente detalle.
P8: ¿Qué limitaciones tiene este enfoque?
Primero, el modelo de revisión puede dejar pasar algo o juzgarlo mal, así que hay que calibrarlo con muestras de respuestas ya conocidas. Segundo, la estimación de costos se basa en el precio de lista y no tiene en cuenta los descuentos de caché ni las fluctuaciones por reintentos fallidos. Tercero, como en el hilo de investigación, la conclusión final sigue necesitando verificación externa, por ejemplo una prueba formal o la revisión de un experto del dominio; que los agentes se aprueben unos a otros no significa que el resultado sea correcto.
Puntos clave al elegir una API para tareas intensivas de agentes Key Takeaways
- Calificar el origen: la investigación de Fable 5.2 sobre agujeros negros es una declaración oficial de la empresa y el paper es un preprint; mira el método, no las conclusiones
- Separar roles: la inferencia abierta se la dejas al modelo de razonamiento principal, y las comprobaciones con criterios claros al modelo de revisión
- La revisión debe ser independiente: el revisor solo juzga, no vuelve a razonar; entrega PASS / FAIL más el motivo
- Las líneas de parada son obligatorias: número de rondas, costo, falta de progreso consecutiva y número de fallos; las cuatro líneas son imprescindibles
- Usa solo modelos con precio de lista: el ID del modelo y el precio unitario se escriben fijos en el código; si cambias de modelo, debes actualizar el precio al mismo tiempo
- Aprovecha la lectura de caché: deja el contexto estable y el progreso en la parte inicial; la lectura de caché cuesta solo el 2.5% del precio de entrada
- Empieza con un único punto de entrada: mediante APIYI, cambias entre el modelo de razonamiento principal y el de revisión con una sola clave API; primero corre problemas pequeños con la cuota gratuita
Resumen
Partiendo del caso de Claude Fable 5.2 resolviendo problemas de física de agujeros negros, hay tres lecciones que vale la pena aplicar a las tareas agénticas de alto exigencia:
- Separar la inferencia principal de la revisión: la publicación de investigación usó varias copias del mismo modelo para verificarse entre sí; sobre esa base puedes probar a elegir modelos de distintos precios según el rol y validar la calidad de la revisión con muestras.
- Definir con claridad la línea de parada en cada vía: los 61 intentos fallidos demuestran que el fracaso es lo normal; el número de rondas, el costo, la falta de progreso y el número de fallos deben tener todos un tope.
- Invocar solo modelos con precio en la tabla: escribe en el código los ID de modelos como
claude-fable-5-2,claude-sonnet-5-5,claude-haiku-5-5y sus precios unitarios, para que el costo sea previsible y pueda tener un tope.
El éxito o fracaso de una tarea larga a menudo no depende de lo inteligente que sea una llamada concreta, sino de si el proceso global puede avanzar de forma sostenida dentro de un presupuesto controlado y dejar resultados verificables. Se recomienda usar el crédito de prueba gratuito de APIYI apiyi.com para completar primero un problema pequeño y, después, ajustar los parámetros según el motivo de parada y escalar gradualmente.
📚 Referencias
-
Publicación de investigación de Anthropic: descripción oficial sobre cómo múltiples agentes completaron dos problemas de física de agujeros negros con Claude Fable 5.2
- Enlace:
anthropic.com/research/claude-black-hole-physics - Descripción: descripción de primera mano sobre la división de trabajo entre agentes, la duración y el método de revisión
- Enlace:
-
Preprint uno: preprint asociado a la publicación de investigación, sin revisión por pares
- Enlace:
hexagonmath.org/2611.00175v1 - Descripción: adecuado para lectores que quieran consultar el texto original de los resultados
- Enlace:
-
Preprint dos: otro preprint asociado a la publicación de investigación, sin revisión por pares
- Enlace:
hexagonmath.org/2611.00174v1 - Descripción: para leerlo en comparación con el anterior
- Enlace:
-
Página oficial del modelo Claude Fable 5.2: ID del modelo, contexto, salida máxima y precio oficial
- Enlace:
platform.claude.com/docs/en/models/fable-5-2/overview - Descripción: verificar las especificaciones del modelo y la escala de precios oficial
- Enlace:
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página principal del sitio de APIYI; las especificaciones de modelos y precios están disponibles en el centro de documentación docs.apiyi.com


