
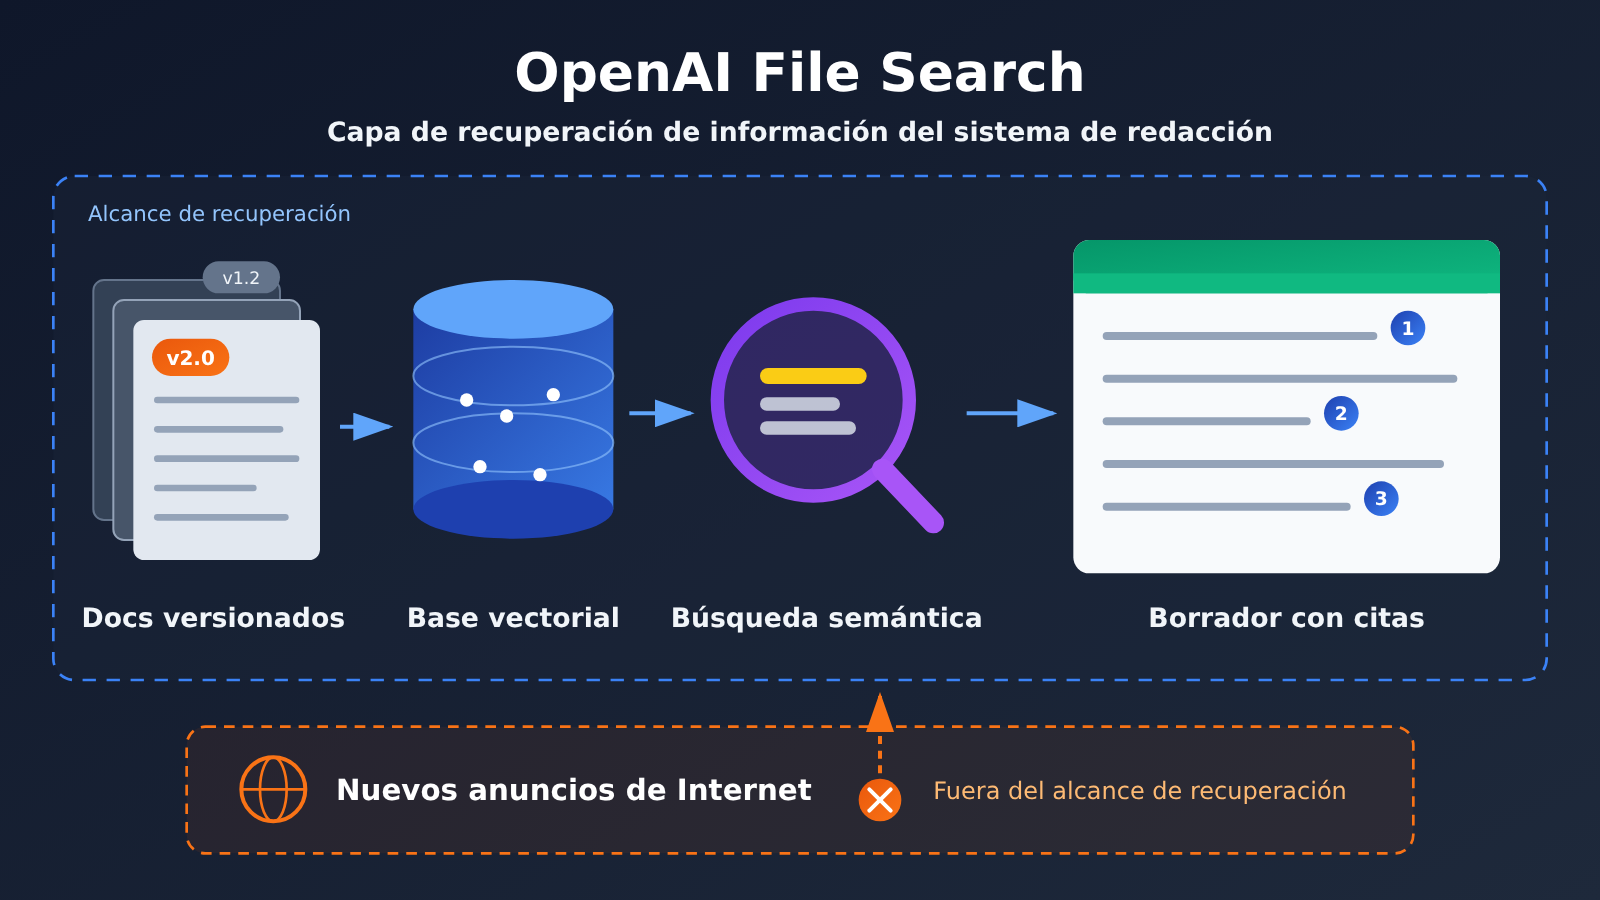
Puede cubrir una parte, pero no todo. OpenAI File Search resuelve el problema de «no encontrar con precisión el material que ya existe y de tener citas poco claras». Puede buscar archivos por semántica en una base vectorial y añadir referencias a los archivos en la respuesta; para un sistema de escritura, eso resulta muy útil. No resuelve el problema de «que falte material o que esté desactualizado»: la herramienta solo busca en los archivos que ya has cargado y no descubre por su cuenta nuevos anuncios publicados en internet. Las marcas de cita solo indican de qué archivo procede el contenido; no garantizan que la conclusión esté bien formulada.
Así que la conclusión más precisa es esta: File Search puede actuar como la «capa de recuperación de material» de un sistema de escritura; la recopilación de material, la gestión de versiones y la revisión factual siguen siendo tareas aparte.
¿Qué puedes aprender al leer este artículo?
- Qué papel ocupa File Search dentro de Responses API y qué capacidades puede aportar al flujo de escritura
- Cómo ajustar la cantidad de resultados recuperados y cómo hacer que la respuesta devuelva el contenido realmente recuperado, para facilitar la depuración
- Por qué un archivo borrado puede seguir apareciendo en los resultados durante un tiempo y cómo debería responder el sistema de escritura
- En qué capa conviene corregir cada uno de estos tres tipos de problema: material faltante, fallo de recuperación y error de generación
- Qué metadatos conviene guardar al indexar documentos para evitar presentar restricciones obsoletas como reglas vigentes
Índice: La introducción del texto explica primero algunos conceptos clave y enumera las implicaciones por tipo de audiencia. La sección «Hechos objetivos» se basa en la documentación oficial de OpenAI y repasa cómo funciona File Search, sus parámetros ajustables y su comportamiento conocido. La sección «Análisis y valoración» trata de cómo encaja dentro de un sistema de escritura, la ruta de diagnóstico de problemas y las normas de indexación; por último, señala varias ideas erróneas de las que conviene mantenerse alerta.
Conceptos relacionados con OpenAI File Search que conviene conocer
| Concepto | Explicación breve |
|---|---|
| Responses API | Interfaz de generación de respuestas de OpenAI que permite adjuntar herramientas en una sola solicitud; File Search es una de ellas. |
| File Search | Herramienta integrada en Responses API que recupera fragmentos relevantes de los archivos de un almacén vectorial para ayudar a generar la respuesta. |
| Almacén vectorial (Vector Store) | Lugar donde se guardan los archivos subidos y sus representaciones vectoriales; es el ámbito de búsqueda de File Search. |
| Búsqueda semántica | Busca contenido por similitud de significado, de modo que también encuentra fragmentos expresados con palabras distintas pero relacionados por su sentido. |
| Referencia de archivo (Citation) | Indica, dentro de la respuesta, de qué archivo proviene un fragmento, para que lectores y revisores puedan consultarlo. |
max_num_results |
Parámetro que controla cuántos resultados como máximo devuelve una búsqueda. |
include |
Parámetro de la solicitud; al pasar file_search_call.results, la respuesta incluirá el contenido realmente recuperado. |
| Consistencia eventual | Las operaciones de escritura o borrado no se reflejan de inmediato en todas partes; durante un breve periodo puede verse el estado anterior. |
Impacto de OpenAI File Search de un vistazo
| Perfil | Impacto principal |
|---|---|
| Desarrolladores de sistemas de redacción | Pueden obtener búsqueda semántica y referencias a archivos sin crear su propio servicio de recuperación. Aun así, deben diseñar sus propias normas de ingesta y procesos de diagnóstico. |
| Editores y revisores de contenido | Las referencias facilitan la comprobación, pero aún hay que verificar cada conclusión; no se puede aprobar algo solo porque “tiene referencias”. |
| Responsables del mantenimiento de documentación técnica | Deben indicar claramente la versión y la fecha de los documentos antiguos y nuevos; de lo contrario, una limitación antigua puede recuperarse y acabar en un artículo nuevo. |
| Responsables de costos | Tanto el almacenamiento en el almacén vectorial como las llamadas a herramientas se facturan; consulta la página de precios actual de OpenAI. Cuando el volumen de material es grande, conviene hacer una estimación. |
Hechos objetivos sobre OpenAI File Search
El siguiente contenido se basa en las dos guías de la documentación para desarrolladores de OpenAI: File Search y Retrieval, con fecha de verificación 2026-11-17. Ambas son documentos que se mantienen actualizados; este artículo no verificó la fecha de lanzamiento inicial de esta función.
Qué es File Search: la herramienta de recuperación en Responses API
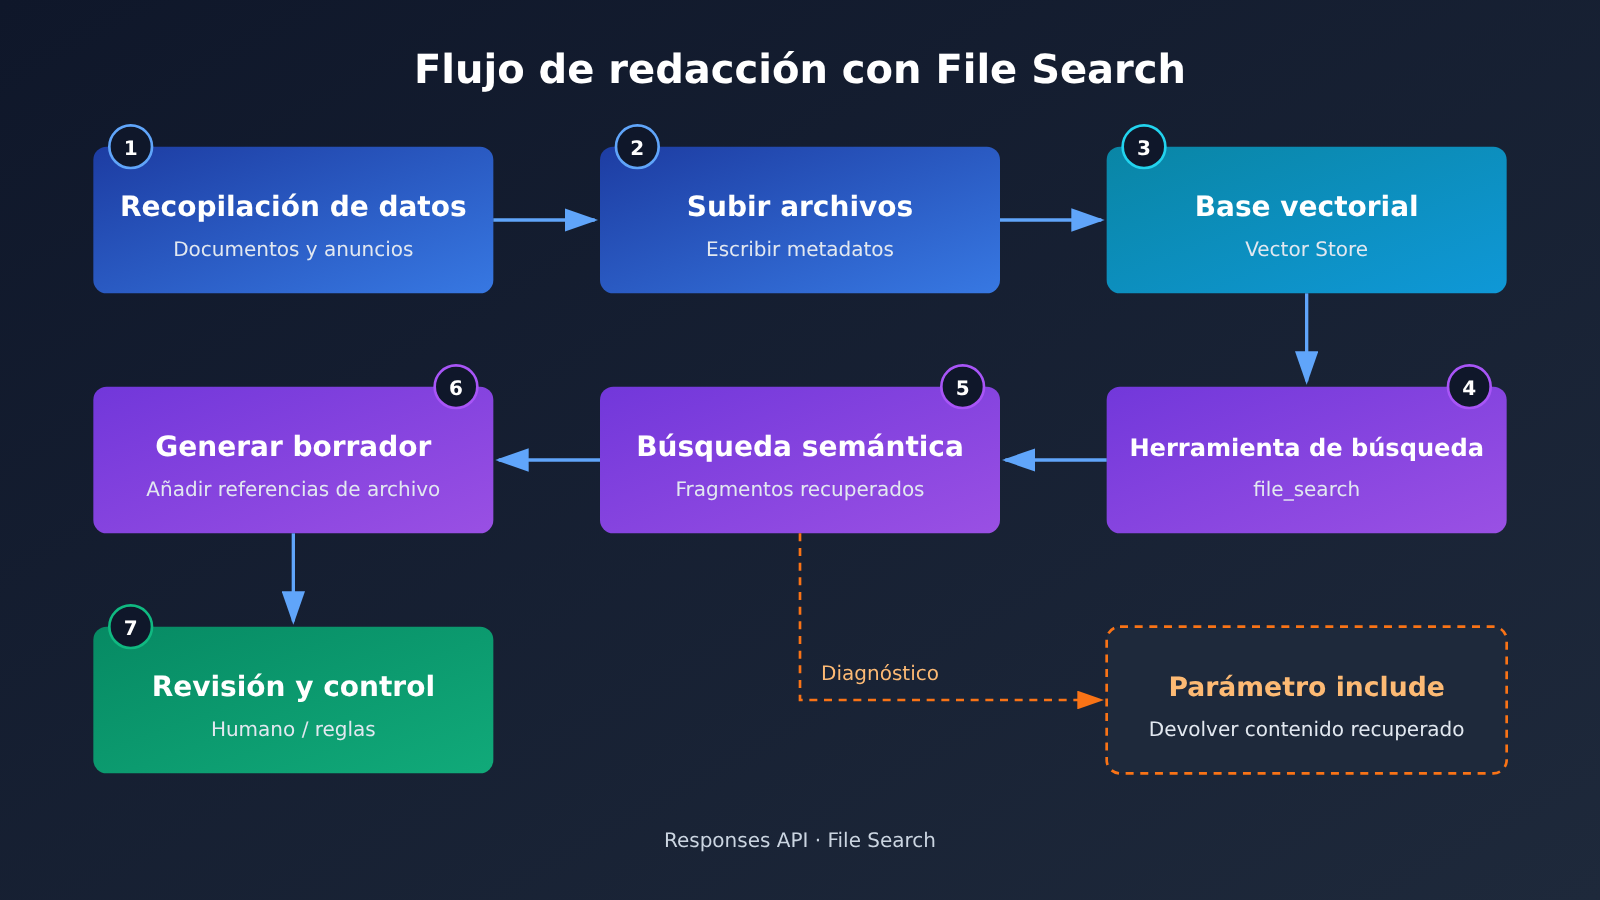
File Search es una herramienta que ofrece Responses API. Los desarrolladores primero cargan los archivos en una biblioteca vectorial y, al enviar la solicitud, declaran File Search dentro de tools y especifican la biblioteca vectorial. Cuando el modelo genera una respuesta, recupera contenido relevante de esos archivos, y la respuesta puede incluir referencias a archivos que indican la fuente de la información.
Utiliza recuperación semántica, por lo que puede encontrar contenido relacionado por significado aunque no coincida exactamente en las palabras. Por ejemplo, si se consulta «limitación de frecuencia de la API» y en la documentación aparece «límite de frecuencia de solicitudes», también podría recuperarse. Para los sistemas de redacción, esto significa que al formular preguntas no es necesario reproducir exactamente la redacción original.
Parámetros ajustables y opciones de diagnóstico de File Search
En la documentación hay dos parámetros que tienen la relación más directa con el sistema de escritura:
| Parámetro / comportamiento | Función | Importancia para el flujo de escritura |
|---|---|---|
max_num_results |
Ajusta la cantidad de resultados devueltos por una sola búsqueda | Menos resultados ahorran contexto, pero la evidencia puede quedar incompleta; más resultados amplían la cobertura, pero también aumentan el ruido |
| Contenido devuelto por defecto | La llamada a la herramienta, por defecto, no devuelve los resultados completos de la búsqueda | Si solo se mira la respuesta final, no se puede saber qué leyó realmente el modelo |
include: ["file_search_call.results"] |
Permite que la respuesta incluya el contenido realmente recuperado | Permite distinguir entre «no se recuperó nada» y «se recuperó, pero se escribió mal»; imprescindible para diagnosticar |
| Referencia de archivo | Se indica el archivo de origen en la respuesta | Facilita la verificación, pero no implica que la conclusión sea correcta |
A continuación se muestra un ejemplo mínimo de invocación que indica cómo conectar un almacén vectorial, limitar la cantidad de resultados recuperados y solicitar que la respuesta devuelva los resultados de la búsqueda. Sustituye el nombre del modelo y el ID del almacén vectorial por tu propia configuración:
from openai import OpenAI

client = OpenAI()  # Lee la clave desde la variable de entorno OPENAI_API_KEY

response = client.responses.create(
    model="YOUR_MODEL",
    input="根据资料库,总结该接口目前的调用限制,并标明出处。",
    tools=[{
        "type": "file_search",
        "vector_store_ids": ["YOUR_VECTOR_STORE_ID"],
        "max_num_results": 8,   # Cantidad de recuperación: equilibrio entre cobertura de evidencia y ruido
    }],
    include=["file_search_call.results"],  # Devuelve el contenido realmente recuperado para facilitar el diagnóstico
)

# Recorre la salida: obtienes tanto el texto final como los fragmentos recuperados
for item in response.output:
    if item.type == "file_search_call":
        for r in (item.results or []):
            print("召回:", r.filename, r.score)
    elif item.type == "message":
        print(item.content[0].text)
Consistencia eventual al eliminar archivos en File Search
La documentación indica que eliminar un archivo del almacén vectorial es consistente de forma eventual: durante un tiempo después de la eliminación, ese archivo todavía puede aparecer en los resultados de búsqueda. Por eso no conviene afirmar públicamente que «tras eliminarlo, deja de ser recuperable de inmediato». Si un material tiene que retirarse por ser erróneo o estar desactualizado, lo mejor es que el sistema de escritura aplique también un filtrado en su propia capa, en lugar de depender únicamente de la operación de borrado.
Lo que File Search no hace
Según lo que describe la documentación oficial y el funcionamiento del propio herramienta, hay varios puntos que conviene dejar claros:
- File Search solo busca entre archivos que ya existen en el almacén vectorial; no descubre automáticamente anuncios nuevos ni actualizaciones de documentos en internet.
- Las marcas de cita indican de qué archivo proviene el contenido, pero no garantizan que la conclusión derivada de ese archivo sea correcta.
- Tanto el almacenamiento en el almacén vectorial como las invocaciones de la herramienta tienen costo; las tarifas se rigen por los precios que OpenAI publica en cada momento, y este artículo no incluye cifras concretas.
- Este artículo no verifica si APIYI u otras plataformas de terceros son compatibles con las interfaces relacionadas de File Search; para el estado de soporte, consulta la documentación oficial de cada plataforma.
Análisis y conclusiones sobre OpenAI File Search
Conclusión 1: File Search cubre la «capa de recuperación», no la «capa de documentación»
Las carencias documentales de un sistema de redacción suelen ser de dos tipos. En el primero, hay documentación disponible, pero no se encuentra con precisión; el modelo escribe de memoria y no deja claras las fuentes. En el segundo, directamente no hay documentación, o la que hay está desactualizada. File Search resulta muy eficaz para el primero: la búsqueda semántica aumenta la flexibilidad de recuperación y las citas de archivos permiten verificar cada fragmento.
Con el segundo, no puede hacer nada. La herramienta no sale a buscar nuevos comunicados por su cuenta: solo puede recuperar lo que hay en la base vectorial. Por ejemplo, si el precio o los límites de un modelo acaban de cambiar y en la base solo hay documentos antiguos, File Search recuperará «con precisión» información obsoleta y la acompañará con una cita que parece fiable. Eso es más peligroso que no citar nada, porque engaña con más facilidad al proceso de revisión.
Por eso, File Search debe entenderse como una capa dentro del sistema de redacción, no como toda la solución documental. La recopilación de documentación, la actualización periódica y la eliminación de versiones obsoletas siguen necesitando procesos independientes.
Segundo criterio: usar la clasificación en tres categorías para ubicar los problemas de escritura de File Search
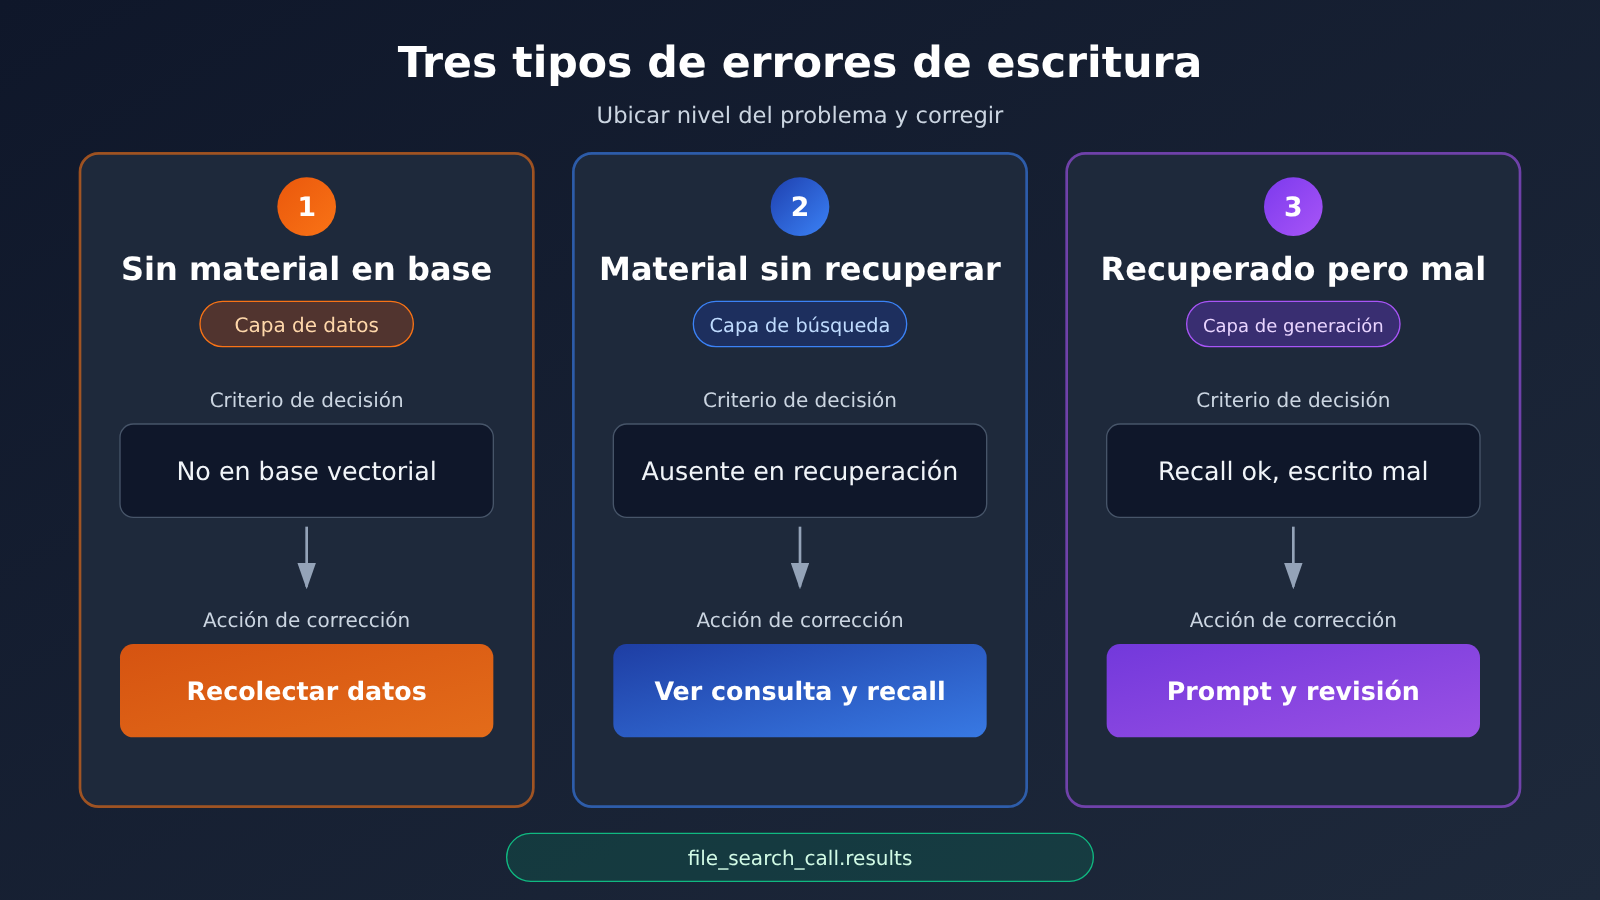
Cuando un artículo está mal escrito, el problema puede originarse en tres etapas distintas. El valor de include: ["file_search_call.results"] está en que permite distinguir por primera vez estas tres categorías de problemas.
| Tipo de problema | Criterio de diagnóstico | Dirección de corrección |
|---|---|---|
| No hay material en la base | El archivo relevante no se encuentra en la base vectorial | Recopilar más material; es un problema de la capa de datos |
| Hay material, pero no se recuperó | El archivo está en la base, pero no aparece en file_search_call.results |
Ajustar la formulación de la consulta, dividir la pregunta o aumentar adecuadamente max_num_results |
| Se recuperó, pero se escribió mal | Los resultados de recuperación son correctos, pero el texto final no coincide con ellos | Modificar la indicación de generación y las reglas de revisión; es un problema de la capa de generación |
Si no se devuelve el contenido recuperado, el equipo a menudo solo puede decir de forma vaga que “la IA volvió a inventar”, y luego se pone a cambiar la indicación. Muchas veces la verdadera razón es que la base no contiene este material, o que la consulta no lo encontró. Determinar primero en qué capa está el problema y luego actuar ahorra muchos rodeos.
Tercera consideración: los metadatos de ingesta de OpenAI File Search determinan el techo de calidad de la escritura
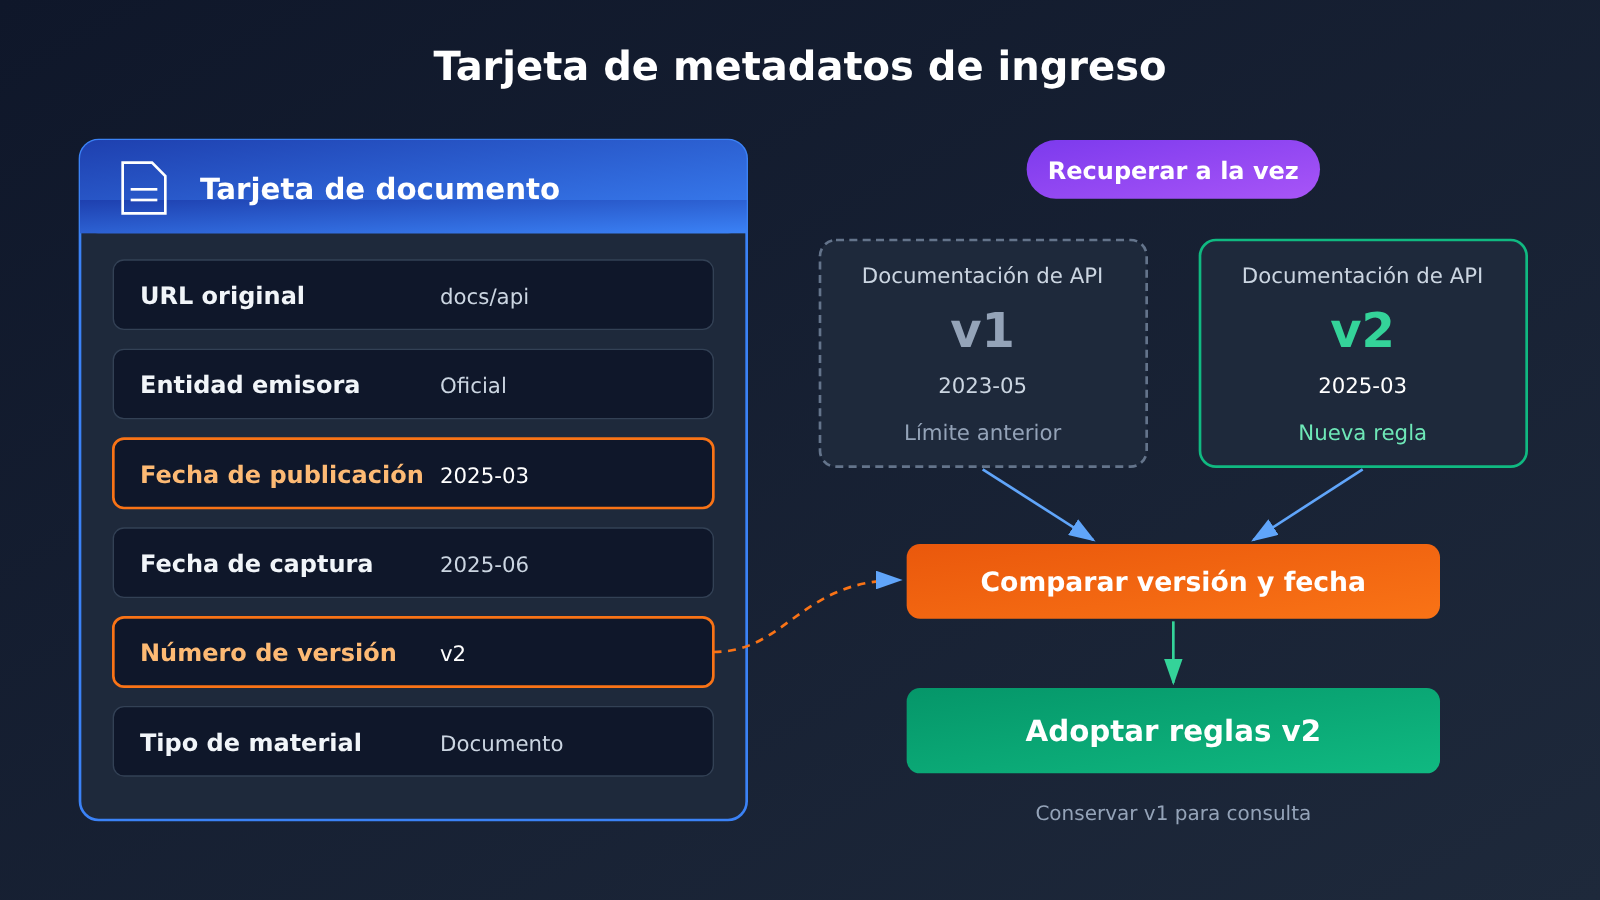
La búsqueda solo puede devolver lo que está en la biblioteca, y la calidad de lo que hay en ella depende de lo que se registró en el momento de la ingesta. Para un sistema de escritura, subir únicamente el cuerpo del archivo no basta: se recomienda que cada documento incluya al menos la siguiente información:
| Campo de metadatos | Uso |
|---|---|
| URL original | Facilita volver a la fuente para verificarla, y también permite listarla en las referencias |
| Entidad publicadora | Distingue declaraciones oficiales, interpretaciones de terceros y rumores de la comunidad |
| Fecha de publicación | Determina si la información sigue vigente |
| Fecha de captura | Determina cuánto tiempo lleva el material sin actualizarse |
| Número de versión | Evita tomar restricciones antiguas como reglas vigentes cuando conviven documentos nuevos y viejos |
| Tipo de material | Distingue anuncios, documentación, blogs y publicaciones de foro, para facilitar la asignación de credibilidad |
De todos estos, la información de versión es la que más fácilmente se pasa por alto. Es posible que en la biblioteca estén tanto los documentos nuevos como los viejos de una misma interfaz y que, además, sean semánticamente muy parecidos, por lo que es bastante probable que se recuperen juntos en una búsqueda. Sin versión y fecha, al modelo le cuesta determinar qué restricción ya ha sido derogada. Conservar la información de versión es más seguro que eliminar directamente los documentos antiguos: por un lado, todavía hacen falta al escribir comparaciones históricas; por otro, la eliminación en sí misma es de consistencia eventual, así que lo borrado no desaparece necesariamente de inmediato.
Criterio cuatro: no hay una respuesta estándar para la cantidad de recuperación
Si reduces max_num_results, el contexto queda más limpio, y tanto el costo como el ruido bajan, pero podrías dejar escapar evidencia clave. Sobre todo en temas donde hace falta que varias fuentes se contrasten entre sí, por ejemplo cuando se trata a la vez de precios, límites y diferencias de versión. Si lo aumentas, la cobertura es más completa, pero los fragmentos irrelevantes diluyen la atención y es más probable que el modelo mezcle información de distintas versiones.
Una forma más práctica es configurarlo por tipo de artículo. Los artículos de análisis de noticias necesitan validación cruzada de múltiples fuentes, así que se puede ampliar un poco. En cambio, para la descripción de parámetros de un único endpoint conviene reducirlo. No existe un valor óptimo universal; más bien deberías ajustarlo observando de verdad el contenido recuperado que devuelve, en lugar de fijar un número por intuición.
Cambios futuros que conviene seguir
Los siguientes puntos son direcciones que vale la pena observar, no hechos confirmados: si File Search ofrecerá un filtrado de metadatos más fino, que permita filtrar directamente por versión o fecha; si la demora de aplicación de las operaciones de borrado tendrá una explicación más clara; si se ajustará el modelo de facturación. Todos estos cambios inciden directamente en las decisiones de arquitectura del sistema de escritura, así que antes de integrarlo conviene volver a consultar la documentación oficial y la página de precios.
Al integrar File Search en un sistema de escritura, el error de juicio más habitual es creer que «con recuperación y citas, el problema de los materiales ya está resuelto». En realidad, hace que los materiales que ya tienes se aprovechen mejor; la frescura y exactitud de los propios materiales siguen dependiendo de la recolección, la gestión de versiones y la revisión.
¿Por qué el estanque está tan claro? Porque tiene una fuente viva que lo alimenta. — Zhu Xi, Reflexiones al leer


