
Resumen: Este artículo responde a una pregunta: ¿puede GPT-6.2 Sol hacerse cargo de las consultas de datos de los usuarios de primera línea, y qué preguntas todavía requieren una verificación adicional?
El desempeño de GPT-6.2 Sol en el análisis de datos puede dividirse en dos partes. En la prueba especializada de una sola ronda publicada por Plotly el 17 de noviembre de 2026, acertó las 38 preguntas de las cinco categorías —análisis convencional, detección de ambigüedad, datos no respondibles, calidad de datos y trampas estadísticas—, con un tiempo medio por pregunta de unos 10,5 segundos. En esa misma ronda, de 5 preguntas sobre patrones ocultos solo superó 2.
De aquí se desprende una conclusión: las consultas de resumen con criterios claros y bajo impacto pueden probarse en piloto confiándolas a Sol para que responda directamente con permisos de solo lectura; cuando falten criterios, primero hay que pedirle que aclare; la atribución abierta y las decisiones de cara al exterior deben pasar por revisión del analista. Esta conclusión tiene tres premisas: la prueba se ejecutó una sola ronda, el banco de preguntas está en inglés y simula una empresa de energía eólica, y los costos provienen del canal OpenRouter. Cuando lo trasladas a tus propios datos y canales, hace falta volver a validar según el tipo de pregunta.
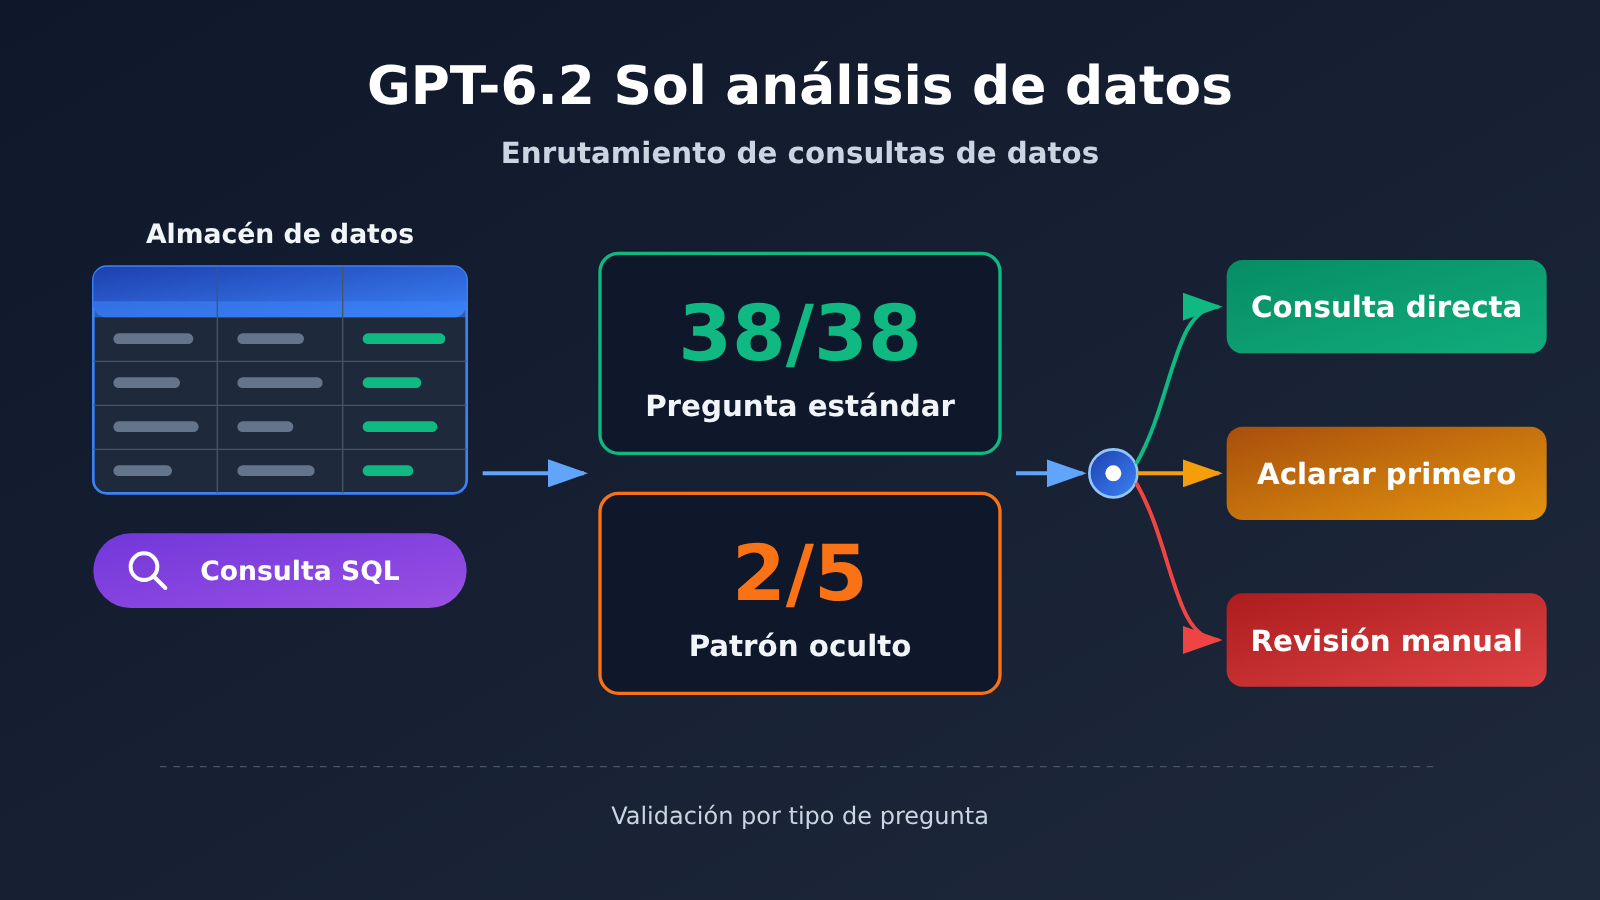
Mapa de conocimiento e índice de lectura del análisis de datos de GPT-6.2 Sol
El diagrama siguiente muestra la lógica de enrutamiento de tareas del artículo completo. Cada rama indica la condición de entrada, la salida que debe producir el modelo y el número de sección correspondiente en el texto.
El usuario plantea una pregunta de datos
 │
 ├─ Definición clara + agregación de bajo impacto ──→ [1] Sol: consulta de solo lectura
 │                              Salida: valor + numerador/denominador + rango temporal y zona horaria + sentencia de consulta
 │
 ├─ Definición ausente / datos insuficientes ────→ [3.2] Aclarar primero
 │                              Salida: una repregunta concreta + lista de definiciones alternativas
 │
 └─ Atribución abierta / decisión externa ──→ [3.3] Derivar a revisión del analista
                                Salida: registro de investigación preliminar + evidencia de respaldo + verificación de explicaciones alternativas
            ↓
   [2] Usar la latencia y el costo por consulta para decidir si conviene ponerlo en primera línea
            ↓
   [4] Validar con tus propios datos según el tipo de pregunta y entregar resultados con fecha de datos y evidencia de consulta
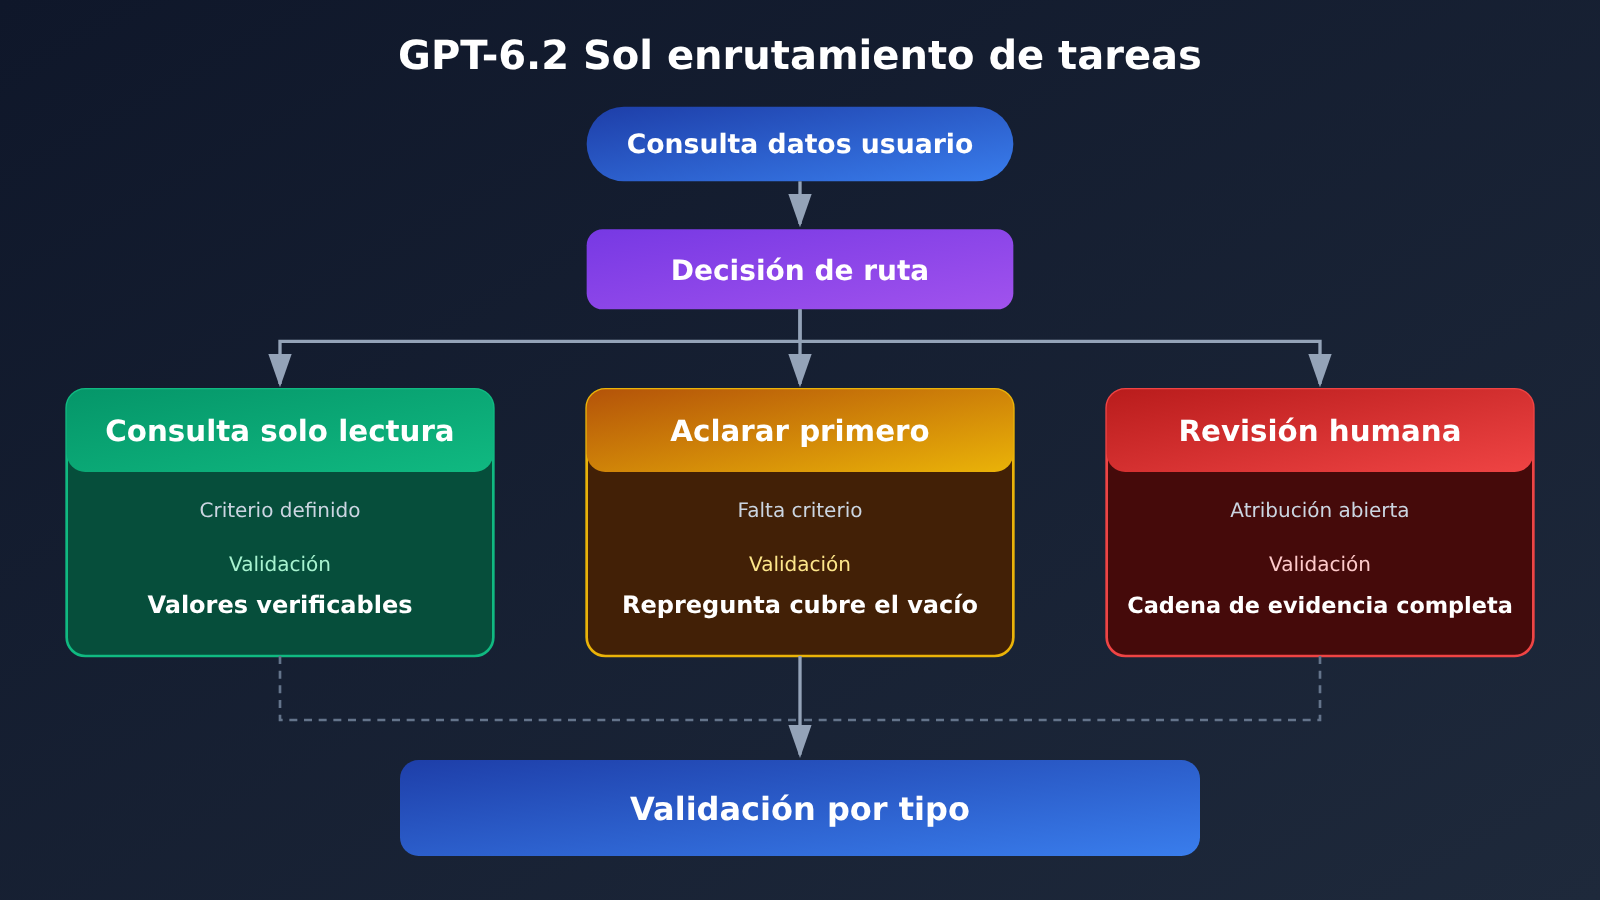
La relación entre las secciones es la siguiente. Las secciones 3 (que son paralelas entre sí) pueden consultarse según necesidad; el resto conviene leerlas en orden.
| Sección | Pregunta que responde | Qué aporta a la sección siguiente | Qué puedes hacer al terminarla |
|---|---|---|---|
| 1 | En qué tipo de preguntas Sol es estable | Límites por tipo de pregunta: 38/38 y 2/5 | Delimitar el rango en el que puedes preguntar directamente por datos |
| 2 | Si compensa ponerlo en primera línea | Latencia, costo por consulta y supuestos de extrapolación | Estimar presupuesto y tiempos de espera en escenarios interactivos |
| 3 | Qué señales exigen aclaración o derivación a humano | Tres formas de perder puntos y tres ejemplos de salida | Diseñar reglas de enrutamiento |
| 4 | Cómo validar con tus propios datos | Métricas y límites por tipo de pregunta | Producir una entrega verificable |
To Know: términos relacionados con el análisis de datos de GPT-6.2 Sol
| Término | Explicación breve |
|---|---|
| Almacén de datos | Conjunto de datos que reúne los datos históricos dispersos en los sistemas de negocio para consulta y análisis |
| Definición del indicador | Definición, condiciones de filtrado, numerador y denominador, y límites temporales de un indicador |
| SQL de solo lectura | Forma de consulta que solo recupera y agrega datos, manteniendo el origen de datos con permisos de solo lectura |
| Pregunta de patrón oculto | Se inyectan de antemano anomalías estructurales en los datos; el enunciado solo ofrece pistas y el modelo debe encontrar activamente el patrón concreto |
| Evidencia de consulta | Sentencia de consulta, definición, resultado y fecha de los datos que permiten a otra persona verificar la conclusión |
| Latencia p50 / p95 | Tiempo dentro del cual se completa la mitad de las solicitudes / tiempo dentro del cual se completa el 95% de las solicitudes |
| Entrada en caché | Tokens de entrada reconocidos como reutilizables al facturar aguas arriba, con un precio unitario muy inferior a la entrada normal |
| Validación por tipo de pregunta | Puntuar por separado consulta de datos, aclaración, rechazo y exploración, para que la nota total no oculte cierto tipo de error |
1. GPT-6.2 Sol en análisis de datos: primero, los resultados de consultas que se pueden validar de forma estable
1.1 Qué hizo la prueba con Plotly
En el marco de pruebas Plotly Studio Embedded, Plotly llama al modelo a través de OpenRouter y habilita solo cuatro herramientas de solo lectura: listar conjuntos de datos, ejecutar consultas SQL, generar gráficos y mostrar tablas. El repositorio de pruebas simula una empresa de energía eólica, con alrededor de 19,9 millones de filas de datos, 44 tablas y 554 columnas. Las 43 preguntas en inglés se evalúan una por una para ver si pasan, según la clave de respuestas y las reglas de puntuación. El modelo evaluador es Claude Sonnet 5, temperature=0, y las preguntas con fallos las revisa manualmente el equipo.
Esta configuración se parece bastante a la forma real de las consultas de datos en BI empresarial: el modelo no ve todos los datos, tiene que buscar tablas, escribir SQL, leer los resultados y responder. Plotly conserva el conjunto de preguntas y la clave de respuestas, y desde fuera no se pueden reproducir pregunta por pregunta; por eso las cifras siguientes deben entenderse como una observación de una sola ronda con metodología documentada, no como un ranking estable.
| Tipo de pregunta | N.º de preguntas | Resultado de GPT-6.2 Sol | Implicación para el negocio |
|---|---|---|---|
| Análisis habitual | 20 | 20/20 | Los resúmenes con criterios fijos pueden probarse con respuesta directa |
| Detección de ambigüedad | 5 | 5/5 | Detecta que la propia pregunta admite varias interpretaciones |
| Preguntas no respondibles con los datos | 5 | 5/5 | Cuando los datos no lo permiten, rechaza responder en vez de inventar cifras |
| Calidad de datos | 3 | 3/3 | Detecta problemas como datos faltantes y duplicados |
| Trampas estadísticas | 5 | 5/5 | Evita malinterpretaciones estadísticas habituales |
| Patrones ocultos | 5 | 2/5 | La búsqueda abierta de patrones aún requiere validación humana |
| Total | 43 | 40/43 | Las primeras 38 preguntas pasan todas; todos los fallos se concentran en las de exploración |
Plotly también menciona que, al repetir la ejecución, otros modelos han mostrado variaciones de hasta tres preguntas. 40/43 queda a solo tres preguntas de la puntuación perfecta, justo dentro de ese margen de variación. Por eso lo más interesante es la distribución de los fallos: todos caen en las preguntas de patrones ocultos; en las cinco primeras categorías no falló ni una.
1.2 Por qué las consultas con criterios fijos se pueden revisar
Tomemos como ejemplo el informe de posventa: «tasa de devoluciones por almacén en los últimos 7 días» se puede validar de forma estable siempre que tres cosas estén fijadas de antemano: si el denominador son los pedidos recibidos o todos los pedidos, en qué zona horaria se corta el rango temporal y si los filtros excluyen pedidos de prueba y pedidos internos. Una vez que estos tres puntos se escriben en el documento de criterios, el SQL y los resultados que genera el modelo se pueden comparar punto por punto con una consulta manual.
Los criterios fijos convierten «si el modelo es listo» en «si las cifras coinciden», y esto último se puede comparar automáticamente. Esa es también la razón por la que las 38 preguntas pueden pasar todas, y por la que tiene sentido que pasen todas: la mayoría tienen una única respuesta correcta.
2. Latencia y coste del análisis de datos con GPT-6.2 Sol: ¿lo ponemos en primer plano?
2.1 Comparativa de una ronda completa entre las dos generaciones de Sol
Cuando el usuario consulta datos en la interfaz, el tiempo de espera determina directamente la experiencia. El informe de Plotly ofrece una comparativa entre GPT-6.2 Sol y GPT-6.1 Sol en la misma ronda de 43 preguntas:
| Métrica | GPT-6.1 Sol | GPT-6.2 Sol | Cambio |
|---|---|---|---|
| Coste de la ronda completa | $2.61 | $1.22 | unos 53,3% menos |
| Mediana del tiempo por pregunta | 17,6 s | 10,5 s | unos 40,3% menos |
| Número de llamadas a herramientas | 258 | 158 | reducción notable |
| Número de invocaciones del modelo | 227 | 173 | reducción |
| Volumen de entrada | unos 7,8 millones de tokens | unos 4,6 millones de tokens | reducción |
| Volumen de salida | unos 70 000 tokens | unos 45 000 tokens | reducción |
| Proporción de entrada en caché | 94% | 97% | aumenta |
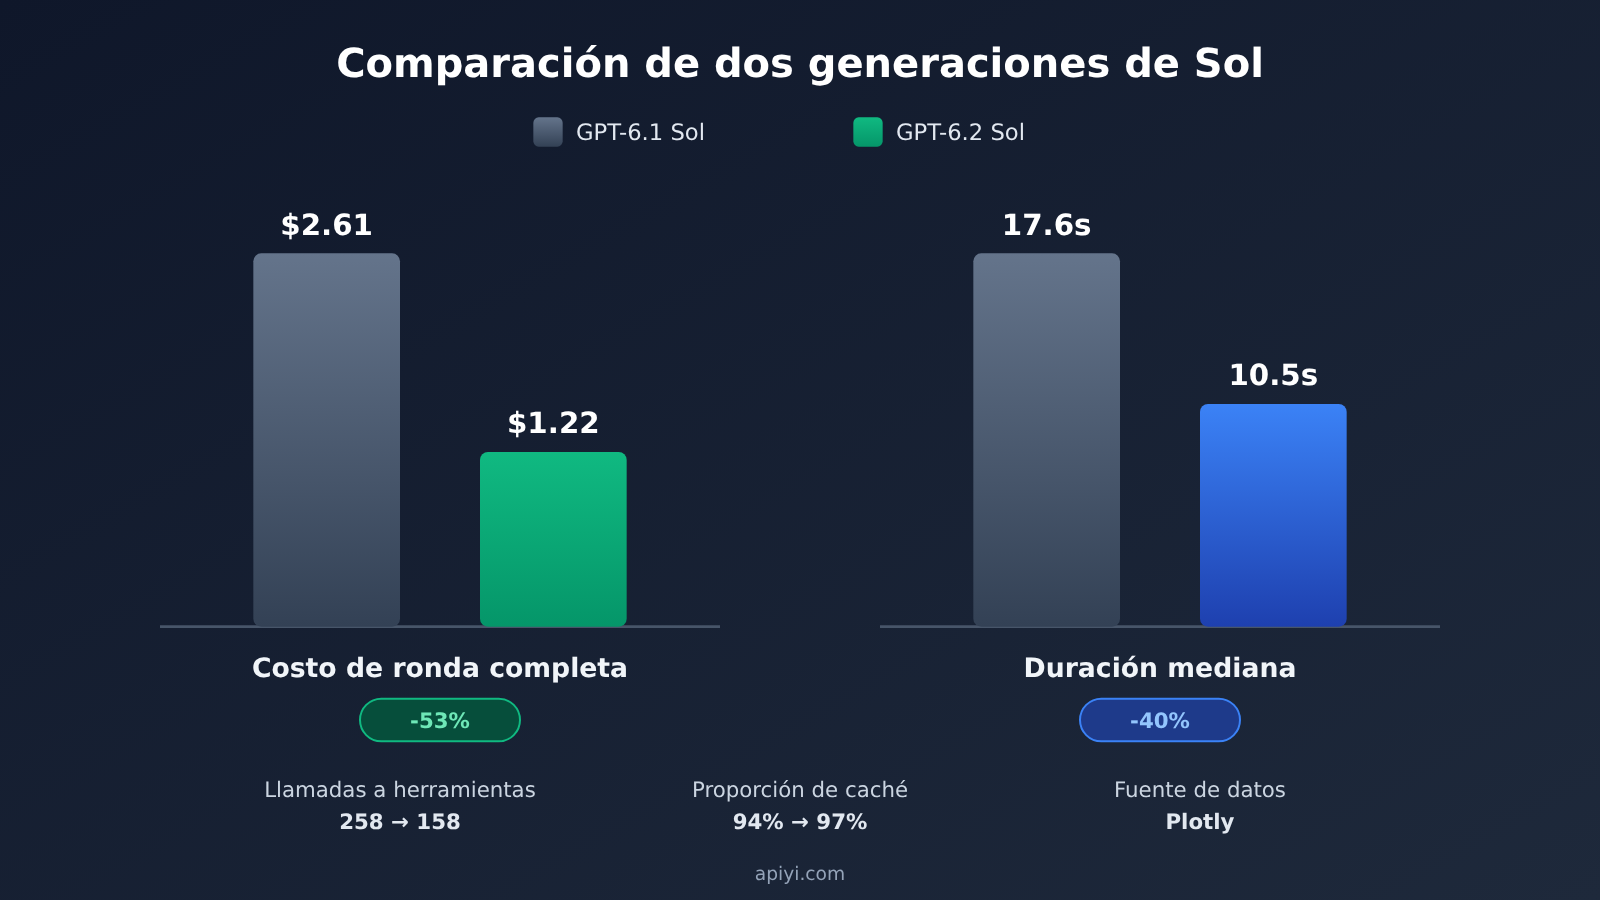
El precio base Standard de contexto corto es el mismo para las dos generaciones de Sol, pero el coste de una ronda completa casi se reduce a la mitad. La diferencia viene del proceso de la tarea: menos rondas de llamada, menos tokens leídos y escritos y una tasa de aciertos de caché más alta. Por eso, al evaluar el coste de un escenario de análisis de datos, conviene usar como unidad «cuánto cuesta completar una pregunta»; el precio por millón de tokens es solo uno de los factores.
2.2 Extrapolación a unos $28,4 por cada 1000 preguntas y supuestos
Si dividimos los $1.22 de la ronda completa entre 43 preguntas, sale una media de unos $0.0284 por pregunta; extrapolado a 1000 preguntas, unos $28.4. Para que esta cifra se sostenga, deben cumplirse a la vez los siguientes supuestos:
- La distribución de tipos de pregunta es la misma que la de las 43 preguntas de Plotly, con alrededor de un 12% de preguntas exploratorias.
- Se usa el mismo canal OpenRouter y la misma tarificación.
- La proporción de caché se mantiene en torno al 97%, compartiendo entre preguntas la misma indicación del sistema y la descripción del esquema de tablas.
- Cada pregunta se ejecuta una sola vez, sin reintentos.
Otra cifra del ranking de Plotly es la mediana del coste por pregunta, $0.017, que pertenece a un estadístico distinto del valor medio. Las preguntas exploratorias hacen más llamadas a herramientas y tardan más, lo que eleva la media; la mediana se acerca más al coste de una pregunta normal de consulta de datos. Al elaborar el presupuesto, se puede usar la mediana para estimar las consultas diarias y añadir aparte una parte según la proporción de preguntas exploratorias.
El precio oficial de OpenAI para Standard de contexto corto es: entrada normal $2.00, lectura de caché $0.10, salida $10.00 (USD / millón de tokens; la salida ya incluye tokens de razonamiento). Cuando el volumen total de entrada de la solicitud supera 272K, toda la solicitud pasa al tramo de contexto largo. La interfaz pública de precios de APIYI apiyi.com coincide con la oficial en el tramo corto; en el tramo largo, la entrada cuesta $3, la lectura de caché $0.15, la escritura de caché $3.75 y la salida $11.25. En escenarios de consulta de datos, cada solicitud individual suele quedar muy por debajo de 272K; solo hay que preocuparse por el cambio de tramo cuando se meten de golpe muchos esquemas de tablas o resultados históricos.
3. Tres tipos de señales en el análisis de datos de GPT-6.2 Sol: cuándo aclarar y cuándo derivar a un humano
3.1 Por qué se pierden puntos en las preguntas con patrones ocultos
En las 38 preguntas sin patrones ocultos, 6.2 Sol hizo un promedio de aproximadamente 2,9 llamadas a herramientas por pregunta, mientras que 6.1 Sol rondó las 4,3, y ambos aprobaron todas. Al llegar a las 5 preguntas con patrones ocultos, el informe específico de Sol registra que 6.2 Sol hizo unas 9 consultas a la base de datos por pregunta en promedio, y 6.1 Sol cerca de 16. (En el artículo del ranking general de Plotly, al poner el ejemplo, la generación anterior usaba la cifra de unas 18 veces; este artículo se basa en el informe específico.)
Tras la revisión manual, las tres preguntas donde se perdieron puntos fueron:
- No aislar por separado el patrón implantado;
- No señalar qué objetos concretos se vieron afectados;
- No localizar la parte de los datos donde el efecto realmente existe.
Las tres fallas comparten un mismo punto: las consultas se quedaron en la superficie. Se puede anotar como una observación: la nueva versión busca de forma más superficial en las preguntas exploratorias. En cuanto a la relación causal de que «menos consultas provocan la pérdida de puntos», haría falta un experimento con variables controladas para confirmarla. Para el negocio, la conclusión es la misma: en cualquier pregunta de atribución que requiera buscar evidencias de forma activa, no se puede tomar la primera respuesta del modelo directamente como conclusión.
3.2 Falta de criterio: preguntar antes de responder
A continuación usamos un conjunto de datos ficticio de tickets de posventa para mostrar tres tipos de salida. El conjunto contiene cuatro tablas: pedidos, tickets, lotes de producto y almacenes; las siguientes salidas son ejemplos de diseño, no resultados reales.
Respuesta normal (criterio claro). El usuario pregunta «el índice de devoluciones de los últimos 7 días por almacén»; una salida válida, además de los valores de cada almacén, debe conservar: el numerador (número de tickets de devolución física), el denominador (número de pedidos firmados como recibidos en el mismo periodo), el rango de fechas y la zona horaria (por ejemplo, hora de Beijing, del 11-13 al 11-19), la dimensión de agregación (almacén), y adjuntar el SQL ejecutado.
Preguntar primero el criterio (criterio ausente). Si el usuario solo pregunta «¿cuál fue el índice de devoluciones la semana pasada?», el modelo debería primero repreguntar: «¿El índice de devoluciones se calcula según las solicitudes de reembolso o según las devoluciones físicas? En el escenario de solo reembolso, la diferencia entre ambas es considerable.» Luego presenta los dos criterios para que el usuario elija, y no entrega cifras hasta que lo haya decidido.
3.3 Atribución abierta: derivar al analista
Cuando el usuario pregunta «el índice de devoluciones de cierto canal se duplicó, ¿en qué lotes se concentra la anomalía?», ya entramos en el terreno de las preguntas con patrones ocultos. El modelo puede hacer primero un diagnóstico preliminar: verificar si faltan datos y si el tamaño total de la muestra es suficiente, y luego segmentar sucesivamente por canal, categoría, almacén y lote. En la salida debe conservar al menos una evidencia de respaldo y una comprobación para descartar explicaciones alternativas (por ejemplo, confirmar que el volumen de pedidos de ese canal esa semana no cayó de forma anómala, descartando así que la duplicación se deba a un denominador más pequeño).
Hecho esto, la salida debe marcarse como «pendiente de revisión del analista», no como «conclusión». Las reglas de enrutamiento se pueden resumir en una tabla:
| Señal | Formulación típica | Ruta | Salida del modelo | Punto clave de aceptación |
|---|---|---|---|---|
| Criterio claro, bajo impacto | Índice de devoluciones de 7 días por almacén | Sol en consulta de datos de solo lectura | Valores + criterio + SQL | Valores coinciden con la consulta manual |
| Criterio o datos insuficientes | ¿Cuál fue el índice de devoluciones la semana pasada? | Aclarar primero | Una repregunta + criterios candidatos | La repregunta apunta al vacío |
| Atribución abierta, decisión externa | ¿En qué lotes se concentra la anomalía? | Derivar a revisión del analista | Registro de diagnóstico + evidencia de respaldo + comprobación de explicaciones alternativas | Cobertura de evidencia, falsos positivos y falsos negativos |
4. Valida la capacidad de análisis de datos de GPT-6.2 Sol con tus propios datos
4.1 Código de integración y enrutamiento
gpt-6.2-sol se puede invocar desde dos endpoints: Responses y Chat Completions; las llamadas a funciones y las herramientas integradas van por la ruta de Responses. Ninguno de los dos endpoints acepta el nivel de razonamiento none, así que conviene revisar ese parámetro al migrar código antiguo. Abajo tienes un ejemplo mínimo de clasificación de rutas con Chat Completions:
import openai, json

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

question = "¿Cuál fue la tasa de devoluciones la semana pasada?"
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[
        {"role": "system", "content": "Clasifica la consulta de datos del usuario como direct / clarify / escalate, "
                                      "devuelve solo JSON: {\"route\":..., \"reason\":...}"},
        {"role": "user", "content": question},
    ],
)
print(json.loads(resp.choices[0].message.content))
Ver el ejemplo completo de una llamada a la herramienta SQL de solo lectura (Responses API)
import openai, json, sqlite3

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Abrimos la base de datos en modo de solo lectura; la comprobación con regex es
# únicamente una segunda capa de seguridad
conn = sqlite3.connect("file:aftersales.db?mode=ro", uri=True)

def run_readonly_sql(sql: str) -> str:
    head = sql.strip().lower()
    if not (head.startswith("select") or head.startswith("with")):
        return json.dumps({"error": "only read-only queries allowed"})
    rows = conn.execute(sql).fetchmany(200)
    return json.dumps({"rows": rows, "row_count": len(rows)}, default=str)

tools = [{
    "type": "function",
    "name": "run_readonly_sql",
    "description": "Ejecuta SQL de solo lectura en el almacén de datos de posventa, devuelve como máximo 200 filas",
    "parameters": {
        "type": "object",
        "properties": {"sql": {"type": "string"}},
        "required": ["sql"],
    },
}]

instructions = (
    "Eres un asistente de análisis de datos. Toda respuesta debe incluir: numerador, denominador, "
    "rango temporal y zona horaria, dimensiones de agregación y el SQL ejecutado. "
    "Si los criterios no están claros, pregunta primero; marca las conclusiones de atribución "
    "como pendientes de revisión por parte de un analista."
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions=instructions,
    input="Indica la tasa de devoluciones de los últimos 7 días por almacén",
    tools=tools,
)

# Procesamos las llamadas a herramientas en bucle hasta que el modelo devuelva la respuesta final
while True:
    calls = [o for o in resp.output if o.type == "function_call"]
    if not calls:
        break
    outputs = [{
        "type": "function_call_output",
        "call_id": c.call_id,
        "output": run_readonly_sql(json.loads(c.arguments)["sql"]),
    } for c in calls]
    resp = client.responses.create(
        model="gpt-6.2-sol",
        previous_response_id=resp.id,
        input=outputs,
        tools=tools,
    )

print(resp.output_text)
print("output_tokens:", resp.usage.output_tokens)
🚀 Inicio rápido: cuando quieras validar con tus propias muestras de negocio, puedes solicitar el crédito de prueba gratuito para nuevos usuarios a través de APIYI apiyi.com. La misma clave API te permite alternar entre
gpt-6.2-soly otros modelos principales, comparándolos en la misma batería de preguntas y manteniendo la fuente de datos en modo de solo lectura.
4.2 Indicadores de aceptación por tipo de pregunta
Se recomienda que el banco de preguntas de aceptación cubra las tres rutas de la sección 3, y que cada tipo de pregunta se puntúe por separado.
| Tipo de pregunta | Métrica principal | Criterio de evaluación | Qué conviene registrar |
|---|---|---|---|
| Preguntas de datos con definición fija | Tasa de acierto numérico | Comparación fila por fila con el resultado del SQL manual | Costo por pregunta, latencia p50/p95 |
| Definición faltante | Tasa de aclaración adecuada | Si la repregunta apunta a la definición realmente faltante | Si aparece el caso de «preguntar cuando no se debería» |
| Datos no respondibles | Tasa de rechazo correcto | No inventar cifras | Número de respuestas erróneas |
| Atribución abierta | Cobertura de evidencia, falsos positivos y falsos negativos | Si están completos la evidencia de apoyo y las explicaciones alternativas | Consistencia entre varias ejecuciones |
El informe de Plotly solo ofrece la mediana del tiempo de ejecución; tu propia aceptación debe añadir el p95. La experiencia en el frontend suele verse afectada por unas pocas solicitudes de cola larga, y las preguntas exploratorias son especialmente propensas a la cola larga. En cuanto al costo, lee el volumen de salida desde usage.output_tokens; los tokens de razonamiento normalmente aparecen en la subpartida output_tokens_details.reasoning_tokens, y combinándolo con el volumen de lectura de caché puedes calcular el gasto real por pregunta.
4.3 Los límites de las muestras pequeñas y las repeticiones
El patrón oculto de Plotly solo tiene 5 preguntas; el intervalo de confianza de 2/5 es muy amplio, y con otro lote de preguntas podría ser 1/5 o incluso 4/5. Al repetir ejecuciones con otros modelos se han observado oscilaciones de hasta tres preguntas, así que una diferencia en la puntuación total de una sola ronda no basta para sustentar la selección. En tu propia aceptación, repite las preguntas exploratorias al menos durante varias rondas y alinea cinco variables: la instantánea de datos, el conjunto de herramientas, el nivel de razonamiento del modelo, el canal de invocación y la tabla de calificación. Si cambia cualquiera de ellas, los resultados anteriores y posteriores no se pueden comparar directamente.
💡 Sugerencia de aceptación: el canal es una variable que se pasa por alto con facilidad. El costo de Plotly proviene de OpenRouter, y el facturado y la estrategia de caché de tu canal de producción pueden ser distintos. Se recomienda repetir la ejecución con la misma instantánea de datos en APIYI apiyi.com, recalcular el costo por cada mil preguntas con la factura real y luego decidir la cuota del frontend.
4.4 Un entregable que se puede aceptar
El criterio para superar la aceptación es: cada resultado de consulta de datos debe permitir que una tercera persona lo revise de forma independiente. A continuación se muestra la forma de un entregable válido (datos ficticios):
question: Tasa de devolución de los últimos 7 días por almacén
route: direct
data_snapshot: 2026-11-19 23:59 (Asia/Shanghai)
metric_definition:
  numerator: Número de tickets de devolución física (status = returned)
  denominator: Número de pedidos con recepción confirmada en el mismo periodo (excluyendo pedidos de prueba y pedidos internos)
  time_range: 2026-11-13 ~ 2026-11-19, hora de Beijing
  group_by: warehouse_id
query: "SELECT w.warehouse_id, ... GROUP BY w.warehouse_id"
result: [{warehouse: Almacén 1 de China Oriental, rate: 3.1%}, {warehouse: Almacén 2 de China Meridional, rate: 2.4%}]
model: gpt-6.2-sol
cost_usd: 0.012
latency_s: 8.7
reviewer: No requiere revisión (consulta con criterio fijo)
Un entregable incluye la fecha de los datos, el criterio (definición del indicador), la consulta y el resultado; GPT-6.2 Sol ya se puede validar en este eslabón de la consulta en primer plano. Una salida que no contenga estos elementos, aunque los números resulten correctos por casualidad, no debería entrar en el informe. Si quieres implementar este flujo en tu propio almacén de datos, puedes empezar por la interfaz compatible con OpenAI de APIYI apiyi.com: primero pone en marcha las consultas con criterio fijo y luego amplía poco a poco hacia la aclaración y la atribución.
Referencias
- Plotly – Informe especializado de análisis de datos de GPT-6.2 Sol: resultados desglosados de las 43 preguntas, comparativa de costos y tiempos
- Enlace:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- Enlace:
- Plotly – Metodología de prueba de DataAnalyticsBench: diseño de tipos de pregunta, reglas de puntuación y criterios de medición del ranking
- Enlace:
plotly.com/blog/introducing-dataanalyticsbench
- Enlace:
- OpenAI – Ficha del modelo GPT-6.2 Sol: ventana de contexto, compatibilidad de endpoints y reglas de facturación para contexto largo
- Enlace:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Enlace:
- OpenAI – Precios de API: precios unitarios de entrada, caché y salida en Standard
- Enlace:
developers.openai.com/api/docs/pricing
- Enlace:
- Interfaz pública de precios de APIYI: expresiones de cálculo de precios para
gpt-6.2-solen tramo corto y tramo largo- Enlace:
api.apiyi.com/api/pricing
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página de inicio del sitio oficial de APIYI; para más recursos de integración, visita el centro de documentación en docs.apiyi.com


