
摘要:本文回答一个问题:GPT-6.2 Sol 能不能接住前台用户的数据问数,哪些问题还需要再核查。
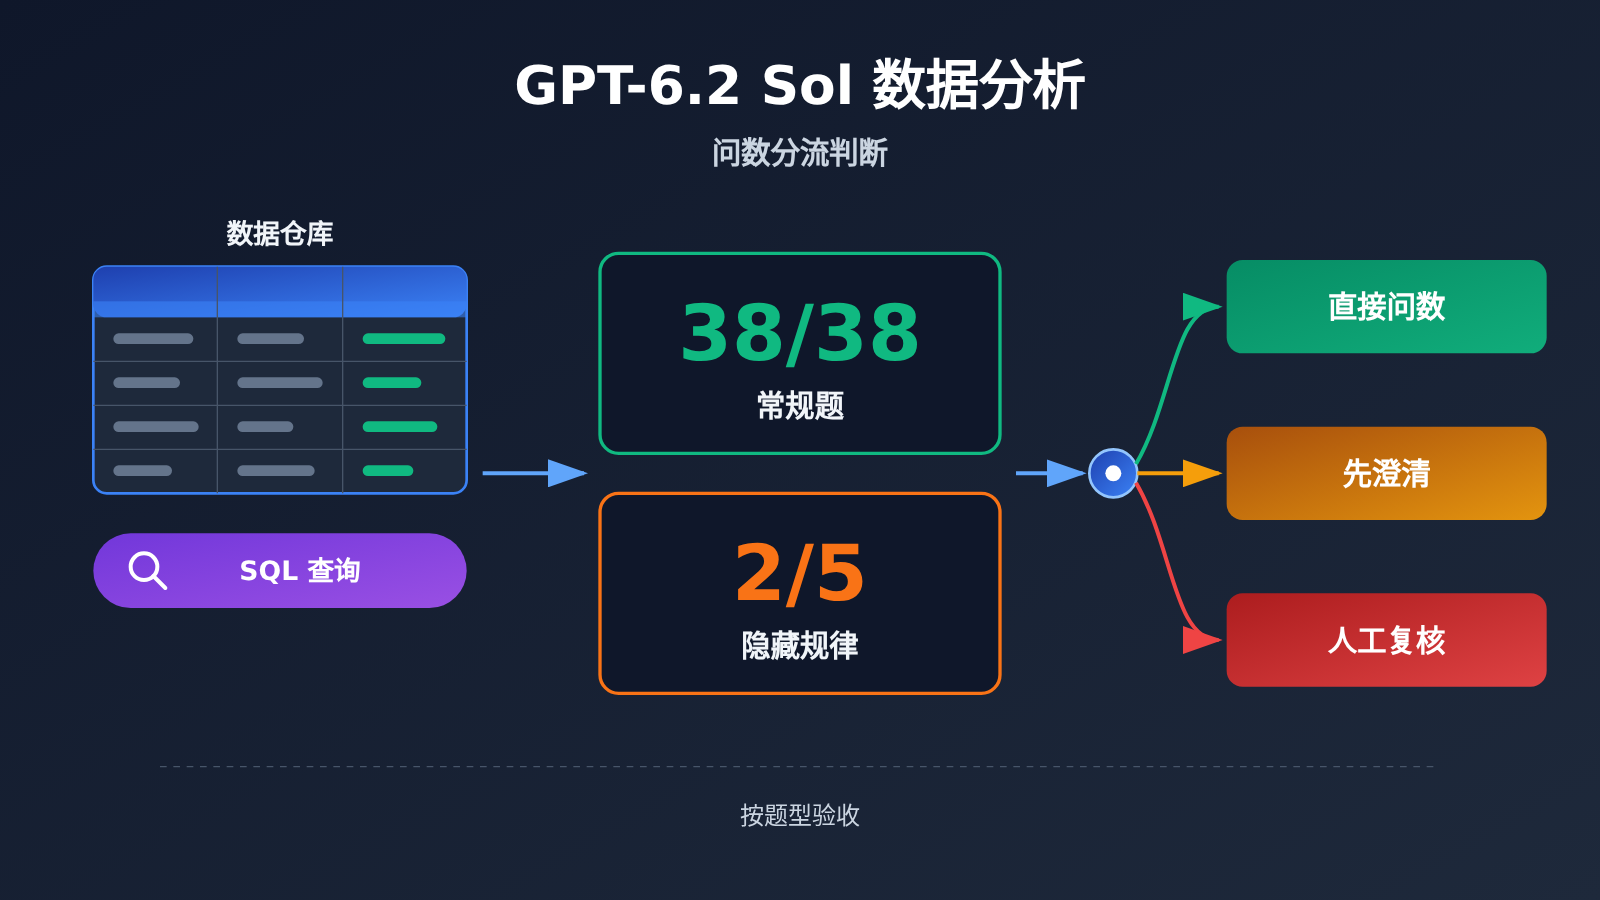
GPT-6.2 Sol 做数据分析的表现可以分成两部分看。在 Plotly 2026 年 11 月 17 日发布的单轮专项测试里,它把常规分析、歧义判断、数据不可回答、数据质量、统计陷阱五类题共 38 道全部答对,单题耗时中位数约 10.5 秒。同一轮测试中,5 道隐藏规律题只过了 2 道。
据此可以得出判断:口径明确、影响较小的汇总问数,可以试点交给 Sol 在只读权限下直接回答;口径缺失时先让它澄清;开放式归因和对外决策要交给分析师复核。 这个结论有三个前提:测试只跑了一轮,题库是模拟风电企业的英文题,费用来自 OpenRouter 渠道。换到你自己的数据和渠道之后,需要按题型重新验收。
GPT-6.2 Sol 数据分析知识地图与阅读索引
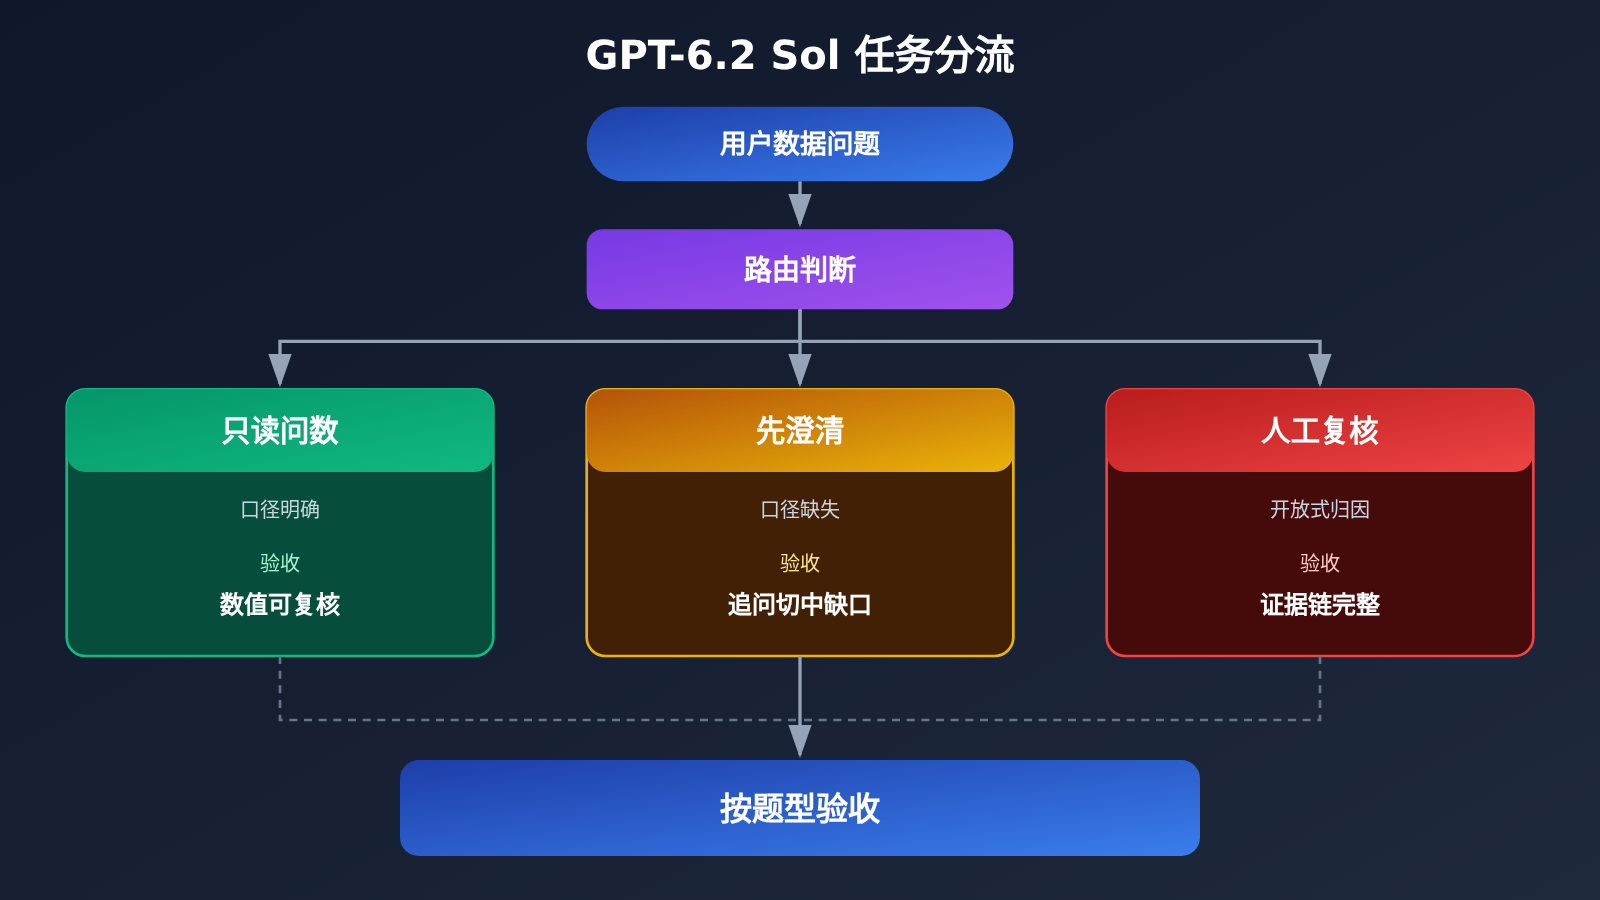
下图是全文的任务分流逻辑。每个分支都写明了输入条件、模型应给出的输出,以及这个分支在正文中的编号。
用户提出数据问题
 │
 ├─ 口径明确 + 低影响汇总 ──→ [1] Sol 只读问数
 │                              输出:数值 + 分子/分母 + 时间范围与时区 + 查询语句
 │
 ├─ 口径缺失 / 数据不足 ────→ [3.2] 先澄清
 │                              输出:一个具体追问 + 可选口径列表
 │
 └─ 开放式归因 / 对外决策 ──→ [3.3] 交分析师复核
                                输出:初步排查记录 + 支持证据 + 替代解释检查
            ↓
   [2] 用延迟与单题成本决定是否放在前台
            ↓
   [4] 用自己的数据按题型验收,交付带数据日期和查询证据的结果
各节的先后关系如下。并列的第 3 节可以按需查阅,其余几节建议按顺序阅读。
| 节号 | 回答的问题 | 为下一节提供什么 | 读完能做什么 |
|---|---|---|---|
| 1 | Sol 在哪类题上稳定 | 题型边界:38/38 与 2/5 | 划出可以直接问数的范围 |
| 2 | 放在前台划不划算 | 延迟、单题成本和外推假设 | 判断交互式场景的预算与等待 |
| 3 | 什么线索要澄清或转人工 | 三种失分形态与三种输出样例 | 设计路由规则 |
| 4 | 怎样在自己的数据上验收 | 按题型的指标与边界 | 产出一份可复核的交付物 |
To Know:GPT-6.2 Sol 数据分析相关术语
| 术语 | 简明解释 |
|---|---|
| 数据仓库 | 把业务系统中分散的历史数据归集起来、供查询分析用的数据集合 |
| 指标口径 | 指标的定义、过滤条件、分子分母和时间边界 |
| 只读 SQL | 只做检索和聚合的查询方式,数据源本身保持只读权限 |
| 隐藏规律题 | 数据里预先植入了结构性异常,题目只给线索,模型需要主动找到具体规律 |
| 查询证据 | 让他人能够复核结论的查询语句、口径、结果和数据日期 |
| p50 / p95 延迟 | 一半请求在多长时间内完成 / 95% 的请求在多长时间内完成 |
| 缓存输入 | 上游计费时被识别为可复用的输入 token,单价远低于普通输入 |
| 按题型验收 | 问数、澄清、拒答、探索等题型分开评分,避免总分掩盖某类错误 |
1. GPT-6.2 Sol 做数据分析:先看能稳定验收的问数结果
1.1 Plotly 测试做了什么
Plotly 在 Plotly Studio Embedded 测试框架里,通过 OpenRouter 调用模型,只开放四种只读工具:列出数据集、执行 SQL 查询、绘图、展示表格。测试仓库模拟一家风电企业,包含约 1,990 万行数据、44 张表、554 列。43 道英文题按答案键和评分规则逐题判定是否通过。判分模型是 Claude Sonnet 5,temperature=0,失分题目由团队人工复核。
这套设置接近企业 BI 问数的真实形态:模型看不到全部数据,只能自己找表、写 SQL、读结果再作答。题库和答案键由 Plotly 保留,外部无法逐题复现,所以下面的数字应理解为一次有方法说明的单轮观察,不宜当作稳定排名。
| 题型 | 题数 | GPT-6.2 Sol 结果 | 对业务的含义 |
|---|---|---|---|
| 常规分析 | 20 | 20/20 | 固定口径汇总可以试点直答 |
| 歧义判断 | 5 | 5/5 | 能识别问题本身有多种理解 |
| 数据不可回答 | 5 | 5/5 | 数据不支持时能拒答,不硬编数字 |
| 数据质量 | 3 | 3/3 | 能注意到缺失、重复等问题 |
| 统计陷阱 | 5 | 5/5 | 能避开常见的统计误读 |
| 隐藏规律 | 5 | 2/5 | 开放式找规律仍需人工验证 |
| 合计 | 43 | 40/43 | 前 38 题全过,失分全部集中在探索题 |
Plotly 还提到,其他模型在复跑时出现过最多三题的波动。40/43 与满分只差三题,正好落在这个波动范围内。因此更值得关注的是失分的分布:失分全部落在隐藏规律题,前五类一题没错。
1.2 为什么固定口径的问数可以复核
以售后报表为例,「过去 7 天各仓库退货率」能够稳定验收,前提是三件事已经事先固定:分母是已签收订单还是全部订单,时间范围按哪个时区截断,过滤条件是否排除了测试单和内部单。这三点一旦写进口径文档,模型生成的 SQL 和结果就能逐项与人工查询核对。
固定口径把「模型是否聪明」变成了「数字是否一致」,后者可以自动比对。这也是 38 道题能全过、而且全过有意义的原因:这些题大多有唯一的标准答案。
2. GPT-6.2 Sol 数据分析的延迟与成本:要不要放在前台
2.1 两代 Sol 的整轮对照
用户在前台问数,等待时间直接决定体验。Plotly 报告给出了 GPT-6.2 Sol 与 GPT-6.1 Sol 在同一轮 43 题上的对照:
| 指标 | GPT-6.1 Sol | GPT-6.2 Sol | 变化 |
|---|---|---|---|
| 整轮费用 | $2.61 | $1.22 | 约低 53.3% |
| 单题耗时中位数 | 17.6 秒 | 10.5 秒 | 约低 40.3% |
| 工具调用次数 | 258 | 158 | 明显减少 |
| 模型调用次数 | 227 | 173 | 减少 |
| 输入量 | 约 780 万 tokens | 约 460 万 tokens | 减少 |
| 输出量 | 约 7 万 tokens | 约 4.5 万 tokens | 减少 |
| 缓存输入比例 | 94% | 97% | 提高 |
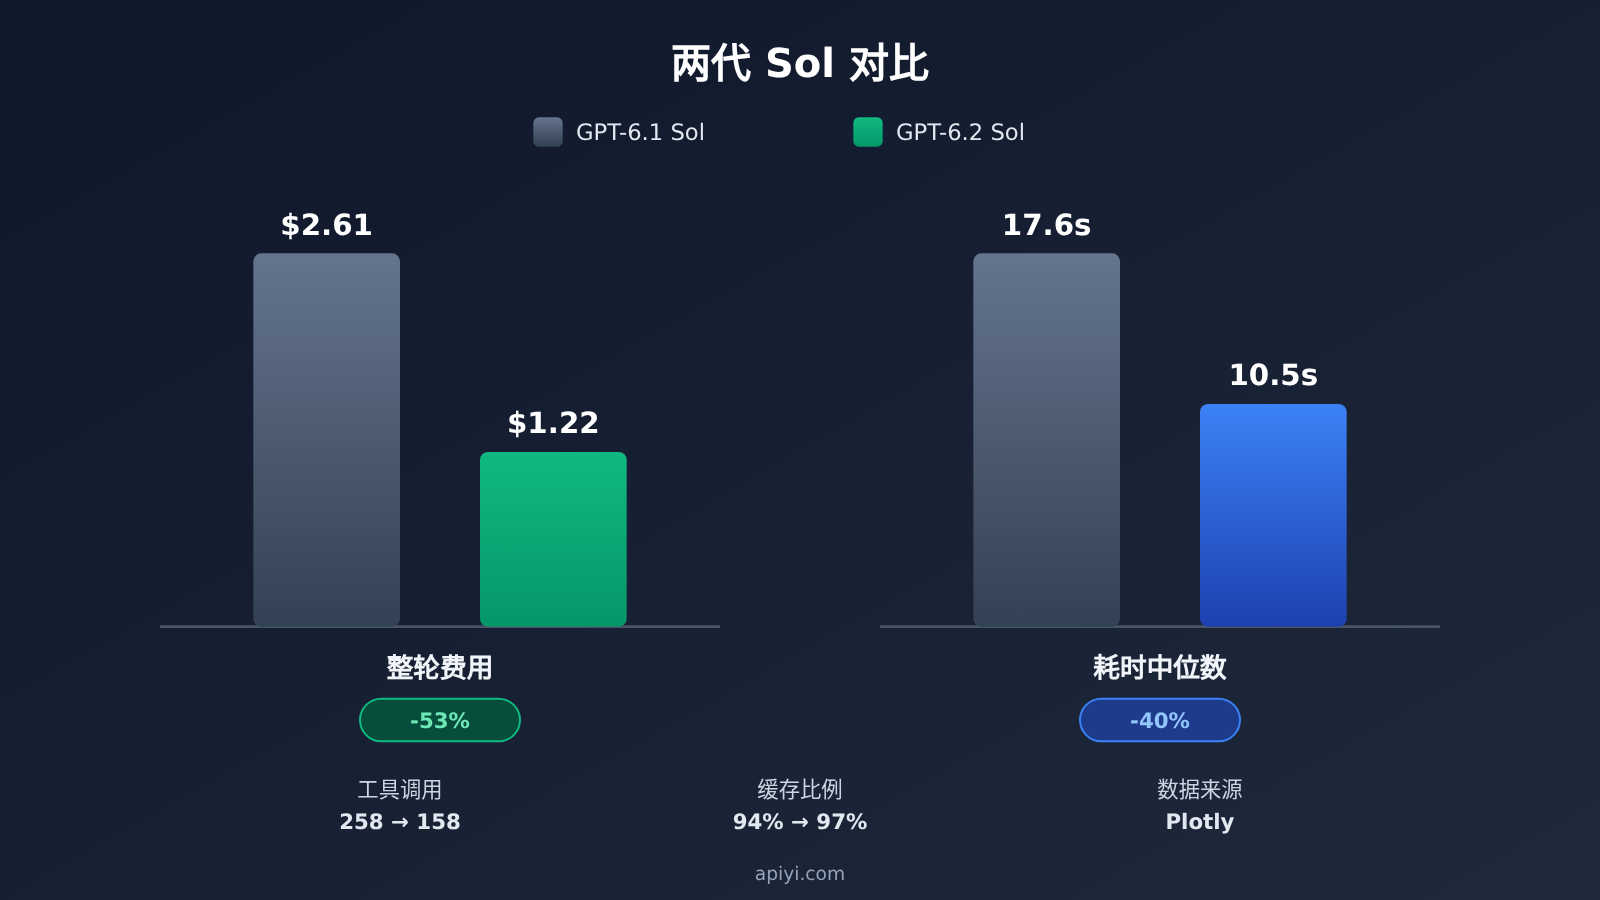
两代 Sol 的短上下文 Standard 基础标价相同,但整轮费用接近减半。差距来自任务过程:调用轮次更少,读写的 token 更少,缓存命中率更高。所以评估数据分析场景的成本时,应以「完成一道题花多少钱」为单位,每百万 token 的标价只是其中一个因素。
2.2 每千题约 $28.4 的外推与假设
把整轮 $1.22 除以 43 题,均摊约 $0.0284/题,外推到每千题约 $28.4。这个数字成立需要同时满足以下假设:
- 题型分布与 Plotly 的 43 题相同,其中探索题约占 12%;
- 使用同样的 OpenRouter 渠道与计价;
- 缓存比例保持在 97% 左右,题目之间共享相同的系统提示和表结构说明;
- 每题只跑一次,没有重试。
Plotly 榜单上另一个数字是单题成本中位数 $0.017,它和均摊值属于不同统计量。探索题调用工具多、耗时长,会把均值拉高,中位数则更接近一道普通问数题的成本。做预算时可以用中位数估算日常问数,再按探索题占比单独加一部分。
OpenAI 官方短上下文 Standard 价格为:普通输入 $2.00、缓存读取 $0.10、输出 $10.00(USD / 百万 token,输出已含推理 token)。请求输入总量超过 272K 时整单切到长上下文档。API易 apiyi.com 公开定价接口的短档与官方一致,长档为输入 $3、缓存读取 $0.15、缓存写入 $3.75、输出 $11.25。问数场景的单次请求通常远低于 272K,只有一次性塞入大量表结构或历史结果时才需要关注切档。
3. GPT-6.2 Sol 数据分析的三类线索:何时澄清、何时转人工
3.1 隐藏规律题为什么失分
在不含隐藏规律的 38 道题里,6.2 Sol 平均每题约 2.9 次工具调用,6.1 Sol 约 4.3 次,两者都全部通过。到了 5 道隐藏规律题,Sol 专项报告记录 6.2 Sol 平均约 9 次数据库查询,6.1 Sol 约 16 次。(Plotly 总榜文章举例时,前代用的是约 18 次的口径,本文以专项报告为准。)
人工检查后,三道失分题分别是:
- 没有把植入的规律单独分离出来;
- 没有指出具体哪些对象受到影响;
- 没有查到效应实际存在的那一部分数据。
三种失分有一个共同点:查询停在了表层。可以把这记作一条观察:新版在探索题上的搜索更浅。至于「查询次数少导致失分」这一因果关系,需要控制变量的实验才能确认。对业务而言,结论是一样的:凡是需要主动搜证据的归因题,不能把模型的第一个答案直接当结论。
3.2 口径缺失:先问再答
下面用一个虚构的售后工单数据集演示三种输出。数据集包含订单、工单、商品批次、仓库四张表,以下输出是设计样例,并非实测结果。
正常回答(口径明确)。用户问「按仓库列过去 7 天的退货率」,合格的输出除了每个仓库的数值,还要保留:分子(实物退货工单数)、分母(同期已签收订单数)、日期范围及时区(如北京时间 11-13 至 11-19)、聚合维度(仓库),并附上执行过的 SQL。
先问口径(口径缺失)。用户只问「上周退货率多少」,模型应先追问:「退货率按退款申请计,还是按实物退回计?两者在仅退款场景下差别较大。」然后列出两种口径供用户选择,用户选定之前不输出数字。
3.3 开放式归因:转交分析师
用户问「某渠道退货率翻倍,异常集中在哪些批次」,这就进入了隐藏规律题的范畴。模型可以先做初步排查:确认数据有没有缺失、整体样本量是否足够,再依次按渠道、品类、仓库、批次切分。输出中至少要保存一项支持证据,以及一项用于排除替代解释的检查(例如确认该渠道当周订单量没有异常下滑,排除分母变小造成的翻倍)。
做完这些之后,输出应标注为「待分析师复核」,而不是「结论」。路由规则可以概括为一张表:
| 线索 | 典型问法 | 路由 | 模型输出 | 验收重点 |
|---|---|---|---|---|
| 口径明确、低影响 | 各仓库 7 天退货率 | Sol 只读问数 | 数值 + 口径 + SQL | 数值与人工查询一致 |
| 口径或数据不足 | 上周退货率多少 | 先澄清 | 一个追问 + 候选口径 | 追问切中缺口 |
| 开放式归因、对外决策 | 异常集中在哪些批次 | 交分析师复核 | 排查记录 + 支持证据 + 替代解释检查 | 证据覆盖、误报与漏报 |
4. 用自己的数据验收 GPT-6.2 Sol 数据分析能力
4.1 接入与路由代码
gpt-6.2-sol 可以通过 Responses 和 Chat Completions 两个端点调用,函数调用和内置工具走 Responses 路径。两个端点都不接受 none 推理档位,迁移旧代码时需要检查这个参数。下面是用 Chat Completions 做路由分类的最小示例:
import openai, json

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

question = "上周退货率多少"
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[
        {"role": "system", "content": "把用户的数据问题分类为 direct / clarify / escalate,"
                                      "只返回 JSON:{\"route\":..., \"reason\":...}"},
        {"role": "user", "content": question},
    ],
)
print(json.loads(resp.choices[0].message.content))
查看只读 SQL 工具调用的完整示例(Responses API)
import openai, json, sqlite3

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 数据库层面以只读方式打开,正则检查只是第二道保险
conn = sqlite3.connect("file:aftersales.db?mode=ro", uri=True)

def run_readonly_sql(sql: str) -> str:
    head = sql.strip().lower()
    if not (head.startswith("select") or head.startswith("with")):
        return json.dumps({"error": "only read-only queries allowed"})
    rows = conn.execute(sql).fetchmany(200)
    return json.dumps({"rows": rows, "row_count": len(rows)}, default=str)

tools = [{
    "type": "function",
    "name": "run_readonly_sql",
    "description": "在售后数据仓库执行只读 SQL,返回最多 200 行",
    "parameters": {
        "type": "object",
        "properties": {"sql": {"type": "string"}},
        "required": ["sql"],
    },
}]

instructions = (
    "你是数据分析助手。回答必须包含:分子、分母、时间范围与时区、聚合维度、所执行的 SQL。"
    "口径不明确时先提问;涉及归因的结论标注为待分析师复核。"
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions=instructions,
    input="按仓库列过去 7 天的退货率",
    tools=tools,
)

# 循环处理工具调用,直到模型给出最终回答
while True:
    calls = [o for o in resp.output if o.type == "function_call"]
    if not calls:
        break
    outputs = [{
        "type": "function_call_output",
        "call_id": c.call_id,
        "output": run_readonly_sql(json.loads(c.arguments)["sql"]),
    } for c in calls]
    resp = client.responses.create(
        model="gpt-6.2-sol",
        previous_response_id=resp.id,
        input=outputs,
        tools=tools,
    )

print(resp.output_text)
print("output_tokens:", resp.usage.output_tokens)
🚀 快速开始:用自己的业务样本验收时,可以通过 API易 apiyi.com 申请新用户免费测试额度。同一个 API Key 可以切换
gpt-6.2-sol与其他主流模型,在同一套题目上横向对比,数据源保持只读即可。
4.2 按题型的验收指标
验收题库建议覆盖第 3 节的三种路由,每种题型单独计分。
| 题型 | 主要指标 | 判定方式 | 建议记录 |
|---|---|---|---|
| 固定口径问数 | 数值正确率 | 与人工 SQL 结果逐行比对 | 单题成本、p50/p95 延迟 |
| 口径缺失 | 澄清合适率 | 追问是否命中真正缺失的口径 | 是否出现「不该问却问」 |
| 数据不可回答 | 拒答正确率 | 不编造数字 | 误答次数 |
| 开放式归因 | 证据覆盖、误报与漏报 | 支持证据 + 替代解释检查是否齐全 | 多次复跑的一致性 |
Plotly 报告只给出了耗时中位数,你自己的验收要补上 p95。前台体验往往被少数长尾请求拖累,探索题尤其容易出现长尾。成本方面,从 usage.output_tokens 读取输出量,推理 token 通常列在 output_tokens_details.reasoning_tokens 子项里,再结合缓存读取量算出每题实际花费。
4.3 小样本与复跑的边界
Plotly 的隐藏规律只有 5 题,2/5 的置信区间很宽,换一批题可能是 1/5,也可能是 4/5。其他模型复跑时出现过最多三题的波动,所以单轮的总分差异不足以支撑选型。自己验收时,探索题至少重复运行几轮,并且对齐五个变量:数据快照、工具集、模型推理档位、调用渠道、判分表。任何一项变了,前后结果就不能直接比较。
💡 验收建议:渠道是容易被忽略的变量。Plotly 的费用来自 OpenRouter,你的生产渠道计费和缓存策略可能不同。建议在 API易 apiyi.com 上用同一份数据快照复跑,结合实际账单重新算每千题成本,再决定前台的配额。
4.4 一条可验收的交付物
验收通过的标准是:每条问数结果都能让第三个人独立复核。下面是一条合格交付物的形态(虚构数据):
question: 按仓库列过去 7 天的退货率
route: direct
data_snapshot: 2026-11-19 23:59 (Asia/Shanghai)
metric_definition:
  numerator: 实物退回工单数(status = returned)
  denominator: 同期已签收订单数(排除测试单、内部单)
  time_range: 2026-11-13 ~ 2026-11-19,北京时间
  group_by: warehouse_id
query: "SELECT w.warehouse_id, ... GROUP BY w.warehouse_id"
result: [{warehouse: 华东一仓, rate: 3.1%}, {warehouse: 华南二仓, rate: 2.4%}]
model: gpt-6.2-sol
cost_usd: 0.012
latency_s: 8.7
reviewer: 无需复核(固定口径问数)
一条交付物包含数据日期、口径、查询和结果,GPT-6.2 Sol 在前台问数这一环就可以验收。没有这几项的输出,即使数字恰好正确,也不应进入报表。想在自己的仓库上跑通这套流程,可以从 API易 apiyi.com 的 OpenAI 兼容接口开始,先上线固定口径问数,再逐步扩展到澄清和归因。
参考资料
- Plotly – GPT-6.2 Sol 数据分析专项报告:43 题分项结果、费用与耗时对照
- 链接:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- 链接:
- Plotly – DataAnalyticsBench 测试方法:题型设计、判分规则与榜单统计口径
- 链接:
plotly.com/blog/introducing-dataanalyticsbench
- 链接:
- OpenAI – GPT-6.2 Sol 模型卡:上下文窗口、端点支持与长上下文计费规则
- 链接:
developers.openai.com/api/docs/models/gpt-6.2-sol
- 链接:
- OpenAI – API 定价:Standard 输入、缓存与输出单价
- 链接:
developers.openai.com/api/docs/pricing
- 链接:
- API易 公开定价接口:
gpt-6.2-sol的短档与长档计价表达式- 链接:
api.apiyi.com/api/pricing
- 链接:
作者: APIYI 技术团队
技术交流: 欢迎在 API易官网首页联系我们,更多接入资料可访问 docs.apiyi.com 文档中心


