
تستخدم هذه المقالة مؤشرات Qwen4-Max وGPT-6 Luna على القائمة نفسها، وتسعير السياق الطويل، ووسائط الإدخال، لإجراء جولة اختيار لنموذج لغة كبير، وتحويل الدرجة الإجمالية إلى معايير قبول وتقدير تكلفة لمهام محددة.
نبدأ بالخلاصة، ثم نضع الشروط. إذا كان لا بد من إدخال فيديو في المهمة، فوفقًا لبطاقات النموذجين لا يمكن النظر إلا في Qwen4-Max، ولا يدخل GPT-6 Luna ضمن المرشحين. وإذا كانت المهمة نصية خالصة أو نصية-صورية، وكانت تكلفة الاستدعاء الواحد وعدد الاستدعاءات قيدًا صارمًا، فإن السعر المعلن لـ GPT-6 Luna أقل بكثير، ويستحق أن يكون الخيار الافتراضي. وإذا كانت المهمة عالية التعقيد مثل الأتمتة متعددة الخطوات، فإن Qwen4-Max يتقدم بوضوح في بعض البنود الفرعية لدى Artificial Analysis، ويمكن اعتباره مرشحًا لتوجيه المهام عالية التعقيد. أما أي مستوى تستخدمه في النهاية، فيعتمد على معدل نجاح القبول على مجموعة مهامك الخاصة وتكلفة المهمة المقبولة.
هناك ثلاثة شروط قد تغيّر هذه الخلاصة. أولًا، عندما يختلف مستوى الاستدلال في Luna، يمكن أن تتغير الفجوة في درجة المؤشر وتكلفة المهمة من نحو 22 ضعفًا إلى نحو 77 ضعفًا. ثانيًا، عندما يتجاوز الإدخال 272,000 Token، فإن Luna يرفع الطلب بأكمله إلى فئة سعرية أعلى وفق التسعير المعلن من OpenAI. ثالثًا، قد تكون الفجوة في بند فرعي على مهمة محددة صغيرة جدًا، فعلى سبيل المثال في FrontierCode-AA 2.0 لا يفصل بين النموذجين سوى 1.3 نقطة مئوية.
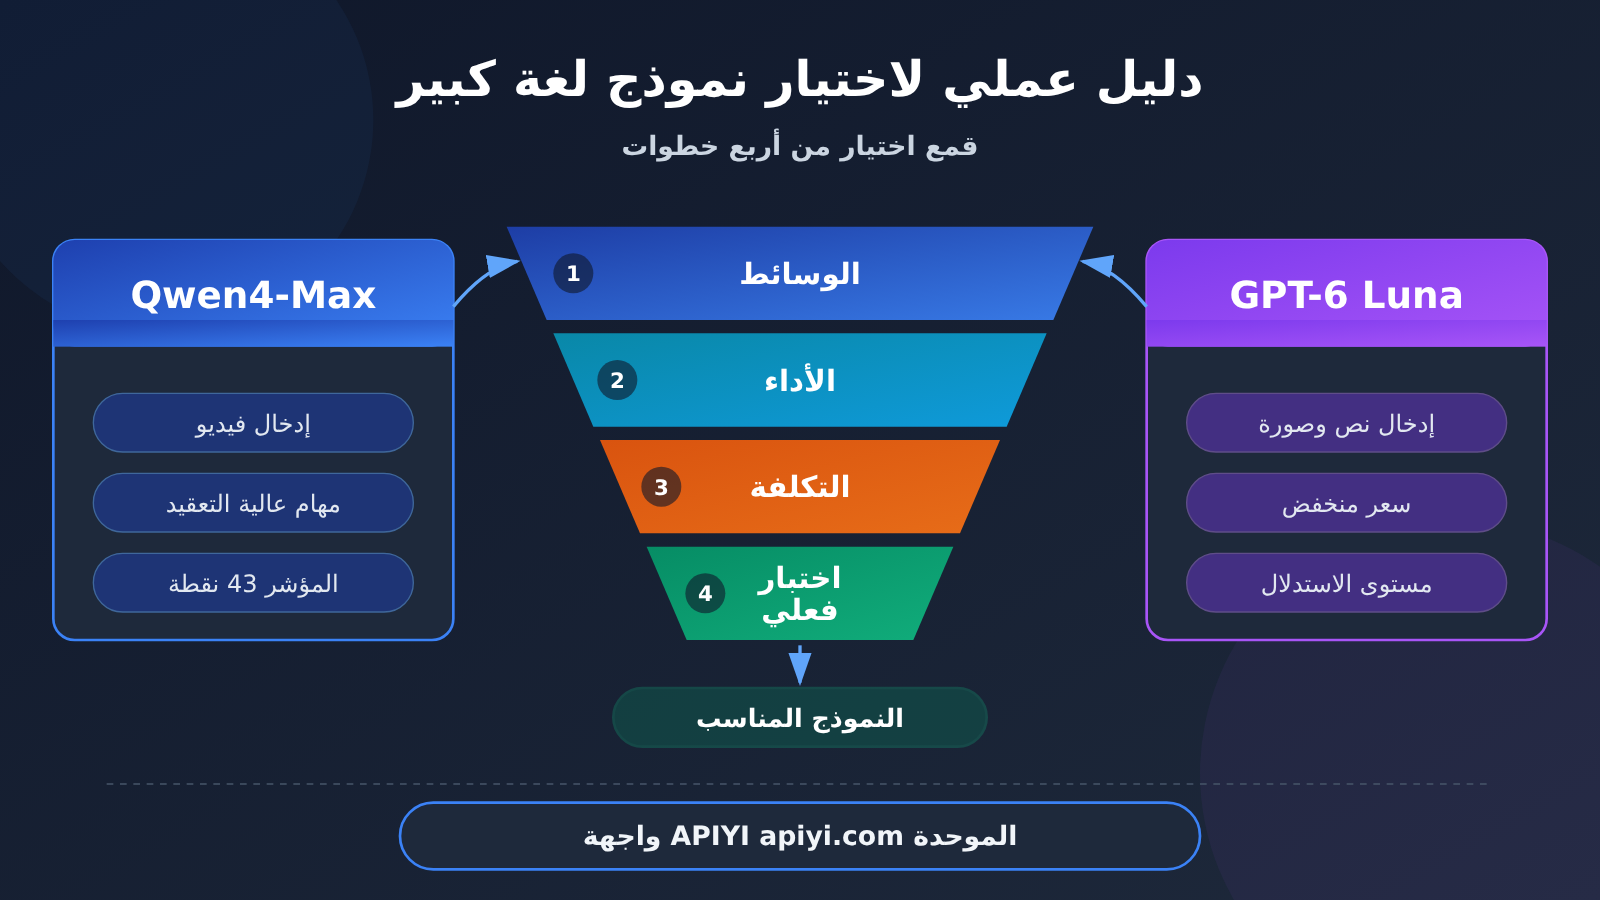
نظرة سريعة على مقارنة اختيار نماذج اللغة الكبيرة: Qwen4-Max مقابل GPT-6 Luna
يسرد الجدول التالي فقط الأبعاد التي تؤثر على اختيار النموذج. الدرجات في الجدول مأخوذة من Intelligence Index v5.0.1 الخاص بـ Artificial Analysis، والأسعار من القوائم العلنية للمزوّدين أو من دليل APIYI، وكلها معلومات علنية كما كانت في تاريخ التحقق من هذا المقال 2026-11-20، وليست اختبارات فعلية دفعنا ثمنها.
| بُعد المقارنة | Qwen4-Max | GPT-6 Luna | ماذا يعني الاختلاف |
|---|---|---|---|
| وسائط الإدخال (بطاقة النموذج من المزوّد) | نص، صورة، فيديو | نص، صورة | مهام الفيديو تستبعد Luna مباشرة |
| وسائط الإخراج | نص | نص | لا ينتج أي منهما صورًا أو صوتًا |
| Intelligence Index v5.0.1 | 43 درجة | فئة Medium: 18 درجة؛ فئة Max: 28 درجة | الفئة مختلفة، لذا يختلف الفرق |
| تكلفة مهام المؤشر | $3.27 | فئة Medium: $0.0422؛ فئة Max: $0.15 | تنطبق فقط على حمل العمل الخاص بهذا المؤشر |
| السعر المعلن للمزوّد (لكل مليون Token، سياق قصير) | Alibaba Cloud سنغافورة: الإدخال $1.50، الإخراج $4.50 | OpenAI القياسي: الإدخال $0.10، الإخراج $0.50 | الإدخال بنسبة 15 إلى 1 تقريبًا، والإخراج 9 إلى 1 |
| تسعير الإدخال الطويل | تقول مصادر طرف ثالث إن هناك سعرًا موحدًا للنافذة كاملة | عند تجاوز 272,000 Token يترقى الطلب بأكمله إلى فئة أعلى | يجب حساب سيناريو المستندات الطويلة بشكل منفصل |
| نقاط النهاية في دليل APIYI | chat، responses، messages | Chat Completions، Responses | يؤثر اختيار البروتوكول على تكلفة الترحيل |
| المنصات المتاحة | APIYI apiyi.com، Alibaba Cloud Model Studio وغيرها | APIYI apiyi.com، OpenAI الرسمي وغيرها | مفتاح واحد يسهّل التبديل والمقارنة |
يأتي نص المقال مرتبًا حسب ترتيب الاعتماد في عملية الاختيار. يتأكد القسم 1 أولاً من إمكانية الاتصال، لأنه إذا لم تتحقق شروط الوسائط أو نقاط النهاية فلن تكون للدرجات والأسعار اللاحقة أي معنى. ويقارن القسم 2 النتائج تحت المعيار نفسه، ويفصل القسم 3 — بناءً على حجم الاستخدام نفسه — سعر المزوّد وسعر الدليل والمبلغ المدفوع فعليًا من الحساب، ويحوّل القسم 4 الأحكام السابقة إلى خطوات يمكن إعادة اختبارها على عملك الخاص. يمكن للقراء الذين يهتمون بالتكلفة فقط الانتقال مباشرة إلى القسم 3، لكن يُنصح بقراءة شروط الاستبعاد في القسم 1 أولاً.
مصطلحات يجب معرفتها قبل اختيار نموذج لغة كبير (To Know)
| المصطلح | المعنى في هذا المقال |
|---|---|
| Intelligence Index | الدرجة المجمّعة التي يمنحها Artificial Analysis لأداء عدة مهام ضمن إصدار محدد؛ يستخدم هذا المقال الإصدار v5.0.1 |
| تكلفة مهمة المؤشر | تقدير الاستهلاك اللازم لإكمال مهمة واحدة في هذا المعيار؛ ويتغير الناتج بتغيّر مستوى الاستدلال وكميات الإدخال والإخراج |
| مستوى الاستدلال | يتحكم في شدة التفكير التي يخصصها النموذج، مثل Medium و Max في Luna؛ ويجب ذكره عند المقارنة |
| نمط الإدخال | نوع المحتوى الذي يستقبله النموذج، مثل النص أو الصورة أو الفيديو |
| التسعير المتدرج حسب السياق | بعد تجاوز الإدخال حدًا معينًا يُحتسب وفق مجموعة أسعار أخرى؛ ويلزم التأكد مما إذا كان يُحتسب الجزء الزائد فقط أم الطلب بأكمله |
| قراءة الذاكرة المؤقتة | بند الفوترة الخاص بإعادة استخدام المدخلات الموجودة؛ ويُحتسب وفق جدول الأسعار وسجلات الإصابة الفعلية |
| زمن وصول أول Token مرئي للإجابة | الوقت من إرسال الطلب حتى ظهور أول جزء قابل للاستخدام من الإجابة؛ ويجب التمييز في نماذج الاستدلال بينه وبين «أول حدث» |
| P50 / P95 | الوسيط والمئوي 95 لتوزيع زمن الوصول، ويعكسان على التوالي القيمة النموذجية والطلبات البطيئة |
| تكلفة المهمة المؤهلة | توزيع تكاليف الفشل والمراجعة وإعادة التنفيذ على كل نتيجة مطابقة فعليًا |
1. الخطوة الأولى في اختيار نموذج لغة كبير: استبعاد التركيبات غير المناسبة وفقًا لقيود المهمة
الإجراء الأقل تكلفة في الاختيار هو الاستبعاد أولًا. فمهما كان تقييم النموذج مرتفعًا، إذا لم يكن قابلاً للتكامل مع نوع الإدخال أو بروتوكول الاستدعاء لديك، فلا خيار سوى التخلي عنه؛ وبالعكس، إذا لم يستوفِ النموذج الرخيص القيود الصارمة، فلا داعي لحساب التكلفة لاحقًا.
1.1 التمييز بين وسائط الإدخال باستخدام بطاقة النموذج
تسرد بطاقة النموذج في Alibaba Cloud Model Studio أن Qwen4-Max يقبل إدخال النص والصورة والفيديو، ويُخرج نصًا. كما تسرد بطاقة النموذج لدى OpenAI أن GPT-6 Luna يقبل إدخال النص والصورة، ويُخرج نصًا؛ وتشير ملاحظات OrcaRouter أيضًا إلى أن Luna لا يدعم توليد الصور ولا توليد الصوت ولا النسخ الصوتي ولا الترجمة. هذا هو الفرق الأكثر صلابة بينهما، وهو ما يحدد أن مهام الفيديو لها مرشح واحد فقط هو Qwen4-Max.
تجدر الإشارة إلى أن بطاقة النموذج لدى المورّد تصف قدرات النموذج نفسه؛ أما على مستوى جهة وصول معينة أو نقطة نهاية معينة، فیجب التحقق بشكل منفصل مما إذا كان يمكن تمرير معاملات الفيديو. على سبيل المثال، تسرد صفحة النموذج في Together AI صراحةً إدخال النص والصورة، لكن لم يُعثر على وصف للفيديو على المسار نفسه؛ في هذه الحالة لا يمكن سوى كتابة «Together يذكر صراحةً النص والصورة»، ولا يمكن استنتاج أنه يدعم الفيديو.
1.2 التحقق من المعرّفات والمجموعات ونقاط النهاية باستخدام فهرس APIYI
أعلنت APIYI في 2026-11-17 طرح qwen4-max، وفي 2026-11-20 أورد سجل النماذج العام المنشور نقاط النهاية الخاصة به على أنها chat وresponses وmessages، والمجموعات على أنها ClaudeCode وCodexResponses وdefault وsvip. أما gpt-6-luna فقد ورد في قائمة الأسعار ضمن مجموعتي Default وSVIP، مع إدخالي Chat Completions وResponses. والقول الوارد في منشور سابق على المدونة إن «Qwen4-Max لم يُطرح بعد» يُستبعد لصالح أحدث إعلان وسجل النماذج.
لا يثبت الفهرس إلا أن المنصة تدعم النموذج ونقاط النهاية؛ لكن المجموعة التي ينتمي إليها حسابك وصلاحيات الرمز المميز تحددان ما يمكنك استدعاؤه فعليًا. لذلك يُنصح بعد إنشاء رمز في لوحة تحكم APIYI على apiyi.com بأن ترسل أول طلب بسيط جدًا لتأكيد معرّف النموذج الدقيق وتوفر نقطة النهاية، ثم تنتقل إلى مقارنة النتائج.
1.3 القيود غير القابلة للتنازل في كل سيناريو
| السيناريو | القيد غير القابل للتنازل | نتيجة الاستبعاد | التركيز التالي |
|---|---|---|---|
| تنظيم السجلات النصية (محاضر الاجتماعات، وأرشفة تذاكر الدعم) | تنسيق إخراج مستقر، وتكلفة منخفضة للاستدعاء الواحد، وحجم استدعاءات كبير | كلاهما يتأهل | مقارنة معدل نجاح التنسيق والتكلفة لكل وحدة |
| فهم الفيديو (فحص جودة تسجيلات الشاشة، وملخصات الفيديو) | يجب أن يستقبل إدخال فيديو | استُبعد GPT-6 Luna بحسب بطاقة النموذج | التحقق مما إذا كانت نقطة النهاية والرمز يدعمان معاملات الفيديو |
| العمليات المعقدة (الأتمتة متعددة الخطوات، والعمليات عبر الأنظمة) | معدل نجاح مرتفع للتنفيذ متعدد الخطوات، وكلفة الفشل كبيرة | كلاهما يتأهل | الاعتماد على معدل نجاح القبول بدلًا من سعر الوحدة |
تنظيم السجلات النصية سيناريو حساس للتكلفة بشكل نموذجي؛ فالمهمة نفسها ليست صعبة، والأمر الحاسم هو متوسط التكلفة لكل نتيجة عند الاستدعاء بكميات كبيرة. أما فهم الفيديو فهو مسألة عتبة قدرات، إذ لا معنى للمقارنة عند عدم تطابق الوسائط. وفي العمليات المعقدة يعني الفشل غالبًا إعادة عمل يدوية؛ وإذا تكرر فشل النموذج الأرخص عدة مرات، فقد تصبح التكلفة الفعلية أعلى. وسيُحسب ذلك بالتفصيل في القسمين 3 و4.
2. الخطوة الثانية في اختيار نموذج لغة كبير: المقارنة على أساس واحد
لا تبدأ بمقارنة النتائج إلا بعد الانتهاء من عملية الاستبعاد. وسنستخدم هنا بيانات صفحة المقارنة المنشورة نفسها على Artificial Analysis فقط، لأن مجموعات المهام وطرق التقييم تختلف من قائمة إلى أخرى، ولا معنى لخلطها في تصنيف واحد.
2.1 يجب قراءة الدرجة الإجمالية وتكلفة المهمة مع مستوى الإعداد معًا
| الإعداد | Intelligence Index v5.0.1 | تكلفة مهمة المؤشر | مضاعف التكلفة نسبةً إلى Qwen4-Max |
|---|---|---|---|
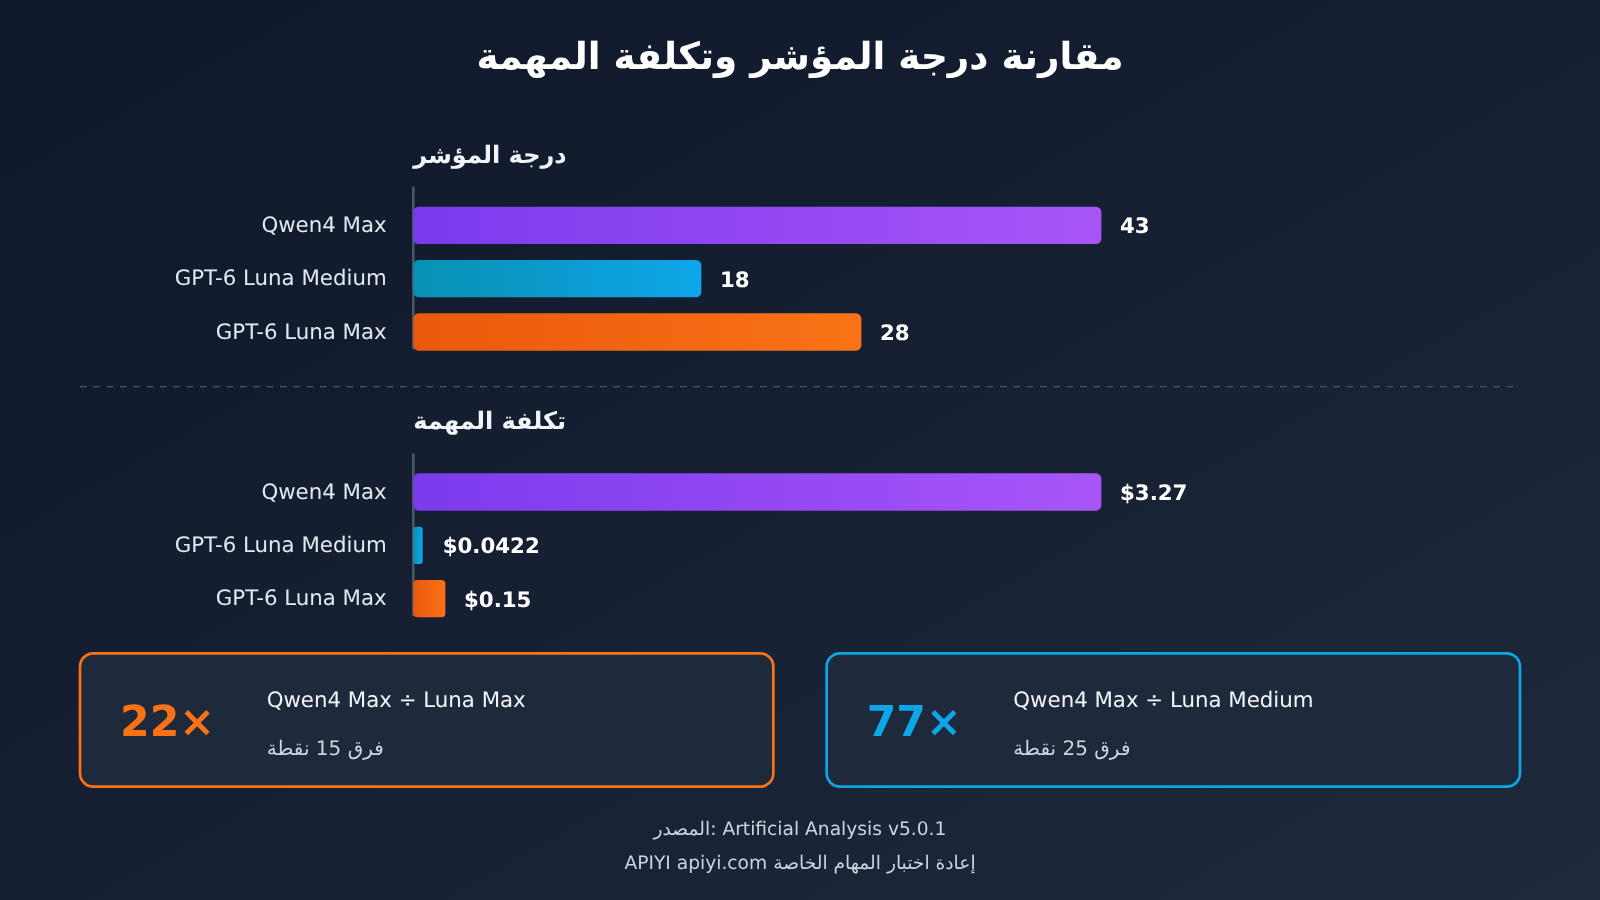
| Qwen4 Max | 43 | $3.27 | 1 |
| GPT-6 Luna (Medium، المستوى الافتراضي) | 18 | $0.0422 | نحو 1/77 |
| GPT-6 Luna (مستوى Max) | 28 | $0.15 | نحو 1/22 |
الرقم الشائع في الاستشهادات، أي «نحو 22 ضعفًا»، مشتق من $3.27 ÷ $0.15، أي من مقارنة Qwen4 Max بمستوى Max من Luna، حيث يبلغ فرق الدرجات 15 درجة. أما إذا قارنّا بالمستوى الافتراضي Medium من Luna، يصبح مضاعف التكلفة نحو 77 ضعفًا، وفرق الدرجات 25 درجة. لذلك فإن القول بأنه «أغلى 22 ضعفًا» فقط غير مكتمل، ويجب أن يوضح في الوقت نفسه أي مستوى إعداد وأي نوع من أحمال العمل هو المقصود.
وهناك تفصيل آخر يتعلق باكتمال البيانات. فقد أشار OrcaRouter إلى أن القائمة نشرت درجة واحدة فقط لـ Qwen4-Max، دون بيانات لكل مستوى إعداد، في حين نشرت Luna سلّم المستويات كاملًا. وعند تقدير التكلفة، يتيح السلّم الكامل رؤية نقطة الانعطاف التي «هل تستمر الدرجة في الارتفاع بعد رفع المستوى؟»، وهذا النوع من المعلومات قد يكون أنفع أحيانًا من درجة واحدة أعلى.
2.2 الفروق في المهام الفرعية تتغير بحسب المهمة
لا يستطيع المؤشر الإجمالي التنبؤ بعائد مهمة محددة. ففي AutomationBench-AA بلغ Qwen4 Max نسبة 72.6%، وLuna Max نسبة 53.2%، بفارق نحو 19 نقطة مئوية؛ وفي FrontierCode-AA 2.0 بلغت النسبتان 26.5% و25.2% على التوالي، أي بفارق 1.3 نقطة مئوية فقط.
وإذا أعدنا هذا إلى سيناريوهات القسم الأول، نجد أن العمليات المعقدة أقرب إلى مهام الأتمتة متعددة الخطوات مثل AutomationBench، ومن ثم فقد تتحول أفضلية Qwen4-Max إلى إعادة عمل أقل. أما إذا كانت مهامك أقرب إلى فئة FrontierCode، فالفارق بينهما صغير جدًا، في حين يظل فارق سعر الوحدة كبيرًا، وهنا تبرز القيمة مقابل السعر لدى Luna. وهذا حكم اتجاهي فقط، ويبقى التحقق الفعلي على مجموعة مهامك أنت.
3. الخطوة الثالثة في اختيار نموذج لغة كبير: حساب سعر المزوّد وسعر الكتالوج ورسوم الحساب بشكل منفصل
غالبًا ما تختلط التكاليف عند الحديث عنها. يقسم هذا القسم الموضوع إلى ثلاث طبقات: السعر المعلن من المزوّد، وسعر كتالوج APIYI، والمبلغ الفعلي المدفوع من الحساب بعد إعادة الشحن والمكافأة. وهذه الطبقات الثلاث تنتمي إلى جهات مختلفة، ولا يمكن أن تحل إحداها محل الأخرى.
3.1 مثال حسابي على سعر المزوّد لطلب واحد بإدخال طويل
لنفترض أن طلبًا واحدًا يتضمن إدخالًا مقداره 400 ألف توكن، وإخراجًا مفوترًا مقداره 8,000 توكن، دون إصابة في الذاكرة المؤقتة، ودون رسوم أدوات إضافية.
| البند | Qwen4-Max (سعر Alibaba Cloud International القياسي في سنغافورة) | GPT-6 Luna (سعر OpenAI القياسي، الإدخال الطويل) |
|---|---|---|
| سعر الإدخال | $1.50 / مليون | $0.20 / مليون (الانتقال إلى الشريحة الأعلى للطلب بأكمله عند تجاوز 272,000) |
| سعر الإخراج | $4.50 / مليون | $0.75 / مليون |
| المعادلة | 0.4 × 1.50 + 0.008 × 4.50 | 0.4 × 0.20 + 0.008 × 0.75 |
| تكلفة الطلب الواحد | $0.636 | $0.086 |
النسبة بينهما نحو 7.40 أضعاف، أي أقل بنحو النصف من فارق سعر الإدخال 15 مقابل 1 في السياق القصير؛ والسبب في ذلك هو قاعدة الانتقال إلى شريحة أعلى لدى Luna. وفق سعر OpenAI، ينطبق الانتقال إلى الشريحة الأعلى للإدخال الطويل على الطلب بأكمله، لا على الجزء الزائد فقط: فمع موجه بطول 300 ألف توكن، تُحتسب الـ300 ألف كلها بالسعر المرتفع، وليس آخر 28,000 توكن فقط. ويذكر ملخص OrcaRouter أن Qwen4-Max يُحتسب بالسعر نفسه على امتداد نافذة المليون توكن بأكملها، من دون شرائح 32K أو 128K.
كما يختلف سعر المزوّد بحسب المنطقة والقناة. يسرد OrcaRouter سعر Qwen4-Max في منطقة Global عند $1.413 للإدخال و$4.24 للإخراج، وهو مختلف عن سعر سنغافورة. وتصنّف صفحة الأسعار الرسمية لدى Together AI نموذج Qwen4 Max ضمن عرض ترويجي، بسعر لفترة محدودة: $1.05 للإدخال، و$3.15 للإخراج، و$0.0525 لقراءة الذاكرة المؤقتة، وهو بالضبط 70% من سعر سنغافورة. وتشير الصفحة إلى أن السعر ساري حتى 2026-11-23، لكنها لا تذكر المنطقة الزمنية؛ في حين تعرض صفحة تفاصيل الطراز شريحة أخرى: $1.43 و$4.28 و$0.0713. وعند الاستشهاد بأسعار من هذا النوع، يجب ذكر الصفحة المصدر والتاريخ؛ ويُعتمد التسوية الفعلية على استخدام الحساب.
3.2 حساب سعر دليل APIYI وفق أسعار الدليل وسجل الاستخدام
في دليل APIYI، سعر qwen4-max لكل مليون Token هو $1.50 للإدخال، و$4.50 للإخراج، و$0.075 لقراءة الذاكرة المؤقتة؛ أما gpt-6-luna فسعر الإدخال في السياق القصير $0.10، والإخراج $0.50، وقراءة الذاكرة المؤقتة $0.01، وتوضح قائمة الأسعار أن سعر الإدخال يرتفع إلى $0.20 عندما يتجاوز الإدخال 272,000 Token.
وبتطبيق الطلب نفسه الوارد في 3.1، يكون سعر qwen4-max وفق أسعار الدليل أيضًا $0.636. أما جزء الإدخال في gpt-6-luna فهو 0.4 × 0.20 = $0.08؛ وقائمة الأسعار التي تم التحقق منها في هذه الجولة تذكر فقط ترقية سعر الإدخال، أما جزء الإخراج فبأي سعر يُحسب في السياق الطويل، فارجع في ذلك إلى قائمة الأسعار السارية وسجل الاستخدام. أرقام التكلفة الحقيقية ينبغي أن تأتي من سجل الاستخدام في حسابك، لا من الصيغة أعلاه.
💰 نصيحة لحساب التكلفة: استدعِ النموذجين كلاً على حدة ضمن الحساب نفسه على APIYI apiyi.com، فسجل الاستخدام يسجّل الإدخال والإخراج وذاكرات Token المؤقتة لكل طلب، وهو أقرب إلى الفاتورة الفعلية من التقدير بناءً على الأسعار المعلنة.
3.3 تؤثر مكافأة إعادة الشحن على تحويل المبلغ الأساسي، وليس على سعر وحدة النموذج
تسرد الأسئلة الشائعة الحالية لـ APIYI شرائح إعادة الشحن لمعاملة واحدة: من $100 إلى أقل من $500 تُضاف مكافأة 10%، ومن $500 إلى أقل من $1,000 تُضاف مكافأة 12%، ومن $1,000 إلى أقل من $3,000 تُضاف مكافأة 15%، ومن $3,000 فصاعدًا تُضاف مكافأة 20%. يمكن المشاركة في الشحن عبر الإنترنت والشحن للشركات، وتُصرف المكافأة تلقائيًا؛ أما إمكانية الجمع مع التسعير الخاص الذي تعدله فرق الأعمال فيجب تأكيده بشكل منفصل. كما يحصل المستخدم العادي عند أول شحن على $1 إضافية، بينما يحصل المستخدم التعليمي الموثق عبر البريد الإلكتروني للمدرسة على $2، ويجب التواصل مع خدمة العملاء لصرفها؛ ويُستخدم رصيد الشحن وفق قاعدة 365 يومًا المذكورة في الوثائق.
| شريحة الشحن | الرصيد المستلم | ما يعادل $1 من السجل بالمبلغ الأساسي المشحون | نسبة انخفاض تكلفة المبلغ الأساسي |
|---|---|---|---|
| معاملة واحدة $100 | $110 | حوالي $0.909 | حوالي 9.09% |
| معاملة واحدة من $3,000 فصاعدًا | مبلغ الشحن × 1.2 | حوالي $0.833 | حوالي 16.67% |
الافتراض هنا هو استخدام رصيد المكافأة بالكامل. وبالتحويل وفق شريحة 10%، فإن تكلفة السجل الواحد البالغة $0.636 في القسم 3.1 تقابل حوالي $0.578 من المبلغ الأساسي المشحون. وتجدر الإشارة إلى أن المكافأة تُطبق بشكل موحد على رصيد الموقع بالكامل، فهي تخفض المبلغ الأساسي المقابل لكل $1 من حصة السجل، ولا يمكن فهمها على أنها تخفيض إضافي على سعر نموذج معين؛ وعند مقارنة الخيارات، يجب استخدام معامل تحويل واحد على كلا الجانبين، وإلا فإن المقارنة ستكون مضللة.
4. الخطوة الرابعة في اختيار نموذج لغة كبير: صياغة الشروط في خطوات قابلة للمقارنة والقياس
الأقسام الثلاثة السابقة كلها معلومات عامة. ما يحدد فعلاً أي نموذج تختاره هو معدل نجاح مهامك الخاصة تحت الظروف نفسها، وزمن الاستجابة، والتكلفة. في الوقت الحالي لا نمتلك على منصة APIYI بيانات معدل النجاح وزمن الاستجابة وفواتير النموذجين لنفس المهمة ونفس المجموعة، وفيما يلي نوضح معايير المقارنة التي يمكنك تنفيذها بنفسك.
4.1 ضبط المتغيرات وحقول التسجيل
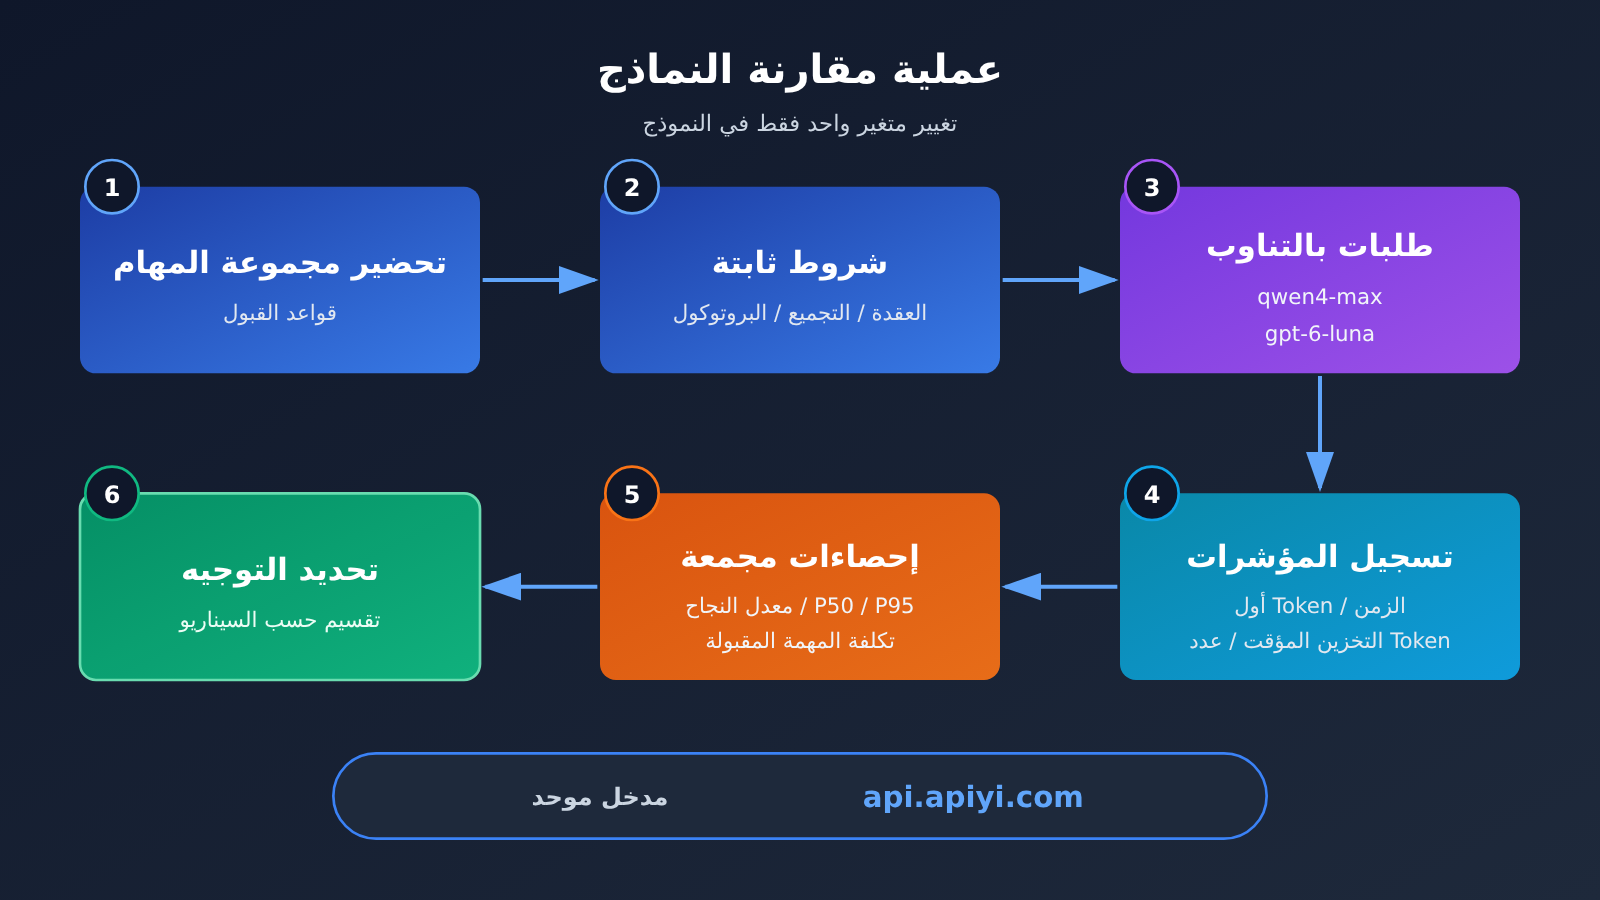
ينبغي أن تجعل المقارنة تتغير فيها فقط “النموذج” كمتغير واحد قدر الإمكان. الطريقة المحددة هي استخدام نفس عقدة البر الرئيسي ونفس مزود الخدمة، ونفس مجموعة وبروتوكول APIYI، ونفس مجموعة المدخلات والحد الأعلى للمخرجات، وإرسال طلبات النموذجين بالتناوب تحت نفس مستوى التزامن، لتجنب الانحراف الزمني الناجم عن تشغيل نموذج بالكامل ثم الانتقال إلى الآخر.
| حقل التسجيل | الغرض |
|---|---|
| هل اجتاز القبول | حساب معدل النجاح وتكلفة المهام المؤهلة |
| حالة HTTP، معرف الطلب | استكشاف الأعطال، والمطابقة مع سجلات الاستخدام |
| زمن استجابة أول توكن مرئي من الإجابة | قياس تجربة التفاعل، ويجب فصل نموذج الاستدلال عن الحدث الأول |
| إجمالي الوقت المستغرق | قياس إنتاجية المعالجة المجمعة |
| الاتصال البارد/الساخن، إصابة الذاكرة المؤقتة | تفسير تقلبات زمن الاستجابة والتكلفة |
| عدد توكنات الإدخال والإخراج | التحقق من الاستخدام الفعلي المفوتَر |
من الأفضل تسجيل أوقات DNS وTCP وTLS بشكل منفصل. عند التقرير، اذكر بوضوح حجم العينة ومعدل النجاح وP50 وP95؛ وعند المقارنة العلنية الخارجية، يمكن الرجوع إلى تعريفات معدل النجاح وزمن استجابة أول كلمة والإنتاجية في تقرير أكاديمية الصين لتقنية المعلومات والاتصالات (CAICT).
4.2 أصغر سكربت للاختبار التبادلي المقارن
يقوم السكربت التالي باستدعاء نموذجين بالتبادل عبر واجهة متوافقة مع OpenAI، ويستخدم الإخراج المتدفق لقياس زمن أول رمز (Token) مرئي في الإجابة والزمن الكلي. عليك استبدال دالة التحقق بما يناسب مهمتك؛ وإذا كنت بحاجة إلى ضبط درجة الاستدلال، فتأكد من اسم المعامل في وثائق APIYI قبل إضافته، ودوّن ذلك في السجلات.
import time, statistics, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحدة، يستخدم النموذجان مفتاحًا واحدًا
)

MODELS = ["qwen4-max", "gpt-6-luna"]
TASKS = ["把下面的会议记录整理成 JSON:...", "..."]  # استبدلها بمجموعة مهامك

def passed(task, answer):
    return answer.strip().startswith("{")  # استبدلها بقاعدة التحقق الحقيقية

records = {m: [] for m in MODELS}
for task in TASKS:
    for model in MODELS:  # طلبات متبادلة لتقليل تحيّز الفترة الزمنية
        start, first = time.perf_counter(), None
        text = ""
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": task}],
            max_tokens=2000,  # يستخدم النموذجان الحد الأقصى نفسه للإخراج
            stream=True,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                if first is None:
                    first = time.perf_counter() - start  # أول رمز مرئي في الإجابة
                text += chunk.choices[0].delta.content
        total = time.perf_counter() - start
        records[model].append({"ok": passed(task, text), "ttft": first, "total": total})

for m, rs in records.items():
    ttfts = sorted(r["ttft"] for r in rs if r["ttft"] is not None)
    n = len(rs)
    print(m, "样本", n, "通过率", sum(r["ok"] for r in rs) / n,
          "首字P50", statistics.median(ttfts) if ttfts else None,
          "首字P95", ttfts[int(0.95 * (len(ttfts) - 1))] if ttfts else None)
يُنصح بتجميع استخدام الرموز (Tokens) والتكلفة مباشرةً من سجل الاستخدام في المنصة حسب معرّف الطلب، ثم إدخالهما في الصيغة أدناه.
4.3 تكلفة المهمة المقبولة والتوجيه حسب المستوى
تُحسب تكلفة المهمة المقبولة على أنها إجمالي تكاليف الاستدعاء (بما في ذلك محاولات الفشل وإعادة المحاولة) مضافًا إليها تكاليف المراجعة البشرية وإعادة العمل، ثم يُقسم الناتج على عدد المهام التي اجتازت القبول في النهاية. إذا كان النموذج الأقل سعرًا للوحدة يتمتع بمعدل نجاح منخفض، يصغر المقام ويكبر البسط، وقد تتجاوز تكلفة المهمة المقبولة تكلفة النموذج الأعلى سعرًا؛ وبالعكس، إذا تقارب معدل النجاح بينهما، فسيظهر فرق سعر الوحدة تقريبًا كما هو في النتيجة.
بناءً على ذلك، يمكن توجيه الطلبات حسب تعقيد المهمة: المهام العادية تمر افتراضيًا عبر gpt-6-luna، والمهام عالية التعقيد أو مهام الفيديو تمر عبر qwen4-max. وقبل تفعيل أي مسار توجيه، تحقق أولًا من بلوغ معدل اجتياز القبول على مجموعة المهام المعنية الحد المطلوب، ثم انظر في تكلفة المهمة المقبولة. ولأن كلا النموذجين متاحان عبر المجموعة نفسها من واجهات API المتوافقة مع OpenAI على APIYI apiyi.com، لا يتطلب تبديل المسار سوى تغيير حقل model.
🎯 نصيحة للمقارنة التجريبية: يمكن للمستخدمين الجدد أولًا استخدام رصيد التجربة عند التسجيل والمدرج في صفحة البدء السريع على APIYI apiyi.com لتشغيل السكربت بنجاح، ثم شحن الرصيد بما يتناسب مع حجم مجموعة المهام لإجراء مقارنة تجريبية رسمية.
4.4 بيانات فحص المدخل لا توضح إلا حدود القياس
أجرت Lingjian AI في جدول المراقبة المنشور عيّنات من عُقد البر الرئيسي على نطاق APIYI؛ وفي الفترة من 2026-11-05 إلى 11-06، سجّلت ثلاثة استجابات HTTP 200 أزمنة قدرها 429 و569 و565 ms على التوالي. مثل هذه الفحوص لا تعكس سوى اتصال المدخل، كما أن الصفحة تعد بعض استجابات HTTP 404 طبيعية، ولا توضح حمل الطلب أو طريقة المصادقة، لذا لا يمكن استخدامها لاستنتاج زمن توليد النموذج أو معدل نجاحه. كما أن زمن أول Token لدى Artificial Analysis يمثل بيئة التقييم الخاصة به هو فقط؛ أما النتائج في ظل شبكتك وظروف التزامن لديك فتحتاج إلى قياس منفصل بالطريقة الواردة في 4.1.
عودةً إلى السؤال في العنوان: إدخال الفيديو شرط إلزامي لا بد منه، ولا يفي به إلا Qwen4-Max؛ وفي المهام النصية البحتة ومهام النص مع الصورة، تكون ميزة السعر المعلن لـ GPT-6 Luna في أقصاها مع السياق القصير، وتتقلص عندما يتجاوز الإدخال 272,000 Token؛ وفي المهام عالية التعقيد متعددة الخطوات، قد يعوّض تفوق Qwen4-Max في البنود الفرعية فرق سعر الوحدة. تستند الاستنتاجات الثلاثة جميعها إلى فئة النموذج وطول الإدخال ونوع المهمة، ويبقى الحكم النهائي لتكلفة المهمة المقبولة على مجموعة مهامك أنت. وإذا كنت بحاجة إلى مدخل موحّد لإجراء مقارنة تجريبية بالتناوب، فيمكنك عبر APIYI apiyi.com استدعاء النموذجين معًا باستخدام مفتاح API واحد.
المراجع
- Artificial Analysis — مقارنة إصدار Qwen4 Max مقابل GPT-6 Luna: مؤشر الذكاء Intelligence Index v5.0.1 وبيانات المؤشرات الفرعية
- الرابط:
artificialanalysis.ai/zh/models/comparisons/qwen4-max-vs-gpt-6-luna
- الرابط:
- Alibaba Cloud Model Studio — بطاقة نموذج Qwen4-Max وقائمة الأسعار: الوسائط المُدخلة والسعر القياسي في سنغافورة
- الرابط:
alibabacloud.com/help/en/model-studio/model-pricing
- الرابط:
- OpenAI — نموذج GPT-6 Luna: الوسائط المُدخلة وتسعير السياق الطويل
- الرابط:
developers.openai.com/api/docs/models/gpt-6-luna
- الرابط:
- OrcaRouter — Qwen4-Max مقابل GPT-6 Luna: نسبة سعر الوحدة، وتوضيح الترقية إلى فئة أعلى عند 272,000 Token
- الرابط:
orcarouter.ai/blog/qwen-4-max-vs-gpt-6-luna
- الرابط:
- Together AI — الأسعار: سعر ترويجي لفترة محدودة لنموذج Qwen4 Max
- الرابط:
together.ai/pricing
- الرابط:
- APIYI — الجدول الشامل لأسعار النماذج وسجل النماذج والأسئلة الشائعة حول عروض الشحن: سعر الكتالوج، وتجميع نقاط النهاية، وشرائح المكافآت الإضافية
- الرابط:
docs.apiyi.com/models
- الرابط:
- الأكاديمية الصينية لتقنية المعلومات والاتصالات (CAICT) وآخرون — تقرير مراقبة أداء خدمات الرموز لنماذج اللغة الكبيرة (2026): معدل النجاح، وزمن استجابة أول رمز، وتعريفات معدل النقل
- الرابط:
caict.ac.cn
- الرابط:
المؤلف: فريق APIYI التقني
التواصل التقني: يسعدنا تواصلك معنا عبر الصفحة الرئيسية لموقع APIYI على apiyi.com، ولمزيد من مواد التكامل يمكنك زيارة مركز الوثائق docs.apiyi.com


