
直接回答:在理想條件下,OpenAI 默認 30 分鐘提示緩存從第 2 次使用起就比不緩存便宜,12 小時緩存要到第 3 次使用纔開始划算。 這裏的理想條件是:同一段固定前綴先完整寫入一次緩存,後續請求全部命中,期間沒有重複寫入。按 gpt-6-luna 標準短上下文檔的官方價格計算,一段 10000 Token 的固定前綴總共使用 10 次時,30 分鐘緩存比不緩存節省約 78.5%,12 小時緩存節省約 66%。但這只是固定前綴部分的賬,不代表整個請求打了折。
您讀完此文能瞭解到什麼?
- 提示緩存命中的真實條件,以及它和“語義相似”的區別。
- 30 分鐘與 12 小時兩種寫入費率如何計價,爲什麼不能再疊加普通輸入費。
- 一組可複覈的 1、2、3、10 次使用算例,以及適用於任意前綴長度的回本公式。
- 這套規則對開發者設計提示結構、安排批量任務分別意味着什麼。
索引: 先用一張概念表和影響速覽幫你對齊術語與受影響人羣;“客觀事實”部分整理官方文檔中的緩存規則、價格和算例數據;“分析判斷”部分解釋回本線背後的數學關係,並討論提示結構、批次安排和常見誤判。
OpenAI 提示緩存 To Know:概念解釋
| 概念 | 簡要解釋 |
|---|---|
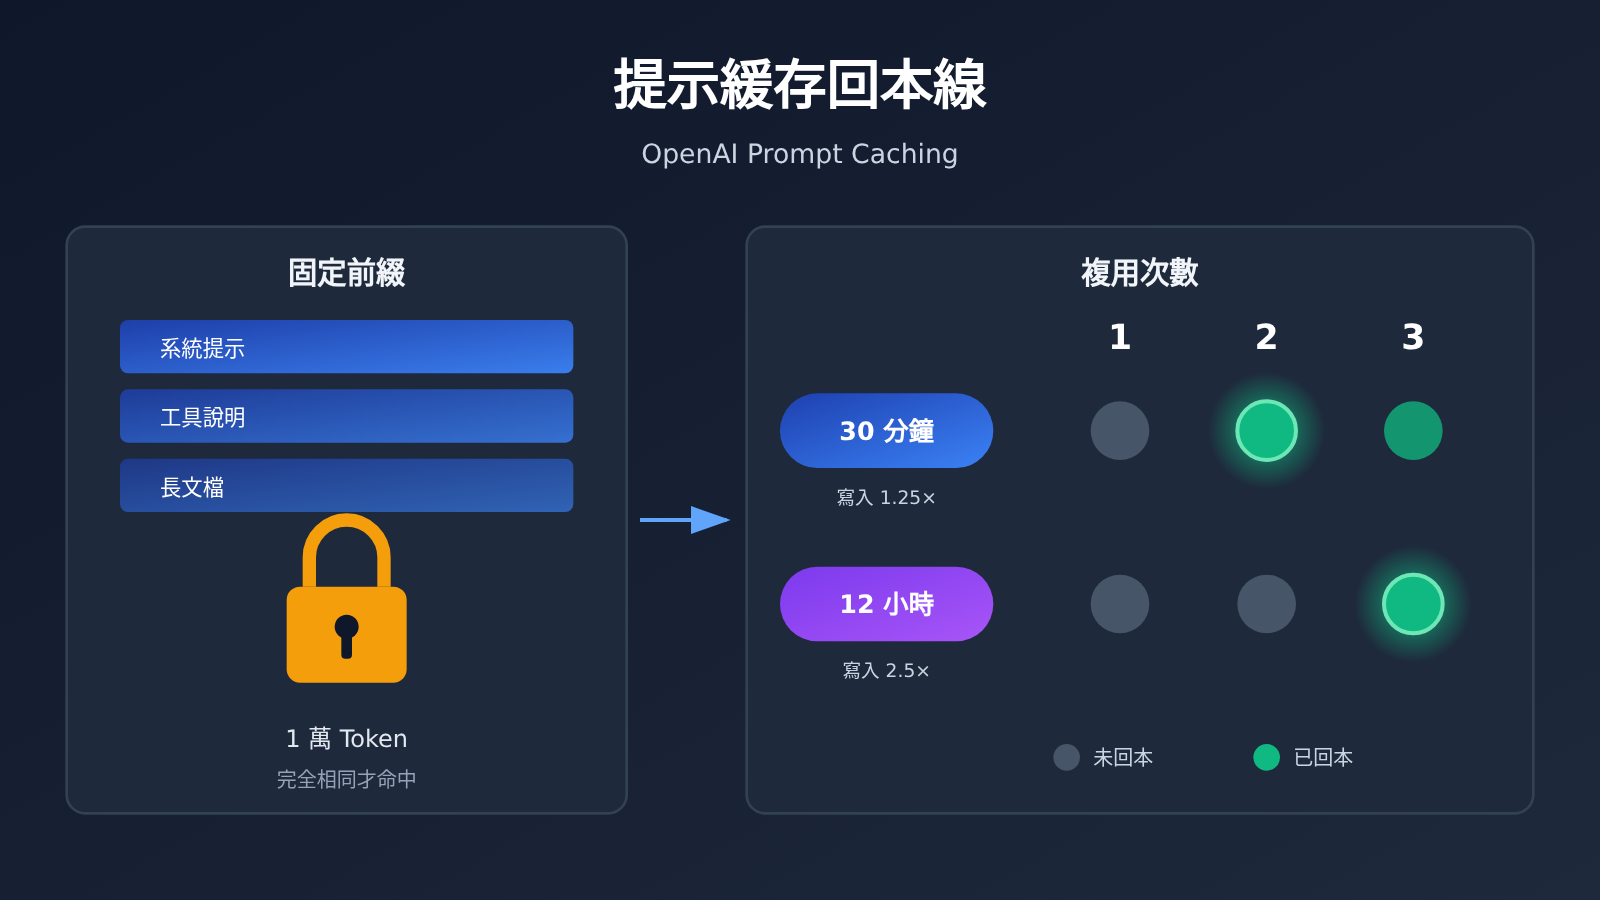
| 提示緩存(Prompt Caching) | OpenAI 對重複出現的提示前綴進行緩存,後續請求命中時按更低的“讀緩存”價格計費 |
| 提示前綴 | 一次請求輸入中從開頭起的連續內容,緩存匹配的是完全相同的前綴,而不是意思相近的內容 |
| 可見輸入 Token | 計入緩存門檻的輸入 Token,GPT-5.6 及以後模型要求至少 1024 個纔可使用緩存 |
| 緩存寫入 | 首次把前綴存入緩存時的計費,按普通輸入價格的倍數計價,是一個總寫入費率 |
| 緩存讀取 | 後續請求命中緩存時的計費,價格遠低於普通輸入 |
| 30 分鐘 / 12 小時緩存 | 兩種緩存有效時間檔位,默認 30 分鐘;12 小時檔在 Responses API 中提供,寫入更貴 |
| Standard 處理檔 | 官方價格表中的標準處理檔位,不同處理檔價格不同,不能混用 |
| Short context 檔 | 官方價格表按上下文長度區分檔位,本文只使用短上下文檔價格 |
OpenAI 提示緩存影響速覽
- API 開發者: 緩存是否省錢取決於複用次數和有效時間內的命中率,而不是“開了就省”。30 分鐘檔只要總使用 2 次(首次寫入加一次命中)即可比不緩存更便宜,12 小時檔寫入成本更高,需要更多複用才能攤平。
- 做 Agent 或長系統提示的團隊: 固定規則、工具說明、長文檔放在前面,變化內容放在後面,前綴才能穩定命中,這是結構設計問題而不是參數問題。
- 批量處理任務的團隊: 把同一前綴的請求集中在緩存有效時間內發送,能顯著提高命中率;任務分散在一整天裏,則需要評估 12 小時檔是否值得。
- 負責成本覈算的人: 緩存隻影響固定前綴那部分輸入費用,輸出、新增材料、工具調用和重試都不在其內,預算表裏不能把緩存節省比例直接套到總賬單上。
OpenAI 提示緩存客觀事實
信息來源與時效說明
本文依據的資料覈查於 2026-11-17,來源爲 OpenAI 持續維護的官方文檔:提示緩存指南 developers.openai.com/api/docs/guides/prompt-caching,以及價格頁 developers.openai.com/api/docs/pricing.md。這些文檔會隨時更新,我們沒有核實相關規則的首次發佈日期,因此本文不是當日新聞,而是對現行規則的整理與測算。
提示緩存的命中規則
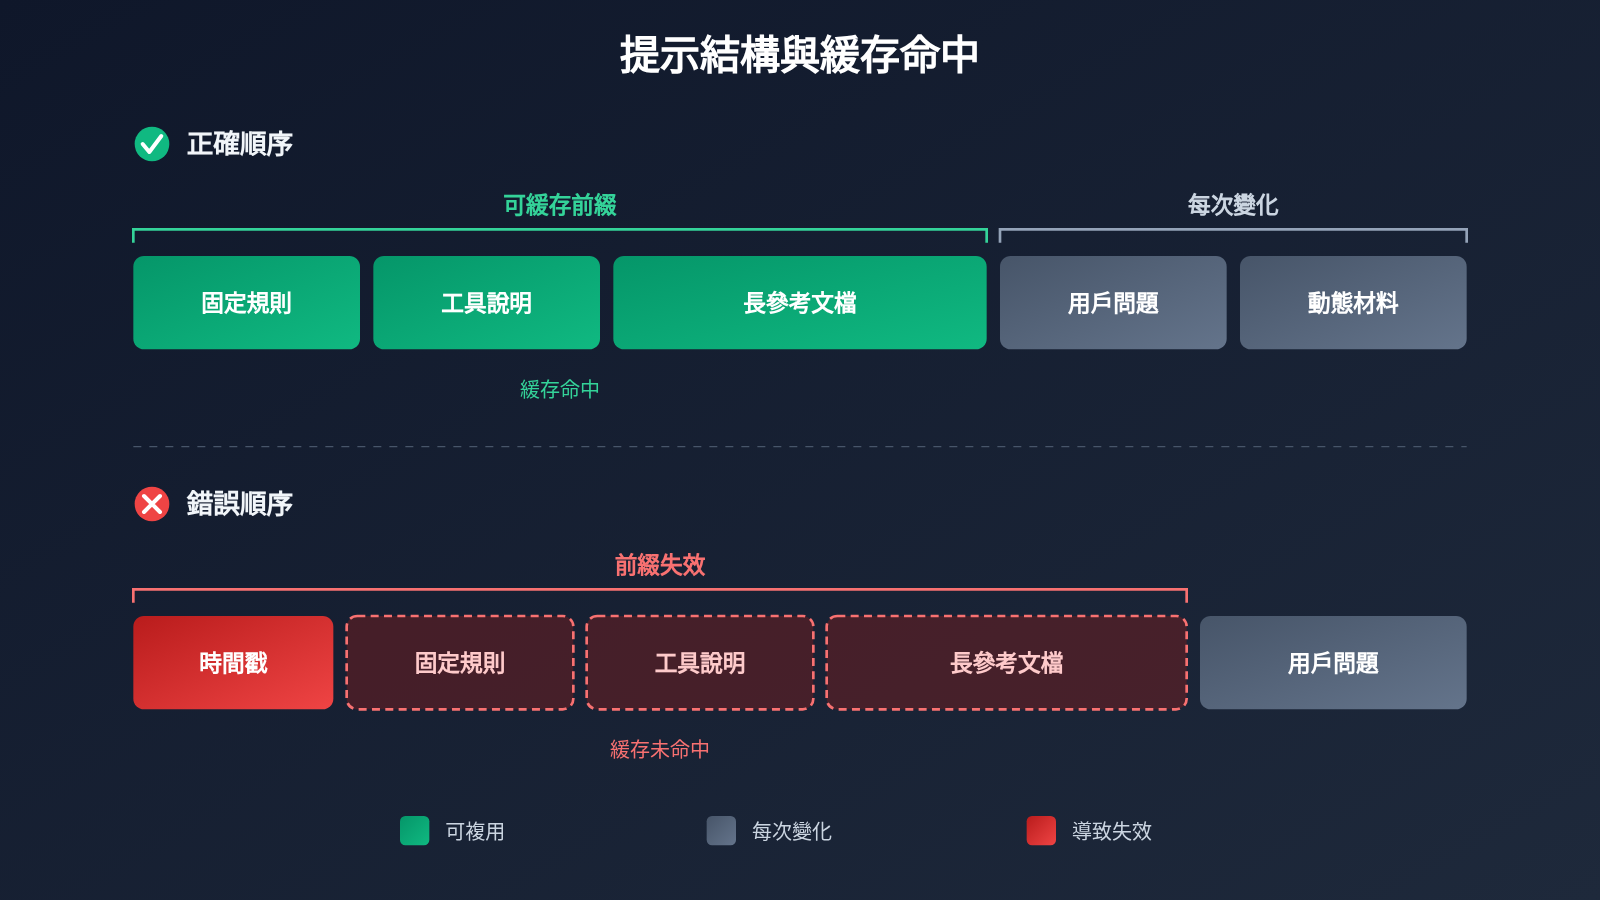
OpenAI 提示緩存的匹配對象是相同的提示前綴。兩段提示即使意思幾乎一樣,只要開頭部分的內容不同,就不會命中,它不是語義相似度檢索。這意味着前綴中任何一個字符的變化,例如在系統提示開頭插入當前時間,都可能讓後續內容全部失去命中機會。
對於 GPT-5.6 及以後的模型,緩存門檻是至少 1024 個可見輸入 Token。舊模型的規則不同,本文的計價與門檻結論只適用於官方文檔中描述的新規則,不能直接套用到舊模型上。
兩種緩存寫入費率
| 緩存檔位 | 寫入費率(相對普通輸入) | 適用說明 |
|---|---|---|
| 30 分鐘(默認) | 1.25 倍 | 默認緩存有效時間 |
| 12 小時 | 2.5 倍 | 在 Responses API 中提供 |
官方文檔明確,這兩個倍數都是總寫入費率,首次寫入時按該費率計費,不再另外疊加一遍普通輸入費。另外需要注意,12 小時指的是緩存有效時間,不是數據刪除期限,兩者不能混爲一談。
gpt-6-luna 官方價格
以下爲 OpenAI 官方價格頁中 gpt-6-luna 在 Standard 處理檔、Short context 檔的價格,單位爲每百萬 Token。這組價格不能套用到長上下文檔或其他處理檔,也不是任何第三方平臺的報價。
| 計費項 | 價格(美元 / 百萬 Token) |
|---|---|
| 普通輸入 | $0.10 |
| 輸出 | $0.50 |
| 讀緩存 | $0.01 |
| 30 分鐘緩存寫入 | $0.125 |
| 12 小時緩存寫入 | $0.25 |
可以看到,30 分鐘寫入價 $0.125 正好是普通輸入的 1.25 倍,12 小時寫入價 $0.25 是 2.5 倍,與文檔中的倍數規則一致。讀緩存只有普通輸入的十分之一。
複用次數算例
以下算例爲按官方價格推導的理論計算,並非實測。假設條件爲:固定前綴 10000 個計費 Token,第一次使用時完整寫入緩存,後續每次都命中,期間沒有重複寫入。
| 總使用次數 | 不使用緩存 | 30 分鐘緩存 | 12 小時緩存 |
|---|---|---|---|
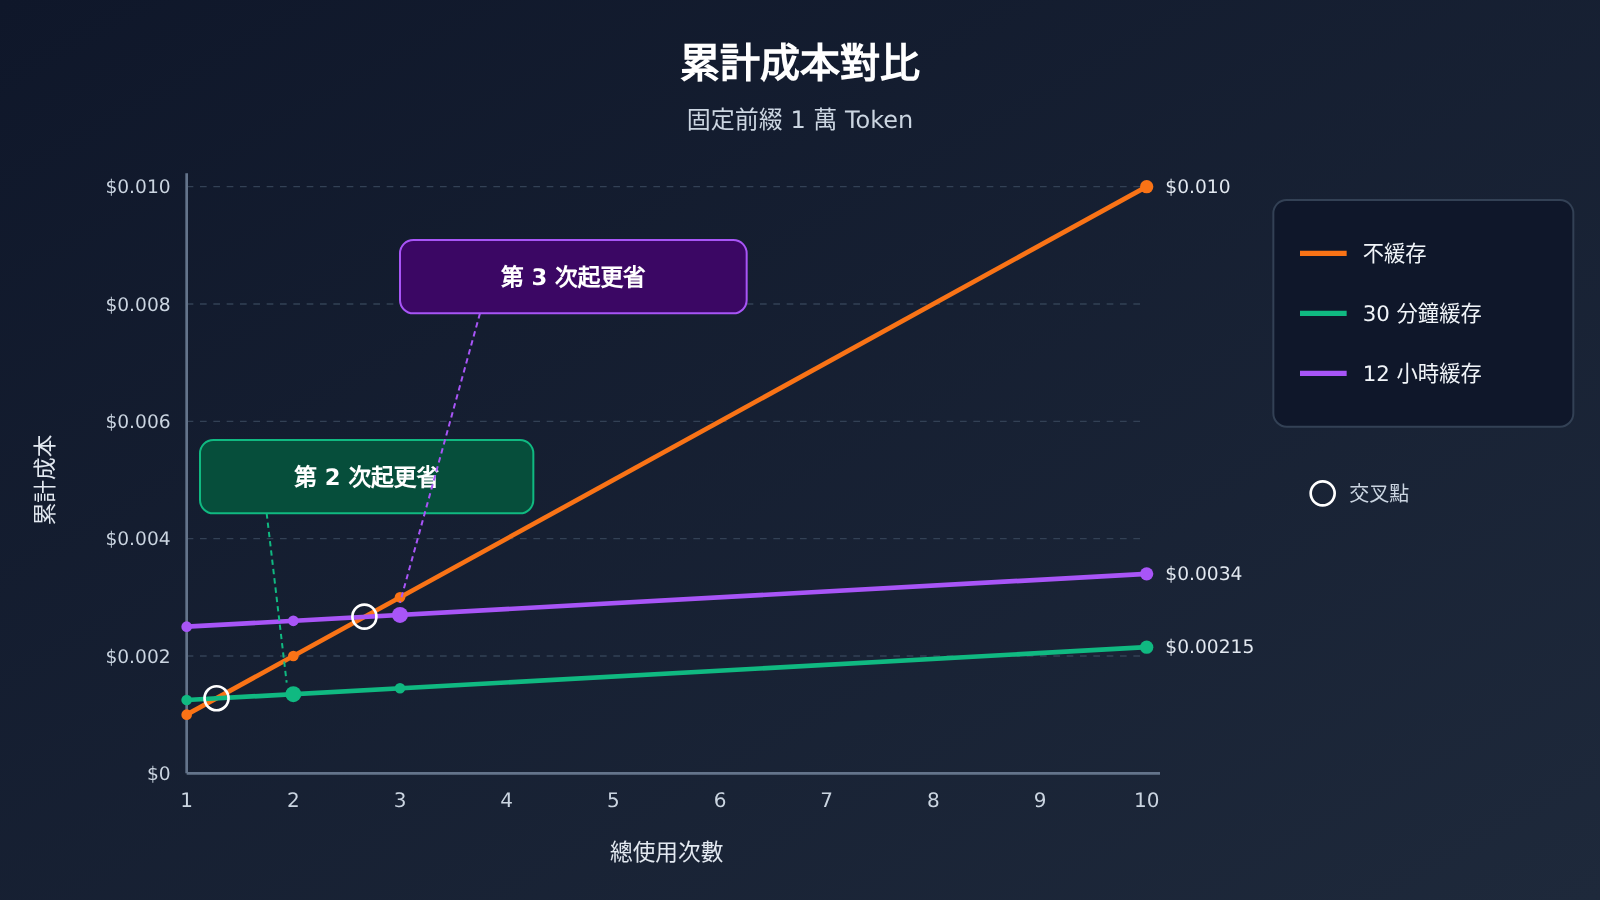
| 1 次 | $0.001 | $0.00125 | $0.0025 |
| 2 次 | $0.002 | $0.00135 | $0.0026 |
| 3 次 | $0.003 | $0.00145 | $0.0027 |
| 10 次 | $0.010 | $0.00215 | $0.0034 |
在這組假設下,30 分鐘緩存從第 2 次總使用開始比不緩存便宜,12 小時緩存從第 3 次開始更便宜。只用 1 次時,兩種緩存都比不緩存更貴,因爲多付了寫入溢價卻沒有享受到讀取折扣。
算例的適用邊界
這組數字只計算了固定前綴部分。每次請求中新增的材料、模型輸出、工具調用以及失敗重試,都不在計算範圍之內,因此它不是整篇請求的折扣。如果兩次使用之間的間隔超過緩存有效時間,後續請求就不能再按“全部命中”計算,需要把重新寫入的費用加回去。
OpenAI 提示緩存分析判斷
回本線爲什麼是 2 次和 3 次
把算例推廣到任意使用次數 N,可以寫出三條成本線(單位爲每百萬前綴 Token 的美元成本):
- 不緩存:0.10 × N
- 30 分鐘緩存:0.125 + 0.01 × (N − 1)
- 12 小時緩存:0.25 + 0.01 × (N − 1)
令緩存成本小於不緩存成本,30 分鐘檔需要 N 大於約 1.28,即第 2 次起划算;12 小時檔需要 N 大於約 2.67,即第 3 次起划算。這個結論與前綴長度無關,因爲三條成本線都與 Token 數成正比,前綴從 2000 Token 換成 50000 Token,回本次數不變,變的只是省下的絕對金額。前提是前綴滿足 1024 Token 門檻,且價格檔位一致。
從結構上看,寫入溢價是一次性成本,每次命中帶來的節省是普通輸入價與讀緩存價之差,即每百萬 Token 節省 $0.09。30 分鐘檔的溢價只有 $0.025,一次命中就能覆蓋;12 小時檔的溢價是 $0.15,需要兩次命中才能覆蓋。這就是兩條回本線差一次的原因。
一個可複用的回本計算腳本
下面的腳本按本文的假設復現算例,你可以替換價格和使用次數,快速判斷自己的場景。價格參數請以官方價格頁的最新數值爲準。
# 按官方 gpt-6-luna Standard / Short context 價格(美元 / 百萬 Token)
INPUT = 0.10
CACHE_READ = 0.01
WRITE = {"30min": 0.125, "12h": 0.25}

def prefix_cost(prefix_tokens: int, uses: int, mode: str | None) -> float:
    """只計算固定前綴成本;假設首次完整寫入、後續全部命中、無重複寫入"""
    m = prefix_tokens / 1_000_000
    if mode is None:
        return INPUT * uses * m
    return (WRITE[mode] + CACHE_READ * (uses - 1)) * m

for n in (1, 2, 3, 10):
    base = prefix_cost(10_000, n, None)
    c30 = prefix_cost(10_000, n, "30min")
    c12 = prefix_cost(10_000, n, "12h")
    print(f"{n:>2} 次  不緩存 ${base:.5f}  30分鐘 ${c30:.5f}  12小時 ${c12:.5f}")
運行結果與上文算例表一致。如果你的實際情況是部分請求未命中,可以把未命中的次數按“重新寫入”處理,回本線會相應後移。
提示結構比開關更重要
由於緩存只認完全相同的前綴,提示的排列順序直接決定命中率。較穩妥的做法是把固定的系統規則、角色設定、工具定義和參考文檔放在最前面,把用戶問題、檢索結果、時間戳等每次都會變化的材料放在最後。任何會變化的字段一旦混進前綴開頭,後面再長的固定內容也無法複用。
還有一個常見誤區值得單獨指出:爲了湊夠 1024 Token 門檻而往提示裏填充無關內容並不划算。填充的 Token 首次要按寫入價付費,之後每次也要按讀緩存價付費,而且可能干擾模型對真正指令的理解。門檻的意義在於說明短提示本來就不需要緩存,而不是鼓勵把短提示變長。
批次安排決定能否“全部命中”
算例的另一個關鍵假設是後續請求全部命中。現實中,如果同一前綴的請求零散分佈在一天裏,30 分鐘檔很可能在兩次請求之間過期,每次都重新寫入,反而比不緩存更貴。這時有兩種思路:一是把同類任務集中成批次,在 30 分鐘內連續發送;二是評估 12 小時檔,用更高的一次性寫入換取更長的有效期。
可以把選擇簡化爲一個經驗判斷:請求密集、間隔短,用默認 30 分鐘檔,總使用 2 次即可比不緩存更便宜;請求稀疏但同一天內會反覆使用同一前綴,且總使用次數能穩定達到 3 次以上,12 小時檔纔有意義。如果一段前綴在有效期內大概率只用 1 次,不緩存反而是最便宜的選擇。
成本覈算中容易被高估的部分
10 次使用節省約 78.5% 的數字很醒目,但它針對的只是固定前綴的輸入費用。在 gpt-6-luna 的價格結構裏,輸出價是普通輸入的 5 倍,如果一個應用的輸出很長,或者每次請求都附帶大量新檢索材料,前綴緩存省下的錢在總賬單中的佔比可能並不高。做預算時更合理的做法是把請求拆成“固定前綴”“動態輸入”“輸出”“工具與重試”幾塊分別估算,只對第一塊套用緩存公式。
此外,本文所述寫入倍數規則針對 GPT-5.6 及以後模型;算例中的具體價格僅對應 gpt-6-luna 的 Standard 處理檔、Short context 檔。換用舊模型、長上下文檔或其他處理檔時,需要重新查價重新算,回本次數也可能隨之改變。官方文檔持續維護,後續規則如有調整,結論應以屆時的文檔爲準,這一點屬於需要持續關注的變量,而不是已經發生的變化。
荀子在《勸學》中寫道:“積土成山,風雨興焉;積水成淵,蛟龍生焉。”提示緩存的賬也是如此,一次寫入只是付出,真正的節省來自有效期內一次又一次的穩定複用。


