
作者注:拆解 Kimi K3.1 Pro 的 2.8T 參數、104B 激活、MXFP4 量化與 1M 上下文,估算權重體積和硬件門檻,對比 $2/$10 API 價格,給出“自部署還是 API”的決策表與檢查清單。
先說結論:Kimi K3.1 Pro 是一個 2.8T 總參數的 MoE 模型,單臺機器跑不起來。按 MXFP4 估算,光是權重就在 TB 級,常見的單節點 8 卡服務器放不下,至少需要多卡跨節點部署,還要給 1M 上下文的 KV Cache 留出顯存。開放權重解決的是“能不能拿到模型”,並沒有降低“能不能跑好模型”的門檻。
所以對絕大多數技術團隊來說,先按 $2/$10 的價格調 API 更現實。只有調用量大且穩定、數據必須留在自己機房、團隊本身有 GPU 集羣運維能力,這三個條件同時滿足時,自部署才值得認真算賬。這篇文章不復讀跑分,先算權重和硬件的賬,再算利用率和運維的賬,最後按團隊類型給出推薦。如果只是想先驗證效果,可以用 API易 apiyi.com 這類聚合平臺的一個 Key 接入,再決定後續路線。
Kimi K3.1 Pro 規格:2.8T 參數與 1M 上下文意味着什麼
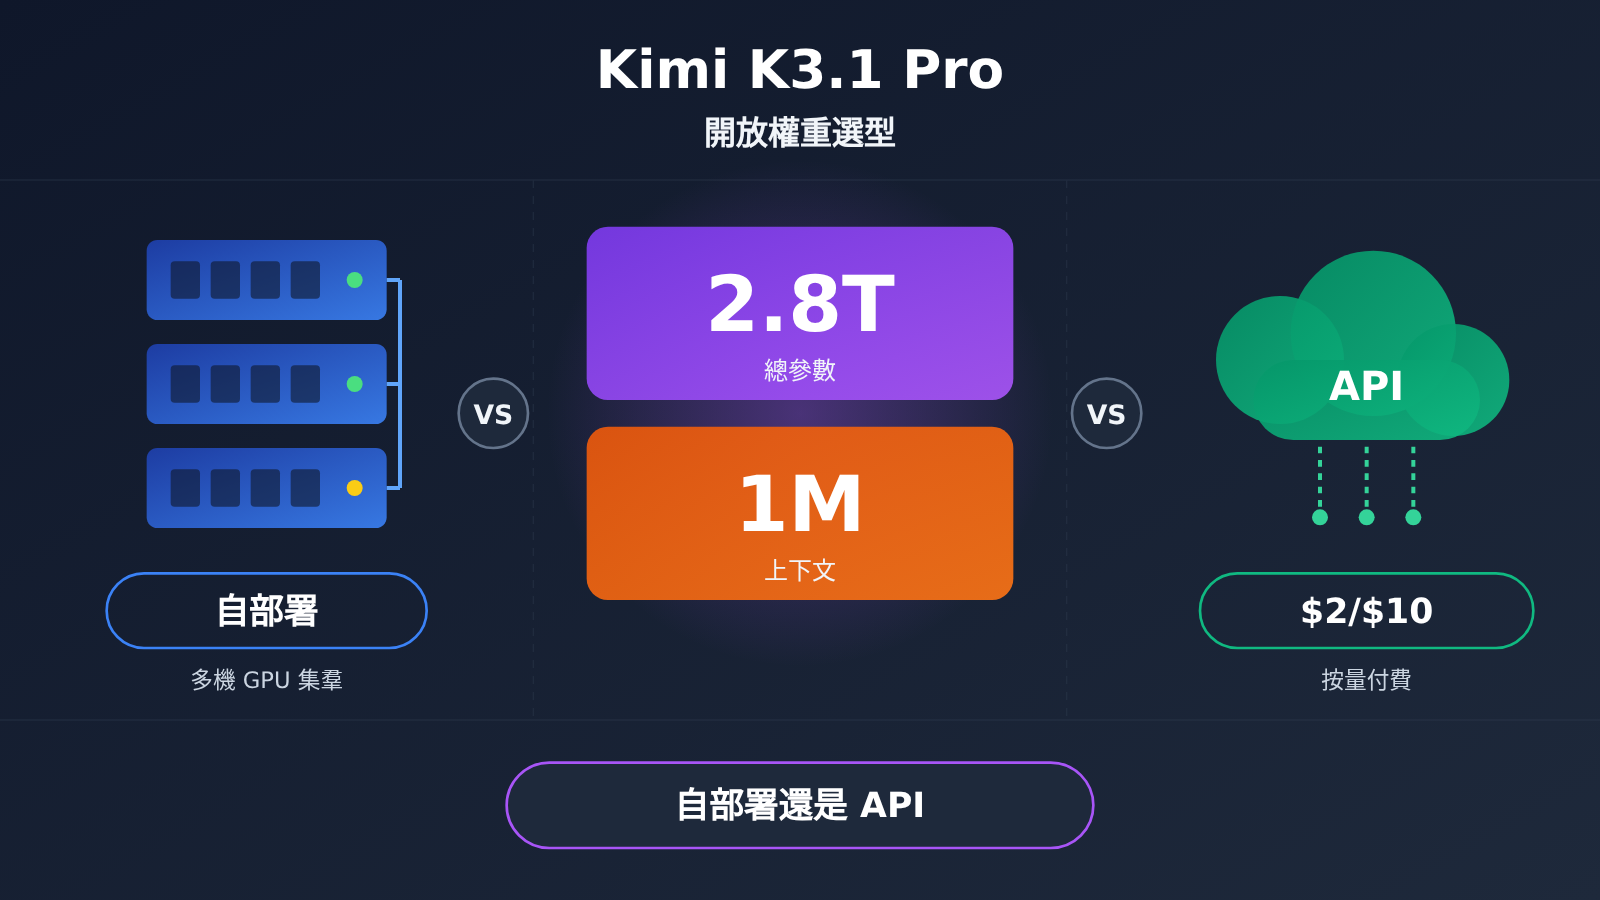
Kimi K3.1 Pro 是 K3.1 系列的首個模型,也是開放權重發布。它採用 MoE(混合專家)架構,總參數 2.8T,每個 token 實際激活約 104B 參數。可以這樣理解:存儲成本按 2.8T 算,計算成本更接近 104B 級別的稠密模型。這也是 MoE 自部署的典型矛盾,算力需求沒那麼誇張,顯存需求卻很難壓下來。
另一個關鍵點是量化感知訓練(QAT)。官方採用 MXFP4 權重加 MXFP8 激活的組合,並在訓練階段就考慮了量化。這意味着低精度運行是模型的“原生形態”,而不是事後壓縮出來的版本,理論上精度損失更可控。不過這也對推理硬件和推理引擎提出了要求,需要能高效支持 MX 系列微縮放格式。
| 規格項 | Kimi K3.1 Pro 參數 | 對選型的意義 |
|---|---|---|
| 架構 | MoE,93 層 | 存儲按總參數算,計算按激活參數算 |
| 總參數 | 2.8T | 決定權重體積和顯存下限 |
| 激活參數 | 104B | 決定單 token 計算量 |
| 視覺編碼器 | MoonViT-V2,401M 參數 | 原生多模態,圖像理解無需外掛 |
| 量化方式 | MXFP4 權重 / MXFP8 激活,QAT | 低精度爲原生形態,依賴硬件支持 |
| 上下文 | 1M tokens | 長文檔、大倉庫場景友好,KV Cache 壓力大 |
| 定位場景 | 編程、3D 創作、金融研究、Agent | 偏重複雜任務和長鏈路調用 |
Kimi K3.1 Pro 的 1M 上下文與多模態能力
1M tokens 的上下文窗口足夠一次塞進一箇中型代碼倉庫、整套財報或長篇研究資料,這正是 Agent 和金融研究場景需要的。原生多模態則讓模型可以直接讀圖、讀截圖、讀圖表,配合 3D 創作和編程任務更順手。
但這兩項能力在自部署時都要付出代價。長上下文意味着 KV Cache 隨序列長度線性增長,真正跑滿 1M 時佔用的顯存可能非常可觀。視覺編碼器本身不大,但多模態輸入的預處理和批處理調度會讓推理服務更復雜。走 API 時這些都由服務方承擔,你只按 token 付費。
Kimi K3.1 Pro 權重體積與硬件門檻
Kimi K3.1 Pro 權重體積估算
先聲明:以下體積是按參數量估算,實際文件大小以官方發佈爲準。MXFP4 每個參數約佔 4 bit,也就是 0.5 字節,2.8T 參數折算下來大約 1.4TB。MX 格式還需要額外存儲分塊縮放因子,再加上視覺編碼器、嵌入層等可能保留更高精度的部分,實際文件通常會比純算術值略大一些。
| 精度假設 | 每參數字節數 | 2.8T 權重估算體積 | 說明 |
|---|---|---|---|
| MXFP4 | 約 0.5 字節 | 約 1.4TB | 官方主推形態,未含縮放因子開銷 |
| 8 bit 級 | 約 1 字節 | 約 2.8TB | 僅作對照,非官方推薦 |
| BF16 | 2 字節 | 約 5.6TB | 僅作對照,說明 QAT 的意義 |
這張表的意義在於:即使在最省的 MXFP4 下,權重也已經是 TB 級。下載、校驗、分發到多臺機器本身就是一項工程,存儲和內網帶寬都要提前規劃。
Kimi K3.1 Pro 自部署硬件門檻
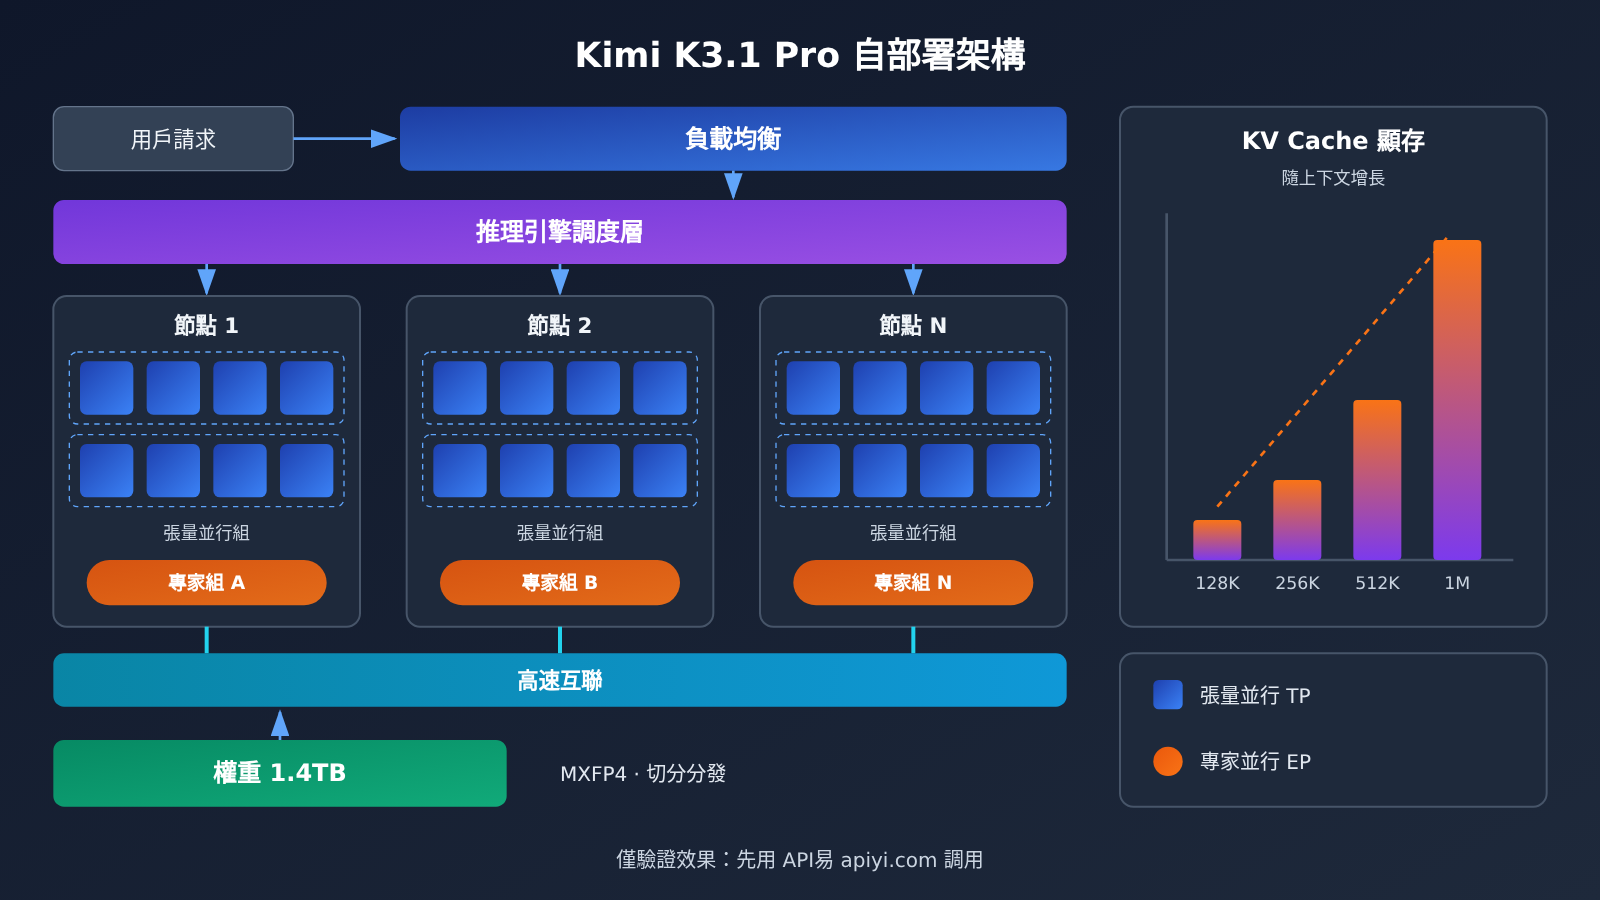
按 1.4TB 粗算,如果用 80GB 顯存級別的加速卡,光裝下權重就需要接近 18 張卡,這還沒算 KV Cache、激活值和推理引擎的運行開銷。一臺常規的 8 卡服務器顯然不夠,即使換成單卡顯存更大的新一代卡,單節點也只能勉強裝下權重,很難留出長上下文需要的餘量。因此現實方案基本是多卡、多機,通過張量並行、專家並行、流水線並行組合切分模型。
硬件之外,還有幾類容易被低估的成本:
- 推理引擎與並行策略:需要支持 MoE 專家並行和 MX 格式的推理框架,具體推薦引擎、並行配置以官方部署文檔爲準。
- 節點間互聯:專家並行會產生大量跨節點通信,網絡帶寬和延遲直接影響吞吐。
- 機房與電力:多機 GPU 集羣的供電、散熱、機櫃空間都要提前落實。
- 峯值容量:業務高峯需要額外冗餘,低谷時這部分算力就是閒置成本。
- 運維人力:模型升級、故障排查、監控告警,都需要懂 GPU 集羣的工程師長期投入。
需要強調的是,參考資料中沒有官方的實測吞吐和成本數據,本文也不給出確定的自建報價。真要立項,請以官方部署文檔和你自己的壓測結果爲準。
Kimi K3.1 Pro 許可證:開放權重不等於隨便商用
“開放權重”和“開源可隨意商用”是兩回事,這一點在選型階段一定要先覈對。很多開放權重模型的許可證會對商用設置條件,比如收入或用戶規模門檻、在產品中標註來源的通知義務等。Kimi K3.1 Pro 的具體商用條件、收入門檻和通知義務,一律以官方許可證原文爲準。
除了直接商用,還有幾類行爲可能有額外要求:
- 分發:把權重或其衍生版本提供給第三方。
- 修改:微調、蒸餾、合併後的模型如何適用許可證。
- 託管服務:把自部署的模型包裝成 API 對外提供,往往是許可證重點約束的場景。
建議法務和技術負責人一起逐條過一遍許可證,形成書面結論後再採購硬件。走官方 API 或第三方平臺調用時,主要遵循的是服務條款,一般不涉及權重分發問題,但同樣要確認數據和使用範圍是否合規。
Kimi K3.1 Pro API 價格:$2/$10 怎麼算
官方 API 的模型 ID 爲 kimi-k3.1-pro,提供 OpenAI 和 Anthropic 兼容接口,現有項目改動成本很低。價格按每百萬 tokens 計:
| 計費項 | 標準版 kimi-k3.1-pro |
Highspeed 版 | 說明 |
|---|---|---|---|
| 輸入 | $2 |
$4 |
每百萬 tokens |
| 輸出 | $10 |
$20 |
每百萬 tokens |
| 緩存命中 | $0.20 |
以官方爲準 | 重複前綴可大幅降本 |
| 緩存寫入 | $2 |
以官方爲準 | 與標準輸入同價 |
| 速度 | 基準 | 約 3 倍 | 延遲敏感場景可選 |
用一個算術示例幫助理解(非實測,僅爲價格換算):假設每月 1 億輸入 tokens、2,000 萬輸出 tokens,標準版費用約爲 100 × $2 + 20 × $10 = $400。如果其中 70% 的輸入命中緩存,輸入部分變爲 70 × $0.20 + 30 × $2 = $74,總費用降到約 $274。換成 Highspeed 版,同樣用量不計緩存約爲 $800。
這個量級很能說明問題:即使每月調用上億 tokens,API 賬單也遠低於一個多機 GPU 集羣的月度折舊加電費加人力。Agent 場景裏系統提示詞和工具定義往往高度重複,用好緩存命中價是 API 路線最直接的降本手段。
接入方式上,只要客戶端支持 OpenAI 兼容協議,把 base_url 換成 https://api.apiyi.com/v1、模型名填入平臺提供的模型 ID 即可,不需要額外寫適配層。
🚀 快速開始:如果團隊要同時比較 Kimi、Claude、GPT、Gemini 在同一任務上的表現,可以通過 API易 apiyi.com 用一個 API Key 統一調用,在控制檯查看模型列表、用量和日誌。
kimi-k3.1-pro是否已上架、具體價格多少,請以控制檯實時信息爲準。
Kimi K3.1 Pro 自部署 vs API 核心差異
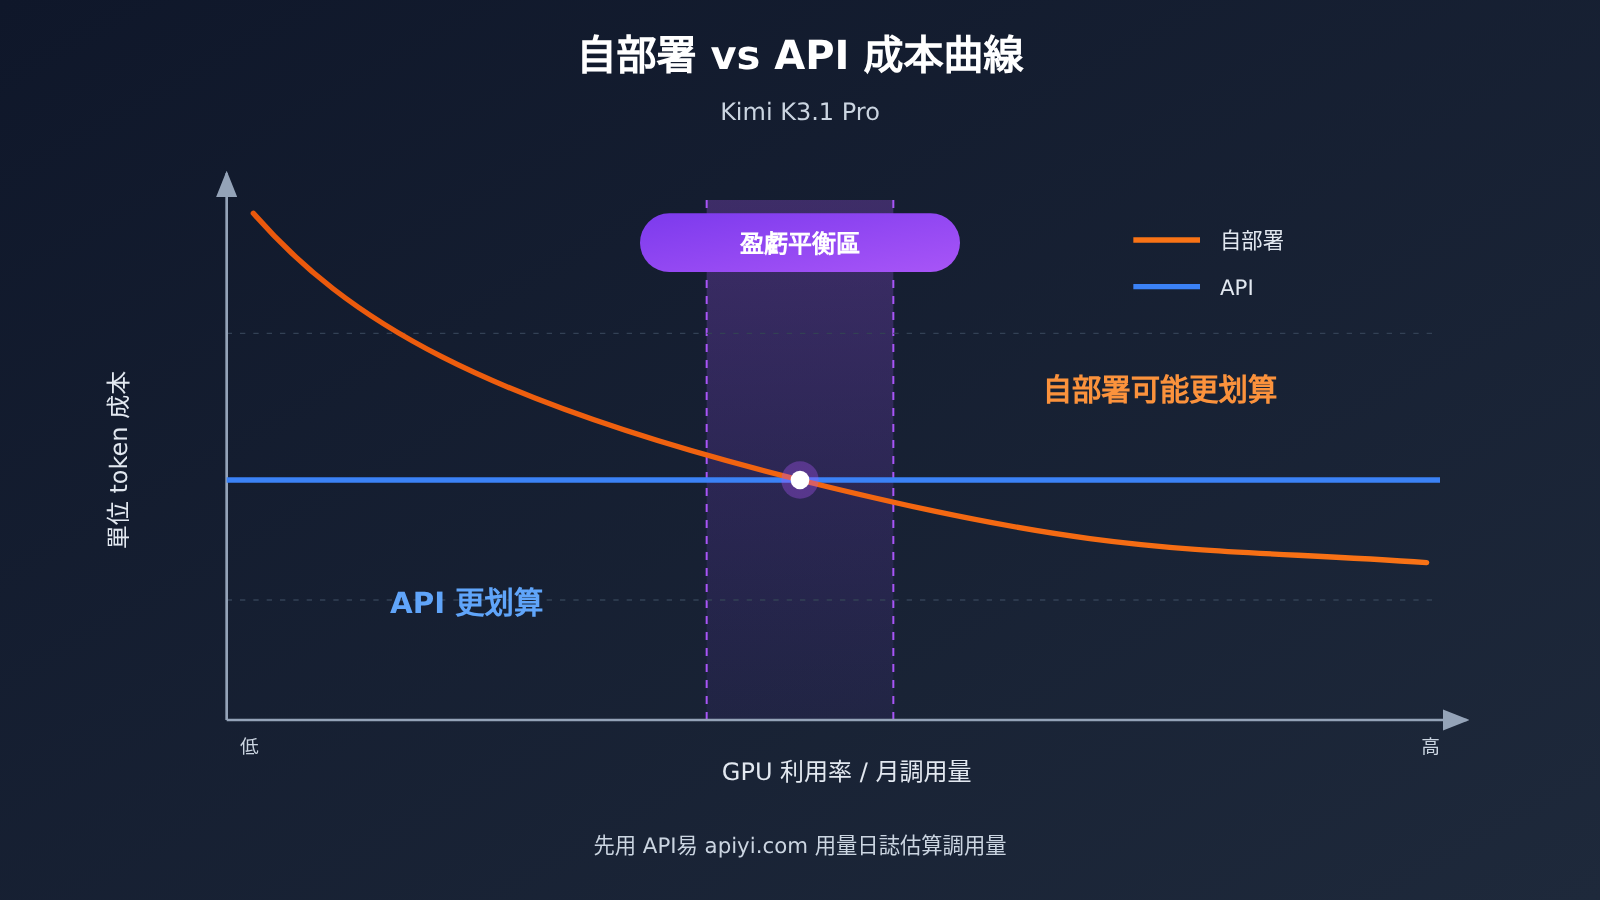
自部署和 API 的本質區別是成本結構。API 是純變動成本,用多少付多少,不用不花錢。自部署是高固定成本加低邊際成本,硬件、機房、人力一旦投入,不管跑不跑滿都在花錢。所以決定性的變量是利用率:只有集羣長期保持高負載,攤薄後的單位 token 成本纔可能低於 API 價格。
| 決策維度 | 自部署 Kimi K3.1 Pro | 調用 API | 傾向 |
|---|---|---|---|
| 利用率 | 需長期高負載才能攤薄成本 | 按量付費,無閒置浪費 | 低中頻選 API |
| 數據合規 | 數據可完全不出域 | 數據需發送至服務方 | 強監管選自部署 |
| 前期投入 | 多機 GPU、機房、網絡,投入大 | 幾乎爲零 | API |
| 運維成本 | 需專職 GPU 集羣運維 | 服務方承擔 | API |
| 峯值彈性 | 需預留冗餘,擴容慢 | 彈性較好,受限流約束 | API |
| 定製能力 | 可微調、改推理配置 | 受接口參數限制 | 深度定製選自部署 |
| 上線速度 | 周到月級 | 小時級 | API |
| 接入渠道 | 自建推理服務 | 官方 API、API易 apiyi.com 等平臺 | 視需求 |
API 對標分析:API 在上線速度、彈性和總擁有成本上保持領先,但數據需要出域,接口可調參數有限。相比之下,自部署在數據控制和深度定製上更有優勢,更適合強監管且調用量巨大的團隊。
自部署對標分析:自部署在單位成本上限和可控性上有潛力,但前期投入、運維人力和閒置風險都很高。對於調用量波動、缺少 GPU 團隊的場景,API 仍然是更穩妥的選擇。
Kimi K3.1 Pro 場景推薦與決策建議
適合調用 Kimi K3.1 Pro API 的團隊
- 初創與中小團隊:沒有 GPU 集羣,也沒有專職運維,API 是唯一合理選項。
- 調用量波動大的業務:白天高峯、夜間低谷,或者活動期突增,按量付費能避免閒置。
- 需要快速上線的項目:產品驗證期最重要的是速度,幾小時就能完成接入。
- 多模型並行評估:同一任務要和其他模型對比,統一接口比分別部署省事得多。
適合自部署 Kimi K3.1 Pro 的團隊
- 數據不能出域:金融、醫療、政企等場景,合規要求數據完全留在內網。
- 高頻穩定調用:7×24 小時持續高負載,利用率能長期保持在高位。
- 已有 GPU 集羣與運維團隊:邊際投入可控,能把模型納入現有基礎設施。
- 深度定製需求:需要基於開放權重做微調或特殊推理優化,前提是許可證允許。
混合路線
還有一種常被忽視的做法:打樣用 API,生產再評估自建,或者反過來,核心敏感數據走自部署,通用流量走 API。前者能用真實調用數據替代拍腦袋估算,後者能兼顧合規與彈性。
💡 選擇建議:在投入硬件之前,建議先通過 API易 apiyi.com 跑一段時間真實業務流量,用控制檯的用量日誌統計每日 tokens 數、峯谷比和緩存命中率。這組數據就是判斷自部署是否划算的最可靠依據。
常見問題 FAQ
Q1:Kimi K3.1 Pro 能在單臺服務器上自部署嗎?
按 MXFP4 估算權重約 1.4TB,常規 8 卡服務器放不下,即使單卡顯存更大的節點也很難給 1M 上下文的 KV Cache 留出餘量。現實做法是多卡多機部署,具體配置以官方部署文檔爲準。
Q2:104B 激活參數是不是意味着硬件需求只按 104B 算?
不是。激活參數決定每個 token 的計算量,但所有專家的權重都要常駐顯存,顯存需求仍然按 2.8T 總參數計算。這正是 MoE 模型“算得快、裝得多”的特點。
Q3:開放權重後可以直接商用嗎?
不一定。開放權重不等於無條件商用,收入門檻、通知義務、託管服務限制等都要以官方許可證原文爲準,建議在採購硬件前由法務確認。
Q4:如何低成本試用 Kimi K3.1 Pro 的 API?
可以在 API易 apiyi.com 註冊,用新用戶免費測試額度,通過 OpenAI 兼容接口接入現有項目。平臺一個 Key 可調用 Kimi 系列及 Claude、GPT、Gemini 等模型,`kimi-k3.1-pro` 是否上架和價格以控制檯爲準。
Q5:標準版和 Highspeed 版怎麼選?
Highspeed 價格爲 `$4/$20`,是標準版的 2 倍,速度約 3 倍。面向用戶的實時交互、對首字延遲敏感的 Agent 適合 Highspeed,離線批處理和後臺任務用標準版加緩存更省錢。
總結:Kimi K3.1 Pro 自部署 vs API 檢查清單
Kimi K3.1 Pro 開放權重是一件好事,它讓有條件的團隊擁有了完全可控的選項。但 2.8T 參數決定了它屬於“集羣級”模型,自部署的門檻主要不在能否下載權重,而在硬件、利用率、運維和許可證四本賬。對大多數團隊來說,先用 $2/$10 的 API 把業務跑起來,再用真實數據評估是否自建,是風險最低的路徑。
Kimi K3.1 Pro 核心要點 Key Takeaways
- 規格:2.8T 總參、104B 激活、93 層 MoE,原生多模態,1M 上下文。
- 權重:MXFP4 下估算約 1.4TB,實際以官方文件爲準,單機放不下。
- 硬件:需多卡多機並行部署,還要爲長上下文 KV Cache 預留顯存。
- 許可證:開放權重不等於隨便商用,條件以官方許可證爲準。
- 價格:標準版
$2/$10,緩存命中$0.20,Highspeed$4/$20。 - 決策:利用率是關鍵變量,低中頻、波動大的業務優先選 API。
自部署 vs API 檢查清單
| 檢查項 | 選 API 的信號 | 選自部署的信號 |
|---|---|---|
| 調用量 | 月調用量不大或波動明顯 | 長期 7×24 高負載 |
| 數據合規 | 數據可發送至服務方 | 數據必須留在內網 |
| GPU 能力 | 無集羣、無專職運維 | 已有多機集羣與運維團隊 |
| 許可證 | 不想處理分發與託管條款 | 法務已確認商用條件 |
| 上線時間 | 需要儘快上線驗證 | 可接受周到月級部署週期 |
| 成本數據 | 尚無真實調用統計 | 已用真實數據算過盈虧平衡 |
如果清單裏大多數項落在左列,直接走 API 即可。推薦通過 API易 apiyi.com 用一個 Key 接入 Kimi 系列和其他主流模型,藉助控制檯的用量日誌積累真實數據,等調用量和合規需求真正到位時,再拿着這份數據去評估自部署。
作者:APIYI 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多接入說明可訪問 docs.apiyi.com 文檔中心


