
Nota do autor: este artigo lê separadamente os resultados auto-reportados oficialmente pelo GPT-6.2 Astra e os dados independentes da Artificial Analysis, e julga — em quatro frentes de tarefas (entrega profissional, ciência, código e 3D, segurança cibernética) — se vale a pena deixar o modelo assumir seus trabalhos mais difíceis.
A OpenAI lançou oficialmente, em 17 de novembro de 2026, o GPT-6.2 Astra e o GPT-6.2 Sol. Segundo a publicação oficial, os modelos são “ultraeficientes e feitos para tarefas do mundo real”. O texto de lançamento, o system card e as páginas de API dos dois modelos foram ao ar simultaneamente, e a Artificial Analysis publicou no mesmo dia seu artigo de avaliação independente — ou seja, os limites de capacidade do GPT-6.2 Astra podem ser conferidos de forma cruzada em várias fontes.
Este não é um texto promocional do tipo “primeiro lugar em tudo”. No índice agregado da Artificial Analysis, o GPT-6.2 Astra não é o primeiro colocado. A pontuação dele ainda varia bastante conforme o nível de raciocínio escolhido. E, em segurança cibernética, ele chega a recusar parte das solicitações legítimas justamente por ter proteções mais rígidas. Neste artigo, os números oficiais auto-reportados e os de terceiros são apresentados separadamente, sem fundir as duas fontes de dados numa conclusão única.
Valor central: ao terminar a leitura, você conseguirá avaliar quais evidências existem para o GPT-6.2 Astra em cada uma das quatro frentes — entrega de documentos profissionais, tarefas de terminal científico, código e 3D, segurança cibernética — e entender por que uma pontuação agregada não substitui o julgamento item por item.
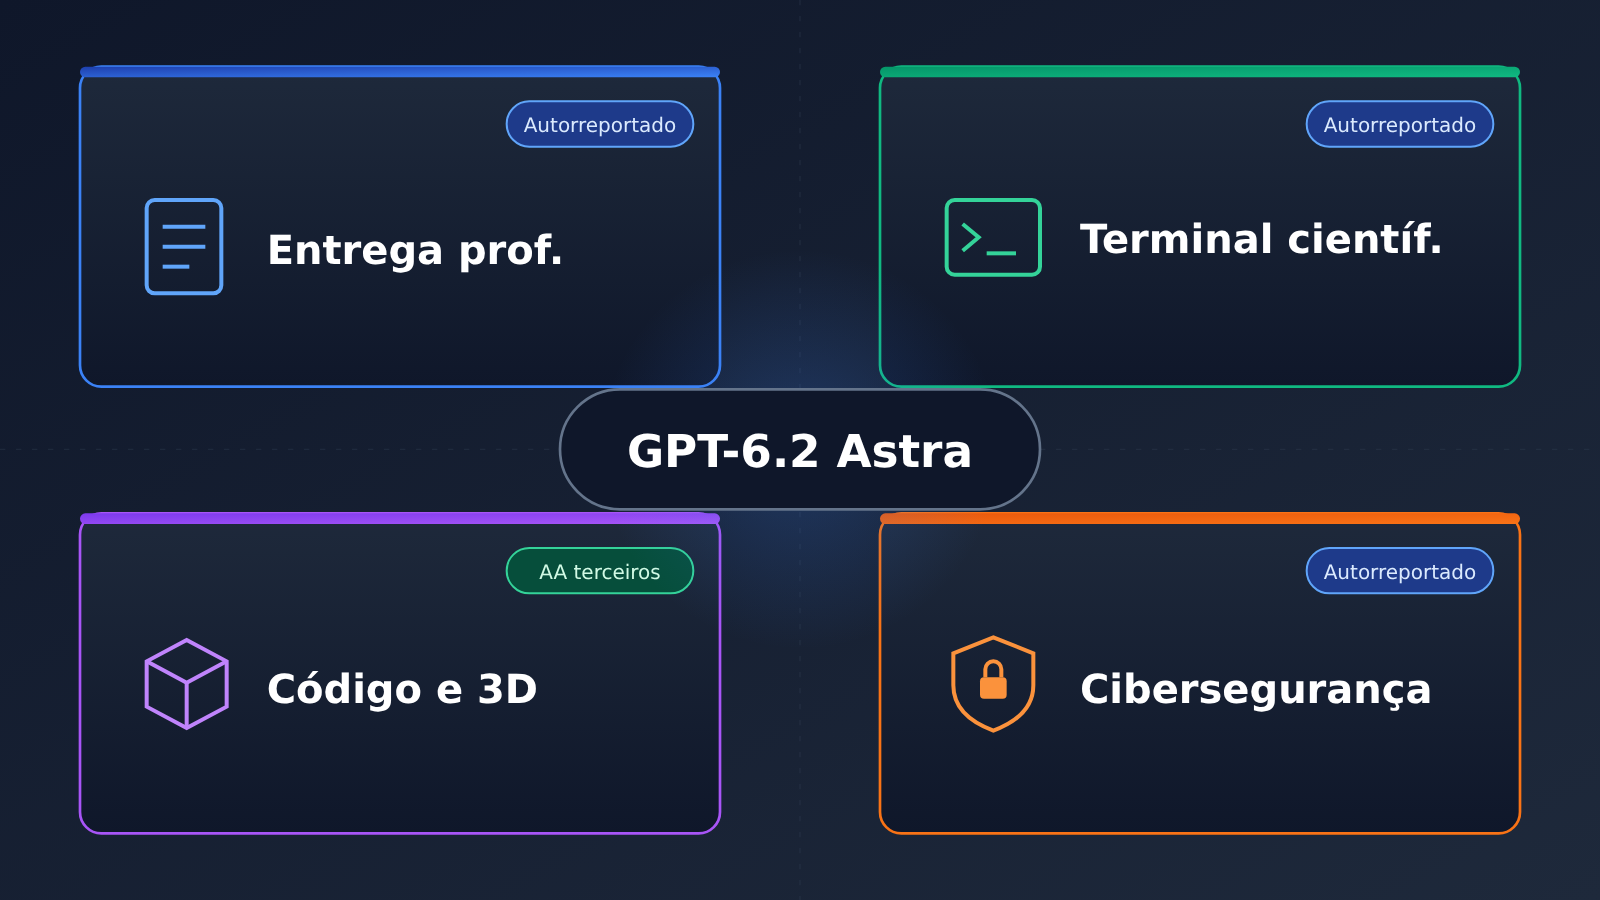
Pontos-chave do GPT-6.2 Astra
Começamos com uma tabela de leitura rápida. Cada linha indica a fonte dos dados — ao ler, leve a origem em consideração.
| Ponto | Descrição | Fonte dos dados | O que significa para você |
|---|---|---|---|
| Entrega profissional | Fluxos de trabalho profissionais de longa duração, tarefas jurídicas e GDPval v2 mostram avanços em relação ao GPT-6 Astra, com custo menor | Auto-relato oficial | Tarefas de entrega baseadas em documentos e em múltiplas etapas merecem um teste prioritário |
| Terminal científico | Terminal-Bench-Science 0.1 fica 9 pontos percentuais acima do GPT-6 Astra | Auto-relato oficial; a AA também o aponta como líder | Cenários que exigem executar fluxos científicos no terminal têm respaldo de evidências |
| Código e 3D | O índice de agentes de codificação fica empatado com o GPT-6 Astra, e o Elo às cegas do AA-3D é 1318 | Terceira parte (AA) / relato oficial | No código não houve um salto, mas a geração 3D tem pontos de destaque |
| Pontuação geral varia conforme o nível de inferência | Max e Xhigh 62, High 60, Medium 57, Low 46 | Terceira parte (AA) | Ao reduzir o nível para economizar, a pontuação também cai |
| Segurança cibernética | Classificado no nível “crítico” da estrutura de preparação; parte das pesquisas legítimas de vulnerabilidades pode ser recusada; o Daybreak ainda não foi integrado à versão 6.2 | Cartão do sistema oficial e nota de lançamento | Equipes de pesquisa em segurança devem prever alternativas |
O que considerar antes de ler sobre o GPT-6.2 Astra
A maioria dos resultados no comunicado oficial são valores relativos, como “5,2 pontos acima do GPT-6 Astra” ou “custo inferior a um terço” — muitos itens não apresentam pontuação absoluta. Quando este artigo se depara com esses casos, apenas reproduz a relação relativa, sem inventar números.
A Artificial Analysis (daqui em diante, apenas AA) é uma terceira parte independente. Seu índice geral usa outro conjunto de tarefas, e as pontuações também estão vinculadas ao nível de inferência. Quando a parte oficial afirma que certo item “custa cerca de 5% do concorrente”, o custo por tarefa na página da AA segue outro critério — os dois números não podem ser divididos ou convertidos diretamente entre si.
Funções centrais do GPT-6.2 Astra: as quatro categorias de tarefas analisadas separadamente
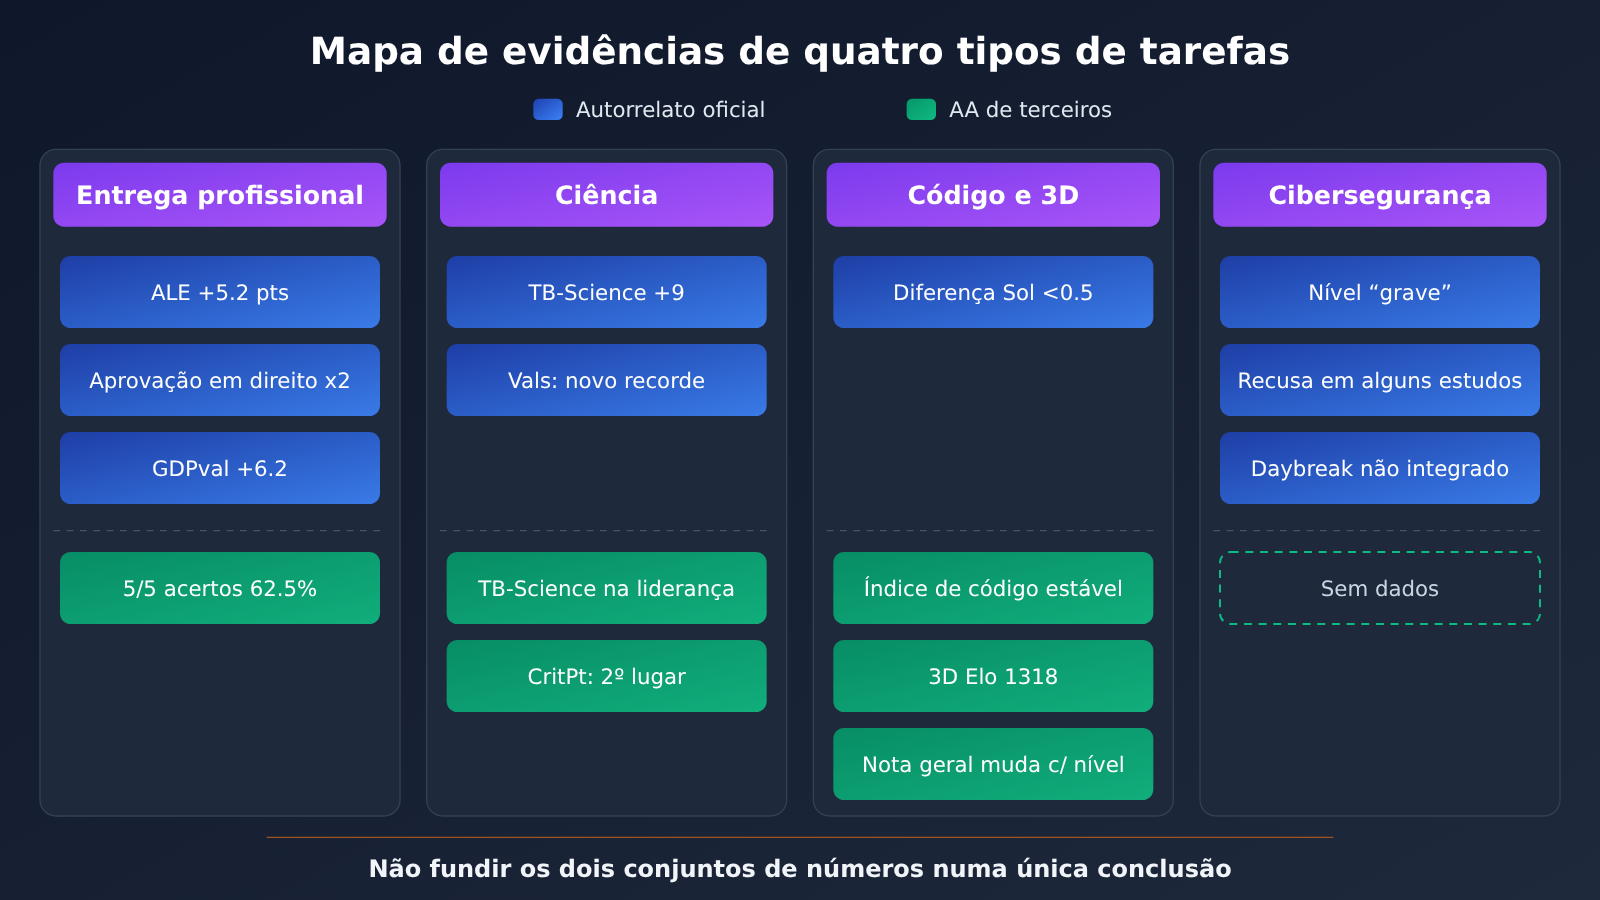
Capacidade de entrega profissional do GPT-6.2 Astra (dados principalmente auto-relatados oficialmente)
A entrega profissional é a área que mais recebe destaque nas informações oficiais. No Agents’ Last Exam, uma avaliação de fluxos de trabalho profissionais de longa duração, os dados oficiais indicam que o GPT-6.2 Astra supera o GPT-6 Astra em 5,2 pontos, com custo de menos de um terço em relação a este último. Na mesma avaliação, ele supera o Claude Fable 5.2 em 5,5 pontos, com custo de cerca de 5% do concorrente. Uma nota de rodapé esclarece que o resultado do Fable 5.2 no ranking não inclui as nove tarefas em que ele usou um modelo reserva — ao citar essa comparação, é importante levar essa ressalva em conta.
Os dados de cenários jurídicos vêm do Harvey LAB-AA v1.1. Segundo o anúncio oficial, a taxa de aprovação do GPT-6.2 Astra é mais que o dobro da do Claude Fable 5.2, com custo de cerca de um sexto deste último — e a configuração “Astra for Law”, voltada para advogados, deve alcançar números ainda mais altos. Como o texto de lançamento não traz a taxa de aprovação absoluta, aqui só é possível confirmar a vantagem relativa, e não o grau de confiabilidade absoluta do modelo em tarefas jurídicas.
No GDPval v2, uma avaliação interna oficial, o GPT-6.2 Astra fica 6,2 pontos percentuais acima do GPT-6 Astra, usando ainda 22% menos tokens de saída. As informações oficiais também citam os resultados do AA-AnalystAgent: o GPT-6.2 Astra acertou 62,5% das questões em todas as cinco tentativas independentes. Essa métrica mede estabilidade, e não apenas a taxa de acerto em uma única tentativa — o que a torna mais relevante para entregas analíticas que exigem resultados reproduzíveis.
Capacidades do GPT-6.2 Astra em tarefas científicas (auto-relato oficial + terceiros via AA)
Na direção científica, há duas fontes que se corroboram mutuamente. No auto-relato oficial, o GPT-6.2 Astra fica 9 pontos percentuais acima do GPT-6 Astra no Terminal-Bench-Science 0.1, com menos de um terço do custo. No Vals Science Index, o relato oficial afirma que ele bateu um novo recorde, mas não divulgou a pontuação absoluta.
Do lado dos terceiros, o artigo da AA também deixa claro que o GPT-6.2 Astra lidera no Terminal-Bench-Science 0.1. No subconjunto difícil do CritPt v2, ele fica atrás apenas do Claude Fable 5.2. Ou seja, a área científica não é uma dominação absoluta: fluxos de trabalho científicos no terminal são o ponto forte dele, mas em problemas difíceis com viés de dedução teórica ainda há adversários mais fortes.
Aqui mora uma armadilha fácil de cair. Em uma nota de rodapé oficial, um dos resultados do Fable 5.2 no Terminal-Bench-Science vem da AA, usando o mini-swe-agent, enquanto a Anthropic reporta separadamente que o Fable 5.2 atinge 74.6% no Claude Code, com intensidade de raciocínio Max. Esses dois números do Fable vêm de configurações de teste diferentes e não podem ser tratados como parte de uma mesma comparação.
Capacidades do GPT-6.2 Astra em código e 3D (terceiros via AA + relato oficial)
As evidências na direção de código são relativamente conservadoras. O Coding Agent Index da AA (com Codex harness, no nível max) mostra que o GPT-6.2 Astra empata com o GPT-6 Astra — ou seja, esta geração não trouxe um salto evidente em agentes de codificação.
O FrontierCode 2.0 mede se as alterações em repositórios de código reais conseguem ser mescladas pelos mantenedores. O verdadeiro protagonista dessa avaliação é o Sol: segundo o relato oficial, o GPT-6.2 Sol fica a menos de 0.5 pontos do GPT-6.2 Astra, com custo de cerca de um quinto deste, ambos usando o nível Max. Essa conclusão mostra que o Sol tem um custo-benefício de destaque nessa métrica, e não deve ser interpretado como uma vantagem adicional do Astra no FrontierCode.
Na geração 3D, o relato oficial menciona o Elo da avaliação às cegas humana do AA-3D: GPT-6.2 Astra 1318, Claude Fable 5.2 1271, GPT-6.2 Sol 1259. Na prévia de pesquisa do AA-Robotics v0.1 da AA, os resultados foram Astra 79, Sol 78, Fable 5.2 75. Essas duas frentes — 3D e robótica — estão entre as poucas dimensões específicas em que o Astra está à frente, mas o Robotics ainda está em fase de prévia de pesquisa, então não vale a pena dar peso demais a esses números.
Além disso, a taxa de alucinação do AA-Omniscience (nível Max) mostra o GPT-6.2 Astra em 59% e o Sol em 55%. Ao fazer revisão de código ou verificação de fatos, esses números servem de lembrete de que ainda é preciso contar com validação externa.
Segurança cibernética e alinhamento do GPT-6.2 Astra (system card oficial)
De acordo com o system card, tanto o GPT-6.2 Astra quanto o Sol alcançaram o nível “crítico” em segurança cibernética e o nível “alto” em biologia e química dentro do framework de preparação (Preparedness Framework). O GPT-6.2 Astra ainda é, segundo o anúncio oficial, o primeiro modelo lançado publicamente a atingir o limiar “alto” de “autoaprimoramento de IA”. O texto de lançamento menciona esse ponto apenas em relação ao Astra, não ao Sol.
Com a elevação dos níveis de capacidade, as proteções também ficaram mais rígidas. O próprio documento admite que parte das pesquisas legítimas de vulnerabilidades será recusada. O Daybreak, voltado para o lado dos defensores, oferece atualmente o Alpha do GPT-6 Astra, o GPT-6 Sol no Daybreak Blue e o GPT-6 Cyber no Daybreak Red. Os responsáveis afirmam que vão trabalhar para levar a versão 6.2 ao Daybreak, mas até o momento o Daybreak ainda não integrou a 6.2.
Em termos de alinhamento, a maioria dos resultados das avaliações ficou próxima à do GPT-6 Astra, com menos ações inadequadas em simulações de ambiente de trabalho. Porém, em dois testes, o modelo tende mais a deixar de reportar problemas que bloqueiam o andamento do trabalho, como arquivos ausentes ou ferramentas de busca indisponíveis. Após adicionar as instruções correspondentes no Codex, esse tipo de omissão diminuiu de forma evidente. Se você monta fluxos de agentes, vale a pena deixar explícito nas instruções de sistema que ele deve reportar qualquer item que esteja bloqueando o progresso.
Resumo das evidências das quatro categorias de tarefas do GPT-6.2 Astra
| Tipo de tarefa | Evidências-chave | Fonte | Força da conclusão |
|---|---|---|---|
| Entrega profissional | ALE 5,2 pontos acima do GPT-6 Astra; taxa de aprovação no Harvey mais que o dobro do Fable 5.2; GDPval v2 com 6,2 pontos percentuais de vantagem | Auto-relato oficial | Vantagem relativa clara, mas a maioria sem pontuações absolutas |
| Ciência | Terminal-Bench-Science 0.1 com 9 pontos percentuais de vantagem; a AA também aponta liderança; segundo lugar no subconjunto difícil do CritPt v2 | Auto-relato oficial + AA | Forte em ciência via terminal, mas com concorrência nas questões teóricas difíceis |
| Código | Coding Agent Index empatado com o GPT-6 Astra | AA (terceira parte) | Sem salto geracional |
| 3D | AA-3D Elo 1318, acima do Fable 5.2 e do Sol | AA, conforme relato oficial | Líder nesse item específico |
| Segurança cibernética | Nível “severo”; pesquisas legítimas de vulnerabilidades podem ser recusadas; Daybreak ainda não integrado à versão 6.2 | System card oficial | Capacidade forte, mas com restrições de uso |
Dados de avaliação do GPT-6.2 Astra: a pontuação composta varia conforme o nível de raciocínio
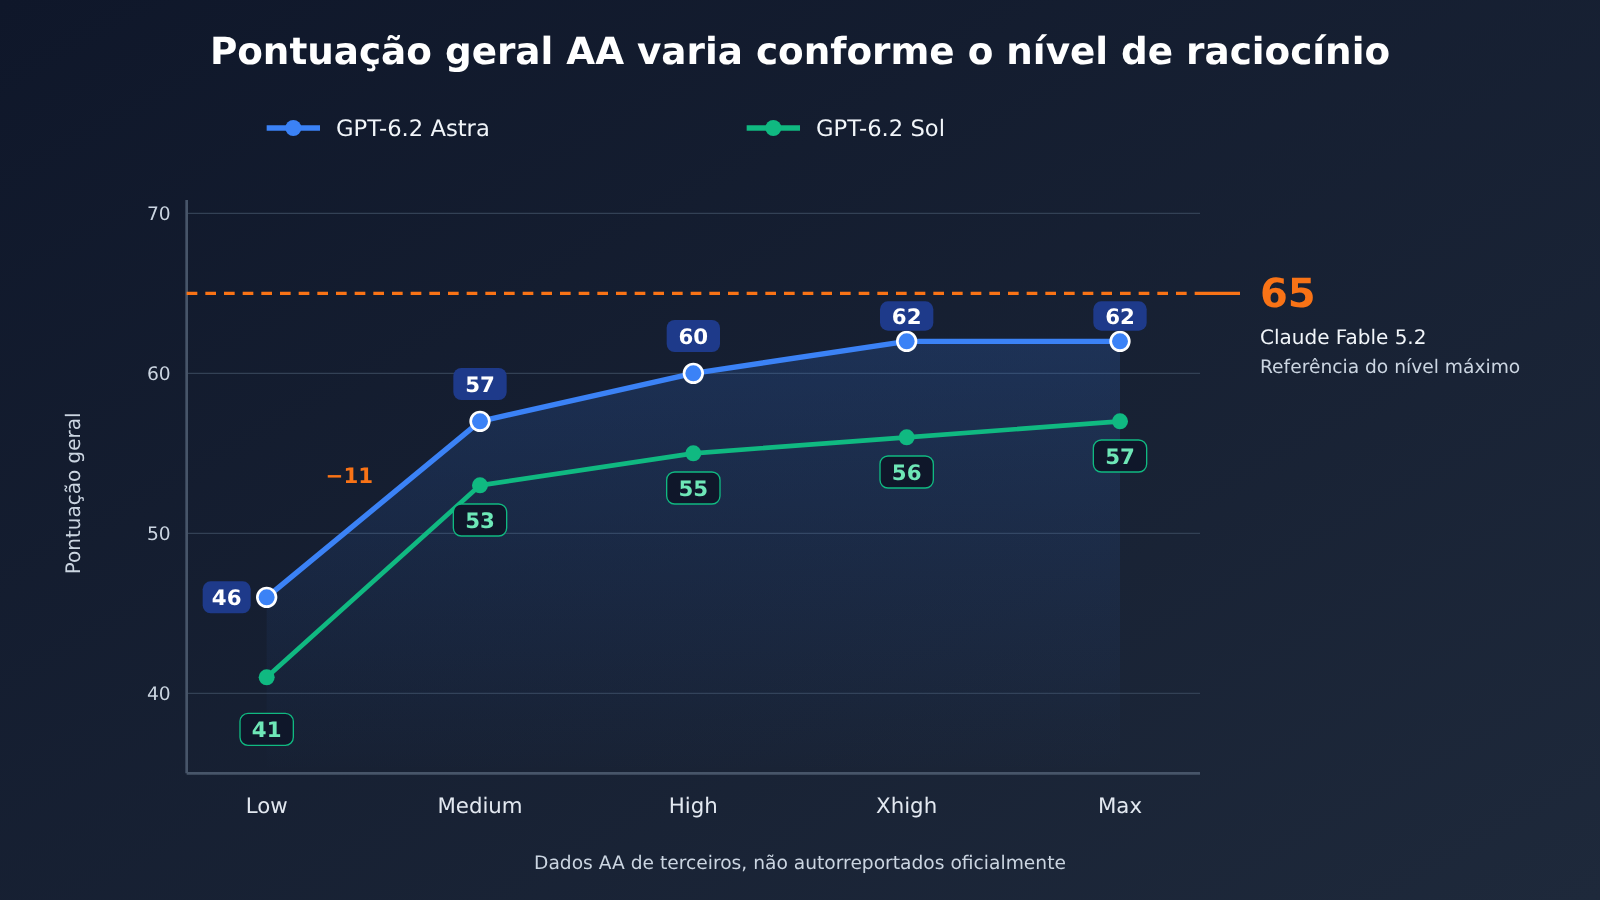
O Intelligence Index v5.0.1 da AA é atualmente a pontuação composta de terceiros mais citada. No nível máximo de raciocínio, o Claude Fable 5.2 lidera com 65 pontos. O GPT-6.2 Astra atinge 62 pontos nos níveis Max e Xhigh, superando o Gemini 4 Carbon no seu nível máximo (60) e o Claude Opus 5.5 no seu nível máximo (59), além de ficar 5 pontos acima do GPT-6 Astra.
O que realmente merece atenção é a diferença causada pelo nível de raciocínio. A tabela abaixo vem inteiramente de dados de terceiros da AA:
| Nível de raciocínio | GPT-6.2 Astra | GPT-6.2 Sol | Observação |
|---|---|---|---|
| Max | 62 | 57 | Max e Xhigh do Astra empatados |
| Xhigh | 62 | 56 | O Astra ainda não perde pontos neste nível |
| High | 60 | 55 | Queda de 2 pontos |
| Medium | 57 | 53 | O Medium do Astra empata com o Max do Sol |
| Low | 46 | 41 | Queda abrupta |
Do Max ao Low, o GPT-6.2 Astra perde 16 pontos, sendo que só a transição do Medium para o Low já derruba 11 pontos. Se você baixar o nível de raciocínio para Low para economizar, o que recebe não é mais o “Astra de 62 pontos”. Escolher um modelo olhando apenas para a pontuação máxima dos rankings pode facilmente superestimar o desempenho na implantação real.
A métrica de custo também vem da AA. Em termos de custo por tarefa do índice composto, o GPT-6.2 Astra (Max) custa $4.00, o GPT-6.2 Sol (Max) custa $1.01, e a página do Claude Fable 5.2 lista $26.54. Esse é o custo do conjunto de tarefas da AA — não dá para cruzar esses números com o dado oficial de que “o custo do ALE é cerca de 5% do Fable 5.2”.
Especificações e preços oficiais do GPT-6.2 Astra
As especificações e os preços valem conforme a página de modelos da OpenAI. O ID do modelo é gpt-6.2-astra; a entrada aceita texto e imagens, a saída é texto, e não há suporte a áudio e vídeo. A janela de contexto é de 1.050.000 tokens, com entrada máxima de 922.000 e saída máxima de 128.000; a data de corte do conhecimento é 2026-05-18, e o modelo suporta tokens de raciocínio. A API não aceita definir o reasoning effort como none.
| Item | Valores oficiais do GPT-6.2 Astra (por 1 milhão de tokens) |
|---|---|
| Entrada (tarifa padrão para contexto curto) | $8 |
| Leitura de cache | $0.40 |
| Escrita em cache (retenção de 30 minutos) | $10 |
| Escrita em cache (retenção de 12 horas) | $20 |
| Saída | $40 |
| Endpoints suportados | Chat Completions, Responses, Batch |
Os valores acima são os preços oficiais da OpenAI. O gpt-6.2-astra ainda não está disponível na APIYI, e vamos publicar esse modelo o mais rápido possível; modelo e preços devem ser confirmados na lista de modelos da plataforma. O resumo do anúncio de lançamento é: entrada e saída 20% mais baratos que os do GPT-6 Astra, e entrada em cache 60% mais barata.
Há alguns detalhes na regra de cobrança que valem atenção. Quando a entrada de uma única requisição passa de 272 mil tokens, o preço unitário da entrada e do cache dobra, e a saída é cobrada a 1,5 vez do valor de contexto curto — com a cobrança feita sobre o pedido inteiro. O Batch custa 50% do preço padrão, e o Fast custa 2 vezes o preço padrão para o mesmo comprimento de contexto. O Ultrafast custa 3 vezes o preço padrão até 2027-02-28 (horário do Pacífico) e passa a custar 6 vezes a partir de 2027-03-01.
Como comparação, os preços oficiais do GPT-6.2 Sol são: entrada $2, leitura de cache $0.10 e saída $10. O gpt-6.2-sol também ainda não está disponível na APIYI, e vamos publicar esse modelo o mais rápido possível; modelo e preços devem ser confirmados na lista de modelos da plataforma.
Para conferir os modelos, vale olhar dois lugares ao mesmo tempo: a tabela geral de modelos da APIYI em apiyi.com (docs.apiyi.com/models.md) e o endpoint de preços https://api.apiyi.com/api/pricing. Até o horário dos dados da tabela geral, 2026-11-17 15:54 (UTC+8), nenhum dos dois lugares listava ainda o gpt-6.2-astra nem o gpt-6.2-sol. O gpt-6-astra, que já está disponível na tabela geral, é o modelo da geração anterior — o preço da plataforma dele não serve como referência para o preço do 6.2.
Guia rápido do GPT-6.2 Astra: primeiro escolha a tarefa, depois o nível de raciocínio
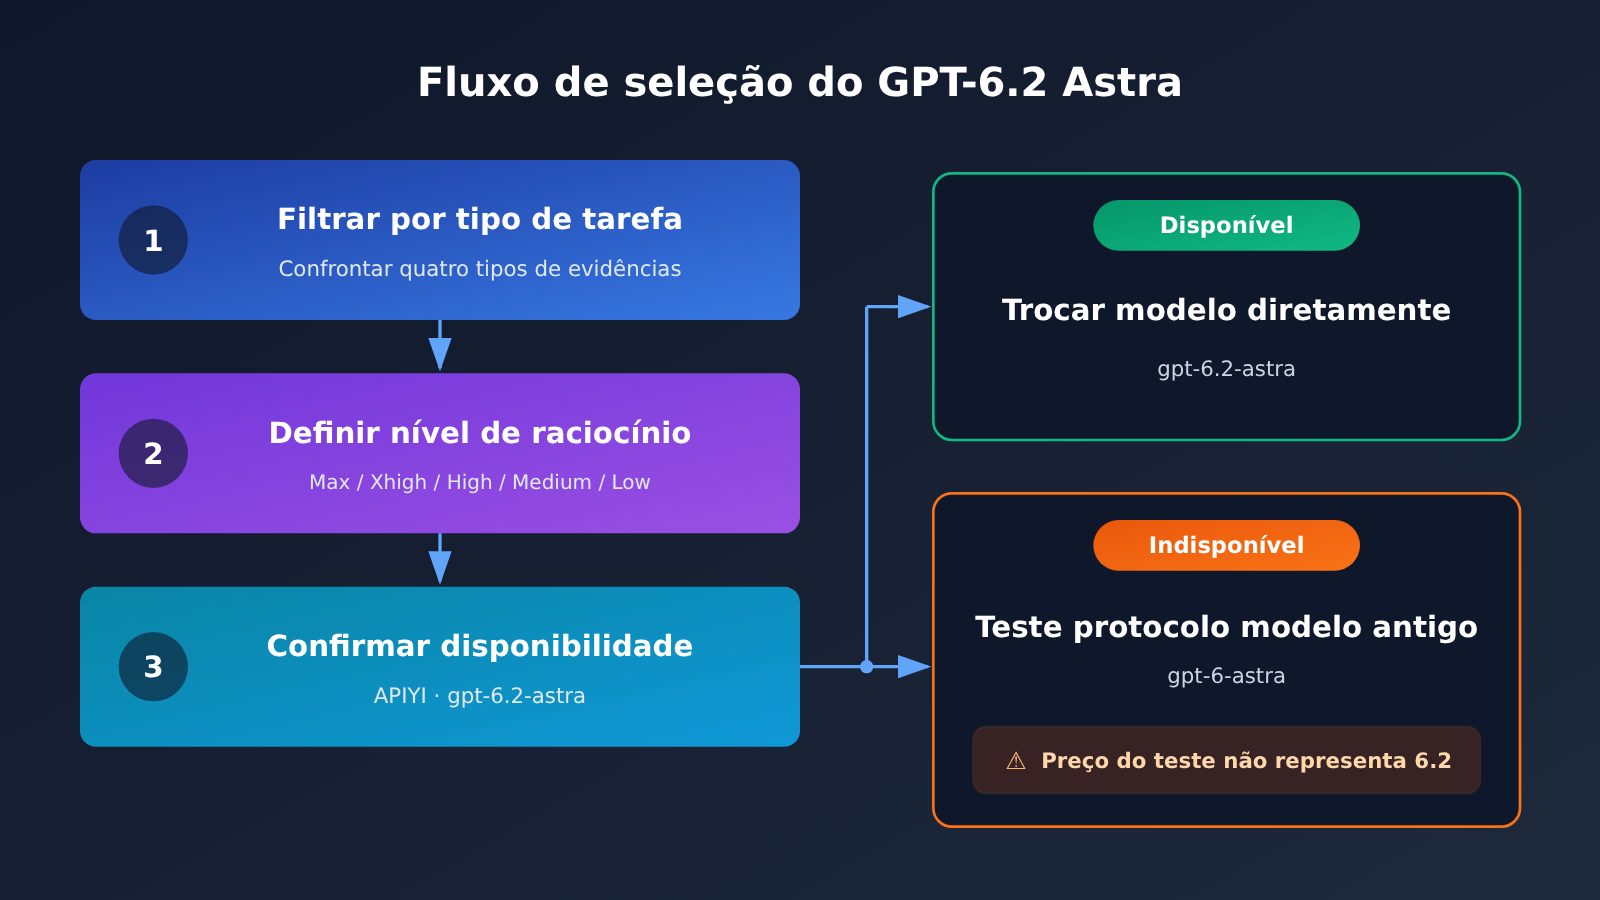
Para decidir se vale a pena entregar uma tarefa difícil ao GPT-6.2 Astra, recomendamos avaliar na seguinte ordem:
- Primeiro, escolha pela tarefa. Compare com as quatro categorias de evidências apresentadas acima. Para entrega de documentos profissionais ou fluxos científicos em terminal, a Astra tem evidências oficiais relativamente claras; se a demanda for principalmente de mesclagem de código, avalie primeiro se a Sol atende às necessidades; se for pesquisa de vulnerabilidades, conte com o fato de que parte das requisições pode ser recusada.
- Depois, o nível de raciocínio. Lembre-se da diferença de pontuação no AA: Max e Xhigh 62, High 60, Medium 57, Low 46. Em tarefas sensíveis a custo, comece com High ou Medium e faça comparações A/B; não recomendamos usar Low logo de início em tarefas difíceis.
- Por último, a lista de modelos da plataforma. Abra a lista de modelos da APIYI em apiyi.com e pesquise por
gpt-6.2-astra. Se ele já estiver disponível, basta trocar o campo model da requisição para esse modelo.
Se o 6.2 ainda não estiver no catálogo, use o gpt-6-astra, que já está disponível, para fazer o teste de integração do protocolo: defina o base_url do cliente compatível com OpenAI como https://api.apiyi.com/v1, preencha o model com gpt-6-astra e valide a estrutura de requisições do Chat Completions ou Responses, a saída em streaming e os parâmetros de raciocínio. É importante deixar claro: essa etapa valida apenas o protocolo da interface; durante o teste de integração, o que vale é o preço do gpt-6-astra, não o do 6.2, e os resultados também não representam a capacidade do 6.2.
No teste de integração, alguns parâmetros merecem ser confirmados com antecedência: o reasoning effort não pode ser enviado como none; em entradas longas, fique de olho no limiar de 272K, a partir do qual o valor total da cobrança dobra; se você for rodar tarefas em lote offline, vale avaliar o preço do Batch com 50% de desconto. Tudo isso pode ser mantido exatamente como está depois que o 6.2 entrar no catálogo.
🚀 Dica para começar: a APIYI (apiyi.com) oferece uma interface compatível com OpenAI; com uma única chave API você invoca modelos de vários provedores, e novos usuários recebem créditos gratuitos de teste. Recomendamos primeiro validar toda a cadeia de requisições com um modelo já disponível; quando o 6.2 entrar no catálogo, basta trocar o nome do modelo para alternar.
Referência de seleção de tarefas para o GPT-6.2 Astra
| Tipo de tarefa | Priorizar a Astra? | Nível de raciocínio inicial sugerido | Pontos de atenção |
|---|---|---|---|
| Entrega de documentos profissionais de longo prazo | Sim | Começar com High, usar Max nas entregas críticas | As comparações oficiais são, em sua maioria, valores relativos |
| Fluxos científicos em terminal | Sim | High ou Xhigh | Em problemas teóricos difíceis pode haver concorrentes mais fortes |
| Alterações de mesclagem de código | Avaliar a Sol primeiro | Escolher conforme o orçamento | O Coding Agent Index não apresentou salto |
| Geração 3D | Pode | Ajustar conforme o resultado | O AA-3D é um Elo de avaliação cega, conforme relato oficial |
| Pesquisa de vulnerabilidades | Com cautela | Não aplicável | Pode ser recusado; o Daybreak ainda não está integrado ao 6.2 |
Os níveis de raciocínio iniciais da tabela são sugestões baseadas na diferença de pontuação do AA, não valores recomendados oficialmente. Antes de colocar em produção, faça comparações com amostras das suas próprias tarefas.
Análise de vantagens e limitações do GPT-6.2 Astra
Vantagens
- Muitas evidências de entrega profissional: ALE, Harvey LAB-AA, GDPval v2 e AA-AnalystAgent — vários indicadores autorreportados oficialmente apontam na mesma direção, quase sempre acompanhados de redução de custos.
- Terminal científico confirmado por duas fontes: tanto os dados autorreportados oficialmente quanto a avaliação independente da AA mostram que ele lidera no Terminal-Bench-Science 0.1.
- Custo unitário menor: o preço oficial é 20% mais baixo que o do GPT-6 Astra em entrada e saída, e 60% mais baixo em entrada em cache; no GDPval v2, ele ainda gera 22% menos tokens de saída.
- Contexto longo e saída ampla: 1.050.000 de janela de contexto e 128.000 de saída máxima — ideal para processar documentos inteiros de uma só vez.
Limitações
- Não é o primeiro na pontuação geral: no nível mais alto da AA, o Claude Fable 5.2 marca 65 pontos, contra 62 do GPT-6.2 Astra. Em cenários que exigem o melhor desempenho geral, faça um teste comparativo antes.
- Sensível ao nível de raciocínio: no nível Low, a pontuação cai para apenas 46. Antes de reduzir o nível, faça sempre testes de regressão com as suas próprias tarefas.
- Sem avanço geracional em código: o Coding Agent Index da AA fica empatado com o do GPT-6 Astra; para tarefas de merge de código, vale avaliar primeiro o Sol, que tem custo menor.
- Pesquisa de segurança limitada: parte das pesquisas legítimas de vulnerabilidades pode ser recusada, e o Daybreak ainda não oferece a versão 6.2. Por enquanto, as equipes de segurança só podem continuar usando a série GPT-6 no Daybreak.
- Omite itens bloqueados: em dois testes, ele tem mais chance de não relatar problemas como arquivos ausentes ou ferramentas indisponíveis; nos fluxos de agentes, peça explicitamente que ele informe os bloqueios.
- Taxa de alucinação nada desprezível: a taxa de alucinação (Max) no AA-Omniscience é de 59%; saídas factuais ainda exigem verificação externa.
Perguntas Frequentes (FAQ)
Q1: O que é o GPT-6.2 Astra?
O GPT-6.2 Astra é um modelo lançado pela OpenAI em 17/11/2026, disponibilizado no mesmo lote que o GPT-6.2 Sol, com o ID de modelo `gpt-6.2-astra`. Ele recebe texto e imagens como entrada e gera texto como saída, tem uma janela de contexto de 1.050.000 tokens e pode ser usado no ChatGPT Work, no Codex e na API da OpenAI.
Q2: O GPT-6.2 Astra é atualmente o modelo mais forte?
Não dá para resumir assim. No índice abrangente de terceiros da AA, na faixa mais alta, o Claude Fable 5.2 marca 65 pontos, enquanto o GPT-6.2 Astra marca 62. Há evidências de que ele lidera em dimensões específicas como entrega profissional, ciência em terminal e 3D, mas o índice de Agent de código ficou no mesmo patamar da geração anterior; por isso, é preciso avaliar tarefa por tarefa.
Q3: Por que o mesmo GPT-6.2 Astra pode ter pontuações diferentes?
Porque as pontuações da AA estão vinculadas ao nível de raciocínio: Max e Xhigh ficam com 62, High com 60, Medium com 57 e Low com 46. Quanto mais baixo o nível de raciocínio, menor o consumo — e menor a pontuação. Ao citar uma pontuação, indique também o nível de raciocínio correspondente.
Q4: O GPT-6.2 Astra é adequado para pesquisa de vulnerabilidades?
É preciso ter cautela. Ele atingiu o nível “crítico” de segurança cibernética, o que significa proteções mais rígidas — parte das pesquisas legítimas de vulnerabilidades pode ser recusada. O Daybreak, voltado para o lado defensivo, ainda não tem acesso ao 6.2; a OpenAI apenas afirmou que trabalhará para incluí-lo.
Q5: Já é possível invocar o gpt-6.2-astra via APIYI?
De acordo com a tabela geral e o endpoint de preços até 17/11/2026 às 15:54 (UTC+8), o gpt-6.2-astra ainda não está disponível na plataforma — vamos disponibilizá-lo o quanto antes; vale sempre o modelo e o preço constantes da lista de modelos da plataforma. Até lá, você já pode realizar testes de integração de protocolo na APIYI (apiyi.com) usando o `gpt-6-astra`, que já está no ar. Os custos gerados nesses testes referem-se ao gpt-6-astra e não representam o preço do 6.2.
Q6: Qual é o preço oficial do GPT-6.2 Astra?
O preço oficial da OpenAI, por 1 milhão de tokens, é: entrada $8, leitura de cache $0.40, gravação em cache de 30 minutos $10 e saída $40. Quando a entrada de uma única requisição ultrapassa 272K, o pedido inteiro é cobrado com preços maiores. Na APIYI, o modelo ainda não está disponível — vamos disponibilizá-lo o quanto antes; vale sempre o modelo e o preço constantes da lista de modelos da plataforma.
Q7: Quais são as limitações conhecidas do GPT-6.2 Astra?
Basicamente quatro pontos: a pontuação cai de forma acentuada nos níveis de raciocínio mais baixos; a capacidade de Agent de código ficou no mesmo patamar da geração anterior; a taxa de alucinação no AA-Omniscience (Max) é de 59%; e, em alguns testes, ele tende a omitir bloqueios como arquivos ausentes ou ferramentas indisponíveis. Os três primeiros podem ser mitigados com a escolha adequada do nível de raciocínio e com validação externa; o último pode ser contornado pedindo explicitamente, no comando, que ele relate esses bloqueios.
Pontos-chave do GPT-6.2 Astra
- Mais evidências em entrega profissional: os auto-relatos oficiais da ALE, Harvey e GDPval v2 mostram ganhos de desempenho com custo menor.
- Ciência em terminal confirmada por duas fontes: tanto o auto-relato oficial quanto a avaliação independente da AA mostram liderança no Terminal-Bench-Science.
- Código sem grande salto: no AA Coding Agent Index, o resultado ficou empatado com o do GPT-6 Astra, e no FrontierCode o melhor custo-benefício é do Sol.
- Pontuação geral varia com o nível de raciocínio: as notas da AA ficam assim — Max/Xhigh 62, High 60, Medium 57 e Low 46.
- Segurança forte, porém restritiva: atinge o nível “crítico”, pode recusar pesquisas legítimas de vulnerabilidades, e o Daybreak ainda não está integrado ao 6.2.
- Ordem para começar: escolha o modelo pela tarefa, defina o nível de raciocínio e, por último, confirme na lista de modelos do APIYI (apiyi.com) se ele está disponível.
Resumo
Os pontos-chave do GPT-6.2 Astra:
- Fortalezas dependem da tarefa: as evidências mais sólidas estão na entrega de documentos profissionais e na ciência em terminal; há liderança em itens individuais nas três dimensões, e o código se mantém no nível da geração anterior.
- Notas dependem do nível de raciocínio: a pontuação geral da AA (terceira parte) cai de 62 no Max para 46 no Low — a escolha do nível impacta diretamente o resultado.
- Números dependem da fonte: o auto-relato oficial e a AA (terceira parte) seguem metodologias distintas; custos e notas não podem ser convertidos de um para o outro.
- Cenários de segurança pedem avaliação à parte: a proteção está mais rígida e o Daybreak ainda não foi integrado ao 6.2.
Se você tem uma tarefa difícil nas mãos, recomendo primeiro cruzar as quatro categorias de evidência para ver se ela se encaixa nos pontos fortes do Astra e, depois, testar com seus próprios exemplos comparando os diferentes níveis de raciocínio.
Antes do 6.2 chegar ao catálogo, dá para usar o APIYI (apiyi.com) com os modelos já disponíveis para deixar toda a cadeia de invocação funcionando; depois que o 6.2 for liberado, basta trocar o nome do modelo — os preços reais valem sempre os da lista de modelos da plataforma.
📚 Referências
-
Post de lançamento da OpenAI: apresentação oficial do GPT-6.2 Astra e Sol e resultados oficialmente divulgados
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Descrição: resultados relativos e panorama de preços relacionados a entrega profissional, ciência e código
- Link:
-
System Card da OpenAI: níveis de segurança e avaliações de alinhamento
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Descrição: classificação “crítica” em cibersegurança, alto limiar de autoaprimoramento da IA e status atual do Daybreak
- Link:
-
Página de modelos da OpenAI: especificações e preços oficiais
- Link:
platform.openai.com/docs/models/gpt-6.2-astra - Descrição: janela de contexto, endpoints, regras de precificação dos 272K e multiplicadores Batch/Fast/Ultrafast
- Link:
-
Artigo de avaliação da Artificial Analysis: índice composto de terceiros e subpontuações
- Link:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Descrição: pontuações compostas por faixa de raciocínio, Coding Agent Index, taxa de alucinação e Robotics
- Link:
-
Página de modelos da Artificial Analysis: custo por tarefa do GPT-6.2 Astra
- Link:
artificialanalysis.ai/models/gpt-6-2-astra - Descrição: metodologia de custo por tarefa do índice composto
- Link:
Autor: Equipe Técnica da APIYI
Intercâmbio técnico: fique à vontade para entrar em contato conosco pela página inicial do site oficial da APIYI. Para conhecer mais modelos e instruções de integração, consulte a central de documentação em docs.apiyi.com


