
Nota do autor: neste artigo, desmontamos as quatro linhas de cobrança do gpt-6.2-sol — entrada, leitura de cache, escrita de cache e saída —, explicamos o cálculo completo das faturas acima de 272K e os multiplicadores Batch/Fast/Ultrafast, além de apresentar dois exemplos de estimativa: um com contexto curto e outro com contexto ultralongo.
Em 17 de novembro de 2026, a OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol. Para muitas equipes, a primeira tarefa foi estimar a fatura do gpt-6.2-sol — mas o número calculado quase nunca batia com o valor real. O motivo: a cobrança do GPT-6.2 Sol não é “um preço para entrada, um preço para saída”; entrada, leitura de cache, escrita de cache e saída são calculadas separadamente, em quatro linhas distintas. Além disso, o contexto ultralongo e faixas como Ultrafast também alteram os multiplicadores.
Este não é um artigo que só copia preços. Tendo como base as regras de precificação da página de modelos da OpenAI, aqui você encontra a fórmula de cálculo para contexto curto, o algoritmo completo para faturas acima de 272K e dois exemplos calculados separadamente. Também explicamos em quais condições a OpenAI chegou à afirmação de que o Sol custa “cerca de um quinto do Astra”.
Valor principal: ao terminar a leitura, você será capaz de montar sozinho a fatura de quatro colunas do gpt-6.2-sol, verificar se uma requisição ultrapassou os 272K e identificar qual multiplicador pode dobrar o custo.
Pontos essenciais da precificação do GPT-6.2 Sol
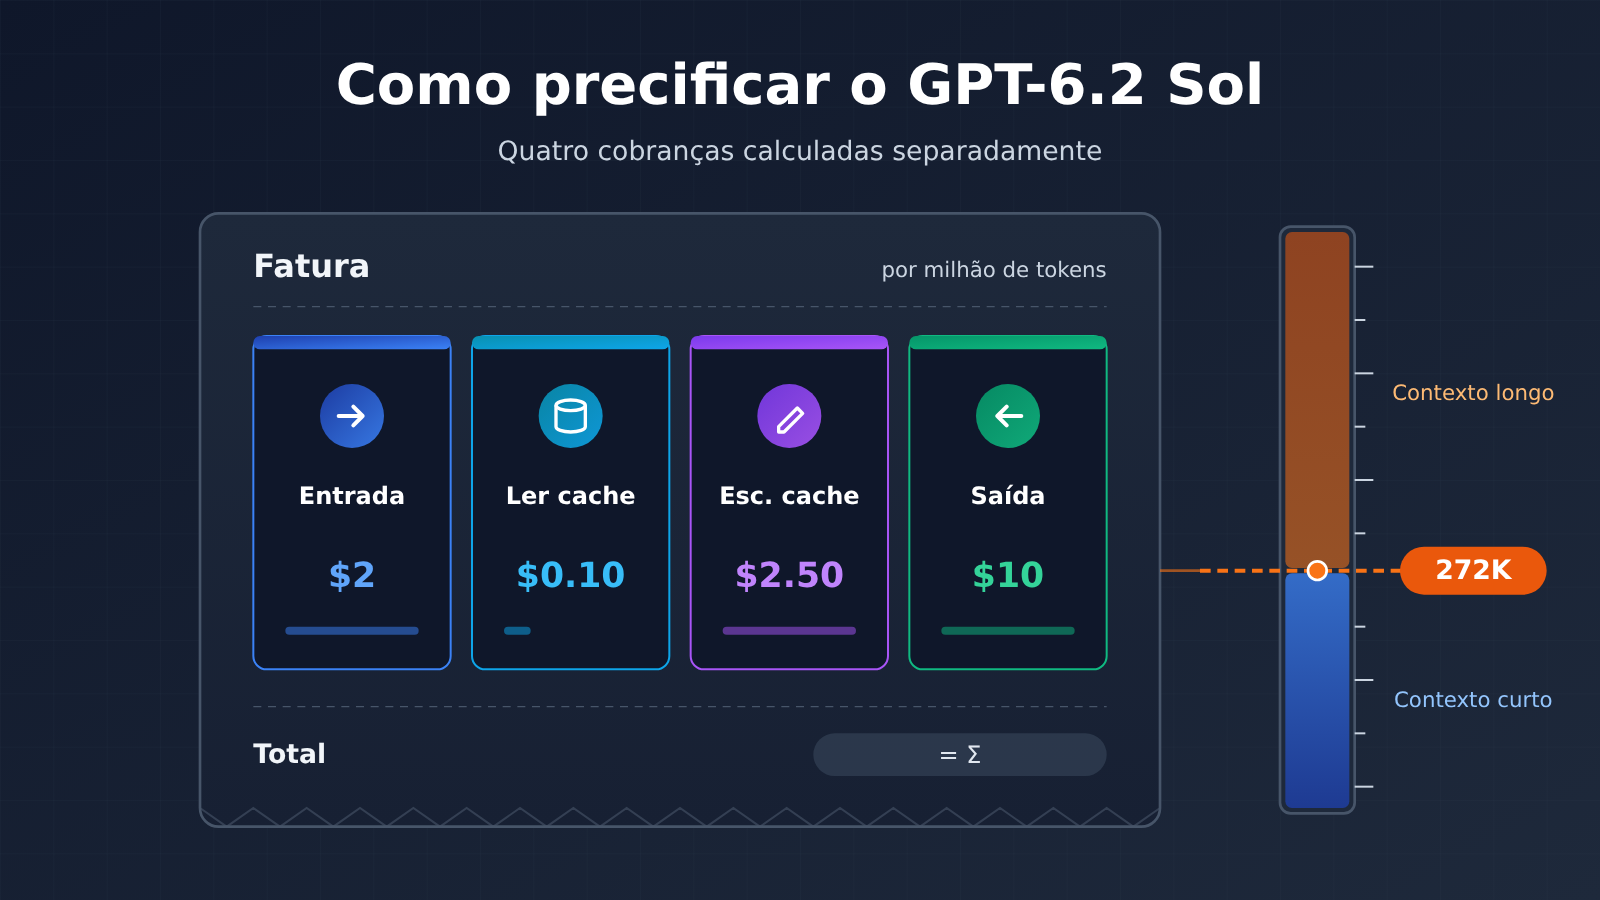
Antes de mais nada, vamos deixar as regras claras. Os números abaixo vêm todos da página oficial de modelos da OpenAI, com valores por 1 milhão de tokens — ou seja, são preços oficiais de tabela.
| Ponto | Descrição | Impacto na estimativa de custos |
|---|---|---|
| Quatro cobranças separadas | Entrada, leitura de cache, escrita de cache (nas variantes de 30 minutos e 12 horas) e saída têm preços unitários próprios | Quem olha só os preços de entrada e saída acaba deixando de fora a cobrança da escrita no cache |
| Limite de 272K | Quando a entrada da requisição ultrapassa 272K tokens, os preços unitários de entrada e cache dobram e a saída passa a valer 1,5x | A majoração vale para a requisição inteira, e não apenas para a parte que exceder o limite |
| Multiplicadores por nível | Batch custa 50% do preço padrão, Fast custa 2x, e Ultrafast custa hoje 3x, passando a 6x a partir de 01/03/2027 | Com o mesmo volume de tokens, a fatura pode variar mais de dez vezes |
| A inferência não pode ser desligada | A API não aceita definir o reasoning effort como none |
Os tokens do lado da saída nunca chegam ao nível de inferência zero |
| Limites de especificação | Janela de contexto de 1,050,000, entrada máxima de 922,000, saída máxima de 128,000 | Requisições muito longas vão cruzar o limite de 272K de qualquer jeito |
Detalhamento das quatro cobranças do GPT-6.2 Sol
Entrada se refere aos tokens comuns da requisição que não acertaram o cache; o preço de tabela em contextos curtos é $2. A leitura de cache é a parte que aproveita um prefixo já existente no cache, com preço unitário de apenas $0.10 — um vigésimo do valor da entrada comum. É exatamente por isso que comandos de sistema longos e prefixos de documentos fixos são ideais para reutilizar o cache.
A escrita de cache costuma passar despercebida. Gravar um conteúdo no cache em si tem custo: a escrita com retenção de 30 minutos custa $2.50, e a de 12 horas custa $5 — ambas mais caras que a entrada comum. Ou seja, cachear não significa economizar automaticamente. Só quando o número de acertos posteriores for grande o suficiente é que o valor extra pago na escrita se recupera com o preço baixo da leitura de cache.
A saída tem preço de tabela de $10 e cobre a resposta gerada pelo modelo. Como a intensidade de raciocínio não pode ser definida como none, o processo de raciocínio geralmente também faz aumentar a quantidade de tokens no lado da saída — o valor exato deve ser conferido no campo de uso retornado pela API. Para consultar modelos e conferir preços, o recomendado é se guiar pelas informações em tempo real da lista de modelos da plataforma APIYI (apiyi.com), sem depender apenas de informações de segunda mão.
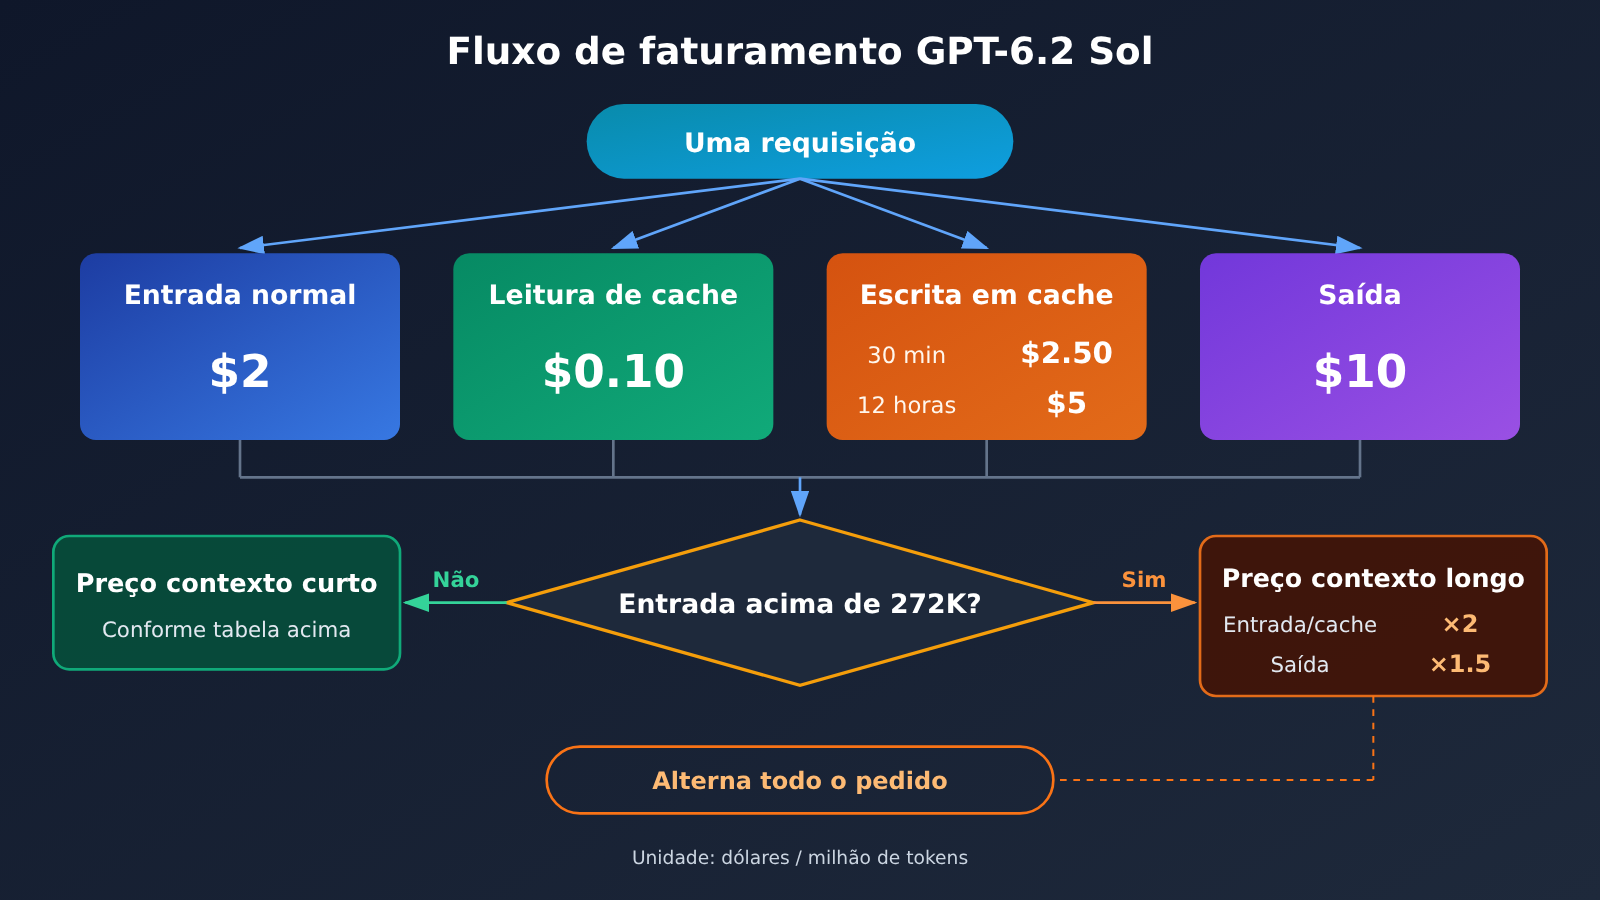
Tabela de preços do GPT-6.2 Sol para contexto curto e acima de 272K
A tabela abaixo reúne os preços padrão do gpt-6.2-sol nos dois comprimentos de contexto. A coluna de contexto longo foi calculada com base nas regras da página do modelo: os preços unitários de entrada e de cache multiplicados por 2, e a saída multiplicada por 1.5.
| Item de cobrança (por 1 milhão de tokens) | Contexto curto (≤272K) | Acima de 272K (pedido inteiro) | Fonte da regra |
|---|---|---|---|
| Entrada | $2 | $4 | Página do modelo: entrada em dobro |
| Leitura de cache | $0.10 | $0.20 | Página do modelo: cache em dobro |
| Escrita de cache (30 minutos) | $2.50 | $5 | Página do modelo: cache em dobro |
| Escrita de cache (12 horas) | $5 | $10 | Página do modelo: cache em dobro |
| Saída | $10 | $15 | Página do modelo: saída 1.5x |
Os valores acima são os preços oficiais da OpenAI. O gpt-6.2-sol ainda não está disponível na APIYI, e vamos adicioná-lo ao catálogo o mais rápido possível; o modelo e os preços corretos são os da lista de modelos da plataforma, onde você pode conferir o status mais recente em apiyi.com. Até o horário dos dados da tabela geral da APIYI, 2026-11-17 15:54 (UTC+8), nem a tabela geral nem o endpoint de preços exibiam gpt-6.2-sol ou gpt-6.2-astra.
Como entender a regra de pedido inteiro do GPT-6.2 Sol
A cobrança “aplicável a todo o pedido” é o ponto mais fácil de errar no cálculo. Se a entrada de uma requisição for de 300K, não dá para dividir a conta: os primeiros 272K pelo preço de contexto curto e os 28K restantes pelo preço de contexto longo. Assim que a entrada do pedido cruza esse limite, toda a entrada, a leitura de cache e a escrita de cache desse pedido são cobradas pelo valor em dobro, e a saída, por 1.5x.
Por isso, entre duas requisições com entradas de 270K e 280K, a diferença na fatura vai muito além dos 10K de tokens extras. Em cenários de RAG ou análise de documentos longos, manter a entrada dentro de 272K costuma sair mais barato do que encaixar um pouco mais de contexto.
GPT-6.2 Sol em comparação com o anterior gpt-6.1-sol
A nota de lançamento explica que o Sol mantém os preços de token de API do GPT-6.1 Sol. Dá para usar o gpt-6.1-sol, que já está disponível, como referência: na tabela geral da APIYI em apiyi.com, o gpt-6.1-sol com contexto curto tem entrada de $2, saída de $10 e leitura de cache de $0.1; acima de 272.000, a entrada vai para $4, e os endpoints suportam responses e chat.
Vale reforçar: esses são os preços de plataforma do modelo anterior, ou seja, não significam que o gpt-6.2-sol já esteja disponível, nem que possam ser tratados como os preços de plataforma da versão 6.2. Além disso, na mesma tabela, a leitura de cache do gpt-6-sol é de $0.2, diferente do 6.1 — na hora de comparar, cuidado para não olhar a linha errada.
Como os multiplicadores de camada do GPT-6.2 Sol se acumulam
Além do comprimento de contexto, a camada de serviço também altera o preço unitário. Os multiplicadores indicados na página do modelo são:
| Camada | Multiplicador | Prazo e observações |
|---|---|---|
| Standard | 1× | Camada padrão (default) |
| Batch | 0.5× | 50% do preço padrão, ideal para tarefas offline sem pressa |
| Fast | 2× | Base: preço padrão do mesmo comprimento de contexto |
| Ultrafast | 3× | Até 2027-02-28 (horário do Pacífico) |
| Ultrafast | 6× | A partir de 2027-03-01 |
A página do modelo é bem explícita quanto ao Fast: são “2 vezes o preço padrão do mesmo comprimento de contexto”. Ou seja, requisições acima de 272K rodando no Fast têm o preço de contexto longo multiplicado por 2. Já no caso do Batch e do Ultrafast, o texto original fala em multiplicadores sobre o “preço padrão”; como exatamente isso se acumula para requisições ultralongas nessas duas camadas, a recomendação é validar com a fatura oficial — na hora de fazer uma estimativa, uma boa aproximação é multiplicar pelo preço padrão do mesmo comprimento de contexto.
O marco temporal do Ultrafast merece um lembrete à parte. O orçamento estimado hoje pode simplesmente dobrar em março de 2027. Se o seu negócio depende do Ultrafast, o ideal é já deixar prevista no orçamento uma linha com o multiplicador de 6×.
Guia rápido do GPT-6.2 Sol: dois exemplos de estimativa de custos
Os dois exemplos abaixo usam apenas adição e multiplicação, e todos os números aparecem escritos no meio das frases, para você aplicar direto ao seu próprio volume de uso. Cada token é contado em apenas uma categoria; qual categoria recebe cada parte dos tokens é definida pelo campo usage retornado pela API.
Exemplo 1: requisição com contexto curto
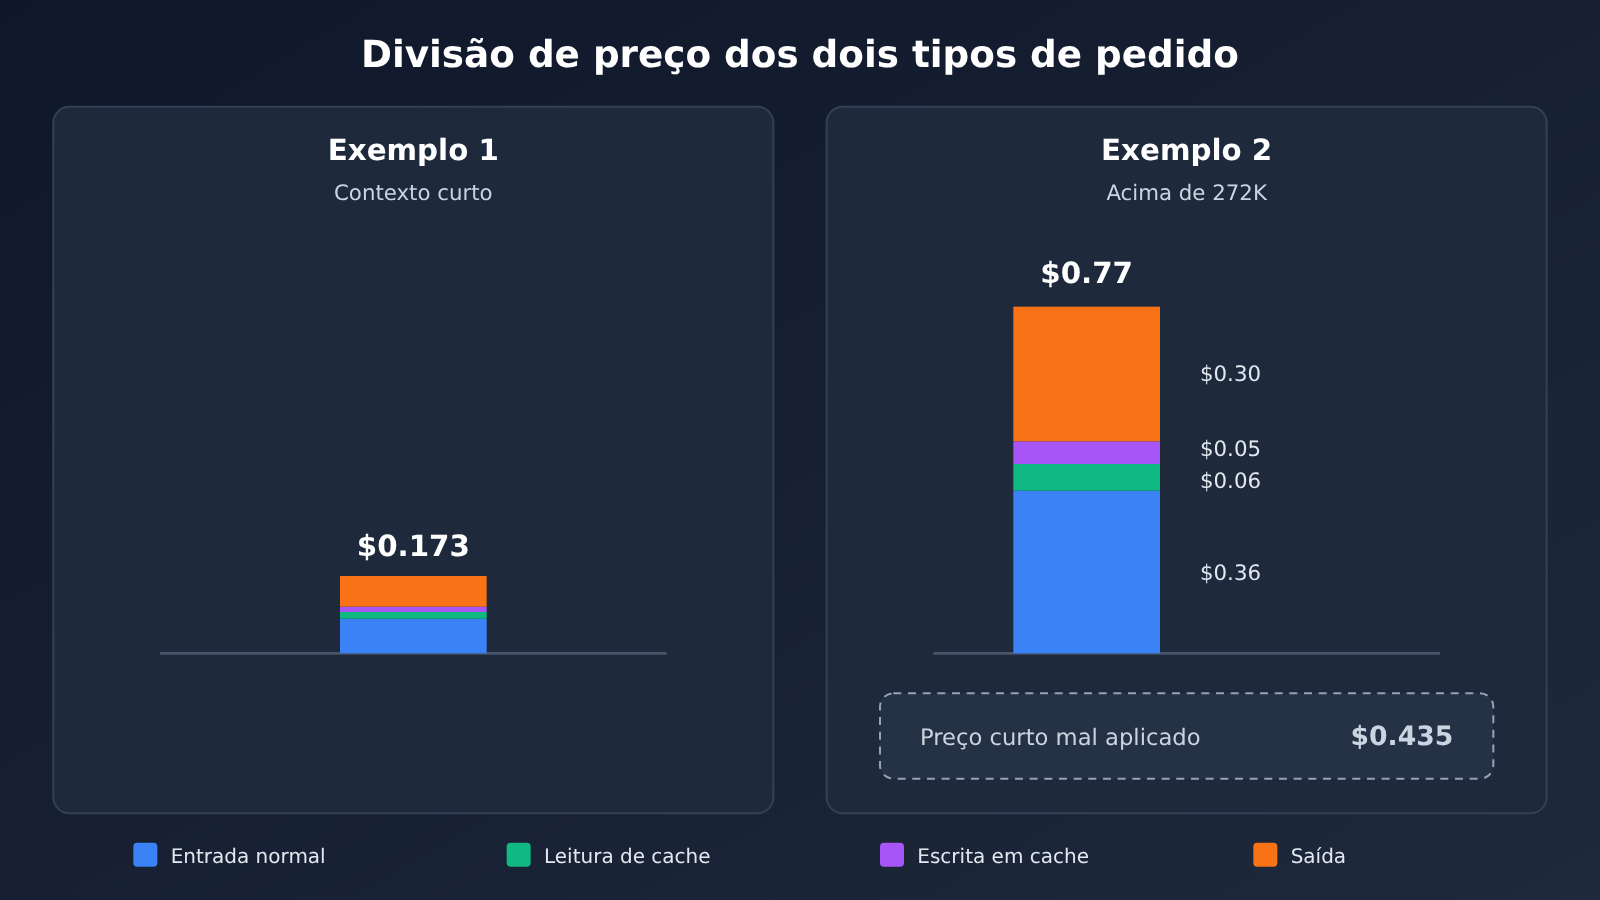
Suponha que uma requisição tenha, no total, 120.000 tokens de entrada: 80.000 acertam o cache (leitura de cache), 10.000 são escritos no cache de 30 minutos, 30.000 são entrada comum, e a saída é de 8.000 tokens.
- Entrada comum: 30.000 × $2 ÷ 1.000.000 =
$0.06 - Leitura de cache: 80.000 × $0.10 ÷ 1.000.000 =
$0.008 - Escrita no cache (30 minutos): 10.000 × $2.50 ÷ 1.000.000 =
$0.025 - Saída: 8.000 × $10 ÷ 1.000.000 =
$0.08
O total desta requisição fica em $0.173. Repare que 8.000 tokens de saída custam dez vezes mais do que 80.000 tokens de leitura de cache. Se, na hora de estimar, você considerar apenas o volume total de entrada, a conclusão pode ficar bem distante do valor real.
Exemplo 2: pedido inteiro acima de 272K
Suponha que uma solicitação tenha, ao todo, 400,000 tokens de entrada, sendo 300,000 de leitura de cache, 10,000 de gravação no cache de 30 minutos, 90,000 de entrada normal e 20,000 tokens de saída. Como a entrada ultrapassa 272K, o pedido inteiro é cobrado pelo preço de contexto longo.
- Entrada normal: 90,000 × $4 ÷ 1,000,000 =
$0.36 - Leitura de cache: 300,000 × $0.20 ÷ 1,000,000 =
$0.06 - Gravação no cache (30 minutos): 10,000 × $5 ÷ 1,000,000 =
$0.05 - Saída: 20,000 × $15 ÷ 1,000,000 =
$0.30
Esse pedido soma $0.77 no total. Se você usar por engano o preço de contexto curto, o cálculo dá apenas $0.435 — quase metade a menos.
| Tier (com base no Exemplo 2) | Cálculo | Custo por solicitação |
|---|---|---|
| Padrão | preço original | $0.77 |
| Batch | × 0.5 | $0.385 |
| Fast | × 2 | $1.54 |
| Ultrafast (até 2027-02-28) | × 3 | $2.31 |
| Ultrafast (a partir de 2027-03-01) | × 6 | $4.62 |
No mesmo pedido, do Batch ao Ultrafast de 2027, o custo varia 12 vezes. A escolha do tier costuma ter um impacto maior na fatura do que ajustar o tamanho do comando.
Verificando o uso com o protocolo compatível com OpenAI
Em termos de integração, o gpt-6.2-sol suporta oficialmente Chat Completions e Responses, além de Batch; não suporta Realtime, Assistants, ajuste fino, geração de imagens, vídeo e voz. Ele aceita apenas texto e imagem como entrada e gera texto como saída.
Se você quiser primeiro validar o fluxo de estimativa de custos no gpt-6.1-sol, que já está disponível, siga os passos abaixo:
- No cliente compatível com OpenAI, defina a base URL como
https://api.apiyi.com/v1e preencha o campo de modelo comgpt-6.1-sol. - Defina o esforço de raciocínio com valores válidos como
lowemedium; não usenone. Os dois modelos 6.2 rejeitamnonediretamente na API oficial. - Após cada requisição, registre o usage retornado, anotando separadamente os quatro valores: entrada normal, leitura de cache, escrita de cache e saída.
- Aplique os quatro valores na tabela de preços unitários acima e verifique se a entrada ultrapassa 272K.
Quando o gpt-6.2-sol estiver disponível, basta trocar o ID do modelo e atualizar os preços unitários.
Ver a lista completa de verificação para estimativa
– Primeiro passo: calcule o volume total de entrada e verifique se ultrapassa 272K, para determinar se todo o pedido usa o preço curto ou o preço longo.
– Segundo passo: divida a entrada em três colunas: entrada normal, leitura de cache e escrita de cache (distinguindo 30 minutos e 12 horas).
– Terceiro passo: conte os tokens de saída; com o raciocínio ativado, tome como base o usage retornado pela API.
– Quarto passo: multiplique cada uma das quatro colunas pelo preço unitário e some os resultados para obter o custo da faixa padrão.
– Quinto passo: multiplique pelo fator de cada faixa: Batch é 0,5, Fast é 2 e Ultrafast é 3 ou 6, dependendo da data.
– Sexto passo: multiplique pelo número médio de requisições diárias para obter o orçamento diário; estime a taxa de acerto do cache com valores conservadores.
🚀 Começo rápido: recomendo primeiro resgatar créditos de teste gratuitos na APIYI (apiyi.com) e rodar algumas requisições reais com o gpt-6.1-sol, que já está disponível. Com os quatro valores de usage em mãos, é só aplicar as fórmulas deste artigo. Assim, o orçamento estimado fica bem mais próximo da realidade do que uma projeção puramente teórica.
Como interpretar o “um quinto” entre GPT-6.2 Sol e Astra
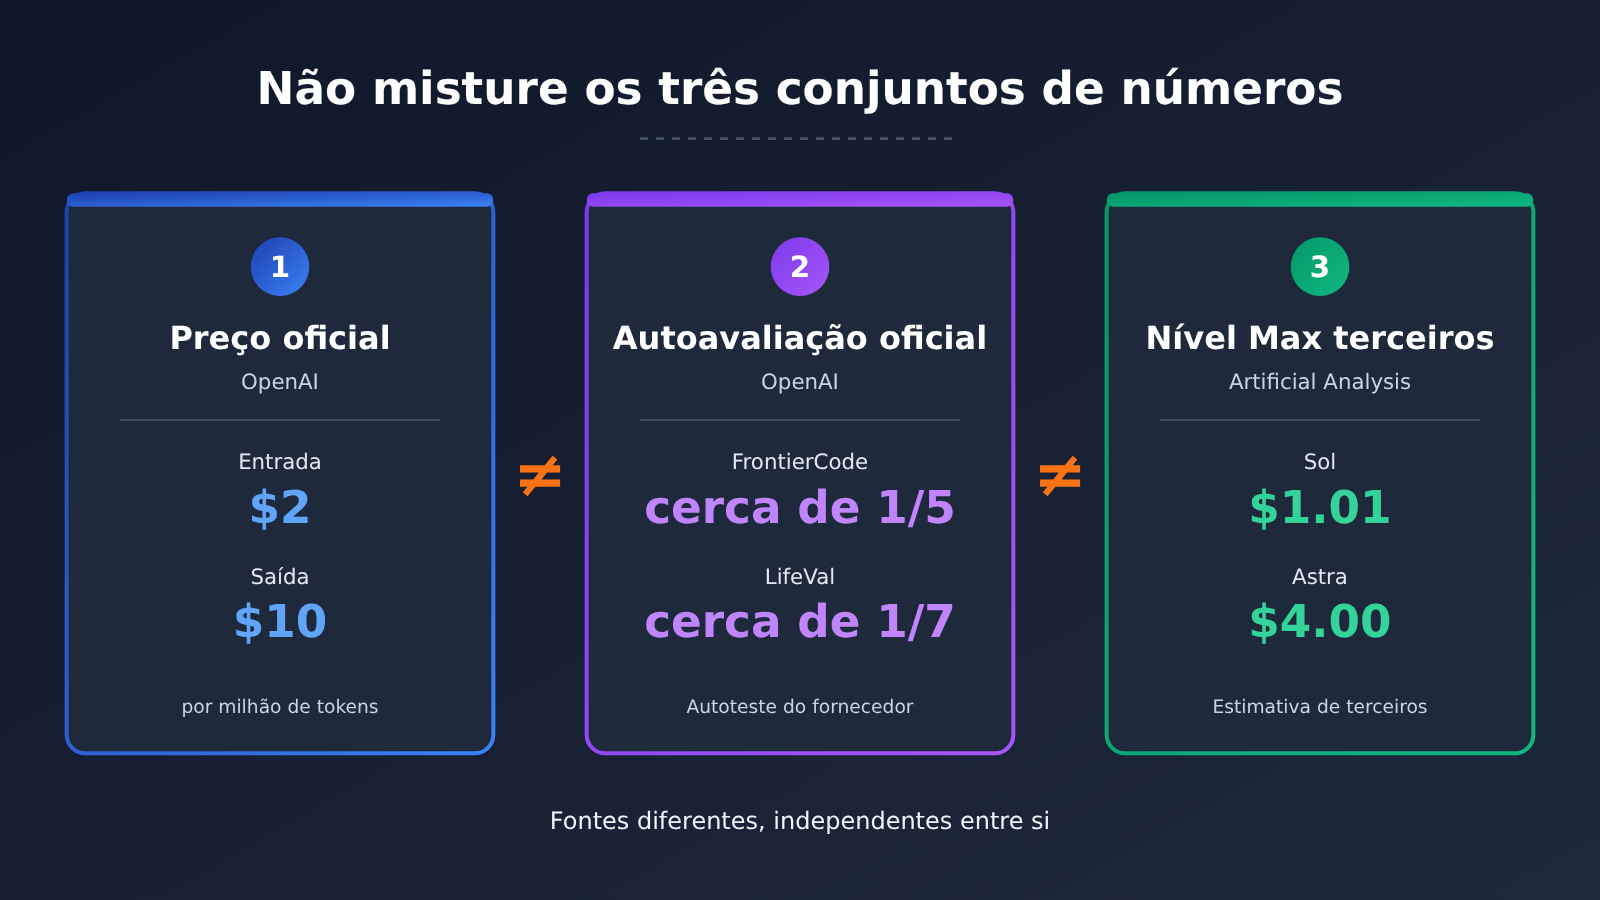
Na publicação de lançamento há uma afirmação que é fácil de interpretar errado: no FrontierCode 2.0 da Cognition — que avalia se as alterações em repositórios de código reais podem ser mescladas pelos mantenedores —, o GPT-6.2 Sol e o GPT-6.2 Astra ficam a menos de 0,5 ponto um do outro, com custo de cerca de um quinto, ambos no nível de raciocínio Max. Trata-se de um número autoinformado pela própria OpenAI, e que vale apenas para essa avaliação.
Isso não significa que o Sol custe um quinto do que o Astra em cada requisição. Pelos preços de tabela, o Sol custa $2 na entrada e $10 na saída, enquanto o Astra custa $8 e $40 — a proporção entre os preços unitários é de um quarto. A proporção real de custo de cada requisição também depende de quantos tokens cada modelo consome na mesma tarefa. O consumo de tokens varia bastante entre tarefas diferentes, então a proporção naturalmente muda junto. Outro dado autoinformado oficialmente é o do LifeVal: o Sol pontua acima do GPT-6 Astra, com custo de cerca de um sétimo — que, da mesma forma, se aplica apenas àquele conjunto de tarefas.
Os números da Artificial Analysis, uma fonte independente de terceiros, seguem outro sistema. No Intelligence Index v5.0.1 deles, o Sol obteve 57 pontos no nível de raciocínio Max, com custo por tarefa no índice composto de $1.01; o Astra obteve 62 pontos no mesmo nível, com custo por tarefa de $4.00. Esse $1.01 pertence apenas ao conjunto de avaliações do índice composto: não pode ser multiplicado ou dividido pelo “um quinto” oficial do FrontierCode, nem tratado como o custo de cada requisição no seu negócio.
Comparação de preços de tabela oficiais do GPT-6.2 Sol com outros modelos
| Modelo (preço de tabela oficial, por 1 milhão de tokens) | Entrada | Saída | Leitura de cache | Regra de contexto ultralongo |
|---|---|---|---|---|
| GPT-6.2 Sol | $2 | $10 | $0.10 | Acima de 272K, sobretaxa na requisição inteira |
| GPT-6.2 Astra | $8 | $40 | $0.40 | Acima de 272K, sobretaxa na requisição inteira |
| Claude Fable 5.2 | $8 | $40 | $0.20 | Regra não listada na documentação |
| Claude Opus 5.5 | $4 | $20 | $0.20 | Regra não listada na documentação |
| Gemini 4 Carbon (até 30/11) | $2 | $10 | $0.10 | A tabela de preços do Google não prevê dobra da requisição inteira acima de 272K |
| Gemini 4 Carbon (a partir de 01/12) | $4 | $20 | $0.20 | Idem |
Todos os valores da tabela são preços de tabela oficiais dos fabricantes, não os preços da plataforma APIYI. O preço de tabela oficial do GPT-6.2 Astra é: entrada $8, leitura de cache $0.40, escrita de cache de 30 minutos $10 e saída $40. Assim como o gpt-6.2-sol, ele ainda não está disponível na APIYI; vamos publicá-lo o quanto antes — os modelos e preços válidos são os da lista de modelos da plataforma. Além disso, o Gemini 4 Carbon aparece na página de informações da APIYI com preço de lançamento; o preço oficial vai subir em 01/12/2026, então a partir dessa data siga a lista da plataforma.
💡 Dica de escolha: a tabela de preços unitários só reflete a diferença de preço para a mesma quantidade de tokens — ela não indica qual modelo sai mais barato no conjunto das suas tarefas. Recomendo comparar os modelos já disponíveis na APIYI (apiyi.com) usando o mesmo lote de requisições reais, observando o usage e os resultados, antes de tomar a decisão.
Perguntas Frequentes (FAQ)
Q1: Como o GPT-6.2 Sol é precificado e por que os valores são calculados separadamente?
O GPT-6.2 Sol é cobrado por 1 milhão de tokens em quatro colunas separadas: entrada ($2), leitura de cache ($0.10), escrita de cache ($2.50 por 30 minutos, $5 por 12 horas) e saída ($10) — esses são os preços-padrão oficiais para contexto curto. Como os preços unitários das quatro colunas podem diferir em mais de cem vezes entre si, estimar apenas pelo total de tokens gera uma distorção grave.
Q2: Depois de ultrapassar 272K, o preço extra vale só para a parte excedente?
Não. A página do modelo deixa claro que a cobrança é calculada sobre o pedido inteiro: assim que a entrada da requisição ultrapassa 272K, os preços unitários de entrada e de cache desse pedido dobram, e o de saída passa a valer 1,5 vez. Quando a entrada fica exatamente perto da linha de corte, vale a pena considerar comprimir o contexto para caber dentro dos 272K.
Q3: Quando o GPT-6.2 Sol foi lançado e onde está disponível?
A OpenAI lançou o modelo em 17/11/2026. Segundo o comunicado oficial, assinantes Plus, Pro, Enterprise e Edu podem usar no ChatGPT Work e no Codex, desenvolvedores podem fazer a invocação do modelo pela API da OpenAI, e o Ultrafast já estava disponível no lançamento. Ele ainda não está disponível na APIYI, mas vamos adicioná-lo o quanto antes; os modelos e preços de referência são os da lista de modelos da plataforma.
Q4: Se a escrita de cache custa mais que a entrada normal, ainda vale a pena usar?
Depende da frequência de reutilização. A escrita de cache de 30 minutos custa $0.50 a mais por milhão que a entrada normal, enquanto cada acerto posterior economiza $1.90. Se um trecho de prefixo for acessado mais de uma vez dentro de 30 minutos, geralmente o investimento se paga. A escrita de cache de 12 horas custa $5 e serve para prefixos fixos reutilizados com alta frequência ao longo do dia.
Q5: Como treinar o fluxo de estimativa de custos antes do 6.2 ficar disponível?
É possível ensaiar com o gpt-6.1-sol, que já está disponível. Segundo a documentação oficial, o 6.2 Sol herda os preços de token dele. Depois de se registrar na APIYI (apiyi.com) e resgatar o crédito de teste, use um cliente compatível com a OpenAI, defina a base URL como `https://api.apiyi.com/v1`, registre as quatro colunas do campo usage e aplique as fórmulas deste artigo. Atenção: o preço na plataforma do gpt-6.1-sol é apenas o do modelo anterior, e não significa que o 6.2 já esteja disponível.
Q6: O multiplicador do Ultrafast vai mudar?
Vai. Até 28/02/2027 (horário do Pacífico), o preço será 3 vezes o valor padrão; a partir de 01/03/2027, passa a ser 6 vezes. Para orçamentos de longo prazo, a recomendação é usar 6 vezes como teto logo de cara.
Q7: Quais são as limitações conhecidas do GPT-6.2 Sol?
A intensidade de raciocínio não pode ser definida como `none`, então não dá para reduzir o custo de saída desativando o raciocínio. Ele não aceita entrada de áudio e vídeo, nem oferece suporte a Realtime, Assistants e fine-tuning. Segundo a Artificial Analysis (análise de terceiros), o Sol ficou 14 pontos abaixo do 6.1 Sol no SWE-Atlas-QnA-AA e tende a omitir fatos-chave com mais frequência. A avaliação oficial de alinhamento também aponta que, em parte dos testes, o modelo tende a deixar de reportar problemas bloqueantes, como arquivos ausentes e ferramentas indisponíveis.
Pontos essenciais da precificação do GPT-6.2 Sol — Key Takeaways
- Cobrança em quatro colunas: entrada $2, leitura de cache $0.10, escrita de cache $2.50 ou $5, saída $10 (preço oficial para contexto curto)
- Regra do pedido inteiro acima de 272K: assim que o limite é ultrapassado, os preços de entrada e de cache de todo o pedido dobram, e a saída passa a custar 1,5x
- O tier tem o maior impacto: Batch 0,5x, Fast 2x, Ultrafast 3x — e 6x a partir de março de 2027
- O “um quinto” tem condições: vale apenas para o FrontierCode 2.0 (tier Max) autorreportado oficialmente, e não significa que todos os pedidos serão assim
- Números de terceiros, análise à parte: os $1.01 do tier Max no Artificial Analysis pertencem apenas à metodologia do índice composto dessa avaliação
- Por onde começar: antes do 6.2 chegar ao catálogo, você já pode usar o gpt-6.1-sol na APIYI (apiyi.com) para deixar o fluxo de registro de usage rodando ponta a ponta
Resumo
Pontos essenciais da precificação do GPT-6.2 Sol:
- Cálculo por colunas: entrada, leitura de cache, escrita de cache e saída — cada uma das quatro colunas é multiplicada pelo respectivo preço unitário, e a escrita de cache não pode ficar de fora da conta.
- Primeiro, verifique os 272K: depois de ultrapassar o limite, o pedido inteiro passa a usar os preços longos; no exemplo 2, aplicar os preços curtos por engano subestimaria o custo em quase metade.
- Por último, multiplique pela taxa: o multiplicador do tier define a ordem de grandeza da conta, e a data de virada do Ultrafast precisa entrar no planejamento do orçamento.
Na hora de estimar custos, comece usando a fórmula do exemplo curto para calcular o valor das requisições do dia a dia, depois use o exemplo ultralongo para conferir os casos de fronteira e, por fim, registre separadamente o autorreporte oficial, as avaliações de terceiros e o seu próprio usage — não misture tudo numa única conclusão.
Recomendo validar as estatísticas de usage e o modelo de custos na APIYI (apiyi.com) com os modelos já disponíveis. Quando o gpt-6.2-sol chegar ao catálogo, basta trocar o ID do modelo e os preços unitários para continuar usando a mesma lógica.
📚 Referências
-
Post de lançamento da OpenAI: apresentação do GPT-6.2 Astra e do Sol, incluindo as avaliações auto-relatadas oficialmente e um resumo da precificação
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Descrição: fonte dos dados auto-relatados oficialmente, como FrontierCode, LifeVal e outros
- Link:
-
Página do modelo gpt-6.2-sol na OpenAI: especificações, preços em quatro colunas, regra dos 272K e multiplicadores por nível
- Link:
platform.openai.com/docs/models/gpt-6.2-sol - Descrição: principal base das regras de precificação deste artigo
- Link:
-
System Card da OpenAI: avaliações de segurança e alinhamento
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Descrição: para conhecer as estratégias de proteção e as limitações de comportamento conhecidas
- Link:
-
Avaliação independente da Artificial Analysis: pontuações por nível de raciocínio e custo por tarefa no Intelligence Index v5.0.1
- Link:
artificialanalysis.ai/models/gpt-6-2-sol - Descrição: dados de terceiros; o custo por tarefa de US$ 1,01 no nível Max se aplica apenas a este conjunto de avaliações
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Sinta-se à vontade para entrar em contato conosco pela página inicial do site da APIYI e obter mais materiais sobre integração de modelos e faturamento


