
作者注:拆解 Claude Fable 5.2 在 RoboDojo Sim 上的 64.9%:它在什麼條件下得出、和 Opus 5.5、GPT-6 Astra 差多少、哪些事它證明不了,以及接入前要算清的價格與限制。
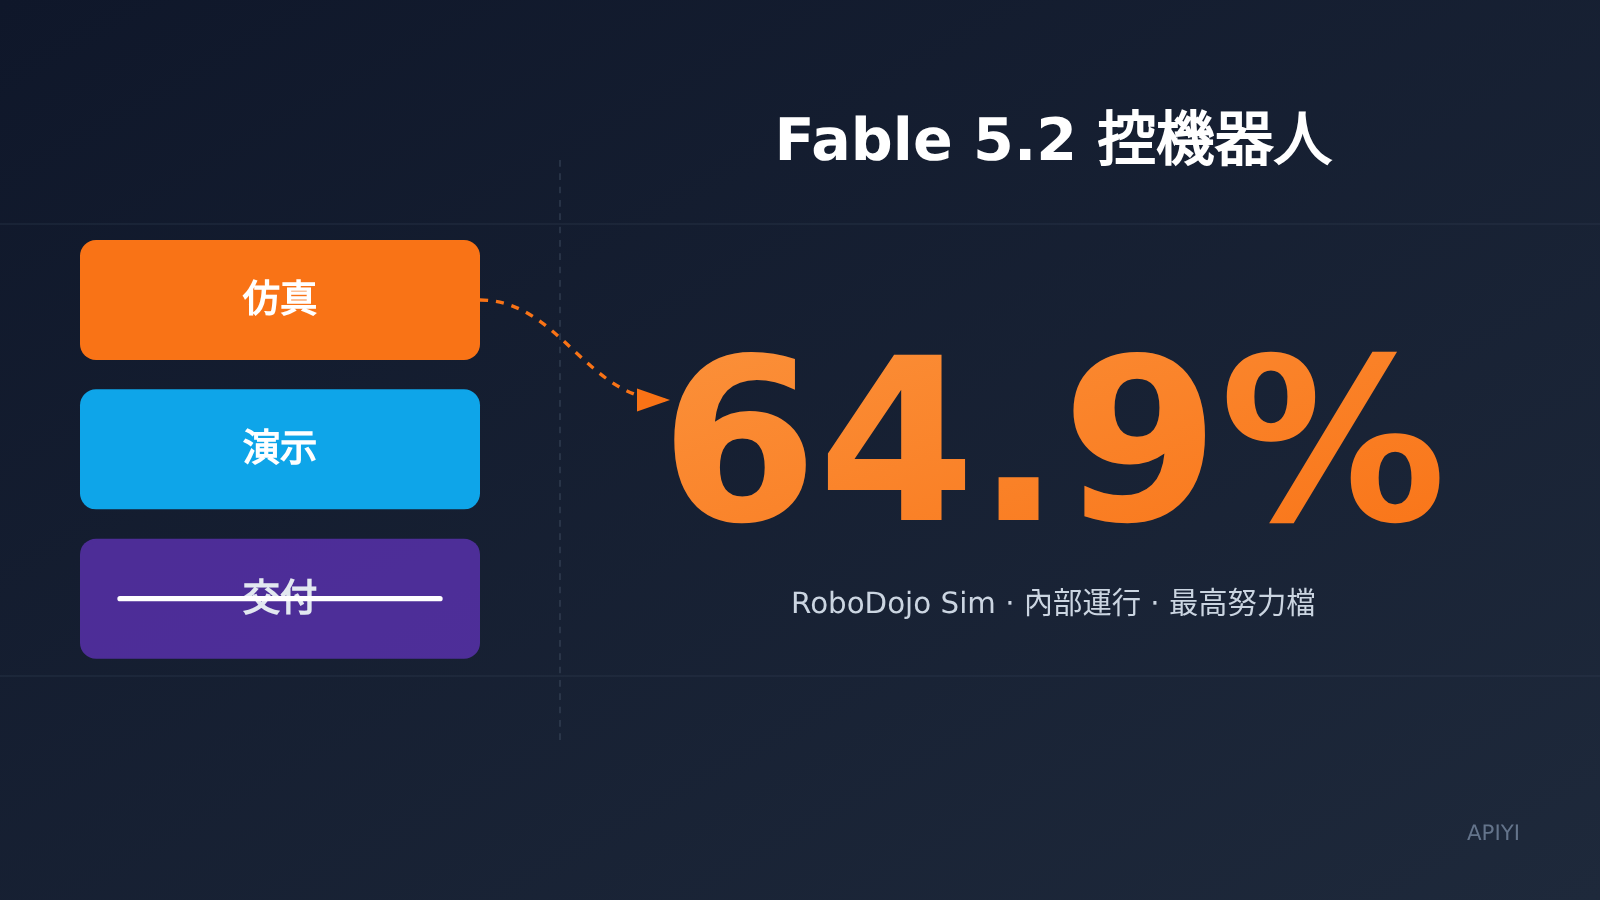
先說結論。在 Anthropic 內部運行、最高努力檔的 RoboDojo Sim 上,Claude Fable 5.2 是 64.9%,Opus 5.5 是 39.4%,GPT-6 Astra 是 29.8%,Fable 5.1 是 27.6%。這是模型看攝像頭圖像、控制模擬雙臂的成績,不是工廠交付記錄。
這不是一篇“機器人時代來了”的宣傳稿。 下面把仿真分數、演示視頻和真實部署拆開講。如果你正準備接 API、算成本,讀完能判斷現在該不該爲這 64.9% 改技術路線。
核心價值:分清 Fable 5.2 的 64.9% 證明了什麼、沒證明什麼,以及現在能調用哪個模型做前期驗證。
Claude Fable 5.2 的 64.9% 到底是什麼
這個數字可以用三句話說清。RoboDojo 是一個公開基準,測的是模型能否根據攝像頭圖像控制模擬環境裏的雙臂機器人。發佈文腳註寫明,64.9% 是 Anthropic 內部運行、使用最高可用努力檔得到的結果。截至 2026-11-10,我們沒能從 RoboDojo 公開榜頁面覈對到同一個數字,所以它不能被寫成“公開榜第一”,更不能說成“世界最強機器人模型”。
下面是 Anthropic 在 2026-11-09 的發佈文裏給出的 RoboDojo Sim 對照:
| 模型 | RoboDojo Sim | 與 Fable 5.2 的差距 | 說明 |
|---|---|---|---|
| Claude Fable 5.2 | 64.9% | — | 內部運行,最高努力檔 |
| Claude Opus 5.5 | 39.4% | 低 25.5 個點 | 同一張表 |
| GPT-6 Astra | 29.8% | 低 35.1 個點 | 由 Anthropic 跑出,不是 OpenAI 自報 |
| Claude Fable 5.1 | 27.6% | 低 37.3 個點 | 上一代 |
| Gemini 4 Carbon | 表上爲空 | 無法比較 | 沒有數字,不能當 0 看 |
從 27.6% 到 64.9%,代際提升超過兩倍,跨度在整張成績表裏非常顯眼。但這個分數有三個前提:仿真環境、內部運行、最高努力檔。任何一個前提換掉,比如改成真機、改成第三方複測或用默認努力檔,這個數字都不能直接搬過去。
Fable 5.2 和 Mythos 5.2 是什麼關係
發佈文寫得很清楚:Claude Fable 5.2 和 Claude Mythos 5.2 是同一個底層模型。Fable 帶更強的網絡安全和生物安全護欄,所以對所有用戶開放。Mythos 只開放給通過生命科學或網絡安全覈驗項目的組織。Mythos 不是“更強的另一個模型”,做機器人方向的評估時,看 Fable 5.2 就夠了。
官方模型 ID 如下:
- Claude API、Google Cloud、Microsoft Foundry、Claude Platform on AWS:
claude-fable-5-2 - Amazon Bedrock:
anthropic.claude-fable-5-2 - Mythos 對應爲
claude-mythos-5-2和anthropic.claude-mythos-5-2
Fable 5.2 控機器人的核心功能:演示裏有什麼
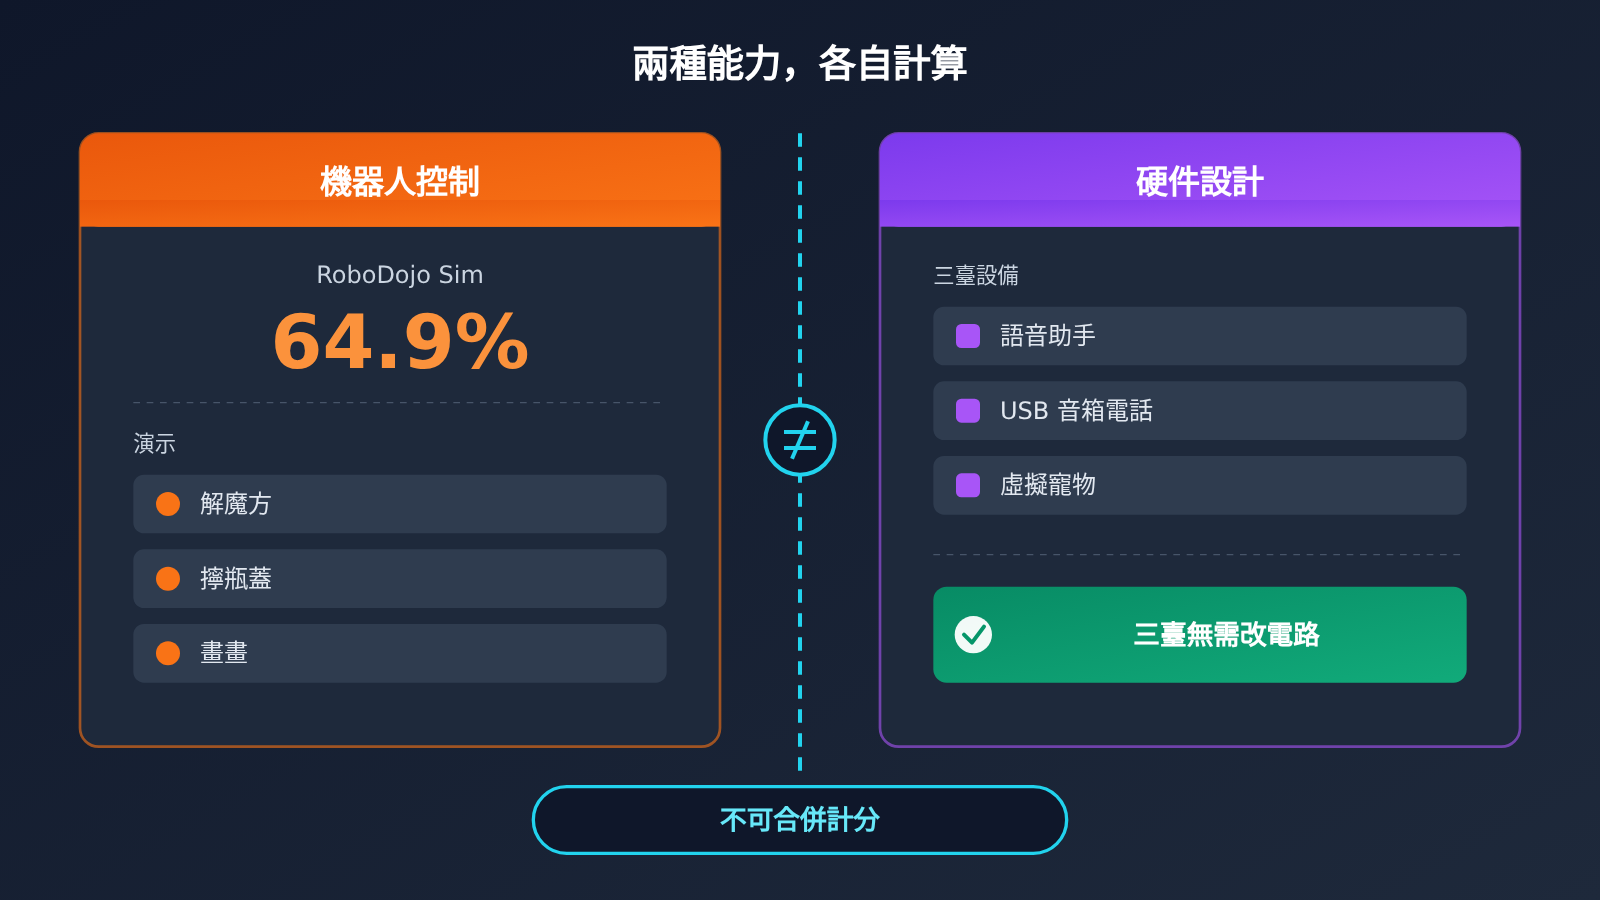
發佈文稱,Fable 5.2 控制物理機器人的能力比更早的 Claude 明顯更好,其中包括沒有專門訓練過的任務。配套演示視頻裏有三個場景:解魔方、擰瓶蓋、畫一張機器人圖。
這些內容應該按“發佈文裏的演示”來理解。演示能說明模型在特定設置下完成過這些動作,但說明不了成功率、重試次數和失敗比例,也不代表 Anthropic 推出了可以直接安裝的機器人技能包。官方說其中有未經專門訓練的任務,這一點值得關注,但它仍然是官方自述,沒有附上獨立復現的數據。
發佈文還說,Fable 5.2 在同一套測試套件上超過了其他前沿模型,也超過了大多數專門爲控制機器人設計的系統。後半句沒有附名單,讀者無從知道比的是哪些系統、用的是什麼版本。這句話可以當作方向性信號,不能當作結論。
模型輸出的是文字,控制靠外部套件
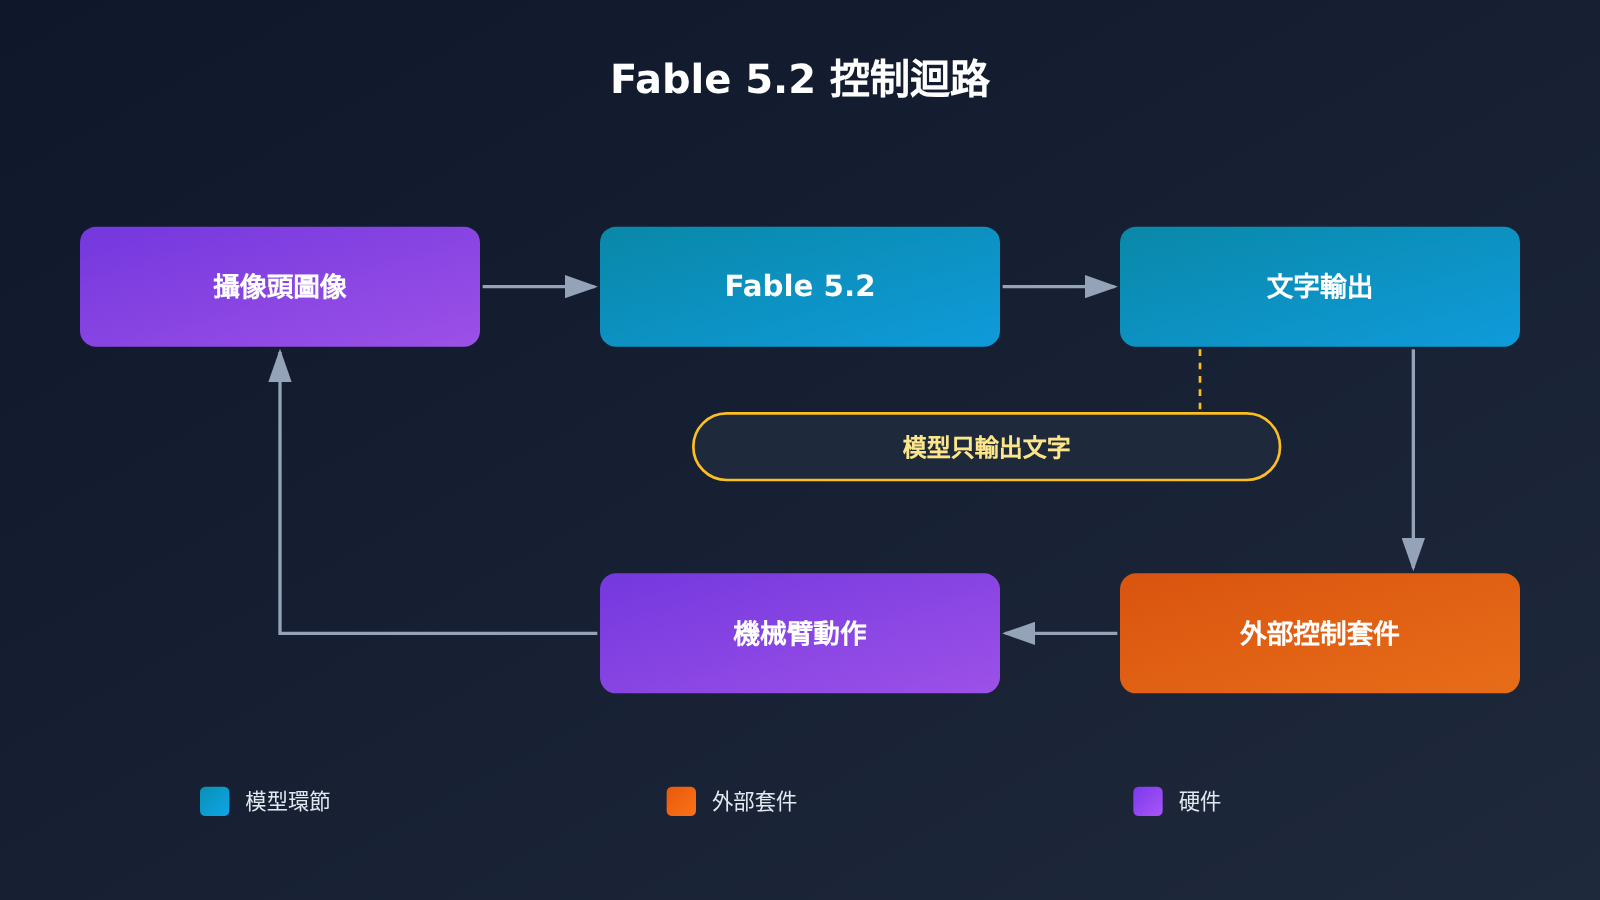
這一點最容易被演示視頻掩蓋。模型頁寫明,Fable 5.2 的輸入是文字和圖片,輸出只有文字。它不會直接發出電機指令,每一步都要由外部套件把文字解析成動作,再把新的攝像頭畫面送回模型。
所以,真實場景裏的控制效果,一半取決於模型,另一半取決於你的套件:動作空間怎麼定義、解析失敗時怎麼兜底、單步延遲能不能接受。RoboDojo 的 64.9% 是在 Anthropic 自己的套件上跑出來的,換一套套件,分數會如何變化,目前不知道。
Fable 5.2 實測數據:機器人的差距和電腦操作的差距不是一回事
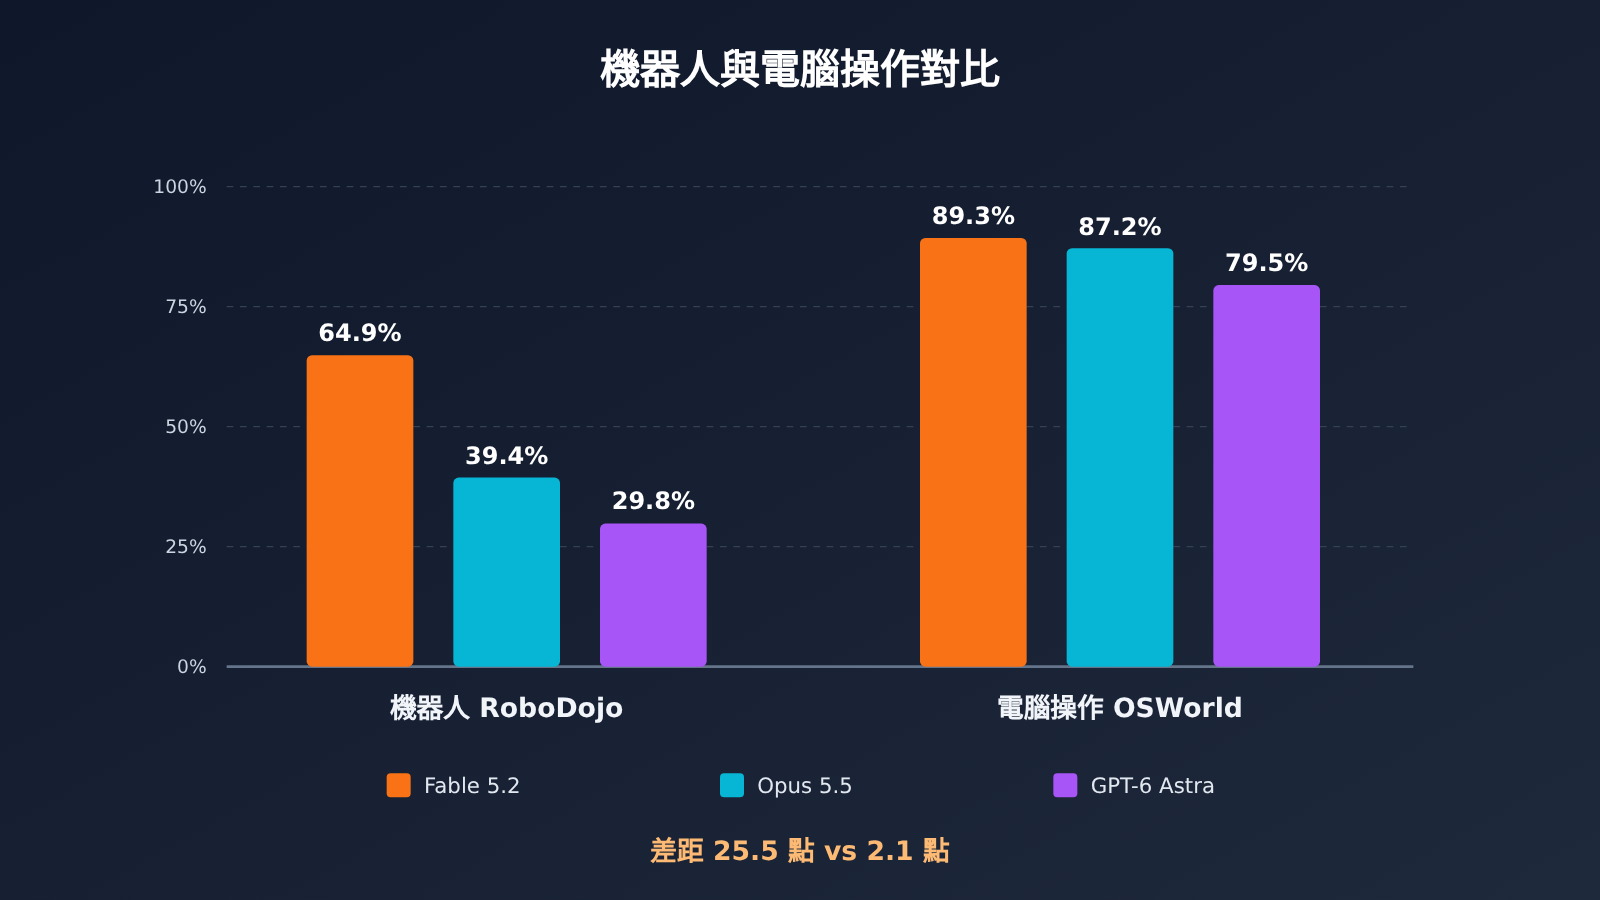
很多人看到“Fable 5.2 很強”,會順手把機器人分數和其他項目混在一起理解。下面這張表全部來自 Anthropic 在 2026-11-09 的發佈文,用來對比幾項與“操控”相關的測試中差距的大小:
| 測試項 | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Fable 5.2 領先 Opus 5.5 |
|---|---|---|---|---|
| RoboDojo Sim(模擬雙臂) | 64.9% | 39.4% | 29.8% | 25.5 個點 |
| OSWorld 2.1(電腦操作,離線集部分) | 89.3% | 87.2% | 79.5% | 2.1 個點 |
| AutomationBench | 51.4% | 42.5% | 41.4% | 8.9 個點(Carbon 爲 53.9%,更高) |
| Remote Labor Index(High 檔) | 41.3% | 21.3% | 20.8% | 20.0 個點 |
在 OSWorld 2.1 上,Fable 5.2 只比 Opus 5.5 高 2.1 個點。這個差距和 RoboDojo 上從 39.4% 到 64.9% 的跨度不是一個量級。如果你的需求是電腦操作類的代理任務,Opus 5.5 和 Fable 5.2 的差別遠沒有機器人項目那麼大。
努力檔:64.9% 不是默認檔的成績
發佈文的成績表除另有標註外,用的都是每個模型當時可用的最高努力檔。Fable 5.2 在 Claude API 中的默認 effort 是 high,在 Claude 應用和 Claude Code 中默認是 Medium。也就是說,你用默認參數調用時,拿到的不一定是 64.9% 對應的那套配置。
最高檔意味着更長的思考和更多 token。在機器人這種要求反覆決策的迴路裏,每一步都按最高檔推理,延遲和成本都會被放大。至於 64.9% 在 high 或 medium 檔下會降到多少,發佈文沒有給出。
規格對照:Fable 5.2、Opus 5.5 與 GPT-6 Astra
| 項目 | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| 上下文 | 1M | 1M | 1,050,000 |
| 最大輸出 | 128K | 128K | 128,000 |
| 輸入 / 輸出模態 | 文字 + 圖片 / 文字 | 文字 + 圖片 / 文字 | 文字 + 圖片 / 文字 |
| API 默認努力檔 | high | medium | 支持 low 至 max |
| 延遲檔位 | Moderate | Moderate | 官方頁未用同一口徑 |
| 知識截止 | 2026 年 6 月 | 2026-06 | 2026-04-30 |
三者的輸出都是文字,這是做機器人控制時無法繞開的共同前提。
Fable 5.2 不能算進機器人分數的事
三臺電子設備是硬件設計實驗
發佈文裏還有一段:用一段話的提示,讓 Fable 5.2 設計出三臺能工作的電子設備,分別是家庭語音助手、USB 音箱電話和手持虛擬寵物。這個項目與 Diode 合作完成,每塊電路板不到一天即可生產,三臺設備都無需修改電路就能工作。
這件事展示的是硬件設計能力,與 RoboDojo 無關,設備本身也不是機器人。把它和 64.9% 放在一起,容易讓人產生“從設計到控制都能包辦”的印象,但兩件事沒有交集。
Fable 5.2 的能力邊界:會影響控制迴路的限制
以下內容來自模型頁和更新說明。每一條都會直接影響你搭建的控制迴路:
- 強制工具調用會報錯:
tool_choice設爲any或tool會返回 400。如果你的套件依賴“必須調用動作工具”,需要改成讓模型自主選擇,再做解析兜底。 - 採樣參數不可設置:傳入
temperature、top_p、top_k會返回 400。 - 思考無法關閉:自適應思考常開,只能通過 effort 調節思考量。更新說明提到,在 medium 及以上檔位,提示詞裏寫“不要思考、直接回答”也無法讓它停止思考。
- 長工具鏈中很少說話:連續調用工具時,模型面向用戶的輸出可能很少,也可能不做說明就直接調用工具。監控界面不能依賴它主動報告進度。
- 可能提前停下:有時一輪結束就停,留下待辦清單,或者被一個普通障礙卡住。low 檔位下更常見。
- 拒絕也佔額度:被拒絕時返回 HTTP 200,
stop_reason爲refusal,同樣會佔用速率額度。 - 數據保留:要求保留 30 天數據,除非獲得 Anthropic 明確授權,否則不能走零數據保留。
機器人迴路對“每一步都給出可執行動作”的要求很高。上面幾條加在一起意味着,把模型接入控制迴路前,你需要先把超時、空動作、拒絕和中途停止都設計成可以恢復的狀態。
Fable 5.2 價格:接入前先算清楚
官方價格以每百萬 token 計,來自模型頁、更新說明和快速模式頁:
| 計費項 | Fable 5.2 | Opus 5.5 | GPT-6 Astra(短上下文) |
|---|---|---|---|
| 標準輸入 / 輸出 | $8 / $40 | $4 / $20 | $10 / $50 |
| 緩存讀 | $0.20 | $0.20 | $1(緩存輸入) |
| 緩存寫 | 5 分鐘 $10,1 小時 $16 | 官方頁有,本文未列 | $12.5 |
| 批量 | 按批量 5 折計算爲 $4 / $20 | 同爲 5 折 | 本文未列 |
| 快速模式 | $16 / $80 | $8 / $40 | — |
另外幾點需要注意。Fable 5.2 比 Fable 5.1($10 / $50)便宜 20%。快速模式能力不變,輸出速度最高可達標準模式的 2.5 倍,但官方沒有單獨給出快速模式下的緩存價格;按倍率推算,緩存讀約爲 $0.40,5 分鐘緩存寫約爲 $20,1 小時緩存寫約爲 $32。不同速度模式之間不共享提示緩存,從快速模式切回標準模式會導致緩存未命中。GPT-6 Astra 的輸入超過 272K token 後,整單按輸入 2 倍、輸出 1.5 倍計價。
機器人迴路的特點是每步都要傳一張新圖片,前面的系統提示和動作說明則基本不變。這類結構適合用緩存降低成本,但每步的圖片輸入和思考 token 無法省掉。
現在能調用 Fable 5.2 嗎:API易 上架情況
截至 2026-11-10,API易 apiyi.com 的模型總表和公開價格接口裏都還沒有 claude-fable-5-2,也沒有任何 Mythos 型號。我們會盡快推出此模型。型號與價格以平臺型號列表爲準。 在它上架之前,本文不提供 Fable 5.2 在 API易 上的價格,也不會用分組倍率去換算官方價。
當天在 API易 總表中已經可以調用的相關型號如下(列表標價,單位爲美元 / 百萬 token):
| 型號 ID | 輸入 / 輸出 | 緩存讀 | 端點 | 適合用來做什麼 |
|---|---|---|---|---|
claude-opus-5-5、claude-opus-5-5-thinking |
$4 / $20 | $0.2 | chat、messages | 先搭建工具調用和電腦操作迴路 |
claude-fable-5-1、claude-fable-5-1-thinking |
$10 / $50 | $0.25 | chat、messages | 作爲上一代基線對比 |
claude-fable-5、claude-fable-5-thinking |
$10 / $50 | $1 | chat、messages | 歷史版本對比 |
gpt-6-astra |
$10 / $50 | $1 | responses(主)、chat | 跨廠商對照 |
總表上的價格是列表標價,實際扣費還要乘以令牌分組倍率,以賬單爲準。gpt-6-astra 的腳註只寫了輸入階梯(272,000 token 以內 $10,272,001 到 1,050,000 爲 $20),長上下文的輸出價沒有寫,以控制檯賬單爲準。接入時使用 OpenAI 兼容接口,base_url 填 https://api.apiyi.com/v1 即可。
比較實際的做法是:先用 claude-opus-5-5 把圖片輸入、動作解析和失敗恢復跑通,等 Fable 5.2 在 API易 上架後再替換型號 ID 做對比。機器人這一項的差距(25.5 個點)比電腦操作(2.1 個點)大得多,所以等 Fable 5.2 是有理由的,但僅憑演示視頻做決定還不夠。
Fable 5.2 機器人能力的優缺點分析
優勢
- 代際跨度大:RoboDojo Sim 從 27.6% 提升到 64.9%,是整張成績表中提升最明顯的項目之一。
- 相對同類領先明顯:比 Opus 5.5 高 25.5 個點,比 GPT-6 Astra 高 35.1 個點(數據來自 Anthropic 發佈文)。
- 單價下降:標準價比 5.1 低 20%,緩存讀爲 $0.20。
- 視覺輸入一致:圖片輸入、1M 上下文,可以容納較長的多步視覺歷史。
侷限
- 證據層級偏弱:內部運行、最高努力檔,公開榜沒有核對到同一數字,也沒有獨立複測。
- 只有仿真數據:演示視頻不提供成功率,“超過大多數專門機器人系統”的說法沒有附名單。
- 迴路約束多:只輸出文字、無法強制調用工具、思考無法關閉、長鏈中很少主動說明。
- 最高檔成本高:分數基於最高努力檔,實際部署時的延遲和 token 消耗需要自己測量。
什麼時候不該據此換模型
如果你沒有自己的仿真環境或真機迴路,這 64.9% 對你沒有可驗證的意義,因爲你沒法確認它在你的設置下是否成立。如果你的需求是網絡安全、生物相關或日常寫代碼,這個分數也證明不了什麼,那些場景應該看對應的測試項。發佈文自己的建議是:大多數編碼和知識工作先從 Opus 5.5 開始,再按難度升級或降級。
常見問題 FAQ
Q1: Fable 5.2 的 64.9% 是公開榜成績嗎?
不是。發佈文腳註寫明這是 Anthropic 內部運行的結果。RoboDojo 本身是公開基準,但截至 2026-11-10,我們沒能從公開榜頁面覈對到同一個數字。
Q2: 64.9% 是默認努力檔的成績嗎?
不是,是最高可用努力檔。Claude API 的默認檔位是 high,Claude 應用和 Claude Code 默認是 Medium。默認檔下能得多少分,發佈文沒有給出。
Q3: Fable 5.2 是不是超過了專門的機器人系統?
發佈文的說法是超過了“大多數專門爲控制機器人做的系統”,但沒有附名單。具體超過了哪些系統,目前不知道。
Q4: 爲什麼 Gemini 4 Carbon 在 RoboDojo 上沒有分數?
發佈文表格中這一格是空的,沒有說明原因。空白不等於 0 分,也不能據此推斷它的表現。
Q5: 現在怎麼通過 API 先做準備?
截至 2026-11-10,API易 apiyi.com 還沒有上架 `claude-fable-5-2`,我們會盡快推出此模型,型號與價格以平臺型號列表爲準。可以先用已上架的 `claude-opus-5-5` 跑通圖片輸入和工具調用迴路,上架後再切換型號對比。
Q6: 三臺電子設備能證明它會控制機器人嗎?
不能。語音助手、USB 音箱電話和虛擬寵物是與 Diode 合作的硬件設計實驗,屬於電路設計能力,和 RoboDojo 的雙臂控制分數無關。
Q7: 電腦操作類代理需要等 Fable 5.2 嗎?
必要性不大。OSWorld 2.1 上 Fable 5.2 是 89.3%,Opus 5.5 是 87.2%,只差 2.1 個點,而 Opus 5.5 的標準價只有 Fable 5.2 的一半。
Fable 5.2 機器人能力 Key Takeaways
- 分數含義:64.9% 是內部運行、最高努力檔下的模擬雙臂成績。
- 差距大小:比 Opus 5.5 高 25.5 個點,比 GPT-6 Astra 高 35.1 個點。
- 對照項:OSWorld 只領先 2.1 個點,兩種差距不能混爲一談。
- 演示定位:解魔方、擰瓶蓋、畫畫是發佈文中的演示,不是產品化技能。
- 迴路約束:只輸出文字,強制
tool_choice會返回 400,思考無法關閉。 - 上架狀態:截至 2026-11-10,API易 尚未上架,可先用
claude-opus-5-5搭建迴路。
總結
Claude Fable 5.2 在機器人控制上的進步是真實可見的信號:RoboDojo Sim 從上一代的 27.6% 提升到 64.9%,在 Anthropic 給出的對照中明顯領先。但這個數字的適用範圍很窄,只覆蓋仿真環境、內部運行和最高努力檔,不包括真機成功率,也不代表工廠交付能力。
如果你已經有自己的仿真或真機迴路,值得在 Fable 5.2 上架後跑一輪對比,同時提前把文字輸出解析、工具調用無法強制、思考無法關閉這些約束設計進去。如果你沒有迴路,或者要解決的是寫代碼、電腦操作類任務,就沒有必要因爲這 64.9% 改變現有方案。
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 首頁聯繫我們,型號上架進度以平臺型號列表爲準。


