
요약: 이 글은 한 가지 질문에 답해요. GPT-6.2 Sol이 프런트엔드 현업 사용자의 데이터 질의를 받아낼 수 있는지, 그리고 어떤 질문은 추가 검토가 필요한지요.
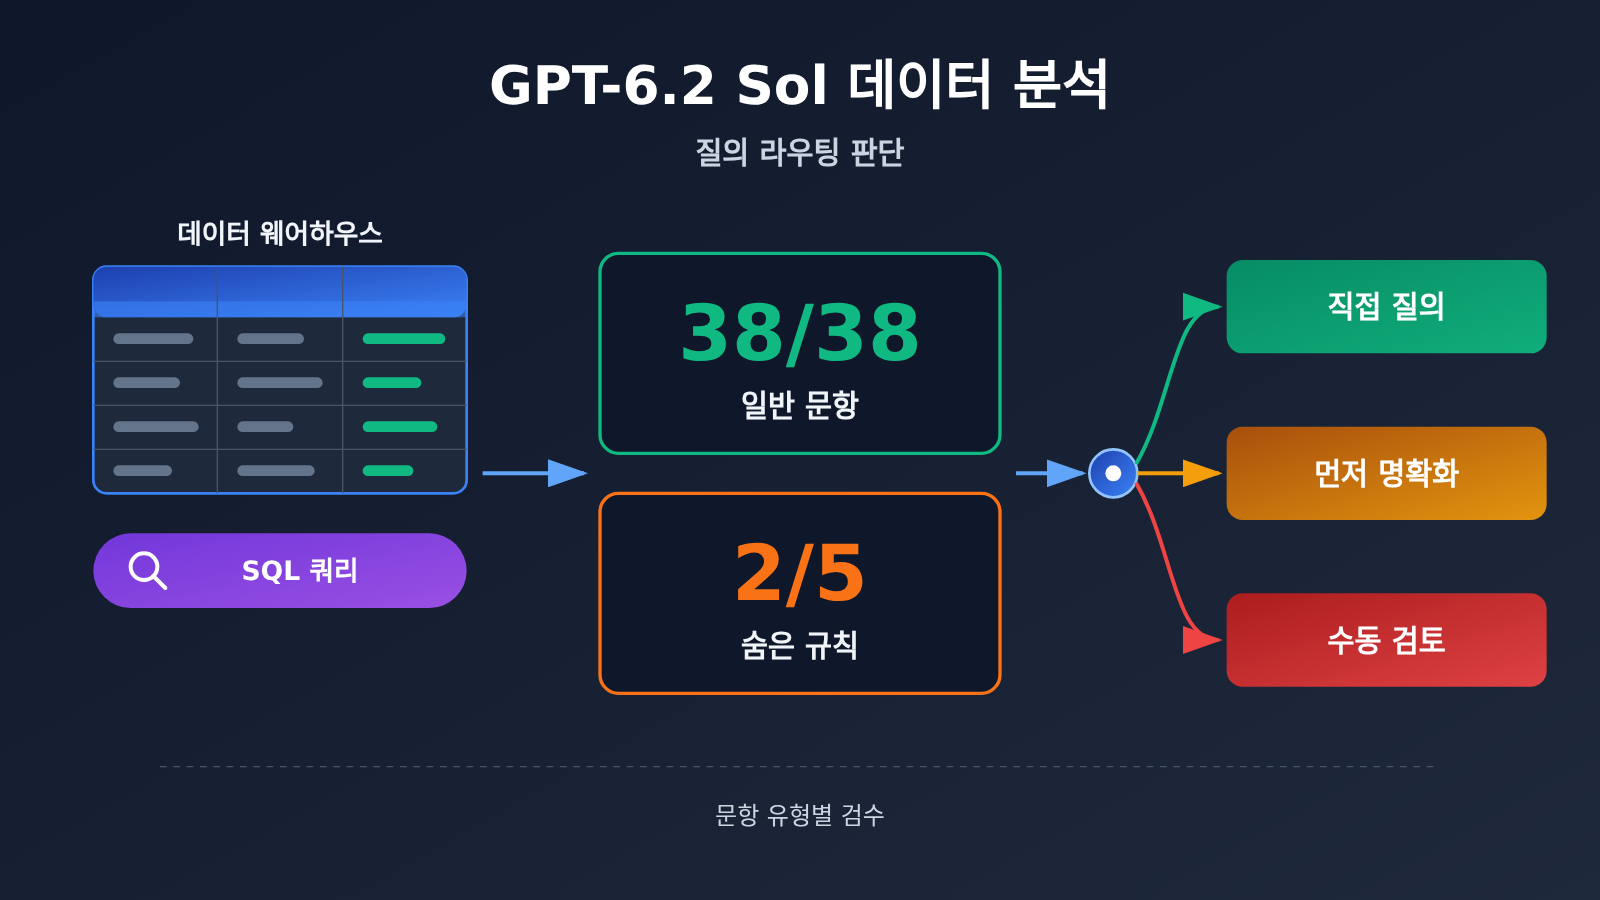
GPT-6.2 Sol의 데이터 분석 성능은 두 갈래로 나눠 볼 수 있어요. Plotly가 2026년 11월 17일에 공개한 단일 라운드 전용 테스트에서 이 모델은 일반 분석, 모호성 판단, 데이터로 답할 수 없는 질문, 데이터 품질, 통계적 함정이라는 다섯 가지 유형, 총 38문항을 전부 맞혔고, 문항당 소요 시간 중앙값은 약 10.5초였어요. 같은 라운드에서 숨은 패턴 문항 5개는 2개만 통과했어요.
여기서 이런 판단을 내릴 수 있어요: 지표 정의가 분명하고 영향이 작은 집계성 질의는 읽기 전용 권한 아래에서 Sol이 직접 답하도록 시범 운영해 보고, 정의가 빠져 있으면 먼저 되물어 명확히 하게 하고, 개방형 원인 분석과 대외 의사결정은 분석가가 재검토하게 해야 해요. 이 결론에는 세 가지 전제가 깔려 있어요. 테스트를 한 라운드만 돌렸다는 점, 문제 은행이 풍력 발전 기업을 가정한 영어 문항이라는 점, 비용이 OpenRouter 채널에서 나왔다는 점이에요. 여러분의 데이터와 채널로 바꿔 끼우면 문항 유형별로 다시 검증해야 해요.
GPT-6.2 Sol 데이터 분석 지식 지도와 읽기 안내
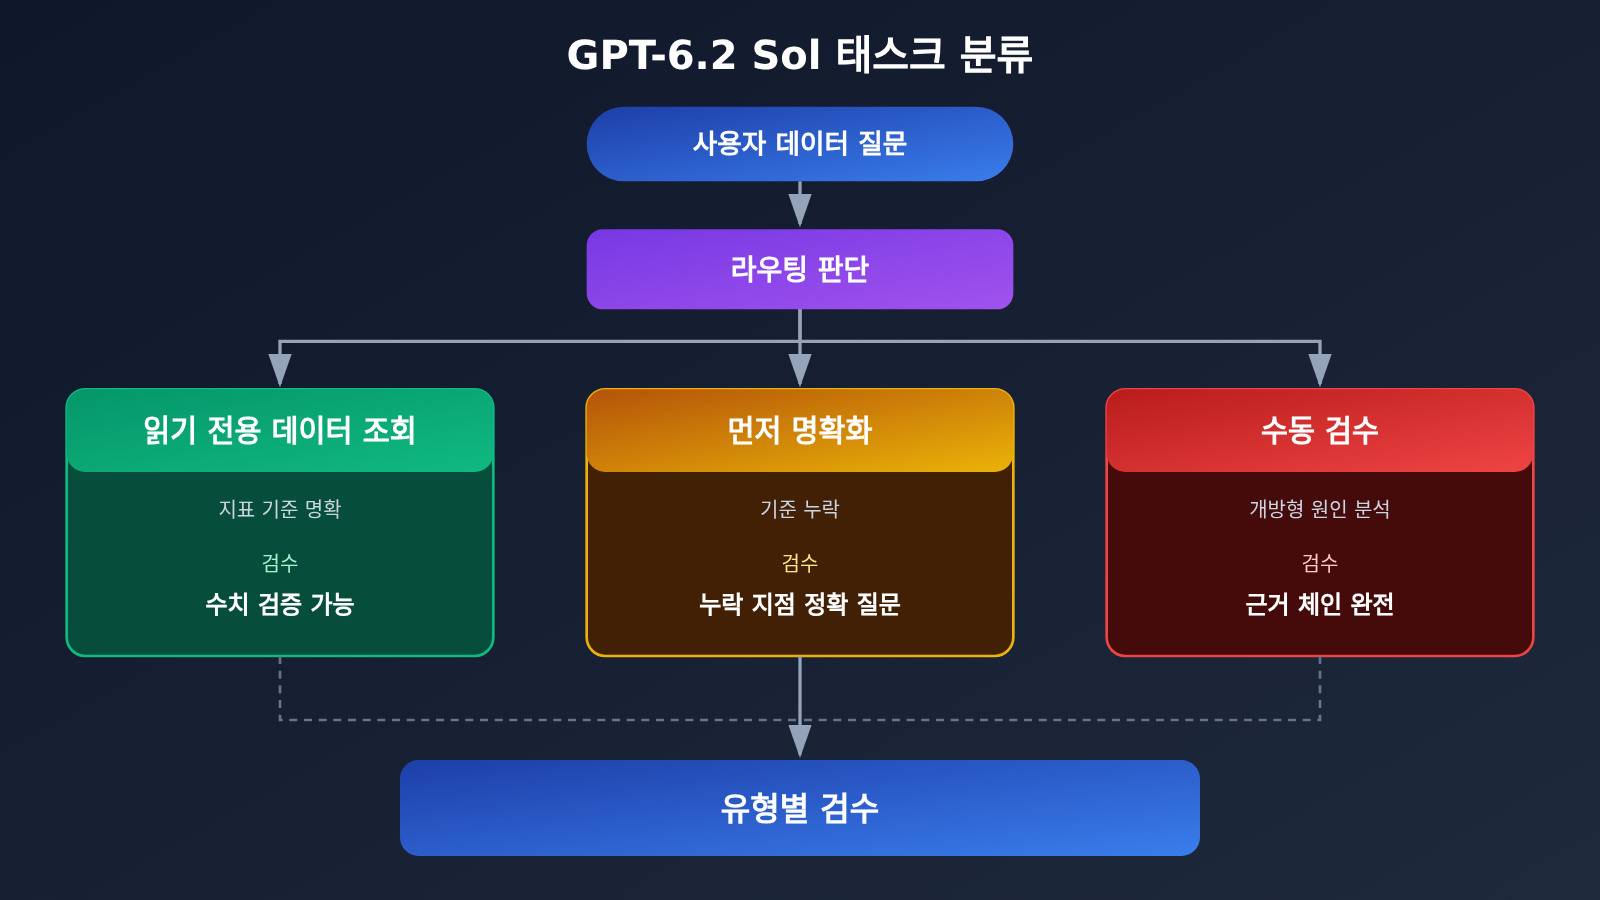
아래 그림은 전체 글의 작업 분기 로직이에요. 각 분기에는 입력 조건, 모델이 내놓아야 할 출력, 그리고 이 분기가 본문에서 갖는 번호가 적혀 있어요.
사용자가 데이터 질문을 제기
 │
 ├─ 기준 명확 + 영향이 낮은 요약 ──→ [1] Sol 읽기 전용 데이터 질의
 │                               출력: 수치 + 분자/분모 + 시간 범위와 시간대 + 쿼리 문
 │
 ├─ 기준 누락 / 데이터 부족 ────→ [3.2] 먼저 명확화
 │                               출력: 구체적인 재질문 + 선택 가능한 기준 목록
 │
 └─ 개방형 원인 분석 / 대외 의사결정 ──→ [3.3] 분석가 검토로 이관
                                 출력: 초기 점검 기록 + 뒷받침 증거 + 대안 설명 점검
            ↓
   [2] 지연과 단일 문제 비용으로 전면 배치 여부 결정
            ↓
   [4] 자체 데이터로 문제 유형별 검수, 데이터 날짜와 쿼리 증거가 포함된 결과 전달
각 절의 선후 관계는 다음과 같아요. 병렬로 배치된 3절은 필요에 따라 찾아볼 수 있고, 나머지 절은 순서대로 읽는 것을 권장해요.
| 절 번호 | 답하는 질문 | 다음 절에 제공하는 것 | 읽고 나서 할 수 있는 것 |
|---|---|---|---|
| 1 | Sol이 어떤 유형의 문제에서 안정적인가 | 문제 유형 경계: 38/38과 2/5 | 바로 데이터 질의할 수 있는 범위를 설정 |
| 2 | 전면 배치가 효율적인가 | 지연, 단일 문제 비용과 외삽 가정 | 대화형 시나리오의 예산과 대기 시간 판단 |
| 3 | 어떤 단서를 명확히 하거나 사람에게 이관할지 | 세 가지 감점 양태와 세 가지 출력 예시 | 라우팅 규칙 설계 |
| 4 | 자체 데이터로 어떻게 검수할지 | 문제 유형별 지표와 경계 | 재검증 가능한 산출물 생성 |
To Know: GPT-6.2 Sol 데이터 분석 관련 용어
| 용어 | 간단한 설명 |
|---|---|
| 데이터 워터하우스 | 업무 시스템에 흩어진 과거 데이터를 모아 조회 분석에 쓰도록 한 데이터 집합 |
| 지표 기준 | 지표의 정의, 필터 조건, 분자/분모와 시간 경계 |
| 읽기 전용 SQL | 검색과 집계만 수행하는 질의 방식으로, 데이터 원본은 읽기 전용 권한 유지 |
| 숨겨진 규칙 문제 | 데이터에 구조적 이상이 미리 심어져 있고, 문제는 단서만 제공하며 모델이 능동적으로 구체적 규칙을 찾아야 함 |
| 쿼리 증거 | 다른 사람이 결론을 재검증할 수 있게 하는 쿼리 문, 기준, 결과와 데이터 날짜 |
| p50 / p95 지연 | 절반의 요청이 완료되는 데 걸리는 시간 / 95% 요청이 완료되는 데 걸리는 시간 |
| 캐시 입력 | 업스트림 과금 시 재사용 가능한 입력 토큰으로 식별되며, 단가가 일반 입력보다 훨씬 낮음 |
| 문제 유형별 검수 | 데이터 질의, 명확화, 거부 응답, 탐색 등 문제 유형을 분리해 채점하여 총점이 특정 유형의 오류를 가리지 않도록 함 |
1. GPT-6.2 Sol로 데이터 분석하기: 안정적으로 검수할 수 있는 데이터 질의 결과부터 보기
1.1 Plotly 테스트는 무엇을 했나
Plotly는 Plotly Studio Embedded 테스트 프레임워크에서 OpenRouter를 통해 모델을 호출했고, 네 가지 읽기 전용 도구만 열어 두었어요. 데이터셋 목록 조회, SQL 쿼리 실행, 차트 그리기, 테이블 표시가 그것이에요. 테스트 저장소는 한 풍력 발전 기업을 모사했고, 약 1,990만 행의 데이터, 44개 테이블, 554개 컬럼으로 구성됐어요. 영어로 된 43개 문항을 정답 키와 채점 규칙에 따라 문항별로 통과 여부를 판정했어요. 채점 모델은 Claude Sonnet 5, temperature=0이며, 실점한 문항은 팀에서 직접 검토했어요.
이 설정은 기업 BI 데이터 질의의 실제 모습에 가까워요. 모델은 전체 데이터를 볼 수 없고, 스스로 테이블을 찾고 SQL을 작성한 뒤 결과를 읽고 답해야 하죠. 문제 은행과 정답 키는 Plotly가 보유하고 있어 외부에서는 문항별로 재현할 수 없어요. 그래서 아래 숫자는 방법 설명이 포함된 1회성 관찰로 이해해야 하고, 안정적인 순위로 받아들이기에는 무리가 있어요.
| 문제 유형 | 문항 수 | GPT-6.2 Sol 결과 | 비즈니스 의미 |
|---|---|---|---|
| 일반 분석 | 20 | 20/20 | 고정된 집계 기준의 요약은 직접 답변을 시범 적용해볼 수 있음 |
| 모호성 판단 | 5 | 5/5 | 질문 자체에 여러 해석이 있음을 인식할 수 있음 |
| 데이터로 답할 수 없음 | 5 | 5/5 | 데이터가 뒷받침하지 않을 때 답변을 거부하고 숫자를 억지로 만들지 않음 |
| 데이터 품질 | 3 | 3/3 | 결측, 중복 같은 문제를 알아차릴 수 있음 |
| 통계 함정 | 5 | 5/5 | 흔한 통계적 오독을 피할 수 있음 |
| 숨겨진 패턴 | 5 | 2/5 | 개방형 패턴 탐색은 여전히 사람의 검증이 필요 |
| 합계 | 43 | 40/43 | 앞선 38문항은 모두 통과, 실점은 전부 탐색형 문항에 집중 |
Plotly는 다른 모델들이 재실행했을 때 최대 세 문항의 변동이 나타났다고도 언급했어요. 40/43은 만점과 딱 세 문항 차이로, 바로 이 변동 범위에 들어가요. 그래서 더 주목할 것은 실점의 분포예요. 실점은 전부 숨겨진 패턴 문항에 몰려 있고, 앞선 다섯 유형에서는 한 문항도 틀리지 않았어요.
1.2 고정된 집계 기준의 데이터 질의는 왜 검수할 수 있나
A/S 리포트를 예로 들면, “지난 7일간 창고별 반품률”을 안정적으로 검수할 수 있는 전제는 세 가지가 사전에 고정되어 있다는 것이에요. 분모가 배송 완료 주문인지 전체 주문인지, 시간 범위를 어느 시간대 기준으로 자를지, 필터 조건이 테스트 주문과 내부 주문을 제외했는지예요. 이 세 가지가 집계 기준 문서에 명시되면, 모델이 생성한 SQL과 결과를 사람이 직접 조회한 결과와 항목별로 대조할 수 있어요.
고정된 집계 기준은 “모델이 똑똑한가”를 “숫자가 일치하는가”로 바꿔 줘요. 후자는 자동으로 비교할 수 있죠. 이것이 38문항을 모두 통과할 수 있었고, 그 통과에 의미가 있는 이유예요. 이 문항들은 대부분 유일한 표준 답을 가지고 있거든요.
2. GPT-6.2 Sol 데이터 분석의 지연과 비용: 프런트엔드에 둘 것인가
2.1 두 세대 Sol의 전체 회차 비교
사용자가 프런트엔드에서 데이터를 질의하면 대기 시간이 곧 경험이 돼요. Plotly 보고서는 GPT-6.2 Sol과 GPT-6.1 Sol을 같은 회차의 43개 문항에서 비교한 결과를 내놨어요:
| 지표 | GPT-6.1 Sol | GPT-6.2 Sol | 변화 |
|---|---|---|---|
| 전체 회차 비용 | $2.61 | $1.22 | 약 53.3% 낮음 |
| 문항당 소요 시간 중위수 | 17.6초 | 10.5초 | 약 40.3% 낮음 |
| 도구 호출 횟수 | 258 | 158 | 뚜렷하게 감소 |
| 모델 호출 횟수 | 227 | 173 | 감소 |
| 입력량 | 약 780만 토큰 | 약 460만 토큰 | 감소 |
| 출력량 | 약 7만 토큰 | 약 4.5만 토큰 | 감소 |
| 캐시 입력 비율 | 94% | 97% | 상승 |
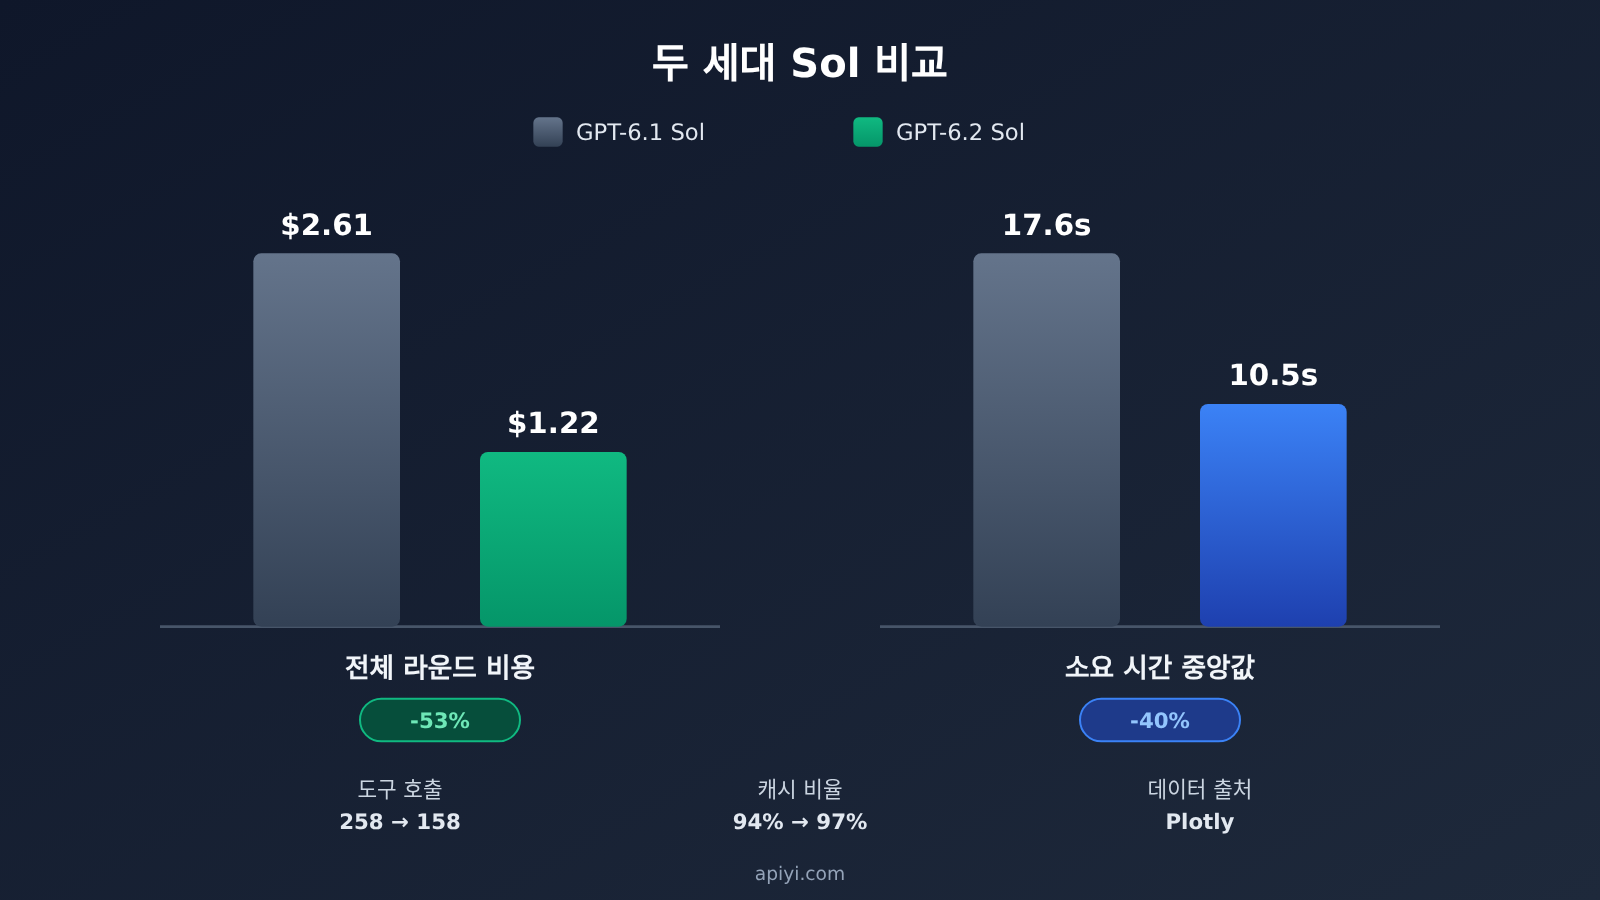
두 세대 Sol은 짧은 컨텍스트 Standard 기본 정가가 같지만, 전체 회차 비용은 거의 절반으로 줄었어요. 차이는 작업 과정에서 생겨요. 호출 라운드가 더 적고, 읽고 쓰는 토큰이 더 적으며, 캐시 적중률은 더 높아요. 그래서 데이터 분석 시나리오의 비용을 평가할 때는 ‘문항 하나를 완료하는 데 드는 비용’을 단위로 삼아야 하고, 백만 토큰당 정가는 그중 하나의 요인일 뿐이에요.
2.2 천 문항당 약 $28.4의 외삽과 가정
전체 회차 $1.22를 43개 문항으로 나누면 문항당 평균 약 $0.0284이고, 이를 천 문항으로 외삽하면 약 $28.4가 돼요. 이 숫자가 성립하려면 다음 가정을 동시에 만족해야 해요:
- 문항 유형 분포가 Plotly의 43개 문항과 같고, 그중 탐색형 문항이 약 12%를 차지해요.
- 같은 OpenRouter 채널과 과금 방식을 사용해요.
- 캐시 비율이 약 97%로 유지되고, 문항 간에 동일한 시스템 프롬프트와 테이블 구조 설명을 공유해요.
- 문항마다 한 번만 실행하고 재시도하지 않아요.
Plotly 리더보드에 있는 또 다른 숫자는 문항당 비용 중위수 $0.017인데, 이건 평균값과는 다른 통계량이에요. 탐색형 문항은 도구 호출이 많고 시간이 오래 걸려서 평균을 끌어올리고, 중위수는 일반적인 데이터 질의 문항 비용에 더 가까워요. 예산을 잡을 때는 중위수로 일상적인 데이터 질의 비용을 추정하고, 탐색형 문항 비율에 따라 별도로 일부를 더하면 돼요.
OpenAI 공식 짧은 컨텍스트 Standard 가격은 일반 입력 $2.00, 캐시 읽기 $0.10, 출력 $10.00이에요(USD/백만 토큰, 출력에는 추론 토큰이 포함돼요). 요청 입력 총량이 272K를 넘으면 요청 전체가 긴 컨텍스트 등급으로 전환돼요. APIYI apiyi.com의 공개 가격 인터페이스에서 짧은 등급은 공식과 같고, 긴 등급은 입력 $3, 캐시 읽기 $0.15, 캐시 쓰기 $3.75, 출력 $11.25예요. 데이터 질의 시나리오의 단일 요청은 보통 272K보다 훨씬 작아서, 한 번에 대량의 테이블 구조나 과거 결과를 넣을 때만 등급 전환을 신경 쓰면 돼요.
3. GPT-6.2 Sol 데이터 분석의 세 가지 단서: 언제 명확히 하고, 언제 사람에게 넘길까
3.1 숨겨진 규칙 문제에서 왜 점수를 잃는가
숨겨진 규칙이 없는 38개 문제에서 6.2 Sol은 문제당 평균 약 2.9회의 도구 호출을, 6.1 Sol은 약 4.3회를 기록했고, 둘 다 전부 통과했어요. 숨겨진 규칙 문제 5개에 이르자, Sol 특별 보고서에는 6.2 Sol이 평균 약 9회의 데이터베이스 쿼리를, 6.1 Sol이 약 16회를 기록했다고 나와요. (Plotly 종합 순위 글에서 예시를 들 때 이전 세대는 약 18회라는 산출 기준을 썼지만, 이 글에서는 특별 보고서를 기준으로 해요.)
사람이 직접 확인한 뒤, 점수를 잃은 세 문제는 각각 이랬어요:
- 삽입된 규칙을 따로 분리해내지 못했어요.
- 구체적으로 어떤 객체가 영향을 받는지 지적하지 못했어요.
- 효과가 실제로 존재하는 데이터 부분을 찾아내지 못했어요.
세 가지 실점에는 공통점이 하나 있어요. 바로 쿼리가 표면에서 멈췄다는 거예요. 이걸 하나의 관찰로 기록할 수 있어요. 신버전은 탐색 문제에서 검색이 더 얕아요. 「쿼리 횟수가 적어서 점수를 잃었다」는 인과관계는 변수를 통제한 실험을 해야 확인할 수 있어요. 비즈니스 입장에서 결론은 같아요. 적극적으로 증거를 찾아야 하는 귀인 문제에서는 모델의 첫 번째 답변을 그대로 결론으로 삼으면 안 돼요.
3.2 산출 기준 결여: 먼저 묻고 답하기
아래에서는 가상의 애프터서비스 티켓 데이터셋으로 세 가지 출력을 시연할게요. 데이터셋은 주문, 티켓, 상품 배치, 창고 네 개의 테이블로 구성되어 있고, 아래 출력은 설계 예시이며 실제 측정 결과가 아니에요.
정상 응답(산출 기준 명확). 사용자가 「창고별 지난 7일 반품률을 보여줘」라고 물으면, 합격한 출력은 각 창고의 수치 외에도 분자(실물 반품 티켓 수), 분모(동기간 서명 완료된 주문 수), 날짜 범위 및 시간대(예: 베이징 시간 11-13부터 11-19), 집계 차원(창고)을 보존해야 하고, 실행된 SQL도 첨부해야 해요.
산출 기준 선질문(산출 기준 결여). 사용자가 「지난주 반품률이 얼마야」라고만 물으면, 모델은 먼저 되물어야 해요. 「반품률을 환불 신청 기준으로 계산할까요, 아니면 실물 반송 기준으로 계산할까요? 둘은 환불만 하고 반품하지 않는 시나리오에서 차이가 커요.」 그리고 나서 두 가지 산출 기준을 나열해 사용자가 선택하게 하고, 사용자가 정하기 전에는 숫자를 출력하지 않아야 해요.
3.3 개방형 귀인: 분석가에게 넘기기
사용자가 「어떤 채널의 반품률이 두 배로 뛰었는데, 이상 현상이 어느 배치에 집중되어 있어?」라고 물으면, 이는 숨겨진 규칙 문제의 범주에 들어가요. 모델은 먼저 예비 점검을 할 수 있어요. 데이터에 결측이 있는지, 전체 샘플 크기가 충분한지 확인한 다음, 채널, 카테고리, 창고, 배치 순으로 분할하는 거예요. 출력에는 최소한 하나의 지지 증거와, 대체 설명을 배제하기 위한 점검 하나를 보존해야 해요(예를 들어 해당 채널의 그 주 주문량이 비정상적으로 급감하지 않았음을 확인해, 분모가 작아져 생긴 두 배 상승을 배제하는 것).
이걸 다 하고 나면, 출력은 「분석가 검토 대기」로 표시해야 하고 「결론」이 아니에요. 라우팅 규칙은 표 하나로 요약할 수 있어요:
| 단서 | 전형적인 질문 | 라우팅 | 모델 출력 | 검수 중점 |
|---|---|---|---|---|
| 산출 기준 명확, 영향도 낮음 | 각 창고 7일 반품률 | Sol 읽기 전용 질의 | 수치 + 산출 기준 + SQL | 수치가 수동 조회와 일치 |
| 산출 기준 또는 데이터 부족 | 지난주 반품률 얼마 | 먼저 명확화 | 되묻기 하나 + 후보 산출 기준 | 되묻기가 결측을 정확히 짚음 |
| 개방형 귀인, 대외 의사결정 | 이상 현상이 어느 배치에 집중 | 분석가 검토로 이관 | 점검 기록 + 지지 증거 + 대체 설명 점검 | 증거 커버리지, 오탐과 누락 |
4. 자체 데이터로 GPT-6.2 Sol의 데이터 분석 능력 검증하기
4.1 연동 및 라우팅 코드
gpt-6.2-sol은 Responses와 Chat Completions 두 엔드포인트로 호출할 수 있고, 함수 호출과 내장 도구는 Responses 경로를 사용해요. 두 엔드포인트 모두 none 추론 등급을 받지 않으니, 기존 코드를 마이그레이션할 때 이 파라미터를 꼭 확인해야 해요. 아래는 Chat Completions로 라우팅 분류를 수행하는 최소 예제예요.
import openai, json

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

question = "上周退货率多少"
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[
        {"role": "system", "content": "把用户的数据问题分类为 direct / clarify / escalate,"
                                      "只返回 JSON:{\"route\":..., \"reason\":...}"},
        {"role": "user", "content": question},
    ],
)
print(json.loads(resp.choices[0].message.content))
읽기 전용 SQL 도구 호출의 전체 예제 보기(Responses API)
import openai, json, sqlite3

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 데이터베이스 수준에서 읽기 전용으로 열고, 정규식 검사는 두 번째 안전장치일 뿐이에요
conn = sqlite3.connect("file:aftersales.db?mode=ro", uri=True)

def run_readonly_sql(sql: str) -> str:
    head = sql.strip().lower()
    if not (head.startswith("select") or head.startswith("with")):
        return json.dumps({"error": "only read-only queries allowed"})
    rows = conn.execute(sql).fetchmany(200)
    return json.dumps({"rows": rows, "row_count": len(rows)}, default=str)

tools = [{
    "type": "function",
    "name": "run_readonly_sql",
    "description": "在售后数据仓库执行只读 SQL,返回最多 200 行",
    "parameters": {
        "type": "object",
        "properties": {"sql": {"type": "string"}},
        "required": ["sql"],
    },
}]

instructions = (
    "你是数据分析助手。回答必须包含:分子、分母、时间范围与时区、聚合维度、所执行的 SQL。"
    "口径不明确时先提问;涉及归因的结论标注为待分析师复核。"
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions=instructions,
    input="按仓库列过去 7 天的退货率",
    tools=tools,
)

# 모델이 최종 답변을 내놓을 때까지 도구 호출을 반복 처리해요
while True:
    calls = [o for o in resp.output if o.type == "function_call"]
    if not calls:
        break
    outputs = [{
        "type": "function_call_output",
        "call_id": c.call_id,
        "output": run_readonly_sql(json.loads(c.arguments)["sql"]),
    } for c in calls]
    resp = client.responses.create(
        model="gpt-6.2-sol",
        previous_response_id=resp.id,
        input=outputs,
        tools=tools,
    )

print(resp.output_text)
print("output_tokens:", resp.usage.output_tokens)
🚀 빠른 시작: 자체 업무 샘플로 검증할 때는 APIYI apiyi.com을 통해 신규 사용자 무료 테스트 크레딧을 신청할 수 있어요. 동일한 API Key로
gpt-6.2-sol과 다른 주요 모델을 전환하며 같은 문제 세트에서 가로 비교할 수 있고, 데이터 소스만 읽기 전용으로 유지하면 됩니다.
4.2 문항 유형별 검증 지표
검증 문제 세트는 3절에서 설명한 세 가지 라우팅을 모두 포함하고, 각 문항 유형을 따로 채점하는 게 좋아요.
| 문항 유형 | 주요 지표 | 판정 방식 | 권장 기록 |
|---|---|---|---|
| 고정 기준 수치 질의 | 수치 정확도 | 수동 SQL 결과와 행 단위로 비교 | 문항당 비용, p50/p95 지연 시간 |
| 기준 정의 누락 | 되묻기 적합률 | 되묻기가 실제로 빠진 기준 정의를 짚었는지 | ‘물어보면 안 될 것을 물어본’ 경우가 있는지 |
| 데이터로 답할 수 없음 | 답변 거부 정확도 | 숫자를 꾸며내지 않음 | 오답 횟수 |
| 개방형 원인 분석 | 근거 커버리지, 오탐·누락 | 뒷받침 근거와 대안 설명 점검이 모두 갖춰졌는지 | 여러 차례 재실행 시 일관성 |
Plotly 보고서에는 소요 시간 중앙값만 있었어요. 직접 검증할 때는 p95를 꼭 추가하세요. 프런트엔드 사용자 경험은 소수의 롱테일 요청에 발목 잡히는 경우가 많고, 탐색형 문항은 특히 롱테일이 생기기 쉬워요. 비용은 usage.output_tokens에서 출력량을 읽고, 추론 토큰은 보통 output_tokens_details.reasoning_tokens 하위 항목에 표시되니 여기에 캐시 읽기량을 더해 문항당 실제 비용을 계산하세요.
4.3 소표본과 재실행의 경계
Plotly의 숨은 규칙은 5문항뿐이라 2/5의 신뢰구간이 아주 넓어요. 문제 세트를 바꾸면 1/5이 될 수도, 4/5가 될 수도 있죠. 다른 모델을 재실행했을 때 최대 3문항까지 변동이 나타난 적이 있어서, 한 번의 총점 차이만으로는 모델 선택을 뒷받침하기 어려워요. 직접 검증할 때는 탐색형 문항을 최소 여러 차례 반복 실행하고, 다음 다섯 가지 변수를 맞춰야 해요. 데이터 스냅샷, 도구 세트, 모델 추론 수준, 호출 채널, 채점표예요. 하나라도 바뀌면 앞뒤 결과를 바로 비교할 수 없어요.
💡 검증 팁: 채널은 쉽게 놓치는 변수예요. Plotly의 비용은 OpenRouter에서 나왔지만, 여러분의 프로덕션 채널은 과금과 캐시 전략이 다를 수 있어요. APIYI apiyi.com에서 같은 데이터 스냅샷으로 재실행해 보길 권해요. 실제 청구서를 반영해 1,000문항당 비용을 다시 계산한 뒤 프런트엔드 쿼터를 정하세요.
4.4 검증 가능한 하나의 산출물
검증 통과의 기준은 간단해요. 각 질의 결과를 제3자가 독립적으로 다시 확인할 수 있어야 한다는 것이죠. 아래는 합격한 산출물의 모습이에요(가상 데이터).
question: 창고별 지난 7일 반품률
route: direct
data_snapshot: 2026-11-19 23:59 (Asia/Shanghai)
metric_definition:
  numerator: 실물 반품 티켓 수(status = returned)
  denominator: 동기간 수령 확인된 주문 수(테스트 주문, 내부 주문 제외)
  time_range: 2026-11-13 ~ 2026-11-19, 베이징 시간
  group_by: warehouse_id
query: "SELECT w.warehouse_id, ... GROUP BY w.warehouse_id"
result: [{warehouse: 화둥 1창고, rate: 3.1%}, {warehouse: 화난 2창고, rate: 2.4%}]
model: gpt-6.2-sol
cost_usd: 0.012
latency_s: 8.7
reviewer: 재검증 불필요(고정 기준 질의)
산출물 하나에는 데이터 날짜, 기준(정의), 쿼리, 결과가 함께 담겨요. GPT-6.2 Sol은 프런트엔드 질의 단계에서 이대로 검증할 수 있죠. 이 항목들이 빠진 출력은 숫자가 우연히 맞아떨어지더라도 리포트에 넣으면 안 돼요. 자기 창고에서 이 흐름을 돌려보고 싶다면 APIYI apiyi.com의 OpenAI 호환 인터페이스에서 시작해 보세요. 먼저 고정 기준 질의를 출시한 다음, 점차 명확화와 원인 분석 단계로 확장해 나가면 돼요.
참고 자료
- Plotly – GPT-6.2 Sol 데이터 분석 특별 보고서: 43개 문항별 결과, 비용 및 소요 시간 대조
- 링크:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- 링크:
- Plotly – DataAnalyticsBench 테스트 방법: 문항 유형 설계, 채점 규칙 및 리더보드 통계 기준
- 링크:
plotly.com/blog/introducing-dataanalyticsbench
- 링크:
- OpenAI – GPT-6.2 Sol 모델 카드: 컨텍스트 윈도우, 엔드포인트 지원 및 장문 컨텍스트 과금 규칙
- 링크:
developers.openai.com/api/docs/models/gpt-6.2-sol
- 링크:
- OpenAI – API 가격: Standard 입력, 캐시 및 출력 단가
- 링크:
developers.openai.com/api/docs/pricing
- 링크:
- APIYI 공개 가격 책정 인터페이스:
gpt-6.2-sol의 단문 구간 및 장문 구간 가격 산식- 링크:
api.apiyi.com/api/pricing
- 링크:
저자: APIYI 기술 팀
기술 교류: APIYI 공식 웹사이트 첫 페이지에서 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다.


