
著者注:Codex のタスク所要時間は、モデル、推論強度、サービス経路、ツールループ、キャッシュ、ネットワークによって決まります。同一タスクでの比較と区間ごとの計測を行うと、ボトルネックを特定できます。
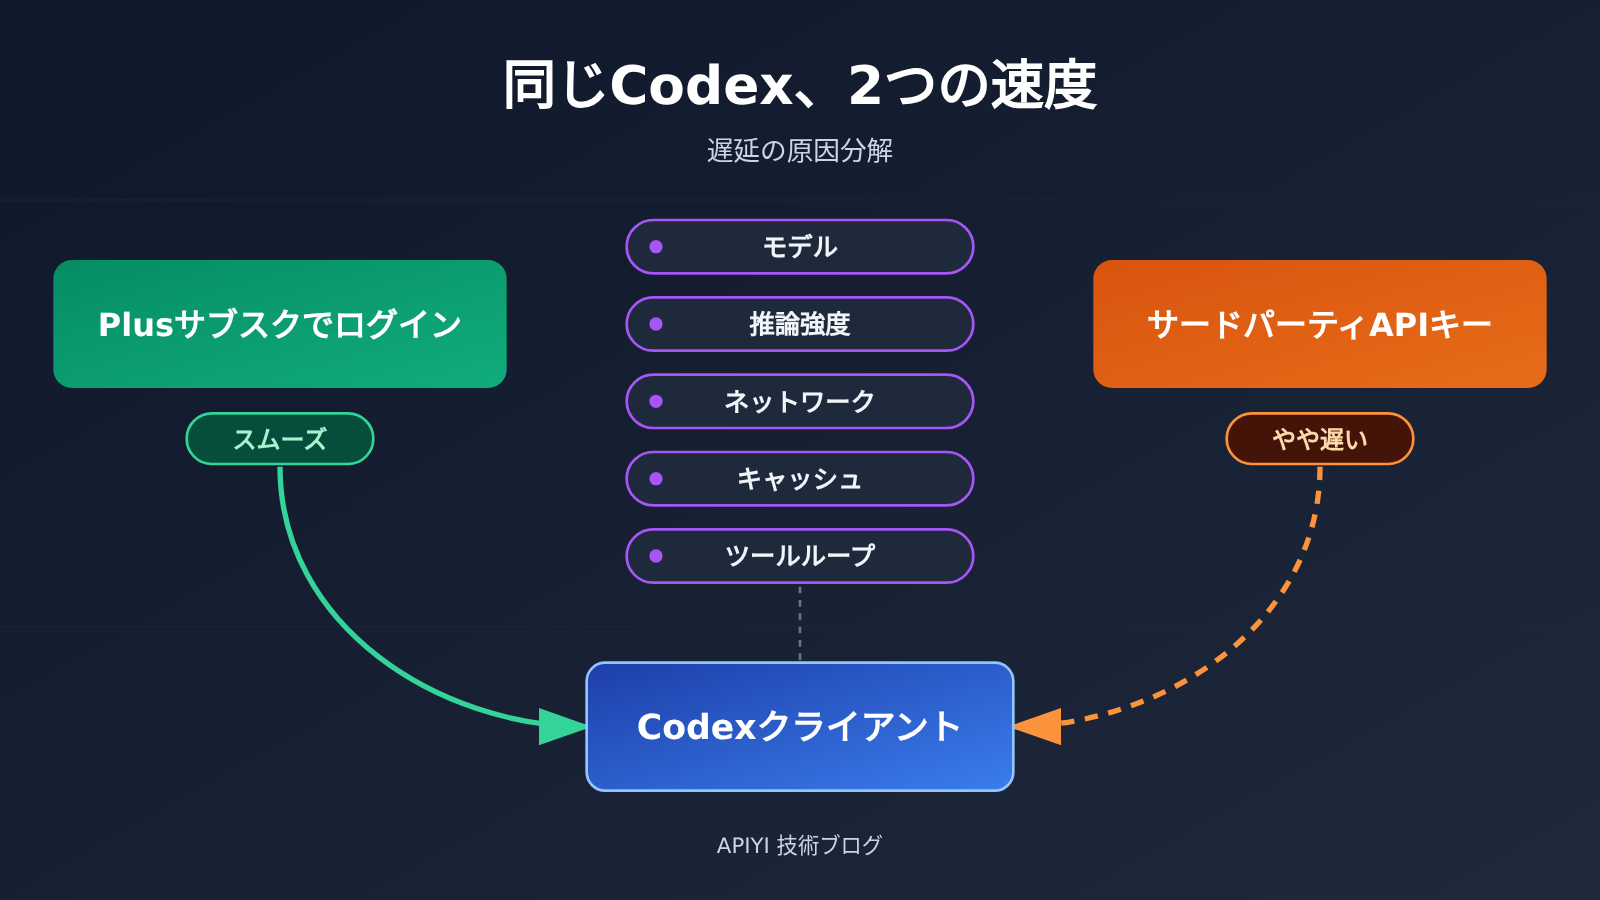
同じ Codex でも、ChatGPT Plus でログインしているときはスムーズなのに、サードパーティの APIキーに切り替えると遅くなる——原因は通常、両者が 異なるサービス経路 を通ることにあります。しかも Codex の Agent ループでは、各ラウンドのリクエストに生じる追加遅延が積み重なって増幅されます。クライアントの UI は同じでも、モデルのデプロイ、推論ティア、転送プロトコル、キャッシュヒット、ツールイベントの互換性は異なる可能性があります。1回のリクエストで3秒多く待つだけでも、20回の直列呼び出しが必要なコーディングタスクでは約1分余計にかかる可能性があります。
以下ではまず Codex の動作方式と2つの接続経路を分解し、続いてサードパーティ API の遅延要因を項目ごとに説明し、公開されている2つの GitHub Issue を個別事例として根拠にします。その後、4つの主要指標、3組の比較テスト、症状別の最適化案を示し、自分の Codex がモデル、ネットワーク、キャッシュ、ツールループのどこで遅くなっているかを判断できるようにします。最後に、サードパーティ API を選ぶ際、どの指標が単価よりも実コストをよく反映するかを議論します。
To Know:Codex の速度差を理解するための用語
| 用語 | 説明 |
|---|---|
| Codex Harness | Codex の実行フレームワーク。モデル、ツール、コンテキスト、マルチターンのタスクループを組織する役割を担います。 |
| Responses API | OpenAI が提供するインターフェース。モデル出力、ツール呼び出し、マルチターンの状態管理をサポートし、Codex はこれに依存して動作します。 |
| TTFT | Time To First Token。リクエスト送信から最初の出力トークンを受け取るまでの待ち時間です。 |
| TPS | Tokens Per Second。1秒あたりに生成されるトークン数で、持続的な出力速度を反映します。 |
| エンドツーエンド所要時間 | タスクを提出してから最終的に完了するまでの総時間で、すべてのモデル呼び出しとツール実行を含みます。 |
| 推論強度 | モデルが思考する深さの段階(low、medium、high など)。段階が高いほど通常は出力が多くなり、所要時間も長くなります。 |
| ツール呼び出し(Tool Calling) | モデルが外部プログラムにファイル読み取りやコマンド実行などを要求し、その結果を受けて推論を続けるプロセスです。 |
| プロンプトキャッシュ(Prompt Caching) | 入力プレフィックスが重複し条件を満たす場合に、既存の計算結果を再利用して処理時間を短縮します。 |
| SSE | Server-Sent Events。サーバーが一方向の HTTP 接続を通じてイベントを継続的にプッシュします。 |
| WebSocket | 持続的な双方向接続で、マルチターンのリクエストが同じ接続を再利用できます。 |
| previous_response_id | Responses API で前回のレスポンスを参照するパラメータ。増分入力と組み合わせることで重複送信を減らせます。 |
| サービスティア | 同一モデルにおける異なる処理オプション(Standard、Fast など)で、速度と価格がそれぞれ異なります。 |
1 同じ Codex でなぜ 2 つの速度になるのか?
1.1 Codex のサブスクリプションログインと API Key ではサービス経路が異なる
OpenAI の認証ドキュメントによると、Codex CLI、IDE 拡張機能、デスクトップアプリは 2 つのログイン方法をサポートしています。ChatGPT アカウントでログインするか、API Key を入力する方法です。ChatGPT ログインでは、サブスクリプションに付帯する Codex 利用特典と対応する上限を消費します。一方、API Key は API アカウントの従量課金とレート制限ルールに従って実行されます。Plus サブスクリプション自体にも、任意の OpenAI API を無料で呼び出す権利は含まれていません。
サードパーティの API Key を接続する場合、Codex クライアントはタスクの整理だけを担当し、実際の推論はそのインターフェースの背後にあるサービスで行われます。実際に呼び出されるモデル、課金方式、ストリーミングプロトコル、サービス品質は、サードパーティのインターフェースとそのバックエンド実装によって決まります。したがって、クライアント上に表示されるモデル名が同じであることは、同じ名前を選択したというだけであり、2 回のリクエストが同じモデルデプロイ、サービスキュー、伝送経路を経由したことを確認するものではありません。
1.2 Codex の Agent ループがモデルへの繰り返しリクエストを必要とする理由
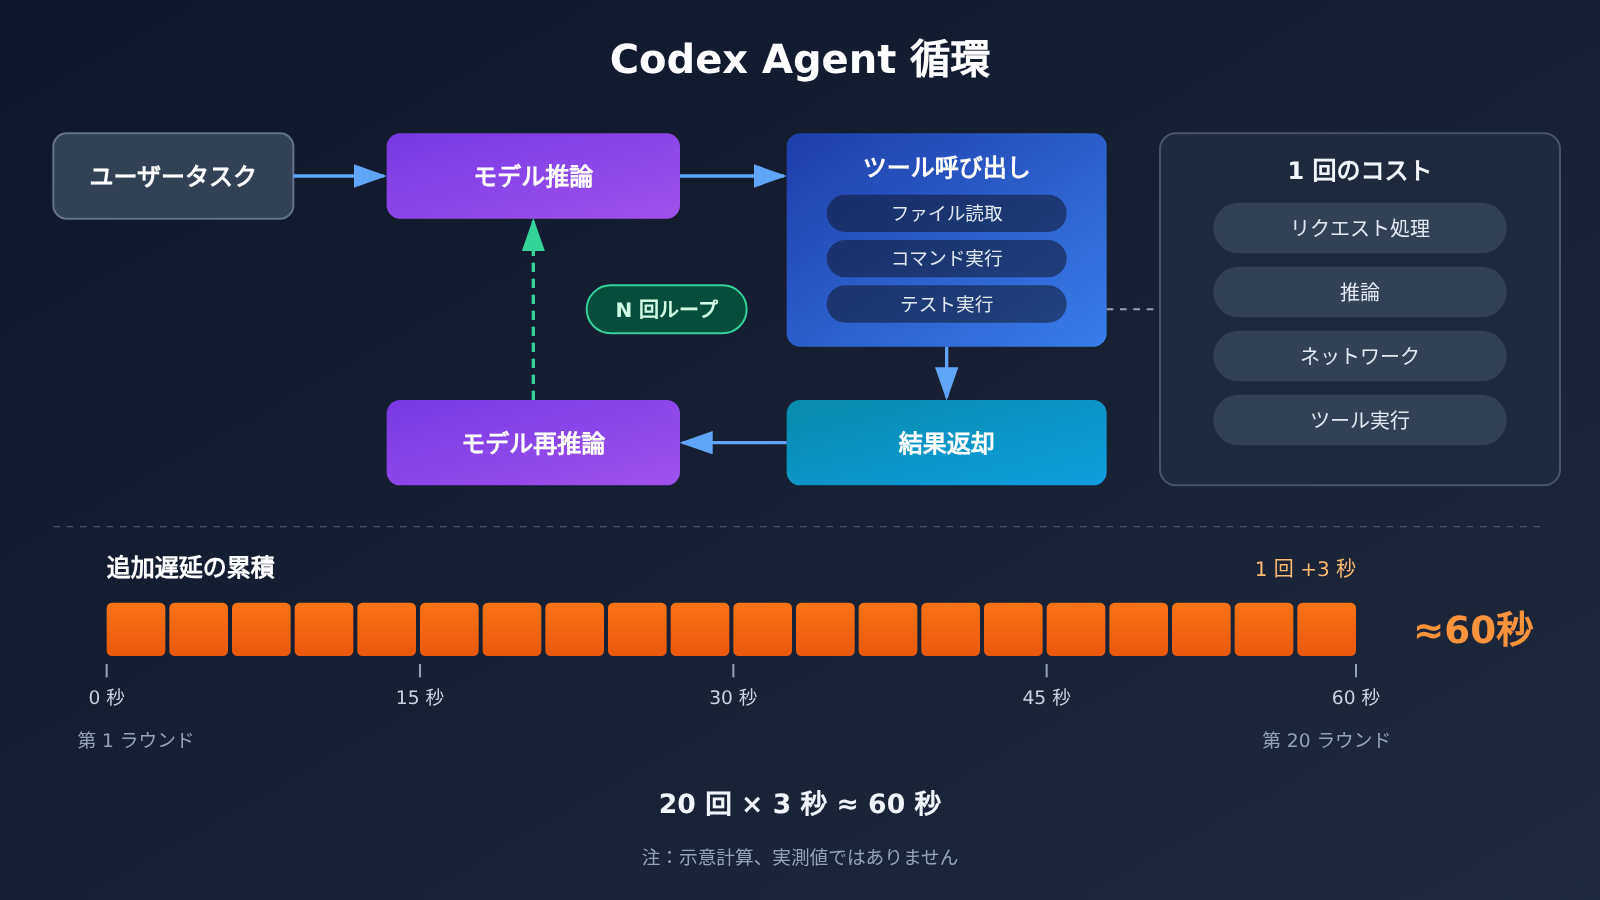
OpenAI が 2026 年 8 月 19 日に公開した「Codex as a platform」では、Codex のオープンソース Agent Harness が、タスクの理解、コンテキストの維持、コードベースの検索、Shell の呼び出し、ファイルの編集、テストの実行を担い、さらに失敗からの復旧、ユーザー承認、実行境界を処理すると説明されています。その本質は「モデル推論 → ツール実行 → 再推論」という循環システムです。
OpenAI が 2026 年 4 月 22 日のエンジニアリング記事で典型的な流れを説明しています。ユーザーが修正タスクを提示し、モデルが何をすべきかを判断し、Codex がファイルを読み取るかコマンドを実行し、ツールが結果を返すとモデルが再分析し、その後もツール呼び出し、コード修正、テスト実行、結果確認を続けます。複雑なタスクでは、モデルとツールの間で数十回のやり取りが発生することがあり、その各回が完全な 1 回の API リクエストになります。
2 Codex がサードパーティ API に接続する際の速度差はどこから生まれるのか?
まず、5 種類のレイテンシ要因を表で整理し、その後で項目ごとに詳しく説明します。
| レイテンシ要因 | 主に影響する指標 | 典型的な症状 | 調査優先度 |
|---|---|---|---|
| モデルと推論強度 | TPS、1 ターンの推論時間 | 出力が持続的に遅く、思考時間が長い | 高 |
| サービスティアとルーティング | TTFT、変動幅 | 初回応答が遅い、または速度が不安定 | 高 |
| ゲートウェイとネットワーク経路 | 各ターンに固定で加わる時間 | 呼び出しごとに安定して数秒増える | 中 |
| 転送プロトコル(SSE / WebSocket) | 複数ターンの累積オーバーヘッド、接続の安定性 | 長いタスクが遅い、途中でストリームが切れる | 中 |
| キャッシュとツールループ | 入力処理時間、呼び出し回数 | 長い会話で明らかに遅くなる、ターン数が多すぎる | 高 |
2.1 モデルの推論速度と推論強度が Codex の所要時間に与える影響
2 つの接続方式を比較する前に、実際のモデル ID、推論強度、モデルバージョン、サービスティアが一致しているかどうかを必ず確認する必要があります。推論強度は low から xhigh、max まであり、ティアが高いほどモデルが生成する思考内容が増え、1 ターンの所要時間が長くなります。
OpenAI のレイテンシ最適化ガイドでは、出力トークン数を推論時間に影響する重要な変数として挙げています。一部のシナリオでは、出力トークンが約 50% 減ると生成レイテンシも 50% 近く低下する可能性がありますが、通常の入力テキストを減らすことによる影響ははるかに小さいのが一般的です。サービスティアも同様に重要で、OpenAI の Fast モードは対象モデルと負荷によって最大 2.5 倍の速度になります。ただしこれは有料ティアの選択肢であり、一部のモデルにのみ有効です。
つまり、サブスクリプション側とサードパーティ側で同じモデルが表示されていても、推論ティアやサービスティアが異なれば、速度差は明らかになります。
2.2 API中継サービス、ネットワーク経路、WebSocketがマルチターンタスクに与える影響
サードパーティAPIのリクエスト経路は一般に長くなります。クライアント → サービスプロバイダーのゲートウェイ → プロキシノード → 場合によっては越境回線 → 最終的な推論サービス、という流れです。ホップが増えるたびに固定遅延やネットワーク変動が少しずつ増える可能性があり、こうした遅延はエージェントループの中でターンごとに積み重なります。
もう一つの変数は転送プロトコルです。従来のResponses APIは主にHTTP/SSEで転送され、各ターンでリクエストを再確立し、コンテキストを運ぶ必要があります。WebSocketモードは永続接続を維持し、previous_response_idとインクリメンタル入力によって重複転送と処理を削減します。OpenAIが公式に公表したデータは次のとおりです。
- 2025年末のAPI最適化により、最初のトークンまでの遅延が45%近く改善しました。
- 20回以上のツール呼び出しを行う特定のワークフローでは、WebSocketモードにより最大約40%のエンドツーエンド高速化が実現します。
- Vercel関連の統合では最大約40%の遅延改善が報告され、Clineの複数ファイルワークフローでは約39%の高速化、CursorのOpenAIモデルでは最大約30%の改善が報告されています。
これらのデータは異なる製品とテストシナリオに由来し、特定のワークフローにおける上限値です。一部の互換ゲートウェイはHTTP/SSEのみを実装しているか、Codexが使用するWebSocketとインクリメンタル状態管理を完全にはサポートしていないため、こうした接続ではこの効果を享受できません。
2.3 Codex のコンテキストキャッシュとツール呼び出し回数
長いタスクでは、履歴メッセージ、ツール定義、繰り返し現れるコンテキストが大量の入力トークンを占めます。プロンプトキャッシュがヒットすると、この接頭辞部分の処理時間を短縮できます。OpenAI のドキュメントによると、GPT-5.6 以降のシリーズは新しいキャッシュの書き込み、読み取り、TTL 制御をサポートしています。
問題は、キャッシュがリクエスト接頭辞の安定性に依存している点です。中継レイヤーがリクエスト接頭辞を書き換えたり、ツール定義の順序を調整したり、キャッシュ境界を変更したりすると、キャッシュの再利用に影響が出て、毎ラウンドで大量のコンテキストを再処理することになります。ツール呼び出し回数はリクエストのラウンド数を直接決めます。ラウンド数が増えるほど、1ラウンドあたりのオーバーヘッドが増幅される倍数も大きくなります。
2.4 Codex の初回応答は正常なのに、その後も遅いのはなぜ?
これはタイトルの問いでもっともよく見られる形です。TTFT は最初のトークンがどれだけ速く届くかだけを測るもので、Codex タスクの総所要時間はすべてのラウンドの累積です。総所要時間は次のように書けます:
T_total = Σ(APIリクエスト処理時間 + モデル推論時間 + ネットワーク転送時間 + ローカルツール実行時間 + 待機・リトライ時間)
初回応答は正常なのに全体が遅い場合、通常は次のようないくつかの状況が原因です。持続出力速度(TPS)が低く、長い応答が各ラウンドを遅くする。ツール実行後にモデルが再推論し、そのたびにコンテキストを再度処理する。ストリーミング接続が途中で切断されたりタイムアウトしたりしてクライアントがリトライし、ユーザーには「モデルが止まった」ように見える。仕組みから計算すると、20 回の直列モデル呼び出しが必要なタスクで毎回 3 秒余分に待つと、総所要時間は約 60 秒増えます。この数字は累積効果を説明するためのもので、実測結果ではありません。
3 公開事例は Codex の速度低下問題にどのような証拠を提供しているか?
以下に紹介する2つの事例は、openai/codex リポジトリのユーザー報告に由来する単一ユーザーの個別ログであり、仕組みを説明するためのものです。業界全体の一般的な水準を示すものではありません。
3.1 Issue #60831:同一セッション内で約7倍の応答時間変動
2026年11月に提出された Issue #60831 では、報告者が同一セッション、同一クライアントプロセス、同一の推論設定の下で2回のリクエストを観察しました。圧縮後のリクエストボディはいずれも約13.09 MB で、途中でコンテキスト圧縮は発生しておらず、画像履歴も変化していませんでした。遅い方はリクエスト圧縮の完了から HTTP レスポンスヘッダを受信するまでに109.317秒を要し、速い方は15.637秒で、その比率は約6.99倍でした。
ここで計測の基準に注意が必要です。この2つの数値は「レスポンスヘッダを受信するまで」の時間を測ったもので、サービス処理段階に属し、タスク全体の完了時間ではありません。また、2回のリクエストはいずれも同じ経路から来ており、サブスクリプションとサードパーティの比較とは関係ありません。これは、コンテキストのサイズが変わらない場合でも、サーバー側の処理時間そのものが大きく変動し得ることを示しています。報告自体からは、具体的にどのサービス段階がボトルネックを引き起こしたのかを特定することはできません。
3.2 Issue #44305:ツールループが1回の読み取り専用タスクの所要時間を急増させる
2026年9月の Issue #44305 では、報告者が同種の読み取り専用タスクを比較しました。別の Agent は3回の並列読み取りで約10.6秒で完了しましたが、Codex は91.5秒実行した後にタイムアウトし、完全な回答は得られませんでした。その間、Codex は約11回のモデル推論と11回のツール呼び出しを行い、累計入力は約295,042トークン、うちキャッシュ入力は約260,608トークンでした。
この数値群から計算すると、キャッシュ入力の割合は約88.3%で、キャッシュヒットの状況は良好でした。しかし直列の11ラウンドのループが、依然として所要時間を並列読み取りの方式よりはるかに大きくしていました。2つの Agent の作業戦略自体が異なるため、時間差のすべてを Codex やモデルに帰属させることはできませんが、呼び出しラウンド数と直列実行が総所要時間を増幅させる作用を明確に示しています。
さらに、サードパーティ接続に直接関係する2種類の問題もあります。Issue #33029 は、Codex Desktop がサードパーティ互換インターフェースを使用する際、モデルエンドポイントは正常に動作するものの、デスクトップ側が一部の ChatGPT 補助サービスへのリクエストを依然として行い、これらのリクエストのタイムアウトがアプリの応答を遅くすると報告しています。Issue #41340 と #42471 はそれぞれ、サードパーティの Responses エンドポイントで「stream disconnected before completion」が発生したこと、およびツール呼び出しイベントが受信されたものの実行フローに入らないことを報告しています。簡単なチャットが問題なく動くことと、完全な Codex ツールループが問題なく動くことは、2つの異なるレベルの互換性要件なのです。
4 自分の Codex がどこで遅くなっているかを見つける方法
4.1 4つのコア指標で Codex のボトルネックを特定する
| 指標 | 記録方法 | 明らかになる問題 |
|---|---|---|
| TTFT | 各リクエストで最初の有効な出力までの待ち時間 | キュー、モデルの起動、ネットワークのファーストパケット |
| エンドツーエンドの所要時間 | タスクを投入してから完了するまでの総時間 | 全体的な体験であり、最終判断の根拠 |
| モデル / ツール呼び出し回数 | 推論ラウンド数、ツール回数、ツール実行時間を集計 | Agent の戦略と直列処理による増幅 |
| キャッシュヒット | 総入力、キャッシュ読み取り、キャッシュ書き込み、出力 token | コンテキストの重複処理コスト |
これら4項目に加えて、TPS、1リクエストあたりの入出力 token、使用しているプロトコル(WebSocket または SSE)、さらに 429、5xx、タイムアウト、リトライの回数も併せて記録することをおすすめします。これらの補助データがあれば、「単に遅い」のか「エラー後のリトライによって遅くなっている」のかを区別できます。
4.2 3グループによるCodex対照テストの実行手順
対照テストの前提となるのは変数の制御です。モデルID、推論強度、Codexのバージョン、プロジェクトファイル、タスクの説明をすべて揃えたうえで、さらに新規セッションと長期セッションの2つのシナリオでそれぞれ1回ずつ実行し、コンテキスト長の影響を洗い出します。
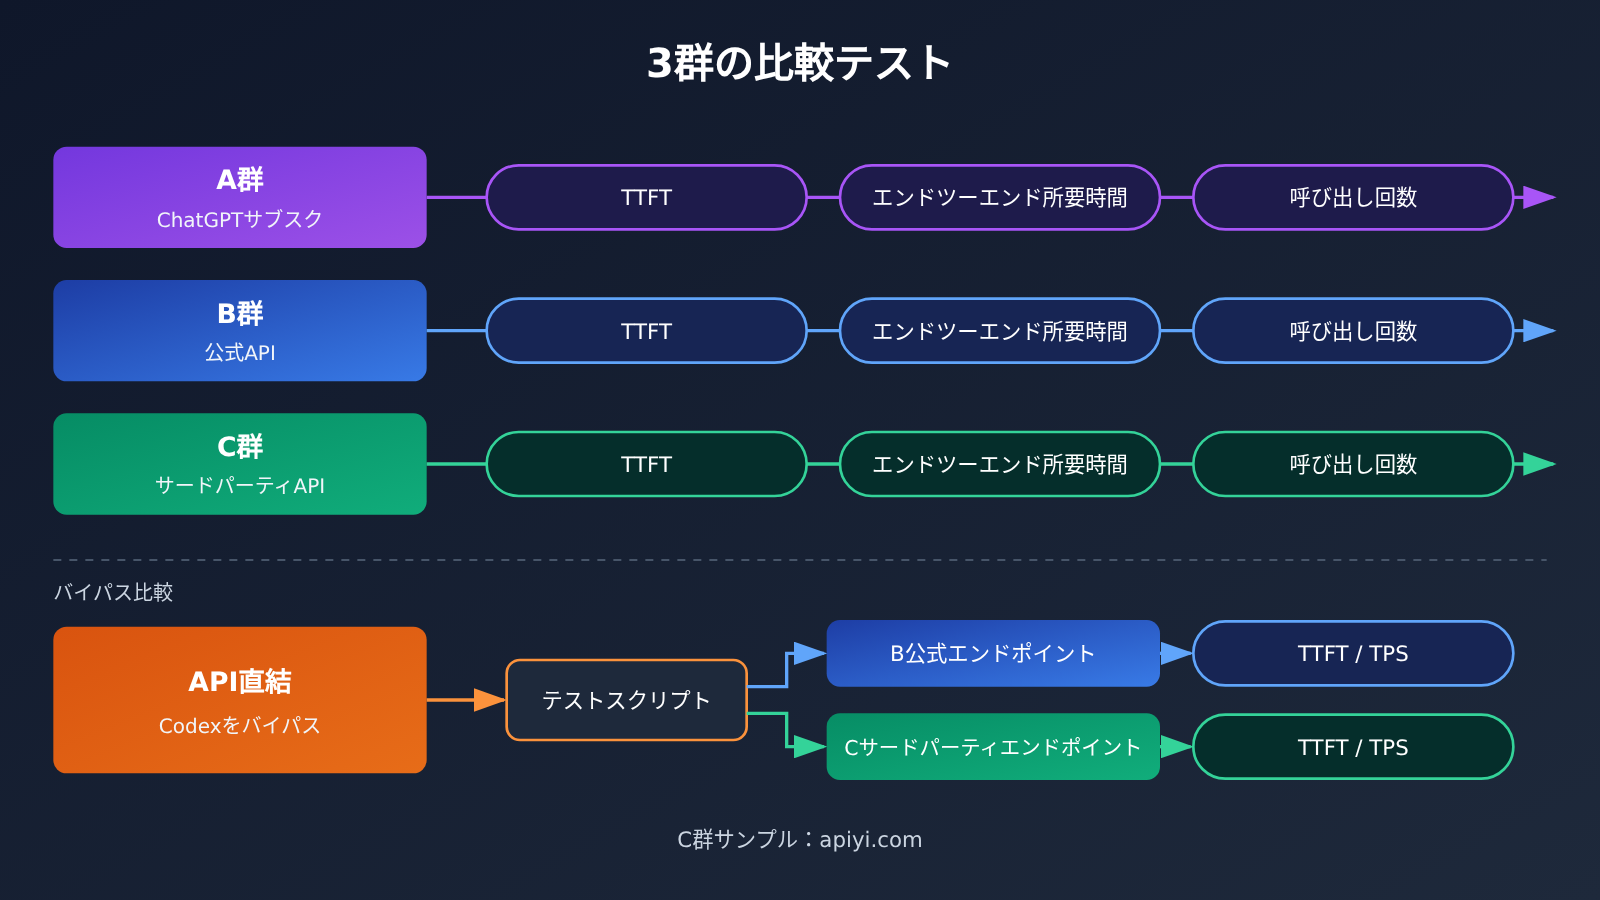
- Aグループ:ChatGPTのサブスクリプションでCodexにログインし、標準タスクを実行して、エンドツーエンドの所要時間と呼び出しラウンド数を記録します。
- Bグループ:同じモデルの公式APIキーでCodexに接続し、同一のタスクを実行します。
- Cグループ:サードパーティの互換APIでCodexに接続し、同一のタスクを実行します。
- 直結グループ:BとCの2つの経路について、Codexを経由せずにスクリプトで同じ単発リクエストを送信し、TTFTとTPSを計測します。
AとBの差は主に、サブスクリプション経路とAPI経路のサービス差を反映します。BとCの差は、ゲートウェイ、ルーティング、推論サービスの差を反映します。そして直結の結果とCodex内の結果との差は、Agentループ、プロトコル互換性、クライアント側がもたらす追加オーバーヘッドを反映します。各グループは複数回繰り返して中央値を取ることをおすすめします。一度の偶発的な変動をそのまま結論にしないよう注意しましょう。
以下のスクリプトは「直結グループ」のテスト用で、ストリーミングのResponsesリクエストを通じてTTFT、総所要時間、出力トークン数、TPSを計測します。
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIの統一インターフェース。公式アドレスに切り替えればBグループの対照テストができます
)

start = time.perf_counter()
ttft = None
stream = client.responses.create(
    model="YOUR_MODEL_ID",            # Codexで使用するモデルIDと一致させる
    reasoning={"effort": "medium"},   # Codexの推論強度と一致させる
    input="阅读下面的函数并指出潜在 bug:def add(a, b): return a - b",
    stream=True,
)
usage = None
for event in stream:
    if event.type == "response.output_text.delta" and ttft is None:
        ttft = time.perf_counter() - start
    elif event.type == "response.completed":
        usage = event.response.usage

total = time.perf_counter() - start
out_tokens = usage.output_tokens if usage else 0
print(f"TTFT: {ttft:.2f}s | 总耗时: {total:.2f}s | 输出: {out_tokens} tokens")
if ttft and total > ttft:
    print(f"TPS: {out_tokens / (total - ttft):.1f} tokens/s")
複数回の繰り返しテストとキャッシュ統計を含む完全なスクリプトを見る
import time
import statistics
from openai import OpenAI

ENDPOINTS = {
    "official": {"base_url": "https://api.openai.com/v1", "key": "OFFICIAL_KEY"},
    "apiyi": {"base_url": "https://api.apiyi.com/v1", "key": "APIYI_KEY"},  # APIYI のエンドポイント
}
MODEL = "YOUR_MODEL_ID"
EFFORT = "medium"
# Codex のシステムプロンプトとツール定義を模擬するため、長めの固定プレフィックスを使い、キャッシュヒットを観察しやすくする
PREFIX = "你是代码审查助手。项目规范如下:\n" + ("- 函数必须有类型注解。\n" * 300)
TASK = "检查这个函数:def add(a, b): return a - b"


def run_once(client):
    start = time.perf_counter()
    ttft, usage = None, None
    stream = client.responses.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=PREFIX + TASK,
        stream=True,
    )
    for event in stream:
        if event.type == "response.output_text.delta" and ttft is None:
            ttft = time.perf_counter() - start
        elif event.type == "response.completed":
            usage = event.response.usage
    total = time.perf_counter() - start
    cached = 0
    if usage and getattr(usage, "input_tokens_details", None):
        cached = usage.input_tokens_details.cached_tokens or 0
    return {
        "ttft": ttft or total,
        "total": total,
        "input": usage.input_tokens if usage else 0,
        "cached": cached,
        "output": usage.output_tokens if usage else 0,
    }


def bench(name, cfg, rounds=5):
    client = OpenAI(api_key=cfg["key"], base_url=cfg["base_url"])
    results, errors = [], 0
    for _ in range(rounds):
        try:
            results.append(run_once(client))
        except Exception as e:
            errors += 1
            print(f"[{name}] 请求失败: {e}")
    if not results:
        return
    med = lambda k: statistics.median(r[k] for r in results)
    hit = sum(r["cached"] for r in results) / max(sum(r["input"] for r in results), 1)
    print(
        f"[{name}] TTFT中位数 {med('ttft'):.2f}s | 总耗时中位数 {med('total'):.2f}s | "
        f"缓存命中率 {hit:.1%} | 失败 {errors}/{rounds}"
    )


for name, cfg in ENDPOINTS.items():
    bench(name, cfg)
Codex 内で C グループのテストを行う場合は、サードパーティのエンドポイントをモデルプロバイダーとして設定する必要があります。以下は一般的な ~/.codex/config.toml の書き方です。具体的なフィールド名は、使用している Codex バージョンの公式ドキュメントを確認してください。
model = "YOUR_MODEL_ID"
model_provider = "apiyi"
model_reasoning_effort = "medium"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
🚀 クイックスタート:C グループの比較テストを行う際は、APIYI apiyi.com で新規ユーザー向けの無料テスト枠を申請できます。同じ API キーで複数のモデルを切り替え、それぞれ上記のスクリプトを実行すれば、比較可能な TTFT と総所要時間のデータをすぐに取得できます。
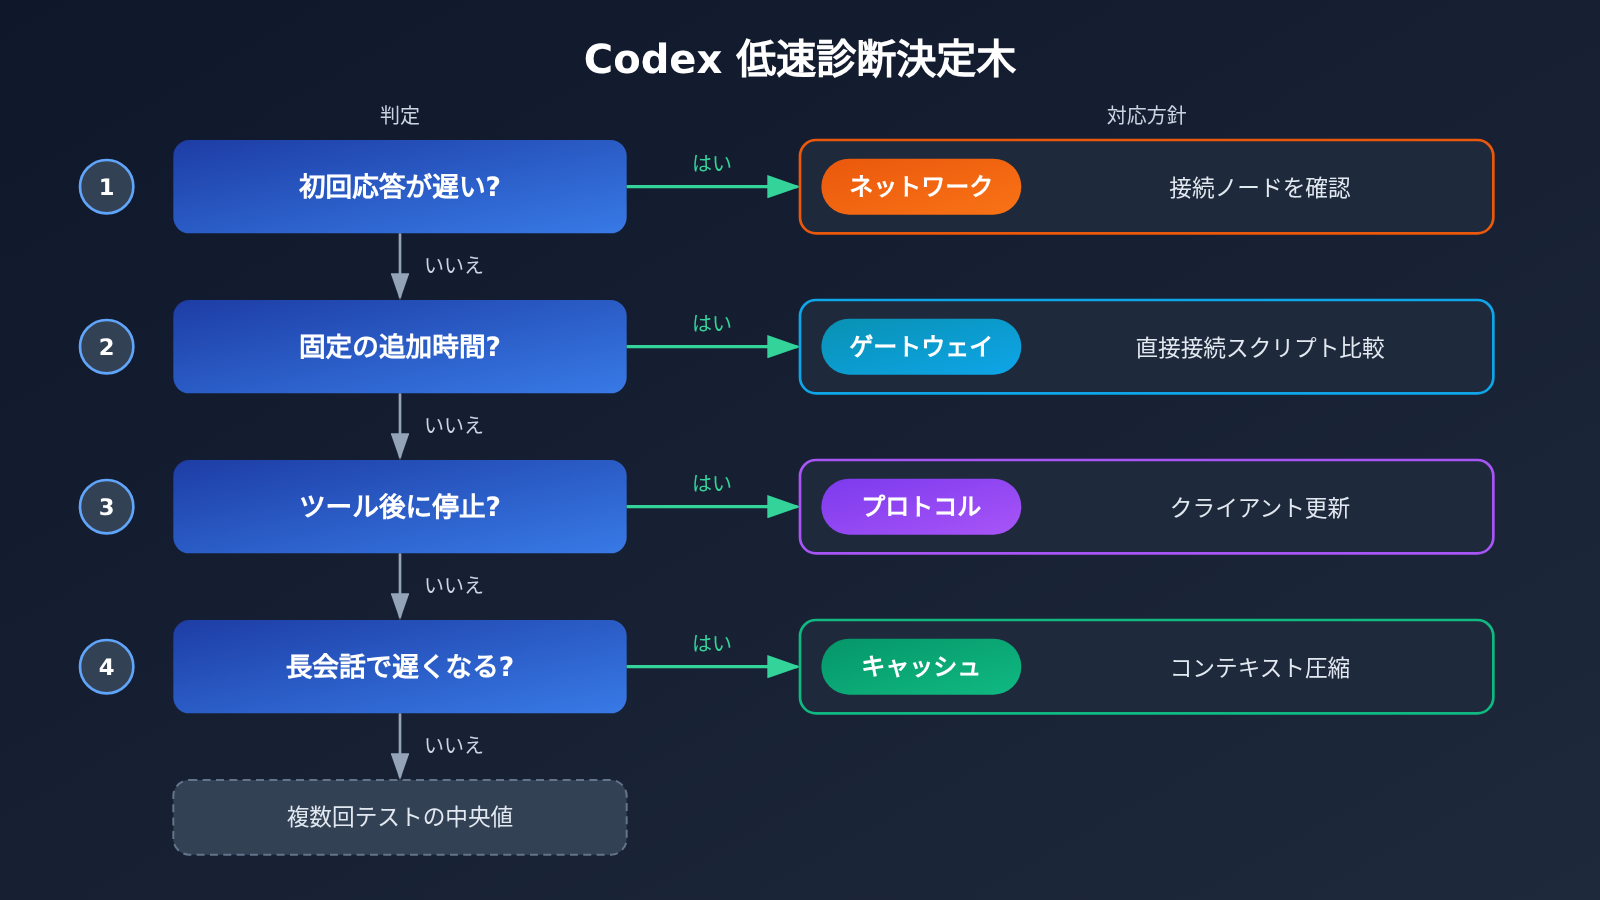
4.3 症状別の Codex 最適化プラン
| 症状 | 優先的に確認する項目 | 対処方法 |
|---|---|---|
| 初回応答が遅い | キュー、モデル起動、ネットワークの最初のパケット | より近い接続ノードに切り替え、サービスグレードを確認し、ピーク時間帯を避けて比較する |
| 初回応答は速いが、その後が遅い | TPS、ツール呼び出しのラウンド数、キャッシュ | 推論の強度を下げ、出力長を制限し、キャッシュヒット率を確認する |
| 呼び出しごとに一定の追加時間が発生する | 中継経路、追加リクエスト | 直接接続スクリプトで B/C グループを比較し、ゲートウェイのオーバーヘッドを特定する |
| ツール呼び出し後に停止する | Responses イベント、ツールの返戻 | ストリーム切断やツールイベントの欠落がないか確認し、クライアントバージョンをアップグレードする |
| 長い会話が新しい会話より明らかに遅い | 履歴トークン、圧縮、キャッシュ | 適宜新しいセッションを開くかコンテキスト圧縮をトリガーし、キャッシュ読み取りの変化を観察する |
| 速度が速いときと遅いときがある | サービス負荷、リトライ、ネットワーク変動 | 429/5xx とタイムアウト回数を集計し、複数回テストして中央値を取る |
| デスクトップ端末全体が重く、API は正常 | ChatGPT 補助サービスへのリクエスト | Issue #33029 を参照し、補助リクエストがタイムアウトしていないか確認し、必要に応じて CLI に切り替える |
モデル層の最適化は OpenAI のレイテンシーガイドの考え方に従います。出力トークンを減らし、入力コンテキストを小さくし、呼び出し回数を減らし、独立したステップを並列処理し、通常のプログラムで完結できる処理はモデルに任せないことです。Codex の場合、最も直接的な手段はタスク記述に明確な範囲を与え、Agent が探索的な読み取りラウンドを減らせるようにすることです。
5 Codex向けサードパーティAPIを選ぶ際、単価より重要な指標は?
5.1 トークン単価からタスク完了コストへ
Codexのシーンでは、実際のコストは「1つのタスクを完了する」ことで決まります。単価の低いAPIでも、キャッシュヒット率が悪く、呼び出し回数が多く、たびたびストリームが途切れてリトライが発生する場合、最終的に消費するトークンと時間はかえって増えます。評価時は、以下の項目をまとめて見ることをおすすめします。タスク成功率、エンドツーエンドの所要時間、1タスクあたりの総トークン消費量(キャッシュ読み取りを含む)、失敗やリトライによる追加コストです。
| 評価軸 | 注目ポイント | テスト方法 | 利用可能なプラットフォーム |
|---|---|---|---|
| モデルIDとバージョン | モデルIDとバージョンが明確で、安定して利用できるか | 返却されたモデルフィールドとドキュメントを照合 | APIYI(apiyi.com)、公式API |
| 初回トークンと継続速度 | TTFT、TPSの中間値とばらつき | 直結スクリプトで複数回テスト | APIYI(apiyi.com)、公式API |
| マルチターンAgentの完了時間 | Codex内の実タスクの総所要時間 | 3グループの対照テスト | APIYI(apiyi.com)、公式API |
| プロトコル互換性 | Responses、WebSocket、ツールイベントのサポート | ファイル読み取り+コード変更+テストという一連のタスクを1回実行 | サービス提供者のドキュメント次第 |
| キャッシュサポート | キャッシュ読み取りトークンが正常に返されるか | usage内のキャッシュフィールドを集計 | サービス提供者のドキュメント次第 |
| 安定性と課金 | 失敗率、同時実行数、課金の透明性 | 429/5xxと請求明細を記録 | サービス提供者のドキュメント次第 |
5.2 実タスクでAPIYIなどのサードパーティAPIを評価する
APIYI(apiyi.com)はAI大規模言語モデルAPIのアグリゲーションプラットフォームで、1つのAPIキーでOpenAI、Claude、Geminiなどの主要モデルを呼び出せます。インターフェースはOpenAIプロトコルと互換性があり、従量課金制です。Codexのシーンにおける価値は、主に横比較のしやすさにあります。同じ設定のまま異なるモデルやサービスティアを切り替えれば、自分のプロジェクト上で比較可能なデータを得られます。
サードパーティのサービス提供者ごとに、通信経路、プロトコル対応、安定性は異なります。評価は具体的なテストデータとサービス契約に基づいて行うべきです。代表的なタスクを2〜3個(たとえば複数ファイルのリファクタリング、テスト付きのバグ修正)選び、第4節の方法で各接続方式において個別に実行し、成功率と総トークン数を合わせて判断することをおすすめします。
💡 選択のアドバイス:まず直結スクリプトでTTFTとTPSが明らかに外れている選択肢を除外し、残った候補をCodexで一連のタスクとして実行します。APIYI(apiyi.com)の統一インターフェースを使えば、コード構造を変えずに複数モデルの比較を完了できます。
よくある質問(FAQ)
Q1:Codex のサブスクリプションとサードパーティ API の速度差は、主にどこから来るのでしょうか?
サービス経路全体の違いから来ています。具体的には、実際のモデル配置、推論強度、サービスグレード、ゲートウェイ経路、転送プロトコル、キャッシュヒット、ツールイベントの互換性の度合いです。Codex のマルチターンな Agent ループでは、こうした単一リクエストごとの差がターンを重ねるごとに積み上がっていくため、総所要時間の差は1回のリクエストの差よりもはるかに大きくなりやすいのです。
Q2:TTFT は正常なのに、Codex のタスクが遅いのはなぜですか?
TTFT は最初のトークンを待つ時間だけを測る指標です。Codex の1タスクには複数ターンの推論とツール呼び出しが含まれており、継続的な出力速度、ツール実行後の再推論、キャッシュミス、途中のリトライなどが総時間を押し上げます。体感を判断するときは、エンドツーエンドの所要時間と呼び出しターン数を見てください。
Q3:WebSocket モードにすると Codex はどれくらい速くなるのですか?
OpenAI が公表しているデータでは、ツール呼び出しが20回以上ある特定のワークフローにおいて、エンドツーエンドの速度が最大で約40%向上します。これは特定シナリオでの上限値であり、実際の効果はタスクのターン数や、インターフェースが WebSocket とインクリメンタルな状態管理をどこまで完全にサポートしているかによって変わります。
Q4:長い会話で Codex がどんどん遅くなる場合、どう対処すればよいですか?
まず各ターンの総入力トークン数とキャッシュ読み取りトークン数を記録し、キャッシュが正常にヒットしているか確認しましょう。履歴コンテキストが長すぎる場合は、新しいセッションを開始するかコンテキスト圧縮を発動します。あわせてタスクの範囲を絞り、探索的なファイル読み取りのターンを減らすことも有効です。
Q5:サードパーティ API が Codex で実際にどう振る舞うかを素早く測るには?
1. APIYI(apiyi.com)で登録し、APIキーと無料テスト枠を取得します。
2. 本記事の直接接続スクリプトで TTFT、TPS、キャッシュヒットを測定します。
3. 4.2 節の手順で Codex を設定し、サブスクリプション側と同じタスクを実行して、エンドツーエンドの所要時間と呼び出しターン数を比較します。
これにより、推論サービスの差と Agent ループに起因する差を切り分けて確認できます。
Q6:公開 Issue のデータは Codex の一般的な性能を代表できるのでしょうか?
そのまま代表させることはできません。Issue #60831 と #44305 はいずれも単一ユーザーのログであり、前者は HTTP レスポンスヘッダーまでに要した時間を測ったもの、後者はタイムアウトした1回の読み取り専用タスクです。これらの価値は、サーバー側の変動や直列的なツールループが所要時間にどう影響するかを示す点にあり、具体的な結論は自分自身のタスクでテストして検証する必要があります。
Codex の速度差に関する重要ポイント(Key Takeaways)
- 経路が異なる:サブスクリプションログインと API Key では課金・サービス経路が異なり、モデル名が同じでも同じデプロイとは限りません。
- ループによる増幅:Codex の Agent ループでは、各ラウンドのわずかな遅延が積み重なり、全体の所要時間に大きな差として現れます。
- 指標を分けて見る:TTFT は最初の応答を見る指標であり、実際の体験を反映するのはエンドツーエンドの所要時間と呼び出しラウンド数です。
- プロトコルの影響:WebSocket はツール呼び出しが多ラウンドにわたる場面で最大約40%の高速化が可能ですが、インターフェース側の完全なサポートが必要です。
- キャッシュは要確認:中継レイヤーがリクエストのプレフィックスを変えるとキャッシュに影響する可能性があるため、キャッシュ読み取りトークンを集計する必要があります。
- 比較テスト:サブスクリプション、公式 API、サードパーティ API の3グループで同一タスクを比較し、さらに直結テストを加えてボトルネックを特定します。
- タスクに応じた選択:実際のタスクを使って APIYI apiyi.com などのプラットフォームで横断テストを行い、単価ではなくタスク完了コストで判断します。
まとめ
同じ Codex で2種類の速度が現れる根本原因は、サービス経路と Agent ループの相乗効果にあります。
- 仕組みの面:モデル、推論強度、サービスティア、ゲートウェイ、プロトコル、キャッシュ、ツールループが総所要時間を左右し、1ラウンドでも差があれば複数ラウンドの呼び出しで増幅されます。
- エビデンスの面:公式データはプロトコルとティアの最適化が無視できない高速化をもたらすことを示し、ユーザーログはサーバー側の変動や直列ループがタスクを大幅に長引かせることを示しています。
- 手法の面:4つの核心指標を記録し、3グループの比較と直結テストを実施してから、症状に応じて項目ごとに最適化します。
トラブルシューティングでは、まずモデルと推論強度を固定し、それからデータで語りましょう。複数のモデルや接続方式を比較する必要がある場合は、APIYI の統一インターフェースを活用すれば、テストコストを最小限に抑えられます。
📚 参考資料
- Codex as a platform: build on the open agent harness:OpenAI による Codex Agent Harness の役割の解説
- リンク:
developers.openai.com/blog/codex-as-a-platform -
説明: Codex のマルチターンのモデルとツールループを理解するための公式根拠
-
Codex 認証ドキュメント:ChatGPT ログインと API Key の2種類の接続方法
- リンク:
learn.chatgpt.com/docs/auth?surface=cli -
説明: サブスクリプション特典と API 課金、レート制限ルールの区別
-
Speeding up agentic workflows with WebSockets in the Responses API:OpenAI のエンジニアリング記事
- リンク:
openai.com/index/speeding-up-agentic-workflows-with-websockets -
説明: Agent ループのフローと WebSocket による高速化のデータ
-
WebSocket モードのドキュメント:Responses API の WebSocket モード
- リンク:
developers.openai.com/api/docs/guides/websocket-mode -
説明: 永続接続、インクリメンタル入力、適したユースケース
-
Latency optimization ガイド:OpenAI のレイテンシ最適化の原則
- リンク:
developers.openai.com/api/docs/guides/latency-optimization -
説明: 出力トークン、呼び出し回数、並列化などの最適化の考え方
-
Fast mode ドキュメント:サービスティアと高速化の適用範囲
- リンク:
developers.openai.com/api/docs/guides/fast-mode -
説明: 速度を比較する際に制御すべきサービスティアの変数
-
Prompt caching ドキュメント:キャッシュの書き込み、読み取り、TTL
- リンク:
developers.openai.com/api/docs/guides/prompt-caching -
説明: 長時間の対話におけるキャッシュヒットの計測と最適化
-
openai/codex Issue #60831 / #44305 / #33029 / #41340 / #42471:ユーザーから報告されたレイテンシと互換性の問題
- リンク:
github.com/openai/codex/issues/60831、github.com/openai/codex/issues/44305、github.com/openai/codex/issues/33029 - 説明: サーバー側の変動、ツールループの増幅、デスクトップクライアントの補助リクエスト、サードパーティ製プロトコルの互換性に関する個別ケースのログ
著者:APIYI 技術チーム
技術交流:Codex の接続や性能テストの経験について交流したい方は、APIYI(APIYI)apiyi.com のサイトトップページからお気軽にお問い合わせください。その他の資料は docs.apiyi.com のドキュメントセンターをご覧いただけます。


