
著者注:本記事で示す能力の境界は、すべてAPIYIのモデルドキュメントに照らして整理したものです。執筆前に2026年11月版で一通り確認しており、結論はドキュメントに従います。
1枚の人物画像と1本の音声を用意して、画面の中の人にしゃべらせたい。これは画像から動画を生成する際によくある要望です。多くの人がまず最初に、driving_audio も一緒に happyhorse-1.1-i2v へ渡してしまい、音声ドライブが効かないと、素材を疑い、パラメータの順序を疑い、果ては自分の呼び出し方まで疑ってしまいます。
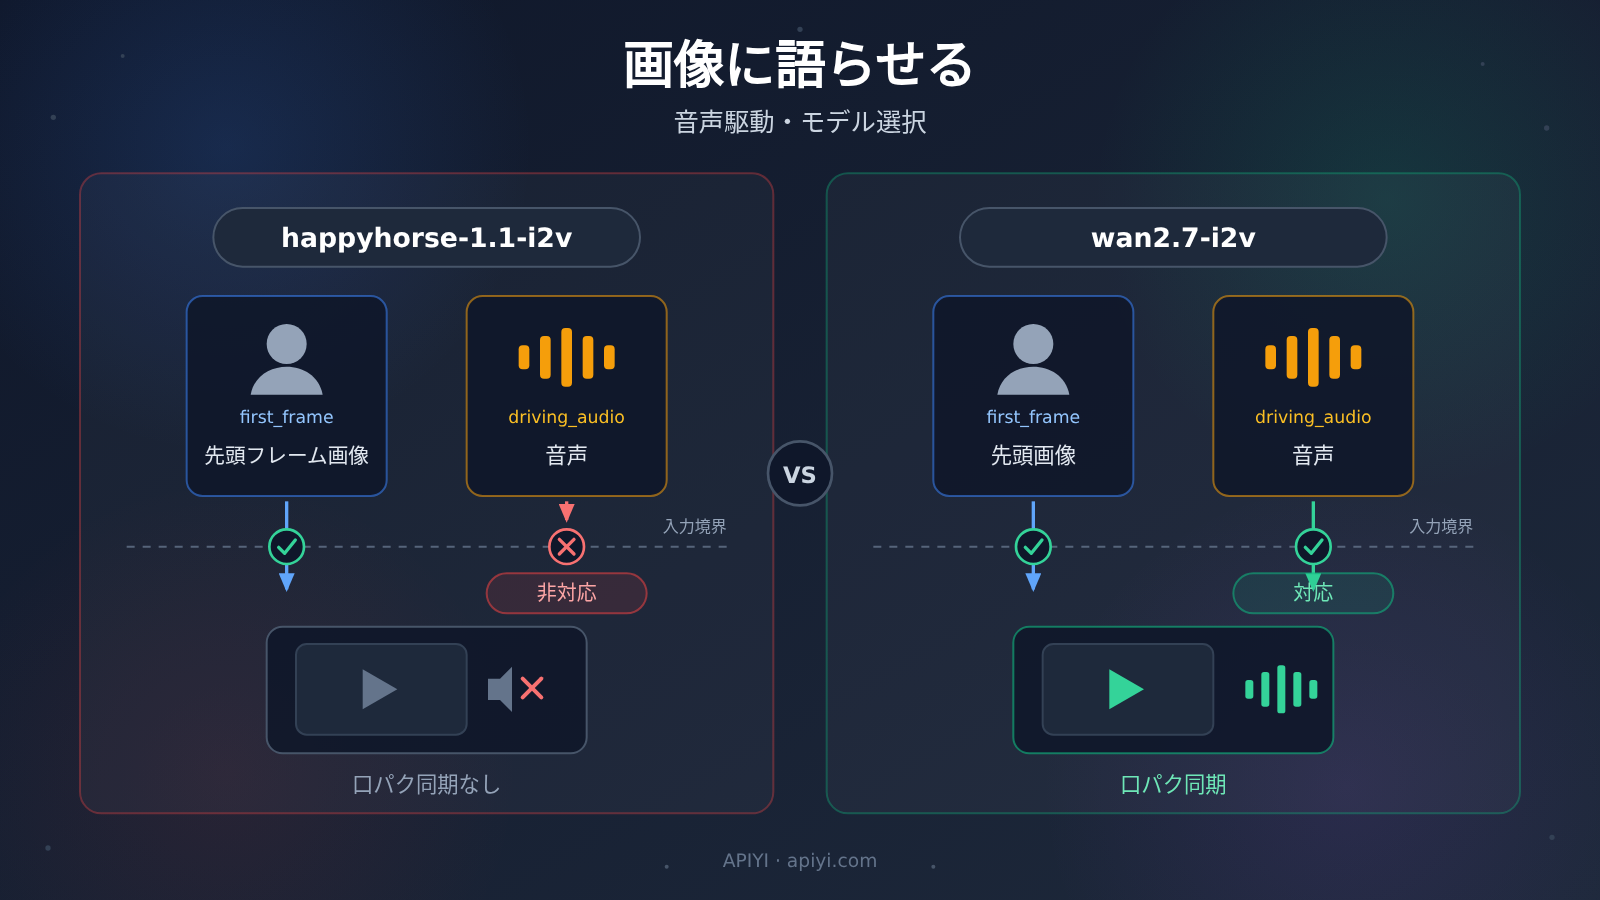
これは不可解な不具合でも、素材が良くないわけでもありません。ドキュメントはこの点を非常に率直に書いています。happyhorse-1.1-i2v は first_frame のみを受け取り、driving_audio には対応していません。リップシンクや「ラップでしゃべる」映像を作りたい場合、ドキュメントが示す方向は wan2.7-i2v に切り替えることです。
この記事の価値:読み終える頃には、happyhorse-1.1-i2v と wan2.7-i2v の役割の境界がはっきり分かり、「画像にしゃべらせる」ためにパラメータをどちらへ渡せばよいかを理解して、一度で動かせるようになります。
happyhorse-1.1-i2v の核心ポイント
まず結論からお伝えし、詳細は後ほど展開します。
| 要点 | ドキュメントの記載 | あなたにとっての意味 |
|---|---|---|
| 最初のフレーム画像のみを受け付ける | happyhorse-1.1-i2v は first_frame 入力を処理する |
画像が唯一の駆動入力である |
| 音声駆動には非対応 | このモデルは driving_audio をサポートしていない |
渡しても反映されないため、何度も再試行する必要はない |
| リップシンクには別の選択肢がある | ドキュメントでは、リップシンクのシナリオには wan2.7-i2v を使うことを推奨している |
パラメータを変えるよりも、モデルを変える方が早く解決する |
1点目は最も誤解しやすいところです。driving_audio は happyhorse-1.1-i2v の隠しパラメータではなく、特定のバージョンを待たなければ使えない機能でもありません。モデルのドキュメントでは明確に「非対応」と記載されており、概要ページの画像から動画生成の項目にも同じ結論が書かれています。つまり、問題はあなたの呼び出し方にあるのではなく、モデルの能力の境界がそもそもここにあるということです。
2点目は代替ルートについてです。ドキュメントによると、音声駆動は wan2.7-i2v 専用の機能であり、HappyHorse の i2v はこの種のタスクを担いません。そのため、人物に話させる必要がある場合、正しい対応はパラメータ調整を続けることではなく、モデルを直接切り替えることです。
happyhorse-1.1-i2v と wan2.7-i2v の核心的な違い
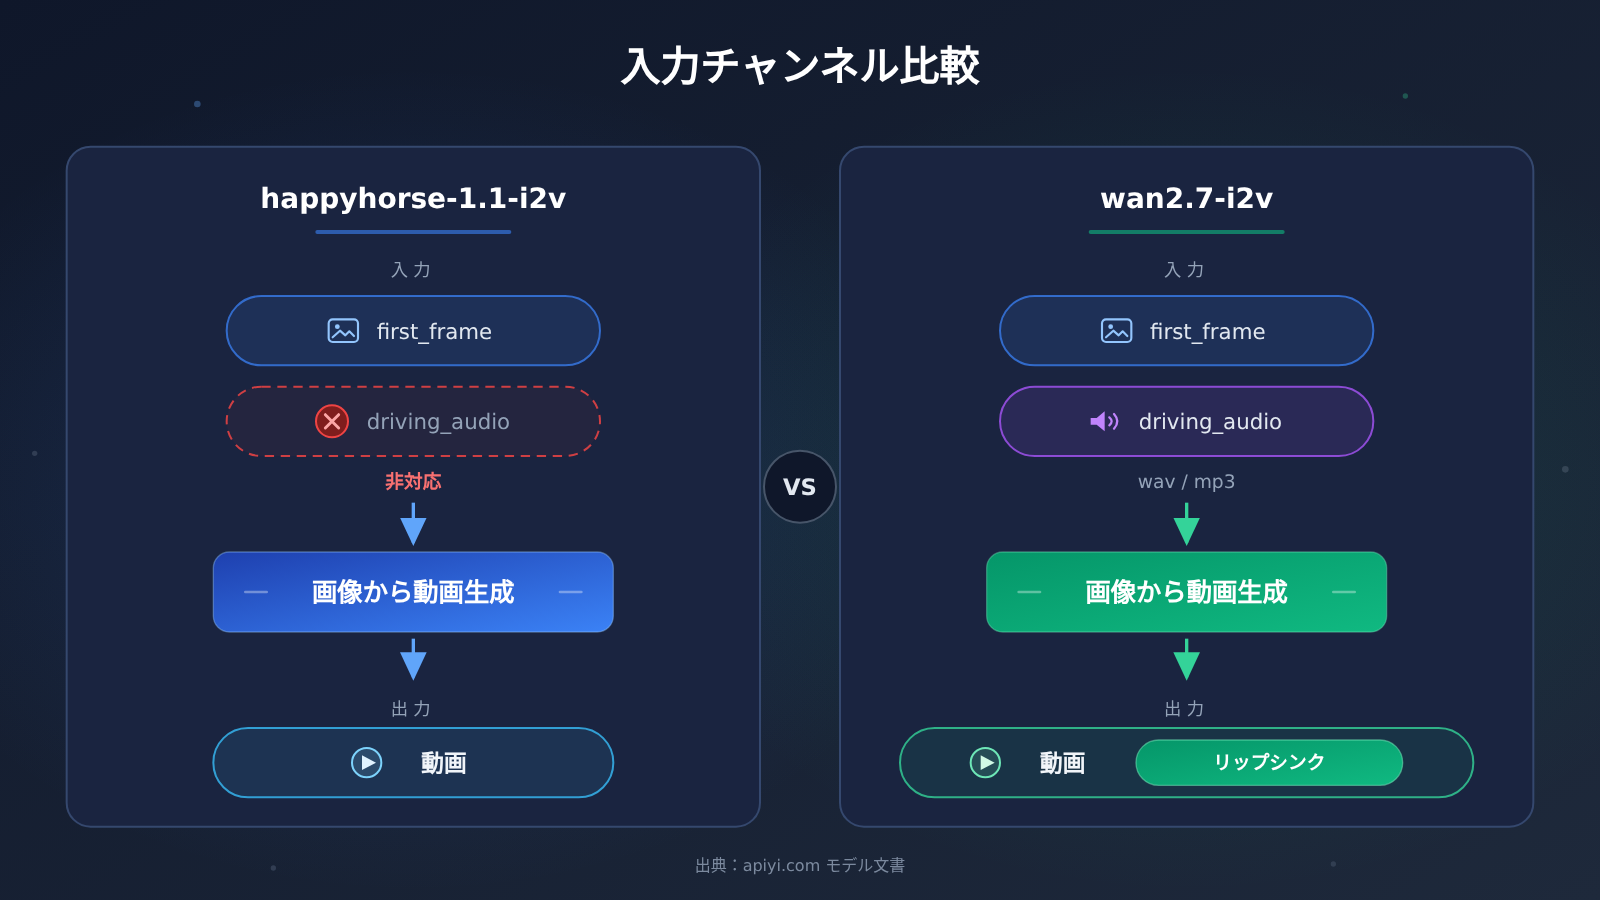
両モデルはいずれも先頭フレーム画像から動画を生成するもので、ポジションが重なっています。両者を大きく引き離すのは、音声入力の行です:
| 比較項目 | happyhorse-1.1-i2v |
wan2.7-i2v |
違いの結論 |
|---|---|---|---|
| タスクの種類 | 先頭フレームからの動画生成 | 先頭フレームからの動画生成 | ポジションは重複、名前で優劣をつけないこと |
first_frame |
受け付ける | 1 個必須 | 画像入力はどちらも欠かせない |
driving_audio |
非対応 | 対応、任意で 1 個 | リップシンクの分岐点 |
| 音声フォーマット | 該当なし | wav または mp3 |
パラメータを渡す前に形式を確認 |
| リップシンクのシーン | ドキュメントは wan2.7-i2v への切り替えを推奨 |
ドキュメントがこのシーンを担うと指定 | モデル選定はこの行を見れば十分 |
上記の表と図は、いずれも APIYI のモデルドキュメント(apiyi.com)に基づいて整理したもので、経験に基づく推測ではありません。
happyhorse-1.1-i2v は「静止した先頭フレームを動かす」という点では正攻法です。first_frame を 1 枚渡せば、あとは画面を動かし続けるのが役割です。ただし音声は入力リストに含まれておらず、ドキュメントには音声駆動機能が HappyHorse の i2v には開放されていないと記載されています。それに対して wan2.7-i2v は、同じ先頭フレーム入力に加えて、もう一つの扉を開いています。それが driving_audio で、人物の動きのリズムを音声に合わせられます。
wan2.7-i2v の制約はさらに具体的です。メディアの中に first_frame がちょうど 1 個なければならず、driving_audio は最大 1 個、音声フォーマットは wav または mp3 に限定されます。これらの制約は明確に明記されているので、ドキュメントどおりに組み立てれば一度で通せます。推測に頼る必要はありません。
なぜ happyhorse-1.1-i2v は driving_audio を受け付けないのか
ドキュメントの手がかりを並べてみると、少なくとも4つの情報が同じ結論を指し示しています。
- モデルページには明記されています。
happyhorse-1.1-i2vは最初のフレーム画像から動画を生成するモデルで、first_frameのみを受け付けます。 - 同じページには「
driving_audio非対応」とはっきり記載されています。 - 概要ページの画像から動画生成の項目でも、音声駆動には非対応と記載されています。
- リップシンクやラップのニーズに対して、ドキュメントは移行案を直接提示しています。
wan2.7-i2vに切り替えてください、と。
ここでよくあるシナリオに戻りましょう。リクエストに driving_audio を含めたのに期待どおりの結果が得られず、素材やパラメータを一つずつ確認し始める、というケースです。インターフェースが最終的にどのような形で応答するとしても、根本的な原因はただ一つ——このフィールドは happyhorse-1.1-i2v の入力範囲に含まれていません。ドキュメントには「書き方を変えれば通る」といった抜け道はなく、リトライや素材の差し替えでは入力の境界線を変えることはできません。
APIYI(apiyi.com)から呼び出している場合は、まずリクエストのモデルIDとフィールド名をドキュメントと項目ごとに照合し、その後で他の部分を確認してください。「音声が効かない」という問題の多くはこの段階で特定でき、遠回りする必要はありません。
wan2.7-i2v の driving_audio でリップシンクを実現:クイックスタート
wan2.7-i2v への切り替えが決まれば、流れは4ステップだけです。ポイントはすべてメディアの組み立てにあります。
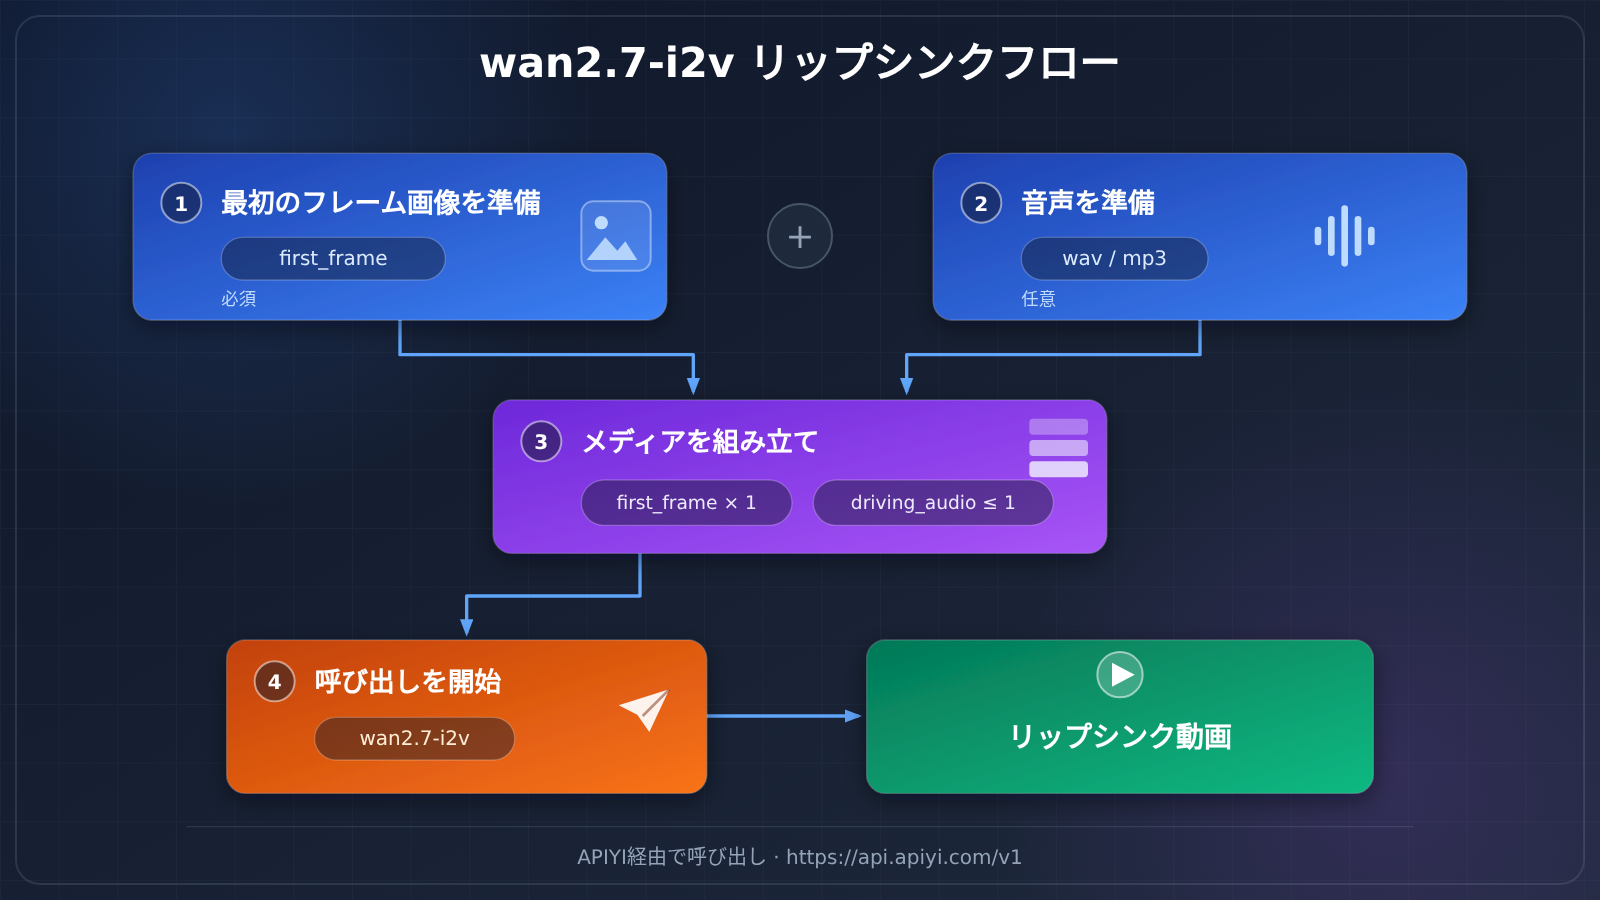
- 最初のフレーム画像を用意する:人物がはっきり写り、構図が安定した画像を
first_frameとして使用します。 - 音声を用意する:
wavまたはmp3形式で、driving_audioとして口パクとリズムを駆動します。 - メディアを組み立てる:
first_frameはちょうど1つ、driving_audioは最大1つで、余分に追加しないでください。 - 呼び出しを実行する:モデルには
wan2.7-i2vを指定します。APIYI経由で呼び出す場合、APIのベースURLはhttps://api.apiyi.com/v1です。
| フィールド | 必須かどうか | 数量制約 | 形式要件 |
|---|---|---|---|
first_frame |
必須 | ちょうど1つ | 最初のフレーム画像 |
driving_audio |
任意 | 最大1つ | wav または mp3 |
最初の2ステップは問題ありません。成否を分けるのは第3ステップです。ドキュメントの数量に関する記述は非常に厳格です。first_frame は必ず1つだけ、driving_audio は任意で最大1つです。画像や音声を余分に渡すとリクエストが規約に適合しない可能性があるため、「多ければ多いほどよい」という直感をパラメータの組み立てに持ち込まないようにしましょう。
🚀 クイックスタート:この流れは APIYI(apiyi.com)で直接検証するのがおすすめです。同プラットフォームはOpenAI、Claude、Geminiなどの主要モデルAPIを集約しており、1つのキーで複数のモデルを呼び出せます。従量課金制で、新規ユーザーには無料テスト枠があり、
wan2.7-i2vのリップシンクをほぼゼロコストで試せます。
happyhorse-1.1-i2v と wan2.7-i2v:シーン別の使い分け
| やりたいこと | 推奨モデル | 主な入力 |
|---|---|---|
| 人物に喋らせる、音声に口の動きを合わせる | wan2.7-i2v |
first_frame と driving_audio |
| ラップやセリフなどリズムのあるパフォーマンス | wan2.7-i2v |
first_frame と driving_audio |
| 静止画を自然に動かしたい、音声は不要 | happyhorse-1.1-i2v |
first_frame のみ |
happyhorse-1.1-i2v に向いているケース
音声を伴わない動画化タスクなら、happyhorse-1.1-i2v が引き続き本命です。役割は首帧画像(最初のフレーム)を動きのある映像へと展開することにあり、入力はシンプルで first_frame だけを受け取ります。完成映像に後からアフレコする場合や、そもそも音声が不要な場合は、こちらに留まるほうがむしろ手間が少なくて済みます。
- 最初のフレームで動きを作る:人物や風景を静止画から自然に動かします。
- 無音コンテンツの制作:完成後にアフレコする場合や、音声が不要な展示用途に。
wan2.7-i2v に切り替えるケース
完成映像で人物を「音に合わせて動かす」必要があれば、答えは wan2.7-i2v にあります。ドキュメントに記載された音声駆動機能により、この2モデルの中で唯一 driving_audio を受け取れる選択肢であり、口の動きとリズムは音声が直接コントロールします。
- リップシンク:1枚の人物画像と1本の音声から、口を動かして喋る動画を生成します。
- 音声駆動のパフォーマンス:ラップやセリフなどリズムのあるコンテンツでは、動作が音声に追従します。
両方のニーズがある場合は、APIYI 上で同じ素材をそれぞれ一度ずつ実行してみましょう。モデルを切り替えても Key を変える必要はありません。比較したうえで分担を決めても遅くはありません。
happyhorse-1.1-i2v と wan2.7-i2v の選択ガイド
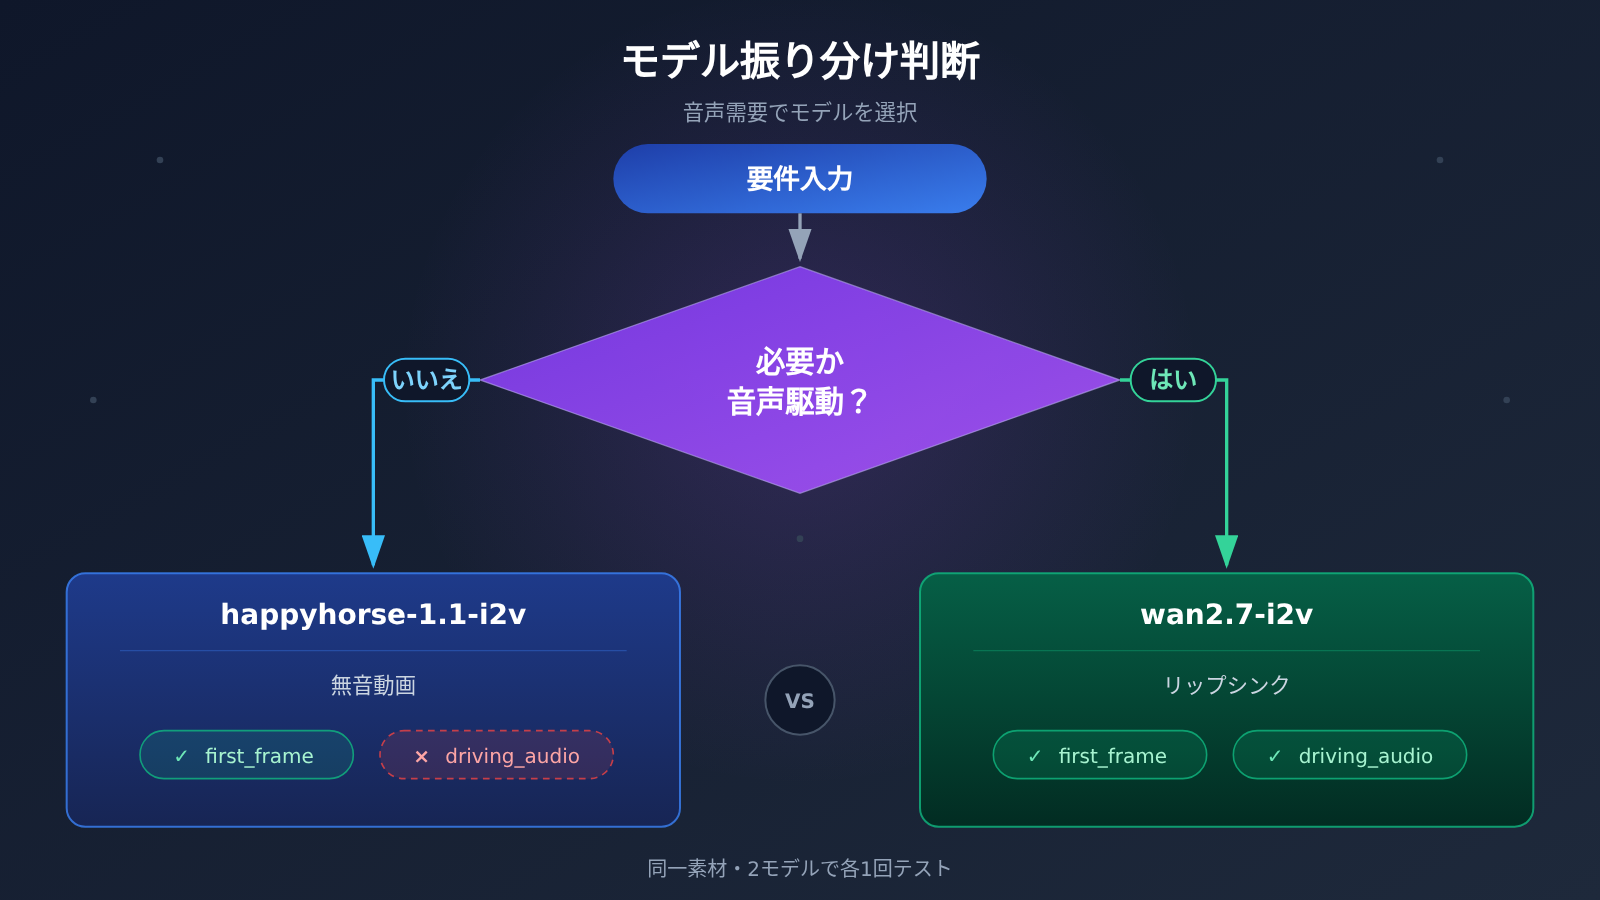
| 現在の状況 | 推奨アクション |
|---|---|
| リップシンクが必須要件 | wan2.7-i2v を直接使い、driving_audio を付ける |
| 映像を動かすだけでよい | happyhorse-1.1-i2v のまま、first_frame のみを渡す |
happyhorse-1.1-i2v に音声を渡したが反映されない |
リトライをやめ、wan2.7-i2v に切り替える。これはパラメータの問題ではない |
判断の核心はただ一言です。「この動画で人物に話させる必要があるか」を先に問いかけてください。音声を演技に参加させる必要があれば、答えは wan2.7-i2v です。不要なら、happyhorse-1.1-i2v が引き続きファーストフレームからの動画生成を担当できます。音声を正しいモデルに渡すほうが、どのモデルでもパラメータを粘り強く調整するより時間の節約になります。
💡 選択のヒント:効果が判断できないときは、ドキュメント上の推論で止まらず、APIYI apiyi.com でそれぞれ最小ケースを一度ずつ実行し、2つの実際の結果で決めるのがもっとも確実です。
driving_audio に関するよくある質問 FAQ
Q1:happyhorse-1.1-i2v とは何ですか?
最初のフレーム画像から動画を生成するモデルで、入力は `first_frame` のみを受け付けます。ドキュメントにも `driving_audio` には対応していないと明記されており、音声駆動はこのモデルの機能範囲外です。
Q2:happyhorse-1.1-i2v と wan2.7-i2v では、音声駆動に関してどう違うのですか?
ドキュメントでは、音声駆動は `wan2.7-i2v` の専有能力と記載されており、同時に HappyHorse の i2v は非対応であることも明記されています。つまり、`wan2.7-i2v` は `driving_audio` を受け取り、`happyhorse-1.1-i2v` は受け取りません。他のモデルが対応しているかどうかは、それぞれのドキュメントに従って判断してください。シリーズ名から類推しないようにしましょう。
Q3:driving_audio を happyhorse-1.1-i2v に渡すとどうなりますか?
ドキュメントの回答は明快です。非対応であり、`first_frame` のみを受け付けます。どのようなエラーが出るかの細部を調べるよりも、この素材一式を `wan2.7-i2v` に回したほうが早道です。同じ画像と音声がすぐに活躍の場を得られます。
Q4:driving_audio にはフォーマットや数の要件がありますか?
音声フォーマットは `wav` または `mp3` です。メディア内にはちょうど 1 つの `first_frame` が必須で、`driving_audio` は最大 1 つまでです。この制約に沿ってリクエストを組み立てれば、一発で通る確率が最も高くなります。
Q5:API 経由で wan2.7-i2v をすばやく呼び出すには?
集約プラットフォームから始めるのがおすすめです:
1. APIYI apiyi.com で登録して APIキーを取得します。新規ユーザーには無料のテスト枠が用意されています;
2. エンドポイントのベースURLには `https://api.apiyi.com/v1` を使用します;
3. 「`first_frame` 1 つ+`driving_audio` 1 つ」でメディアを組み立て、モデルには `wan2.7-i2v` を指定します。
Q6:Wan シリーズならどれでも同じように音声を渡せるのですか?
そのような類推はできません。ドキュメントで音声駆動が記載されているのは `wan2.7-i2v` のみです。他のモデルが対応しているかどうかは該当するドキュメントに従ってください。シリーズ名から能力を推測しないようにしましょう。
Q7:この 2 つのモデルの能力説明はどこで確認できますか?
APIYI では能力の境界をモデルドキュメントに記載しています。docs.apiyi.com にアクセスすれば 1 つずつ確認できます。選定前に一度ドキュメントを確認するほうが、つまずいてから調査するよりもはるかにコストが低く済みます。
happyhorse-1.1-i2v と driving_audio の核心ポイント
- 機能の境界:
happyhorse-1.1-i2vはfirst_frameのみを受け付け、driving_audioは入力に含まれていません。 - 専用機能:音声ドリブンは
wan2.7-i2vの担当で、リップシンクが必要な場合はこちらを使います。 - メディア制約:
first_frameはちょうど 1 つ、driving_audioは最大 1 つまでで、音声はwavまたはmp3に限られます。 - 移行の指針:ドキュメントでは、リップシンクやラップ系のシーンでは
happyhorse-1.1-i2vからwan2.7-i2vに切り替えることを推奨しています。 - 検証方法:同じ素材セットでそれぞれ最小ケースを 1 回ずつ実行すれば、2 つの結果を見るだけで選定を確定できます。
まとめ
「画像にしゃべらせたい」というテーマについて、持ち帰るべき結論は次の 3 つです。
- 入力の境界:
happyhorse-1.1-i2vはdriving_audioを受け付けず、first_frameのみを認識します。これはドキュメントに明記された機能の境界です。 - 正しい使いどころ:リップシンクと音声ドリブンは
wan2.7-i2vの専用機能で、画像 1 枚とwavまたはmp3が 1 本あれば始められます。 - トラブルシューティングの考え方:音声が効かないときは、まずモデルとフィールドの対応関係を確認しましょう。何度もリトライを繰り返すのは得策ではありません。
選定に迷ったら、最小ケースをそれぞれ 1 回ずつ実行してから決めてください。APIYI apiyi.com でのスピーディーな検証がおすすめです。同プラットフォームは無料テスト枠と複数モデルの統一アクセスを提供しており、モデルを切り替えても APIキーを変える必要はありません。
📚 参考資料
- APIYI ドキュメント · HappyHorse 画像から動画生成
- リンク:
docs.apiyi.com/api-capabilities/happyhorse/image-to-video.md -
説明:
happyhorse-1.1-i2vの入力定義、および「driving_audio非対応」という原文の出典。 -
APIYI ドキュメント · Wan 画像から動画生成
- リンク:
docs.apiyi.com/api-capabilities/wan/image-to-video.md -
説明:
wan2.7-i2vにおけるfirst_frameとdriving_audioの数量およびフォーマット制約。 -
APIYI ドキュメント · HappyHorse 概観
- リンク:
docs.apiyi.com/api-capabilities/happyhorse/overview.md - 説明: 画像から動画生成の項目における音声駆動機能の全体的な注記。
作者: APIYI 技術チーム
技術交流: APIYI のウェブサイトのトップページからお問い合わせください。その他の資料は docs.apiyi.com のドキュメントセンターからご覧いただけます。


