
著者注:マルチモデルアプリケーションでは、統一メッセージ形式、ベンダー適応層、機能レジストリを通じて、ツール呼び出し、推論状態、ストリーミング出力、構造化データ、キャッシュの差異を扱うべきです。
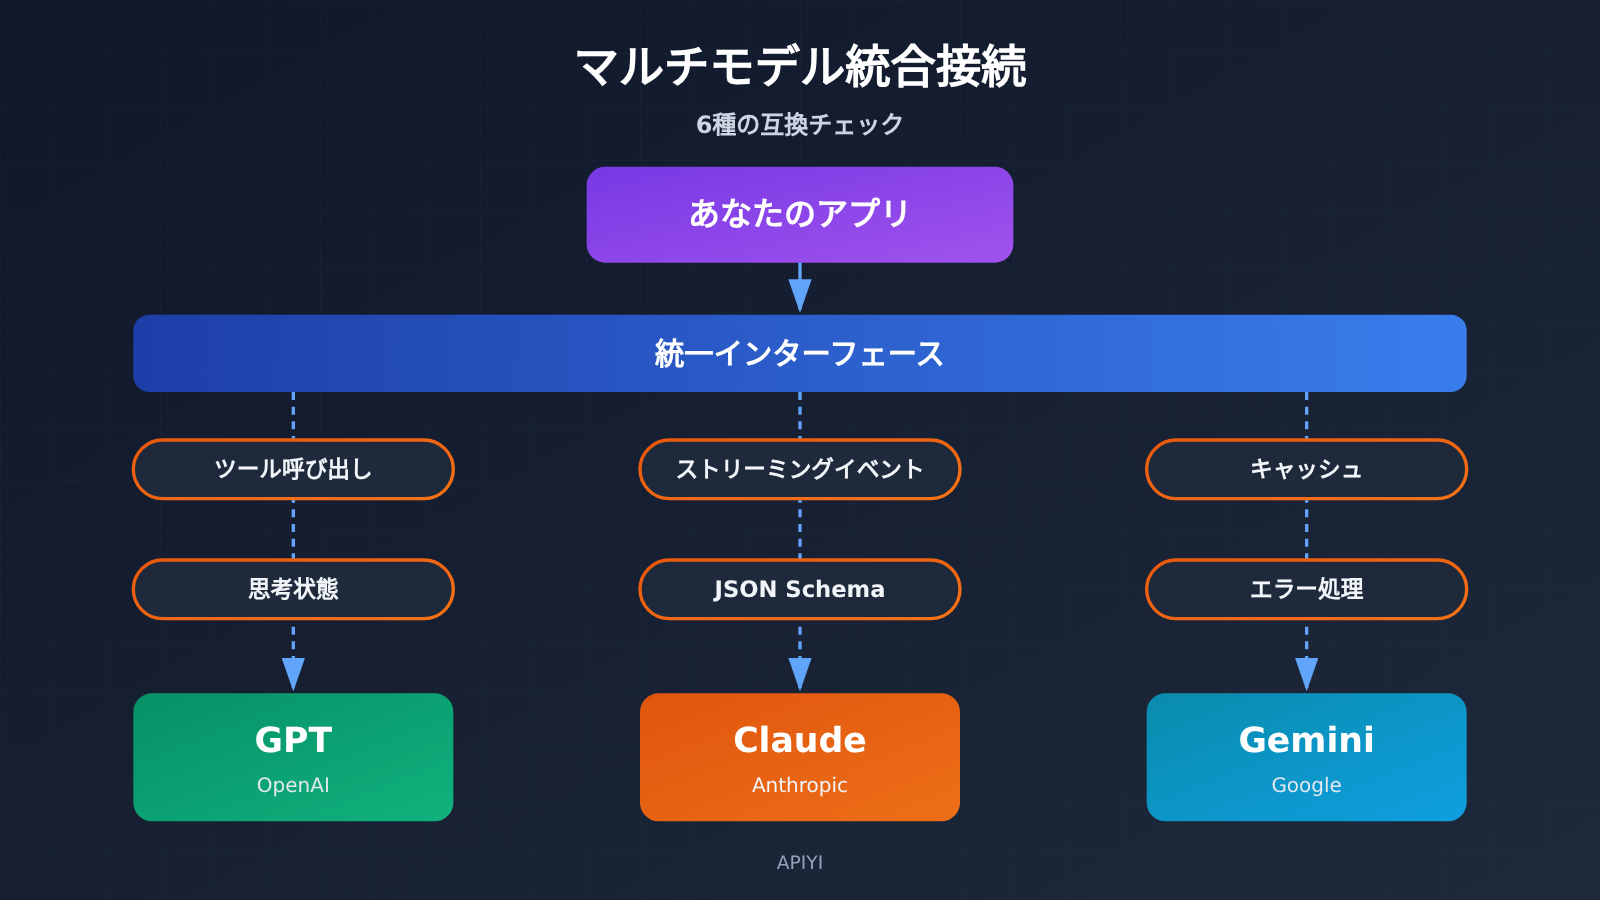
GPT、Claude、Gemini はいずれも通常のテキスト呼び出しに対応しており、Claude と Gemini は公式の OpenAI SDK 互換エンドポイントも提供しています。プロダクションレベルのアプリケーションでモデルを切り替える際には、6 種類の互換性問題——メッセージロールとシステム指示、ツール呼び出しプロトコル、推論パラメータと思考状態、ストリーミングイベント、構造化出力とマルチモーダル、キャッシュ課金とエラーハンドリング——を解決する必要があります。Model ID を差し替えるだけで簡単な Q&A は動きますが、マルチターンのツール呼び出し、ストリーム切断からの復旧、コスト計算は個別に対処しなければなりません。より堅実なエンジニアリング手法は「統一業務インターフェース + ベンダー適応層(Provider Adapter)+ モデル機能レジストリ」です。こうすることで、モデル切り替えを保守可能なプロダクト機能として管理できます。
以下ではまず、3 社のネイティブ API の構造上の違いを比較し、OpenAI 互換インターフェースがどのようなシナリオをカバーできるかを説明します。続いて、6 種類の互換性問題が引き起こす実際の障害を一つずつ分解し、6 層の接続アーキテクチャと実行可能な統一呼び出しコードを示します。最後に、リリース前の 6 項目の互換性テストを挙げ、統一 API ゲートウェイとネイティブ機能の適応の間でどのように役割を分担するかを説明します。
知っておくべきこと:マルチモデルAPI互換の用語集
| 用語 | 説明 |
|---|---|
| API | アプリケーションがモデルサービスにリクエストを送り、結果を受け取るためのインターフェース。 |
| SDK | インターフェース呼び出しの詳細をラップしたソフトウェア開発キット。 |
| ネイティブAPI | ベンダー自身が設計した主要インターフェース。例:OpenAI Responses、Claude Messages、Gemini Interactions。 |
| 互換インターフェース | 別のリクエスト形式(通常はOpenAI形式)を流用する互換エントリーポイント。同じSDKで呼び出せるようにするためのものです。 |
| 関数呼び出し(Function Calling) | モデルが構造化されたパラメータを使って、アプリに外部関数の実行を要求すること。 |
| 呼び出しID | モデルが発行したツール要求と、アプリが返す実行結果を対応付ける識別子。 |
| 思考シグネチャ(Thought / Thinking Signature) | 一部のモデルが推論やツール呼び出しのコンテキストを保存するために使う暗号化された状態データ。そのまま返す必要があります。 |
| ストリーミング出力(Streaming) | サーバーがイベントごとに結果を逐次返し、フロントエンドが受信しながら表示できる方式。 |
| JSON Schema | JSONデータ構造と検証ルールを記述する仕様。 |
| プロンプトキャッシュ(Prompt Caching) | 繰り返し現れる入力プレフィックスの計算結果を再利用し、遅延とコストを抑える仕組み。 |
| TTL | キャッシュの存続時間。期限切れ後は再書き込みが必要です。 |
| アダプター(Provider Adapter) | 統一リクエストを各ベンダーのネイティブ形式に変換し、返却結果を再び統一形式に変換するコンポーネント。 |
| ケイパビリティレジストリ | 各モデル、各接続エンドポイントが実際にサポートするパラメータと機能を記録した設定リスト。 |
| 冪等 | 同じ操作を1回実行しても複数回実行しても効果が同じであること。再試行による二重請求や二重送信を防ぐために使います。 |
1 マルチモデルAPI互換性:モデルを切り替えるときに Model ID だけを変えてはいけない理由
3社はいずれも model フィールドでモデルを指定できますが、リクエストボディ、レスポンスオブジェクト、コンテキスト状態の組み立て方はそれぞれ異なります。通常のQ&Aであれば差異はフィールド名に集中するため、適応コストは低めです。しかしAgent系アプリではツール呼び出し、推論状態、ストリーミングイベントに依存するため、その差異がそのまま本番障害につながります。
1.1 GPT、Claude、Gemini 3社のネイティブAPI対照
下表はネイティブAPIのみを扱い、互換レイヤーやゲートウェイのエンドポイントには触れません。
| 観点 | OpenAI(ネイティブ) | Claude(ネイティブ) | Gemini(ネイティブ) |
|---|---|---|---|
| 主要インターフェース | Responses API、/v1/responses |
Messages API、/v1/messages |
Interactions API(2026年6月にGA、公式が新規プロジェクトでの利用を推奨)。generateContent も引き続きサポート |
| 入力の構成 | model + input |
model + messages + max_tokens。system はメッセージ配列とは独立 |
ネイティブのInteractions構造。加えて system_instruction のルールあり |
| 出力構造 | 複数タイプの出力項目:テキスト、reasoning項目、function_call など |
content blocks:text、thinking、tool_use など |
steps:モデル出力、ツール呼び出し、推論などのステップ |
| 終了判定 | レスポンス完了イベント/出力項目のタイプ | stop_reason(正常終了、ツール実行が必要 など) |
ステップのタイプとインタラクション状態 |
| コンテキストの継続 | previous_response_id |
アプリ側が完全なメッセージ履歴を返送 | previous_interaction_id。サーバー側セッション状態も任意で利用可 |
| 組み込みツール | プラットフォームツール + カスタム関数 | カスタムツールが中心 | Google Search、URL Context、コード実行などの組み込みツール。サードパーティツールはアプリ側で実行 |
上の表から分かるように、3社は「コンテキストを誰が保持するか」の時点で2つの路線に分かれています。OpenAIとGeminiはサーバー側でのコンテキスト継続に対応し、Claude Messagesはアプリ側が履歴を返送します。アプリの会話ストレージをどちらか一方の方式だけで設計していると、別のプロバイダーへ切り替えたときにコンテキストの消失や重複送信が発生します。
1.2 OpenAI互換インターフェースはどこまで解決できるか
ClaudeとGeminiはいずれもOpenAI SDK互換のエントリポイントを提供しています。Geminiの公式互換エンドポイントは generativelanguage.googleapis.com/v1beta/openai/ で、OpenAIクライアントを使う場合は base_url、APIキー、model を変更するだけで済みます。一方、Claudeの互換ドキュメントは対応範囲を明確に限定しており、2026-11-13 時点で判明している制限は次のとおりです。
- ツール定義の
strictパラメータは無視されるため、ツールパラメータの厳格な制約が機能しません。 - プロンプトキャッシングはサポートされません。
- audio、file タイプの入力はサポートされません。
systemとdeveloperのメッセージは先頭にまとめてマージされたうえで処理されます。thinking関連のフィールドはネイティブAPIと差異があります。
互換インターフェースは3つのシーンに向いています。通常のチャット、単一ターンの生成、そして複数モデルの回答品質を素早く比較する用途です。複雑なAgentの移行では、厳格なツールパラメータ、キャッシュ、ファイル入力、マルチターンの推論状態が関わってくるため、これらの機能はネイティブAPIに戻るか、項目ごとに検証したうえでリリースする必要があります。実用的な判断基準はこうです。アプリが依存する機能がネイティブドキュメントにしか登場しないのであれば、それをケイパビリティレジストリに記録し、専用のアダプターで扱うようにします。
2 GPT、Claude、Gemini のモデル切り替えで最もよく遭遇する6つの互換性問題
2.1 メッセージロールとシステム指示の互換処理
OpenAIはdeveloperやsystemなどのロールを区別します。Claudeのsystem命令はメッセージ配列の外側に置かれます。Geminiはsystem_instructionを使用し、ユーザーとモデルの内容にも独自の構造ルールがあります。3者はいずれも「命令の優先度 + 複数ターンの履歴」を表現しますが、それを保持するフィールドの位置はそれぞれ異なります。
よくある障害は、安易な文字列連結から生まれます。システム命令、履歴メッセージ、ツール結果をひとつの文字列にまとめて、ユーザー入力としてモデルに渡すのです。これでも動作はしますが、命令の優先度が弱まり、モデルが履歴中のツール出力をユーザーからの新しい要求と見なす可能性があります。正しい方法は、アプリケーション内部でロールのセマンティクスを保持し、アダプターが各社のフィールドへマッピングすることです。また、Claude互換レイヤーはsystemとdeveloperを統合するため、両者の階層化に依存したプロンプト設計では、実際にテストして効果を確認する必要があります。
2.2 ツール呼び出しプロトコルと呼び出しIDの互換処理
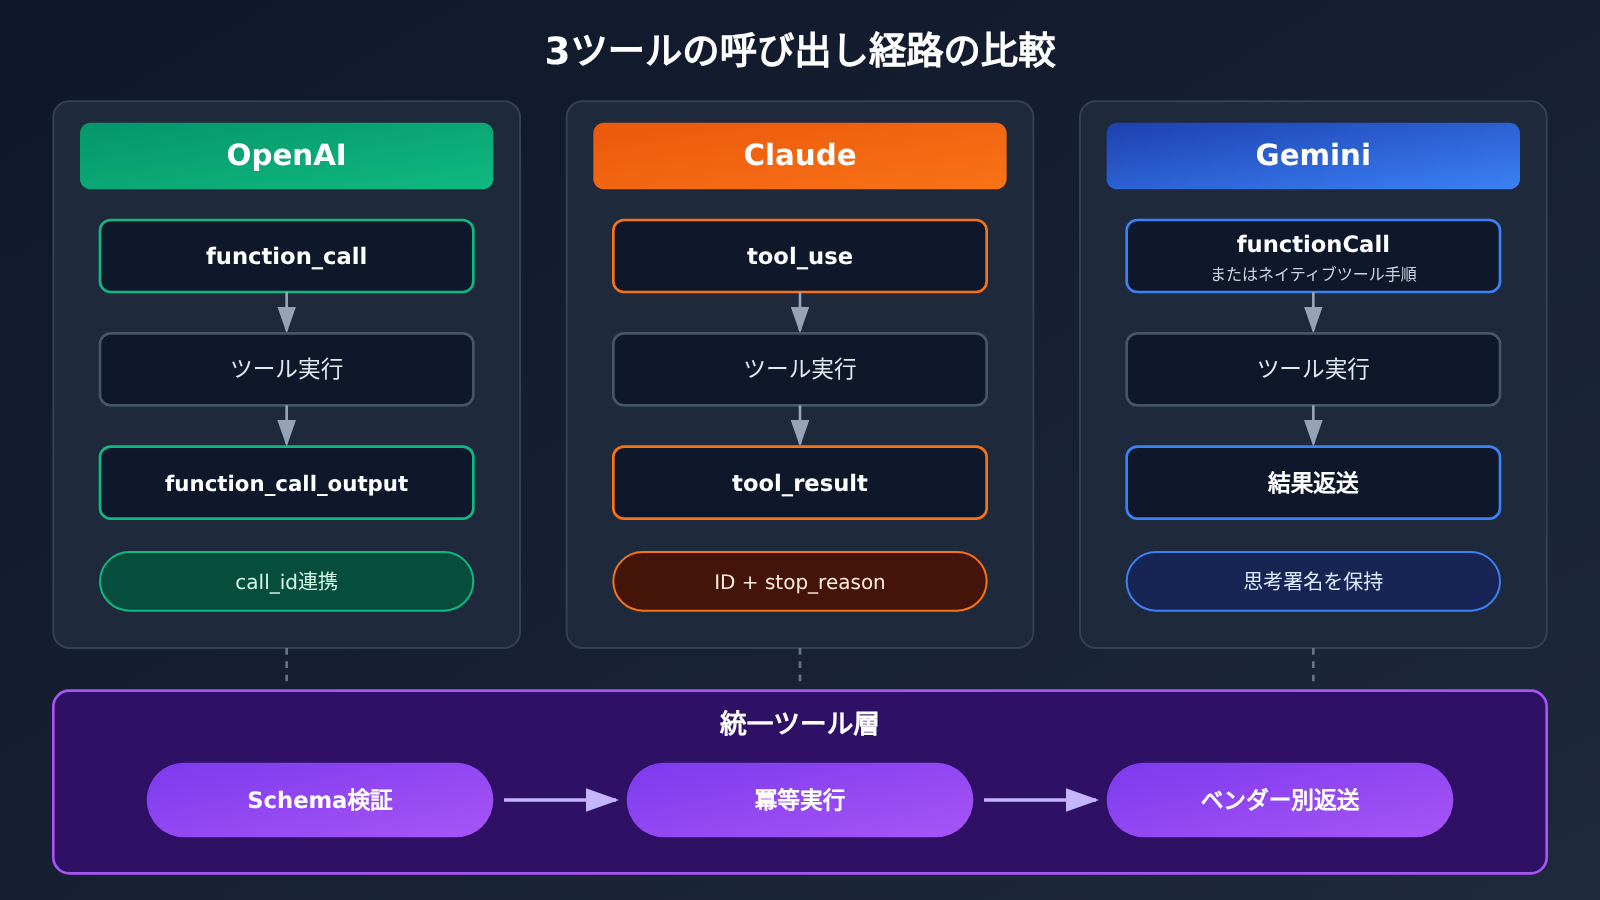
3社はいずれも Function Calling をサポートしており、呼び出しチェーンの形態は次のとおりです。
| 段階 | OpenAI | Claude | Gemini |
|---|---|---|---|
| モデルによる呼び出しの開始 | function_call 出力項目 |
tool_use コンテンツブロック |
functionCall / ネイティブツールステップ |
| 関連付け識別子 | call_id |
tool_use の ID |
対応する呼び出し識別子 |
| アプリからの返送 | function_call_output |
tool_result コンテンツブロック |
対応する結果返送構造 |
| 継続が必要か | 出力項目に基づいて判断 | stop_reason がツール実行の必要性を示す |
ステップの状態に基づいて判断 |
| 推論状態 | reasoning 項目は履歴とともに渡す必要がある場合がある | thinking ブロックはそのまま返送する必要がある場合がある | stateless モードでは thought ブロックと署名を保持する必要がある |
ツール層では、呼び出しID、関数名、パラメータJSON、並列呼び出しの関係、実行結果、およびモデルが推論の継続を要求しているかどうかという6項目の情報を完全に保存する必要があります。並列呼び出しは最もエラーが起きやすい部分です。モデルが一度に複数のツールリクエストを開始した際、アプリがそのうち1つの結果だけを返送したり、結果とIDの対応が誤っていたりすると、次のリクエストでパラメータエラーが発生し、モデルが誤ったデータに基づいて回答を続ける可能性があります。
ツール層を統一する際は、まず JSON Schema でパラメータを検証し、検証に通過した後に実際の外部操作を実行することを推奨します。モデルが生成するパラメータは常に有効とは限らず、事前に検証することで「外部システムの呼び出し」の前でエラーを食い止められます。
2.3 推論モードとコンテキスト状態の互換処理
推論パラメータの名称と意味は、3社の間で必ずしも一致していません。
- OpenAI:
reasoning.effortなどのパラメータを使用します。GPT-6 Astra と GPT-6.1 Sol はreasoning.effort=noneを受け付けず、これら2モデルのツール呼び出しでは Responses API の使用も求められます。 - Claude:新世代モデルは主に Adaptive Thinking を採用し、effort などの思考設定を組み合わせます。一部の新モデルでは、従来型の固定
budget_tokensによる手動思考モードがすでにサポートされていません。 - Gemini:モデルごとに thinking level または budget を使用し、推論を無効化できるか、どのような段階があるかもモデルによって異なります。ネイティブ API と OpenAI 互換エントリでは、パラメータのマッピングルールも異なります。
製品 UI で「高速・標準・深掘り」の3段階の推論強度を設計する場合、段階名は製品としての意図を表しています。アダプターはそれを各モデルが実際にサポートするパラメータに変換する必要があり、同じ段階でも3社が得る計算リソースは同じではありません。また、ユーザーに見える思考の要約と、実際に課金される思考 Token 数が一致しないことがあり、コスト統計は API が返す使用量フィールドに基づく必要があります。
マルチターンのツール呼び出しにおける暗号化状態は、長期的に動作する Agent が最も見落としやすい問題です。
- OpenAI Responses の reasoning 項目とツール呼び出しは、履歴とともに引き続き渡す必要がある場合があります。
- Claude の
thinking/redacted_thinkingブロックには暗号化状態が含まれることがあり、ツール実行後に返送する際は元の構造を保つ必要があります。 - Gemini Interactions の stateless モードでは、thought ブロックと署名をそのまま保持する必要があります。stateful モードを使用する場合、一部の状態はサーバー側で維持できます。
チャットウィンドウに表示されるテキストだけを保存しても、モデルの推論履歴を完全に復元することはできません。典型的な障害は、Agent が3回目のツール呼び出し後に突然エラーを出したり、すでに完了したステップを繰り返し始めたりすることです。原因は通常、途中のいずれかのターンで署名ブロックが失われたことにあります。
2.4 ストリーミングイベントの統一
3社のストリーミングイベントは、種類・順序・終了シグナルがそれぞれ異なります。OpenAI Responses は response.output_text.delta、ツール呼び出しの差分、response 完了イベントを出力する場合があります。Claude Messages のストリームでは、message_start、content_block_delta、message_delta などのイベントを使用します。Gemini のネイティブAPIは、独自の出力とステップ構造を使用します。
フロントエンドでベンダーの生イベントを直接解析すると、モデルを追加するたびにフロントエンドのコードを変更する必要があります。バックエンドで内部イベントプロトコルに統一変換することをおすすめします。
| 内部イベント | 意味 | 処理のポイント |
|---|---|---|
text_delta |
テキスト差分 | そのまま追記して表示 |
reasoning_summary |
思考サマリー | 折りたたみ表示可能。課金は usage を基準とする |
tool_call_start |
ツール呼び出しの開始 | 呼び出しIDと関数名を記録 |
tool_call_args |
引数の断片 | 呼び出しIDまたはインデックスで結合し、すべて揃ってから解析 |
tool_result |
ツール実行結果 | 呼び出しIDと1対1で対応 |
usage |
使用量統計 | 入力、キャッシュ、思考、出力のTokenを区別 |
completed |
正常終了 | 明確な終了シグナルを必ず受信する |
error |
エラーまたはストリーム切断 | 再試行可能と再試行不可を区別 |
ストリーミング処理には、頻発する障害ポイントが3つあります。1つ目は、複数のツール呼び出しの引数断片が交互に到着し、到着順に結合すると呼び出しIDが混ざるケースです。2つ目は、JSON引数が任意の文字位置で分割され、半分受け取った時点で解析すると例外が発生するケースです。3つ目は、接続が途中で切れたのに完了イベントを受信できず、画面が「生成中」のまま止まってしまうケースです。変換レイヤーでは、これら3つのケースを明示的に処理する必要があります。
2.5 JSON Schema 構造化出力とマルチモーダル能力の差異
3社はいずれも構造化出力機能を提供していますが、サポートする JSON Schema の機能、厳格モード、ツール呼び出しとの組み合わせ方には違いがあります。Claude 公式は2つのメカニズムを区別しています。JSON outputs は最終回答の構造を制約し、Strict tool use はツール呼び出しパラメータの構造を制約します。一部のモデルでは、厳格なフォーマットを使用する際に、追加の Schema コンパイルやキャッシュのオーバーヘッドが発生します。
エンジニアリング上の推奨事項としては、アプリケーション側で独自の標準 JSON Schema を維持し、能力レジストリに各モデルがどの Schema 機能をサポートしているかを記録します。サポートされていない機能については、アダプターでダウングレード変換を行います。モデルがどれほど厳格さを謳っていても、アプリケーション側でもう一度検証を行い、検証失敗時は制御可能なリトライまたはエラー処理のフローに入ります。
マルチモーダルも同様です。「画像入力対応」は能力カテゴリを示すだけなので、具体的には次の点も比較する必要があります。受け入れ可能なファイルタイプ、サイズ、画像数、動画・音声機能、ファイルアップロード方式、長いコンテキストの上限と実際に利用可能な範囲、最大出力 Token、そしてツール呼び出しをマルチモーダル入力と組み合わせて使えるかどうか。Claude 互換レイヤーが audio、file 入力をサポートしていないことは、レジストリに記載すべき具体的な制限の一例です。
2.6 キャッシュ、課金、エラー処理におけるモデル間の違い
3社のプロンプトキャッシュの仕組みには、明確な違いがあります。
- OpenAI:GPT-5.6 以降のモデルは、暗黙的キャッシュと明示的キャッシュブレークポイントをサポートします。TTL には30分と12時間の2種類があります。
- Claude:
cache_controlで自動キャッシュまたは明示的キャッシュを指定でき、5分と1時間の2つのモードをサポートします。この機能は同社の OpenAI 互換レイヤーではサポートされていません。 - Gemini:新しいモデルでは自動の暗黙的キャッシュが提供され、一部の API とモデルではキャッシュオブジェクトを明示的に作成できます。
モデルを切り替えると、元のベンダーのキャッシュは通常再利用できません。会話の途中で Claude から Gemini に切り替えると、最初のリクエストは入力全体に対して課金されます。コスト見積もりで「キャッシュが常にヒットする」と想定している場合、切り替えが頻繁になるほど請求額のずれが大きくなります。
各社の標準単価にも明確な差があります。2026-11-13 時点の公式標準価格は次のとおりです(USD / 100万トークン)。
| モデル | 入力 | 出力 | 備考 |
|---|---|---|---|
| GPT-6 Astra | $10 | $50 | ツール呼び出しには Responses API が必要 |
| GPT-6.1 Sol | $1 | $5 | ツール呼び出しには Responses API が必要 |
| Claude Sonnet 5.5 | $2 | $10 | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | プロモーション価格は 2026-12-31 まで;2027-01-01 から $1.50 / $7.50 に調整予定 |
この表は課金の違いを説明するためのものであり、各モデルの能力や利用条件は異なります。価格の高低をそのまま性能比較に換算することはできません。また、表にはキャッシュ書き込み、ツール呼び出し、サービス階層、第三者による追加料金などは含まれていません。
💰 コスト計算のヒント:マルチモデルアプリケーションの請求明細は、「通常入力、キャッシュ書き込み、キャッシュヒット、思考と出力、ツール費用、長コンテキスト追加料金」ごとに項目を分けて記録する必要があります。APIYI apiyi.com を通じて複数モデルを一元的に呼び出す場合、各モデルの使用量を同じ場所で確認できるため、ルーティング戦略と実際のコストを対応付けやすくなります。
エラー処理の面では、3社のリクエストレート、Token レート、クォータ、タイムアウト、エラー形式がそれぞれ異なります。アプリケーションでは統一したエラー分類を設けるべきです。認証失敗、モデル非対応、不正なパラメータ、リクエストサイズ過大またはコンテキスト超過、429 レート制限、サーバーエラー、ネットワーク切断、レスポンスストリームの中断、ツール呼び出し失敗などです。
モデルフォールバックでは、タスクに副作用があるかどうかも考慮する必要があります。メインモデルがツール実行後にタイムアウトし、システムが自動で代替モデルに切り替えてタスク全体を再実行すると、支払い、メール送信、ファイル変更といった操作が二重に実行される可能性があります。解決策は、副作用のあるツールに冪等キーを付与し、フォールバック時は「まだ実行していないステップ」からのみ再開することです。
3 マルチモデル API 互換アーキテクチャはどう設計すべきか
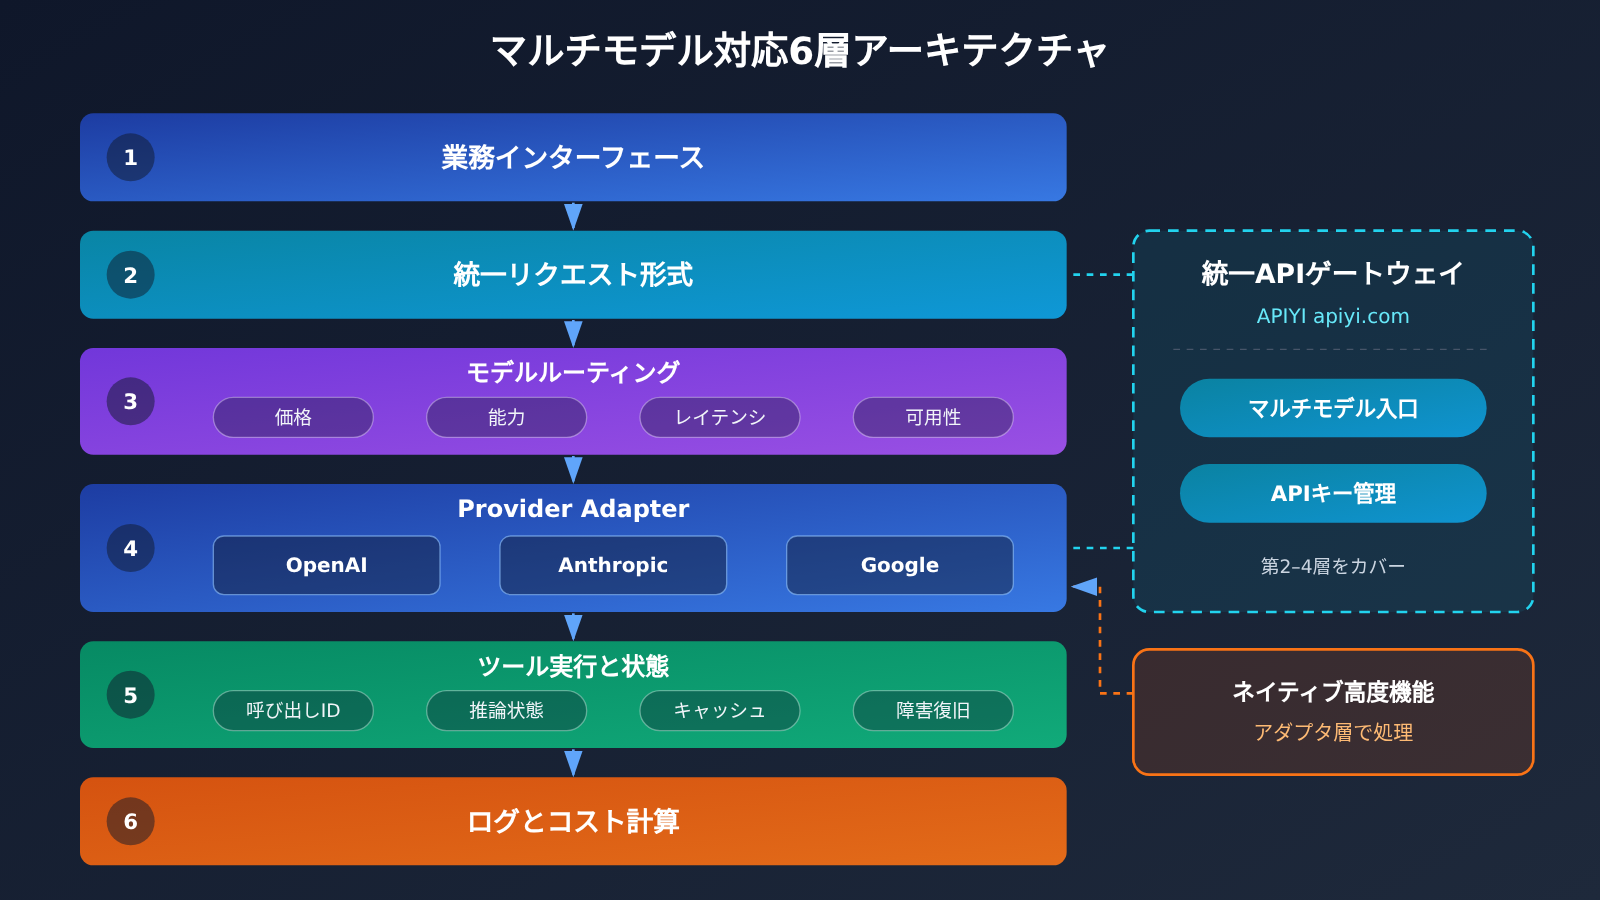
推奨する六層構造は次のとおりです。
- 業務インターフェース:ユーザーが質問し、資料をアップロードし、モデルとタスクを選択します。
- 統一リクエスト形式:メッセージ履歴、添付ファイル、ツール一覧、構造化出力の要件、推論強度、タスク ID を統一構造で表現します。
- モデルルーティング:価格、能力、レイテンシ、可用性、業務ルールに基づいて GPT、Claude、Gemini を選択します。
- Provider Adapter:標準リクエストを各社のネイティブ形式に変換し、返却結果を内部形式にマッピングします。
- ツール実行と状態管理:呼び出し ID、実行記録、会話コンテキスト、ベンダーの推論状態、キャッシュ、障害からの復旧を維持します。
- ログとコスト計算:各リクエストのモデル、トークン、実際の費用、レイテンシ、キャッシュ、エラー、ツール呼び出しを記録します。
3.1 統一メッセージおよびツールフォーマットの構築
統一フォーマットの核心となる原則は、履歴を2つの層に分けて保存することです。第1層は汎用的な標準履歴で、ユーザーメッセージ、モデルの最終回答、ツールリクエスト、ツール結果を含み、どのベンダーでも解読できます。第2層はベンダー固有の状態で、reasoning項目、thinking署名、thoughtブロックなどが該当し、ベンダーごとに分離して保存し、同じベンダーへのリクエスト時のみそのまま返送します。
from dataclasses import dataclass, field
from typing import Any, Literal

@dataclass
class ToolCall:
    call_id: str              # 統一呼び出しID。アダプターがベンダーIDとの相互マッピングを担当
    name: str
    arguments: dict[str, Any]
    result: Any = None
    idempotency_key: str = "" # 副作用のあるツールでは必ず設定する

@dataclass
class Message:
    role: Literal["system", "developer", "user", "assistant", "tool"]
    content: list[dict]                      # テキスト、画像などのマルチモーダルブロック
    tool_calls: list[ToolCall] = field(default_factory=list)
    # ベンダー固有の状態:キーはベンダー名、値はそのまま保存された署名 / reasoningブロック
    vendor_state: dict[str, Any] = field(default_factory=dict)
モデルを切り替える際、アダプターは標準フィールドを読み取って新しいリクエストを生成します。vendor_state のうち他のベンダーに属する部分は送信せず、対象ベンダーに属する部分はそのまま返送します。
3.2 Provider Adapter でネイティブ API を適合させる
各アダプターは3つの責務を担います:
- 入力変換:ロールマッピング(たとえば system を Claude の独立フィールドへ移す)、ツール定義の変換、Schema のダウングレード、推論レベルのマッピング。
- 出力変換:ネイティブ応答とストリーミングイベントを 2.4 節の内部イベントに変換し、ツール呼び出し ID を統一 ID にマッピングします。
- 状態処理:署名や reasoning 項目などのベンダー状態を抽出・保存し、サーバー側の継続(
previous_response_id、previous_interaction_id)を使うか、履歴を完全に返送するかを決定します。
通常の質疑応答は OpenAI 互換形式の共通アダプターで処理できます。厳密なツールパラメータ、キャッシュ制御、暗号化された思考状態が必要な場面では、個別にネイティブアダプターを実装します。こうすることで、統一された入口の利便性を保ちつつ、高度な機能にも明確な実装先を与えることができます。
3.3 ケイパビリティレジストリで利用可能な機能を決める
ケイパビリティレジストリは「モデル + 接続エンドポイント」を単位として、実際のサポート状況を記録します。同じモデルでも、ネイティブ API 経由と互換レイヤー経由では、別々のレコードに対応する場合があります。以下はその構造の一例で、具体的な値は必ず公式ドキュメントとご自身のテスト結果に基づいてください:
gpt-6.1-sol@responses:
  tools: true
  tool_api: responses          # ツール呼び出しでは Responses API の使用が必要
  reasoning_effort: [low, medium, high]   # none は受け付けない
  vendor_state: reasoning_items
claude-sonnet@openai-compat:
  tools: true
  strict_tools: false          # 互換レイヤーは strict を無視する
  prompt_caching: false
  file_input: false
  merges_system_developer: true
gemini-flash@interactions:
  tools: true
  builtin_tools: [google_search, url_context, code_execution]
  vendor_state: thought_signatures
ルーティング層はモデルを選択する前にレジストリを参照します。リクエストにファイルが含まれていれば file_input: false のエントリを除外し、厳密なツールパラメータが必要なら strict_tools: true のエントリだけを選択します。製品の UI でも、これに基づいて現在のモデルがサポートしていないオプションを非表示にでき、ユーザーがエラーを引き起こす状況を減らせます。
4 マルチモデルAPIの互換性対応――リリース前のテストと観測
4.1 シンプルな質疑応答からマルチターンのツールチェーンまで、6つの互換性テスト
複雑さが増す順に、次の6つのテストを進めていきます。
- 通常の質疑応答:同じプロンプトを3つのモデルに送り、回答内容とトークン統計が正常かどうかを確認します。
- ストリーミング出力:出力が継続的に届き、正しい終了シグナルを受け取れることを確認します。
- ツール呼び出し:モデルが天気照会やデータ照会のツールを呼び出し、アプリ側が実行して結果を返します。
- マルチツールループ:2ラウンド以上にわたってツールを呼び出し、履歴とコールIDが完全に保たれていることを確認します。
- 構造化JSON:同じSchemaに沿って出力し、アプリ側のバリデータで構造を検証します。
- モデル切り替え:同じ業務セッションをGPT、Claude、Geminiの間で切り替え、コンテキスト、ツール記録、最終回答がすべて正常であることを確認します。
第4項と第6項は、推論状態に関する問題を最もよく浮き彫りにします。そのため、継続的インテグレーション(CI)のプロセスに組み込むことをおすすめします。モデルのバージョンをアップグレードするたび、あるいは接続エンドポイントを変更するたびに、もう一度実行してください。
4.2 コストと安定性を統一して観測する仕組みづくり
リクエストごとに、少なくとも次の項目を記録します。モデルとエンドポイント、リクエスト成功率、異常の種類(第2.6節の分類に従います)、最初のトークンが届くまでの遅延とタスク全体の所要時間、トークンの内訳(入力、キャッシュ書き込み、キャッシュヒット、思考、出力)、ツール呼び出しの回数と失敗回数、リトライ回数とフォールバック回数です。
モデルを評価するときは、タスク全体の総所要時間と総コストを見ることが大切です。単一リクエストのデータは、参考程度の価値しかありません。単価が安いモデルでも、ツールパラメータのエラー率が高く何度もリトライが必要になれば、全体のコストはかえって高くなる可能性があります。
5 統合APIゲートウェイがマルチモデルAPI互換性において果たす役割
5.1 接続と保守のコスト
3つのモデルを同時に使うということは、3組のアカウント、3組のキー、3組の課金体系、3組のSDK設定を抱えることになります。統合APIゲートウェイは、こうした作業を1つの入口に集約します。モデルの接続と認証情報を一元管理し、各プロバイダーの設定保守を減らし、設定レイヤーでのモデル選択・切り替えを可能にし、利用量とコストを統合的に可視化します。モデルの効果を頻繁に比較するチームにとって、新しいモデルを試すハードルも下がります。
5.2 APIYI の立ち位置:統一入口とネイティブ機能適配の役割分担
APIYI はAI大規模言語モデルAPIのアグリゲーションプラットフォームです。1つのAPIキーだけで、OpenAI互換インターフェースを通じてOpenAI、Claude、Geminiなどの主要モデルを呼び出せ、従量課金で利用できます。アーキテクチャにおける「統一呼び出し入口」というレイヤーを担うのに適しており、通常の質問応答、ストリーミング出力、モデル比較、マルチモデルルーティングはそのまま接続できます。
「統一呼び出し入口」と「ベンダー固有のネイティブ機能が完全に一致すること」は、2つの異なる技術要件です。具体的なモデルを接続する際には、ツール呼び出し、思考状態、マルチモーダル、キャッシュ、構造化出力のサポート範囲を、能力レジストリで項目ごとに確認する必要があります。Responses API、cache_control、暗号化署名などのネイティブ機能に依存するチェーンでは、対応するエンドポイントが実際に利用可能であることを確認したうえでリリースするか、専用のネイティブアダプターを用意しておく必要があります。
マルチモデル API 互換性クイックスタート
最小構成の例:同じプロンプトで3つのモデルを比較
以下のコードは、1つの OpenAI SDK クライアントで3つのモデルを順番に呼び出す例です。セクション4.1の第1項のテストに相当します。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一エンドポイント
)

# モデルIDはプラットフォームのモデル一覧に準拠します
MODELS = ["你的GPT模型ID", "你的Claude模型ID", "你的Gemini模型ID"]

for model in MODELS:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是幂等"}],
    )
    print(model, "→", resp.choices[0].message.content)
    print("usage:", resp.usage)
完全な実装を見る:統一ストリーミングイベント + 機能レジストリ + ツール検証
import json
import openai
from openai import OpenAI
from jsonschema import validate, ValidationError

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 統一インターフェース
)

# 機能レジストリ:値はあくまで構造の例です。公式ドキュメントと実測結果に基づいて更新してください
CAPABILITIES = {
    "gpt":    {"model": "你的GPT模型ID",    "tools_via": "responses"},  # ツール呼び出しは Responses アダプター経由で行う
    "claude": {"model": "你的Claude模型ID", "tools_via": "chat"},
    "gemini": {"model": "你的Gemini模型ID", "tools_via": "chat"},
}

def classify_error(e: Exception) -> str:
    """エラーを統一的に分類し、再試行が可能かどうかを判断する"""
    if isinstance(e, openai.AuthenticationError):
        return "auth_failed"
    if isinstance(e, openai.NotFoundError):
        return "model_not_supported"
    if isinstance(e, openai.RateLimitError):
        return "rate_limited"          # バックオフ付きの再試行が可能
    if isinstance(e, openai.BadRequestError):
        return "invalid_request"       # パラメータエラーまたはコンテキスト超過。無条件に再試行すべきではない
    if isinstance(e, openai.APIConnectionError):
        return "network_error"
    if isinstance(e, openai.InternalServerError):
        return "server_error"
    return "unknown"

def stream_chat(provider: str, messages: list, tools: list | None = None):
    """OpenAI 互換形式のストリームを内部の統一イベントに変換する"""
    cap = CAPABILITIES[provider]
    if tools and cap["tools_via"] != "chat":
        raise NotImplementedError(f"{provider} 的工具调用请交给原生适配器处理")

    kwargs = {
        "model": cap["model"],
        "messages": messages,
        "stream": True,
        "stream_options": {"include_usage": True},
    }
    if tools:
        kwargs["tools"] = tools

    calls: dict[int, dict] = {}   # index ごとに、並列ツール呼び出しの引数フラグメントを結合する
    finished = False
    try:
        for chunk in client.chat.completions.create(**kwargs):
            if not chunk.choices:
                if chunk.usage:
                    yield {"type": "usage", "data": chunk.usage.model_dump()}
                continue
            choice = chunk.choices[0]
            delta = choice.delta
            if delta.content:
                yield {"type": "text_delta", "data": delta.content}
            for tc in delta.tool_calls or []:
                slot = calls.setdefault(tc.index, {"id": None, "name": "", "args": ""})
                if tc.id:
                    slot["id"] = tc.id
                if tc.function and tc.function.name:
                    slot["name"] = tc.function.name
                    yield {"type": "tool_call_start", "data": {"id": slot["id"], "name": slot["name"]}}
                if tc.function and tc.function.arguments:
                    slot["args"] += tc.function.arguments
                    yield {"type": "tool_call_args", "data": {"index": tc.index}}
            if choice.finish_reason:
                finished = True
                yield {"type": "completed", "data": {
                    "finish_reason": choice.finish_reason,
                    "tool_calls": list(calls.values()),
                }}
    except Exception as e:
        yield {"type": "error", "data": classify_error(e)}
        return
    if not finished:
        yield {"type": "error", "data": "stream_interrupted"}  # 途中でストリームが切断された

EXECUTED_KEYS: set[str] = set()   # 本番環境では永続ストレージに置き換えてください

def run_tool(call: dict, schema: dict, func, idempotency_key: str | None = None):
    """まず引数を検証し、その後で冪等に実行する"""
    try:
        args = json.loads(call["args"])   # フラグメントがすべて揃った後で初めて解析する
        validate(instance=args, schema=schema)
    except (json.JSONDecodeError, ValidationError) as e:
        return {"error": f"invalid_arguments: {e}"}
    if idempotency_key:
        if idempotency_key in EXECUTED_KEYS:
            return {"skipped": "already_executed"}
        EXECUTED_KEYS.add(idempotency_key)
    return func(**args)

# 使用例
for event in stream_chat("claude", [{"role": "user", "content": "介绍一下流式输出"}]):
    print(event)
🚀 クイックスタート:APIYI apiyi.com で登録すれば無料のテスト枠が取得できます。上記のコードを使い、同じキーのままでセクション 4.1 の最初の 2 項目のテストを完了しましょう。ツール呼び出しやマルチターン推論に関するテストは、機能レジストリと組み合わせてモデルごとに検証してください。
よくある質問(FAQ)
Q1:マルチモデルAPIの互換性問題とは主に何を指しますか?
同じアプリケーションでGPT、Claude、Geminiを切り替える際に、各社のネイティブAPI構造の違いによって対応が必要になる差異を指します。主に6種類あります。メッセージロール、ツール呼び出し、推論状態、ストリーミングイベント、構造化出力とマルチモーダル、キャッシュ課金とエラー処理です。
Q2:OpenAI互換インターフェースでClaudeとGeminiを呼び出す場合、アダプター層は必要ですか?
通常のチャットであれば、互換インターフェースをそのまま利用できます。厳密なツールパラメータ、Prompt Caching、ファイル入力、暗号化された思考状態が関わる場合は、アダプター層が必要です。Claudeの公式互換レイヤーを例にすると、`strict`を無視し、キャッシュや音声/ファイル入力にも対応していません。これらの差異は機能レジストリに記載しておくべきです。
Q3:Geminiの新規プロジェクトではInteractions APIとgenerateContentのどちらを使うべきですか?
Interactions APIは2026年6月にGAとなり、Googleは新規プロジェクトでの優先的な採用を推奨しています。サーバー側のセッション状態、`previous_interaction_id`、steps構造に対応しています。`generateContent`も引き続きサポートされており、既存プロジェクトは計画に沿って移行できます。
Q4:会話の途中でモデルを切り替える場合、履歴はどのように扱えばよいですか?
ユーザーメッセージ、最終回答、ツールリクエスト、ツール結果は標準履歴として保存し、切り替え後はターゲット側のアダプターが再構成します。署名やreasoning項目などのベンダー固有の状態は別途保存し、同じベンダーへのリクエスト時のみそのまま返送します。また、切り替え後は元のベンダーのキャッシュを通常再利用できないため、初回ターンの入力コスト全体を見込んでおく必要があります。
Q5:3つのモデルが自分の業務でどの程度互換性があるかを素早く検証するには?
次の手順で進めることをおすすめします。
1. APIYI apiyi.com にアクセスしてアカウントを登録し、APIキーと無料テストクレジットを取得します。
2. 本記事のコードを使用し、base_urlをAPIYIのエンドポイントURLに設定して、3つのモデルIDを入力します。
3. 第4.1節の6項目テストを順に実行し、成功率、異常の種類、コスト、総所要時間を記録します。
Q6:モデルの自動フォールバックを設定する際に注意すべきことは?
まず、タスクに副作用があるかどうかを判断します。決済、メール送信、ファイル変更などのツールには冪等キーを必ず付与し、フォールバック時は未完了のステップから再開して、タスク全体の再実行を避けます。レート制限とサーバー側エラーはバックオフ付きリトライが適していますが、パラメータエラーやコンテキスト超過はリクエストを修正してから送信する必要があります。
Q7:マルチモデルルーティングでコストを抑えるには?
項目別トークンで費用を記録し、タスク全体の総コストで比較します。3社の単価差は大きく、たとえばGPT-6 Astraの出力価格は100万トークンあたり$50、Gemini 3.8 Flashの現在のキャンペーン価格は$3.75です。APIYI apiyi.comで各モデルの使用量を一元確認すれば、高コストな経路をより早く発見でき、それに基づいてルーティングルールを調整できます。
Q8:統一APIゲートウェイにはどのような限界がありますか?
ゲートウェイが統一できるのは、呼び出し入口、APIキー、課金です。ベンダーネイティブの高度な機能(Responses API専用のツール呼び出し、`cache_control`、暗号化署名の返送など)が利用できるかどうかは、特定のエンドポイントのサポート状況に依存するため、項目ごとに実測が必要です。これらの機能に依存する経路では、ネイティブアダプターを補完として残すべきです。
マルチモデル API 互換の核心ポイント Key Takeaways
- モデルを変える ≠ IDを変える:通常のQ&Aはそのまま移行できますが、Agent のチェーンでは6種類の差異に対処する必要があります。
- 互換レイヤーには境界がある:Claude 互換レイヤーは
strictを無視し、キャッシュやファイル入力には対応していません。 - 署名はそのまま保存する:thinking / thought 署名の消失は、マルチターンのツールチェーンでエラーが出るよくある原因です。
- ストリーミングイベントを統一する:バックエンドは8種類の内部イベントを出力し、フロントエンドは1つのプロトコルだけに対応させます。
- ケイパビリティレジストリでルーティングする:「モデル + エンドポイント」を単位として、実際にサポートしている機能を記録します。
- フォールバックは冪等に:副作用のあるツールには冪等キーを付け、重複実行を防ぎます。
- テストしてからリリース:APIYI apiyi.com の無料枠を使って、6項目の互換性テストを通します。
まとめ
1つのアプリケーションで GPT、Claude、Gemini を同時に接続する鍵は、差異を少数のコンポーネントに集約して管理することにあります。
- メッセージとツール形式の統一:標準の履歴とベンダー固有の状態をレイヤー分けして保存し、モデルを切り替えてもコンテキストが失われないようにします。
- Provider Adapter:入力変換、出力変換、状態処理を担当し、ネイティブの高度な機能はここで実装します。
- ケイパビリティレジストリ:各モデル、各エンドポイントについて、ツール、推論、マルチモーダル、Schema、キャッシュのサポート状況を正確に記録し、ルーティングと UI の選択肢を決めます。
この土台の上で、6項目の互換性テストと項目ごとのコスト観測によってリリース品質を守ります。通常の呼び出しやモデル比較の段階では、APIYI apiyi.com で1つのキーを使ってマルチモデルの検証を素早く完了し、そのテスト結果をもとに、どのチェーンにネイティブな適応が必要かを判断するのがおすすめです。
📚 参考資料
- OpenAI Function Calling:ツール呼び出し、
call_id、function_call_output - リンク:
developers.openai.com/api/docs/guides/function-calling -
説明:Responses API のツール呼び出しプロトコルに関する公式解説
-
OpenAI 最新モデル移行ガイド:GPT-6 シリーズの推論パラメータとAPI要件
- リンク:
developers.openai.com/api/docs/guides/latest-model -
説明:
reasoning.effortの値の制限と Responses API の要件 -
OpenAI Prompt Caching:キャッシュブレークポイントと TTL
- リンク:
developers.openai.com/api/docs/guides/prompt-caching -
説明:暗黙的キャッシュと明示的キャッシュの仕組み
-
Claude の OpenAI SDK 互換:互換レイヤーのサポート範囲と制限
- リンク:
platform.claude.com/docs/en/cli-sdks-libraries/libraries/openai-sdk -
説明:
strict、キャッシュ、ファイル入力、system 統合などの差異 -
Claude Extended Thinking:Adaptive Thinking と思考シグネチャ
- リンク:
platform.claude.com/docs/en/build-with-claude/extended-thinking -
説明:マルチターンのツール呼び出しにおける thinking ブロックの返送ルール
-
Claude の構造化出力とキャッシュ:JSON outputs、Strict tool use、
cache_control - リンク:
platform.claude.com/docs/en/build-with-claude/structured-outputs - リンク:
platform.claude.com/docs/en/build-with-claude/prompt-caching -
説明:構造化制約とキャッシュモード
-
Gemini Interactions API と OpenAI 互換:新インターフェースと互換エンドポイント
- リンク:
ai.google.dev/gemini-api/docs/interactions-overview - リンク:
ai.google.dev/gemini-api/docs/openai -
説明:steps 構造、セッション状態、互換パラメータのマッピング
-
Gemini の思考シグネチャ、ツール呼び出し、キャッシュ
- リンク:
ai.google.dev/gemini-api/docs/thought-signatures - リンク:
ai.google.dev/gemini-api/docs/function-calling - リンク:
ai.google.dev/gemini-api/docs/caching -
説明:ステートレスモードでのシグネチャ保持、ツールプロトコル、明示的キャッシュ
-
3社の公式料金ページ
- リンク:
developers.openai.com/api/docs/pricing - リンク:
platform.claude.com/docs/en/models/sonnet-5-5/overview - リンク:
ai.google.dev/gemini-api/docs/pricing - 説明:本文の料金表のデータソース(確認日:2026-11-13)
著者:APIYI 技術チーム
技術交流:APIYI のウェブサイトトップページからお問い合わせください。詳細資料は docs.apiyi.com のドキュメントセンターをご覧ください


