
Anmerkung des Autors: Wie lange eine Codex-Aufgabe dauert, hängt von Modell, Reasoning-Intensität, Servicepfad, Tool-Schleife, Cache und Netzwerk ab. Mit einem Vergleich derselben Aufgabe und segmentierter Zeitmessung lassen sich Engpässe genau lokalisieren.
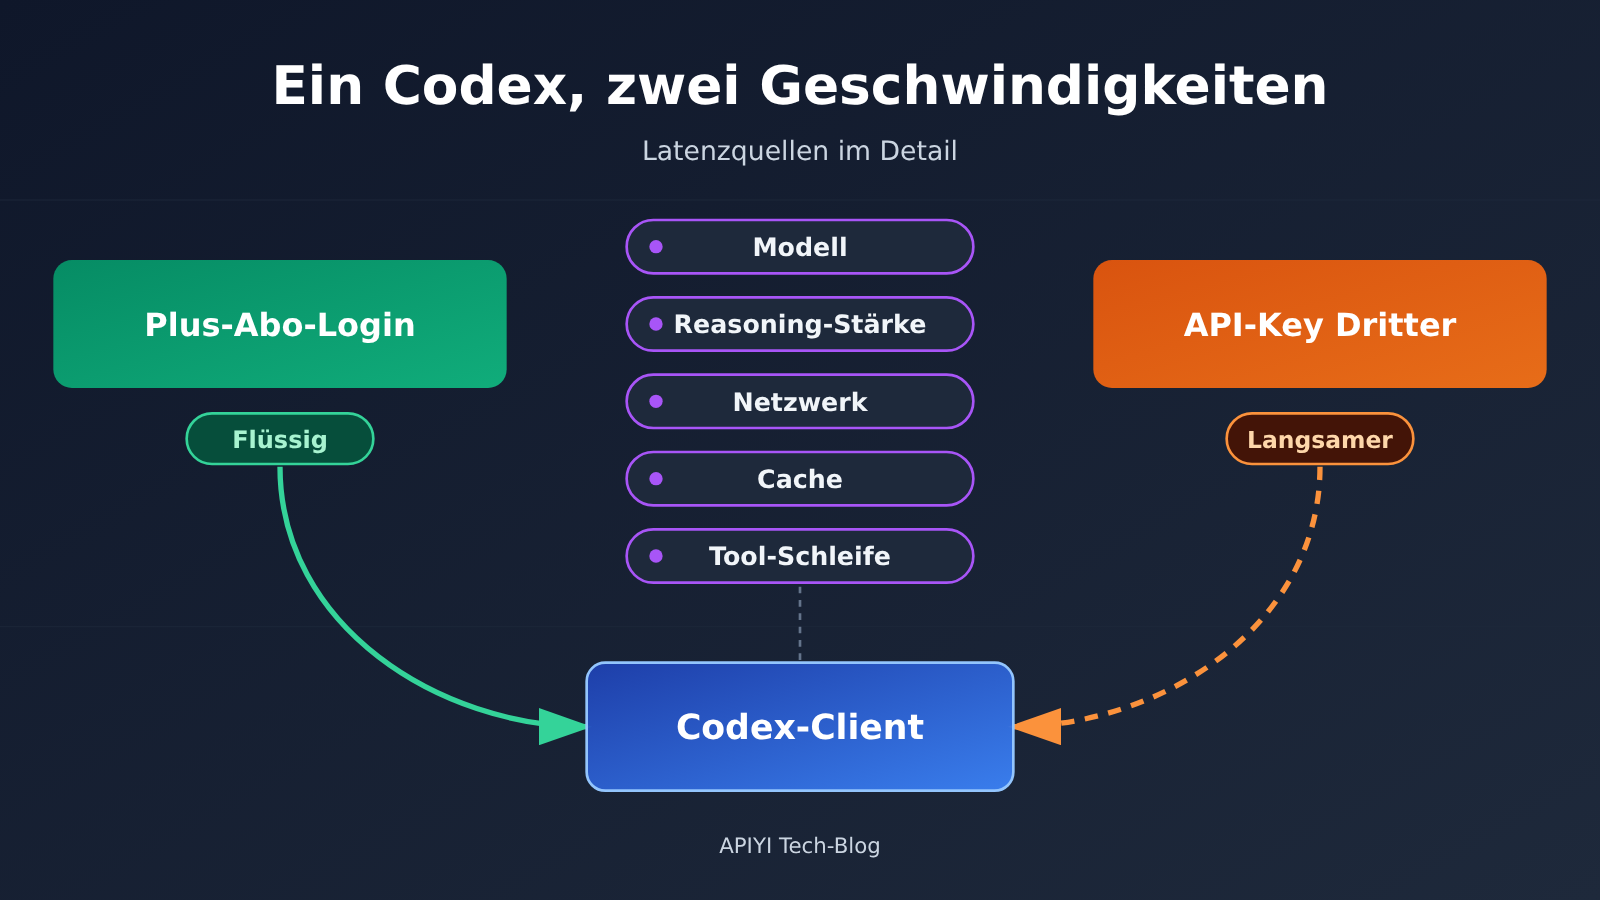
Derselbe Codex, der bei Anmeldung über ChatGPT Plus flüssig läuft, wird langsamer, sobald man auf einen Drittanbieter-API-Schlüssel umstellt. Die Ursache liegt in der Regel darin, dass beide unterschiedliche Servicepfade nutzen und die Agent-Schleife von Codex die zusätzliche Latenz jeder einzelnen Anfrage vervielfacht. Die Oberfläche des Clients ist identisch, doch Modell-Deployment, Reasoning-Stufe, Transportprotokoll, Cache-Trefferquote und die Kompatibilität der Tool-Events können sich unterscheiden. Wartet man pro Anfrage nur 3 Sekunden länger, so kann eine Programmieraufgabe mit 20 seriellen Aufrufen rund 1 Minute mehr kosten.
Im Folgenden wird zunächst die Arbeitsweise von Codex und die beiden Zugangswege zerlegt, anschließend werden die Latenzquellen einer Drittanbieter-API Punkt für Punkt erläutert und mit zwei öffentlichen GitHub-Issues als Einzelfallbelegen untermauert. Danach folgen vier zentrale Kennzahlen, drei Vergleichstests und ein nach Symptomen gegliederter Optimierungsplan, mit dem Sie beurteilen können, ob Ihr Codex im Modell, im Netzwerk, im Cache oder in der Tool-Schleife langsam ist. Zum Schluss wird diskutiert, welche Kennzahlen bei der Wahl einer Drittanbieter-API den tatsächlichen Kostenaufwand besser widerspiegeln als der Stückpreis.
To Know: Die Begriffe verstehen, die die Geschwindigkeitsunterschiede von Codex erklären
| Begriff | Erklärung |
|---|---|
| Codex Harness | Das Ausführungsframework von Codex, das für die Organisation von Modell, Tools, Kontext und der mehrstufigen Aufgabenrunde zuständig ist. |
| Responses API | Die von OpenAI bereitgestellte Schnittstelle, die Modellausgaben, Tool-Aufrufe und mehrstufige Statusverwaltung unterstützt; Codex hängt von ihr ab. |
| TTFT | Time To First Token, die Wartezeit vom Absenden der Anfrage bis zum Erhalt des ersten Ausgabe-Tokens. |
| TPS | Tokens Per Second, die Anzahl der pro Sekunde generierten Token, spiegelt die kontinuierliche Ausgabegeschwindigkeit wider. |
| Ende-zu-Ende-Zeit | Die Gesamtzeit vom Übermitteln der Aufgabe bis zum endgültigen Abschluss der Aufgabe, einschließlich aller Modellaufrufe und Tool-Ausführungen. |
| Inferenzintensität | Die Tiefenstufe des Modelldenkens, z. B. low, medium, high; je höher die Stufe, desto mehr Ausgabe und desto längere Dauer. |
| Tool-Aufruf (Tool Calling) | Der Prozess, bei dem das Modell ein externes Programm anfordert, Dateien zu lesen, Befehle auszuführen usw., und mit dem Ergebnis weiterdenkt. |
| Prompt-Caching | Wenn das Eingabepräfix wiederholt und die Bedingungen erfüllt sind, werden bereits berechnete Ergebnisse wiederverwendet, um die Verarbeitungszeit zu reduzieren. |
| SSE | Server-Sent Events, der Server sendet kontinuierlich Ereignisse über eine unidirektionale HTTP-Verbindung. |
| WebSocket | Eine dauerhafte bidirektionale Verbindung, bei der mehrere Anfragen dieselbe Verbindung wiederverwenden können. |
| previous_response_id | Der Parameter im Responses API, der auf die vorherige Antwort verweist; zusammen mit inkrementeller Eingabe kann die wiederholte Übertragung reduziert werden. |
| Dienststufe | Verschiedene Verarbeitungsoptionen desselben Modells, wie Standard, Fast, mit unterschiedlicher Geschwindigkeit und unterschiedlichem Preis. |
1 Warum hat dasselbe Codex zwei Geschwindigkeiten?
1.1 Codex-Abo-Login und API-Schlüssel laufen über unterschiedliche Servicepfade
Laut der Authentifizierungsdokumentation von OpenAI unterstützen Codex CLI, IDE-Erweiterungen und Desktop-App zwei Anmeldeverfahren: die Anmeldung mit einem ChatGPT-Konto oder das Eintragen eines API-Schlüssels. Bei der ChatGPT-Anmeldung werden die im Abo enthaltenen Codex-Nutzungsrechte und das entsprechende Limit verbraucht; ein API-Schlüssel unterliegt dagegen der Messung und den Ratenbegrenzungsregeln des API-Kontos. Das Plus-Abo enthält übrigens nicht das Recht, beliebige OpenAI-APIs kostenlos aufzurufen.
Wenn du einen API-Schlüssel eines Drittanbieters verwendest, ist der Codex-Client nur für die Organisation der Aufgabe zuständig – die eigentliche Inferenz läuft auf dem Dienst, der hinter dieser Schnittstelle steht. Welches Modell tatsächlich aufgerufen wird, wie abgerechnet wird, welches Streaming-Protokoll gilt und wie die Servicequalität ausfällt, entscheiden die Drittanbieter-Schnittstelle und ihre Backend-Implementierung. Wenn im Client also derselbe Modellname erscheint, heißt das nur, dass du denselben Namen gewählt hast. Es lässt sich daraus nicht ableiten, dass zwei Anfragen über dieselbe Modellbereitstellung, dieselbe Service-Warteschlange und denselben Übertragungsweg liefen.
1.2 Die Agent-Schleife von Codex sorgt dafür, dass das Modell wiederholt angefragt wird
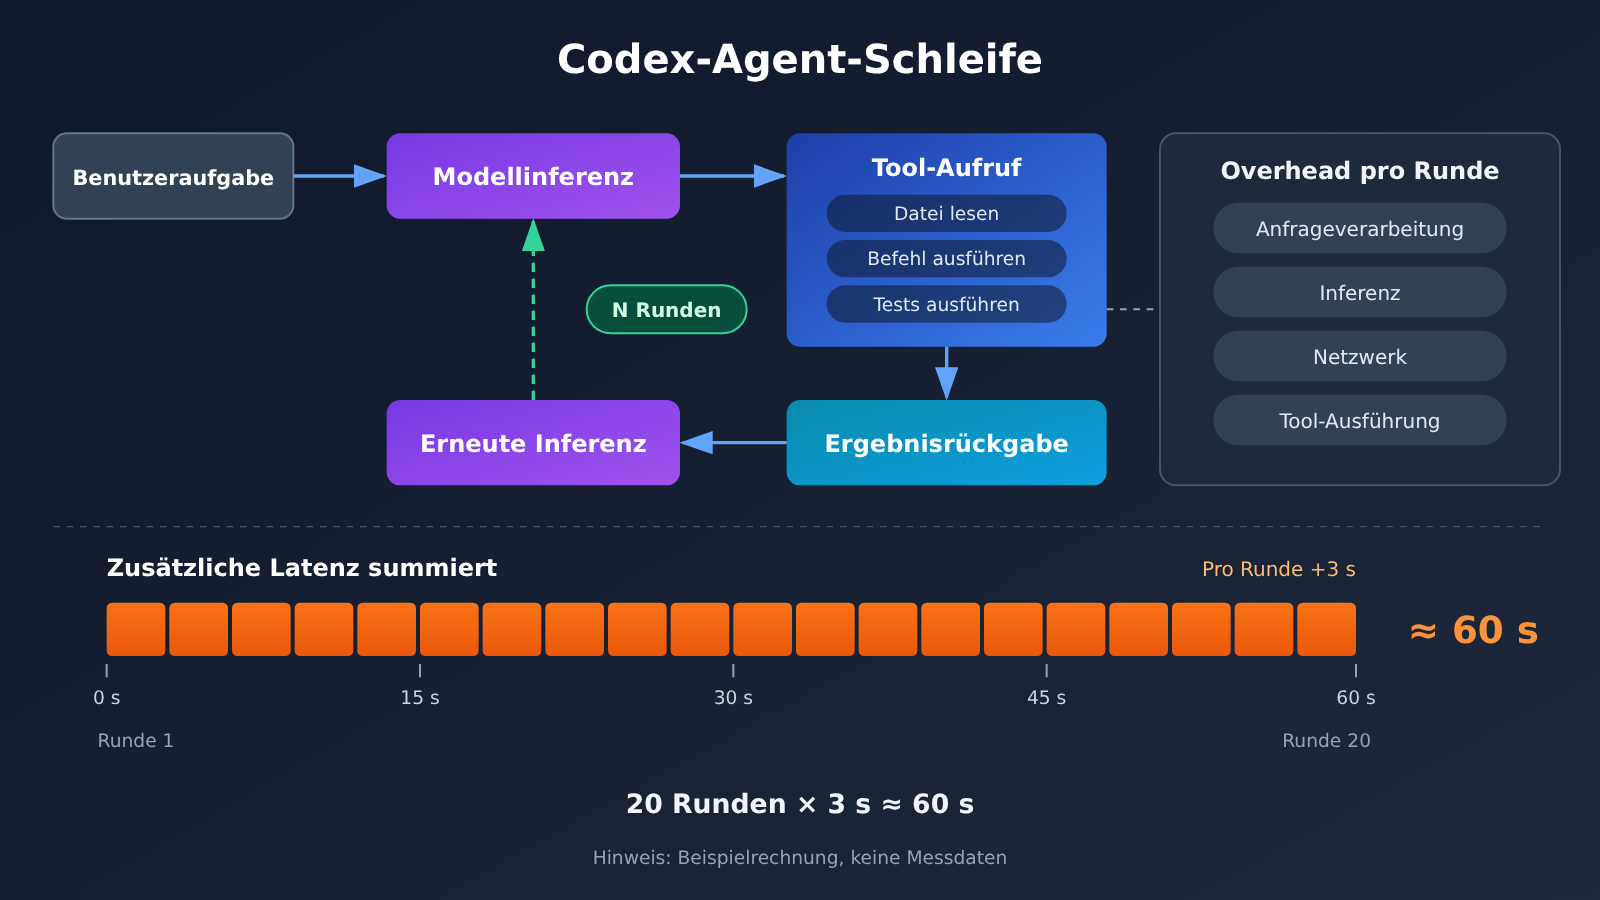
In dem am 19. August 2026 veröffentlichten Beitrag „Codex as a platform“ erklärt OpenAI, dass der Open-Source-Agent-Harness von Codex dafür zuständig ist, Aufgaben zu verstehen, den Kontext zu pflegen, die Codebasis zu durchsuchen, die Shell aufzurufen, Dateien zu bearbeiten, Tests auszuführen und außerdem Fehlerwiederherstellung, Benutzergenehmigungen und Ausführungsgrenzen zu behandeln. Im Kern ist er ein Schleifensystem aus „Modellinferenz → Tool-Ausführung → erneute Inferenz“.
In einem Engineering-Artikel vom 22. April 2026 beschreibt OpenAI einen typischen Ablauf: Der Nutzer stellt eine Änderungsaufgabe, das Modell entscheidet, was zu tun ist, Codex liest Dateien oder führt Befehle aus, nachdem die Tools Ergebnisse zurückmelden, analysiert das Modell die Lage erneut und ruft anschließend weitere Tools auf, ändert Code, führt Tests aus und prüft die Ergebnisse. Komplexe Aufgaben können Dutzende Runden zwischen Modell und Tools umfassen – und jede dieser Runden ist eine vollständige API-Anfrage.
2 Woher kommen die Geschwindigkeitsunterschiede bei der Anbindung von Codex an Drittanbieter-APIs?
Zunächst fasst eine Tabelle fünf Kategorien von Latenzquellen zusammen; anschließend werden sie einzeln erläutert.
| Latenzquelle | Hauptsächlich betroffene Kennzahl | Typisches Symptom | Prüfpriorität |
|---|---|---|---|
| Modell und Reasoning-Aufwand | TPS, Inferenzzeit pro Runde | Ausgabe dauerhaft langsam, lange Denkzeit | Hoch |
| Service-Tier und Routing | TTFT, Schwankungsbreite | Erste Antwort langsam oder unbeständig | Hoch |
| Gateway und Netzwerkpfad | Feste zusätzliche Zeit pro Runde | Bei jedem Aufruf kommen konstant einige Sekunden hinzu | Mittel |
| Transportprotokoll (SSE / WebSocket) | Kumulativer Aufwand über mehrere Runden, Verbindungsstabilität | Lange Aufgaben langsam, Verbindungsabbrüche mittendrin | Mittel |
| Caching und Tool-Schleifen | Eingabeverarbeitungszeit, Anzahl der Aufrufrunden | Lange Dialoge deutlich langsamer, zu viele Runden | Hoch |
2.1 Einfluss von Modell-Inferenzgeschwindigkeit und Reasoning-Aufwand auf die Codex-Laufzeit
Bevor man zwei Anbindungsvarianten vergleicht, muss man zunächst prüfen, ob die tatsächliche Modell-ID, der Reasoning-Aufwand, die Modellversion und das Service-Tier übereinstimmen. Der Reasoning-Aufwand reicht von low bis xhigh und max; je höher die Stufe, desto mehr Reasoning-Inhalt erzeugt das Modell und desto länger dauert eine einzelne Runde.
Der Leitfaden zur Latenzoptimierung von OpenAI nennt die Anzahl der Output-Tokens als Schlüsselvariable für die Inferenzdauer: In einigen Szenarien kann eine Verringerung der Output-Tokens um etwa 50 % auch die Generierungslatenz um nahezu 50 % senken; eine Reduzierung des normalen Eingabetexts hat dagegen meist einen viel geringeren Effekt. Auch das Service-Tier ist wichtig: Der Fast-Modus von OpenAI kann bei geeigneten Modellen und Workloads bis zu 2,5-mal so schnell sein, ist aber eine kostenpflichtige Tier-Option und gilt nur für einige Modelle.
Das bedeutet: Selbst wenn auf der Abo-Seite und auf der Drittanbieterseite dasselbe Modell angezeigt wird, sind die Geschwindigkeitsunterschiede deutlich, sobald sich Reasoning-Stufe oder Service-Tier unterscheiden.
2.2 Auswirkungen von API-Proxy-Diensten, Netzwerkpfaden und WebSocket auf mehrstufige Aufgaben
Bei Schnittstellen von Drittanbietern ist die Anforderungskette in der Regel länger: Client → Gateway des Anbieters → Proxy-Knoten → möglicherweise eine grenzüberschreitende Verbindung → endgültiger Inferenzdienst. Mit jedem zusätzlichen Sprung kommen potenziell etwas feste Latenz und Netzwerkschwankungen hinzu – und diese Latenz summiert sich im Agent-Loop mit jeder Runde.
Ein weiterer Faktor ist das Übertragungsprotokoll. Die klassische Responses API überträgt in der Regel über HTTP/SSE, wobei jede Runde eine neue Anfrage erfordert und der Kontext mitgeführt werden muss. Der WebSocket-Modus hält eine persistente Verbindung aufrecht und reduziert durch previous_response_id und inkrementelle Eingaben wiederholte Übertragungen und Verarbeitung. Die von OpenAI offiziell veröffentlichten Zahlen:
- Eine API-Optimierungsrunde Ende 2025 verbesserte die Latenz bis zum ersten Token um nahezu 45 %.
- In bestimmten Workflows mit mehr als 20 Tool-Aufrufen bringt der WebSocket-Modus eine End-to-End-Beschleunigung von bis zu etwa 40 %.
- Berichte zu entsprechenden Vercel-Integrationen nennen eine Latenzverbesserung von bis zu etwa 40 %, Cline meldet für Multi-Datei-Workflows etwa 39 % Beschleunigung, und für OpenAI-Modelle in Cursor werden Verbesserungen von bis zu etwa 30 % berichtet.
Diese Daten stammen aus unterschiedlichen Produkten und Testszenarien und sind Obergrenzen für bestimmte Workflows. Manche kompatiblen Gateways implementieren nur HTTP/SSE oder unterstützen die von Codex genutzte WebSocket- und inkrementelle Zustandsverwaltung nicht vollständig – bei solchen Anbindungen fallen diese Vorteile weg.
2.3 Kontext-Caching und Anzahl der Tool-Aufrufe bei Codex
Bei langen Aufgaben belegen Verlaufsnachrichten, Tool-Definitionen und wiederholter Kontext eine große Menge an Eingabe-Tokens. Wenn der Cache der Eingabeaufforderung greift, lässt sich die Verarbeitungszeit für diesen Präfix reduzieren. Laut der OpenAI-Dokumentation unterstützen GPT-5.6 und die nachfolgenden Serien neue Mechanismen zum Schreiben und Lesen des Caches sowie zur TTL-Steuerung.
Das Problem dabei: Caching hängt von der Stabilität des Anfrage-Präfixes ab. Wenn die Proxy-Schicht das Präfix der Anfrage umschreibt, die Reihenfolge der Tool-Definitionen ändert oder die Cache-Grenzen verschiebt, kann die Wiederverwendung des Caches beeinträchtigt werden – dann wird in jeder Runde ein großer Kontextblock neu verarbeitet. Die Anzahl der Tool-Aufrufe bestimmt wiederum direkt die Anzahl der Anfrage-Runden: Je mehr Runden, desto stärker vervielfachen sich alle Aufwände einer einzelnen Runde.
2.4 Warum reagiert Codex beim ersten Mal normal und ist danach trotzdem langsam?
Das ist die häufigste Ausprägung dieser Fragestellung. TTFT misst nur, wie schnell das erste Token ankommt – die Gesamtlaufzeit einer Codex-Aufgabe ist jedoch die Summe aller Runden. Die Gesamtzeit lässt sich so schreiben:
T_total = Σ (Verarbeitungszeit der API-Anfrage + Modellinferenzzeit + Netzwerkübertragungszeit + lokale Tool-Ausführungszeit + Warte- und Wiederholungszeit)
Ein normaler erster Response bei insgesamt langsamer Ausführung entsteht typischerweise in folgenden Situationen: Die kontinuierliche Ausgabegeschwindigkeit (TPS) ist niedrig, sodass lange Antworten jede Runde verlangsamen; nach Abschluss der Tool-Ausführung denkt das Modell erneut nach, und jede erneute Inferenz muss den Kontext noch einmal verarbeiten; die Streaming-Verbindung bricht mittendrin ab oder läuft in ein Timeout, der Client löst einen Retry aus, und für den Nutzer sieht es aus, als hätte „das Modell angehalten“. Rechnet man das anhand des Mechanismus durch: Bei einer Aufgabe, die 20 serielle Modellaufrufe erfordert, verlängert sich die Gesamtlaufzeit um rund 60 Sekunden, wenn pro Aufruf 3 Sekunden zusätzlich anfallen. Diese Zahl dient dazu, den Kumulationseffekt zu veranschaulichen, und ist kein Messergebnis.
3 Welche Belege liefern die öffentlichen Fälle für das Langsamkeitsproblem von Codex?
Die beiden folgenden Fälle stammen aus Nutzerberichten im openai/codex-Repository. Es handelt sich um Einzelfallprotokolle einzelner Nutzer, die den Mechanismus veranschaulichen sollen und keine branchenübliche Größenordnung repräsentieren.
3.1 Issue #60831: Etwa siebenfache Schwankung der Antwortzeit innerhalb derselben Sitzung
In dem im November 2026 eingereichten Issue #60831 beobachtete der Berichtende in derselben Sitzung, demselben Client-Prozess und mit identischen Inferenzeinstellungen zwei Anfragen: Die komprimierten Anfragekörper waren jeweils etwa 13,09 MB groß, dazwischen fand keine Kontextkomprimierung statt, und auch der Bildverlauf blieb unverändert. Die langsame Anfrage brauchte vom Abschluss der Anfragekomprimierung bis zum Empfang des HTTP-Antwort-Headers 109,317 Sekunden, die schnelle 15,637 Sekunden – ein Verhältnis von etwa 6,99.
Zu beachten ist dabei, worauf sich die Messung bezieht: Diese beiden Zahlen erfassen die Zeit „bis zum Empfang des Antwort-Headers“, also die Phase der Service-Verarbeitung, nicht die Gesamtdauer der Aufgabe; beide Anfragen stammten zudem aus demselben Pfad und hängen nicht mit einem Vergleich zwischen Abonnement und Drittanbieter zusammen. Es zeigt, dass die serverseitige Verarbeitungszeit selbst bei gleichbleibender Kontextgröße stark schwanken kann. Der Bericht selbst kann nicht feststellen, welcher Service-Schritt konkret den Engpass verursacht hat.
3.2 Issue #44305: Eine Tool-Schleife lässt die Laufzeit einer reinen Leseaufgabe in die Höhe schnellen
In dem im September 2026 eingereichten Issue #44305 verglich der Berichtende gleichartige reine Leseaufgaben: Ein anderer Agent erledigte sie mit 3 parallelen Lesevorgängen in etwa 10,6 Sekunden; Codex lief 91,5 Sekunden und ging dann in einen Timeout, ohne eine vollständige Antwort zu liefern. Währenddessen führte Codex etwa 11 Modellinferenzen und 11 Tool-Aufrufe aus, mit einer kumulierten Eingabe von etwa 295.042 Tokens, davon etwa 260.608 Tokens gecachte Eingabe.
Rechnet man mit diesen Zahlen, liegt der Anteil der gecachten Eingabe bei etwa 88,3 %, die Cache-Trefferquote ist also gut – doch die seriellen 11 Runden lassen die Laufzeit trotzdem weit über die parallele Leselösung steigen. Die Arbeitsstrategien der beiden Agenten unterscheiden sich grundsätzlich, die Zeitdifferenz lässt sich daher nicht vollständig auf Codex oder das Modell zurückführen, aber sie zeigt deutlich, wie Aufrufrunden und serielle Ausführung die Gesamtlaufzeit vervielfachen.
Darüber hinaus gibt es zwei weitere Problemtypen, die direkt mit der Drittanbieter-Anbindung zusammenhängen: Issue #33029 berichtet, dass bei Codex Desktop mit einer kompatiblen Drittanbieter-Schnittstelle der Modell-Endpunkt normal funktioniert, der Desktop-Client aber dennoch einige ChatGPT-Hilfsdienste anfragt, deren Timeouts die Reaktionszeit der App verlangsamen; Issue #41340 und #42471 berichten jeweils von „stream disconnected before completion“ bei Drittanbieter-Responses-Endpunkten sowie davon, dass Tool-Aufrufereignisse zwar empfangen, aber nicht in den Ausführungsablauf übernommen wurden. Dass einfacher Chat läuft und dass eine vollständige Codex-Tool-Schleife läuft, sind zwei verschiedene Stufen von Kompatibilitätsanforderungen.
4 Wie finden Sie heraus, wo Ihr Codex langsam ist?
4.1 Mit vier Kernmetriken den Codex-Engpass lokalisieren
| Metrik | Erfassungsmethode | Welches Problem sie widerspiegelt |
|---|---|---|
| TTFT | Wartezeit bis zur ersten gültigen Ausgabe pro Anfrage | Warteschlange, Modellstart, erstes Netzwerkpaket |
| End-to-End-Dauer | Gesamtzeit vom Absenden bis zum Abschluss einer Aufgabe | Gesamterlebnis, die endgültige Beurteilungsgrundlage |
| Anzahl der Modell-/Tool-Aufrufe | Zählung der Inferenzrunden, Tool-Aufrufe und Tool-Ausführungszeiten | Agent-Strategie und serielle Verstärkung |
| Cache-Treffer | Gesamteingabe, Cache-Lesen, Cache-Schreiben, Ausgabe-Token | Overhead durch wiederholte Kontextverarbeitung |
Zusätzlich zu diesen vier Metriken empfiehlt es sich, gleichzeitig TPS, die Eingabe- und Ausgabe-Token pro Anfrage, das verwendete Protokoll (WebSocket oder SSE) sowie die Anzahl von 429ern, 5xx-Fehlern, Timeouts und Wiederholungsversuchen zu erfassen. Diese ergänzenden Daten helfen Ihnen, zwischen „langsam“ und „langsam durch Wiederholungen nach Fehlern“ zu unterscheiden.
4.2 Durchführungsschritte des Codex-Vergleichstests mit drei Gruppen
Die Voraussetzung für einen Vergleichstest ist die Kontrolle der Variablen: Modell-ID, Reasoning-Aufwand, Codex-Version, Projektdateien und Aufgabenbeschreibung bleiben gleich, und der Test wird jeweils einmal in einer neuen Sitzung und einmal in einer langen Sitzung durchgeführt, um den Einfluss der Kontextlänge zu erkennen.
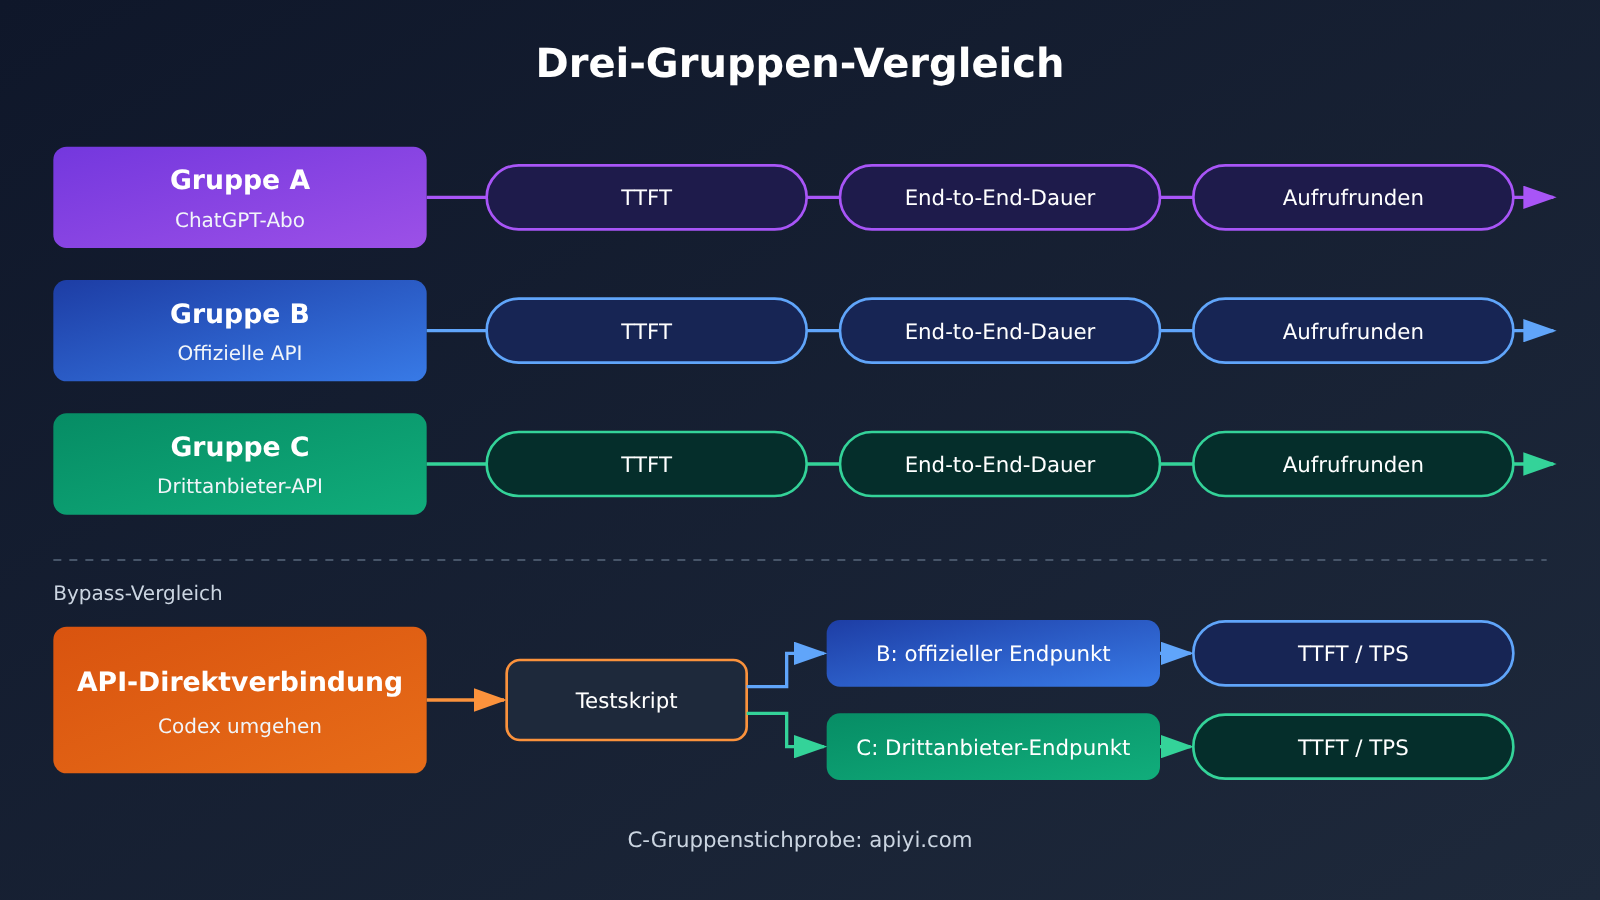
- Gruppe A: Codex mit einem ChatGPT-Abo anmelden, die Standardaufgabe ausführen, End-to-End-Dauer und Anzahl der Aufrufrunden erfassen.
- Gruppe B: Codex über den offiziellen API-Schlüssel desselben Modells anbinden und dieselbe Aufgabe ausführen.
- Gruppe C: Codex über eine kompatible Drittanbieter-API anbinden und dieselbe Aufgabe ausführen.
- Direktverbindungsgruppe: Bei den beiden Pfaden B und C Codex umgehen und mit einem Skript dieselbe einzelne Anfrage senden, um TTFT und TPS zu messen.
Der Unterschied zwischen A und B spiegelt vor allem die Serviceunterschiede zwischen Abo-Pfad und API-Pfad wider; der Unterschied zwischen B und C spiegelt die Unterschiede bei Gateway, Routing und Inferenzdienst wider; die Differenz zwischen dem Direktverbindungs-Ergebnis und dem Ergebnis innerhalb von Codex spiegelt den zusätzlichen Overhead wider, den Agent-Schleife, Protokollkompatibilität und Client verursachen. Für jede Gruppe empfiehlt es sich, mehrfach zu wiederholen und den Median zu nehmen, damit eine einmalige zufällige Schwankung nicht als Schlussfolgerung gewertet wird.
Das folgende Skript dient dem Test der „Direktverbindungsgruppe“ und misst TTFT, Gesamtdauer, Ausgabe-Token und TPS über eine gestreamte Responses-Anfrage:
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle; für die B-Gruppe einfach auf die offizielle Adresse umstellen
)

start = time.perf_counter()
ttft = None
stream = client.responses.create(
    model="YOUR_MODEL_ID",            # mit der in Codex verwendeten Modell-ID übereinstimmen
    reasoning={"effort": "medium"},   # mit dem Reasoning-Aufwand in Codex übereinstimmen
    input="阅读下面的函数并指出潜在 bug:def add(a, b): return a - b",
    stream=True,
)
usage = None
for event in stream:
    if event.type == "response.output_text.delta" and ttft is None:
        ttft = time.perf_counter() - start
    elif event.type == "response.completed":
        usage = event.response.usage

total = time.perf_counter() - start
out_tokens = usage.output_tokens if usage else 0
print(f"TTFT: {ttft:.2f}s | 总耗时: {total:.2f}s | 输出: {out_tokens} tokens")
if ttft and total > ttft:
    print(f"TPS: {out_tokens / (total - ttft):.1f} tokens/s")
Vollständiges Skript für wiederholte Mehrfachdurchläufe und Cache-Statistik anzeigen
import time
import statistics
from openai import OpenAI

ENDPOINTS = {
    "official": {"base_url": "https://api.openai.com/v1", "key": "OFFICIAL_KEY"},
    "apiyi": {"base_url": "https://api.apiyi.com/v1", "key": "APIYI_KEY"},  # APIYI-Schnittstelle
}
MODEL = "YOUR_MODEL_ID"
EFFORT = "medium"
# Ein längerer fester Präfix simuliert die Systemanweisung und die Tool-Definitionen von Codex,
# damit sich Cache-Treffer besser beobachten lassen
PREFIX = "你是代码审查助手。项目规范如下:\n" + ("- 函数必须有类型注解。\n" * 300)
TASK = "检查这个函数:def add(a, b): return a - b"


def run_once(client):
    start = time.perf_counter()
    ttft, usage = None, None
    stream = client.responses.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=PREFIX + TASK,
        stream=True,
    )
    for event in stream:
        if event.type == "response.output_text.delta" and ttft is None:
            ttft = time.perf_counter() - start
        elif event.type == "response.completed":
            usage = event.response.usage
    total = time.perf_counter() - start
    cached = 0
    if usage and getattr(usage, "input_tokens_details", None):
        cached = usage.input_tokens_details.cached_tokens or 0
    return {
        "ttft": ttft or total,
        "total": total,
        "input": usage.input_tokens if usage else 0,
        "cached": cached,
        "output": usage.output_tokens if usage else 0,
    }


def bench(name, cfg, rounds=5):
    client = OpenAI(api_key=cfg["key"], base_url=cfg["base_url"])
    results, errors = [], 0
    for _ in range(rounds):
        try:
            results.append(run_once(client))
        except Exception as e:
            errors += 1
            print(f"[{name}] 请求失败: {e}")
    if not results:
        return
    med = lambda k: statistics.median(r[k] for r in results)
    hit = sum(r["cached"] for r in results) / max(sum(r["input"] for r in results), 1)
    print(
        f"[{name}] TTFT中位数 {med('ttft'):.2f}s | 总耗时中位数 {med('total'):.2f}s | "
        f"缓存命中率 {hit:.1%} | 失败 {errors}/{rounds}"
    )


for name, cfg in ENDPOINTS.items():
    bench(name, cfg)
Wenn du die Testgruppe C innerhalb von Codex durchführst, musst du den Endpunkt des Drittanbieters als Modellanbieter konfigurieren. Hier ist die gängige Schreibweise für ~/.codex/config.toml – die genauen Feldnamen entnimm bitte der offiziellen Dokumentation der Codex-Version, die du verwendest:
model = "YOUR_MODEL_ID"
model_provider = "apiyi"
model_reasoning_effort = "medium"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
🚀 Schnellstart: Für den Kontrollvergleich in Gruppe C kannst du bei APIYI auf apiyi.com ein kostenloses Testkontingent für neue Nutzer beantragen. Mit demselben Key wechselst du dann mehrere Modelle und lässt das obige Skript jeweils durchlaufen – so bekommst du schnell vergleichbare TTFT- und Gesamtlaufzeit-Daten.
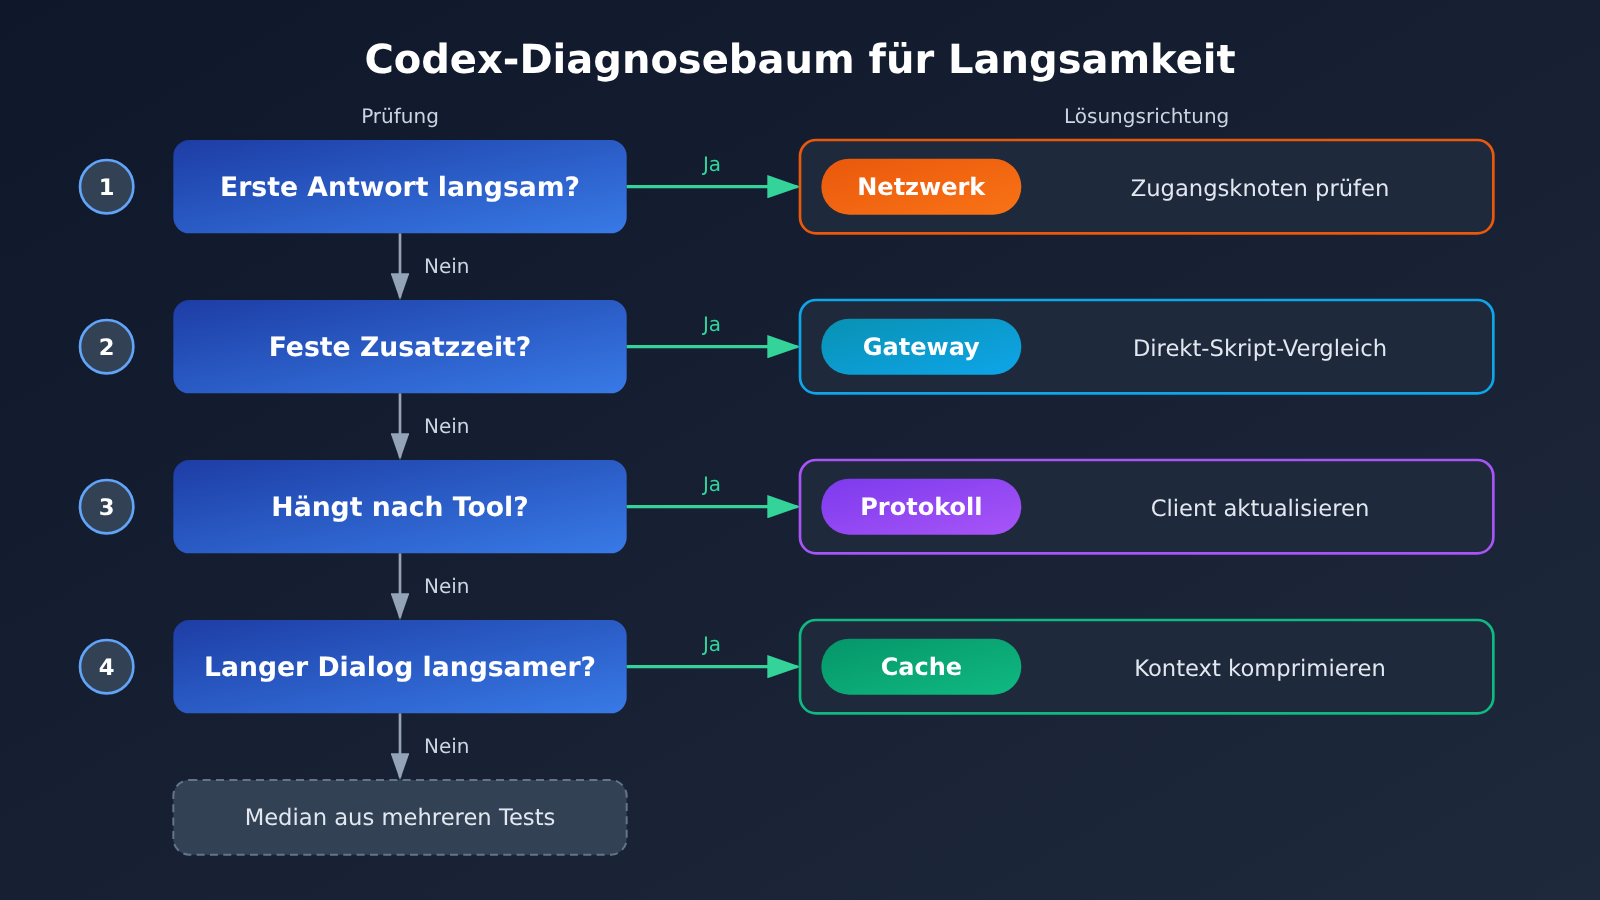
4.3 Symptombezogene Codex-Optimierungslösungen
| Symptom | Vorrangig prüfen | Vorgehen |
|---|---|---|
| Langsame erste Antwort | Warteschlange, Modellstart, erstes Netzwerkpaket | Näheren Zugangsknoten verwenden, Service-Stufe bestätigen, Vergleich außerhalb der Stoßzeiten durchführen |
| Erste Antwort schnell, danach langsam | TPS, Tool-Runden, Cache | Inferenzintensität senken, Ausgabelänge begrenzen, Cache-Trefferrate prüfen |
| Konstante Zusatzzeit bei jedem Aufruf | Proxy-Strecke, zusätzliche Anfragen | Mit einem Direktverbindungsskript Gruppe B und C vergleichen, Gateway-Overhead lokalisieren |
| Hängt nach einem Tool-Aufruf | Responses-Events, Tool-Rückgabe | Prüfen, ob Stream-Abbrüche oder verlorene Tool-Events auftreten, Client-Version aktualisieren |
| Lange Konversation deutlich langsamer als neue | Historische Tokens, Kompression, Cache | Rechtzeitig eine neue Sitzung starten oder Kontextkompression auslösen, Veränderung beim Cache-Lesen beobachten |
| Geschwindigkeit schwankt stark | Service-Last, Retries, Netzwerkschwankungen | 429/5xx und Timeouts zählen, mehrfach testen und den Median verwenden |
| Desktop-Client insgesamt ruckelt, API normal | Anfragen des ChatGPT-Hilfsdienstes | Siehe Issue #33029, prüfen, ob Hilfsanfragen in ein Timeout laufen, bei Bedarf auf CLI wechseln |
Optimierungen auf Modellebene folgen dem Ansatz des OpenAI-Latenzleitfadens: Ausgabe-Tokens reduzieren, Eingabekontext verringern, Anzahl der Aufrufe senken, unabhängige Schritte parallel verarbeiten – und alles, was ein gewöhnliches Programm erledigen kann, nicht dem Modell überlassen. Bei Codex ist der direkteste Hebel, der Aufgabenbeschreibung einen klareren Umfang zu geben, damit der Agent weniger explorative Leserunden dreht.
5 Welche Kennzahlen zählen bei der Auswahl einer Drittanbieter-API für Codex mehr als der Tokenpreis?
5.1 Von Token-Einzelpreisen zu den Kosten pro erledigter Aufgabe
Im Codex-Kontext wird der tatsächliche Preis dadurch bestimmt, ob eine Aufgabe abgeschlossen wird. Bei einer API mit niedrigem Einzelpreis können schlechte Cache-Treffer, viele Aufrufrunden und häufige Verbindungsabbrüche mit Wiederholungen am Ende mehr Token und Zeit verbrauchen. Bei der Bewertung sollten folgende Punkte gemeinsam betrachtet werden: Erfolgsquote der Aufgabe, End-to-End-Dauer, insgesamt pro Aufgabe verbrauchte Token (einschließlich Cache-Lesevorgängen) sowie zusätzliche Kosten durch Fehler und Wiederholungsversuche.
| Bewertungsdimension | Worauf achten | Testmethode | Verfügbare Plattform |
|---|---|---|---|
| Modellidentität und -version | Sind Modell-ID und Version eindeutig, stabil und verfügbar? | Modellfelder in der Antwort mit der Dokumentation abgleichen | APIYI apiyi.com, offizielle API |
| TTFT und anhaltende Geschwindigkeit | Median und Schwankungen von TTFT und TPS | Mehrere Testläufe mit direktem Skript | APIYI apiyi.com, offizielle API |
| Dauer mehrrundiger Agent-Aufgaben | Gesamtzeit realer Aufgaben in Codex | Kontrollierte Tests mit drei Gruppen | APIYI apiyi.com, offizielle API |
| Protokollkompatibilität | Unterstützung für Responses, WebSocket und Tool-Events | Eine vollständige Aufgabe ausführen: Datei lesen + Code ändern + Tests | Abhängig von der Dokumentation des Anbieters |
| Cache-Unterstützung | Werden Token aus Cache-Lesevorgängen korrekt zurückgegeben? | Cache-Felder in den Usage-Daten auswerten | Abhängig von der Dokumentation des Anbieters |
| Stabilität und Abrechnung | Fehlerrate, Parallelität, Abrechnungstransparenz | 429/5xx und Rechnungsdetails protokollieren | Abhängig von der Dokumentation des Anbieters |
5.2 APIYI und andere Drittanbieter-Schnittstellen mit realen Aufgaben bewerten
APIYI apiyi.com ist eine API-Aggregationsplattform für große KI-Modelle: Mit einem API-Schlüssel lassen sich OpenAI, Claude, Gemini und andere gängige Modelle aufrufen; die Schnittstelle ist mit dem OpenAI-Protokoll kompatibel und wird nutzungsbasiert abgerechnet. Der Mehrwert in Codex-Szenarien liegt vor allem im bequemen Quervergleich: Mit derselben Konfiguration können Sie verschiedene Modelle und Tarifstufen umschalten und so in Ihrem eigenen Projekt vergleichbare Daten erzeugen.
Anbindung, Protokollunterstützung und Stabilität unterscheiden sich je nach Drittanbieter. Bei der Bewertung sollten konkrete Testdaten und die Servicevereinbarungen die Grundlage bilden. Wählen Sie 2–3 repräsentative Aufgaben aus (zum Beispiel ein Refactoring über mehrere Dateien oder eine Fehlerbehebung mit Tests), führen Sie sie nach der Methode aus Abschnitt 4 über die jeweiligen Integrationswege aus und entscheiden Sie dann anhand von Erfolgsquote und Gesamt-Token.
💡 Auswahlempfehlung: Filtern Sie mit direkten Skripten zunächst die Optionen heraus, deren TTFT und TPS deutlich abweichen, und setzen Sie die verbleibenden Kandidaten dann in Codex für vollständige Aufgaben ein. Über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich mehrere Modelle vergleichen, ohne die Code-Struktur zu ändern.
Häufig gestellte Fragen (FAQ)
Q1: Woher kommen die Geschwindigkeitsunterschiede zwischen Codex-Abonnement und Drittanbieter-API hauptsächlich?
Sie ergeben sich aus dem gesamten Servicepfad: tatsächliche Modellbereitstellung, Inferenzintensität, Service-Stufe, Gateway-Kette, Übertragungsprotokoll, Cache-Treffer und Kompatibilität bei Tool-Ereignissen. Die mehrstufige Agent-Schleife von Codex summiert diese Unterschiede pro Runde, sodass die Gesamtzeitdifferenz oft viel größer ist als der Unterschied bei einer einzelnen Anfrage.
Q2: TTFT ist normal – warum ist die Codex-Aufgabe trotzdem langsam?
TTFT misst nur die Wartezeit bis zum ersten Token. Eine Codex-Aufgabe umfasst mehrere Inferenzrunden und Tool-Aufrufe; die anhaltende Ausgabegeschwindigkeit, erneute Inferenz nach der Tool-Ausführung, Cache-Misses und zwischenzeitliche Wiederholungen verlängern die Gesamtzeit. Für die Beurteilung der Erfahrung sind End-to-End-Dauer und Anzahl der Aufrufrunden entscheidend.
Q3: Um wie viel schneller macht der WebSocket-Modus Codex?
OpenAI veröffentlichte Daten: In bestimmten Workflows mit mehr als 20 Tool-Aufrufen steigt die End-to-End-Geschwindigkeit um bis zu etwa 40 %. Das ist die Obergrenze für ein bestimmtes Szenario; der tatsächliche Nutzen hängt von den Aufgabenrunden und davon ab, ob die Schnittstelle WebSocket und inkrementelles Zustandsmanagement vollständig unterstützt.
Q4: Codex wird in langen Dialogen immer langsamer – was sollte man tun?
Zuerst die gesamten Eingabe-Token und die Token aus Cache-Lesevorgängen pro Runde erfassen und prüfen, ob der Cache korrekt trifft. Ist der Historienkontext zu lang, kann man eine neue Sitzung starten oder eine Kontextkomprimierung auslösen; zugleich den Aufgabenumfang verkleinern und explorative Dateilese-Runden reduzieren.
Q5: Wie testet man schnell die tatsächliche Leistung einer Drittanbieter-API in Codex?
1. Bei APIYI apiyi.com registrieren und API-Schlüssel sowie kostenloses Testkontingent erhalten;
2. Mit dem Direktverbindungsskript aus diesem Artikel TTFT, TPS und Cache-Treffer messen;
3. Codex gemäß Abschnitt 4.2 konfigurieren, dieselbe Aufgabe wie beim Abonnement ausführen und End-to-End-Dauer sowie Aufrufrunden vergleichen.
So lassen sich Unterschiede des Inferenzdienstes und Unterschiede durch die Agent-Schleife getrennt erkennen.
Q6: Können die Daten aus öffentlichen Issues die allgemeine Performance von Codex repräsentieren?
Nicht direkt. Issue #60831 und #44305 sind Logs einzelner Nutzer; ersteres misst die Zeit bis zu den HTTP-Antwortheadern, letzteres eine einmalige Read-only-Aufgabe mit Timeout. Ihr Wert liegt darin, zu zeigen, wie serverseitige Schwankungen und serielle Tool-Schleifen die Dauer beeinflussen; konkrete Schlussfolgerungen müssen mit eigenen Aufgabentests verifiziert werden.
Codex-Geschwindigkeitsunterschiede – zentrale Key Takeaways
- Unterschiedliche Pfade: Abo-Login und API-Schlüssel laufen über verschiedene Abrechnungs- und Servicepfade. Derselbe Modellname bedeutet nicht dieselbe Bereitstellung.
- Verstärkung durch Schleifen: Die Agent-Schleife von Codex summiert kleine Latenzen jeder Runde zu einem deutlich spürbaren Gesamtzeitunterschied.
- Metriken auf mehreren Ebenen: TTFT misst die erste Antwort; End-to-End-Zeit und Anzahl der Aufrufrunden bilden erst die tatsächliche Erfahrung ab.
- Protokoll hat Einfluss: WebSocket bringt in mehrstufigen Tool-Aufrufszenarien bis zu etwa 40 % Beschleunigung, erfordert aber vollständige Unterstützung auf der Schnittstelle.
- Cache prüfen: Eine Proxy-Schicht kann den Anfrage-Präfix verändern und damit den Cache beeinflussen; Cache-Read-Tokens müssen erfasst werden.
- Kontrolltests: Abo, offizielle API und Drittanbieter-API mit derselben Aufgabe im Dreiervergleich testen, plus Direktverbindungstest zur Lokalisierung des Engpasses.
- Auswahl nach Aufgabe: Mit echten Aufgaben auf Plattformen wie APIYI apiyi.com quer testen und auf die Aufgabenerfüllungskosten statt auf den Stückpreis achten.
Zusammenfassung
Derselbe Codex zeigt zwei Geschwindigkeiten – die Ursache liegt in der Überlagerung von Servicepfad und Agent-Schleife:
- Mechanische Ebene: Modell, Inferenzstärke, Service-Stufe, Gateway, Protokoll, Cache und Tool-Schleife bestimmen gemeinsam die Gesamtzeit; jede einzelne Rundendifferenz wird durch die mehrfachen Aufrufe verstärkt.
- Evidenzebene: Offizielle Daten zeigen, dass Optimierungen an Protokoll und Stufe spürbare Beschleunigung bringen; Nutzer-Logs zeigen, dass serverseitige Schwankungen und serielle Schleifen Aufgaben deutlich verlängern.
- Methodische Ebene: Vier Kernmetriken erfassen, drei Kontrollgruppen plus Direktverbindungstest durchführen und dann symptombasiert Punkt für Punkt optimieren.
Beim Troubleshooting zuerst Modell und Inferenzstärke fixieren und dann mit Daten argumentieren. Wenn Sie zwischen mehreren Modellen und Zugangswegen vergleichen müssen, können Sie die einheitliche Schnittstelle von APIYI nutzen, um die Testkosten auf ein Minimum zu senken.
📚 Referenzen
- Codex as a platform: build on the open agent harness: OpenAI erläutert die Aufgaben des Codex Agent Harness
- Link:
developers.openai.com/blog/codex-as-a-platform -
Beschreibung: Die offizielle Grundlage für das Verständnis des mehrstufigen Modell- und Tool-Loops von Codex
-
Codex-Authentifizierungsdokumentation: Zwei Zugangswege – ChatGPT-Login und API-Schlüssel
- Link:
learn.chatgpt.com/docs/auth?surface=cli -
Beschreibung: Unterscheidung zwischen Abonnementvorteilen sowie API-Abrechnung und Rate-Limits
-
Speeding up agentic workflows with WebSockets in the Responses API: Engineering-Artikel von OpenAI
- Link:
openai.com/index/speeding-up-agentic-workflows-with-websockets -
Beschreibung: Ablauf des Agent-Loops und Kennzahlen zur Beschleunigung mit WebSockets
-
Dokumentation zum WebSocket mode: WebSocket-Modus der Responses API
- Link:
developers.openai.com/api/docs/guides/websocket-mode -
Beschreibung: Persistente Verbindungen, inkrementelle Eingaben und passende Einsatzszenarien
-
Latency optimization-Leitfaden: OpenAIs Prinzipien zur Latenzoptimierung
- Link:
developers.openai.com/api/docs/guides/latency-optimization -
Beschreibung: Optimierungsansätze rund um Ausgabe-Tokens, Anzahl der Aufrufe und Parallelisierung
-
Fast mode-Dokumentation: Service-Stufen und Umfang der Beschleunigung
- Link:
developers.openai.com/api/docs/guides/fast-mode -
Beschreibung: Service-Stufen-Variablen, die bei Geschwindigkeitsvergleichen konstant gehalten werden müssen
-
Prompt caching-Dokumentation: Cache-Schreiben, -Lesen und TTL
- Link:
developers.openai.com/api/docs/guides/prompt-caching -
Beschreibung: Statistik und Optimierung der Cache-Trefferquote bei langen Dialogen
-
openai/codex Issue #60831 / #44305 / #33029 / #41340 / #42471: Von Nutzern gemeldete Latenz- und Kompatibilitätsprobleme
- Link:
github.com/openai/codex/issues/60831,github.com/openai/codex/issues/44305,github.com/openai/codex/issues/33029 - Beschreibung: Einzelfallprotokolle zu Server-Schwankungen, aufgeblähten Tool-Loops, Hilfsanfragen der Desktop-App und Kompatibilität mit Drittanbieter-Protokollen
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com, um Erfahrungen zur Codex-Integration und zu Performancetests auszutauschen. Weitere Materialien finden Sie im Dokumentationszentrum docs.apiyi.com


