
作者注:Codex 的任務耗時由模型、推理強度、服務路徑、工具循環、緩存和網絡共同決定,用同任務對照與分段計時可以定位瓶頸。
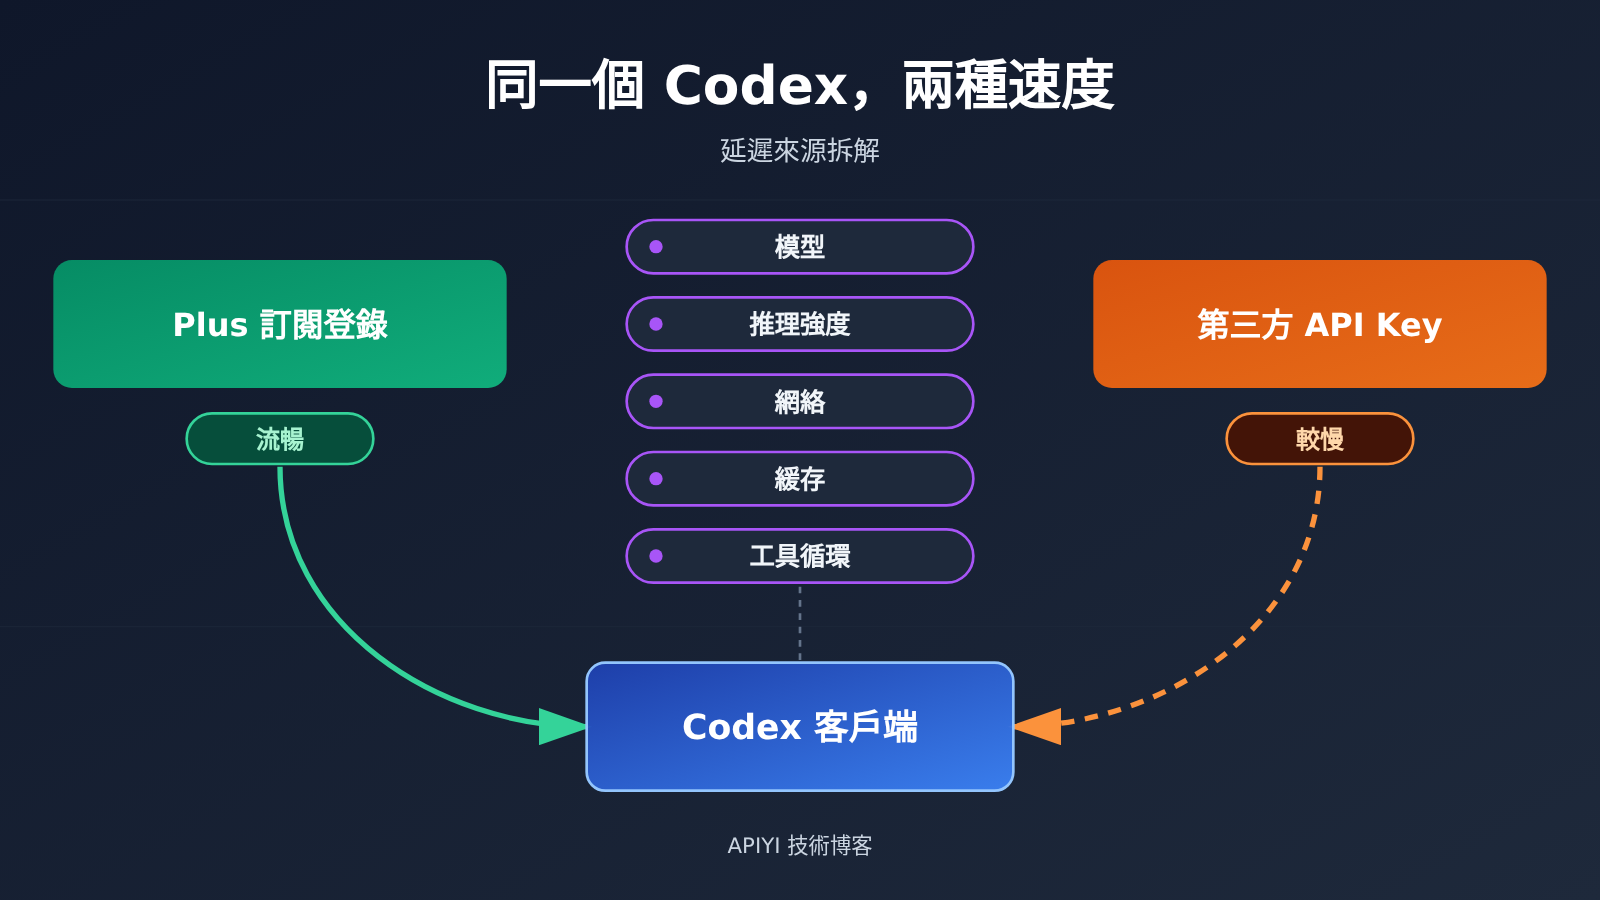
同一個 Codex,用 ChatGPT Plus 登錄時流暢,換成第三方 API Key 後變慢,原因通常在於兩者走的是 不同的服務路徑,而 Codex 的 Agent 循環會把每一輪請求裏的額外延遲成倍累積。客戶端界面相同,但模型部署、推理檔位、傳輸協議、緩存命中和工具事件兼容程度都可能不同。一次請求只多等 3 秒,一個需要 20 輪串行調用的編程任務就可能多出約 1 分鐘。
下文先拆解 Codex 的工作方式和兩種接入路徑,再逐項說明第三方 API 的延遲來源,並用兩個公開的 GitHub Issue 作爲個案佐證。之後給出四項核心指標、三組對照測試和按症狀分類的優化方案,幫助你判斷自己的 Codex 慢在模型、網絡、緩存還是工具循環。最後討論選擇第三方 API 時,哪些指標比單價更能反映真實成本。
To Know:理解 Codex 速度差異的術語
| 術語 | 解釋 |
|---|---|
| Codex Harness | Codex 的執行框架,負責組織模型、工具、上下文和多輪任務循環。 |
| Responses API | OpenAI 提供的接口,支持模型輸出、工具調用和多輪狀態管理,Codex 依賴它運轉。 |
| TTFT | Time To First Token,從發出請求到收到首個輸出 token 的等待時間。 |
| TPS | Tokens Per Second,每秒生成的 token 數,反映持續輸出速度。 |
| 端到端耗時 | 從提交任務到任務最終完成的總時間,包含所有模型調用和工具執行。 |
| 推理強度 | 模型思考的深淺檔位,如 low、medium、high,檔位越高通常輸出越多、耗時越長。 |
| 工具調用(Tool Calling) | 模型請求外部程序讀取文件、執行命令等,再拿結果繼續推理的過程。 |
| 提示詞緩存(Prompt Caching) | 輸入前綴重複且符合條件時,複用已有計算結果以降低處理耗時。 |
| SSE | Server-Sent Events,服務器通過單向 HTTP 連接持續推送事件。 |
| WebSocket | 一種持久的雙向連接,多輪請求可以複用同一條連接。 |
| previous_response_id | Responses API 中引用上一輪響應的參數,配合增量輸入可減少重複傳輸。 |
| 服務檔位 | 同一模型的不同處理選項,如 Standard、Fast,速度和價格各不相同。 |
1 爲什麼同一個 Codex 會有兩種速度?
1.1 Codex 訂閱登錄與 API Key 走不同的服務路徑
根據 OpenAI 的身份驗證文檔,Codex CLI、IDE 擴展和桌面應用都支持兩種登錄方式:ChatGPT 賬號登錄,或填入 API Key。ChatGPT 登錄消耗的是訂閱附帶的 Codex 使用權益和對應限額;API Key 則按 API 賬戶的計量計費和限流規則執行。Plus 訂閱本身也不包含免費調用任意 OpenAI API 的權利。
接入第三方 API Key 時,Codex 客戶端只負責組織任務,真正的推理發生在該接口背後的服務上。實際調用的模型、計費方式、流式協議和服務質量,都由第三方接口及其後端實現決定。因此,客戶端上顯示的模型名稱相同,只能說明你選擇了同一個名字,無法確認兩次請求經過了相同的模型部署、服務隊列和傳輸路徑。
1.2 Codex 的 Agent 循環決定了它需要反覆請求模型
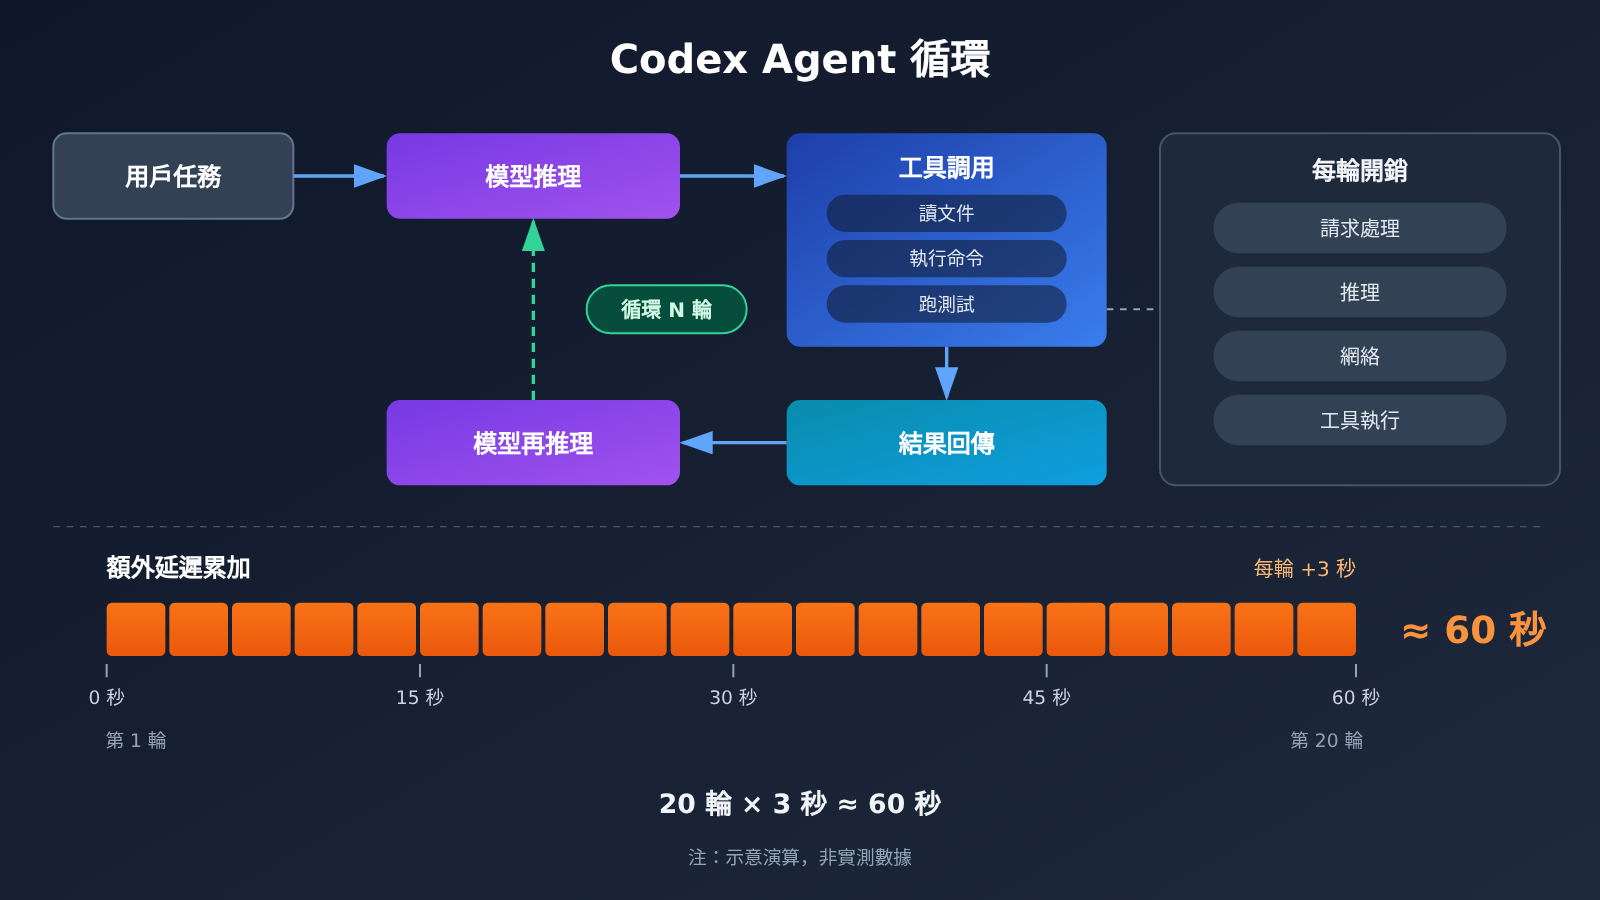
OpenAI 在 2026 年 8 月 19 日發佈的《Codex as a platform》中說明,Codex 的開源 Agent Harness 負責理解任務、維護上下文、檢索代碼庫、調用 Shell、編輯文件、運行測試,並處理失敗恢復、用戶審批和執行邊界。它的本質是一個“模型推理 → 工具執行 → 再推理”的循環系統。
OpenAI 在 2026 年 4 月 22 日的工程文章中描述過典型流程:用戶提出修改任務,模型判斷要做什麼,Codex 讀取文件或執行命令,工具返回結果後模型重新分析,接着繼續調用工具、修改代碼、執行測試、檢查結果。複雜任務可能包含數十輪模型與工具之間的往返,每一輪都是一次完整的 API 請求。
2 Codex 接第三方 API 的速度差異從哪裏來?
先用一張表概括五類延遲來源,後面逐項展開。
| 延遲來源 | 主要影響的指標 | 典型表現 | 排查優先級 |
|---|---|---|---|
| 模型與推理強度 | TPS、單輪推理時間 | 輸出持續偏慢,思考時間長 | 高 |
| 服務檔位與路由 | TTFT、波動幅度 | 首響應慢或忽快忽慢 | 高 |
| 網關與網絡路徑 | 每輪固定附加時間 | 每次調用都多出穩定的幾秒 | 中 |
| 傳輸協議(SSE / WebSocket) | 多輪累計開銷、連接穩定性 | 長任務慢、中途斷流 | 中 |
| 緩存與工具循環 | 輸入處理時間、調用輪次 | 長對話明顯變慢、輪次過多 | 高 |
2.1 模型推理速度和推理強度對 Codex 耗時的影響
對比兩種接入方式之前,必須先確認實際模型 ID、推理強度、模型版本和服務檔位是否一致。推理強度從 low 到 xhigh、max,檔位越高,模型生成的思考內容越多,單輪耗時越長。
OpenAI 的延遲優化指南把輸出 token 數列爲影響推理耗時的關鍵變量:在部分場景中,輸出 token 減少約 50%,生成延遲也可能下降接近 50%;而減少普通輸入文本帶來的影響通常小得多。服務檔位同樣重要,OpenAI 的 Fast 模式對適用模型和負載最高可達 2.5 倍速度,但它是付費檔位選擇,並且只對部分模型生效。
這意味着訂閱側和第三方側哪怕都顯示同一模型,只要推理檔位或服務檔位不同,速度差異就會很明顯。
2.2 API 中轉、網絡路徑與 WebSocket 對多輪任務的影響
第三方接口的請求鏈路通常更長:客戶端 → 服務商網關 → 代理節點 → 可能的跨境鏈路 → 最終推理服務。每多一跳,就可能多一點固定延遲和網絡波動,而這些延遲在 Agent 循環中會被逐輪疊加。
傳輸協議是另一個變量。傳統 Responses API 多通過 HTTP/SSE 傳輸,每輪都要重新建立請求並攜帶上下文。WebSocket 模式維持持久連接,並藉助 previous_response_id 和增量輸入減少重複傳輸與處理。OpenAI 官方公佈的數據如下:
- 2025 年末的一輪 API 優化使首 token 延遲改善接近 45%。
- 在 20 次以上工具調用的特定工作流中,WebSocket 模式帶來最高約 40% 的端到端提速。
- Vercel 相關集成報告最高約 40% 的延遲改善,Cline 多文件工作流報告約 39% 的提速,Cursor 中的 OpenAI 模型報告最高約 30% 的改善。
這些數據來自不同產品和測試場景,屬於特定工作流下的上限值。部分兼容網關只實現了 HTTP/SSE,或未完整支持 Codex 使用的 WebSocket 與增量狀態管理,這類接入就拿不到這部分收益。
2.3 Codex 的上下文緩存與工具調用次數
長任務中,歷史消息、工具定義和重複上下文會佔據大量輸入 token。提示詞緩存命中時,這部分前綴的處理耗時可以降低。OpenAI 文檔顯示,GPT-5.6 及後續系列支持新的緩存寫入、讀取與 TTL 控制。
問題在於,緩存依賴請求前綴的穩定性。如果中轉層改寫了請求前綴、調整了工具定義順序或改變了緩存邊界,就可能影響緩存複用,讓每一輪都重新處理大段上下文。工具調用次數則直接決定請求輪次:輪次越多,所有單輪開銷被放大的倍數就越高。
2.4 爲什麼 Codex 首響應正常,後續仍然很慢?
這是標題問題最常見的形態。TTFT 只衡量第一個 token 來得快不快,而 Codex 任務的總耗時是所有輪次的累加。總耗時可以寫成:
T_total = Σ(API 請求處理時間 + 模型推理時間 + 網絡傳輸時間 + 本地工具執行時間 + 等待與重試時間)
首響應正常但整體慢,通常來自以下幾種情況:持續輸出速度(TPS)偏低,長回覆拖慢每一輪;工具執行完成後模型重新推理,而每次重新推理都要再處理一遍上下文;流式連接中途斷開或超時,客戶端觸發重試,用戶看到的是“模型停住了”。按機制演算,一個需要 20 次串行模型調用的任務,每次多等 3 秒,總耗時就會增加約 60 秒,這個數字用於說明累積效應,並非實測結果。
3 公開案例爲 Codex 慢速問題提供了哪些證據?
以下兩個案例來自 openai/codex 倉庫的用戶報告,屬於單一用戶的個案日誌,用於說明機制,不代表行業普遍水平。
3.1 Issue #60831:同一會話中約七倍的響應時間波動
2026 年 11 月提交的 Issue #60831 中,報告者在同一會話、同一客戶端進程、相同推理設置下觀察到兩次請求:壓縮後的請求體都約爲 13.09 MB,中間沒有發生上下文壓縮,圖片歷史也沒有變化。慢的一次從請求壓縮完成到收到 HTTP 響應頭用了 109.317 秒,快的一次是 15.637 秒,比值約 6.99 倍。
需要注意計時口徑:這兩個數字衡量的是“到收到響應頭”的時間,屬於服務處理階段,而非整個任務的完成時長;兩次請求也來自同一路徑,與訂閱和第三方的對比無關。它說明的是,在上下文大小不變時,服務端處理時間本身就可能大幅波動。報告本身無法確定具體是哪個服務環節造成了瓶頸。
3.2 Issue #44305:工具循環讓一次只讀任務耗時激增
2026 年 9 月的 Issue #44305 中,報告者對比了同類只讀任務:另一個 Agent 用 3 次並行讀取,約 10.6 秒完成;Codex 運行 91.5 秒後超時,仍未給出完整回答。期間 Codex 進行了約 11 次模型推理和 11 次工具調用,累計輸入約 295,042 tokens,其中緩存輸入約 260,608 tokens。
按這組數字計算,緩存輸入佔比約 88.3%,緩存命中情況良好,但串行的 11 輪循環仍然讓耗時遠超並行讀取的方案。兩個 Agent 的工作策略本身不同,時間差不能全部歸因於 Codex 或模型,但它清楚展示了調用輪次和串行執行對總耗時的放大作用。
此外,還有兩類問題與第三方接入直接相關:Issue #33029 報告 Codex Desktop 使用第三方兼容接口時,模型端點工作正常,但桌面端仍會請求部分 ChatGPT 輔助服務,這些請求超時會拖慢應用響應;Issue #41340 和 #42471 分別報告了第三方 Responses 端點出現“stream disconnected before completion”,以及工具調用事件被接收卻未進入執行流程。簡單聊天能跑通,與完整的 Codex 工具循環能跑通,是兩個級別的兼容要求。
4 如何找到自己的 Codex 慢在哪裏?
4.1 用四項核心指標定位 Codex 瓶頸
| 指標 | 記錄方式 | 反映的問題 |
|---|---|---|
| TTFT | 每次請求的首個有效輸出等待時間 | 隊列、模型啓動、網絡首包 |
| 端到端耗時 | 任務從提交到完成的總時間 | 整體體驗,是最終判斷依據 |
| 模型 / 工具調用次數 | 統計推理輪次、工具次數及工具執行時間 | Agent 策略和串行放大 |
| 緩存命中 | 總輸入、緩存讀取、緩存寫入、輸出 token | 上下文重複處理開銷 |
在這四項之外,建議同時記錄 TPS、單次請求的輸入輸出 token、使用的協議(WebSocket 或 SSE),以及 429、5xx、超時和重試的次數。這些輔助數據能幫你區分“慢”和“出錯後重試導致的慢”。
4.2 三組 Codex 對照測試的執行步驟
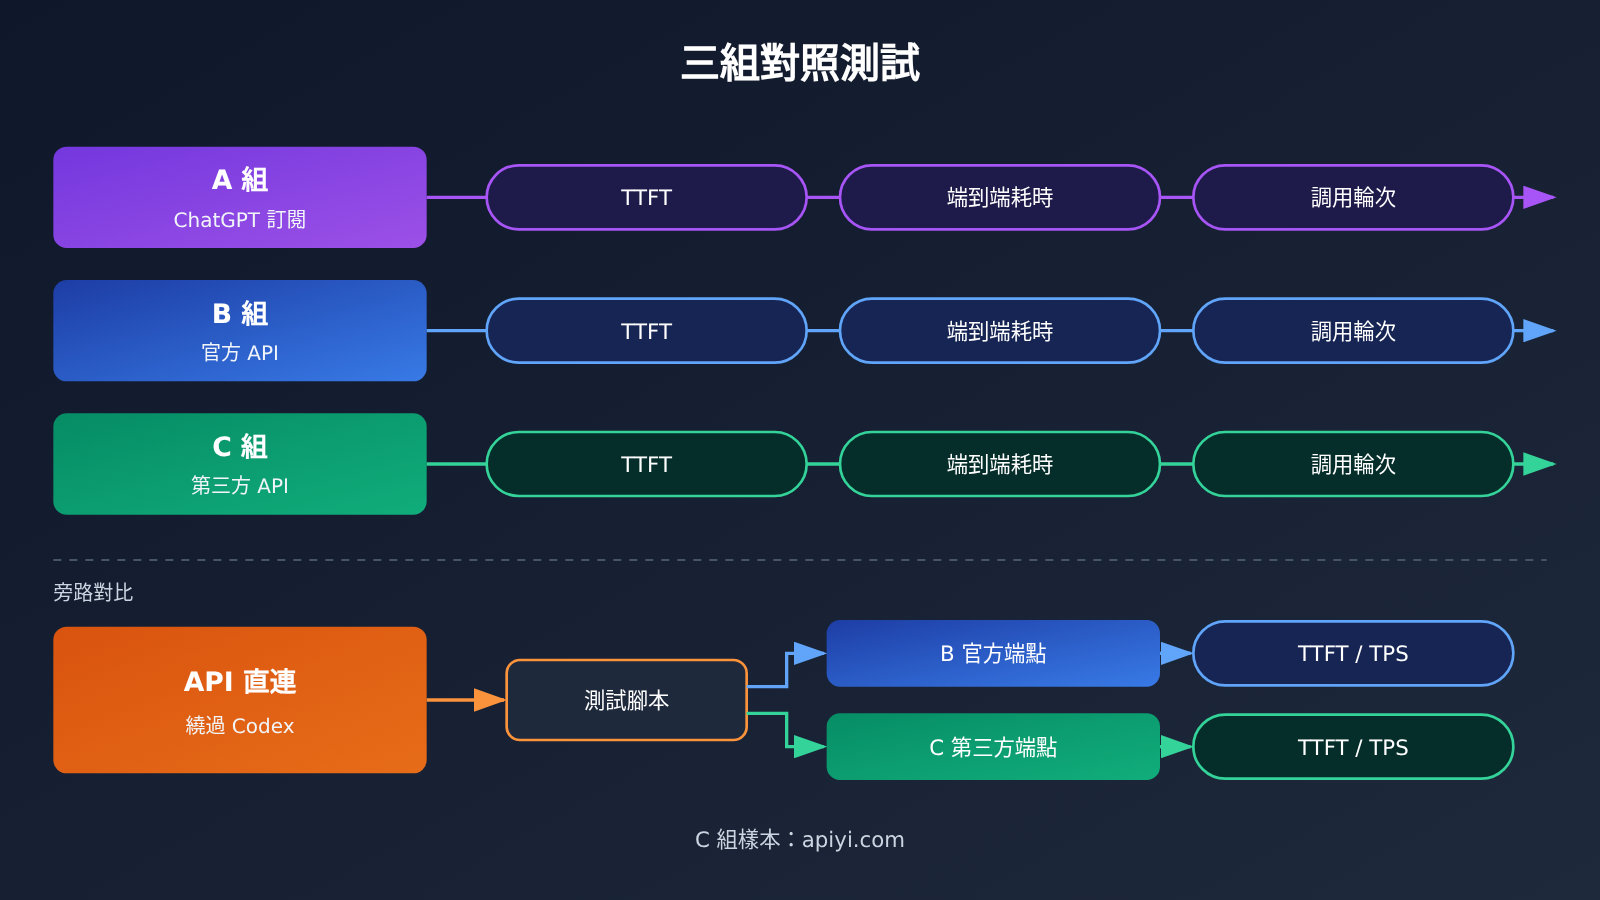
對照測試的前提是控制變量:模型 ID、推理強度、Codex 版本、項目文件和任務描述保持一致,並分別在新會話和長會話兩種場景下各跑一遍,以識別上下文長度的影響。
- A 組:用 ChatGPT 訂閱登錄 Codex,執行標準任務,記錄端到端耗時和調用輪次。
- B 組:用同模型的官方 API Key 接入 Codex,執行同一任務。
- C 組:用第三方兼容 API 接入 Codex,執行同一任務。
- 直連組:對 B、C 兩條路徑,繞過 Codex,用腳本發送同樣的單次請求,測量 TTFT 和 TPS。
A 與 B 的差異主要反映訂閱路徑和 API 路徑的服務差異;B 與 C 的差異反映網關、路由和推理服務的差異;直連結果與 Codex 內結果的差距,則反映 Agent 循環、協議兼容和客戶端帶來的額外開銷。每組建議重複多次取中位數,避免把一次偶發波動當成結論。
以下腳本用於“直連組”測試,通過流式 Responses 請求測量 TTFT、總時長、輸出 token 和 TPS:
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口,切換到官方地址即可做 B 組對照
)

start = time.perf_counter()
ttft = None
stream = client.responses.create(
    model="YOUR_MODEL_ID",            # 與 Codex 中使用的模型 ID 保持一致
    reasoning={"effort": "medium"},   # 與 Codex 中的推理強度保持一致
    input="閱讀下面的函數並指出潛在 bug:def add(a, b): return a - b",
    stream=True,
)
usage = None
for event in stream:
    if event.type == "response.output_text.delta" and ttft is None:
        ttft = time.perf_counter() - start
    elif event.type == "response.completed":
        usage = event.response.usage

total = time.perf_counter() - start
out_tokens = usage.output_tokens if usage else 0
print(f"TTFT: {ttft:.2f}s | 總耗時: {total:.2f}s | 輸出: {out_tokens} tokens")
if ttft and total > ttft:
    print(f"TPS: {out_tokens / (total - ttft):.1f} tokens/s")
查看多輪重複測試與緩存統計的完整腳本
import time
import statistics
from openai import OpenAI

ENDPOINTS = {
    "official": {"base_url": "https://api.openai.com/v1", "key": "OFFICIAL_KEY"},
    "apiyi": {"base_url": "https://api.apiyi.com/v1", "key": "APIYI_KEY"},  # API易 接口
}
MODEL = "YOUR_MODEL_ID"
EFFORT = "medium"
# 用較長的固定前綴模擬 Codex 的系統提示與工具定義,便於觀察緩存命中
PREFIX = "你是代碼審查助手。項目規範如下:\n" + ("- 函數必須有類型註解。\n" * 300)
TASK = "檢查這個函數:def add(a, b): return a - b"


def run_once(client):
    start = time.perf_counter()
    ttft, usage = None, None
    stream = client.responses.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=PREFIX + TASK,
        stream=True,
    )
    for event in stream:
        if event.type == "response.output_text.delta" and ttft is None:
            ttft = time.perf_counter() - start
        elif event.type == "response.completed":
            usage = event.response.usage
    total = time.perf_counter() - start
    cached = 0
    if usage and getattr(usage, "input_tokens_details", None):
        cached = usage.input_tokens_details.cached_tokens or 0
    return {
        "ttft": ttft or total,
        "total": total,
        "input": usage.input_tokens if usage else 0,
        "cached": cached,
        "output": usage.output_tokens if usage else 0,
    }


def bench(name, cfg, rounds=5):
    client = OpenAI(api_key=cfg["key"], base_url=cfg["base_url"])
    results, errors = [], 0
    for _ in range(rounds):
        try:
            results.append(run_once(client))
        except Exception as e:
            errors += 1
            print(f"[{name}] 請求失敗: {e}")
    if not results:
        return
    med = lambda k: statistics.median(r[k] for r in results)
    hit = sum(r["cached"] for r in results) / max(sum(r["input"] for r in results), 1)
    print(
        f"[{name}] TTFT中位數 {med('ttft'):.2f}s | 總耗時中位數 {med('total'):.2f}s | "
        f"緩存命中率 {hit:.1%} | 失敗 {errors}/{rounds}"
    )


for name, cfg in ENDPOINTS.items():
    bench(name, cfg)
在 Codex 內做 C 組測試時,需要把第三方端點配置爲模型提供方。以下是常見的 ~/.codex/config.toml 寫法,具體字段名請以你所用 Codex 版本的官方文檔爲準:
model = "YOUR_MODEL_ID"
model_provider = "apiyi"
model_reasoning_effort = "medium"

[model_providers.apiyi]
name = "API易"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
🚀 快速開始:做 C 組對照時,可以在 API易 apiyi.com 申請新用戶免費測試額度,用同一個 Key 切換多個模型分別跑完上面的腳本,快速得到可比的 TTFT 與總耗時數據。
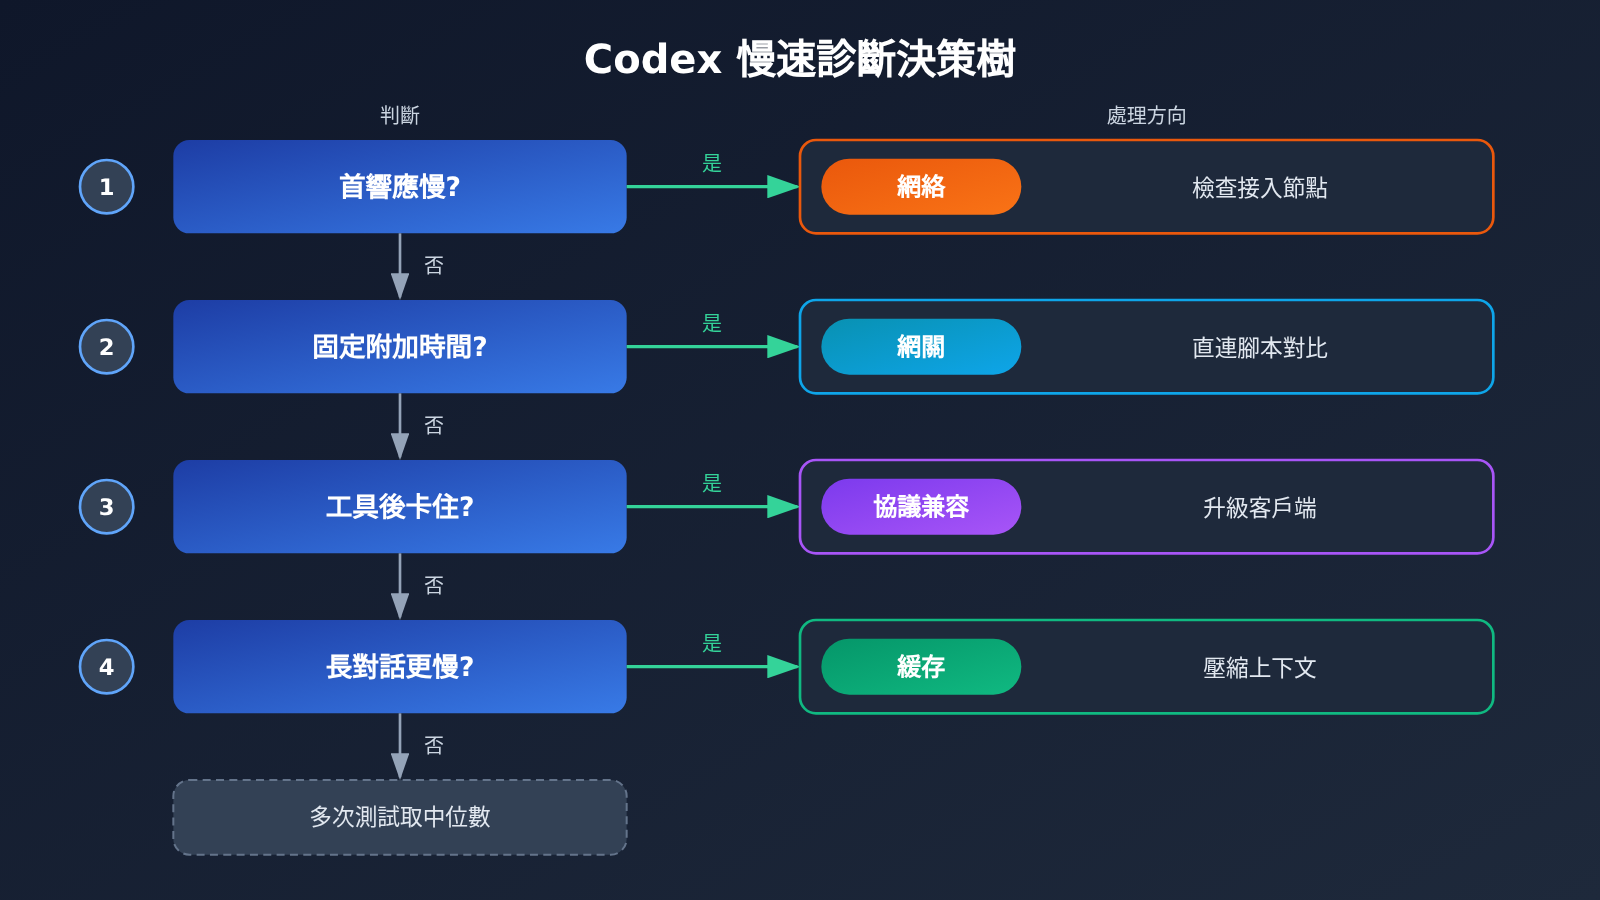
4.3 按症狀對應的 Codex 優化方案
| 症狀 | 優先排查 | 處理方法 |
|---|---|---|
| 首響應慢 | 隊列、模型啓動、網絡首包 | 換用更近的接入節點,確認服務檔位,避開高峯時段對比 |
| 首響應快,後續慢 | TPS、工具輪次、緩存 | 降低推理強度,限制輸出長度,檢查緩存命中率 |
| 每次調用多出穩定時間 | 中轉鏈路、附加請求 | 用直連腳本對比 B、C 組,定位網關開銷 |
| 工具調用後卡住 | Responses 事件、工具回傳 | 檢查是否出現斷流或工具事件丟失,升級客戶端版本 |
| 長對話明顯慢於新對話 | 歷史 token、壓縮、緩存 | 適時開新會話或觸發上下文壓縮,觀察緩存讀取變化 |
| 速度忽快忽慢 | 服務負載、重試、網絡波動 | 統計 429/5xx 和超時次數,多次測試取中位數 |
| 桌面端整體卡頓,API 正常 | ChatGPT 輔助服務請求 | 參考 Issue #33029,檢查輔助請求是否超時,必要時改用 CLI |
模型層面的優化遵循 OpenAI 延遲指南的思路:減少輸出 token、降低輸入上下文、減少調用次數、並行處理獨立步驟,能用普通程序完成的事就別交給模型。對於 Codex 來說,最直接的手段是給任務描述更明確的範圍,讓 Agent 少走探索性的讀取輪次。
5 爲 Codex 選擇第三方 API 時,哪些指標比單價更重要?
5.1 從 token 單價轉向任務完成成本
Codex 場景下,真正的成本由“完成一個任務”決定。單價低的接口,如果緩存命中差、調用輪次多、經常斷流重試,最終消耗的 token 和時間都會更高。評估時建議把以下幾項放在一起看:任務成功率、端到端耗時、單任務消耗的總 token(含緩存讀取)、失敗與重試帶來的額外成本。
| 評估維度 | 關注點 | 測試方法 | 可用平臺 |
|---|---|---|---|
| 模型身份與版本 | 模型 ID 與版本是否明確、穩定可用 | 覈對返回的模型字段與文檔 | API易 apiyi.com、官方 API |
| 首 token 與持續速度 | TTFT、TPS 的中位數和波動 | 直連腳本多輪測試 | API易 apiyi.com、官方 API |
| 多輪 Agent 完成時間 | Codex 內真實任務的總耗時 | 三組對照測試 | API易 apiyi.com、官方 API |
| 協議兼容 | Responses、WebSocket、工具事件支持 | 跑一次完整的讀文件 + 改代碼 + 測試任務 | 視服務商文檔而定 |
| 緩存支持 | 緩存讀取 token 是否正常返回 | 統計 usage 中的緩存字段 | 視服務商文檔而定 |
| 穩定性與計費 | 失敗率、併發、計費透明度 | 記錄 429/5xx 與賬單明細 | 視服務商文檔而定 |
5.2 用真實任務評估 API易 等第三方接口
API易 apiyi.com 是 AI 大模型 API 聚合平臺,一個 API Key 可以調用 OpenAI、Claude、Gemini 等主流模型,接口兼容 OpenAI 協議,按量計費。它在 Codex 場景中的價值,主要體現在方便橫向比較:同一套配置切換不同模型和檔位,就能在你自己的項目上跑出可比數據。
不同第三方服務商的鏈路、協議支持和穩定性各不相同,評估時應以具體測試數據和服務協議爲依據。建議挑選 2~3 個代表性任務(例如一次多文件重構、一次帶測試的 bug 修復),按第 4 節的方法在各接入方式上分別執行,再結合成功率和總 token 做決定。
💡 選擇建議:先用直連腳本篩掉 TTFT 和 TPS 明顯偏離的選項,再把剩下的候選放進 Codex 跑完整任務。通過 API易 apiyi.com 的統一接口,可以在不改代碼結構的情況下完成多個模型的對比。
常見問題 FAQ
Q1:Codex 訂閱和第三方 API 的速度差異主要來自哪裏?
來自服務路徑的整體差異:實際模型部署、推理強度、服務檔位、網關鏈路、傳輸協議、緩存命中和工具事件兼容程度。Codex 的多輪 Agent 循環會把這些單輪差異逐輪累加,因此總耗時差距往往比單次請求差距大得多。
Q2:TTFT 正常,爲什麼 Codex 任務還是很慢?
TTFT 只衡量首個 token 的等待時間。Codex 一個任務包含多輪推理和工具調用,持續輸出速度、工具執行後的重新推理、緩存未命中和中途重試都會拉長總時間。判斷體驗要看端到端耗時和調用輪次。
Q3:WebSocket 模式能讓 Codex 快多少?
OpenAI 公佈的數據是:在 20 次以上工具調用的特定工作流中,端到端速度最高約提升 40%。這是特定場景的上限,實際收益取決於任務輪次以及接口是否完整支持 WebSocket 和增量狀態管理。
Q4:長對話中 Codex 越來越慢,應該怎麼處理?
先記錄每輪的總輸入 token 和緩存讀取 token,確認緩存是否正常命中。如果歷史上下文過長,可以開啓新會話或觸發上下文壓縮;同時縮小任務範圍,減少探索性的文件讀取輪次。
Q5:如何快速測出第三方 API 在 Codex 中的真實表現?
1. 在 API易 apiyi.com 註冊並獲取 API Key 與免費測試額度;
2. 用本文的直連腳本測量 TTFT、TPS 和緩存命中;
3. 按 4.2 節配置 Codex,執行與訂閱側相同的任務,對比端到端耗時與調用輪次。
這樣可以分開看到推理服務差異和 Agent 循環帶來的差異。
Q6:公開 Issue 裏的數據能代表 Codex 的普遍性能嗎?
不能直接代表。Issue #60831 和 #44305 都是單一用戶的日誌,前者衡量的是到 HTTP 響應頭的時間,後者是一次超時的只讀任務。它們的價值在於展示服務端波動和串行工具循環如何影響耗時,具體結論需要用你自己的任務測試來驗證。
Codex 速度差異核心要點 Key Takeaways
- 路徑不同:訂閱登錄與 API Key 走不同計費和服務路徑,模型名相同不代表部署相同。
- 循環放大:Codex 的 Agent 循環會把每輪小延遲累加成顯著的總耗時差。
- 指標分層:TTFT 看首響應,端到端耗時和調用輪次才反映真實體驗。
- 協議有影響:WebSocket 在多輪工具調用場景下最高約 40% 提速,需接口完整支持。
- 緩存要覈對:中轉層改變請求前綴可能影響緩存,需統計緩存讀取 token。
- 對照測試:訂閱、官方 API、第三方 API 三組同任務對照,加直連測試定位瓶頸。
- 按任務選型:用真實任務在 API易 apiyi.com 等平臺橫向測試,看任務完成成本而非單價。
總結
同一個 Codex 出現兩種速度,根源在於服務路徑與 Agent 循環的疊加效應:
- 機制層面:模型、推理強度、服務檔位、網關、協議、緩存和工具循環共同決定總耗時,任何單輪差異都會被多輪調用放大。
- 證據層面:官方數據說明協議和檔位優化能帶來可觀提速,用戶日誌說明服務端波動和串行循環會顯著拉長任務。
- 方法層面:記錄四項核心指標,做三組對照加直連測試,再按症狀逐項優化。
排查時先固定模型和推理強度,再用數據說話。如果你需要在多個模型和接入方式之間做對比,可以藉助 API易 的統一接口,把測試成本降到最低。
📚 參考資料
- Codex as a platform: build on the open agent harness:OpenAI 介紹 Codex Agent Harness 的職責
- 鏈接:
developers.openai.com/blog/codex-as-a-platform -
說明: 理解 Codex 多輪模型與工具循環的官方依據
-
Codex 身份驗證文檔:ChatGPT 登錄與 API Key 兩種接入方式
- 鏈接:
learn.chatgpt.com/docs/auth?surface=cli -
說明: 區分訂閱權益與 API 計費、限流規則
-
Speeding up agentic workflows with WebSockets in the Responses API:OpenAI 工程文章
- 鏈接:
openai.com/index/speeding-up-agentic-workflows-with-websockets -
說明: Agent 循環流程與 WebSocket 提速數據
-
WebSocket mode 文檔:Responses API 的 WebSocket 模式
- 鏈接:
developers.openai.com/api/docs/guides/websocket-mode -
說明: 持久連接、增量輸入與適用場景
-
Latency optimization 指南:OpenAI 延遲優化原則
- 鏈接:
developers.openai.com/api/docs/guides/latency-optimization -
說明: 輸出 token、調用次數、並行化等優化思路
-
Fast mode 文檔:服務檔位與加速範圍
- 鏈接:
developers.openai.com/api/docs/guides/fast-mode -
說明: 比較速度時需控制的服務檔位變量
-
Prompt caching 文檔:緩存寫入、讀取與 TTL
- 鏈接:
developers.openai.com/api/docs/guides/prompt-caching -
說明: 長對話緩存命中的統計與優化
-
openai/codex Issue #60831 / #44305 / #33029 / #41340 / #42471:用戶報告的延遲與兼容問題
- 鏈接:
github.com/openai/codex/issues/60831、github.com/openai/codex/issues/44305、github.com/openai/codex/issues/33029 - 說明: 服務端波動、工具循環放大、桌面端輔助請求及第三方協議兼容的個案日誌
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 網站首頁聯繫我們交流 Codex 接入與性能測試經驗,更多資料可訪問 docs.apiyi.com 文檔中心


