
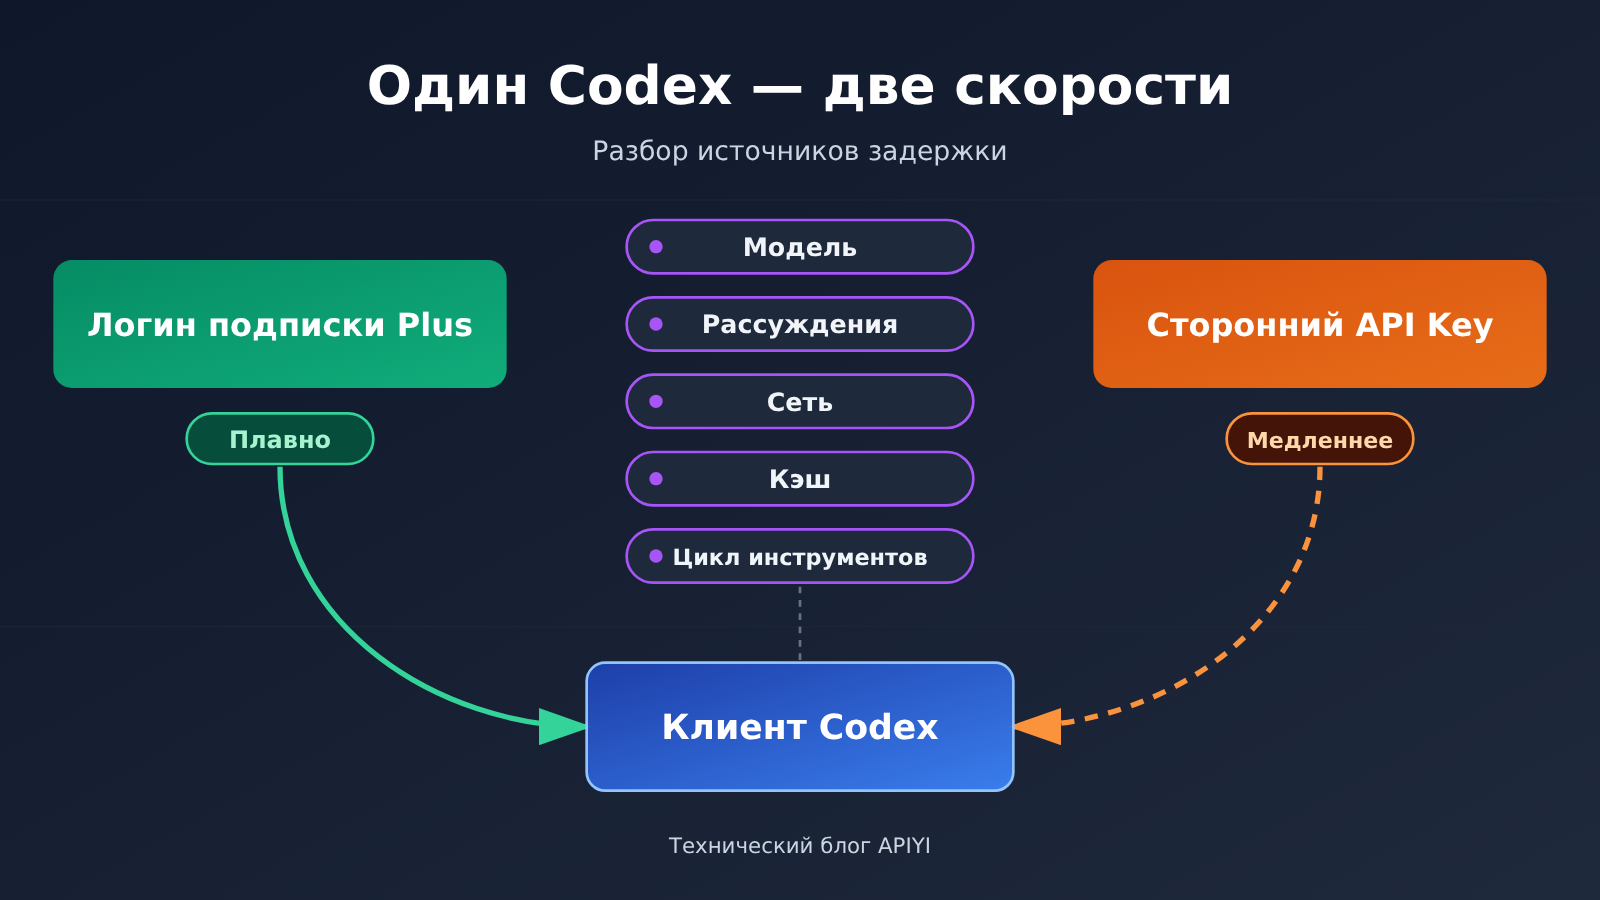
Примечание автора: время выполнения задачи в Codex определяется моделью, уровнем рассуждений, путём обслуживания, циклом инструментов, кэшем и сетью. Чтобы найти узкое место, сравнивайте одну и ту же задачу и измеряйте время по этапам.
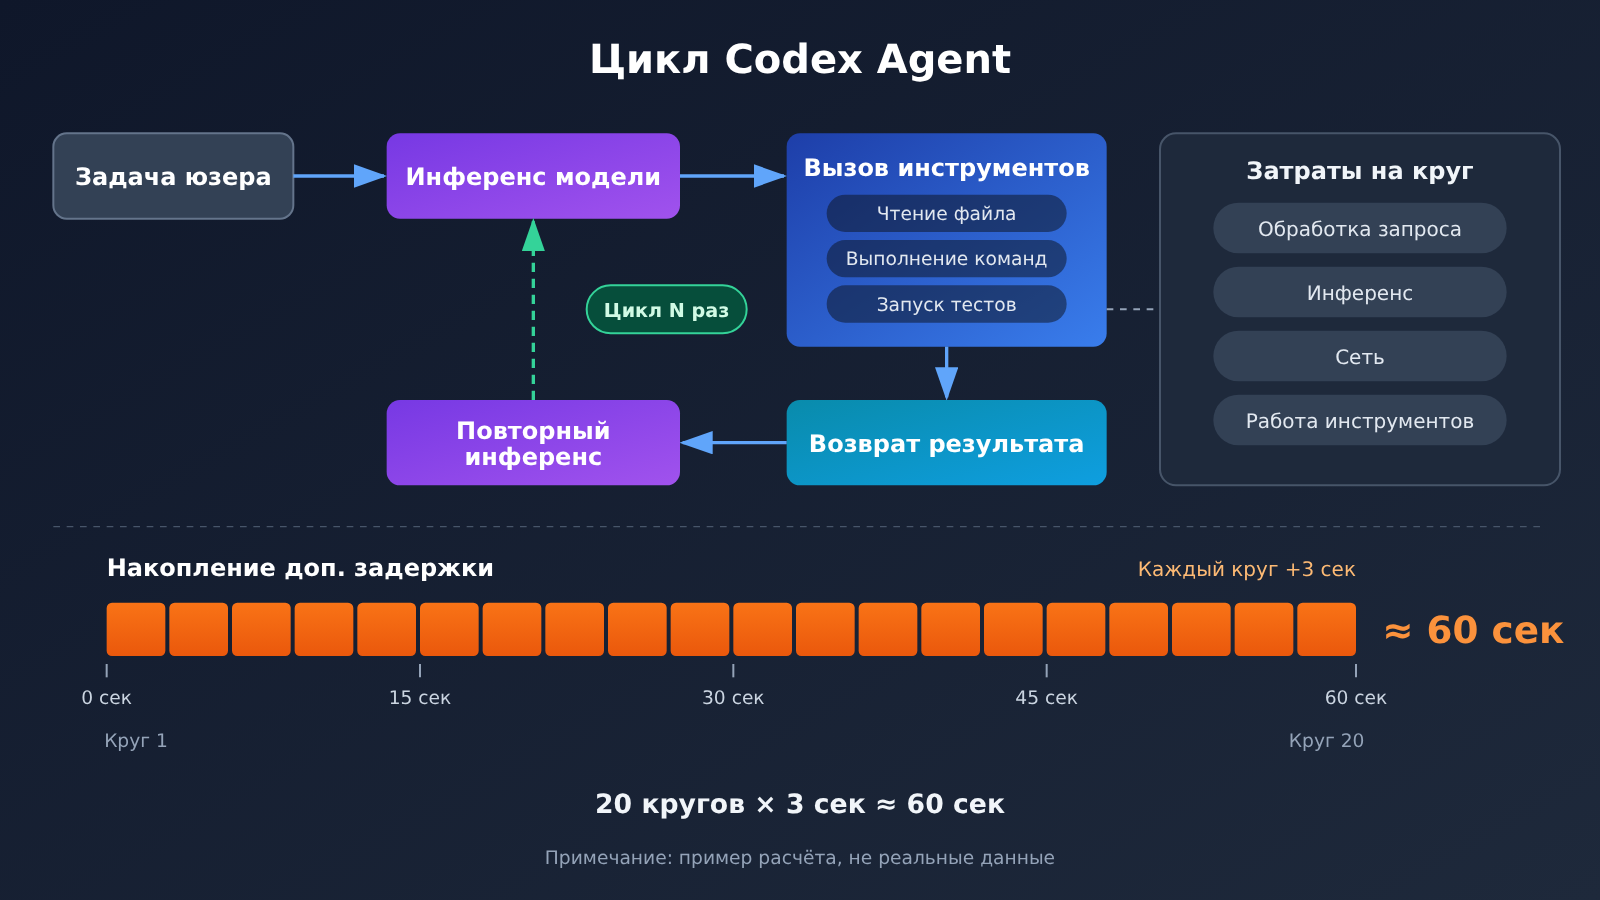
Один и тот же Codex при входе через ChatGPT Plus работает плавно, а после переключения на сторонний API-ключ замедляется. Причина обычно в том, что они идут по разным путям обслуживания, а агентский цикл Codex многократно накапливает дополнительную задержку каждого запроса. Интерфейс клиента одинаковый, но развёртывание модели, уровень рассуждений, протокол передачи, попадание в кэш и совместимость событий инструментов могут отличаться. Если один запрос ждать всего на 3 секунды дольше, задача программирования с 20 последовательными вызовами может растянуться примерно на минуту.
Далее сначала разберём, как работает Codex и каковы два пути подключения, затем по пунктам объясним источники задержки стороннего API и подкрепим двумя публичными GitHub Issue в качестве примеров. После этого приведём четыре ключевые метрики, три группы сравнительных тестов и решения по оптимизации, классифицированные по симптомам, чтобы вы могли определить, где именно тормозит ваш Codex — в модели, сети, кэше или цикле инструментов. В конце обсудим, какие показатели при выборе стороннего API лучше отражают реальную стоимость, чем цена за единицу.
To Know: термины для понимания различий в скорости Codex
| Термин | Объяснение |
|---|---|
| Codex Harness | Фреймворк выполнения Codex, отвечает за организацию модели, инструментов, контекста и цикла многошаговых задач. |
| Responses API | Интерфейс, предоставляемый OpenAI: поддерживает вывод модели, вызов инструментов и управление состоянием в несколько раундов. Codex работает на нём. |
| TTFT | Time To First Token — время ожидания от отправки запроса до получения первого выходного токена. |
| TPS | Tokens Per Second — количество токенов, генерируемых в секунду; отражает скорость непрерывного вывода. |
| Сквозное время выполнения | Общее время от постановки задачи до её окончательного завершения, включая все вызовы модели и выполнение инструментов. |
| Интенсивность рассуждений | Уровень глубины размышлений модели, например low, medium, high. Чем выше уровень, тем обычно больше вывода и дольше время выполнения. |
| Вызов инструментов (Tool Calling) | Процесс, когда модель запрашивает у внешней программы чтение файлов, выполнение команд и т. п., а затем продолжает рассуждение с полученным результатом. |
| Кэширование промптов (Prompt Caching) | Когда входной префикс повторяется и соответствует условиям, ранее вычисленные результаты используются повторно, чтобы снизить время обработки. |
| SSE | Server-Sent Events — сервер непрерывно отправляет события через одностороннее HTTP-соединение. |
| WebSocket | Постоянное двустороннее соединение; несколько раундов запросов могут использовать одно и то же соединение. |
| previous_response_id | Параметр в Responses API для ссылки на ответ предыдущего раунда; вместе с инкрементальным вводом позволяет сократить повторную передачу данных. |
| Уровень обслуживания | Различные варианты обработки одной и той же модели, например Standard, Fast, с разной скоростью и ценой. |
1 Почему один и тот же Codex может работать на двух разных скоростях?
1.1 Вход по подписке и по API-ключу идут разными сервисными путями
Согласно документации OpenAI по аутентификации, Codex CLI, расширения для IDE и десктопные приложения поддерживают два способа входа: вход с учётной записью ChatGPT или ввод API-ключа. Вход через ChatGPT расходует подключённые к подписке права использования Codex и соответствующие лимиты; API-ключ работает по правилам тарификации и ограничения скорости API-аккаунта. Сама подписка Plus не даёт права бесплатно вызывать любые OpenAI API.
Когда вы подключаете сторонний API-ключ, клиент Codex только организует задачу — сам инференс происходит на сервисе, стоящем за этим интерфейсом. Фактически вызываемая модель, способ тарификации, потоковый протокол и качество обслуживания определяются сторонним интерфейсом и его бэкендом. Поэтому одинаковое название модели в клиенте говорит лишь о том, что вы выбрали одно и то же имя, и никак не подтверждает, что два запроса прошли через одно и то же развёртывание модели, одну и ту же очередь сервиса и один и тот же путь передачи.
1.2 Цикл Agent в Codex заставляет его снова и снова обращаться к модели
В материале «Codex as a platform», опубликованном OpenAI 19 августа 2026 года, объясняется: открытый Agent Harness в Codex отвечает за понимание задачи, поддержание контекста, поиск по кодовой базе, вызов Shell, редактирование файлов, запуск тестов, а также за обработку сбоев и восстановление, пользовательские подтверждения и границы выполнения. По своей сути это циклическая система «рассуждение модели → выполнение инструментов → снова рассуждение».
В инженерной статье OpenAI от 22 апреля 2026 года описан типичный процесс: пользователь ставит задачу на изменение, модель решает, что именно делать, Codex читает файлы или выполняет команды, инструменты возвращают результат, модель заново его анализирует, а затем продолжает вызывать инструменты, править код, запускать тесты и проверять результаты. Сложная задача может включать десятки раундов обмена между моделью и инструментами, и каждый такой раунд — это полноценный API-запрос.
2. Откуда берётся разница в скорости при подключении Codex к сторонним API?
Сначала — таблица с пятью источниками задержки. Дальше разберём каждый по порядку.
| Источник задержки | Основные затрагиваемые метрики | Типичное проявление | Приоритет диагностики |
|---|---|---|---|
| Модель и интенсивность рассуждений | TPS, время инференса на один ход | Вывод стабильно медленный, рассуждение занимает много времени | Высокий |
| Уровень сервиса и маршрутизация | TTFT, амплитуда колебаний | Медленный первый ответ или скорость скачет | Высокий |
| Шлюз и сетевой маршрут | Фиксированная дополнительная задержка на каждом ходе | Каждый вызов стабильно добавляет несколько секунд | Средний |
| Протокол передачи (SSE / WebSocket) | Накопленные накладные расходы на нескольких ходах, стабильность соединения | Длинные задачи идут медленно, соединение обрывается на полпути | Средний |
| Кэш и циклы инструментов | Время обработки ввода, число итераций | Длинные диалоги заметно замедляются, итераций слишком много | Высокий |
2.1 Как скорость инференса модели и интенсивность рассуждений влияют на время работы Codex
Прежде чем сравнивать два способа подключения, нужно проверить, совпадают ли фактический ID модели, интенсивность рассуждений, версия модели и уровень сервиса. Интенсивность рассуждений задаётся от low до xhigh и max: чем выше уровень, тем больше рассуждений генерирует модель и тем дольше длится один ход.
В руководстве OpenAI по оптимизации задержек количество выходных токенов названо ключевой переменной, влияющей на время инференса: в некоторых сценариях при сокращении выходных токенов примерно на 50% задержка генерации тоже может упасть почти на 50%. А сокращение обычного входного текста обычно даёт гораздо меньший эффект. Уровень сервиса тоже важен: режим Fast от OpenAI может ускорять подходящие модели и нагрузки до 2.5 раза, но это платная опция уровня сервиса, и она работает только для части моделей.
Отсюда вывод: даже если и на стороне подписки, и у стороннего провайдера указана одна и та же модель, скорость будет заметно отличаться, если не совпадает уровень рассуждений или уровень сервиса.
2.2 Влияние сервиса-прокси API, сетевых путей и WebSocket на многошаговые задачи
У сторонних интерфейсов цепочка запросов обычно длиннее: клиент → шлюз провайдера → прокси-узел → возможный трансграничный маршрут → финальный сервис инференса. Каждый лишний переход добавляет немного фиксированной задержки и сетевой нестабильности, а в цикле агента эти задержки накапливаются от шага к шагу.
Транспортный протокол — ещё одна переменная. Традиционный Responses API чаще всего передаёт данные по HTTP/SSE: на каждом шаге приходится заново устанавливать запрос и передавать контекст. Режим WebSocket поддерживает постоянное соединение и за счёт previous_response_id и инкрементального ввода сокращает повторную передачу и обработку. OpenAI опубликовала следующие данные:
- В конце 2025 года очередная оптимизация API улучшила задержку первого токена почти на 45%.
- В отдельных рабочих процессах с более чем 20 вызовами инструментов режим WebSocket даёт до примерно 40% ускорения сквозной обработки.
- Интеграции, связанные с Vercel, сообщают об улучшении задержки до примерно 40%, многофайловые рабочие процессы Cline — об ускорении около 39%, а модели OpenAI в Cursor — об улучшении до примерно 30%.
Эти данные получены в разных продуктах и тестовых сценариях и представляют собой верхние значения для конкретных рабочих процессов. Некоторые совместимые шлюзы реализуют только HTTP/SSE или не поддерживают в полном объёме WebSocket и управление инкрементальным состоянием, используемые Codex, — при таком подключении эти преимущества недоступны.
2.3 Контекстный кеш Codex и число вызовов инструментов
В длинных задачах историю сообщений, определения инструментов и повторяющийся контекст приходится каждый раз заново отправлять в модель — и всё это съедает львиную долю входных токенов. Когда срабатывает кеш промптов, обработку этой префиксной части можно заметно ускорить. В документации OpenAI указано, что GPT-5.6 и последующие серии поддерживают новые механизмы записи в кеш, чтения из него и управления TTL.
Загвоздка в том, что кеш держится на стабильности префикса запроса. Если транзитный слой переписывает префикс запроса, меняет порядок определений инструментов или сдвигает границы кеша, повторное использование кеша может пострадать — и тогда на каждом раунде заново обрабатывается большой кусок контекста. А число вызовов инструментов напрямую определяет количество раундов запросов: чем больше раундов, тем сильнее раздувается накладной расход каждого отдельного раунда.
2.4 Почему Codex нормально отвечает на первый запрос, но дальше всё равно медленно?
Это самый частый вариант той проблемы, что вынесена в заголовок. TTFT измеряет только то, насколько быстро приходит первый токен, а общее время выполнения задачи Codex — это сумма по всем раундам. Общее время можно записать так:
T_total = Σ (время обработки API-запроса + время инференса модели + время передачи по сети + время локального выполнения инструментов + время ожидания и повторов)
Если первый ответ приходит нормально, а в целом всё медленно, обычно причина в одном из следующего: скорость устойчивого вывода (TPS) низкая, и длинные ответы тормозят каждый раунд; после завершения работы инструмента модель снова запускает инференс, а при каждом таком перезапуске контекст приходится обрабатывать заново; потоковое соединение обрывается или уходит в таймаут посередине, клиент запускает повтор, и пользователь видит, что «модель застыла». Если прикинуть по механике: в задаче с 20 последовательными вызовами модели каждая лишняя секунда ожидания на один вызов добавляет к общему времени примерно 60 секунд — эта цифра приведена, чтобы показать накопительный эффект, а не как результат измерений.
3. Что публичные кейсы говорят о медленной работе Codex?
Два кейса ниже взяты из пользовательских отчётов в репозитории openai/codex. Это отдельные логи одного пользователя: они нужны, чтобы показать механизм, а не претендуют на отражение общей отраслевой картины.
3.1 Issue #60831: почти семикратный разброс времени ответа в одной сессии
В Issue #60831, открытом в ноябре 2026 года, автор отчёта наблюдал два запроса в одной сессии, одном процессе клиента и с одинаковыми настройками инференса: сжатые тела запросов в обоих случаях были около 13.09 MB, сжатия контекста между ними не происходило, история изображений тоже не менялась. В медленном случае от завершения сжатия запроса до получения заголовков HTTP-ответа прошло 109.317 секунды, в быстром — 15.637 секунды; отношение составило примерно 6.99.
Важно понимать, что именно измерялось: эти два числа — время до получения заголовков ответа, то есть этап обработки на сервере, а не полная длительность задачи. Оба запроса шли по одному и тому же пути, так что к сравнению подписки и сторонних решений это отношения не имеет. Это говорит о том, что при неизменном размере контекста время обработки на сервере само по себе может сильно колебаться. Сам отчёт не позволяет определить, какое именно звено сервиса создало узкое место.
3.2 Issue #44305: цикл инструментов резко увеличивает время задачи только для чтения
В Issue #44305 за сентябрь 2026 года автор сравнил однотипные задачи только для чтения: другой агент справился примерно за 10.6 секунды, выполнив три параллельных чтения; Codex работал 91.5 секунды и завершился по тайм-ауту, так и не дав полного ответа. За это время Codex выполнил около 11 инференсов модели и 11 вызовов инструментов, суммарный вход — около 295,042 tokens, из них около 260,608 tokens пришлось на кэшированный вход.
Если посчитать по этим цифрам, доля кэшированного входа — около 88.3%, кэш явно работает хорошо, но последовательный цикл из 11 раундов всё равно делает выполнение гораздо дольше, чем схема с параллельными чтениями. Стратегии работы двух агентов изначально различаются, поэтому разницу во времени нельзя целиком объяснить особенностями Codex или модели, но она наглядно показывает, насколько количество раундов вызовов и последовательное выполнение увеличивают общее время.
Кроме того, есть две категории проблем, напрямую связанных с подключением сторонних сервисов. В Issue #33029 сообщается: когда Codex Desktop работает через сторонний совместимый интерфейс, эндпоинт модели функционирует нормально, но десктопное приложение всё равно запрашивает некоторые вспомогательные сервисы ChatGPT; тайм-ауты таких запросов замедляют отклик приложения. В Issue #41340 сообщается о появлении «stream disconnected before completion» на сторонних эндпоинтах Responses, а в #42471 — о том, что события вызовов инструментов принимаются, но не попадают в процесс выполнения. То, что работает простой чат, и то, что работает полный цикл инструментов Codex, — это два разных уровня требований к совместимости.
4. Как выяснить, где именно тормозит ваш Codex?
4.1. Четыре ключевые метрики, чтобы найти узкое место в Codex
| Метрика | Как фиксировать | О чём говорит |
|---|---|---|
| TTFT | Время ожидания первого полезного вывода на каждый запрос | Очередь, запуск модели, первый сетевой пакет |
| Сквозное время | Общее время от отправки задачи до её завершения | Общее впечатление; это итоговый критерий оценки |
| Количество вызовов модели и инструментов | Считать раунды推理, число вызовов инструментов и время их выполнения | Стратегия агента и задержки из-за последовательного выполнения |
| Попадания в кэш | Общий вход, чтение кэша, запись кэша, выходные токены | Накладные расходы на повторную обработку контекста |
Помимо этих четырёх метрик, стоит также фиксировать TPS, количество входных и выходных токенов на один запрос, используемый протокол (WebSocket или SSE), а также число 429, 5xx, тайм-аутов и повторных попыток. Эти вспомогательные данные помогут отличить «просто медленно» от «медленно из-за повторов после ошибок».
4.2 Порядок выполнения трёх групп контрольных тестов Codex
Залог корректного сравнения — контроль переменных: ID модели, сила рассуждения, версия Codex, файлы проекта и постановка задачи должны совпадать. Кроме того, каждый сценарий прогоняем дважды — в новой сессии и в длинной сессии, — чтобы увидеть влияние длины контекста.
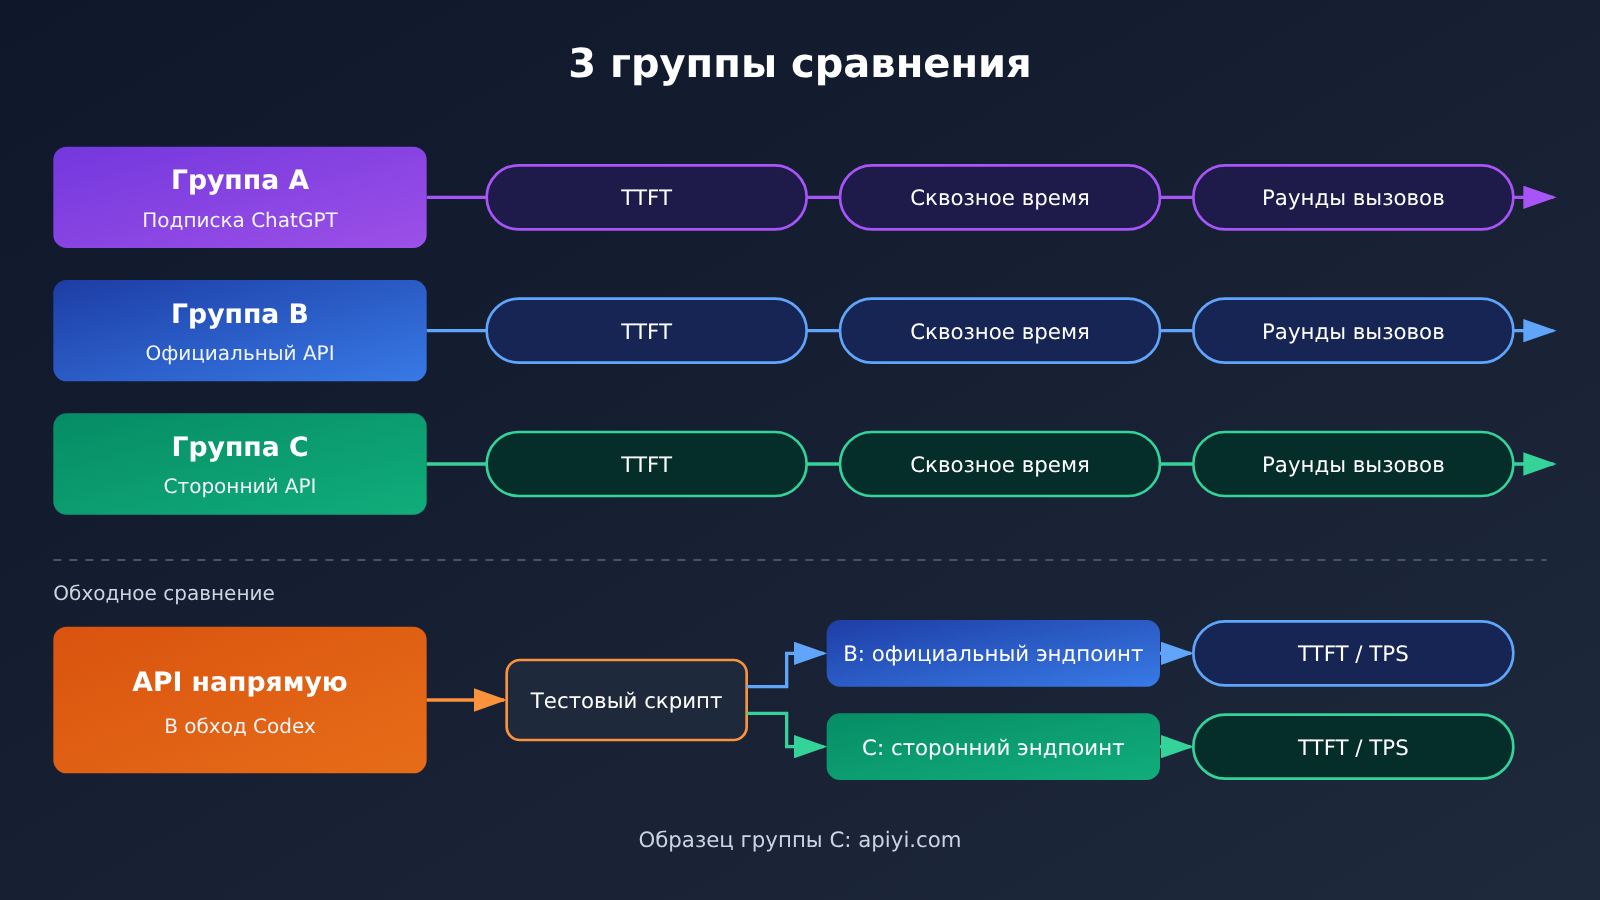
- Группа A: вход в Codex через подписку ChatGPT, выполнение стандартной задачи, фиксируем сквозное время и число раундов вызова.
- Группа B: подключение Codex к официальному API-ключу той же модели, та же задача.
- Группа C: подключение Codex к стороннему совместимому API, та же задача.
- Группа прямого подключения: для путей B и C обходим Codex и отправляем тот же одиночный запрос скриптом, измеряя TTFT и TPS.
Разница между A и B отражает прежде всего различия в обслуживании на пути подписки и на пути API; разница между B и C — различия шлюза, маршрутизации и сервиса инференса; а расхождение между результатами прямого подключения и результатами внутри Codex показывает дополнительные накладные расходы от цикла агента, совместимости протокола и клиента. В каждой группе стоит повторить замер несколько раз и брать медиану, чтобы случайный всплеск не превратился в «вывод».
Скрипт ниже предназначен для «группы прямого подключения»: он отправляет потоковый запрос Responses и измеряет TTFT, общее время, выходные токены и TPS:
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # единый интерфейс APIYI; переключитесь на официальный адрес, чтобы получить замер группы B
)

start = time.perf_counter()
ttft = None
stream = client.responses.create(
    model="YOUR_MODEL_ID",            # тот же ID модели, что используется в Codex
    reasoning={"effort": "medium"},   # та же сила рассуждения, что в Codex
    input="阅读下面的函数并指出潜在 bug:def add(a, b): return a - b",
    stream=True,
)
usage = None
for event in stream:
    if event.type == "response.output_text.delta" and ttft is None:
        ttft = time.perf_counter() - start
    elif event.type == "response.completed":
        usage = event.response.usage

total = time.perf_counter() - start
out_tokens = usage.output_tokens if usage else 0
print(f"TTFT: {ttft:.2f}s | 总耗时: {total:.2f}s | 输出: {out_tokens} tokens")
if ttft and total > ttft:
    print(f"TPS: {out_tokens / (total - ttft):.1f} tokens/s")
Показать полный скрипт многократных повторных прогонов и подсчёта статистики кэша
import time
import statistics
from openai import OpenAI

ENDPOINTS = {
    "official": {"base_url": "https://api.openai.com/v1", "key": "OFFICIAL_KEY"},
    "apiyi": {"base_url": "https://api.apiyi.com/v1", "key": "APIYI_KEY"},  # интерфейс APIYI
}
MODEL = "YOUR_MODEL_ID"
EFFORT = "medium"
# Используем длинный фиксированный префикс, чтобы имитировать системный промпт и определения инструментов Codex — так проще наблюдать за попаданиями в кэш
PREFIX = "你是代码审查助手。项目规范如下:\n" + ("- 函数必须有类型注解。\n" * 300)
TASK = "检查这个函数:def add(a, b): return a - b"


def run_once(client):
    start = time.perf_counter()
    ttft, usage = None, None
    stream = client.responses.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=PREFIX + TASK,
        stream=True,
    )
    for event in stream:
        if event.type == "response.output_text.delta" and ttft is None:
            ttft = time.perf_counter() - start
        elif event.type == "response.completed":
            usage = event.response.usage
    total = time.perf_counter() - start
    cached = 0
    if usage and getattr(usage, "input_tokens_details", None):
        cached = usage.input_tokens_details.cached_tokens or 0
    return {
        "ttft": ttft or total,
        "total": total,
        "input": usage.input_tokens if usage else 0,
        "cached": cached,
        "output": usage.output_tokens if usage else 0,
    }


def bench(name, cfg, rounds=5):
    client = OpenAI(api_key=cfg["key"], base_url=cfg["base_url"])
    results, errors = [], 0
    for _ in range(rounds):
        try:
            results.append(run_once(client))
        except Exception as e:
            errors += 1
            print(f"[{name}] 请求失败: {e}")
    if not results:
        return
    med = lambda k: statistics.median(r[k] for r in results)
    hit = sum(r["cached"] for r in results) / max(sum(r["input"] for r in results), 1)
    print(
        f"[{name}] TTFT中位数 {med('ttft'):.2f}s | 总耗时中位数 {med('total'):.2f}s | "
        f"缓存命中率 {hit:.1%} | 失败 {errors}/{rounds}"
    )


for name, cfg in ENDPOINTS.items():
    bench(name, cfg)
При тестировании группы C внутри Codex нужно настроить сторонний эндпоинт как провайдера модели. Ниже — типичный вариант записи в ~/.codex/config.toml; точные названия полей уточняйте в официальной документации вашей версии Codex:
model = "YOUR_MODEL_ID"
model_provider = "apiyi"
model_reasoning_effort = "medium"

[model_providers.apiyi]
name = "APIYI"
base_url = "https://api.apiyi.com/v1"
env_key = "APIYI_API_KEY"
wire_api = "responses"
🚀 Быстрый старт: для контрольного прогона группы C можно запросить у APIYI apiyi.com бесплатный тестовый лимит для новых пользователей, переключать несколько моделей одним и тем же ключом и по очереди прогонять приведённый выше скрипт — так вы быстро получите сопоставимые данные по TTFT и общему времени выполнения.
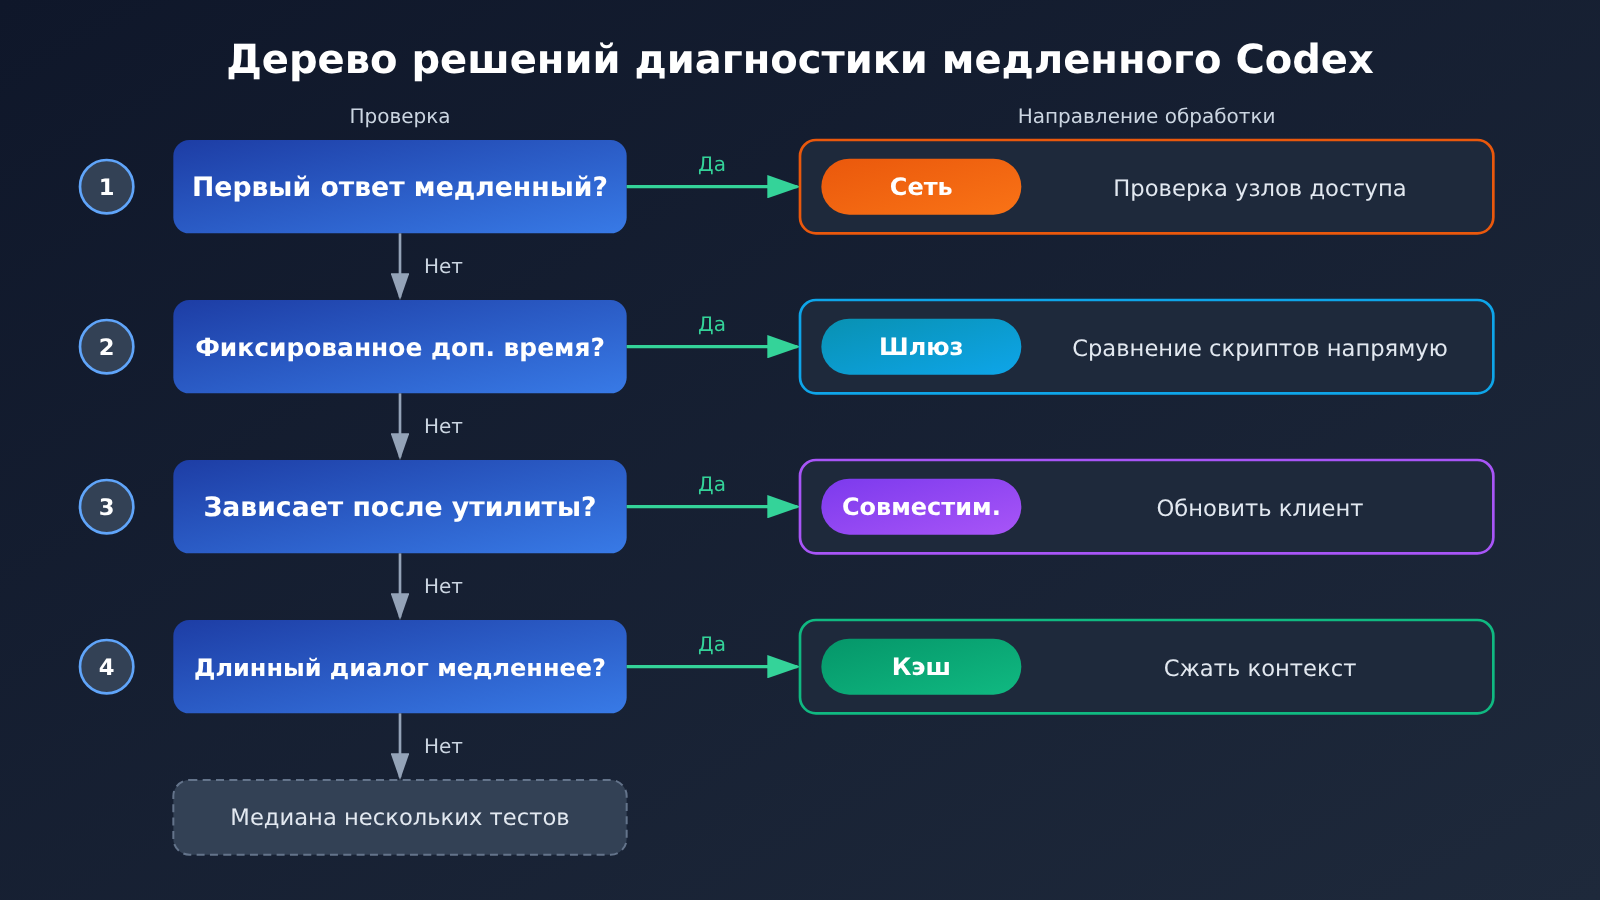
4.3 Схемы оптимизации Codex по симптомам
| Симптом | Что проверять в первую очередь | Что делать |
|---|---|---|
| Медленный первый ответ | Очередь, запуск модели, первый пакет по сети | Переключиться на более близкий узел доступа, уточнить уровень сервиса, сравнить в непиковые часы |
| Первый ответ быстрый, дальше медленно | TPS, число раундов инструментов, кэш | Снизить глубину рассуждений, ограничить длину вывода, проверить долю попаданий в кэш |
| Каждый вызов добавляет стабильное время | Цепочка прокси, дополнительные запросы | Сравнить группы B и C скриптом с прямым подключением, локализовать накладные расходы шлюза |
| Застревает после вызова инструмента | События Responses, возврат от инструмента | Проверить, нет ли обрыва потока или потери событий инструмента, обновить версию клиента |
| Длинный диалог заметно медленнее нового | Исторические токены, сжатие, кэш | Вовремя открывать новый сеанс или запускать сжатие контекста, следить за изменениями при чтении кэша |
| Скорость скачет то вверх, то вниз | Нагрузка на сервис, повторные попытки, колебания сети | Считать количество 429/5xx и таймаутов, брать медиану по нескольким прогонам |
| В десктопном приложении всё тормозит, а API работает нормально | Запросы вспомогательных сервисов ChatGPT | См. Issue #33029, проверить, не истекают ли вспомогательные запросы, при необходимости перейти на CLI |
Оптимизация на уровне модели идёт по той же логике, что и руководство OpenAI по задержкам: меньше выходных токенов, короче входной контекст, меньше вызовов, независимые шаги — параллельно, а всё, что можно сделать обычной программой, лучше модели не поручать. Для Codex самый прямой приём — задавать в описании задачи более чёткие рамки, чтобы Agent меньше тратил раунды на исследовательское чтение.
5. Какие показатели важнее цены за единицу при выборе стороннего API для Codex?
5.1. От цены за token к стоимости выполнения задачи
В сценариях с Codex фактическая стоимость определяется тем, сколько стоит «выполнить одну задачу». У интерфейса с низкой ценой за токен могут быть плохие попадания в кэш, много раундов вызовов и частые обрывы с повторными попытками — в итоге расход токенов и времени окажется выше. При оценке рекомендую смотреть на несколько вещей в комплексе: долю успешно выполненных задач, сквозное время выполнения, общий расход токенов на одну задачу (включая чтение из кэша), дополнительные издержки из-за ошибок и повторных попыток.
| Критерий оценки | Что именно проверять | Метод тестирования | Доступная платформа |
|---|---|---|---|
| Идентичность модели и версия | Ясны ли ID модели и версия, стабильно ли они доступны | Сверить поле модели в ответе с документацией | APIYI apiyi.com, официальный API |
| Первый token и устойчивая скорость | Медиана и разброс TTFT и TPS | Несколько раундов тестов скриптом с прямым подключением | APIYI apiyi.com, официальный API |
| Время выполнения многораундового агента | Общее время реальной задачи внутри Codex | Тесты с тремя контрольными группами | APIYI apiyi.com, официальный API |
| Совместимость протоколов | Поддержка Responses, WebSocket и событий инструментов | Запустить полную задачу: чтение файла + правка кода + тестирование | Зависит от документации провайдера |
| Поддержка кэша | Нормально ли возвращаются токены чтения из кэша | Подсчитать поля кэша в usage | Зависит от документации провайдера |
| Стабильность и биллинг | Доля ошибок, параллелизм, прозрачность биллинга | Фиксировать 429/5xx и детализацию счёта | Зависит от документации провайдера |
5.2. Оценка сторонних интерфейсов, таких как APIYI, на реальных задачах
APIYI apiyi.com — это агрегатор API для больших языковых моделей. С одним API-ключом можно вызывать популярные модели OpenAI, Claude, Gemini и другие; интерфейс совместим с протоколом OpenAI, оплата по фактическому использованию. Его ценность в сценариях с Codex прежде всего в удобном горизонтальном сравнении: с одной и той же конфигурацией можно переключать разные модели и уровни и получать сопоставимые данные на собственном проекте.
У разных сторонних провайдеров различаются цепочки обработки запросов, поддержка протоколов и стабильность, поэтому при оценке стоит опираться на конкретные тестовые данные и условия обслуживания. Рекомендуется выбрать 2–3 показательные задачи (например, один рефакторинг нескольких файлов или исправление бага с тестами), выполнить их отдельно для каждого способа подключения по методике из раздела 4, а затем принять решение с учётом доли успешных задач и общего числа токенов.
💡 Рекомендация по выбору: сначала с помощью скрипта с прямым подключением отсеять варианты с заметно отклоняющимися TTFT и TPS, затем оставшихся кандидатов запустить в Codex на полной задаче. Через единый интерфейс APIYI apiyi.com можно сравнить несколько моделей, не меняя структуру кода.
Частые вопросы (FAQ)
Q1: Откуда в основном берётся разница в скорости между подпиской Codex и сторонним API?
Из общей разницы в сервисном пути: фактическое развёртывание модели, интенсивность рассуждений, уровень обслуживания, цепочка шлюзов, протокол передачи, попадание в кеш и степень совместимости с событиями инструментов. Многораундовый агентный цикл Codex накапливает эти различия одного раунда раунд за раундом, поэтому итоговая разница во времени обычно гораздо больше, чем разница в одном запросе.
Q2: TTFT в норме, почему задача Codex всё равно медленная?
TTFT измеряет только время ожидания первого токена. Одна задача Codex включает несколько раундов рассуждений и вызовов инструментов — скорость непрерывного вывода, повторные рассуждения после выполнения инструментов, промахи кеша и ретраи по ходу дела удлиняют общее время. Чтобы оценить опыт, смотрите на сквозное время и число раундов вызовов.
Q3: Насколько WebSocket-режим ускоряет Codex?
OpenAI опубликовала данные: в特定 рабочих процессах с более чем 20 вызовами инструментов сквозная скорость повышается примерно до 40%. Это верхняя граница для конкретного сценария; реальная выгода зависит от числа раундов задачи и от того, полностью ли интерфейс поддерживает WebSocket и управление инкрементальным состоянием.
Q4: В длинных диалогах Codex становится всё медленнее — что делать?
Сначала фиксируйте общее число входных токенов и токенов чтения кеша на каждом раунде — так вы проверите, попадает ли кеш как надо. Если исторический контекст слишком длинный, можно открыть новую сессию или запустить сжатие контекста; заодно сузьте рамки задачи и сократите число исследовательских раундов чтения файлов.
Q5: Как быстро проверить реальную работу стороннего API в Codex?
1. Зарегистрируйтесь в APIYI apiyi.com и получите API-ключ и бесплатную тестовую квоту;
2. Скриптом прямого подключения из этой статьи измерьте TTFT, TPS и попадание в кеш;
3. Настройте Codex по разделу 4.2, выполните ту же задачу, что и на стороне подписки, и сравните сквозное время и число раундов вызовов.
Так вы сможете отдельно увидеть разницу в сервисе инференса и разницу, которую вносит агентный цикл.
Q6: Могут ли данные из публичных Issue отражать общую производительность Codex?
Напрямую — нет. Issue #60831 и #44305 — это логи отдельных пользователей: первый измеряет время до HTTP-заголовков ответа, второй — одна задача только для чтения, завершившаяся таймаутом. Их ценность в том, что они показывают, как колебания на стороне сервера и последовательный цикл инструментов влияют на время; конкретные выводы нужно проверять собственными тестами на своих задачах.
Ключевые выводы о различиях в скорости Codex
- Разные маршруты: вход по подписке и через API-ключ используют разные схемы биллинга и обслуживания. Одинаковое название модели ещё не значит, что развёртывание тоже одинаковое.
- Усиление в цикле: цикл Agent в Codex складывает небольшие задержки каждого шага в заметную разницу общего времени.
- Метрики нужно разделять: TTFT показывает время до первого ответа, а сквозное время и число вызовов отражают реальный опыт.
- Протокол имеет значение: WebSocket в сценариях с многократными вызовами инструментов даёт ускорение до ~40%, но требует полной поддержки со стороны API.
- Проверяйте кеш: промежуточный слой может изменить префикс запроса и тем самым повлиять на кеш; нужно считать токены, прочитанные из кеша.
- Сравнительное тестирование: сравните три группы на одной задаче — подписку, официальный API и сторонний API, а также добавьте прямой тест, чтобы найти узкое место.
- Выбирайте под задачу: тестируйте на реальных задачах на разных платформах, например APIYI apiyi.com, и смотрите на стоимость выполнения задачи, а не на цену за единицу.
Итог
Один и тот же Codex может работать с двумя разными скоростями. Причина — наложение сервисного маршрута и цикла Agent:
- На уровне механики: модель, интенсивность рассуждений, уровень сервиса, шлюз, протокол, кеш и цикл вызова инструментов вместе определяют общее время. Любая разница на одном шаге умножается при многократных вызовах.
- На уровне данных: официальные данные показывают, что оптимизация протокола и уровня сервиса даёт заметное ускорение. Логи пользователей показывают, что колебания на стороне сервера и последовательные циклы сильно растягивают задачу.
- На уровне методики: фиксируйте четыре ключевых показателя, проведите сравнение трёх групп плюс прямой тест, затем устраняйте проблемы по симптомам.
При диагностике сначала фиксируйте модель и интенсивность рассуждений, а затем опирайтесь на данные. Если нужно сравнить несколько моделей и способов подключения, используйте единый интерфейс APIYI, чтобы снизить затраты на тестирование до минимума.
📚 Справочные материалы
- Codex as a platform: build on the open agent harness: OpenAI рассказывает о роли Codex Agent Harness
- Ссылка:
developers.openai.com/blog/codex-as-a-platform -
Описание: официальная основа для понимания многоходовой модели Codex и цикла инструментов
-
Документация по аутентификации Codex: два способа подключения — вход через ChatGPT и API-ключ
- Ссылка:
learn.chatgpt.com/docs/auth?surface=cli -
Описание: разграничение прав по подписке и биллинга API, правил ограничения частоты запросов
-
Speeding up agentic workflows with WebSockets in the Responses API: инженерная статья OpenAI
- Ссылка:
openai.com/index/speeding-up-agentic-workflows-with-websockets -
Описание: процесс агентного цикла и данные об ускорении с помощью WebSocket
-
Документация по режиму WebSocket: режим WebSocket в Responses API
- Ссылка:
developers.openai.com/api/docs/guides/websocket-mode -
Описание: постоянные соединения, инкрементальный ввод и сценарии применения
-
Руководство по оптимизации задержек: принципы оптимизации задержек OpenAI
- Ссылка:
developers.openai.com/api/docs/guides/latency-optimization -
Описание: идеи оптимизации — выходные токены, количество вызовов, распараллеливание и т.д.
-
Документация по режиму Fast: уровни обслуживания и область ускорения
- Ссылка:
developers.openai.com/api/docs/guides/fast-mode -
Описание: переменная уровня обслуживания, которую нужно контролировать при сравнении скорости
-
Документация по кэшированию промптов: запись в кэш, чтение и TTL
- Ссылка:
developers.openai.com/api/docs/guides/prompt-caching -
Описание: статистика и оптимизация попаданий в кэш в длинных диалогах
-
openai/codex Issue #60831 / #44305 / #33029 / #41340 / #42471: сообщения пользователей о задержках и проблемах совместимости
- Ссылка:
github.com/openai/codex/issues/60831,github.com/openai/codex/issues/44305,github.com/openai/codex/issues/33029 - Описание: логи отдельных случаев — колебания на стороне сервера, разрастание цикла инструментов, вспомогательные запросы десктопного клиента и совместимость со сторонними протоколами
Автор: техническая команда APIYI
Технический обмен: приглашаем связаться с нами на главной странице сайта APIYI apiyi.com, чтобы обсудить опыт подключения Codex и тестирования производительности; больше материалов — в центре документации docs.apiyi.com


